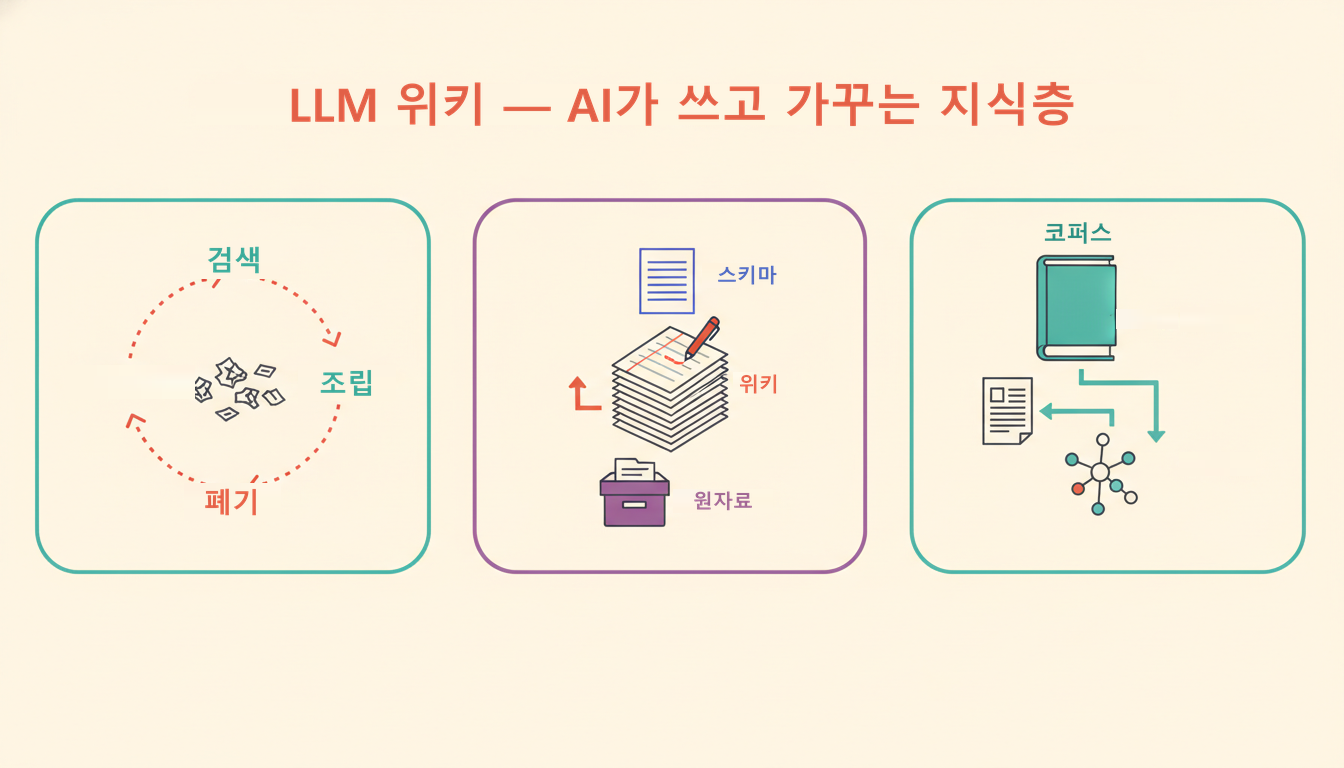
LLM 위키는 LLM이 직접 리서치하고 집필하고 유지하는 자기완결 지식층이다. 매 질문마다 조각을 검색해 합성하고 버리는 RAG와 달리, 한 번 증류한 이해를 문서로 눌러 담아 다음 질문이 그 위에서 시작하게 하는 축적 층이다.
"위키 문서 하나 써줘" 해본 밤
챗봇에 "이 주제로 위키 문서 하나 써줘"라고 시켜 본 적이 있다. 목차도 그럴듯하고, 문단마다 인용까지 붙어 나온다. 처음 읽으면 꽤 근사하다.
그런데 두 번째로 읽으면 어딘가 얄팍하다. 인용은 달렸는데 왜 그 문서를 골랐는지가 안 보이고, 목차는 매끈한데 서로 다른 관점이 부딪친 흔적이 없다. 한 사람이 아는 만큼만, 한 번에 훑어 쓴 글의 냄새가 난다.
그 얄팍함이 바로 이 글이 열어볼 문이다. ‘LLM에게 위키를 통째로 맡긴다’는 일이 실제로 어떻게 돌아가는지, 왜 그냥 시키면 얄팍한지를 뜯어본다. 그리고 이렇게 쌓은 지식층은 요즘 자주 들리는 지식그래프와 어디서 만나는가.
문제는 문장력이 아니라 축적이다
두 뿌리에서 같은 문제로
‘LLM 위키’라는 말은 지금 두 곳에서 자란다. 뿌리가 다르다.
하나는 사람이 읽을 위키를 LLM이 쓰는 흐름이다. Wikipedia 한 편만큼의 장문을, 주제어 하나에서 시작해 처음부터 생성한다. 스탠퍼드의 STORM이 대표다. 목표는 사람이 그냥 읽을 수 있는, 인용 달린 백과사전 문서다.
다른 하나는 LLM이 읽으려고 LLM이 쓰는 흐름이다. Andrej Karpathy가 공유한 llm-wiki.md 패턴이 그 예다. 에이전트가 매번 처음부터 파악하는 대신, 자기가 정리해 둔 마크다운 문서를 먼저 읽고 시작하게 만든다. 독자가 사람이 아니라 다음 턴의 에이전트인 셈이다.
겉보기엔 딴 방향이지만, 둘은 같은 문제의식으로 모인다. 지식은 검색이 아니라 축적의 문제라는 것. 좋은 문서 한 편은 잘 찾는 데서가 아니라 이해가 쌓인 자리에서 나온다.
RAG는 맨바닥에서 다시 찾는다
Karpathy의 논지를 빌리면, RAG(검색 증강 생성)는 매 질문마다 지식을 맨바닥에서 다시 발견한다. 질문이 들어오면 관련 조각을 검색하고, 그 조각들을 합쳐 답을 만들고, 답이 나오면 조립한 이해를 버린다. 다음 질문은 또 아무것도 모르는 상태에서 시작한다.
이 반복에는 축적이 없다 — 어제 열 번 조립한 이해가 오늘의 첫 질문을 조금도 앞당겨 주지 못한다.
위키는 그 반복을 끊는다. 한 번 증류한 이해를 문서로 눌러 담아 두면, 다음 질문은 백지가 아니라 그 문서 위에서 출발한다. Karpathy는 이렇게 쌓아 둔 위키의 유지 비용이 "0에 가깝다"고 말하는데, 이 대목은 정성적 논증이지 측정된 수치가 아니다. 유통되는 몇몇 배수 표현은 원문 어디에도 없다.
문제는 이제 분명해졌다. LLM 위키가 얄팍했던 건 문장력이 부족해서가 아니다. 쓰기 전에 쌓는 단계가 통째로 빠졌기 때문이다. 그럼 잘 만드는 쪽은 그 단계를 어떻게 채우는가. 집필부터 뜯어 본다.
집필: STORM은 쓰기 전에 관점을 여럿 부른다
STORM이 붙잡은 지점은 문장이 아니라 사전조사(pre-writing) 다. 그냥 "써 줘"가 얄팍한 이유가 여기 있다 — 좋은 백과사전 문서를 쓰는 사람은 곧장 쓰지 않고, 뭘 물어야 할지부터 조사한다. STORM은 그 조사를 네 개의 뚜렷한 동작으로 쪼갠다.
관점 발견 — 무엇이 들어가 무엇이 나오나
첫 동작은 관점(perspective) 찾기다. 입력은 주제어 하나뿐이다. STORM은 그 주제와 비슷한 기존 위키 문서들을 모아, 그 문서들이 같은 주제를 어떤 각도로 잘라 놓았는지 목차를 훑는다.
출력은 서로 다른 관점의 묶음이고, 각 관점은 곧 한 명의 ‘작가 페르소나’가 된다. 역사적 배경을 캐묻는 작가, 기술적 원리를 파는 작가처럼, 한 명이 훑고 마는 대신 여러 시선을 일부러 불러 세우는 것이다.
페르소나 Q&A — 사전조사를 명시적 단계로 올리다
두 번째 동작이 이 파이프라인의 핵심이다. 관점별 작가 페르소나가 질문을 던지면, 검색으로 근거를 확보한 전문가 페르소나가 답한다. 입력은 관점 묶음과 검색 도구이고, 출력은 근거가 달린 Q&A 로그다.
작가가 "이 기술은 언제 처음 쓰였나?"를 물으면, 전문가는 곧장 지어내지 않고 검색을 돌려 출처를 확보한 뒤 답한다. 관점이 여럿이니 질문도 여러 결로 쏟아지고, 그때마다 근거가 붙는다. 사람이 자료를 뒤지며 스스로 묻고 답하는 그 조사 과정을, STORM은 대화 시뮬레이션이라는 명시적 단계로 끌어올린 것이다.
아웃라인 조직 → 근거 인용 집필
세 번째 동작은 조직이다. 여기저기서 쏟아진 Q&A 로그를 하나의 목차, 즉 아웃라인으로 정리한다. 흩어진 질문과 답을 주제별로 묶어 글의 뼈대를 세우는 단계다.
네 번째가 비로소 집필이다. 완성된 아웃라인을 따라, 각 섹션을 근거 문서를 인용하며 채운다. 입력은 조직된 Q&A이고 출력은 인용이 박힌 장문이다. 순서를 눈여겨볼 만하다 — 문장을 쓰는 건 맨 마지막이고, 앞의 세 동작이 다 조사와 조직이었다.
절제(ablation)가 개선의 원천을 지목한다
사전조사가 정말 개선의 원천인지는 절제(ablation)로 가려진다. STORM 논문은 그림 1의 세 번째 동작인 아웃라인 조직 단계만 빼고 나머지는 그대로 둔 채 성능을 잰다. FreshWiki 자동 평가에서 다섯 시스템을 나란히 놓으면 계단이 보인다.
| 시스템 | ROUGE-1 | Entity Recall | Heading Soft Recall |
|---|---|---|---|
| Direct Gen (그냥 쓰기) | 25.62 | 5.08 | 80.23 |
| RAG | 28.52 | 7.57 | 73.59 |
| oRAG (아웃라인 RAG) | 44.26 | 12.57 | 73.59 |
| STORM | 45.82 | 14.10 | 86.26 |
| STORM (아웃라인 단계 제거) | 26.77 | 7.39 | — |
(Heading Soft Recall만 아웃라인 품질을 따로 잰 Table 3(GPT-3.5) 값이고, 나머지 둘은 Table 2다.)
그냥 쓰기와 RAG는 아래쪽에 낮게 깔린다. 아웃라인을 도입한 oRAG부터 지표가 한 계단 뛰고, 전체 파이프라인을 갖춘 STORM이 가장 높다. 결정적인 건 맨 아랫줄이다. STORM에서 아웃라인 조직 단계만 빼면 ROUGE-1이 45.82에서 26.77로 내려앉는다 — 그냥 쓰기 수준으로 되돌아간다. Entity Recall도 14.10에서 7.39로 반 토막 난다.

두 지표가 한 방향으로 무너지는 이 기울기가 그림 2에서 한눈에 잡힌다. 개선의 원천은 더 나은 문장이 아니었다. 쓰기 전에 관점을 부르고, 조사하고, 조직하는 그 앞단이었다. 사람 편집자 열 명이 매긴 평가에서도 조직성이 좋다고 본 비율이 뚜렷하게 올랐다. 얄팍함의 반대말은 유창함이 아니라 조직인 셈이다.
유지: 원자료·위키·스키마 3층, 그리고 일부러 뺀 임베딩
집필이 한 편을 만드는 일이라면, 유지는 그 지식층을 오래 살려 두는 일이다. Karpathy의 llm-wiki.md 패턴은 이 유지를 원자료·위키·스키마 세 개의 층으로 나누는데, 층마다 맡는 일이 다르다.
맨 아래는 원자료 층이다. 사람이 넣는 그라운드 트루스로, 논문·문서·로그처럼 사실의 바닥을 이룬다. 이 층은 불변이다 — LLM이 함부로 고치지 않는다.
가운데가 LLM이 쓰는 마크다운 위키 층이다. 세 층 중 유일하게 능동적으로 갱신되는 자리로, 원자료를 읽어 이해로 증류한 결과가 여기 문서로 쌓인다.
맨 위는 스키마 층이다. CLAUDE.md 같은 규칙 문서로, 어떤 형식과 톤으로 무엇을 남기고 버릴지를 정해 두는 헌장 같은 것이다.
index.md와 log.md — 에이전트가 읽는 법
그림 3의 가운데 위키 층을 돌아다니는 법은 뜻밖에 단순하다. 벡터 검색은 없다 — 파일과 목록 두 개면 된다.
index.md는 내용 목록이다. 무엇이 어느 문서에 있는지를 한 파일에서 훑어, 에이전트가 필요한 문서로 곧장 간다. log.md는 append-only 타임라인이다. 무엇이 언제 바뀌었는지를 시간순으로 이어 붙여, 지식층이 어떻게 자라 왔는지를 되짚게 한다. 목록으로 ‘어디에’를 찾고, 로그로 ‘언제·왜’를 잇는 구조다.
이 두 파일이 있으면 에이전트는 임베딩 유사도에 기대지 않고도 자기 지식층을 돌아다닐 수 있다. 인덱스를 열어 문서를 고르고, 로그를 보고 변경을 따라가면 된다. 파일이 먼저라는 저장 기질과 같은 결이다.
임베딩을 일부러 뺀 이유
가장 눈에 띄는 설계 선택은 뺀 것이다. 임베딩과 벡터 검색을 설계상 회피했다. 이유는 간명하다. 소스 100여 개·수백 페이지 정도 규모까지는 목록 파일 하나로 충분하니, 굳이 벡터DB를 세워 유지할 이유가 없다는 것이다 — 원문의 취지를 옮기면 그렇다. 다만 Karpathy 자신도, 규모가 이보다 훨씬 커지면 그때는 제대로 된 검색을 얹으라고 덧붙인다.
이 방향은 우연이 아니다. Claude Code 같은 에이전트 도구도 벡터DB를 걷어내고 그때그때 파일을 뒤지는 에이전틱 검색으로 옮겨 갔다. 컨텍스트를 미리 채우지 않고 필요한 순간에 끌어오는 처방과 같은 지향이다.
연결: 같은 코퍼스에서 위키와 지식그래프가 갈라진다
여기까지가 위키 기질의 안쪽이다. 코퍼스 하나를 지식으로 바꾸는 형태는 위키만 있는 게 아니다.
두 기질과 양방향 변환
지식을 담는 형태는 크게 둘로 갈린다. 한쪽은 위키 — 산문 문서다. 사람이 읽기 좋고, 서사가 있고, 문서 단위로 감사할 수 있다. 다른 쪽은 지식그래프(KG) — 트리플이다. 주어·관계·목적어로 쪼갠 사실들의 그물로, 조인과 멀티홉 질의, 기계적 처리에 강하다.
예전엔 이 둘 사이를 사람이 손으로 오갔다. LLM이 등장하면서, 텍스트에서 그래프를 뽑고 그래프에서 다시 산문을 짓는 변환이 양방향으로 자동화됐다. 그리고 그 중간에는 둘을 섞은 형태도 있다 — Co-STORM의 동적 마인드맵이다. 발견한 정보를 개념 계층 그래프로 조직하되 착지는 산문으로 한다. 사용자가 미처 못 물어본 "모르는 줄도 모르는 것(unknown unknowns)"을 드러내는 게 목적이다.
그래프→산문: GraphRAG 커뮤니티 요약은 자동 생성된 위키 층이다
그림 4의 한 갈래, 그래프에서 산문으로 가는 길을 보자. Microsoft의 원조 GraphRAG(Edge et al.)가 전형이다. 먼저 텍스트를 청크로 잘라 청크마다 LLM으로 엔티티와 관계를 뽑아 그래프를 세운다. 그 그래프를 Leiden 알고리즘으로 커뮤니티(촘촘히 연결된 노드 덩어리)로 나눈 뒤, 커뮤니티마다 LLM에 요약을 시킨다. 질의가 오면 그 요약들을 map-reduce로 종합해 답한다(Global Search).
그래프의 한 덩어리를 사람이 읽을 산문으로 눌러 놓은 이 커뮤니티 요약들은, 사실상 "자동으로 생성된 위키 문서" 층이다. 대신 이 방식은 계보 중 가장 비싸다 — 청크마다, 또 커뮤니티마다 LLM을 부른다. 그래프 색인을 세우는 구조를 통째로 지불하는 셈이다.
텍스트→KG: AutoSchemaKG는 스키마 없이 뽑는다
반대 방향, 텍스트에서 그래프로 가는 길에서 최근 흥미로운 건 스키마를 다루는 태도다. 보통 KG를 구축하려면 어떤 엔티티와 관계를 뽑을지 미리 정한 스키마가 있어야 한다. HKUST의 AutoSchemaKG는 그 전제를 뒤집는다. 스키마를 미리 주지 않고, 트리플 추출과 스키마 유도를 동시에 한다. 뽑으면서 뽑을 틀을 스스로 만들어 가는 것이다.
규모가 크다. 약 5천만 문서에서 9억 개가 넘는 노드와 59억 개의 엣지를 뽑았다. 다만 함께 나오는 트리플 정밀도(엔티티-엔티티 트리플 기준) 95.65~99.13%라는 숫자는 LLM 자기채점 값이라 조심해서 읽어야 한다.
KG를 자동으로 구축할 때 봉합되지 않은 상처가 하나 있다. 엔티티 해소(entity resolution) — 같은 실체가 다른 표기로 등장할 때 이를 하나로 병합하는 문제다. "Microsoft"와 "MSFT"가 별개 노드로 남으면 그래프는 두 회사를 아는 것처럼 부풀지만 실은 하나를 두 번 센 것이다. AutoSchemaKG 본문에는 이 문제에 대한 논의가 사실상 없다. KG를 얹기로 했다면, 자동 구축이 이 병합을 알아서 해 주리라 기대하지 말 것. 별도의 교차 문서 상호참조 해소가 따라와야 한다.
비용은 없앤 게 아니라 옮겼다 — 변종 계보
원조 GraphRAG가 비싸다는 게 알려지자, 그 비용을 깎으려는 변종이 쏟아졌다. 계보를 훑으면 하나의 패턴이 보인다. 비용을 없앤 게 아니라 어디론가 옮겼다는 것. (아래 수치는 모두 저자 자가평가 또는 벤더 자가보고임을 전제로 읽는다.)
- LazyGraphRAG는 인덱싱을 명사구 공기(共起) 추출만으로 끝내고, 무거운 LLM 그래프 추출을 질의 시점으로 미룬다. 인덱싱 비용이 원조 대비 0.1%까지 내려간다는 게 Microsoft의 자가보고다. 없앤 게 아니라 질의 때로 이연한 것이다.
- NodeRAG는 노드를 일곱 종류로 이종화하고 얕은 Personalized PageRank로 탐색한다. MuSiQue에서 46.29% 정확도에 출력 토큰 5.9k로, GraphRAG(41.71%·6.6k)와 LightRAG(36.0%·7.4k)보다 더 정확하면서 토큰은 덜 쓴다고 저자는 보고한다. 인덱싱도 25분으로 76분·90분보다 짧다.
- HippoRAG 2는 KG 위의 PageRank를 아예 연상기억으로 쓴다. 사람 해마의 인덱싱을 은유 삼아, 연상기억 과제에서 SOTA 임베딩 대비 +7%를 저자는 보고한다. "그래프 = 기억" 프레임의 대표 격이다.
- LinearRAG는 극단으로 간다. 관계 추출을 아예 버린다(relation-free). 인덱싱이 선형으로 끝나고 추가 토큰이 0이지만, 잃는 것도 분명하다 — 타입이 붙은 관계와 롱테일 경로를 포기한다.
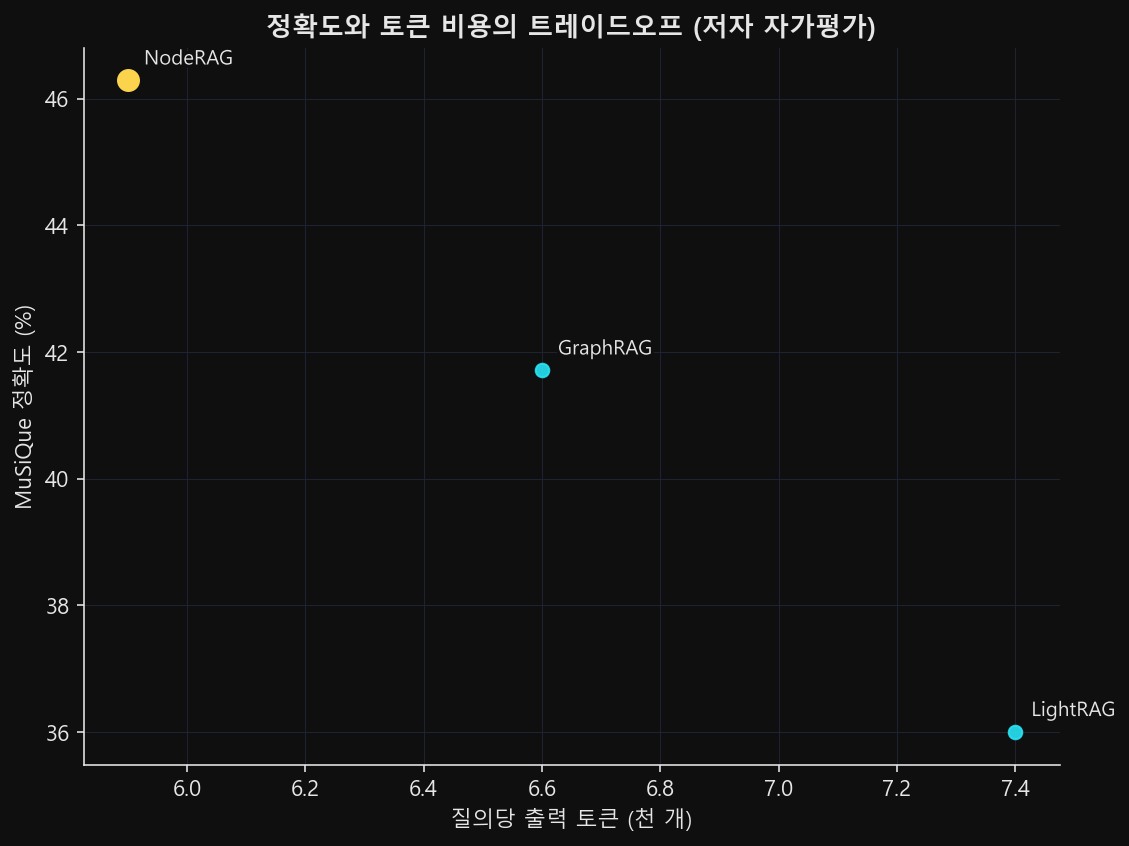
그림 5에서 점들이 좌상단과 우하단으로 흩어지는 모양이 이 계보의 요지다. 인덱싱에서 깎으면 질의에서 물고, 관계를 버리면 멀티홉을 잃는다.
트레이드오프 축 — 사전 증류 비용과 질의 시점 비용
그러면 변종들이 공유하는 축이 드러난다. 지금 눌러 담을 것인가(사전 증류), 질의할 때 다시 조립할 것인가(질의 시점). 원조 GraphRAG는 앞쪽 끝이다 — 인덱싱에 다 지불하고 질의를 싸게 만든다. LazyGraphRAG는 뒤쪽으로 옮겨 인덱싱을 비우고 질의를 무겁게 한다.
위키 기질도 정확히 같은 축 위에 있다. 이해를 지금 문서로 눌러 담는 것은 사전 증류 쪽, RAG처럼 질의 때마다 조립하는 것은 반대쪽 끝이다. 위키냐 그래프냐를 따지기 전에, 사실은 모두 이 한 축 위에서 어디에 설지를 고르고 있었던 셈이다.
어느 쪽이 이기는 게 아니라 역할이 다르다
그래서 어느 기질이 이기는가. 이 물음 자체가 틀을 잘못 잡은 것이다. KG는 기계적 멀티홉 질의에 강하다. 여러 사실을 관계로 이어 "A와 B를 매개하는 C는?"을 조인으로 푼다. 대신 자동 구축의 엔티티 해소가 미봉합이고, 품질 수치는 대개 자기채점이다.
위키는 반대다. 문서 단위 큐레이션이 그 파편화를 사람이 감사할 수 있는 단위로 우회한다 — 한 문서를 열어 통째로 검수하면 된다. 관계가 산문에 녹아 있어 기계적 멀티홉은 약하다. 둘은 겨루는 사이가 아니라 다른 일을 맡는 사이다. 그러면 실무 순서가 나온다.
중간 규모 지식층은 위키(파일 + 인덱스)로 시작하라. 문서와 index.md·log.md만으로 대부분의 조회와 감사가 된다. 벡터DB도, KG도 처음부터 세울 필요가 없다. 그러다 여러 사실을 관계로 이어야 답이 나오는 관계 질의가 진짜 병목이 됐을 때, 그때 KG를 위에 얹는다. 순서를 거꾸로 밟으면, 필요하지도 않은 그래프를 유지하는 비용만 먼저 문다.
지식층을 설계할 때 ‘무엇으로 찾을까(검색)’보다 먼저 ‘어디에 쌓을까(축적)’를 묻게 된다.
이 순서는 던지는 질문 자체를 바꾼다. 찾는 기술을 고르기 전에, 이해를 어디에 눌러 담을지부터 정하는 것. 그게 위키 기질이 남긴 가장 실용적인 물음이다.
남은 벽 하나만 예고해 둔다 — "인용이 붙어 있다"와 "인용이 그 주장을 실제로 확인해 준다"는 전혀 다른 말이고, 자동 집필의 다음 관문인 이 검증은 후속편에서 따로 해부한다.
더 읽기
- Shao et al., STORM (NAACL 2024) — https://arxiv.org/abs/2402.14207
- Jiang et al., Co-STORM (EMNLP 2024) — https://arxiv.org/abs/2408.15232
- Bai et al., AutoSchemaKG (HKUST) — https://arxiv.org/abs/2505.23628
- Edge et al., Microsoft GraphRAG — https://arxiv.org/abs/2404.16130
- Anthropic, "Effective context engineering for AI agents" — https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- 관련 글: 지식그래프란 무엇인가 — 이 글이 지식층의 재료로 삼는 지식그래프를 입문 눈높이로 푼 편(같은 GraphRAG 논문에 기댄다).