RAG(retrieval-augmented generation, 검색 증강 생성)는 모델이 학습 때 외운 것만으로 답하지 않고, 답을 만들기 전에 바깥 문서에서 관련 대목을 찾아와 프롬프트에 붙이는 방법이다. 학습된 기억 옆에 검색할 수 있는 문서 뭉치를 두 번째 기억으로 두는 것이다. 그래서 문서 뭉치를 갈아 끼우면 다시 학습하지 않고도 모델이 아는 것이 바뀌고, 답 옆에 어느 문서에서 왔는지를 붙일 수 있다.
RAG 가 생긴 이유 — 학습이 끝난 뒤의 일
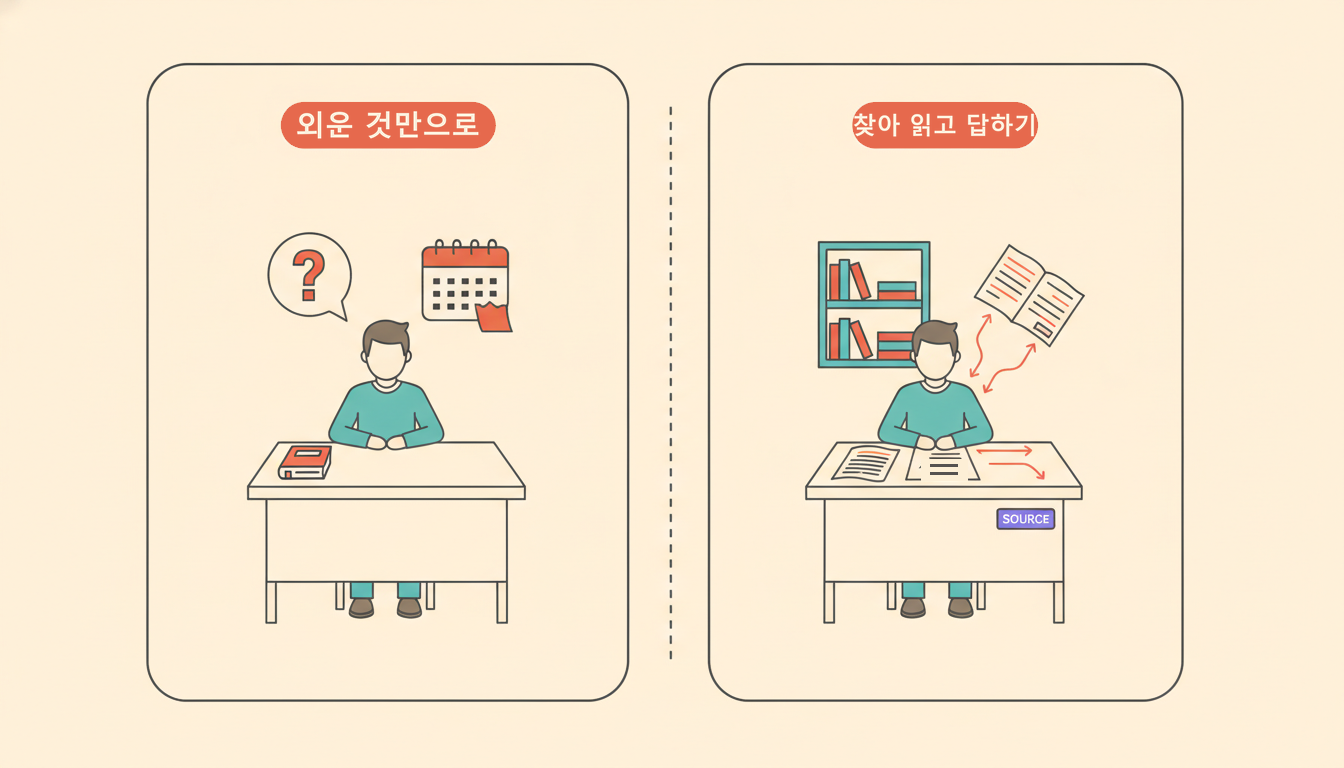
이번 달에 바뀐 사내 규정을 챗봇에 묻는다. 모델은 학습이 끝난 뒤에 일어난 일도, 회사 안에서만 도는 문서도 알지 못한다. 그런데도 답은 나오고, 망설임도 없다.
AWS 의 설명 글은 이 상태를 새로 들어온 직원에 빗댄다. 바깥 소식은 챙기려 들지 않으면서 무엇을 물어도 확신에 차서 답하는 사람이라는 것이다. 같은 글은 학습 데이터가 고정돼 있어서 모델이 아는 것에 컷오프가 생긴다고 적는다.
맨 앞 그림 왼쪽 패널의 책은 덮여 있다. 옆의 달력은 찢겨 있고, 머리 위에는 물음표 하나가 떠 있다. 모르는 것이 있다는 신호는 그 물음표뿐이고, 답은 어쨌든 나온다.
답부터 말하면 이렇다. RAG(retrieval-augmented generation, 검색 증강 생성)는 답을 만들기 전에 바깥 자료에서 관련 대목을 찾아와 프롬프트에 붙여 주는 방법이다. AWS 의 글은 이것을 답을 만들기 전에 학습 데이터 바깥의 믿을 만한 지식 베이스를 참조하도록 LLM 의 출력을 다듬는 과정이라고 적는다. 그림 오른쪽에서 달라진 곳이 딱 그만큼이다. 책장 옆 공중에는 펼친 책 한 권이 떠 있고, 그 책과 책상 사이를 화살표가 오가며, 책상 앞면에는 어디서 가져왔는지 적은 꼬리표가 붙었다. 사람도 머릿속도 그대로다.
이 방법에 이름을 붙인 것은 2020 년 논문이다. 제목은 「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」다. Lewis 외 연구자들이 Facebook AI Research 와 UCL·NYU 에서 함께 냈고, NeurIPS 2020 에 실렸다.
논문은 지식을 파라미터 안에만 담아 둔 그때까지의 모델에 약점 셋이 있다고 든다. 기억을 넓히거나 고치기가 쉽지 않고, 왜 그렇게 답했는지를 들여다볼 길도 마땅치 않다는 것이다. 세 번째는 논문이 따옴표를 친 채로 쓴 "환각"이다.
해법은 기억을 둘로 나누는 것이었다. 논문의 초록이 그 나눔을 이렇게 적는다.
We explore a general-purpose fine-tuning recipe for retrieval-augmented generation (RAG) — models which combine pre-trained parametric and non-parametric memory for language generation. 미리 학습한 파라메트릭 기억과 논파라메트릭 기억을 함께 쓰는 언어 생성 모델, 곧 검색 증강 생성(RAG)을 위한 범용 미세조정(fine-tuning) 방법을 살펴본다.
출처: Lewis 외, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks미세조정은 이미 학습을 마친 모델에 자료를 더 주어 추가로 학습시키는 일을 말한다. 이 문장에서 오래 볼 곳은 그 뒤다. 파라메트릭 기억과 논파라메트릭 기억이라는 두 이름이 나란히 붙어 있다.
두 기억이 무엇인지는 같은 팀이 쓴 소개 글이 짧게 적어 둔다. 하나는 모델이 자기 파라미터, 그러니까 학습으로 값이 정해지는 모델 내부의 수많은 숫자 안에 담아 둔 지식이다. 이것을 파라메트릭 기억(parametric memory)이라 부른다. 다른 하나는 RAG 가 대목을 꺼내 오는 문서 뭉치 안에 있는 지식이고, 이것이 논파라메트릭 기억(nonparametric memory)이다. 소개 글은 입력을 곧장 생성 모델에 넘기는 대신, 그 입력으로 관련 문서를 먼저 찾아 원래 입력에 이어 붙인다고 적는다. 맨 앞 그림의 닫힌 책과 펼친 책이라는 구도도 이 소개 글의 절 제목에서 가져왔다.
기억을 이렇게 갈라 두면 뒤쪽만 따로 손댈 수 있다. 논문은 꺼내 오는 쪽의 인덱스를 통째로 갈아 끼울 수 있다고 적고, 파라미터에만 지식을 담은 모델은 세상이 바뀌면 다시 학습을 시켜야 한다고 견준다. 소개 글의 문장이 더 짧다.
With RAG, we control what it knows simply by swapping out the documents it uses for knowledge retrieval. RAG 에서는 지식을 꺼내 올 때 쓰는 문서를 갈아 끼우는 것만으로 모델이 아는 것을 조절한다.
출처: Meta AI, Retrieval Augmented Generation 소개 글소개 글은 실제로 그렇게 해 봤다고 적는다. 쓰던 위키백과 자료를 더 오래된 판으로 바꿔 놓고 아이슬란드 총리가 누구인지 같은 것을 물었더니, 파라미터 쪽 지식은 그대로인데 답이 바꿔 끼운 자료를 따라갔다는 것이다. 모델은 손대지 않았고, 바뀐 것은 읽히는 자료뿐이다.
"환각"이라는 낱말은 이 편이 읽은 문서 아홉 곳에서 고르게 쓰이지 않는다. 논문은 서론과 마지막 절에서 그 낱말에 따옴표를 치고, 실험 절에서는 정성적으로 보았을 때 RAG 모델이 환각을 덜 한다고 적는다. 벤더 문서 가운데 그 낱말을 쓰는 곳은 Google 하나다. AWS 는 답을 모를 때 틀린 정보를 내놓는다고만 적고, Anthropic·OpenAI·Microsoft 의 문서에는 그 낱말이 나오지 않는다. 그래서 이 편은 RAG 를 환각을 막는 장치라고 단정하지 않는다.
색인이 만들어 두는 네 층
읽힐 자료를 갈아 끼우면 답이 바뀐다는 말은, 읽을 자료가 미리 정리돼 있다는 뜻이기도 하다. 그 정리, 곧 색인은 질문이 오기 전에 끝나 있어야 한다. 네 칸을 위에서 아래로 내려가며 만든다.
그림 1의 맨 위는 문서 뭉치다. Anthropic 의 글은 이 문서 더미를 지식 베이스라 부른다. 사내 위키일 수도 있고 제품 설명서 묶음일 수도 있는데, 여기까지는 아직 글일 뿐이다.
둘째 칸에서 그 글이 잘리고, 조각 하나를 청크(chunk)라 부른다. 크기는 문서마다 다르게 적어 둔다. Anthropic 의 글은 대개 수백 토큰을 넘지 않는 조각으로 자른다고 적는다. OpenAI 의 Retrieval 가이드는 기본값을 800 토큰짜리 조각으로 두고, 잇따른 조각끼리 400 토큰을 겹친다고 적는다.
셋째 칸이 이 편에서 새로 익힐 하나다. 각 청크를 숫자 목록으로 바꾸는데, 그 목록을 임베딩(embedding)이라 부른다. OpenAI 의 임베딩 가이드는 임베딩이 실수의 벡터, 곧 목록이며 두 벡터 사이의 거리가 둘의 관련도를 잰다고 적는다. 거리가 가까우면 관련이 높고, 멀면 낮다는 것이다.
Google 은 같은 것을 낱말이나 글의 뜻과 맥락을 담은 숫자 표현이라 적으면서, 비슷하거나 관련 있는 것끼리 고차원 벡터 공간에서 더 가까이 모인다고 덧붙인다. Claude 문서도 임베딩을 뜻의 비슷함을 잴 수 있게 해 주는 숫자 표현이라고 적는다. 글의 뜻이 위치가 되는 셈이다.
맨 아래 칸은 그 목록들을 넣어 두는 곳이다. 부르는 이름은 문서마다 갈린다. Anthropic 은 뜻의 비슷함으로 검색하게 해 주는 벡터 데이터베이스라 적고, OpenAI 는 같은 것을 vector store 라 부른다. 그 문서는 파일만 넣으면 잘리고 임베딩되고 색인된다고 덧붙인다. Google 은 만들어지는 색인을 corpus 라 부르고, 거대한 참고서의 자세한 목차에 견준다. 이 편에서는 셋을 묶어 벡터 저장소라 적는다.
네 칸이 서면 꺼내 오는 쪽이 필요하다. 질문을 같은 방식으로 임베딩해 가장 가까운 청크를 찾아오는 부품을 검색기(retriever)라 부른다. 논문이 쓴 검색기의 이름은 DPR(Dense Passage Retriever)이다. 답을 쓰는 쪽은 LLM 이다. 문서들은 그 자리를 생성기(generator)라 부른다.
꺼내 온 것을 붙여 넣을 자리에도 이름이 있다. 모델이 한 번에 읽는 입력 길이를 컨텍스트 창(context window)이라 한다. OpenAI 의 임베딩 가이드는 필요한 정보를 이 창에 넣는 방법이 여러 경우에 잘 듣지만 토큰 비용이 올라간다고 적는다.
뜻으로 찾는다는 말은 OpenAI 문서의 예가 그대로 보여 준다. 문서가 든 질문은 "When did we go to the moon?" 이다. 가장 위로 올라온 문장은 "The first lunar landing occurred in July of 1969." 였다. 문서는 그 문장에 질문의 낱말이 하나도 들어 있지 않다는 점을 짚는다. 낱말이 겹쳐야 걸리는 검색이었다면 이 문장은 나오지 않는다.
한 번 오갈 때 — 질문 시점의 순서
여기까지가 질문이 오기 전에 끝나 있는 일이다. 질문이 들어오면 그 위에서 다섯 단계가 지나간다.
- 사용자가 질문을 넣는다.
- 그 질문을 청크와 같은 방식으로 임베딩해 숫자 목록으로 바꾼다.
- 벡터 저장소에서 뜻이 가장 가까운 청크를 상위 k 개, 곧 미리 정해 둔 개수만큼 찾는다.
- 찾아온 청크를 원래 질문과 함께 프롬프트에 붙인다.
- LLM 이 그 프롬프트를 읽고 답을 쓴다. 답에는 어느 자료에서 왔는지를 함께 붙일 수 있다.
그림 2의 가운데 레인이 둘째·셋째 단계를 맡는다. AWS 는 사용자 질문이 벡터 표현으로 바뀌어 벡터 데이터베이스와 맞춰진다고 적고, 그렇게 찾아온 자료를 사용자 입력에 덧붙이는 것을 프롬프트 증강이라는 이름의 단계로 따로 세워 둔다. Anthropic 의 글도 실행 시점을 같은 순서로 적는다. 사용자가 질문을 넣으면 벡터 데이터베이스가 뜻의 비슷함으로 가장 관련 있는 청크를 찾고, 그 청크들이 생성 모델에 보내는 프롬프트에 더해진다는 것이다.
셋째 단계의 k 는 고정된 수가 아니다. 논문은 꺼내 올 문서의 개수를 시험 시점에 조절할 수 있고, 그에 따라 성능과 실행 시간이 달라진다고 적는다. Anthropic 의 글은 같은 수를 반대쪽에서 본다. 청크를 더 넣을수록 필요한 정보가 들어 있을 확률은 오르지만, 정보가 많으면 모델이 산만해질 수 있어서 한계가 있다는 것이다. 그래서 상위 k 는 정답이 정해진 값이 아니라 그때그때 정하는 수다.
마지막 단계에서는 논문과 벤더 문서 둘이 같은 낱말을 쓴다. Google 은 꺼내 온 정보가 원래 질문에 덧붙는 맥락이 되어 모델이 사실에 근거한 답을 내게 한다고 적는다(factually grounded). OpenAI 는 검색 결과와 원래 질문을 함께 주면 근거를 둔 답을 받는다고 적는다(grounded response). 겹치는 낱말은 grounded 하나다. 논문도 끝의 Broader Impact 절에서 RAG 가 실제 사실 지식에 더 강하게 근거를 둔다고 썼다. 답이 찾아온 자료에 발을 붙이게 한다는 이 말을 그라운딩(grounding)이라 부른다.
네 회사가 같은 것을 부르는 이름
순서는 어느 문서를 펴도 같다. 달라지는 것은 그 순서를 부르는 이름이다.
그림 3의 첫째 칸부터 보면 이름이 없다. OpenAI 의 두 가이드에는 RAG 라는 낱말이 한 번도 나오지 않는다. 대신 Retrieval API 와 semantic search 로 말한다. 문서는 이 API 가 내 데이터를 뜻으로 검색하게 해 준다고 적는다. 낱말이 거의 또는 전혀 겹치지 않는 결과까지 끌어올리고, 그 자체로도 쓸 만하지만 모델과 함께 써서 답을 짓게 할 때 특히 힘을 낸다는 것이다. 저장소를 부르는 이름은 vector store 다.
둘째 칸은 이름을 그대로 쓴다. Anthropic 의 글은 RAG 를 지식 베이스에서 관련 정보를 꺼내 사용자의 프롬프트에 붙여 모델의 답을 크게 끌어올리는 방법이라고 정의한다. 같은 글에는 안 써도 되는 경계도 적혀 있다. 지식 베이스가 20만 토큰, 자료로 치면 500쪽쯤보다 작으면 통째로 프롬프트에 넣으면 되고 RAG 같은 방법이 필요 없다는 것이다. 그 글이 쓰인 시점의 수치이고, 컨텍스트 창의 길이는 모델마다 다르다.
그 글이 정작 길게 다루는 것은 그 다음이다. 문서를 작은 조각으로 자르면 조각 하나가 문맥을 잃는다. 글이 든 예는 "The company’s revenue grew by 3% over the previous quarter." 라는 조각이다. 이 조각만 보면 어느 회사인지도 어느 분기인지도 알 수 없다.
임베딩이 놓치는 것도 있다. 뜻은 잘 잡지만 정확히 맞아야 하는 문자열은 지나칠 수 있다. 그래서 "Error code TS-999" 같은 것에는 낱말을 그대로 맞춰 순위를 매기는 BM25(Best Matching 25)를 곁들인다고 적는다.
셋째 칸은 제품 이름이다. Google 의 RAG Engine 이고, 문서는 LLM 이 조직 안의 사적 지식을 모른다는 것을 흔한 문제로 든다. 그 맥락을 사적 정보로 채워 주면 모델이 환각을 줄이고 더 정확하게 답할 수 있다는 것이다. 앞의 노트에서 본 대로, 환각이라는 낱말을 쓰는 벤더 문서는 하나다.
넷째 칸은 우리가 지금까지 본 것에 따로 이름을 붙인다. Microsoft 는 벡터 유사도를 검색 기법으로 쓰는 대부분의 RAG 를 Baseline RAG 라 부르고, 그것을 표준적인 상위 k 벡터 검색이라고 적는다. 그 문서가 곧바로 잇는 말은 한계다. Baseline RAG 는 점들을 잇는 데 약하다는 것이다. 흩어진 조각을 이어야 답이 되는 질문을 두고 하는 말이고, 지식그래프 편에서 본 GraphRAG 가 그 자리를 겨냥한다. 다만 그쪽도 입력 문서로 만든 지식그래프와 요약을 질문 시점에 프롬프트를 늘리는 데 쓴다고 같은 문서가 적는다.
네 문서를 한 표에 놓으면 이렇다.
| 문서 | 이 절차를 부르는 이름 | 저장소를 부르는 이름 | 그 문서가 앞세우는 것 |
|---|---|---|---|
| OpenAI | Retrieval API · semantic search | vector store | 파일을 넣으면 자르기·임베딩·색인이 자동으로 된다 |
| Anthropic | RAG | vector database | 자료가 작으면 안 써도 되고, 청크는 문맥을 잃는다 |
| RAG Engine | corpus | 조직 안의 사적 지식을 채워 환각을 줄인다 | |
| Microsoft | Baseline RAG | — | 표준적인 상위 k 벡터 검색이며 점을 잇는 데 약하다 |
이름은 넷인데 순서는 하나다. 문서를 자르고, 숫자로 바꾸고, 저장해 두고, 질문이 오면 가까운 것을 꺼내 프롬프트에 붙인다. 새 문서를 펼 때 이름을 먼저 외우는 대신, 이 순서의 어디를 말하고 있는지를 찾으면 된다.
얻는 것과 치르는 것
지금까지 나온 것을 한자리에 모으면 얻는 것과 치르는 것이 함께 보인다. 어느 쪽도 이 편이 매긴 점수가 아니라 문서에 그렇게 적혀 있는 것이라, 괄호 안에 어느 문서인지를 남겼다.
| 얻는 것 | 치르는 것 |
|---|---|
| 다시 학습하지 않고 문서만 갈아 끼워 아는 것을 바꾼다 (논문·Meta 소개 글·AWS) | 자료가 컨텍스트 창에 다 들어가면 쓸 이유가 없다 (Anthropic) |
| 답 옆에 어느 자료에서 왔는지를 붙일 수 있다 (논문·AWS) | 조각으로 자르면서 조각이 문맥을 잃는다 (Anthropic) |
| 학습에 없던 사적 자료를 읽힌다 (Google·Microsoft·OpenAI) | 흩어진 조각을 이어야 하는 질문에 약하다 (Microsoft) |
| 질문의 낱말이 없어도 뜻으로 찾는다 (OpenAI) | 정확히 맞아야 하는 문자열을 놓친다 (Anthropic) |
| — | 청크를 더 넣으면 산만해진다 (Anthropic) |
왼쪽과 오른쪽이 한 줄로 맞물리는 곳은 넷째 줄뿐이다. 낱말이 겹치지 않아도 뜻으로 찾아내는 능력과, 정확히 맞아야 하는 문자열을 놓치는 약점은 같은 성질의 앞뒤다. 나머지 줄끼리는 짝이 아니고, 서로 다른 문서가 적어 둔 말이 같은 표에 모인 것이다.
오른쪽 다섯 줄은 Anthropic 과 Microsoft 두 글에서 왔다. 둘 다 그 한계를 메우는 다음 방법을 소개하는 글이다. 그 방법은 Anthropic 에서는 Contextual Retrieval 이고, Microsoft 에서는 GraphRAG 다. 그래서 보통 RAG 의 약점을 먼저 적는다. 얻는 것 쪽은 논문과 소개 글, 그리고 AWS·Google·Microsoft·OpenAI 에 흩어져 있다.
이제 이 말은 안다
- RAG 는 답을 만들기 전에 바깥 문서에서 관련 대목을 찾아와 프롬프트에 붙이는 방법이다.
- 기억이 둘이다. 학습으로 파라미터에 들어간 파라메트릭 기억과, 검색해 꺼내 오는 문서 뭉치인 논파라메트릭 기억이고, 뒤쪽은 갈아 끼울 수 있다.
- 질문이 오기 전에 네 층을 쌓아 둔다. 문서 뭉치, 청크, 임베딩, 벡터 저장소다. 질문이 오면 다섯 단계가 지나간다. 질문, 질문을 임베딩, 상위 k 검색, 프롬프트에 붙이기, 답과 출처다.
- 같은 순서를 문서마다 다른 이름으로 부른다. Retrieval 과 semantic search, RAG, RAG Engine, Baseline RAG 다.
오늘 새로 붙인 이름 여덟 개는 아래 표다.
| 용어 | 한 줄 뜻 | 그림 어디에 |
|---|---|---|
| 파라메트릭 기억 / 논파라메트릭 기억 | 학습으로 파라미터에 들어간 지식 / 검색해 꺼내 오는 문서 뭉치에 있는 지식 | 히어로 왼쪽 패널의 덮인 책 · 오른쪽 패널의 펼친 종이 |
| 청크(chunk) | 문서를 수백 토큰 단위로 자른 조각 | 네 층 그림 둘째 칸 |
| 임베딩(embedding) | 글의 뜻을 실수 목록으로 적은 것. 가까우면 뜻이 비슷하다 | 네 층 그림 셋째 칸(강조된 칸) |
| 벡터 저장소 | 임베딩을 넣어 두고 가까운 것을 찾게 해 주는 곳 | 네 층 그림 맨 아래 칸 |
| 검색기(retriever) | 질문을 같은 방식으로 임베딩해 가장 가까운 청크를 꺼내 오는 부품 | 다섯 단계 그림 가운데 레인 |
| 상위 k | 질문마다 청크를 몇 개 꺼낼지 정하는 수 | 다섯 단계 그림 셋째 단계 |
| 컨텍스트 창(context window) | 모델이 한 번에 읽는 입력 길이 | 다섯 단계 그림 넷째 단계 |
| 그라운딩(grounding) | 답이 찾아온 자료에 발을 붙이게 두는 것 | 다섯 단계 그림 다섯째 단계 |
더 읽기
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — Lewis 외, arXiv:2005.11401 v4(2021-04-12), NeurIPS 2020. 이름의 출처, 두 기억의 정의, 약점 셋, 인덱스 갈아 끼우기, 백 단어 청크와 상위 k.
- Retrieval Augmented Generation: Streamlining the creation of intelligent natural language processing models — Meta AI(2020-09-28). 파라메트릭·논파라메트릭 기억의 평이한 정의, 문서를 입력에 이어 붙인다는 설명, 자료를 바꿔 끼운 실험, 닫힌 책과 펼친 책 비유.
- Introducing Contextual Retrieval — Anthropic(2024-09-19). RAG 정의와 실행 순서, 20만 토큰 경계, 청크의 문맥 소실, BM25, 청크 수의 한계.
- Retrieval — OpenAI 공식 가이드(2026-09-12 열람). semantic search, vector store, 청크 기본값, 검색 결과로 답을 짓는 단계.
- Embeddings — OpenAI 공식 가이드(2026-09-12 열람). 임베딩 정의와 거리의 뜻, 달 착륙 검색 예, 컨텍스트 창과 토큰 비용.
- RAG Engine on Gemini Enterprise Agent Platform overview — Google Cloud(최종 갱신 2026-09-03). 여섯 단계 이름, corpus 라는 색인 이름, 목차 비유, 사적 지식과 환각 문장.
- Welcome to GraphRAG — Microsoft(2026-09-12 열람). Baseline RAG 라는 이름과 상위 k 벡터 검색, 점을 잇지 못한다는 한계.
- What is RAG (Retrieval-Augmented Generation)? — AWS(2026-09-12 열람). 정의 문장, 학습 컷오프, 네 단계 이름, 출처 표시, 신입사원 비유.
- Embeddings — Anthropic 공식 문서(2026-09-12 열람). 임베딩을 뜻의 비슷함을 재는 숫자 표현으로 적은 정의.