구글 휴대폰 키보드 지보드의 이모지 추천 모델은 보정 전에는 「잠들어 버려서 미안해」라는 영어 문장 뒤에도 웃다 우는 얼굴 😂를 첫자리에 올렸다. 가장 그럴듯한 이모지를 고르게 하면 원래 가장 많이 쓰이는 이모지가 거의 늘 이긴다는 것이 2019년 지보드 논문의 진단이다. 처방은 흔한 이모지일수록 점수를 큰 수로 나누는 것이었다. 그러자 논문의 예시 여섯 문장 중 다섯에서 첫자리가 다른 이모지로 바뀌었다. 흔한 것이 문장을 누르는 이런 쏠림에는 인기 편향(popularity bias)이라는 이름이 붙어 있다.
사과하는 문장에 뜬 웃다 우는 얼굴
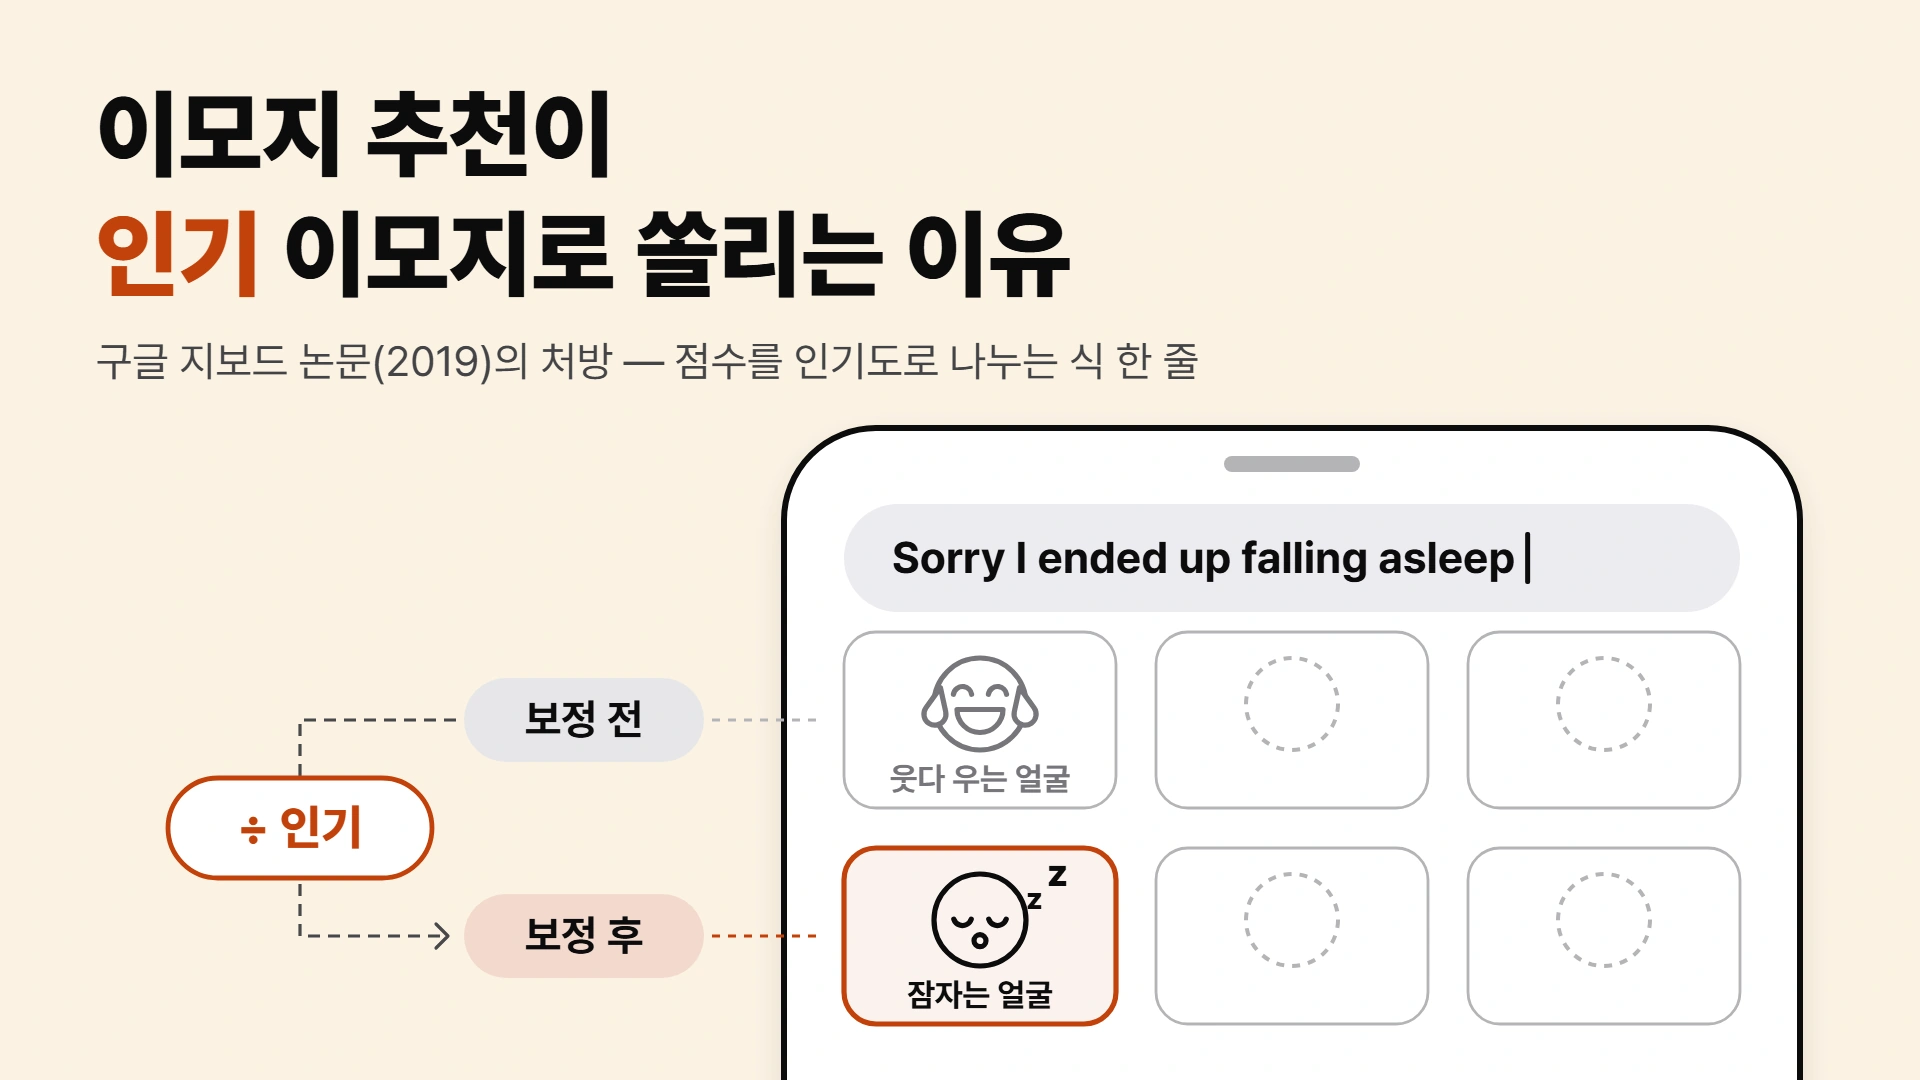
가장 그럴듯한 이모지를 고르도록 만든 추천 모델이, 사과하는 문장 뒤에 웃음을 권했다. 구글이 만든 휴대폰 키보드 지보드(Gboard)의 2019년 영어(미국) 이모지 추천 모델 이야기다. 여기에 「Sorry I ended up falling asleep」(잠들어 버려서 미안해)을 넣자, 보정을 끈 모델은 첫자리에 😂를 냈다. 이 글에서는 이 이모지를 웃다 우는 얼굴이라고 부른다. 같은 모델에 보정 하나를 켜자 첫자리는 잠자는 얼굴 😴로 바뀌었다. 잠들어 버렸다는 사과라면 잠자는 얼굴 쪽이 문장 내용에 훨씬 잘 맞는다.
지보드는 논문이 나온 2019년에 설치 수가 10억 회를 넘었다. 이런 키보드는 글자를 치는 동안 자판 위 한 줄에 다음에 올 만한 낱말이나 이모지를 띄우고, 사용자가 그중 하나를 누르면 그대로 입력된다. 위 장면은 구글 연구진 네 명이 그해 arXiv(논문을 심사 전에 올려 두는 공개 저장소)에 공개한 논문의 표 1 에 실린 예시다. 논문의 큰 주제는 연합 학습(federated learning)이다. 사용자가 친 문장을 서버로 모으지 않고 각자의 휴대폰 안에서 모델을 학습시키는 방식이다. 이 글은 그 가운데 한 절, 이모지 추천이 왜 한 얼굴로 쏠렸고 어떻게 고쳤는지만 본다.
문장을 읽고 고르는 모델이 왜 사과에 웃음을 권했을까? 모델이 문장을 못 읽었다고 보기는 어렵다. 모델은 그대로 두고 출력에 계산 하나를 덧댔을 뿐인데 잠자는 얼굴이 나왔기 때문이다. 문장은 읽혔는데 첫자리는 다른 이유로 정해졌다는 이야기다. 그러니 물을 것은 첫자리를 무엇이 정했느냐다. 가장 그럴듯한 답이 꼭 문장에 맞는 답은 아니었다는 뜻이다.
키보드 이모지 추천 모델이 😂를 먼저 고른 이유
이모지 추천 모델은 사용자가 친 문장을 보고, 그 뒤에 어떤 이모지가 올지를 확률로 매긴다. 논문의 모델은 이모지 100개 각각에 확률을 매기고, 가장 높은 것을 첫자리에 놓는다. 보정이 없으면 이 확률의 순서가 곧 추천 순서다. 앞에서 말한 「가장 그럴듯한 이모지」란 이 확률이 가장 높은 이모지라는 뜻이다. 모델이 할 일은 다음에 올 이모지를 잘 맞히는 것이고, 확률이 높은 것부터 내미는 것은 그 일에 충실한 방법이다.
이 확률 하나에는 두 가지가 섞여 있다. 하나는 이 문장과 이 이모지가 얼마나 맞는가이고, 다른 하나는 이 이모지가 원래 얼마나 많이 쓰이는가다. 모델은 사람들이 실제로 친 문장과 이모지로 배우므로, 학습 자료에 자주 나온 이모지는 그만큼 자주 정답이었다. 그래서 문장이 뚜렷한 단서를 주지 않으면 모델은 흔한 이모지에 높은 확률을 준다.
가령 문장이 「ok」 한 단어뿐이라고 해 보자. 그 뒤에는 어떤 이모지든 올 수 있으니, 가장 자주 본 이모지를 고르는 편이 그나마 잘 맞는다. 문제는 문장이 단서를 줄 때에도 이 몫이 사라지지 않는다는 데 있다. 사과하는 문장이 잠자는 얼굴 쪽으로 확률을 조금 올려도, 흔한 이모지가 원래 가진 몫이 더 크면 첫자리는 흔한 이모지에게 남는다.
얼마나 쏠렸는지는 논문 그림 3 에 있다. 영어(미국)에서 가장 많이 쓰인 이모지 15개의 비율을 그린 막대그래프다. 1위 😂가 약 16% 로, 2위 뽀뽀하는 얼굴 😘(약 8%)의 두 배쯤이다. 3·4위도 8% 가까이라 2위와 거의 붙어 있고, 15위 😜는 약 1% 로 1위와 16배쯤 차이가 난다. 영어(미국) 한 곳의 집계이니, 다른 언어나 지역에서도 순서가 같다는 뜻은 아니다.
이 그림에서 눈여겨볼 것은 1위 하나가 2위의 두 배라는 차이다. 이 차이가 확률에 얹히면, 문장이 웬만큼 다른 쪽을 가리켜도 😂가 앞설 수 있다. 저자들은 이 쏠림이 모델의 예측에 어떻게 번졌는지를 이렇게 적었다.
The distribution of emoji usage frequency is very light-tailed as seen in Figure 3. As a result, the top predictions from the model are almost always the most frequent emoji regardless of the input context.
그림 3 에서 보듯 이모지 사용 빈도는 몇 개에 크게 몰려 있다. 그 결과 모델의 최상위 예측은 입력 문맥과 상관없이 거의 늘 가장 자주 쓰이는 이모지다.
Ramaswamy 외, 「Federated Learning for Emoji Prediction in a Mobile Keyboard」(2019), §3.4「거의 늘」이 몇 퍼센트인지는 논문에 없다. 저자들이 원인으로 짚은 것은 사용 빈도의 쏠림이고, 처방도 그 자리를 겨냥했다. 점수를 그 이모지가 원래 쓰인 비율로 한 번 나누는 것이다. 흔한 이모지일수록 큰 수로 나뉘니, 인기에서 얻던 이점이 깎인다. 그 결과를 담은 논문 표 1 의 첫 줄이 앞에서 본 사과 문장이다.
| 문장(원문 영어) | 보정 전 | 보정 후 | 뜻(우리 번역) |
|---|---|---|---|
| Sorry I ended up falling asleep | 😂 | 😴 | 잠들어 버려서 미안해 |
| Good morning sunshine | 😘 | 🌞 | 좋은 아침, 햇살 같은 사람 |
| Coz I miss you xx | 😘 | 😘 | 보고 싶으니까(xx 는 뽀뽀 표시) |
| I’m so sorry sweetie | 😔 | 💔 | 정말 미안해, 자기야 |
| Hey girl you take it easy | 😂 | 😉 | 얘, 무리하지 말고 쉬어 |
| not sure what happened to that | 😂 | 😕 | 그게 어떻게 된 건지 모르겠어 |
보정 후 칸은 깎는 세기를 0.7 로 둔 칸이다(세기는 다음 절에서 다룬다). 보정 전 여섯 칸 가운데 다섯 칸이 그림 3 의 1·2위였다. 😂가 세 칸, 😘가 두 칸이고, 나머지 한 칸은 😔다. 보정 후에는 다섯 줄이 바뀌었고, 「Coz I miss you xx」는 😘 그대로였다. 보고 싶다는 문장에는 뽀뽀하는 얼굴이 문장과도 잘 맞으니, 인기 몫을 깎은 뒤에도 첫자리를 지킨 것으로 읽힌다(우리 해석). 보정이 흔한 이모지를 무조건 밀어낸 것은 아니라는 뜻이다.
보정 후 칸 여섯 개 가운데 그림 3 의 상위 15개에 드는 것은 😘(2위)와 😉(7위) 둘뿐이고, 😴·🌞·💔·😕는 그 바깥의 이모지다. 보정 전 칸의 😔도 상위 15개 밖이다. 여섯 문장을 어떻게 골랐는지는 논문에 없으니, 「여섯 중 다섯」을 비율로 넓혀 읽을 수는 없다.
흔한 것이 문장이나 취향보다 앞서는 이런 쏠림의 이름은 인기 편향(popularity bias)이다. 추천 시스템 연구에서 쓰는 말이고, 이 논문에는 나오지 않는다. 논문은 처방 쪽에 다양화(diversification)라는 이름을 붙였고, 이 글에서는 그 처방을 보정이라고 부른다. 모델이 😂를 먼저 고른 것은 문장을 못 읽어서가 아니라, 문장과 맞는 정도 위에 「원래 많이 쓰인다」는 몫이 얹혀 흔한 이모지가 이겼기 때문이다. 흔한 몫을 덜어 내고 나서야 문장이 순위를 가른다.
식 한 줄 — 인기도의 α 제곱으로 나눈다
앞 절의 「나눈다」를 식으로 적으면 한 줄인데, 나누는 값은 인기도 그대로가 아니라 인기도의 α 제곱이다. α 는 깎는 세기를 정하는 숫자다. α 가 0 이면 어떤 수든 0제곱은 1 이라 원래 점수가 그대로 남고, α 가 1 이면 인기도로 통째로 나눈다. 그 사이면 덜 나눈다. 정리하면 i 번째 이모지의 점수 $S_i$ 는, 모델이 문장을 보고 낸 그 이모지의 확률 $\hat{P}$ 를 그 이모지가 학습 자료에서 쓰인 비율 $P$ 의 α 제곱으로 나눈 값이다. 논문의 식 (1)을 그대로 옮기면 식 1과 같다.
이 점수는 확률이 아니라 순위를 매기는 값이다. α 를 정한 방법에 대해 논문이 적은 것은 한 문장뿐이다. α 는 「determined empirically through experiments on live traffic」, 곧 실제 사용자 트래픽 실험으로 정했다는 것이다.
그림 3 에서 😂는 15위 😜보다 약 16배 많이 쓰였다. 그림 3 의 비율을 인기도로 놓고 우리가 계산하면, α 가 0.7 일 때 나누는 값의 차이는 16 의 0.7제곱, 약 7배가 된다. 그래서 😂가 😜를 이기려면 모델이 낸 확률이 약 7배는 높아야 한다. 흔한 이모지일수록 더 크게 깎는 이 손잡이 하나가 처방의 전부다. α 는 「원래 많이 쓰인다」는 사실을 점수에 얼마나 남길지 정하는 세기다.
가상 문맥 20만 개로 다섯 α 를 돌려 보다
논문은 보정의 효과를 숫자로 재지 않았다. 그래서 식 1을 우리 컴퓨터에서 돌려 보는 모의 실험을 했다. 설정은 전부 우리 가정이고, 결과는 지보드의 수치가 아니다.
후보는 그림 3 의 이모지 15개(실제 모델은 100개), 인기도는 그림 3 판독값을 15개 안의 비율로 바꾼 값이다. 가상 문맥 20만 개마다 「알맞은 이모지」 하나를 인기도대로 뽑아 이 실험의 정답 표지로 삼았다. 모델은 인기도를 미리 안다. 그 위에 알맞은 이모지를 가리키는 흐린 단서(또렷함 1.5 — 클수록 뚜렷하다, 잡음 표준편차 1)를 보고 확률을 매기되, 단서가 또렷하든 흐리든 같은 무게로 읽는다. α 다섯 값(0 · 0.3 · 0.5 · 0.7 · 1.0)을 같은 문맥에 적용해 1순위만 셌다(난수 시드 하나).
이 가상 세계에서 😂가 알맞은 문맥은 23.5% 다. 그런데 보정을 끈 α = 0 에서는 문맥의 38.7% 에서 😂가 1순위로 떴다. 😂가 알맞지 않은 문맥만 보면, 그 가운데 25.3% 에서도 😂가 1순위였다(그림 1).
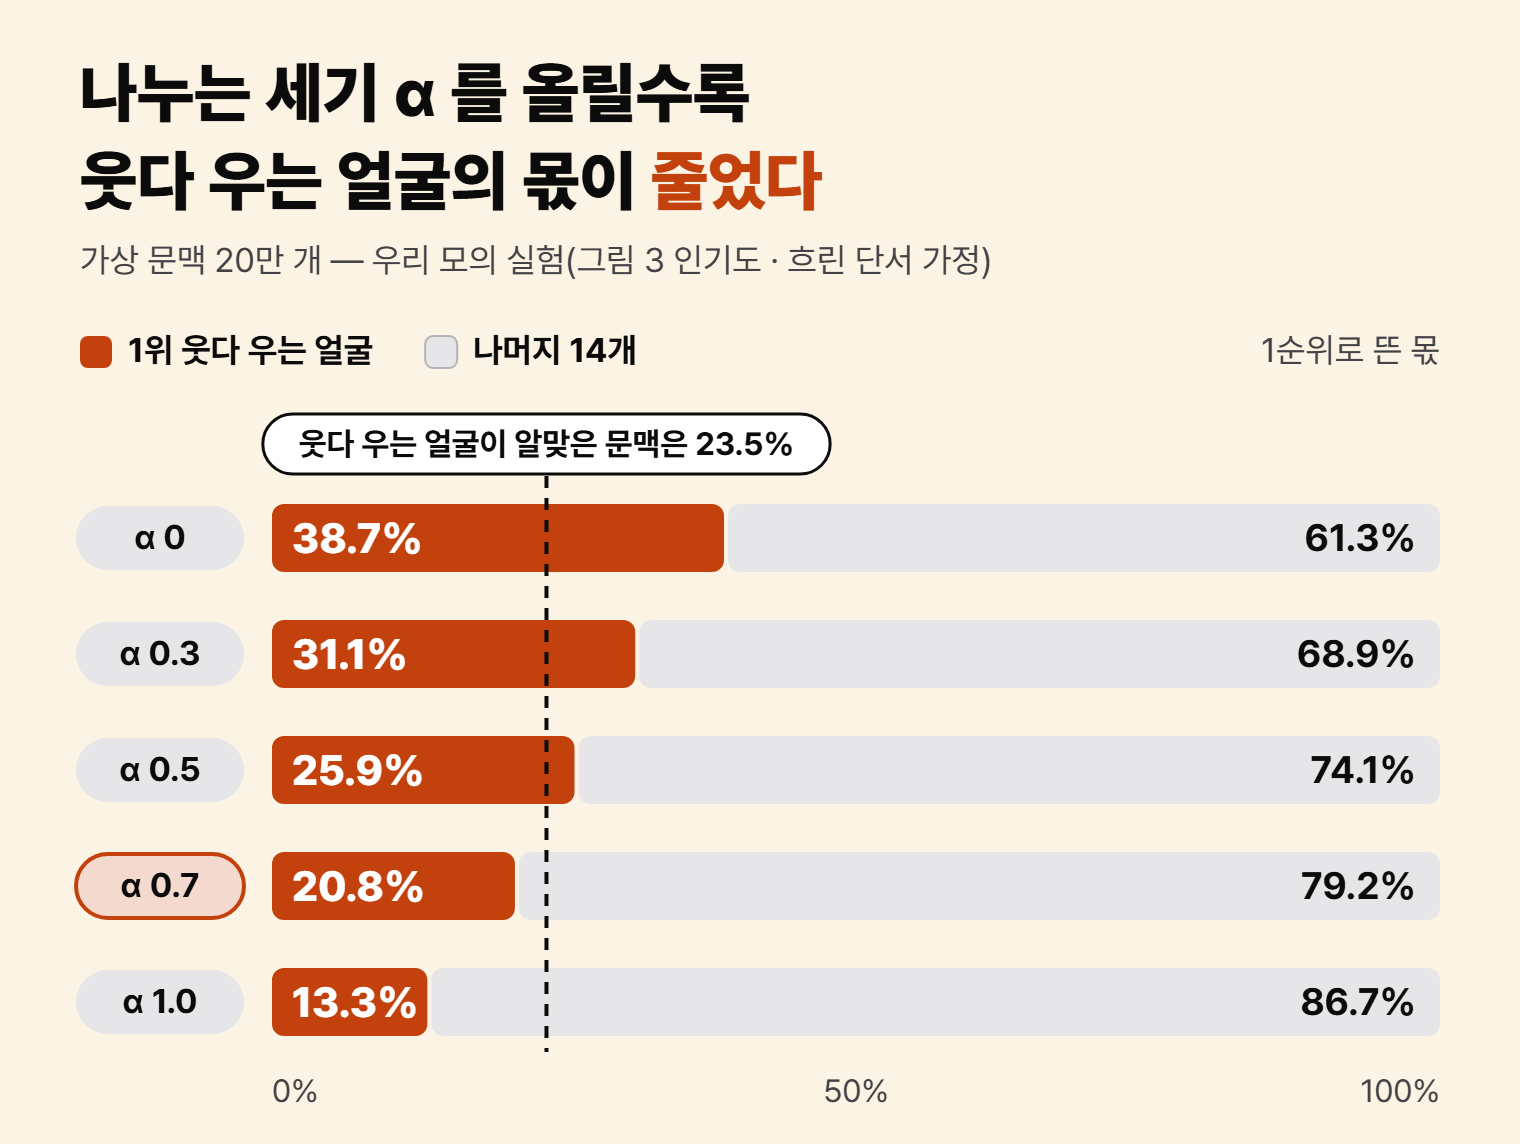
α 를 0.7 로 올리면 😂가 1순위에 오른 비율은 20.8% 로 내려와 23.5% 아래가 된다. 알맞지 않은 문맥에서 😂를 띄운 비율도 8.8% 로 준다. 😂·😘 말고 다른 13개가 알맞은 문맥에서는, 1순위가 그 이모지를 맞힌 비율이 36.7% 에서 44.4% 로 올랐다(그림 2).
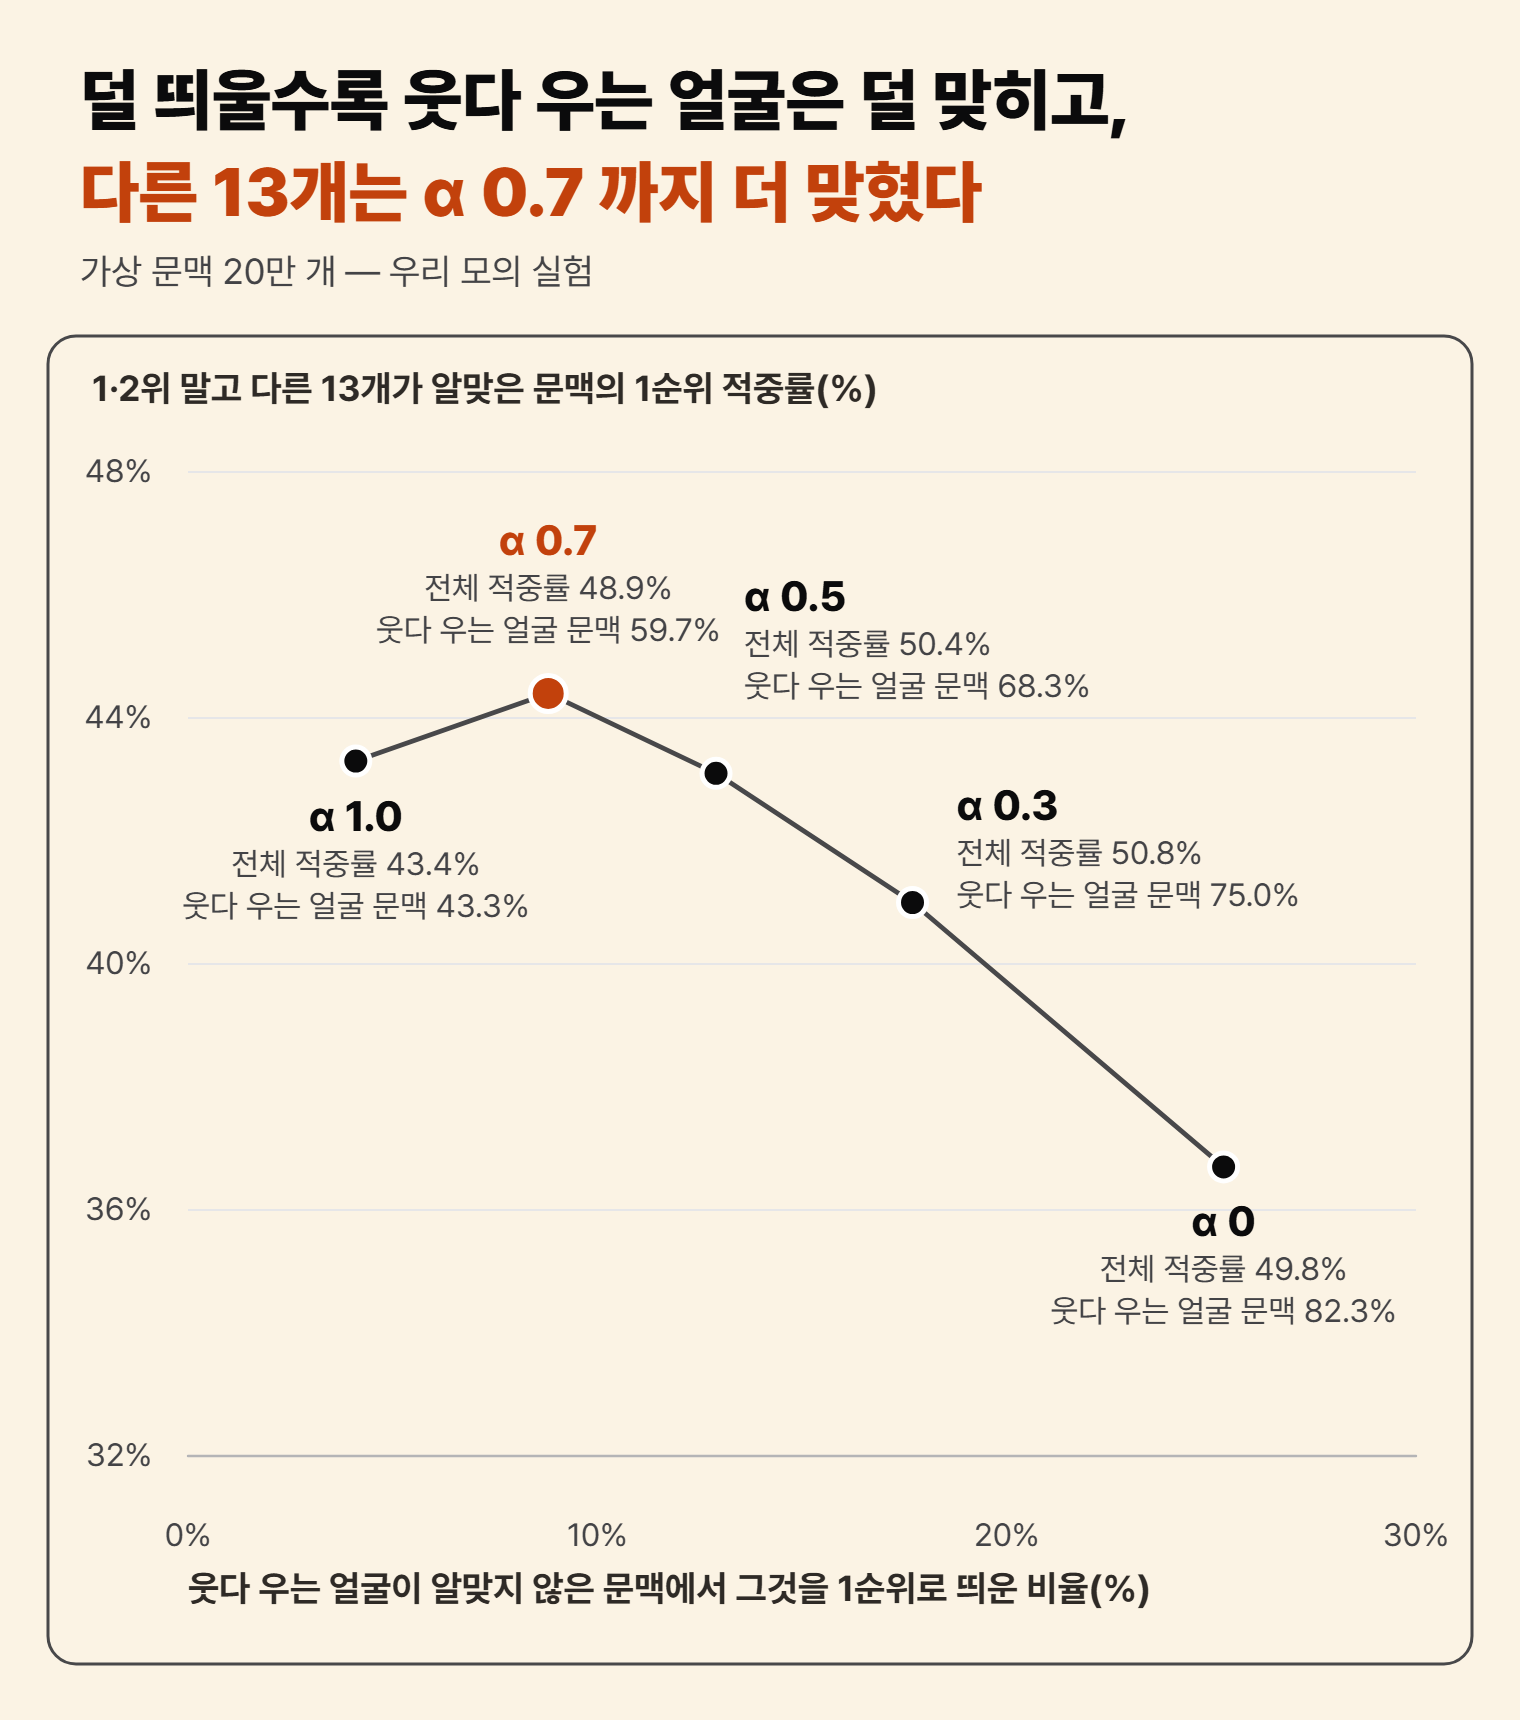
가상 정답 표지를 1순위로 맞힌 비율(적중률)을 전체로 보면 49.8% 에서 48.9% 로 거의 그대로다. 그사이 😂가 알맞은 문맥의 적중률은 82.3% 에서 59.7% 로 떨어졌고, 13개 쪽은 올랐다. 우리 해석으로는 두 쪽의 득실이 엇갈린 결과다.
α = 1.0 의 값은 이 실험의 짜임에서 나왔다. 모델이 곱한 인기도와 보정이 나누는 인기도가 같아서, α = 1 이면 인기 몫이 정확히 지워진다. 😂 문맥·13개 문맥·전체의 적중률이 43.3·43.3·43.4% 로 거의 같아지는 것도 그래서다. 실제 모델도 이렇게 맞물리는지는 알 수 없으니 일반 결론으로 쓰지 않는다.
단서를 같은 무게로 읽는 우리 모델은 또렷한 단서일수록 실제보다 덜 믿는다. 그래서 또렷함 2.5 에서는 α 0 → 0.7 에 전체 적중률이 74.3% → 79.1% 로 올랐다. 단서를 또렷한 만큼 믿는 모델로 돌리면 반대로, α 를 올릴수록 전체 적중률은 줄곧 내렸다. 두 모델에 공통으로 남는 것은 😂가 1순위에 오르는 비율이 줄고 13개 쪽 적중률이 오르는 방향이다. 전체 적중률 한 숫자는 😂 쪽에서 잃은 것과 13개 쪽에서 얻은 것을 합쳐서 가린다는 뜻이다.
논문이 보정 효과를 숫자로 내지 않은 자리
평가 절에는 이런 문장이 있다. 「All evaluation metrics are computed prior to diversification.」 논문이 잰 1순위 적중률을 비롯한 모든 평가 지표를 다양화 이전에, 곧 보정 전 모델로 계산했다는 뜻이다. 보정의 근거로 남은 것은 표 1 의 예시 여섯 문장뿐이고, 보정 전후의 클릭률이나 추천이 얼마나 다양해졌는지를 잰 숫자는 없다.
논문 표 3 의 숫자를 보정의 효과로 읽으면 안 된다. 표 3 은 연합 학습 모델에서 예측 클릭률이 3.66%, 이모지 공유가 5.54%, 이모지를 쓴 하루 사용자가 11.22% 늘었다고 적었다. 이 상대 변화의 비교 대상은 이모지 추천이 아예 없던 키보드다(원문 「The baseline does not have any emoji predictions.」). 곧 이모지 추천 기능을 들인 효과다. 「예측 클릭률」의 원문은 「click-through rate (CTR) of predictions」라서 이모지 추천만의 클릭률로 좁혀 읽을 수도 없다.
왜 재지 않았는지 논문은 말하지 않는다. 우리 해석으로는, 1순위 적중률이 흔한 이모지를 맞힐수록 오르는 지표라서 보정의 이득이 잘 드러나지 않는다. 「잘 맞힌다」를 무엇으로 재느냐에 따라, 같은 보정이 이득으로도 손해로도 보일 수 있다.
흔한 것으로 나누기, 그리고 비어 있는 숫자
흔한 것의 몫을 덜어 내는 손질은 이 논문 밖의 추천에서도 쓰인다. 쇼핑몰이나 영상 앱에서 많이 팔린 물건, 많이 본 영상이 모든 추천 칸을 차지하지 않게 하려는 일이 그렇다. 다만 이 논문은 그런 연구를 인용하지 않았으니, 지보드 팀이 그 흐름을 따랐다고 볼 근거는 없다. 이 연결은 우리 해설이다. 어느 쪽이든 손질의 모양은 같다. 많이 쓰였다는 사실을 점수에서 얼마간 빼고, 남은 차이로 순위를 매긴다.
그래서 비슷한 처방을 내건 추천을 만나면 세 가지를 물어볼 수 있다. 무엇으로 나눴는지, 얼마나 세게 나눴는지, 그리고 그 효과를 어떤 숫자로 쟀는지다. 이 논문은 첫째(학습 자료에서 쓰인 비율)를 밝혔고, 둘째(α 값)는 비워 두었으며, 셋째는 예시 여섯 줄로 대신했다. 셋째 물음에 전체 적중률 하나만 답으로 돌아온다면, 앞에서 본 대로 보정이 한 일이 그 숫자에 가려져 있을 수 있다.
사과 문장으로 돌아가 보자. 보정 뒤에 잠자는 얼굴이 첫자리에 올랐다는 것은, 모델의 확률 안에 이미 그 문장에 맞는 단서가 들어 있었다는 뜻이다. 다만 그 단서가 😂의 인기 몫을 넘지 못했을 뿐이다. 😂가 이긴 까닭이 인기였으니, 고치는 방법도 인기를 덜어 내는 것이었다. 점수를 인기로 한 번 나누면, 문장이 가리키는 이모지가 흔한 이모지를 이길 자리가 생긴다.
남은 빈칸은 세기다. 논문은 α 를 실제 사용자 실험으로 정했다고 적었지만, 그 값도 실험의 숫자도 싣지 않았다. 표 1 의 0.7 은 예시를 보여 준 칸이고, 그것이 실제로 쓴 값이라는 말은 없다. 논문의 실사용 실험은 미국과 캐나다에서 영어(미국)를 쓰는 사용자를 대상으로 했고, 실험 기간과 표본 수도, 그때 보정을 켰는지와 켰다면 어떤 세기였는지도 적혀 있지 않다.
2019년 이후의 지보드가 같은 식으로 도는지, 한국어 키보드는 어떤지도 논문이 다루지 않은 물음으로 남아 있다. 처방은 식 한 줄로 공개됐지만, 그 세기를 정한 근거는 비어 있다. 흔한 이모지를 어디까지 깎았을 때 사람들은 추천된 이모지를 실제로 더 눌렀을까?
더 읽기
- Swaroop Ramaswamy, Rajiv Mathews, Kanishka Rao, Françoise Beaufays, "Federated Learning for Emoji Prediction in a Mobile Keyboard", arXiv:1906.04329v1 (2019) — https://arxiv.org/abs/1906.04329
- Unicode Consortium, "Emoji Frequency" (2019 순위 — 여러 출처의 사용 빈도 중앙값 기준) — https://home.unicode.org/emoji/emoji-frequency/
- The Unicode Blog, "The Most Frequently Used Emoji of 2021" — http://blog.unicode.org/2021/12/our-most-frequently-used-emoji.html