AI 그림 생성기에 영어 간판을 그려 달라고 하면, 글자 모양은 그럴듯한데 철자가 틀린 그림이 나오곤 했다. 구글 연구진은 그 원인 하나를 그리는 솜씨가 아니라 프롬프트를 읽는 쪽에서 찾았다. 읽는 쪽이 낱말을 통째로 번호 하나로 받아서, 그 안에 어떤 글자가 들었는지 알 수 없었다. 읽는 쪽에 글자를 하나씩 받는 부품을 붙이자, 그려 낸 간판에서 흔한 낱말의 철자가 맞은 비율이 75% 에서 94% 로 올랐다. 부품을 붙이기 전의 이런 읽는 쪽을 「글자를 못 보는(character-blind) 텍스트 인코더」라고 부른다.
흔한 낱말일수록 철자를 잘 알 것 같지만
보통은 자주 본 것일수록 잘 안다. 날마다 쓰는 낱말의 철자를 틀리는 사람은 드물고, AI 모델도 대개는 학습 자료에 자주 나온 것을 더 잘 맞힌다. 익힐 기회가 그만큼 많기 때문이다.
그런데 구글의 그림 모델 Imagen 에서 프롬프트를 읽는 쪽만 떼어 내, 낱말을 주고 글자를 하나씩 불러 보게 한 시험이 있다. 낱말은 쓰이는 빈도에 따라 다섯 구간으로 나눴고, 구간마다 1,000개씩이다. 영어에서 가장 흔한 상위 1% 낱말의 철자를 맞힌 비율은 66% 였고, 가장 드문 하위 50% 낱말은 65% 였다. 흔한 낱말이라고 해서 이득을 본 것이 거의 없다.
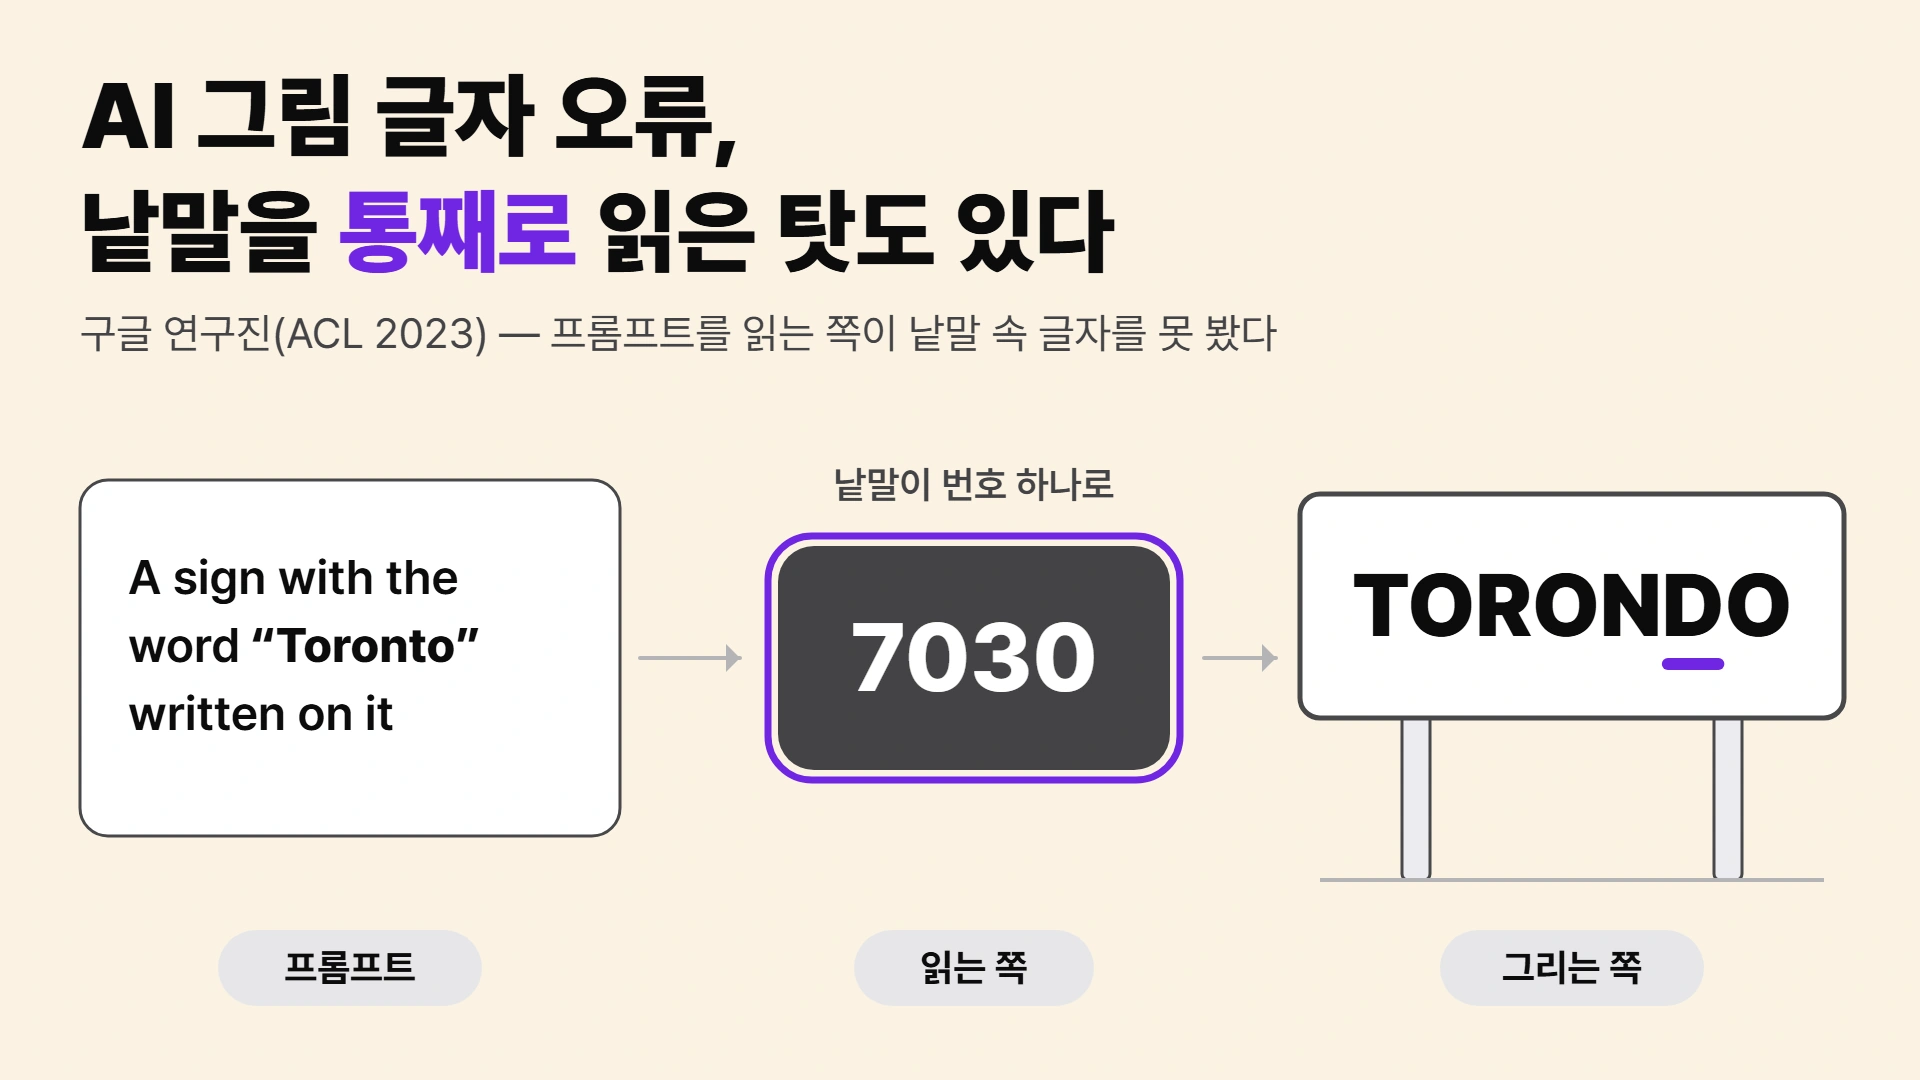
예를 들어 카페 간판을 그려 달라며 프롬프트에 「COFFEE」를 적어 넣었다고 하자. 돌아온 그림의 간판은 글꼴도 자리도 그럴듯한데, 철자 한두 곳이 어긋나 있는 식이다. 연구진이 실제로 모은 예로는, 「Toronto」라고 쓰라고 한 표지판에 「Torondo」가 적혀 나온 경우가 있다(이 오류는 읽는 쪽으로 T5 를 쓴 모델에서만 나왔다). 읽는 쪽에 관한 수치와 사례는 모두 2022~23년 무렵의 연구 모델에서 나왔다.
간판 글자가 틀리는 것은 그림 솜씨만의 문제일까? 그림 속 글자에는 그리기 전 단계, 곧 프롬프트를 읽는 단계의 몫도 있다. 흔한 낱말이 이득을 못 본다는 것은, 프롬프트를 읽는 쪽이 낱말을 글자 단위로 보지 않는다는 단서다.
AI 그림 속 글자가 엉터리였던 이유 — 프롬프트를 읽는 쪽이 낱말을 통째로 받는다
그림 생성기는 크게 두 부분으로 나뉜다. 하나는 사용자가 쓴 프롬프트를 읽어 숫자 묶음으로 바꾸는 부분으로, 텍스트 인코더(text encoder)라고 부른다. 다른 하나는 그 숫자를 보고 실제로 그림을 그리는 부분이다. 그리는 쪽은 프롬프트의 글자를 직접 받지 않고, 텍스트 인코더가 넘겨준 숫자만 받는다. 프롬프트가 「빨간 간판」이든 「COFFEE 라고 쓴 간판」이든, 그리는 쪽에 닿는 것은 이 숫자뿐이다. 이 글은 앞쪽을 「읽는 쪽」, 뒤쪽을 「그리는 쪽」이라고 부른다.
읽는 쪽은 낱말을 글자 하나하나가 아니라 조각, 곧 토큰(token)으로 받는다. 자주 붙어 다니는 글자 묶음을 미리 사전에 올려 두고, 문장을 그 단위로 자른 뒤 조각마다 번호 하나를 붙여 넘기는 방식이다. 이렇게 자른 조각을 하위 단어(서브워드)라고 한다. 이 방식 때문에 챗봇이 낱말 속 글자 수를 잘 못 센다는 이야기는 토크나이저 — AI는 왜 글자를 못 세나에서 다뤘다. 이 글은 같은 방식이 그림 속에 글자를 쓸 때 어떻게 드러났는지를 본다.
흔한 낱말은 대개 통째로 한 조각이 된다. 연구진은 Imagen 의 읽는 쪽인 T5 에서 영어 상위 1% 낱말의 87% 가 한 조각이라고 적었다. 한 조각이 되면 번호 하나가 들어갈 뿐이라, 그 낱말 안에 어떤 글자가 어떤 순서로 들었는지는 입력 어디에도 없다. 당시 널리 쓰이던 그림 모델 여섯은 Imagen 을 포함해 모두 이 방식이었다(원문). 스테이블 디퓨전(Stable Diffusion)·달리(DALL·E)·달리 2·Imagen·Parti·eDiff-I 가 그 여섯이다.
앞의 표지판 예로 보면 이렇다. Toronto 는 T5 에서 통째로 한 조각이고, 번호는 7030 이다. 읽는 쪽이 받는 입력에는 T·o·r·o·n·t·o 라는 글자 순서가 따로 들어 있지 않다. 읽는 쪽은 이 번호를 숫자 묶음으로 바꿔 그리는 쪽에 넘기고, 그리는 쪽은 그 숫자 묶음만 보고 간판에 글자 일곱 개를 차례로 써야 한다. 그래서 읽는 쪽이 번호 하나에 철자를 얼마나 담아 두었는지가 중요해진다. 저자들은 이런 사정이라면 그림 모델이 입력 조각을 글자 줄로 옮기는 데 애를 먹는 것도 놀랍지 않다고 적었다.
이 이야기의 출처는 구글 연구진 Liu 외의 논문 「Character-Aware Models Improve Visual Text Rendering」(ACL 2023)이다. 저자들은 읽는 쪽이 글자 단위 입력을 받지 못하는 점을 그림 속 글자가 틀리는 「주요 원인 하나(a key contributing factor)」로 짚었다. 유일한 원인이라고 하지는 않았다. 그래서 저자들은 글자를 하나씩 받는 인코더를 붙여 봤다. ByT5 는 낱말을 조각으로 묶지 않고 글자 하나하나를 받는 텍스트 인코더다. 글자를 하나씩 받으니, 낱말이 흔하든 드물든 같은 방식으로 들어간다.
논문 결론에 따르면, 그려 낸 간판의 철자가 맞은 비율은 흔한 낱말에서 75% 에서 94% 로, 드문 낱말에서 47% 에서 83% 로 올랐다. 드문 낱말에서는 1.8배 가까이 오른 셈이다. 읽는 쪽이 글자를 보게 하자 그림 속 철자가 크게 나아졌다. 엉터리 글자의 상당 부분은 프롬프트가 그리는 쪽에 닿기 전, 읽는 쪽에서 비롯됐다.
내 PC 에서 낱말을 쪼개 보면
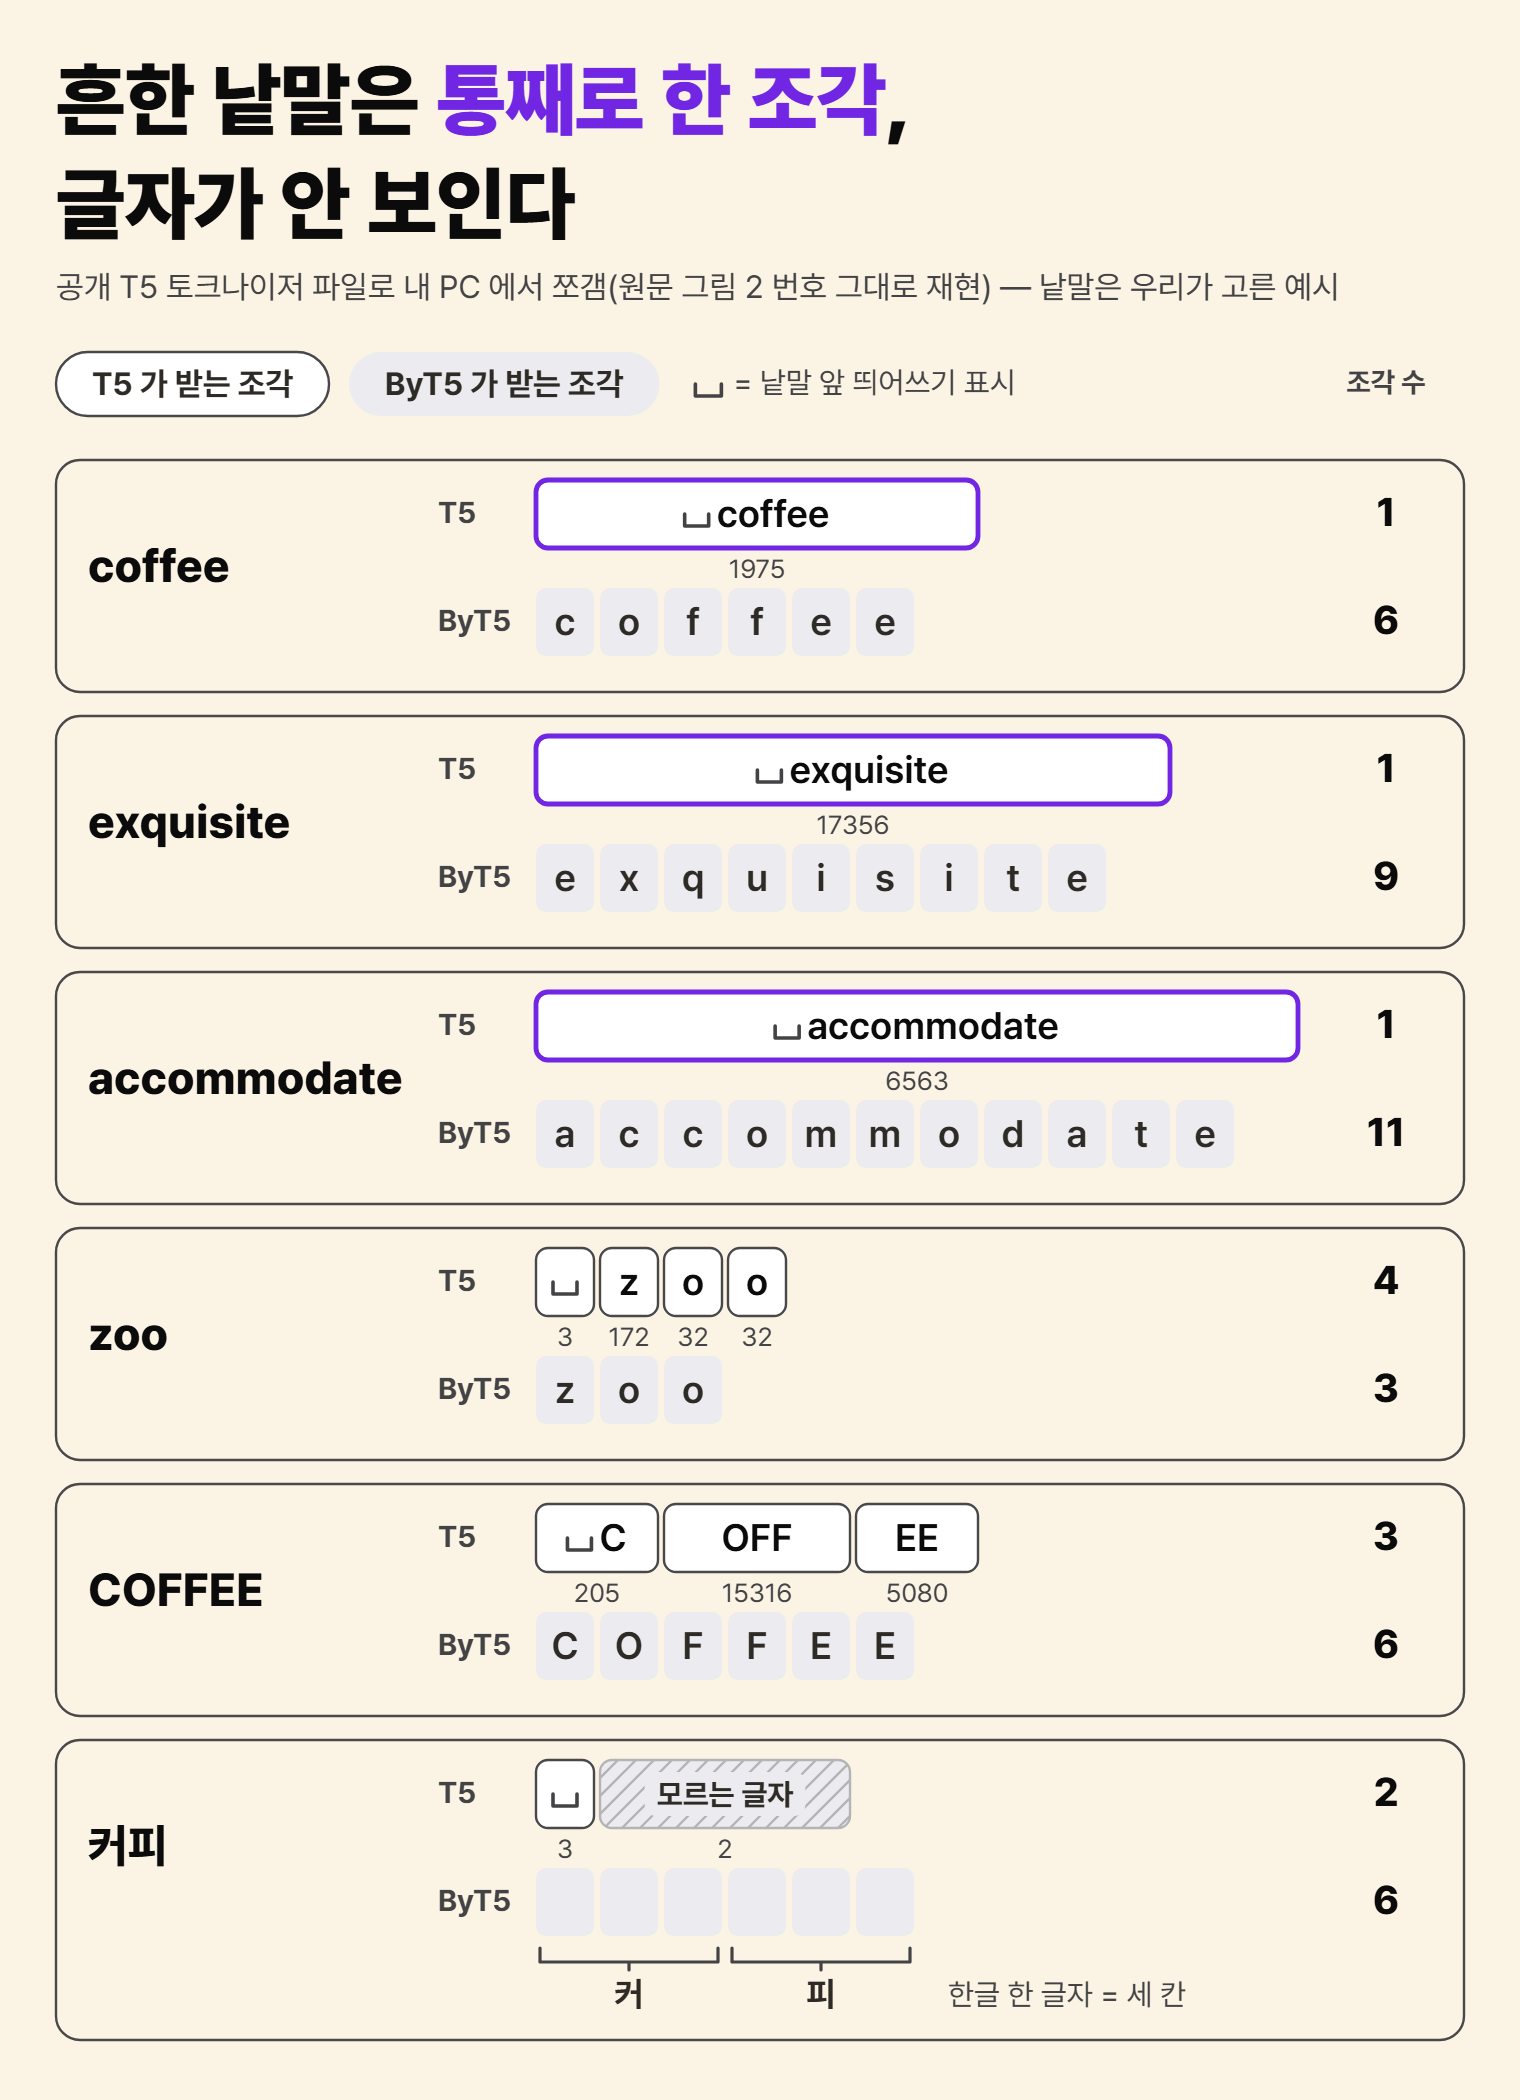
읽는 쪽이 받는 조각은 내 PC 에서도 볼 수 있다. T5 의 토크나이저(문장을 조각으로 자르는 프로그램) 파일이 공개돼 있어, 외부 서비스 없이 파일만 읽어 쪼갠다. 이 파일이 원문의 T5 어휘와 같은지는 원문 그림 2 의 예문 「I saw two elephants at the zoo yesterday.」로 확인했다. 넣어 보니 원문 그림에 적힌 번호 13개가 그대로 나왔다.
from tokenizers import Tokenizer

t5 = Tokenizer.from_file("t5-base_tokenizer.json")
for w in ["zoo", "coffee", "COFFEE", "exquisite", "accommodate", "커피", "청첩장", "할인"]:
    e = t5.encode(w, add_special_tokens=False)
    print(w, len(e.ids), e.tokens, e.ids)
zoo 4 ['▁', 'z', 'o', 'o'] [3, 172, 32, 32]
coffee 1 ['▁coffee'] [1975]
COFFEE 3 ['▁C', 'OFF', 'EE'] [205, 15316, 5080]
exquisite 1 ['▁exquisite'] [17356]
accommodate 1 ['▁accommodate'] [6563]
커피 2 ['▁', '커피'] [3, 2]
청첩장 2 ['▁', '청첩장'] [3, 2]
할인 2 ['▁', '할인'] [3, 2]coffee·exquisite·accommodate 는 조각 하나, 번호 하나라서 c·o·f·f·e·e 같은 글자가 입력에 따로 없다. zoo 는 오히려 ▁·z·o·o 네 조각이다(▁ 는 낱말 앞의 빈칸 표시). 대문자 COFFEE 는 coffee 와 전혀 다른 번호 세 개로 들어가서, 같은 낱말도 쓰는 모양에 따라 다른 입력이 된다. 한글 세 줄에 보이는 「커피」는 토크나이저가 원문을 되돌려 찍어 준 표시일 뿐이고, 모델에 들어가는 것은 번호 [3, 2] 다(2 는 사전에 없는 글자). 그림 1 에 여섯 낱말을 T5 와 ByT5 로 나란히 쪼개 그렸다. 읽는 쪽이 받는 것은 철자가 아니라 번호이고, 철자는 그 번호에서 짐작해야 한다.
읽는 쪽만 떼어 철자를 시험하다
첫 절의 66% 는 이런 시험에서 나왔다(원문 이름 WikiSpell). elephant 를 주면 「e l e p h a n t」처럼 글자를 띄어 내야 맞는다. 이때 읽는 쪽은 얼려 둔다. 학습하는 동안 그 안의 값을 바꾸지 않는다는 뜻이다. 그 뒤에 붙인 부분만 이 과제로 학습시키고, 시험에 쓰는 낱말은 학습 자료에서 뺐다. 그래서 정답이 나온다면, 그 철자는 얼려 둔 읽는 쪽에서 꺼내 온 것이다.
원문 표 1 은 이렇다(철자를 통째로 맞힌 비율, %). T5-XXL 은 Imagen 의 읽는 쪽이고, 첫 두 줄은 읽는 쪽을 얼려 둔 결과다. 셋째 줄은 읽는 쪽까지 전부 학습시킨 경우다.
| 읽는 쪽 | 상위 1% | 1~10% | 10~20% | 20~30% | 하위 50% |
|---|---|---|---|---|---|
| T5-XXL (얼림) | 66 | 69 | 73 | 68 | 65 |
| ByT5-XXL (얼림) | 98 | 98 | 98 | 98 | 98 |
| T5-XXL (읽는 쪽까지 전부 학습) | 68 | 85 | 91 | 90 | 90 |
글자를 받는 ByT5-XXL 은 모든 구간에서 98% 였다. 읽는 쪽까지 전부 학습시키면 드문 낱말은 65% 에서 90% 로 오르지만, 흔한 낱말은 66% 에서 68% 에 그친다. 저자들은 그 까닭을 이렇게 설명한다. 시험 낱말은 학습 자료에서 뺐으니, 한 조각짜리 낱말은 그 조각이 학습에 한 번도 나오지 않아 철자를 배울 길이 없다.
그림에서 나온 오류의 종류도 같은 쪽을 가리킨다. 연구진은 흔한 불규칙 과거형 동사 23개(began·chose·dug 등)를 그리게 했다. T5 를 쓴 모델은 그림 표본의 11% 에서 -ed 를 잘못 붙였다. 글자를 보는 모델은 한 번도 그러지 않았다. 저자들은 이것을, 글자를 못 보는 모델이 철자를 짐작할 때 낱말의 뜻에 「일부(partly)」 기댄다는 분명한 증거로 본다. 읽는 쪽이 글자를 모르면, 그 빈자리는 「fought 는 과거형이니 -ed」 같은 추측이 채운다.
그림에서 다시 재 보면 — 고쳐진 오류와 남은 오류
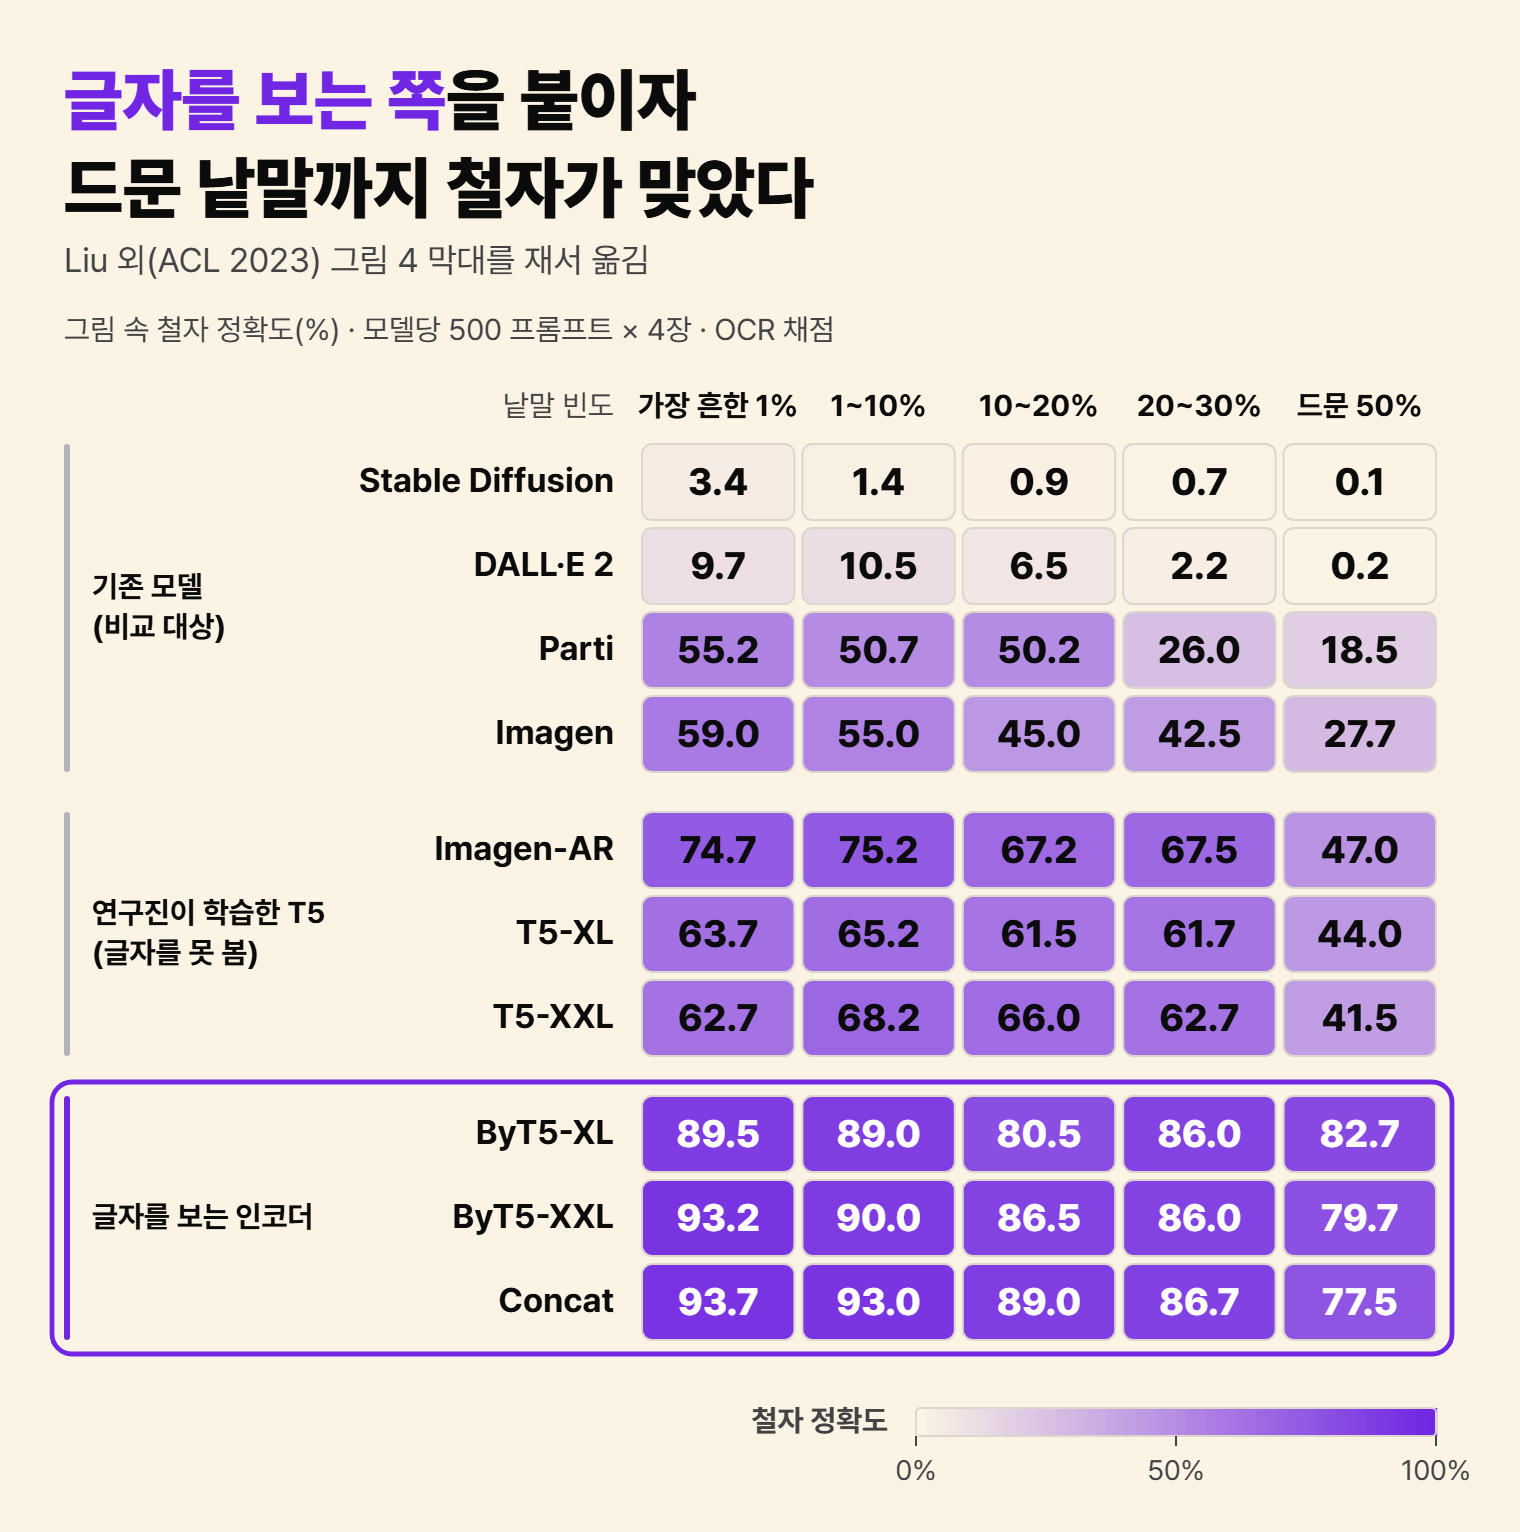
연구진은 「A sign with the word "…" written on it.」 틀에 구간마다 100낱말을 넣은 프롬프트 500개로 모델마다 4장씩 그렸다. 채점은 그림에서 글자를 읽어 내는 프로그램인 광학 문자 인식(OCR)이 맡았고, 낱말 전체가 맞아야 정답으로 쳤다(대소문자는 무시). 비교의 중심은 같은 데이터·같은 학습 길이에서 읽는 쪽만 바꾼 모델 다섯이다. T5 둘, ByT5 둘, 그리고 기존 T5 에 작은 ByT5 를 이어 붙인 Concat 이다.
결과는 그림 2 와 같다. 글자를 보는 세 모델은 T5 두 모델보다 흔한 낱말에서 25점 넘게, 드문 낱말에서 30점 넘게 높았다. Imagen-AR 은 연구진이 Imagen 을 이어서 더 학습시킨 판으로, 학습량이 그 다섯 모델보다 6배 넘게 많다. 글자를 보는 세 모델은 이 Imagen-AR 보다도 모든 구간에서 높았다.
고쳐지지 않은 오류도 있다. 글자를 빠뜨리거나(stopping → stoping) 겹쳐 쓰거나(possible → posssible) 합쳐 버리는 오류는 모든 모델에서 나왔다. 글자를 보는 모델에서도 생겼으니, 저자들은 이것을 그리는 쪽이 글자 모양을 만들어 제자리에 놓는 문제(layout issues)로 본다.
Our results strongly suggest that resolving these issues will require orthogonal improvements outside the text encoder, specifically changes to the image generation module.
(우리 결과는 이 문제들을 풀려면 텍스트 인코더 밖, 곧 그림을 생성하는 부분을 바꾸는 별개의 개선이 필요하다는 것을 강하게 시사한다.)
Liu 외, 「Character-Aware Models Improve Visual Text Rendering」(ACL 2023), §6대가도 있었다. 글자만 받는 ByT5 단독 모델은 그림이 프롬프트와 얼마나 맞는지를 사람이 고르는 평가에서 T5 에 졌고, 프롬프트의 60% 에서 T5 쪽 그림이 뽑혔다. Concat 은 이 차이를 오차 범위 안으로 좁혔다. 읽는 쪽의 크기는 4.8% 늘었을 뿐이다. 읽는 쪽을 고치면 철자 오류는 크게 줄지만, 글자 모양을 놓는 일은 여전히 그리는 쪽의 몫이다.
한글 간판은 읽는 쪽이 글자를 봐도 그려지지 않았다
앞에서 본 한글 세 줄로 돌아가 보자. 영어용 T5 는 「커피」「청첩장」「할인」을 셋 다 같은 번호 [3, 2] 로 받는다. 2 는 사전에 없는 글자를 뜻하니, 읽는 쪽 입장에서 세 낱말은 구별할 수 없는 같은 입력이다. 글자를 받는 ByT5 는 한글도 받는데, 한글은 한 글자가 세 칸으로 들어간다.
그렇다면 읽는 쪽을 ByT5 로 바꾸면 한글 간판도 그려질까? 원문 부록 A 의 답은 「아니다」다. 연구진은 「dog」라는 낱말이 적힌 간판 프롬프트를 열한 개 언어로 옮겨 넣었다. 글자를 보는 모델은 한국어를 포함한 모든 언어에서 간판을 그리라는 뜻은 알아들었지만, 한국어·중국어·러시아어처럼 라틴 문자가 아닌 글자는 간판에 옮기지 못했다.
저자들은 그 이유를, 아마도 학습 그림에서 그 글자 모양을 거의 보지 못했기 때문(presumably)이라고 추정한다. 학습에 쓴 그림 설명문의 95% 가 영어였다. 저자들은 어떤 문자의 글자 모양을 익히려면 그 문자로 쓰인 글자가 담긴 그림을 많이 학습시켜야 할 것으로 예상된다고 적었다.
같은 부록에서 T5 를 쓴 모델은 한국어를 비롯한 여섯 언어의 프롬프트를 통째로 무시하는 것처럼 보였다(appears to ignore). 우리 재현의 [3, 2] 와 방향이 같아 나란히 놓아 볼 뿐, 원문이 그 인과를 말하지는 않는다. 이 연결은 우리 추측이다.
최근 연구도 한글 글자가 여전히 어렵다는 쪽을 가리킨다. 2026년에 공개된 다국어 그림 편집 벤치마크 MultiTextEdit 는 열두 가지 모델 설정이 그림 속 글자를 고칠 때 언어마다 점수가 얼마나 떨어지는지 쟀다. 한국어는 0~5점 척도에서 다섯 항목 평균이 영어보다 0.543 낮아, 비영어 11개 언어 가운데 네 번째로 크게 떨어졌다. 러시아어(0.542)와는 사실상 같고, 중국어(0.304)보다는 컸다. 가장 크게 떨어진 언어는 히브리어와 아랍어였고, 평가한 모든 모델에서 영어 점수가 비영어 평균보다 높았다. 이 논문(동료 심사 전에 공개한 프리프린트)은 원인을 읽는 쪽으로 돌리지 않고, 문자의 특성·쓰는 방향·언어 자원이 함께 얽혔을 수 있다고만 적었다.
이 글에서 읽는 쪽에 관해 든 수치는 2022~23년 연구 모델에서 잰 값이다(Liu 의 그림 모델은 64×64 해상도). 지금 쓰는 상용 그림 서비스가 어떤 읽는 쪽을 쓰는지는 이 글이 본 문헌에 나오지 않으니, 수치를 그대로 옮겨 읽지 않는 편이 맞다.
한글 간판이 영어 간판보다 어려운 까닭은 두 자리로 나눠 볼 수 있다. 영어용 T5 같은 읽는 쪽은 한글 낱말을 모르는 글자 하나로 뭉개서, 「커피」와 「할인」을 가리지 못한다. 읽는 쪽이 글자를 받게 바꿔도, 저자들의 추정대로라면 그리는 쪽이 학습 그림에서 한글 글자 모양을 거의 보지 못해 간판에 옮기지 못했다. 영어 철자는 읽는 쪽을 고치자 크게 나아졌지만, 한글은 두 자리 모두에 걸려 있었다. 이 시기 AI 그림 속 엉터리 글자는 철자를 못 본 읽는 쪽과 글자 모양을 못 익힌 그리는 쪽, 두 군데서 생겼다.
더 읽기
- Rosanne Liu, Dan Garrette, Chitwan Saharia, William Chan, Adam Roberts, Sharan Narang, Irina Blok, RJ Mical, Mohammad Norouzi, Noah Constant, "Character-Aware Models Improve Visual Text Rendering", ACL 2023 (arXiv:2212.10562v2, DOI 10.18653/v1/2023.acl-long.900) — https://aclanthology.org/2023.acl-long.900/
- 호롱스, 「토크나이저 — AI는 왜 글자를 못 세나」(같은 기전을 글자 세기로 다룬 글) — https://horongs.com/tokenizer-strawberry-letter-count/
- Liwei Cheng, Shibo Feng, Lunjie Zhou, Yixuan Guan, Dayan Guan, "MultiTextEdit: Benchmarking Cross-Lingual Degradation in Text-in-Image Editing", arXiv:2605.08163v2 (2026, 프리프린트) — https://arxiv.org/abs/2605.08163