글짓기 숙제는 분량을 꽉 채워야 점수가 잘 나온다는 말이 있다. AI에게 다른 AI의 답을 채점하게 한 시험에서, 같은 AI에게 지시 한 줄만 바꿔 답을 길게 또는 짧게 쓰게 하자 승률이 64.3%와 22.9%로 갈렸다. 다만 평소 판정에서 덜 이기는 모델의 답이 길 때는, 사람도 GPT-4도 그 긴 답을 절반 넘게 고르지 않았다. 채점하는 AI가 같은 내용이라도 더 긴 답 쪽으로 기우는 일을 장황함 편향(verbosity bias)이라고 한다.
독후감 마감 전날, 할 말은 다 썼는데 원고지가 반쯤 비어 있으면 같은 말을 한 번 더 늘여 쓰고 싶어진다. 채점을 사람 대신 AI가 한다면, 그렇게 늘인 글이 점수를 더 받을까. 챗봇의 실력을 견주는 공개 시험 가운데에는 실제로 AI가 채점하는 것이 있다. 다른 AI의 답 두 개를 보고 어느 쪽이 나은지 판정하는 AI를, 이 글에서는 AI 채점관이라고 부른다.
AI에게 채점을 맡기면 왜 긴 답에 점수를 줄까? 같은 AI에게 지시 한 줄만 바꿔 답을 길게 또는 짧게 쓰게 해도 AI 채점관의 점수는 크게 움직인다. 한 시험에서는 그렇게 쓴 답의 승률이 64.3%와 22.9%로 갈렸다. 같은 목록을 말만 바꿔 한 번 더 붙인 답에는 채점관 셋 가운데 둘이 거의 매번 넘어갔다. AI 채점을 쓰는 순위표 가운데 길이를 따로 재서 뺀 점수를 함께 싣는 곳이 생긴 것도, 이렇게 길이에 흔들리는 점수 때문이다.
그런데 평소 판정에서 긴 답이 이긴 기록에는 다른 것도 섞여 있다. 긴 답은 평소 판정에서 더 자주 이기는 모델의 답인 경우가 많았다. 평소 덜 이기는 모델이 길게 쓴 판정만 모으면, 사람도 GPT-4도 오히려 짧은 답 쪽을 더 많이 골랐다.
지시 한 줄만 바꿔도 AI 채점관의 점수가 움직인다
AlpacaEval 2.0은 영어 지시 805개를 두고 챗봇의 답을 견주는 시험이다. 지시마다 평가할 모델의 답과 기준 모델의 답을 GPT-4 turbo가 나란히 보고, 평가할 모델의 답이 나을 확률을 낸다. 이 시험의 승률은 그 확률을 지시 805개에 걸쳐 평균한 값이라, 답 하나의 점수가 아니라 모델 하나가 받은 평균이다. 기준 모델도 GPT-4 turbo(gpt4_1106_preview)다.
연구진은 기준 모델 자신에게 지시마다 한 줄을 덧붙여 다시 답하게 하고, 그 답을 같은 모델이 아무 말 없이 쓴 답과 견줬다. 덧붙인 한 줄은 두 가지다. 하나는 최대한 자세히 답하라는 「Answer with as much detail as possible.」이다. 다른 하나는 필요한 내용은 다 담되 최대한 간결하게 쓰라는 「Be as concise as possible while still providing all the necessary information…」이다. 아무 말도 덧붙이지 않으면 자기 자신과 견주는 셈이라 승률은 정의상 50%다. 간결하게 쓰게 하자 승률은 22.9%로 내려갔고, 자세히 쓰게 하자 64.3%로 올라갔다.
저자들도 길이 지시 하나에 기준 모델의 승률이 그만큼 오르내린다(「…fluctuates from 22.9% to 64.3%…」)고 적었다. 지시 805개를 하나씩 봐도, 자세히 쓴 답이 기준 답을 이길 확률(채점관이 매긴 값)이 간결한 답보다 높은 지시가 718개였다. 이 실험은 지시만 바꿨을 뿐이라, 길어진 답에 내용이 더 들어갔는지까지 맞춘 것은 아니다.
기준 모델보다 승률이 낮은 모델도 같은 한 줄로 점수를 올렸다. claude-2.1은 아무 말 없이 쓴 답의 승률이 15.7%였는데, 자세히 쓰게 하자 24.4%가 됐다. 저자들은 약한 모델도 길게 쓰라고만 하면 점수를 크게 올릴 수 있다는 점을 「Even worse…」, 곧 더 나쁜 일로 꼽았다.
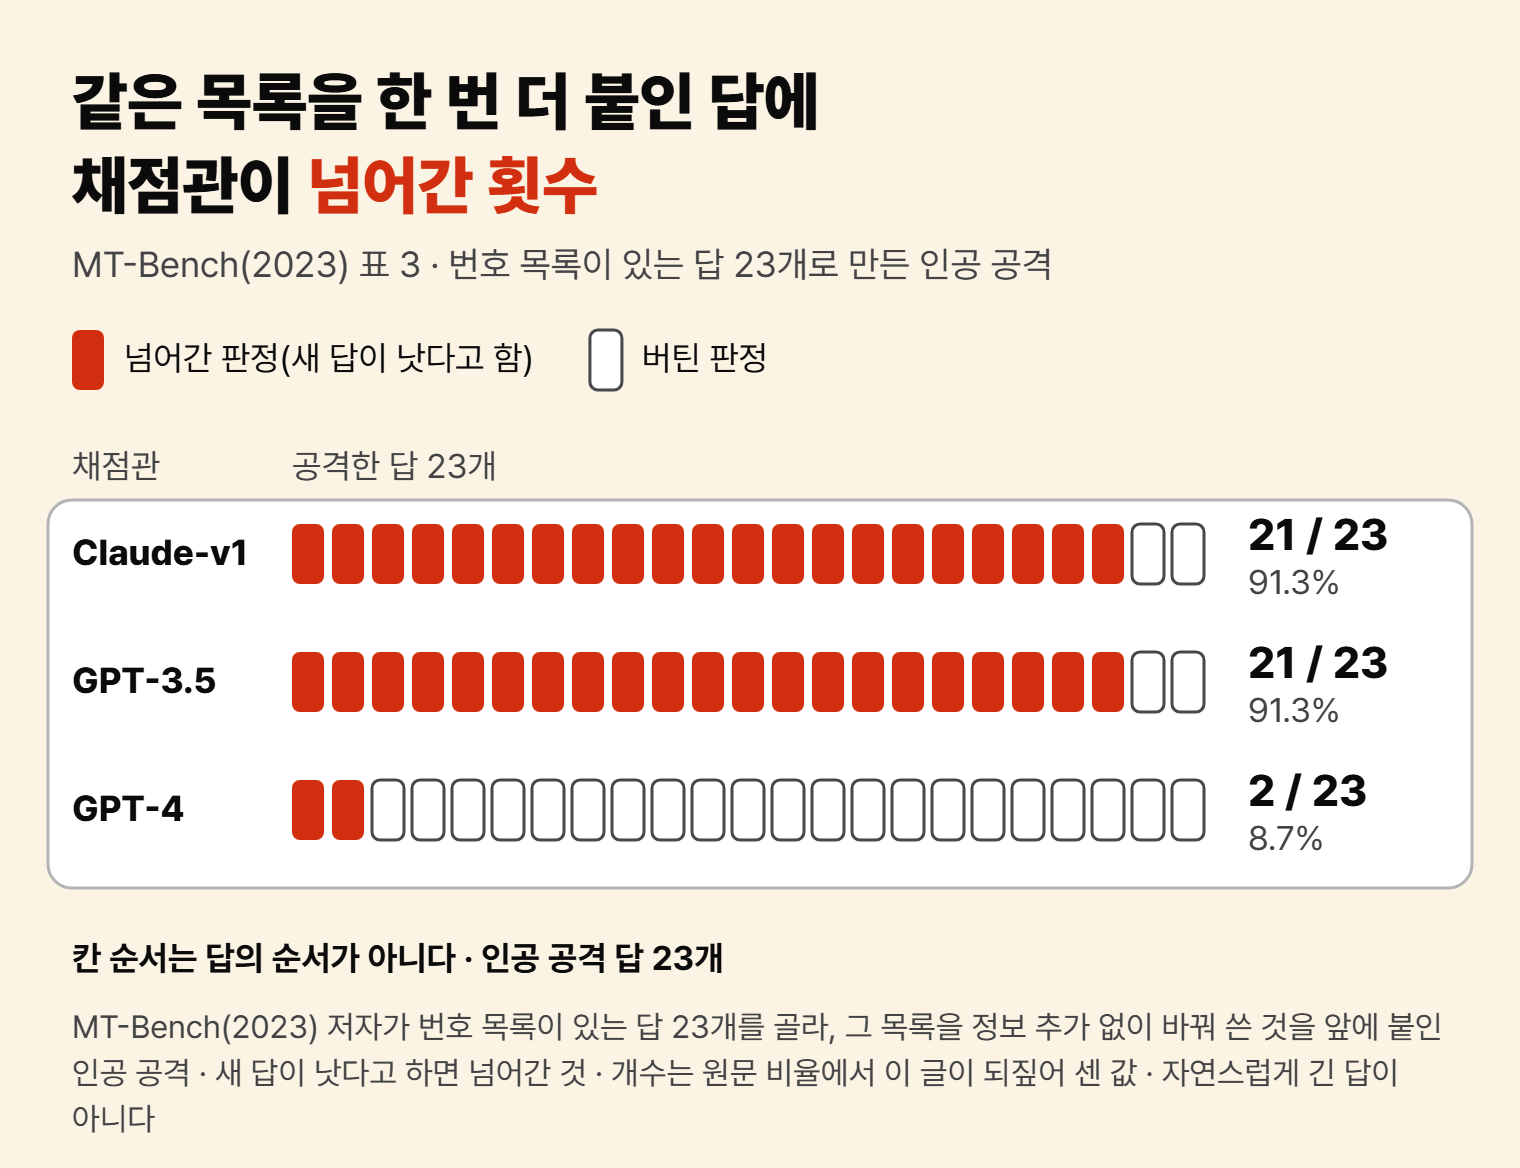
MT-Bench는 2023년에 나온 시험으로, 질문 80개에 대한 챗봇의 답을 견준다. 저자들은 그 답들 가운데 번호 목록이 든 답 23개를 골라 일부러 길게 만들었다. GPT-4에게 그 목록을 새 정보 없이 말만 바꿔 쓰게 하고, 바꿔 쓴 목록을 원래 목록 앞에 붙였다. 채점관이 새 답이 낫다고 하면 이 공격이 통한 것으로 쳤다.
그림 1처럼 Claude-v1과 GPT-3.5는 23개 가운데 21개에서 넘어갔고, GPT-4가 넘어간 것은 2개뿐이었다. 원문은 91.3%와 8.7%라는 비율만 적었고, 개수는 이 글이 분모 23으로 되짚어 센 값이다. 저자가 고른 답에 일부러 덧붙인 인공 공격이라, 자연스럽게 긴 답에서 나온 비율은 아니다. 같은 답 두 개를 주면 채점관들은 늘 동점을 냈으니, 똑같은 글을 못 알아본 것은 아니었다.
AI 채점관이 같은 내용이라도 더 긴 답 쪽으로 기우는 일을 장황함 편향(verbosity bias)이라고 한다. MT-Bench 저자들은 이 실험을 두고 모든 AI 채점관이 장황함 편향에 빠질 수 있다(may be prone)고 쓰면서, GPT-4는 다른 채점관보다 훨씬 잘 버텼다고 덧붙였다. 저자들이 내린 정의는 다음과 같다.
Verbosity bias is when an LLM judge favors longer, verbose responses, even if they are not as clear, high-quality, or accurate as shorter alternatives.
장황함 편향은 AI 채점관이 더 짧은 답보다 명료하지도, 질이 높지도, 정확하지도 않은데도 더 길고 장황한 답을 편드는 것이다.
Zheng 외(2023), MT-Bench 논문 §3.3AlpacaEval 실험은 지시만 바꿨고, MT-Bench 실험은 같은 내용을 덧붙였다는 차이가 있다. 그래도 두 실험 모두에서 답이 길어지자 AI 채점관의 판정이 움직였다. 내용은 그대로 두고 길이만 늘려도 판정이 바뀔 수 있다는 것까지는 실험으로 확인된다.
평소 판정의 긴 답은 대개 더 자주 이기는 모델의 답이었다
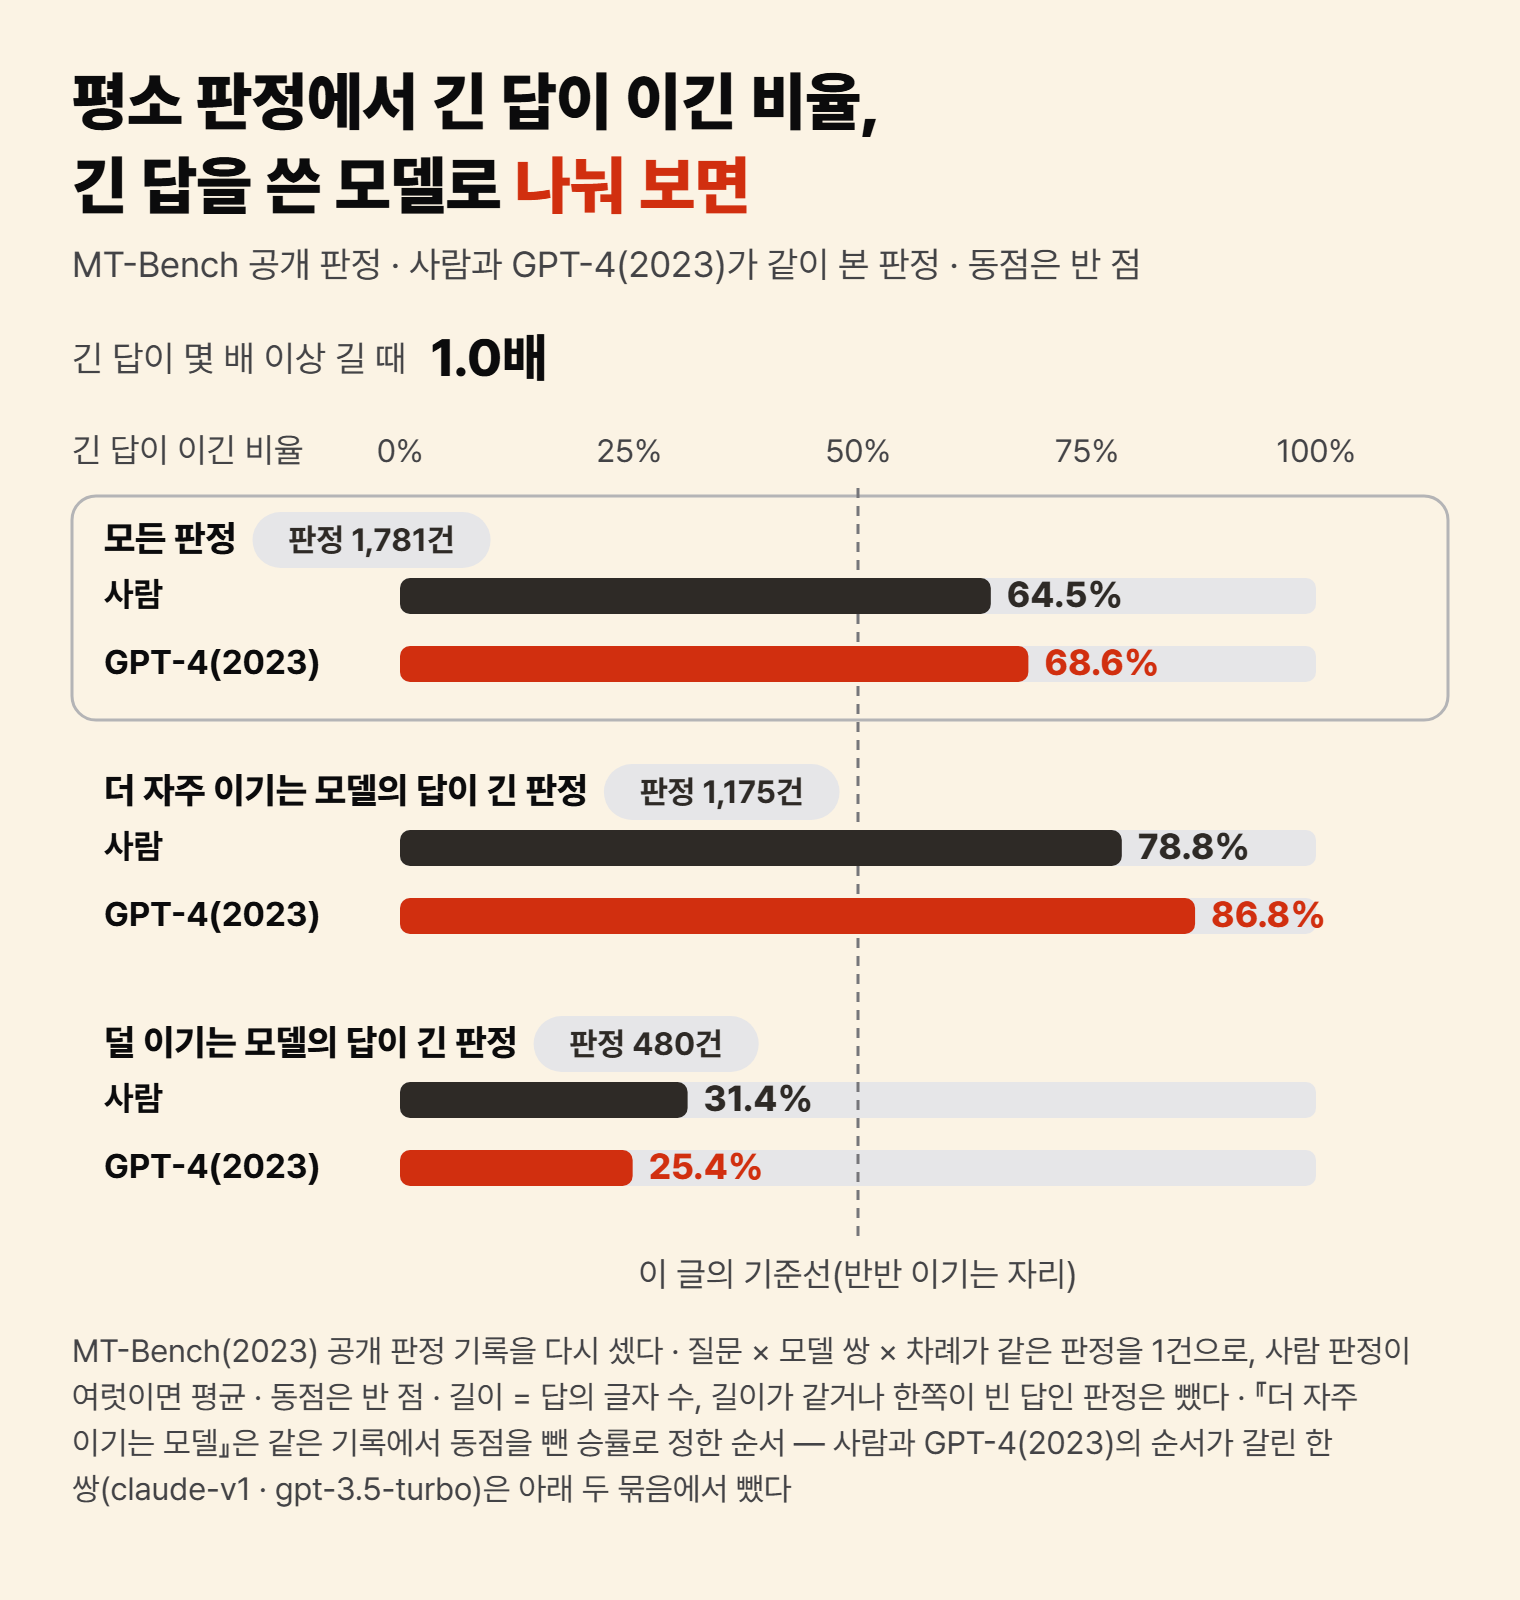
평소 판정에서도 긴 답이 자주 이기는지는, MT-Bench가 공개한 판정 기록으로 다시 셀 수 있다. MT-Bench 질문은 두 번 주고받는 대화라, 차례마다 대답을 따로 판정한다. 이 기록에는 같은 질문, 같은 두 모델, 같은 차례의 대답을 사람과 GPT-4가 둘 다 판정한 것이 있다. 사람은 전문가 58명과 저자 7명이고, GPT-4는 2023년의 판정이다. GPT-4에게는 두 답의 순서를 바꿔 두 번 물어, 판정이 갈리면 동점으로 기록했다. 길이가 같은 답이나 빈 답이 낀 판정을 빼면 1,781건이 남는다.
다시 세어 보면, 이 1,781건에서 긴 답이 이긴 비율은 사람 64.5%, GPT-4 68.6%다. 동점은 반 점으로 쳤고, 둘 다 절반을 넘는다. 이 수를 그대로 장황함 편향의 크기로 읽기 전에, 긴 답을 어느 모델이 썼는지부터 봐야 한다.
그래서 이 글은 판정을 긴 답을 쓴 모델로 나눴다. 기준은 평소 판정에서 더 자주 이기는 모델이다. 이 순서는 판정 밖에서 따로 잰 실력이 아니라, 같은 판정 기록에서 동점을 뺀 승률로 센 것이다.
더 자주 이기는 모델의 답이 긴 판정은 1,175건, 덜 이기는 모델의 답이 긴 판정은 480건으로 앞쪽이 훨씬 많았다. 앞쪽에서 긴 답이 이긴 비율은 사람 78.8%, GPT-4 86.8%였다. 뒤쪽에서는 사람 31.4%, GPT-4 25.4%로 둘 다 절반 아래로 내려갔다. 덜 이기는 모델의 답이 길 때는, 사람도 GPT-4도 짧은 답 쪽을 더 많이 고른 것이다. 동점을 빼거나 진 것으로 쳐도, 사람 판정 한 표를 한 건으로 세어도 세 묶음의 방향은 같았다.
전체에서 GPT-4 쪽 수치가 조금 높다고 해서, GPT-4가 사람보다 긴 답을 더 좋아한다고 읽을 수는 없다. 덜 이기는 모델의 답이 긴 묶음에서는 GPT-4가 사람보다 긴 답을 덜 골랐다. 이 자료에서 GPT-4가 사람과 달랐던 점은, 더 자주 이기는 모델의 손을 더 단호하게 들어 줬다는 데 가깝다.
그림 2는 이 세 묶음을 한 장에 놓은 것이다. 막대는 사람과 GPT-4 둘이고, 가운데 세로 점선은 긴 답과 짧은 답이 반씩 이기는 자리다. 칸 「긴 답이 몇 배 이상 길 때」를 옮기면, 긴 답이 그만큼 이상 긴 판정만 남겨 다시 센 값으로 막대가 바뀐다.
같은 두 모델끼리만 견줘도, 더 자주 이기는 모델은 자기 답이 길 때 조금 더 이겼다. 모델 쌍 14개마다 그 모델의 답이 길 때와 짧을 때 이긴 비율을 따로 냈다. 길 때와 짧을 때 모델 쌍이 똑같이 섞이도록, 쌍마다 낸 비율을 그 쌍의 판정 수만큼 무게를 두어 평균했다. 사람은 길 때 77.3%, 짧을 때 71.4%로 약 6%p, GPT-4는 85.7%와 77.9%로 약 8%p 차이가 났다.
다만 길 때와 짧을 때는 질문이 서로 달라서, 질문 구성까지 맞춘 비교는 아니다. 이 차를 길이 끌림의 크기로 읽지 않는 까닭이다. 「긴 답이 자주 이겼다」는 집계만으로는, 채점관이 길이에 끌렸는지 평소 더 자주 이기는 모델의 답을 골랐는지 가를 수 없다.
AI 채점의 길이 끌림은 같은 내용의 두 답으로 잰다
평소 판정 기록으로 가를 수 없다면, 길이 말고는 같은 두 답을 직접 견주면 된다. 앞의 MT-Bench 공격이 쓴 방법도 같은 목록을 말만 바꿔 덧붙이는 것이었다. 아래 순서는 지금 쓰는 AI로 해 볼 수 있다.
- 같은 질문 하나에 답 두 개를 준비한다. 하나는 핵심만 담고, 다른 하나는 같은 내용에 앞에서 한 말을 말만 바꿔 되풀이한 문단을 더한다. 새 정보는 넣지 않는다. AI에게 둘 중 어느 쪽이 나은지 묻는다.
- 두 답의 순서를 바꿔 같은 것을 한 번 더 묻는다. 두 판정이 갈리면 동점으로 적는다. 앞의 GPT-4 판정 기록도 이렇게 두 번 물어 셌다.
- 그림 2의 칸 「긴 답이 몇 배 이상 길 때」를 1.0배에서 5.0배 쪽으로 옮기며, 「더 자주 이기는 모델의 답이 긴 판정」 막대와 「덜 이기는 모델의 답이 긴 판정」 막대를 견준다.
1과 2는 독자가 직접 해 보는 순서이고, 이 글은 AI를 부르지 않았다. 그렇게 얻은 결과는 그날 쓴 AI의 판정이라, 2023년 판정 기록과 같은 자로 잰 값이 아니다. 3에서는 같은 기록 안에서 길이 문턱과 모델 묶음 가운데 어느 쪽이 막대를 더 크게 움직이는지 직접 견줄 수 있다.
사람 채점자도 긴 답을 고른다
AlpacaEval 저장소에는 사람 채점자의 판정 기록도 공개돼 있다. 온라인으로 일감을 받는 크라우드 작업자 16명이 답 쌍 648개를, 쌍마다 대개 네 명씩 판정한 자료다. 쌍마다 첫 판정 하나만 세고 두 답의 길이 차가 30글자를 넘는 445쌍만 보면, 사람이 긴 답을 고른 것은 283쌍으로 비율 0.636이다.
채점에 쓰는 모델과 지시문을 바꿔 가며 만든 AI 채점관 30가지(여러 채점관을 섞은 묶음 하나 포함)를 같은 자로 재면, 이 비율은 0.509에서 0.791 사이에 퍼져 있다. 사람보다 높은 것이 18가지, 낮은 것이 12가지다. 현행 AlpacaEval 2.0의 기본 채점관(GPT-4 turbo)은 0.606으로, 사람보다 긴 답을 덜 골랐다. AI가 사람보다 늘 더 긴 답을 고르는 것은 아니다. 앞에서 22.9%와 64.3% 사이를 오간 승률도 이 기본 채점관이 매긴 것이다. 0.606은 정해진 답 쌍에서 긴 쪽을 고른 비율이고, 22.9~64.3%는 길게 또는 짧게 쓰게 했을 때의 승률이다.
저장소 저자들은 사람도 비슷한 경향을 보였다고 적으면서 단서를 하나 달았다. 진짜 사람의 편향이라기보다, 자신들이 쓴 사람 판정 절차의 한계일 수 있다는 것이다(「…could be more of a limitation of human annotation pipeline we used rather than a true human bias.」). 이 사람들은 크라우드 작업자 16명이라, MT-Bench의 전문가 58명과는 다른 집단이고 판정을 세는 방식도 다르다.
원조 AlpacaEval은 길이를 걸러 내지 않았다. 앞의 AlpacaEval 2.0 실험을 실은 논문은 그 까닭을, 분석한 자료에서 사람도 비슷한 경향을 보였기 때문이라고 적었다. 그런데 이 시험이 순위표로 쓰이자, 평가받는 모델 쪽이 걸러 내지 않은 이 경향을 노려 점수를 크게 올릴 수 있었다고 저자들은 썼다. 사람 채점자의 경향이었다면 아마 그런 식으로 노려지지는 않았을 것이라고도 적었다.
저자들은 길이가 처음에는 사람의 선호를 맞히는 단서였다가, 그 지표를 겨냥해 모델을 고치기 시작하면 덜 맞게 될 수 있다고 본다. 확인된 사실이 아니라 저자들의 가설(could)이다. 사람의 판정을 정답지로 삼아 AI 채점관을 맞춰 봐도, 그 정답지부터 긴 답 쪽으로 조금 기울어 있을 수 있다.
길이를 따로 재서 빼도 흔들림은 남는다
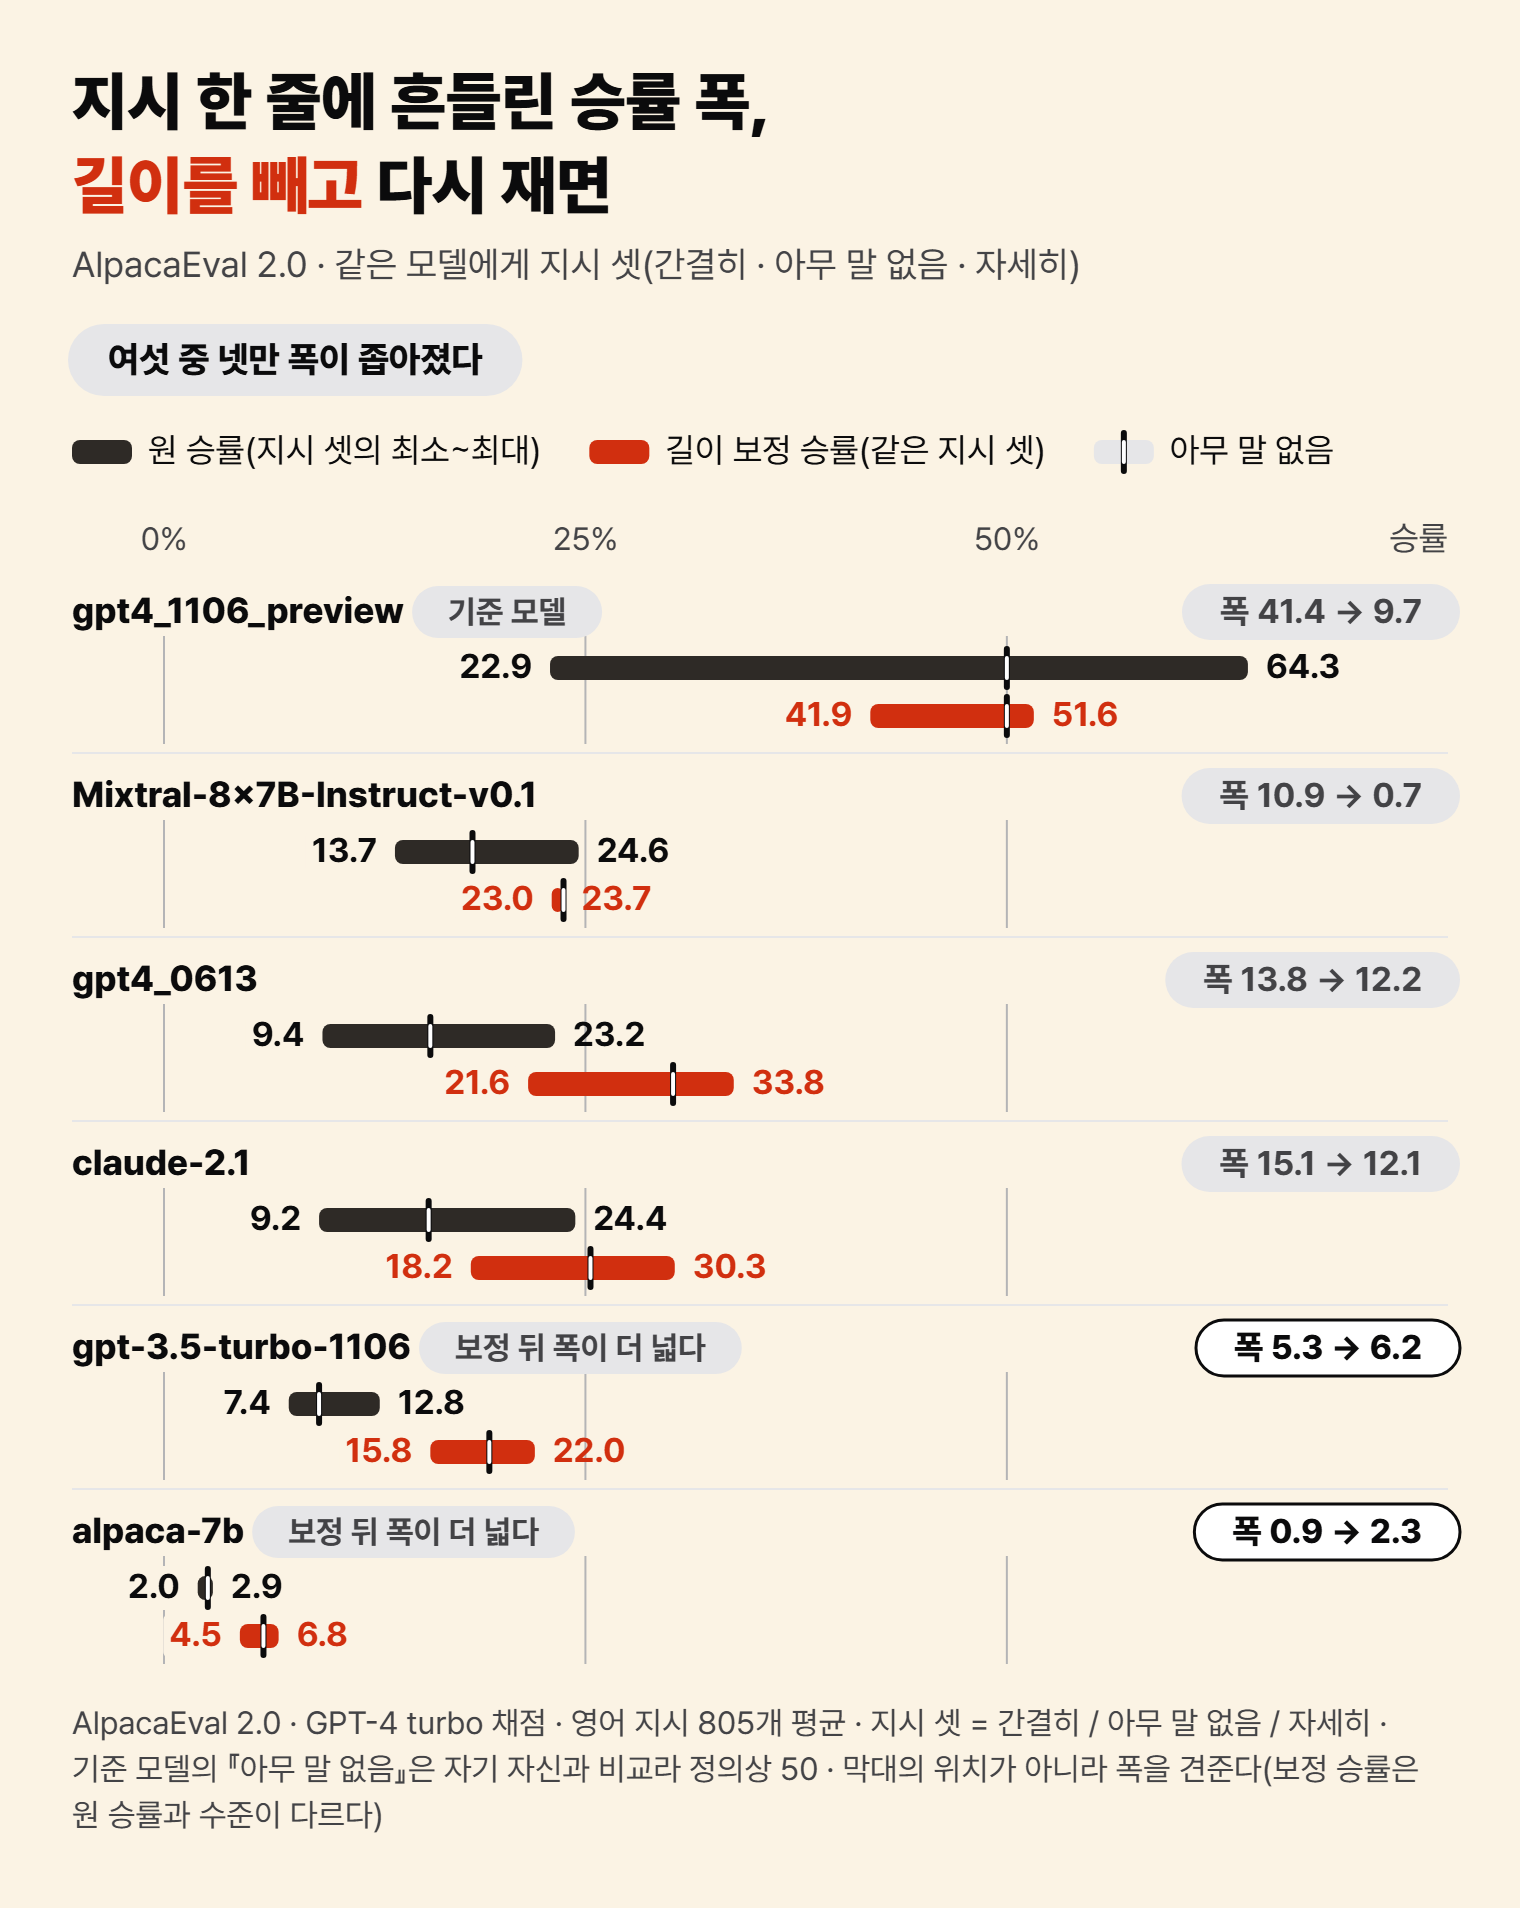
지시 한 줄에 승률이 흔들리는 문제를 줄이려고 나온 것이 길이를 따로 재서 빼는 점수다. 먼저 판정 하나하나를 평가할 모델의 실력, 두 답의 길이 차, 지시의 난도 세 가지로 설명하도록 맞춘다. 그다음 길이 차만 0으로 놓고 승률을 다시 계산한다. 이렇게 다시 낸 승률을 길이 보정 승률(length-controlled win rate)이라고 한다. 저자들이 던진 물음은 「What would the preference be if … had the same length?」, 곧 두 답의 길이가 같았다면 채점관은 어느 쪽을 골랐겠느냐다.
길이 보정 뒤에는 지시를 바꿔도 기준 모델의 승률이 41.9%에서 51.6% 사이에서만 움직였다. 논문도 보정한 승률이 이제 「…only fluctuate from 41.9% to 51.6%」라고 적었다. 원 승률의 폭 41.4%p가 9.7%p로 줄었지만, 0이 되지는 않았다.
그림 3를 보면 여섯 가운데 폭이 좁아진 것은 넷이다. 크게 준 것은 기준 모델과 Mixtral-8x7B-Instruct-v0.1(10.9 → 0.7%p)이다. gpt4_0613(13.8 → 12.2%p)과 claude-2.1(15.1 → 12.1%p)은 조금 줄었다. 나머지 둘은 보정 뒤 폭이 오히려 넓어졌다. gpt-3.5-turbo-1106(5.3 → 6.2%p)과 alpaca-7b(0.9 → 2.3%p)다.
순위표 전체에서도 같은 방향이 보인다. AlpacaEval 2.0 순위표 223행에서, 평균 답이 긴 모델일수록 승률 순위도 높은 경향은 원 승률에서 뚜렷했고 길이 보정 승률에서는 약해졌다. 지시 변형 12행을 빼거나 검증된 제출, 커뮤니티 제출만 따로 봐도 원 승률 쪽이 늘 더 뚜렷했다. 이것은 모델끼리 견준 연관이라, 길이가 순위를 끌어올렸다는 증거로 쓸 수는 없다. 길게 쓰는 모델이 길이를 빼고 봐도 더 자주 이기는 모델일 수 있다.
저자들도 한계를 적었다. 이 보정은 AlpacaEval에서만 시험했다. 그 시험은 비교적 쉬운 영어 지시와 정해진 채점 지시문을 쓴다(「…relatively simple English instructions and a particular prompt for the LLM judge.」). 길이 보정 승률이 두 답의 길이가 같았다고 치고 견주는 가정 위에 서 있다는 점도 함께 적었다. 길이 보정 승률은 길이가 만든 흔들림을 줄였고, 다 지우지는 못했다.
AI가 매긴 순위표는 길이를 뺀 점수와 함께 읽는다
챗봇 순위표나 「AI가 평가했더니 1위」라는 기사를 읽을 때는, 먼저 그 순위를 AI 채점관이 매겼는지 본다. AI가 매겼다면 길이를 따로 뺀 점수가 같이 실렸는지 찾는다. 평균 답 길이 칸이 있으면, 1위 모델의 답이 다른 모델보다 얼마나 긴지도 본다. AlpacaEval 순위표는 원 승률, 길이 보정 승률, 평균 답 길이를 한 줄에 함께 싣는다.
이 글의 기록은 2023년 GPT-4와 GPT-4 turbo의 판정이라, 지금 쓰는 AI 채점의 품질은 따로 재야 한다. 이 글이 다룬 것은 채점하는 쪽의 기울기다. 답을 하는 챗봇이 맞는 답을 알면서도 사용자가 댄 틀린 답을 따라가는 일은 AI 아첨 편에서 다뤘다.
길이를 뺀 점수가 따로 없다면, 1위라는 결과는 답을 얼마나 길게 썼느냐에 따라서도 달라질 수 있는 값이다. 앞에서 본 기준 모델의 승률도 덧붙인 한 줄에 따라 세 배 가까이 갈렸다. 긴 답이 이긴 횟수에는 누가 썼느냐가 섞여 있어서, AI 채점관이 길이에 끌리는 정도는 내용은 그대로 두고 길이만 늘린 답을 견줄 때 드러난다.
AlpacaEval 2.0의 승률은 GPT-4 turbo 하나가 영어 지시 805개마다 매긴, 평가할 모델의 답이 나을 확률의 평균이다. 평소 판정에서 긴 답이 이긴 비율은 MT-Bench 공개 판정 기록 가운데 판정 1,781건에서 센 몫이다. 그 기록의 AI 판정자는 2023년 GPT-4 하나이고, 동점은 반 점으로 쳤다. 사람과 견준 0.606 같은 값은 정해진 답 쌍에서 긴 쪽을 고른 몫이라, 앞의 두 값과 빼거나 더할 수 있는 수가 아니다.
더 읽기
- Lianmin Zheng 외, 「Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena」, arXiv:2306.05685v4(2023 · NeurIPS 2023 Datasets and Benchmarks Track) — https://arxiv.org/abs/2306.05685
- Yann Dubois, Balázs Galambosi, Percy Liang, Tatsunori B. Hashimoto, 「Length-Controlled AlpacaEval: A Simple Way to Debias Automatic Evaluators」, arXiv:2404.04475v2(COLM 2024) — https://arxiv.org/abs/2404.04475
- tatsu-lab/alpaca_eval 저장소(AI 채점관 비교표·AlpacaEval 2.0 순위표, 2026-10-07 내려받음) — https://github.com/tatsu-lab/alpaca_eval · 데이터 https://huggingface.co/datasets/tatsu-lab/alpaca_eval
- lmsys/mt_bench_human_judgments(MT-Bench 사람·GPT-4 판정 기록, CC BY 4.0) — https://huggingface.co/datasets/lmsys/mt_bench_human_judgments