같은 작품인데 내 화면과 가족 화면에 뜬 넷플릭스 썸네일이 다를 때가 있다. 넷플릭스는 작품마다 후보 썸네일을 여러 장 두고, 시청 기록 같은 회원 정보를 보고 사람마다 한 장을 고른다. 고르지 않은 그림이 먹혔을지는 알 수 없어서, 가끔 일부러 다른 한 장을 섞어 보며 배운다. 사람마다 다른 썸네일을 골라 보여 주는 이 일을 썸네일 개인화(artwork personalization)라고 한다.
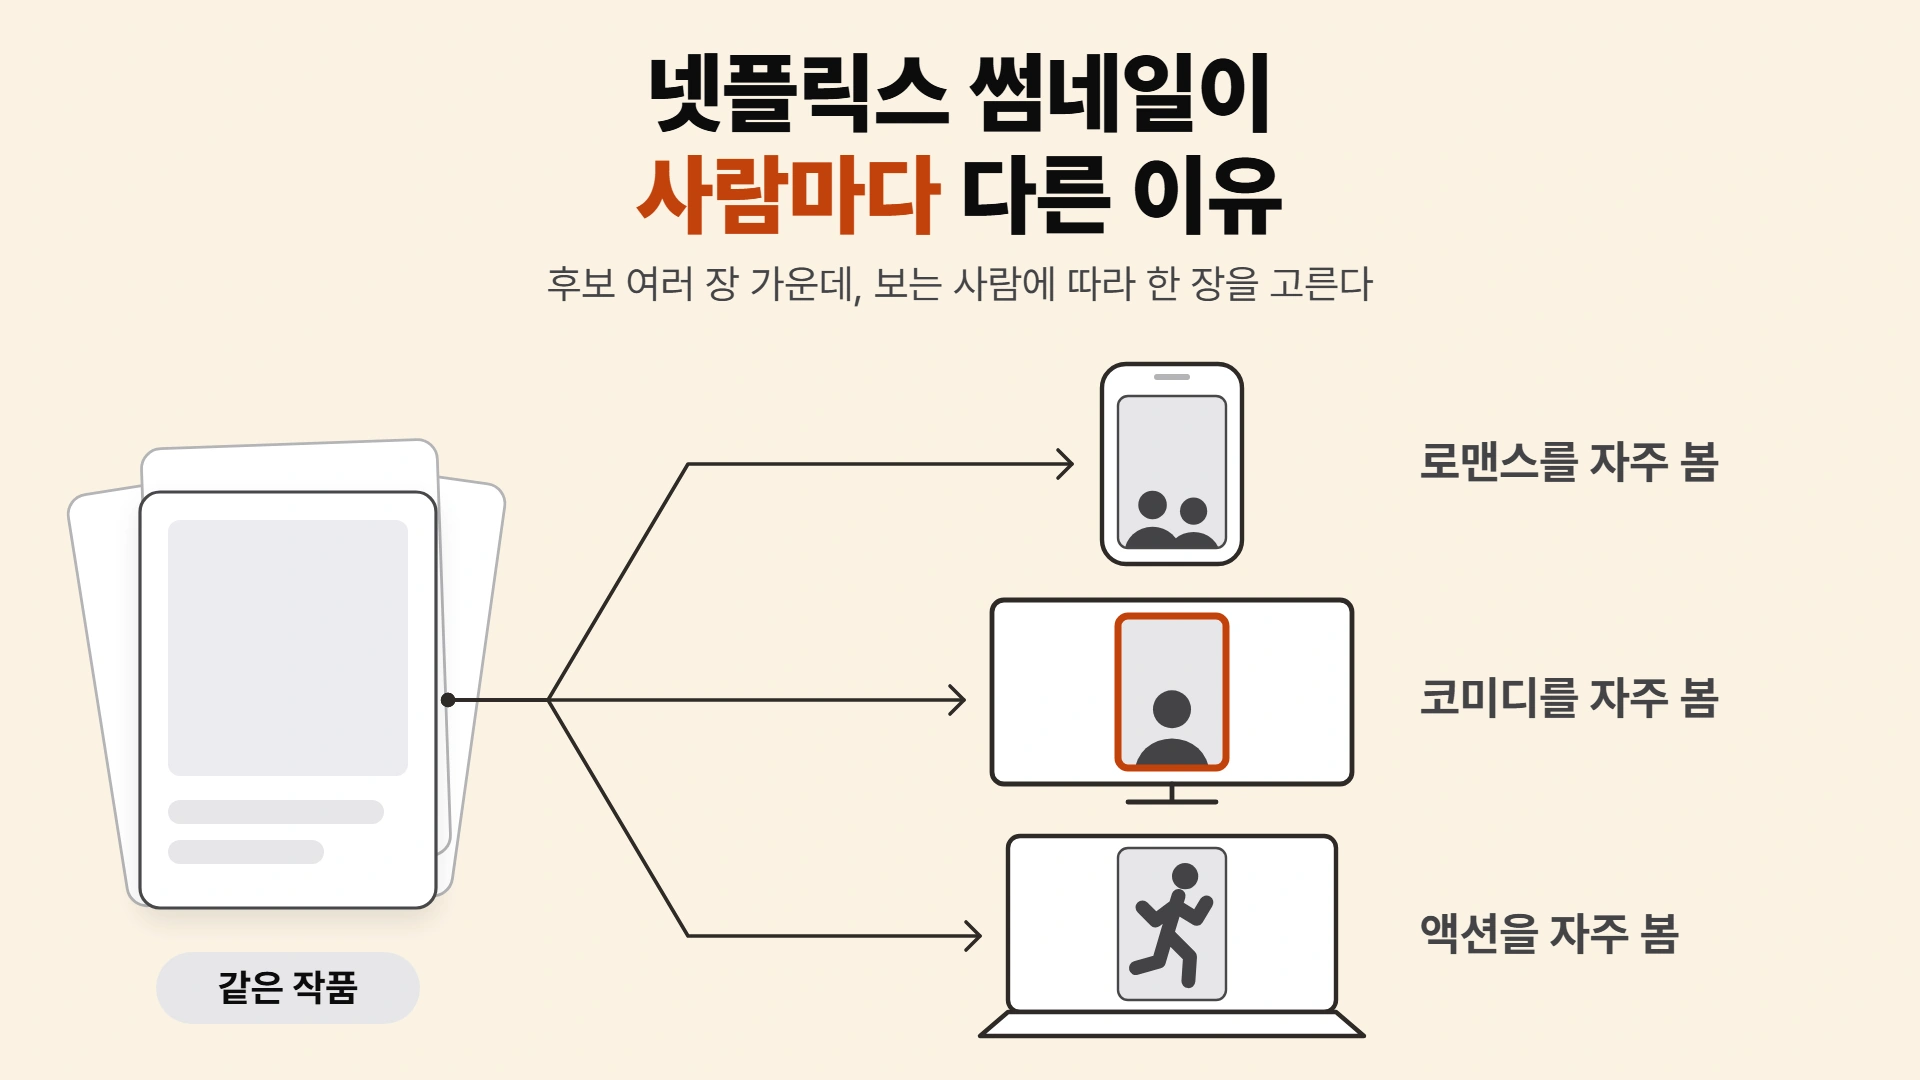
같은 작품인데 썸네일이 내 휴대폰에서는 두 주인공이 함께 선 그림이고, 거실 TV의 가족 프로필에서는 코미디 배우 한 사람의 그림이다. 넷플릭스 썸네일은 왜 사람마다 다를까? 넷플릭스는 같은 작품에 후보 썸네일을 여러 장 두고, 회원마다 시청 기록 같은 정보를 보고 그중 한 장을 골라 보여 주기 때문이다. 그리고 어떤 썸네일이 누구에게 먹히는지 배우려고, 가끔 일부러 다른 한 장을 섞어 보여 준다.
넷플릭스는 무엇을 보고 썸네일을 고를까
넷플릭스 기술 블로그에는 2017년에 실린 「Artwork Personalization at Netflix」라는 글이 있다. 이 글은 후보 그림이 작품마다 보통 수십 장까지 있다고 적었다. 2026년 넷플릭스·스탠퍼드 연구진의 논문은 작품마다 후보가 적게는 4장, 많게는 40장이 넘는다고 썼다.
그 가운데 어느 장을 보여 줄지는 보는 사람에 따라 달라진다. 2017년 글은 사람마다 그림에 다르게 반응하리라 보기 때문에 회원 자체를 고르는 기준으로 삼는다고 적었다. 넷플릭스가 든 예는 영화 「굿 윌 헌팅」이다. 로맨스 영화를 많이 본 사람에게는 두 주인공이 나온 그림을 보여 주면 이 영화에 관심을 보일 수 있다고 했다. 코미디를 많이 본 사람이라면 코미디 배우 로빈 윌리엄스가 나온 그림에 끌릴 수 있다고 덧붙였다.
넷플릭스가 썸네일에 이만큼 공을 들이는 데에는 이유가 있다. 2016년 넷플릭스 뉴스룸 글 「The Power of a Picture」는 넷플릭스가 2014년 초에 벌인 소비자 조사 몇 건을 소개했다. 그림이 볼 작품을 정하는 데 가장 큰 영향을 주고, 넷플릭스를 둘러보는 동안 시선의 82% 넘게가 그림에 간다는 결과였다. 그 조사를 어떻게 설계했는지는 공개하지 않았다.
어느 그림이 먹혔는지는 재생으로 센다. 그림을 보여 준 횟수 가운데 제대로 된 재생이 몇 번 나왔는지를 비율로 잰다. 여기서 「제대로 된」이 중요하다. 재생은 시작하게 만들지만 결국 제대로 보지 않게 되는 낚시 그림을 배우지 않으려고, 넷플릭스는 재생의 질을 따져 먹혔는지를 정한다고 썼다.
고르는 근거가 정확히 무엇인지는 문서마다 적은 것이 다르다. 넷플릭스가 2018년 언론에 낸 성명은 쓰는 정보가 회원의 시청 기록뿐이라고 했다. 2017년 글은 본 작품과 장르 말고도 나라, 쓰는 언어, 기기, 시간대와 요일을 고려할 수 있는 회원 정보로 들었다. 썸네일 고르기에 실제로 들어간 정보의 목록을 공개한 문서는 없다. 그래서 이 글은 고르는 근거를 「시청 기록 같은 회원 정보」라고 쓴다. 어느 쪽이든 내 화면에 뜬 썸네일은 작품에 붙은 고정된 한 장이 아니라, 넷플릭스가 나를 보고 후보 가운데서 고른 한 장이다.
모두에게 같은 썸네일 한 장으로는 왜 모자랄까
사람마다 따로 고르는 수고를 왜 들이는지 작은 세계를 하나 만들어 셈해 보자. 작품은 하나, 썸네일은 네 장이다. A는 두 주인공 얼굴, B는 코미디 배우, C는 추격 장면, D는 제목 글씨만 있는 그림이다. 회원은 세 유형으로, 로맨스파가 50%, 코미디파가 30%, 액션파가 20%다. 유형마다 각 그림을 한 번 봤을 때 재생할 확률은 표로 정해 두었다. 예를 들어 로맨스파는 A를 100번 보면 12번, 코미디파는 B를 100번 보면 11번 재생한다.
이 절부터 나오는 재생 수는 전부 우리가 정한 재생 확률 표에서 나온 값이다. 넷플릭스의 재생률이나 효과 크기가 아니다. 넷플릭스는 썸네일 개인화로 얼마나 더 재생됐는지 크기를 공개하지 않았다.
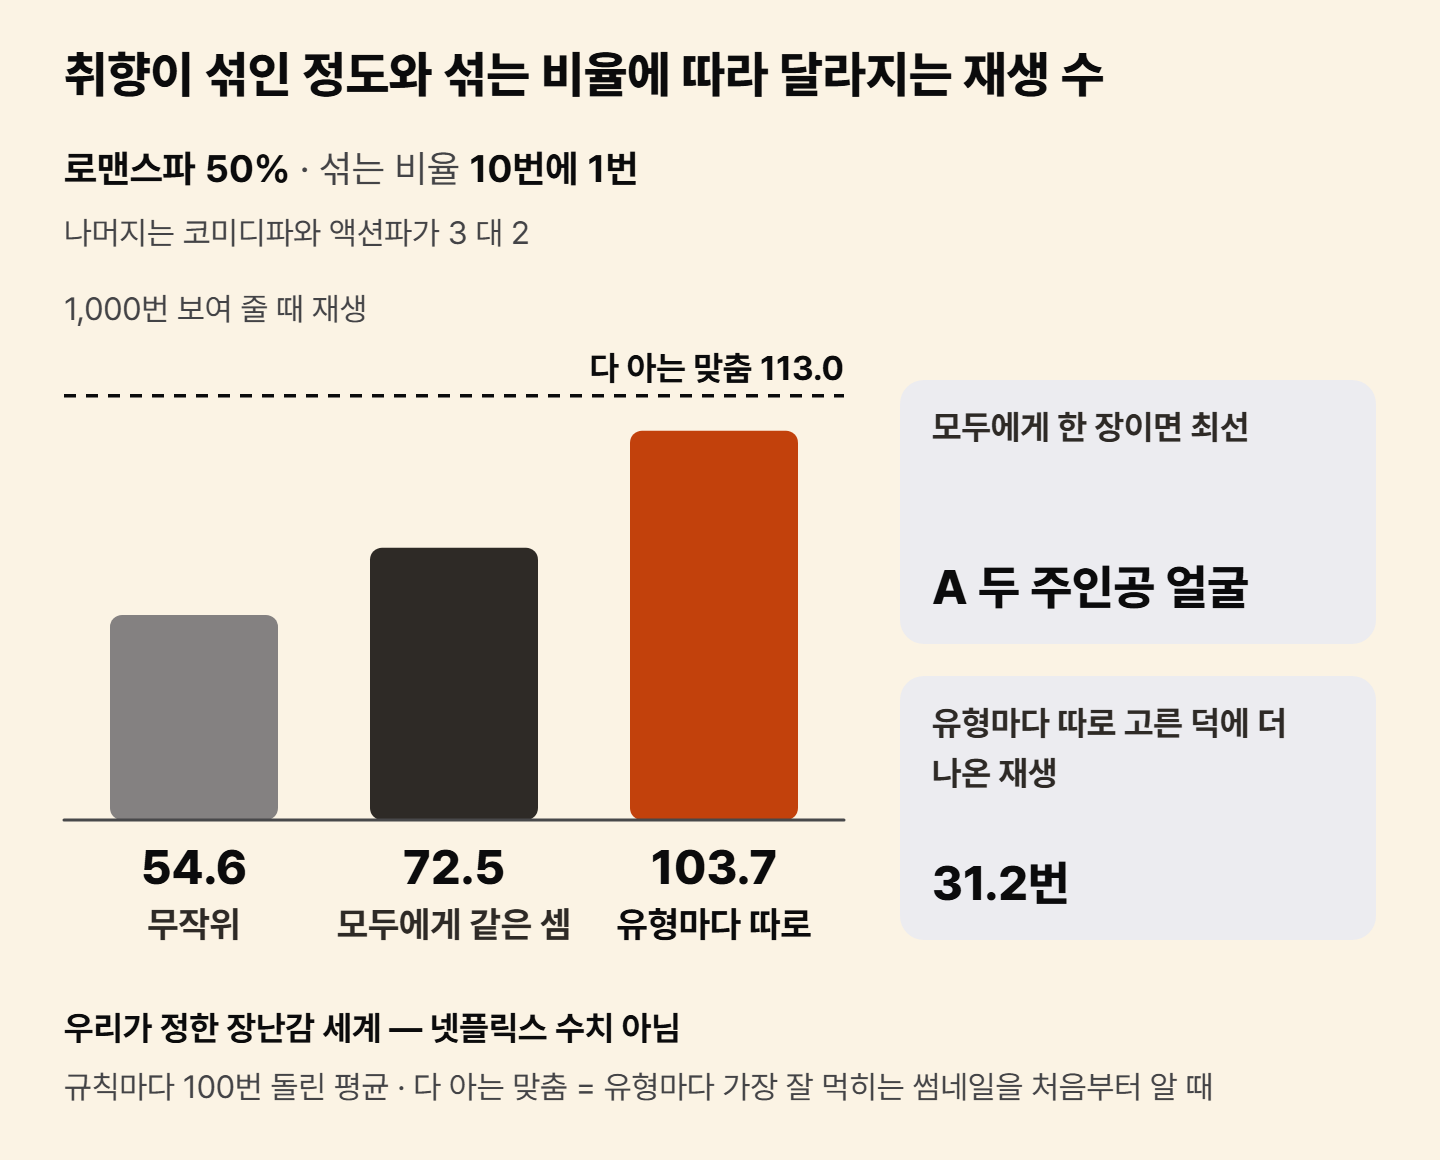
이 표로 썸네일을 1,000번 보여 줄 때 기대되는 재생을 바로 계산해 보자. 네 장 중 아무거나 보여 주면 54.8번이다. 모두에게 가장 잘 먹히는 한 장인 A를 보여 주면, 표에서 계산한 값은 76.0번이다. 유형마다 가장 잘 먹히는 그림을 처음부터 알고 따로 보여 주면 113.0번이다. 뒤의 그림에서는 정답을 다 알고 맞춘 이 값을 「다 아는 맞춤」이라고 적었다.
실제 규칙은 처음에 어느 그림이 잘 먹히는지 모르므로, 보여 주면서 배우는 규칙 두 가지를 돌려 보았다. 하나는 모두에게 같은 셈으로 고르는 규칙이다. 누가 보든 지금까지 재생 비율이 가장 높은 그림을 보여 준다. 다른 하나는 유형마다 따로 고르는 규칙으로, 로맨스파의 성적과 코미디파의 성적을 따로 매긴다.
두 규칙 모두 재생을 세어 성적을 고쳐 가고, 10번에 1번은 일부러 네 장 중 아무거나 섞는다. 이렇게 성적과 상관없이 아무 그림이나 섞어 보여 주는 몫을 이 글에서는 「섞는 비율」이라고 부른다. 규칙마다 200번씩 따로 돌려 평균을 냈다.
두 규칙의 차이는 「놓친 재생」으로 보인다. 놓친 재생은 그 사람 유형에게 가장 잘 먹히는 썸네일을 보여 줬다면 기대되는 재생과, 실제로 보여 준 그림의 기대 재생의 차를 쌓은 것이다. 회원이 실제로 손해 본 시청 시간이 아니라, 이 셈 안에서 덜 나온 재생 횟수의 기댓값이다. 그림 1를 보면 모두에게 같은 셈으로 고르는 규칙은 다 배운 뒤에도 1,000번마다 약 39번씩 놓친 재생이 계속 쌓인다. 유형마다 따로 고르는 규칙은 일부러 섞는 몫인 약 6번씩만 쌓인다.
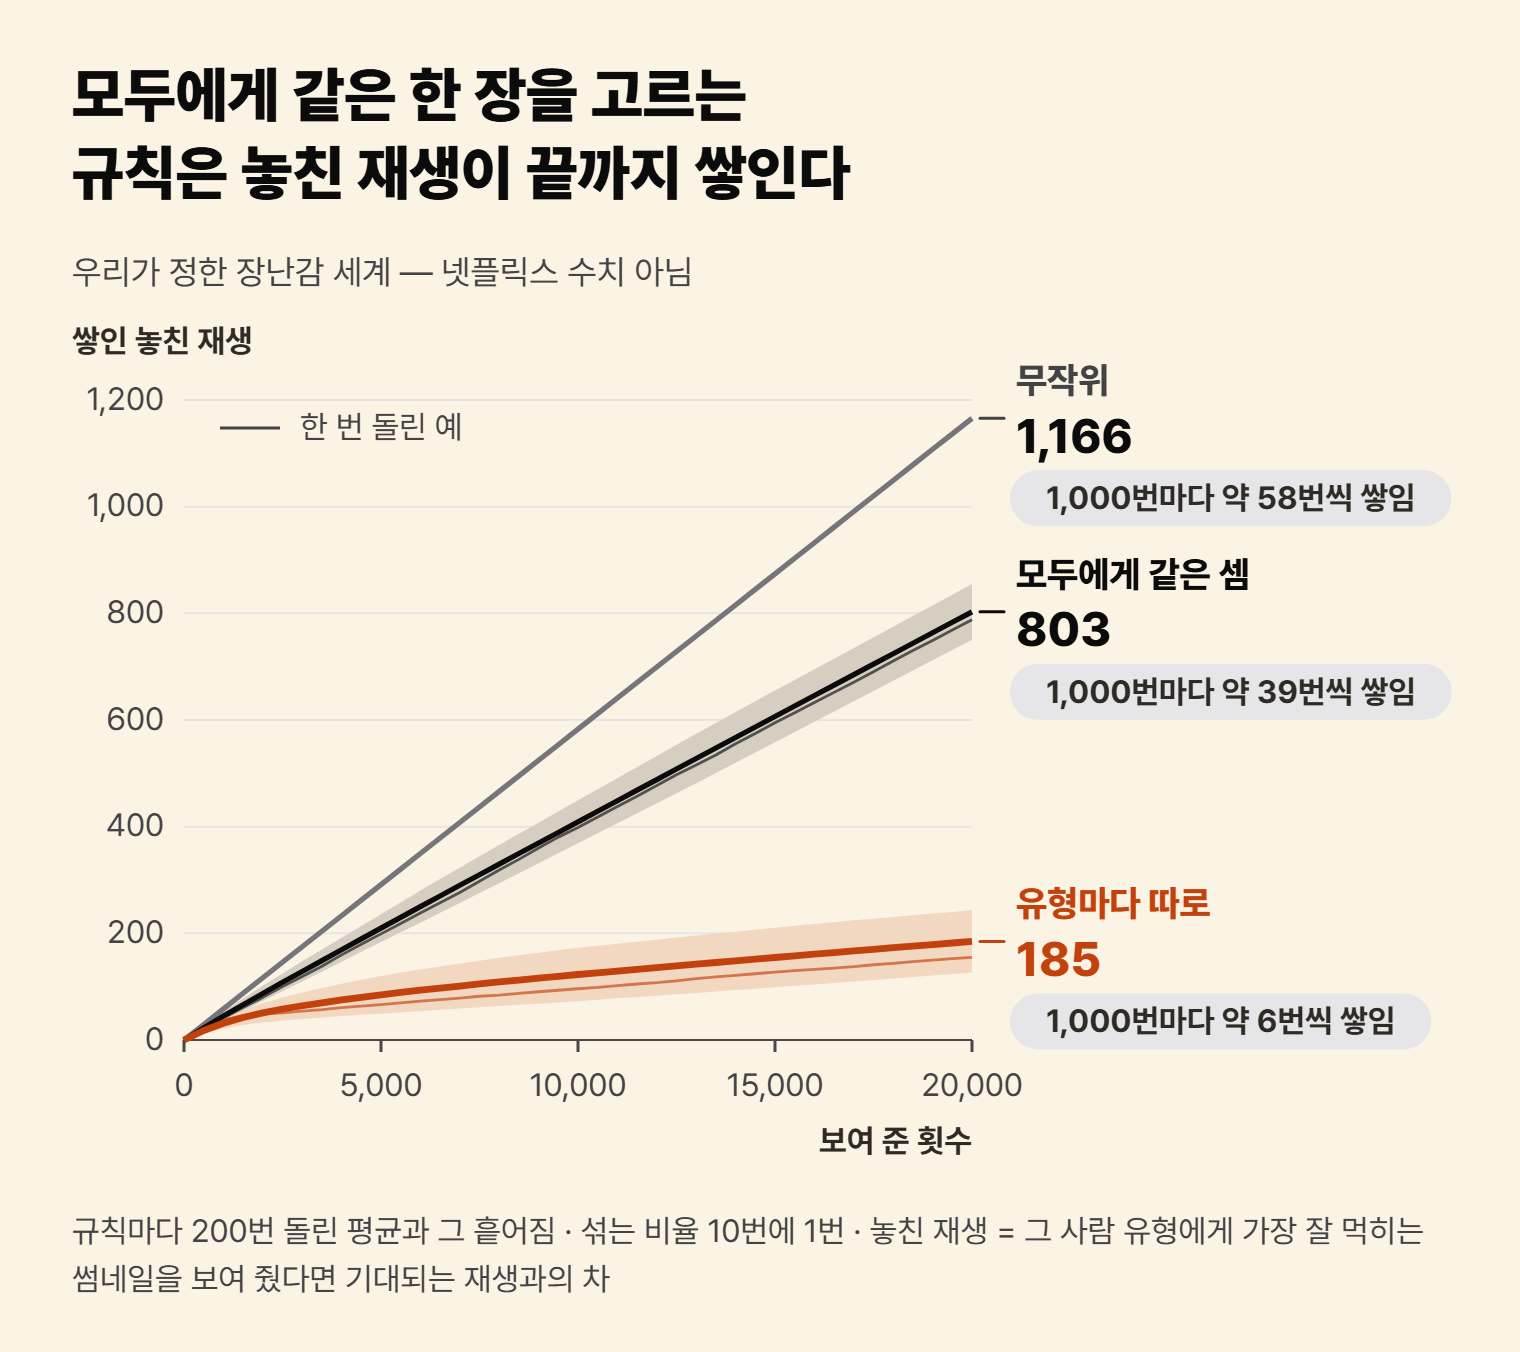
모두에게 같은 셈은 결국 대부분의 회원에게 A를 보여 주게 된다. A는 로맨스파에게는 잘 먹히지만, 코미디파와 액션파에게는 매번 덜 먹히는 그림이다. 이 손해는 배움이 끝나도 줄지 않는다. 누가 보든 같은 한 장을 고르는 규칙에는 코미디파에게 B를 보여 줄 방법이 없기 때문이다.
그림 2에서는 로맨스파 비율과 섞는 비율을 바꿔 가며 이 차이가 어떻게 달라지는지 볼 수 있다. 그림의 막대는 규칙을 직접 돌린 평균이라, 배우는 동안 덜 맞춘 몫과 섞는 몫만큼 앞에서 표로 계산한 값보다 낮게 나온다. 로맨스파가 50%에서 80%로 늘면, 유형마다 따로 고른 덕에 더 나온 재생이 섞는 비율 셋 모두에서 줄어든다. 모두가 거의 같은 취향이면 모두에게 한 장을 보여 줘도 크게 놓치지 않기 때문이다. 로맨스파를 20%로 낮추면 다른 일이 생긴다. 이때는 코미디파가 48%로 가장 많아서, 모두에게 한 장을 보여 줄 때의 최선이 A가 아니라 B로 바뀐다.
취향이 얼마나 갈려 있는지는 세계마다 다르다. 그래도 로맨스파 50%, 코미디파 30%, 액션파 20%처럼 취향이 갈려 있는 한, 모두에게 같은 한 장은 어느 한쪽 취향의 회원에게는 늘 덜 먹히는 그림이 된다. 사람마다 따로 고르는 수고는 그 덜 먹힌 몫을 되찾는 일이다.
왜 가끔 내 취향이 아닌 썸네일이 뜰까
앞 절의 두 규칙은 10번에 1번씩 일부러 아무 그림이나 섞었다. 손해를 보면서 왜 섞을까? 넷플릭스는 그 이유를 한 장만 보여 줄 수 있다는 데서 찾는다.
One challenge of image personalization is that we can only select a single piece of artwork to represent each title in each place we present it. … This means that image selection is a chicken-and-egg problem operating in a closed loop: if a member plays a title it can only come from the image that we decided to present to that member.
그림 개인화의 어려움 하나는, 작품을 보여 주는 자리마다 그 작품을 대표할 그림을 한 장만 고를 수 있다는 것이다. … 그래서 그림 고르기는 닭이 먼저냐 달걀이 먼저냐 하는 문제가 되고, 그 안에서 맴돈다. 회원이 작품을 재생했다면 그 재생은 우리가 그 회원에게 보여 주기로 정한 그림에서만 나올 수 있다.
넷플릭스 기술 블로그, 「Artwork Personalization at Netflix」(2017)보여 주지 않은 그림이 그 사람에게 먹혔을지는 기록에 남지 않는다. 처음에 먼저 재생을 얻은 그림만 계속 보여 주면, 다른 그림은 다시 시험받을 기회가 없다. 그래서 넷플릭스는 일부러 무작위를 섞는다. 2017년 글은 일정 비율로 아무 그림이나 고르는 단순한 방식부터, 모델이 얼마나 확신하는지에 따라 섞는 정도를 바꾸는 방식까지 예로 들었다. 2026년 넷플릭스·스탠퍼드 논문도 지금 운영 중인 썸네일 고르기에 무작위로 고르는 몫이 있다고 언급했다.
섞으면 그만큼 덜 맞춘다. 넷플릭스는 회원이 1억 명이 넘어서, 섞어 보느라 놓치는 몫이 대개 아주 작고 많은 회원에게 나뉜다고 적었다. 얼마나 작은지 수치는 밝히지 않았다. 같은 글은 섞는 일을 조절해 그림이 너무 자주 바뀌지 않게 할 수 있다고도 썼다. 그래야 회원의 재생이 어느 그림 덕인지 더 깨끗하게 가를 수 있다는 설명이다. 그림이 자꾸 바뀌면 보는 사람이 헷갈릴 수 있다는 걱정은 다른 대목에 따로 적었다.
이렇게 여러 선택지 가운데 하나를 고르고, 결과를 보며, 가끔 섞어 보면서 고르는 법을 배우는 규칙을 밴딧(bandit)이라고 부른다. 슬롯머신 여러 대 중 어느 걸 당길지 정하는 문제에서 온 이름이다. 회원 정보를 보고 사람마다 따로 고르면 맥락을 보는 밴딧(contextual bandit), 누구에게나 같은 셈을 쓰면 맥락 없는 밴딧이다. 앞 절의 「유형마다 따로 고르는 규칙」과 「모두에게 같은 셈으로 고르는 규칙」이 바로 이 둘이었다.
이번에는 섞는 비율을 여섯 단계로 바꿔 가며 맥락을 보는 밴딧을 단계마다 200번씩 돌렸다. 섞지 않을 때는 유형마다 네 장을 처음 한 번씩만 보여 본 뒤, 그때까지 재생 비율이 가장 높은 한 장만 계속 보여 준다. 재생 비율이 같으면 목록의 첫 그림인 A를 고른다. 20,000번 보여 준 뒤 놓친 재생이 미리 정해 둔 문턱 600을 넘으면 「갇혔다」고 셌다.
그림 3를 보면 섞지 않을 때는 200번 가운데 160번이 갇혔다. 처음 한 번씩 보여 볼 때는 재생이 드물어 네 장의 비율이 같기 쉽고, 그러면 A가 거듭 나간다. 그렇게 먼저 재생을 얻은 그림이 끝까지 나간 것이다. 100번에 1번만 섞어도 갇힌 횟수는 32번으로 줄고, 10번에 1번 섞으면 0번이다. 10번에 3번 섞으면 갇히지는 않지만 섞는 몫만큼 덜 맞춰, 놓친 재생이 10번에 1번일 때의 173에서 371로 늘었다. 이 비교는 견준 여섯 가지 비율 안에서의 이야기이고, 전부 섞으면 매번 네 장 중 아무거나 고르는 것이라 정의상 무작위와 같다.
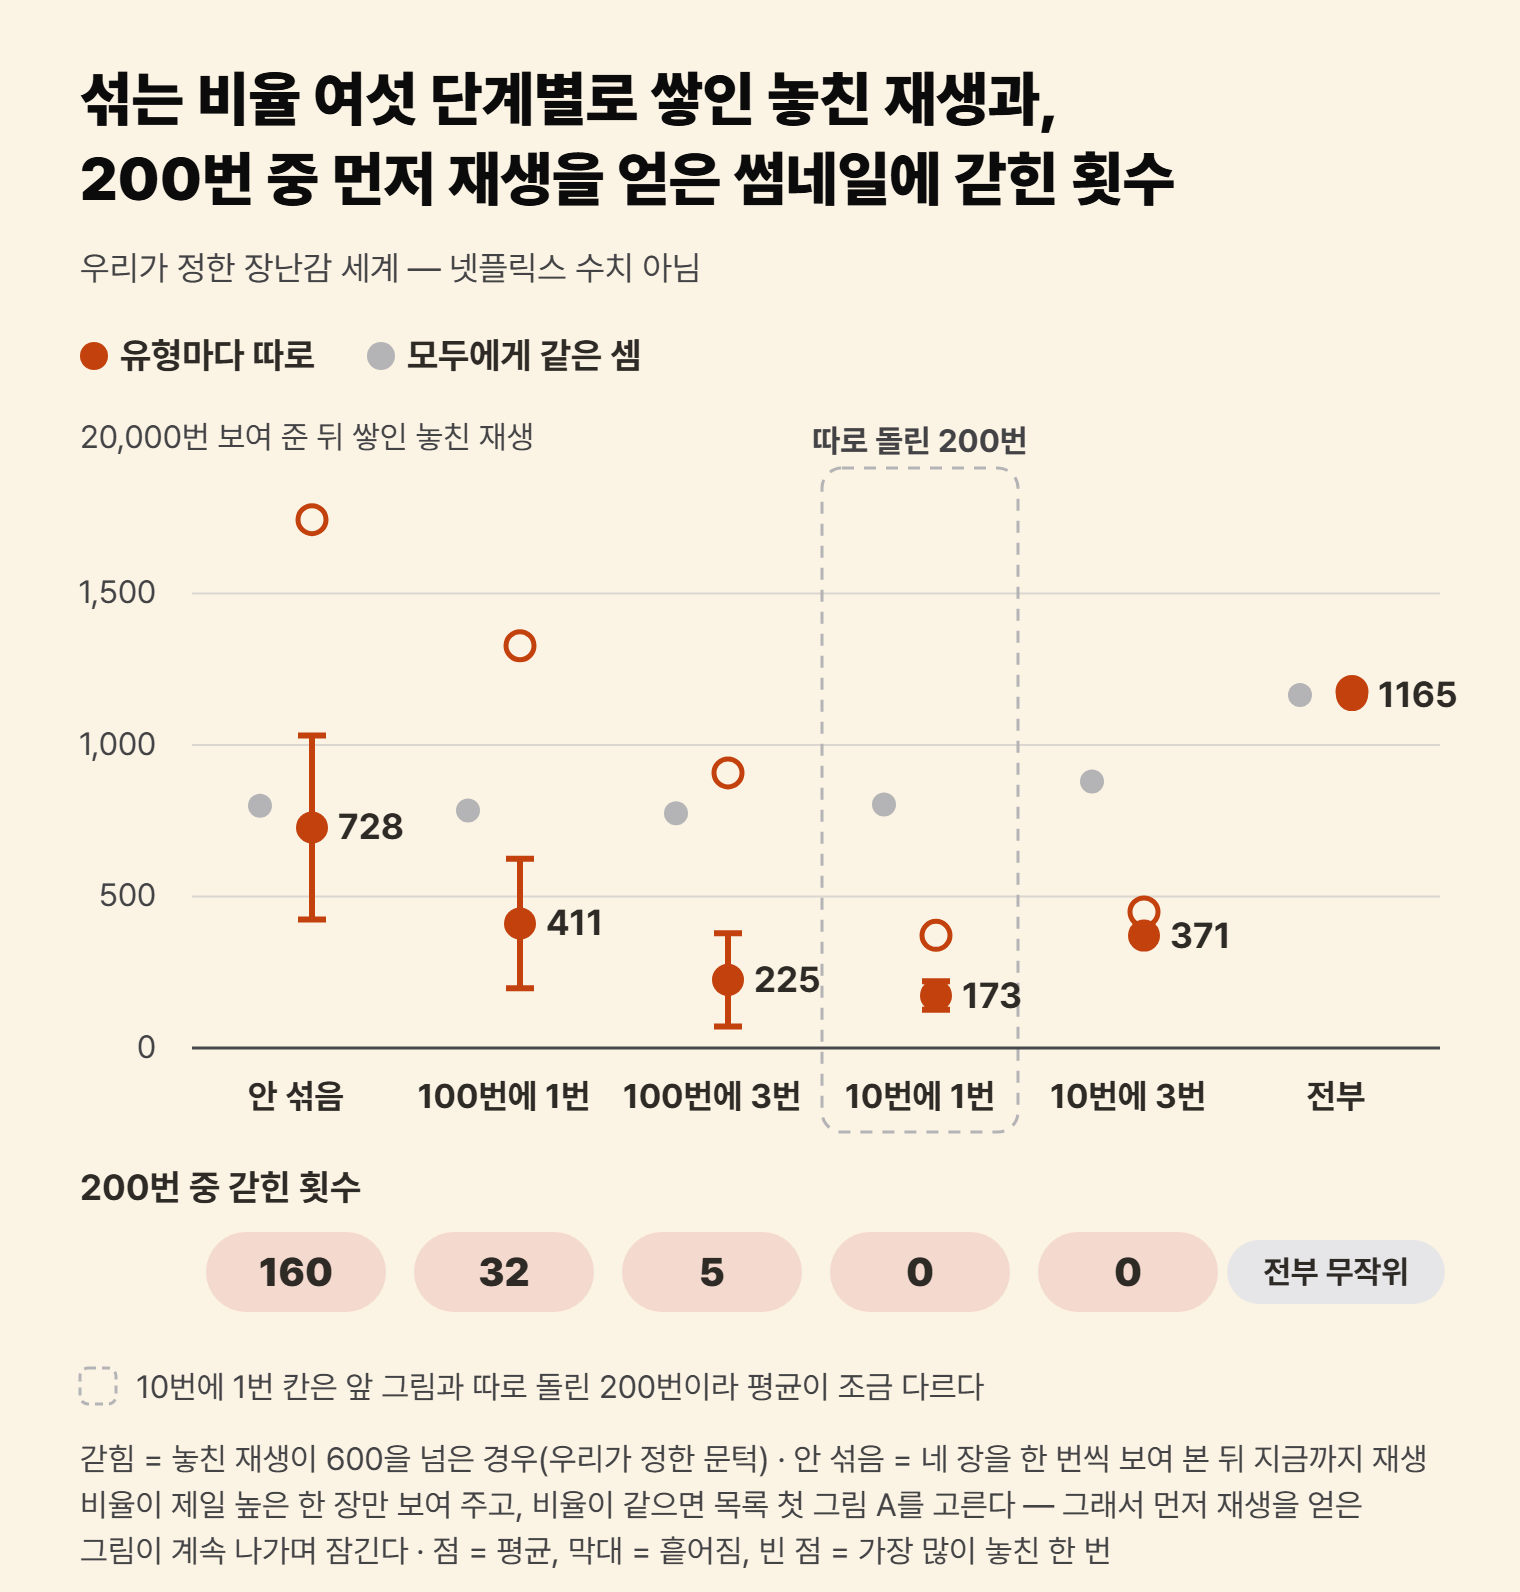
한 장만 보여 줄 수 있으면, 섞어 보지 않을 때 먼저 재생을 얻은 그림에 갇히기 쉽다. 섞어 본 한 장이 잘 먹히면, 그 그림은 다음부터 같은 취향의 회원에게 더 자주 나간다. 내 화면에 가끔 취향과 먼 썸네일이 뜨는 것은 이 섞기의 몫일 수 있다.
내 화면에서는 어떻게 확인할까
썸네일이 정말 사람마다 다른지는 집에서 견줘 볼 수 있다. 프로필이 둘 이상인 계정이나, 함께 볼 가족·친구의 계정이 있으면 된다. 아래 순서는 썸네일이 다르게 보이는지를 확인하는 순서다.
- 같은 계정의 다른 프로필, 또는 가족·친구의 계정으로 같은 작품을 찾는다. 검색 결과처럼 같은 자리에서 나란히 본다. 넷플릭스는 작품을 보여 주는 자리마다 한 장을 고르므로, 서로 다른 줄끼리 견주면 자리 차이가 섞인다.
- 내가 자주 보는 갈래의 작품과 한 번도 안 본 갈래의 작품을 각각 견준다. 넷플릭스는 회원이 처음 보는 작품에서 맞춤의 효과가 더 컸다고 적었다. 그 크기는 밝히지 않았다.
- 며칠 뒤 같은 자리를 다시 본다. 넷플릭스 성명은 썸네일이 「regularly change」, 곧 꾸준히 바뀐다고 했고, 2017년 글은 그림이 너무 자주 바뀌지 않게 조절할 수 있다고 썼다.
- 다르게 보였다면, 왜 그 한 장인지는 화면에 나오지 않는다는 점을 기억한다. 시청 기록에 맞춘 것인지, 섞기로 나온 것인지, 자리 차이인지는 이 비교만으로 가를 수 없다.
보여 주지 않은 썸네일의 성적은 어떻게 매길까
새로 만든 고르기 규칙은 지금 규칙이 보여 주지 않은 그림을 고르기도 한다. 그 그림의 성적은 기록에 없다. 그렇다고 회원에게 바로 내보내면 규칙이 나쁠 때 손해가 크다. 그래서 넷플릭스는 과거 기록을 되감아 새 규칙을 먼저 시험한다.
기록을 되감는 절차는 단순하다. 과거에 무작위로 썸네일을 보여 준 기록을 하나씩 꺼내, 새 규칙이라면 그 회원에게 어느 장을 골랐을지 묻는다. 그때 무작위로 나간 그림과 새 규칙이 고를 그림이 같으면 그 기록을 남기고, 다르면 버린다. 남은 기록에서 재생 비율을 내면 그것이 새 규칙의 성적이다.
같은 장이 우연히 맞는 경우만 남으니, 남는 기록은 전체를 후보 수로 나눈 만큼이다. 이 장난감처럼 후보가 4장이면 기록의 4분의 3을 버린다. 후보가 32장이면 96.9%를 버린다. 이때 평균은 여전히 새 규칙을 실제로 돌렸을 때의 값 근처에 있지만, 기록 묶음마다 결과가 흔들리는 폭은 그 값의 2.7%에서 8.1%로 커진다.
이 버리는 비율에는 가정이 둘 깔려 있다. 과거 기록이 후보마다 똑같은 확률로 무작위로 보여 준 것이고, 되감는 방법도 가장 단순한 형태 그대로 쓴다는 가정이다. 넷플릭스는 무작위로 고른 내역을 함께 기록해 두고 그것으로 치우친 선택을 바로잡아 평가한다고 적었으니, 이 비율을 넷플릭스 숫자로 옮길 수는 없다.
이 장난감에서는 기록을 되감아 매긴 성적이 실제로 내보내 얻은 성적과 맞았다. 맥락을 보는 밴딧을 되감아 매기면 1,000번당 101.3번이었다. 같은 규칙을 실제로 돌린 처음 10,000번에서는 100.7번이었다.
다만 이것은 되감기의 전제, 곧 사건끼리 서로 영향을 주지 않고 기록이 고르게 무작위라는 조건을 일부러 정확히 맞춘 장난감이라서 나온 일치다. 이 방법을 내놓은 논문의 저자들도 자기 데이터에서 이 전제가 깨지는 경우 셋을 짚었다. 그 가운데 보정한 것은 하나뿐이다. 넷플릭스는 되감아 잰 값과 실제로 내보내 본 값이 「reasonable correlation」, 곧 어느 정도 함께 움직였다고만 썼다.
넷플릭스 2017년 글의 그림 2는 기록을 되감아 잰 재생 비율을 막대로 보여 준다. 무작위가 가장 낮고, 맥락 없는 밴딧이 그다음이며, 맥락을 보는 밴딧이 가장 높다. 세로축에 숫자가 없어서 몇 배인지는 읽을 수 없다. 이 장난감의 기록 200벌 가운데 197벌에서도 같은 순서가 나왔다. 그렇다고 넷플릭스 그림의 값까지 같다는 말은 아니다.
넷플릭스는 되감아 본 성적이 좋은 맞춤 밴딧 몇 가지를 골라, 회원을 나눠 맞춤 없는 밴딧과 실제로 견줬다. 맞춤이 핵심 지표를 뚜렷이 올렸다고 적었지만, 그 크기는 공개하지 않았다. 기록 되감기는 이 실제 비교에 앞서 견줄 규칙을 추리는 단계였다. 무작위로 섞어 둔 기록이 있어야 새 규칙을 회원에게 내기 전에 견줄 수 있으니, 섞기는 손해이기만 한 것이 아니라 새 규칙을 매기는 재료다.
인종을 묻지 않아도 썸네일이 무리마다 갈릴 수 있을까
2018년 10월, 작가이자 팟캐스트 제작자인 스테이시아 L. 브라운(Stacia L. Brown)이 트위터에 질문을 올렸다. 다른 흑인 넷플릭스 회원들도 흑인 배우를 앞세운 썸네일을 받느냐는 것이었다. 브라운이 받은 썸네일에는 단역 흑인 배우 두 명이 나와 있었고, 브라운은 두 배우가 화면에 나온 시간이 다 합쳐 10분쯤이나 될까 싶다고 적었다(Deadline 보도).
이 일로 언론이 묻자 넷플릭스가 낸 것이 앞에서 본 2018년 성명이다. 회원에게 인종·성별·민족을 묻지 않으므로 그 정보를 개인화에 쓸 수 없다는 내용이다. 쓰는 정보가 시청 기록뿐이라는 문장도 이 성명에 있다.
지금 넷플릭스 고객센터에도 「추천 콘텐츠 시스템은 인구통계 정보(연령, 성별 등)를 의사결정 절차의 일부로 포함하지 않습니다.」라는 문장이 있다. 다만 이 문장은 추천 전체에 대한 것이고, 썸네일 고르는 방식은 따로 나오지 않는다. 2026년에는 학술지 『Television & New Media』에 Daphne Gershon의 연구가 실렸다. 시청 기록을 서로 다르게 쌓은 계정을 만들어 썸네일 속 흑인 인물의 모습을 살핀 연구다. 저자 스스로 본격적인 조사에 앞서 시험 삼아 해 본 탐색 연구라고 밝혔고, 초록에 결론 수치는 없다.
규칙이 무리를 보지 않아도 썸네일이 무리마다 갈리는지, 장난감으로 그 기제만 따로 시험했다. 회원을 무리 X와 Y로 반씩 나누고, 맥락을 보는 밴딧에는 무리를 알려 주지 않았다. 재생 확률도 무리와 상관없이 취향 유형에만 달리게 했다. 바꾼 것은 하나, 취향 분포가 무리와 겹치는 정도다. 가장 많이 겹치게 하면 X는 로맨스파가 70%, Y는 30%이고, 두 무리를 합치면 앞의 50%가 그대로다. 이 겹침과 비율은 미리 정해 둔 가정값이다.

그림 4에서 겹침이 없으면 두 무리가 받은 A의 몫이 47.5%로 같았다. 겹침을 가득 채우자 X는 A를 65.5%, Y는 29.5%로 받아, 두 비율을 뺀 차이가 36.0%포인트(%p)가 됐다. 규칙은 취향 유형만 보았지만, 취향이 무리와 겹쳐 있어서 취향을 따라 고른 결과가 무리마다 갈렸다. 이것은 무리 정보를 규칙에 넣지 않아도 썸네일 몫이 무리마다 갈릴 수 있다는 기제다. 넷플릭스에서 그런 일이 있었다는 증거는 아니다.
장난감의 규칙은 유형마다 그림별 재생을 따로 세어 썸네일을 골랐다. 섞기로 나간 한 장은 그 순간에는 회원 정보를 보지 않고 고른 그림이지만, 그 재생도 함께 세어져 다음에 누구에게 어떤 그림을 고를지에 쓰인다. 한 장 한 장이 아니라 고르는 규칙 전체로 보면, 섞어 본 결과도 고르는 근거의 하나다. 넷플릭스는 시청 기록 같은 회원 정보와 일부러 섞어 본 결과를 보고 썸네일을 고른다.
더 읽기
- Ashok Chandrashekar, Fernando Amat, Justin Basilico, Tony Jebara, 「Artwork Personalization at Netflix」, Netflix Technology Blog(2017-12-07) — https://web.archive.org/web/20241231232947/https://netflixtechblog.com/artwork-personalization-c589f074ad76 (원 주소 https://netflixtechblog.com/artwork-personalization-c589f074ad76)
- Lihong Li, Wei Chu, John Langford, Xuanhui Wang, 「Unbiased Offline Evaluation of Contextual-bandit-based News Article Recommendation Algorithms」, WSDM 2011 — https://arxiv.org/abs/1003.5956
- Hyunji Nam, Sejoon Oh, Emma Kong, Yesu Feng, Moumita Bhattacharya, 「Netflix Artwork Personalization via LLM Post-training」, ICML 2026 워크숍(Pluralistic Alignment) — https://arxiv.org/abs/2601.02764