손목시계 광고 사진의 바늘은 거의 다 10시 10분에 멎어 있다. 그런데 2024년의 한 AI 모델에게 코드로 그린 시계 450장을 보여 주고 시각을 묻자, 정답에 한 번도 없는 10시 10분을 58번 답했다. 저자들이 공개한 결과표를 다시 세어 본 값이다. 정답이 붙은 시계 그림으로 더 가르치자 그 답은 1번으로 줄었다. 연구진은 이것을 학습 데이터에 시계 예가 모자랐다는 강한 정황으로 읽는다.
시계 광고를 펼치면 바늘은 거의 다 10시 10분이다
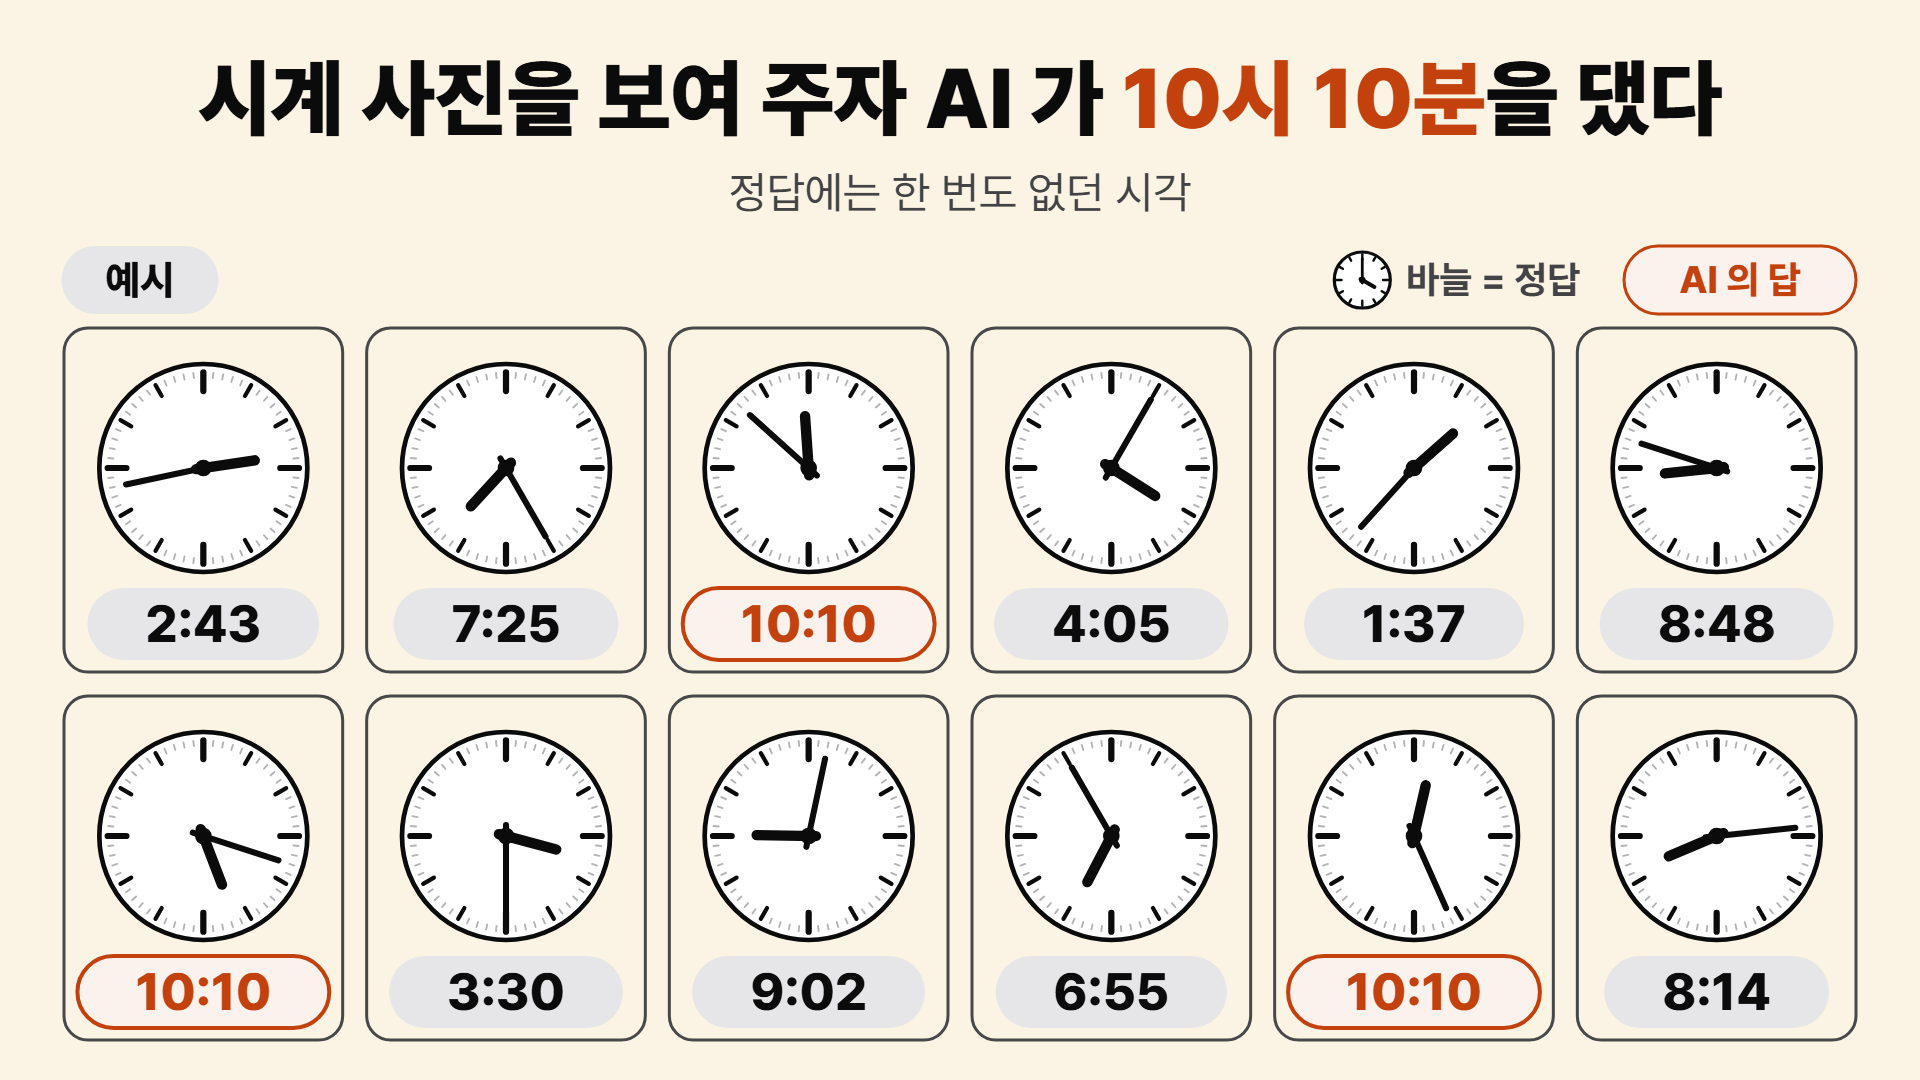
손목시계 광고나 쇼핑몰 상품 사진을 몇 장 넘겨 보면, 바늘이 거의 다 같은 자리에 서 있다. 시침은 10 근처, 분침은 2 근처다. 2008년 뉴욕타임스 기자는 한 일요판 신문의 광고에 실린 시계 24개 가운데 22개가 10시 10분이었다고 셌다. 아마존에서 가장 많이 팔린 남성 정장 시계 100개를 훑었을 때는 97개가 이 시각이었다. 기자가 직접 확인한 숫자이고, 표본을 정해 체계적으로 조사한 것은 아니다.
처음부터 그랬던 것은 아니다. 같은 기사에 따르면 1920~30년대 광고 속 시계는 거의 전부 8시 20분이었다. 10시 10분으로 옮겨 간 때는 회사마다 다르다. 해밀턴(Hamilton)의 광고에는 적어도 1926년부터 10시 10분이 보이고, 롤렉스(Rolex)는 1940년대 초부터 꾸준히 이 시각을 썼다. 타이맥스(Timex)는 1953년 무렵 옮겨 가기 시작한 것으로 보인다.
이유로 근거가 확인되는 설명은 셋이다. 첫째는 바늘이 로고를 가리지 않는다는 것이다. 브랜드 이름은 보통 시계판 위쪽 가운데에 있고, 10과 2를 가리키는 바늘은 그 양옆에 선다. 시계 판매점 Tourneau 의 수석 부사장 앤드루 블록(Andrew Block)이 든 이유다. 그는 이 바늘이 「frame the brand and logo」(브랜드와 로고를 감싸 준다)라고 말했다.
둘째는 두 바늘이 좌우 대칭을 이룬다는 점이다. 이 점은 8시 20분도 같아서, 두 시각을 가르는 것은 셋째 설명인 얼굴이다. 10시 10분의 바늘은 웃는 입꼬리처럼 올라가고, 8시 20분의 바늘은 아래로 처진다. 2017년의 한 심리 실험에서도 참가자 23명이 10시 10분 시계는 웃는 얼굴을, 8시 20분 시계는 슬픈 얼굴을 닮았다고 평가했다.
It has the aesthetic of the smiley face to be 10 past 10, so we try whenever possible to opt for that
10시 10분에는 웃는 얼굴의 미감이 있어서, 가능할 때마다 그 시각을 고르려 한다.
Susanne Hurni(Ulysse Nardin 광고·마케팅 책임자), The New York Times, 2008-11-28이 관행이 인터넷에 올라온 시계 사진까지 한쪽으로 몰았을 것이라는 생각이, 아래에서 다룰 두 AI 논문의 출발점이다. 한 논문은 인터넷에서 모은 데이터셋 대부분이 「highly biased towards some specific times like for example 10:10」(10시 10분 같은 특정 시각에 크게 치우쳐 있다)이라고 쓰고, 검색 예시 3장을 그림으로 실었다. 인터넷 사진 속 10시 10분의 비율은 두 논문 모두 세지 않았다. 광고 속 10시 10분은 기자가 세어 본 관행이고, 인터넷 사진이 그쪽으로 몰렸다는 것은 아직 가정이다.
정답에 10시 10분이 한 번도 없는 시계 450장
2025년 5월에 공개된 Fu 외 연구진의 짧은 논문은, 사진을 보고 답하는 AI 가 아날로그 시계를 정말 읽는지 물었다. 시험지는 코드로 그린 시계다. 흰 바탕에 숫자 1~12와 눈금 60개, 시침·분침·초침이 있는 표준 시계가 기본이다. 여기에 시계판을 찌그러뜨린 시계와, 바늘을 가는 화살표로 바꾼 시계를 더했다. 1시부터 12시 59분 사이에서 시각 150개를 무작위로 뽑아 세 모양에 똑같이 그렸으니 모두 450장이다. 이 150개 정답 가운데 10시 10분은 하나도 없고, 8시 20분도 7시 0분도 없다.
시험을 치른 모델은 OpenAI 의 gpt-4o, 2024년 8월 6일 판이다. 논문은 이 모델이 추가로 가르치기 전에는 시계를 「consistently failed」(번번이 읽지 못했다)라고 적고, 정답과 답을 점으로 찍은 그림을 실었다. 틀린 답이 어느 시각으로 갔는지 센 집계는 논문에 없다. 다만 저자들은 시계마다 모델의 답을 적은 결과표를 따로 올려 두었다. 저자가 공개한 결과표를 다시 세어 보면, gpt-4o 는 450장 가운데 58장(12.9%)에 「10:10」이라고 답했다. 표준 시계 18장, 찌그러진 시계 22장, 가는 바늘 시계 18장이다.

그림 1 에서 주황 칸은 다섯 줄 곳곳에 흩어져 있다. 정답이 10시 10분과 한참 먼 시계에도 주황 칸이 박혀 있다. 답이 시계판의 720가지 시각에 고르게 흩어졌다면, 450장에서 10시 10분은 한 번도 채 나오지 않는다(기댓값 0.6번 — 비교를 위해 따로 계산한 기준선이다). 정답에 없는 시각이 58번이나 되풀이됐다면, 이 답들 대부분은 바늘만 보고 나온 것이 아니라는 신호다.
답은 바늘을 잰 값이 아니라 딱 떨어지는 시각이었다
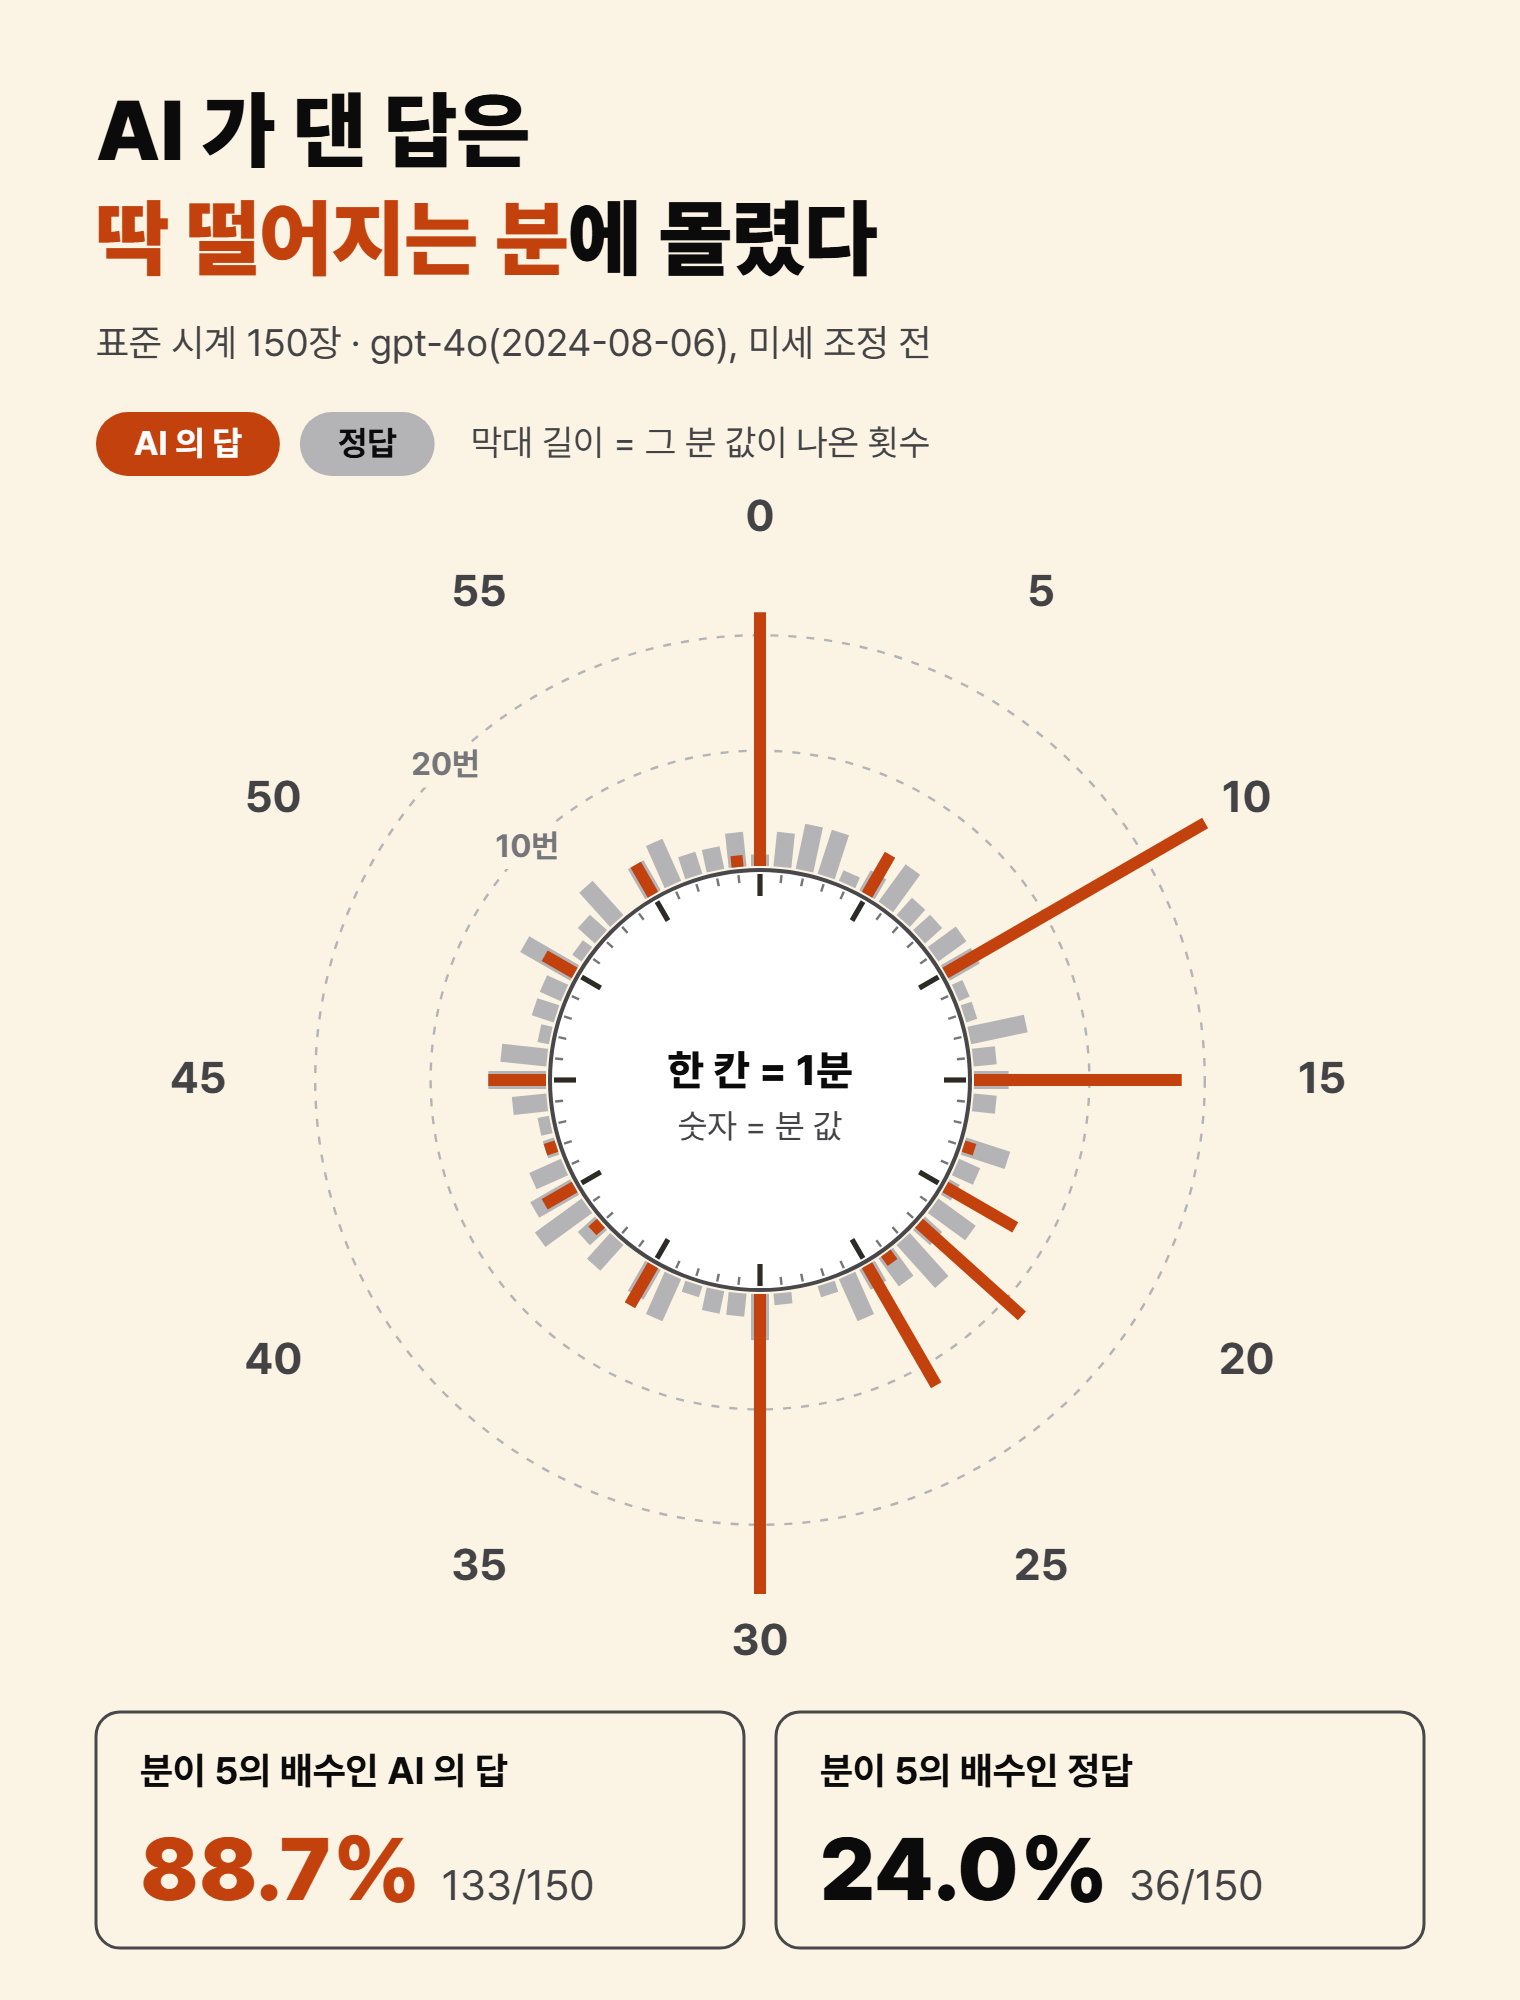
아날로그 시계를 읽는 일은 바늘 두 개의 방향을 재는 일이다. 짧은 시침이 어느 숫자와 어느 숫자 사이에 있는지, 긴 분침이 몇 번째 눈금에 있는지를 보고 시각을 맞춘다. 정답 시각 150개는 무작위로 뽑았으니 분도 제각각이다. 분이 0, 5, 10처럼 5의 배수인 정답은 36개(24.0%)뿐이다.
gpt-4o 의 답은 전혀 다른 모양이었다. 세 모양 모두에서 답의 88.0~96.7%가 분이 5의 배수인 시각, 곧 딱 떨어지는 시각이었다. 그림 2 는 그중 표준 시계 150장의 답과 정답을 분 단위로 나란히 놓은 것이다. 회색 정답 막대는 둘레에 낮게 퍼져 있는데, 주황 답 막대는 10분·30분·0분 같은 칸에서 길게 솟는다. 서로 다른 답의 가짓수도 적었다. 정답 150개는 138가지 시각으로 갈리는데, 답은 모양에 따라 36~67가지에 그쳤다.
평균 몇 분 틀렸는지를 보면 더 분명하다. 정답과 상관없이 아무 시각이나 고르게 찍어도 평균 오차는 180분이다. 이 180분은 비교를 위한 기준선일 뿐, 모델이 실제로 찍었다는 모형은 아니다. gpt-4o 의 답은 모양에 따라 평균 154.3~167.7분, 곧 2시간 반 넘게 어긋나 이 기준선보다 12~26분 나은 데 그쳤다. 바늘을 재서 나온 답이라면 이렇게 크게, 그것도 딱 떨어지는 시각으로 몰려서 틀리기는 어렵다. 이 모델은 시계를 재기보다, 익숙하고 딱 떨어지는 시각 하나를 골라 댄 것에 가깝다.
근처를 잘못 읽은 게 아니라 10시 10분을 통째로 댔다
10시 10분이라는 답 가운데는 정답 근처를 조금 잘못 읽은 것도 있지 않을까? 58번 가운데 정답과 5분 안인 것은 4번뿐이다. 정답이 10시 6분이나 10시 7분이었던 시계라, 거의 맞게 읽은 몫이다. 나머지 가운데 53번은 정답과 10분 넘게 떨어져 있었다. 10시 10분이라는 답이 나온 시계의 정답 시(時)는 12가지 가운데 11가지에 걸쳐 있다. 1시대 시계에도, 4시대 시계에도, 12시대 시계에도 10시 10분이라고 답했다.
그렇다면 시침이 10 쪽으로 끌린 것일까? 10시 10분을 빼고 10시대 답만 세면, 표준 시계는 13개, 가는 바늘 시계는 14개로 정답의 10시대 15개와 비슷하다. 찌그러진 시계에서는 10시대 답 22개가 전부 10시 10분이었다. 정답보다 크게 늘어난 시간대는 10시만이 아니다. 7시대 답도 비슷하게 늘었고, 표준 시계와 찌그러진 시계에서는 7시대가 10시대보다 더 많이 늘었다. 쏠림은 10시라는 시간대가 아니라 10시 10분이라는 한 시각에 있다.
찌그러진 시계에서는 다른 시각도 튀어나왔다. 이 모양에서 가장 많이 나온 답은 7시 0분(34번)이고, 10시 10분(22번)과 8시 20분(21번)이 뒤를 잇는다. 8시 20분은 1920~30년대 광고 시계의 시각이다. 하지만 맨 위의 7시 0분은 광고와 이어진다는 기록이 없는 시각이고, 왜 이 답이 몰렸는지는 결과표만으로 알 수 없다. 옛 광고 시각까지 나오기는 하지만, 이 쏠림을 광고 시각 하나로 다 설명하지는 못한다.
더 가르치자 그 답이 1번으로 줄었다 — 원인은 정황까지다
연구진은 여기서 한 가지를 더 해 봤다. 미세 조정(파인튜닝, fine-tuning)은 이미 학습을 마친 모델에게 정답이 붙은 예제를 더 보여 주며 추가로 가르치는 일이다. 연구진은 모든 시각을 빠짐없이 덮는 시계 그림과 그 시각을 짝지은 데이터를 만들고, 그 가운데 일부로 gpt-4o 를 미세 조정했다. 그 뒤 같은 450장을 다시 물었더니 10시 10분이라는 답은 58번에서 1번으로 줄었다. 분이 5의 배수인 답도 150장 중 23~34장으로 내려와, 정답의 36장과 비슷한 수준이 됐다. 1년이 안 돼 나온 다음 판 gpt-4.1(2025년 4월 14일 판)은 추가로 가르치기 전부터, 같은 450장에서 10시 10분이라는 답이 1번뿐이었다.
연구진은 미세 조정 뒤 모델이 처음 보는 시계도 읽게 된 것을 두고 이렇게 적었다. 「This is a strong indication that the inability of GPT-4o to read clocks is due to the lack of relevant examples in its training dataset.」 풀이하면, gpt-4o 가 시계를 못 읽은 것은 학습 데이터에 관련 예가 모자랐기 때문이라는 강한 정황이라는 말이다.
연구진은 gpt-4.1 이 잘 읽은 이유도 같은 쪽에서 찾았다. 학습 데이터에 시계 예가 더 들어갔기 때문이라고 보면서, 「probably」(아마도)라는 말을 붙였다. 두 설명 모두 증명이 아니라 추정의 말투다.
원인을 가르려면 따로 필요한 실험이 있다. 학습 데이터 속 10시 10분의 비율을 바꿔 가며 쏠림이 그만큼 따라 변하는지 재는 실험인데, 이 글이 읽은 두 논문 어디에도 없다. 빈칸을 채우자 쏠림이 거의 사라졌다는 것은 학습 데이터 쪽을 가리키는 정황이다. 광고 사진이 그 치우침을 만들었다는 증거까지 되지는 않는다.
잘 읽던 모델도 바늘 모양이 바뀌자 무너졌다
gpt-4.1 은 표준 시계를 잘 읽었다. 결과표로는 150장 가운데 138장을 1분 안으로 맞혔고, 논문이 보고한 평균 오차는 약 3.9분이다. 그런데 같은 150개 시각을 다른 모양으로 그리자 사정이 달라졌다. 시계판을 찌그러뜨린 시계에서는 1분 안으로 맞힌 것이 75장, 논문의 평균 오차는 약 23.0분이었다. 바늘만 가늘게 하고 화살촉을 단 시계에서는 68장, 평균 약 62.1분으로 더 나빴다. 시계판 전체를 비튼 쪽보다 바늘만 바꾼 쪽이 더 크게 틀렸다.
저자들은 이 결과를 두고, 모델이 「has not learned to tell the time but rather memorized patterns in the training set」(시계 읽는 법을 배운 게 아니라 학습 데이터에 있던 패턴을 외웠다)임을 시사한다고 적었다. 바늘을 바꾼 시계에서 크게 틀린 까닭으로는, 모델이 바늘의 굵기에 지나치게 기대어 시침과 분침을 가리는 것 같다는 추측을 내놓았다. 이 한계를 살피려고 저자들은 모델을 한 번 더 가르쳤다.
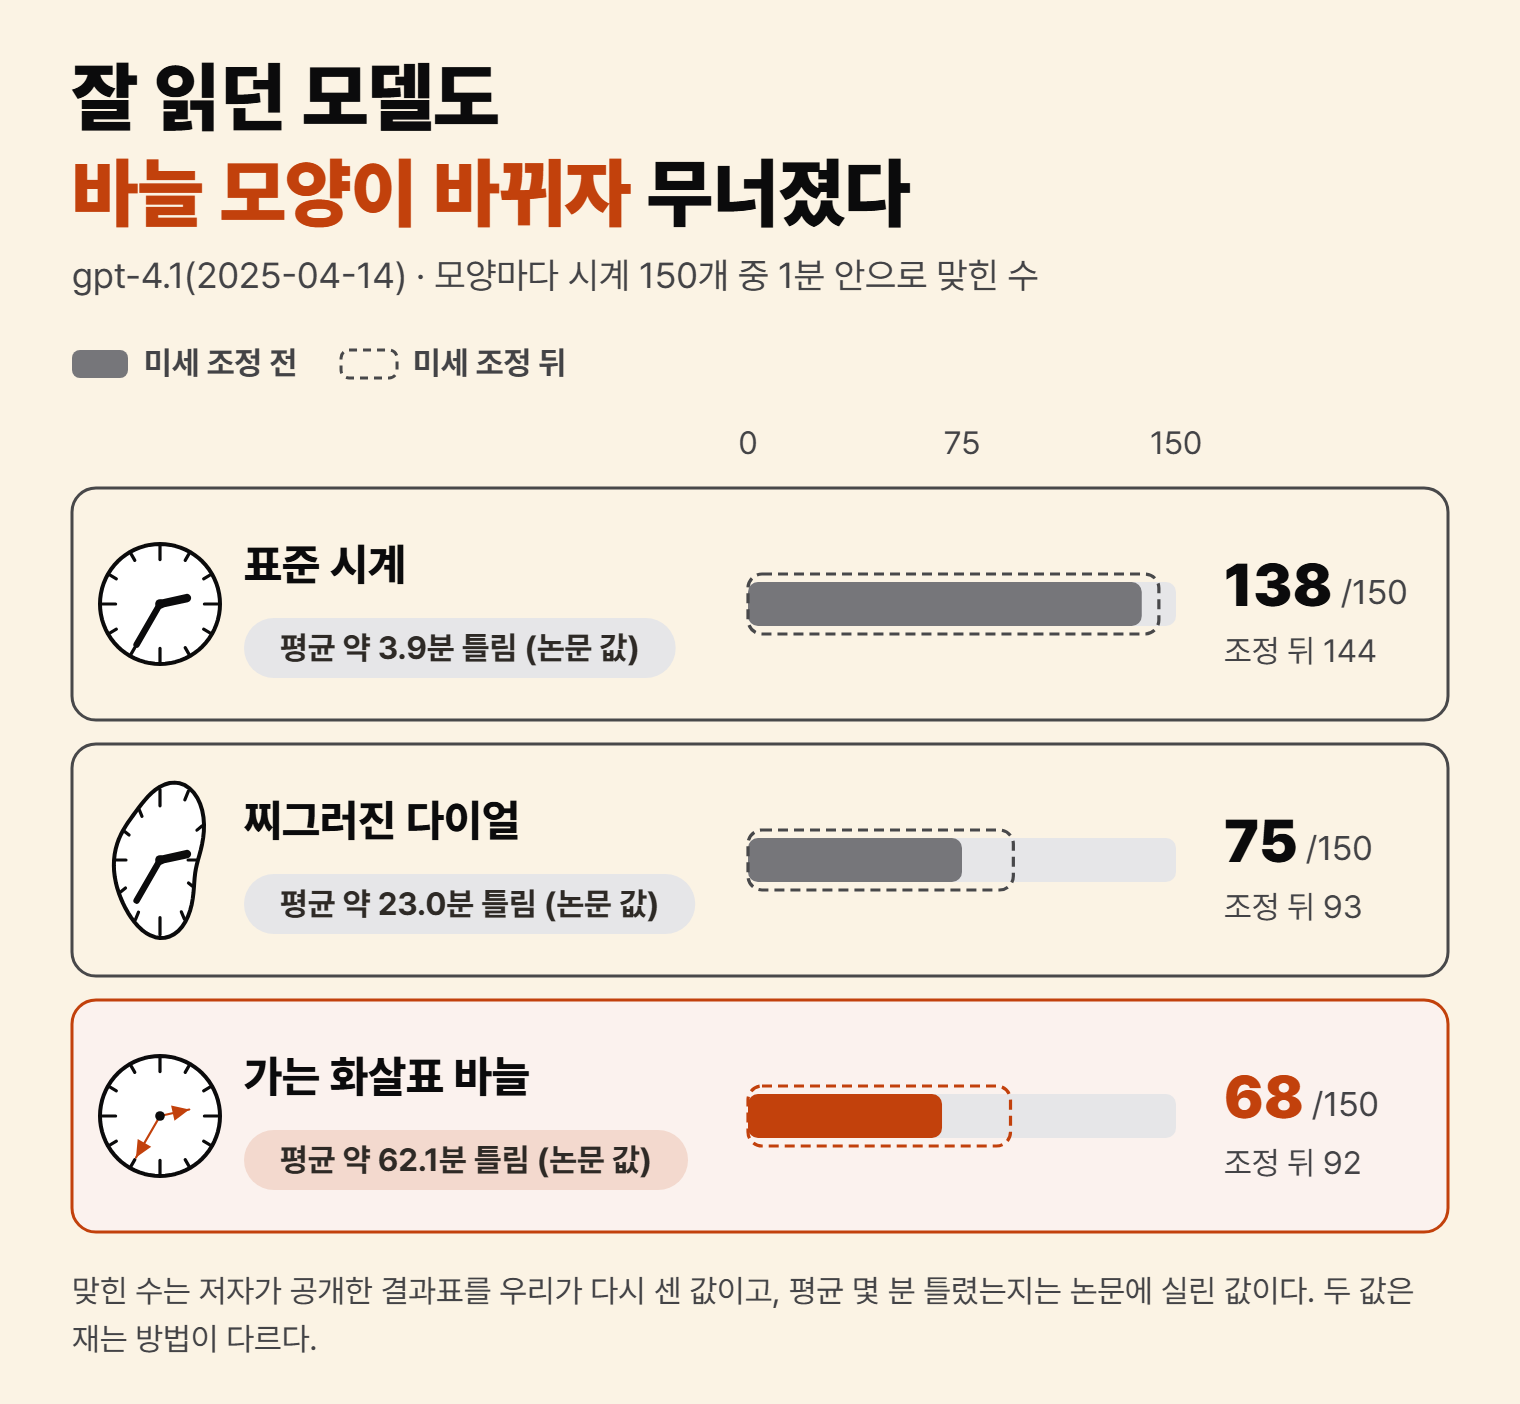
모양마다 300장씩 더 보여 주며 가르친 뒤 같은 150개 시각을 다시 물은 값이 그림 3 의 점선 테다. 표준 시계는 144장까지 올랐지만, 찌그러진 다이얼은 93장, 가는 바늘 시계는 92장에 머물렀다. 가는 바늘 시계는 논문의 평균 오차도 약 48.2분이 남았다. 표준 시계에서 거둔 높은 정답률만 보고는, 모델이 시계 읽는 법을 익혔는지 익숙한 모양을 알아본 것인지 가를 수 없다.
실사 사진에서는 더 어렵다
코드로 그린 시계에서 벗어나 실제 사진으로 가면 사정이 또 다르다. 2026년 인천대와 맥길대(McGill) 소속의 Choi 외 연구진은 실제 사진 12,483장으로 시계 읽기 데이터셋을 만들었다. 이 시험에서는 시와 분을 무작위로 찍어도 둘 다 맞을 확률이 약 0.69%다. 논문이 분을 2분 차이까지 맞은 것으로 채점한 듯해, 그 기준으로 따로 계산해 본 값이다. 공개 모델 Llama-3.2-11B 는 시험용 사진 5,247장에서 시와 분을 모두 맞힌 비율이 1.41%였다.
학습용 실제 사진 7,236장으로 미세 조정하자 45.78%로 올랐다. 그래도 저자들은 「Despite these advances, performance remains well below human-level」이라고 적었다. 나아졌어도 사람 수준에는 한참 못 미친다는 것이다.
이 데이터에도 10시 10분의 흔적이 있다. 연구진은 제품 광고와 스톡 사진에 흔한 10시 10분 사진이 너무 많아 일부만 남겼다고 적었지만, 몇 장을 덜어 냈는지는 밝히지 않았다. 그렇게 덜어 낸 뒤에도 10시대 사진이 1,759장으로 가장 많았다. 전체의 14.1%로, 12시간에 고르게 나뉘었을 때의 8.3%보다 크다. 깨끗하게 그린 시계에서 본 쏠림은 쉬운 시험에서 드러난 것이고, 실제 사진에서는 시각을 맞히는 일 자체가 아직 어렵다.
AI 가 10시 10분이라고 읽어 주면
gpt-4o 가 댄 10시 10분은 58번 중 53번이 정답과 10분 넘게 떨어져 있었다. 바늘을 조금 잘못 읽어서 나올 거리가 아니다. 모델이 가장 흔히 본 시각을 댔다는 설명은, 연구진이 미세 조정 결과에서 읽은 정황에 기대고 있다.
이런 답이 얼마나 나오는지는 모델 판본과 시계 모양, 그 모델이 나온 때에 따라 갈린다. 다음 판 gpt-4.1 은 같은 450장에서 10시 10분을 1번만 댔다. AI 가 사진 속 시계를 10시 10분이라고 읽어 주면, 그 답은 바늘을 잰 결과가 아니라 가장 흔히 본 시각일 수 있다.
더 읽기
- Fu, González, Conde, Reviriego, Merino-Gómez, "Have Multimodal Large Language Models (MLLMs) Really Learned to Tell the Time on Analog Clocks?", arXiv:2505.10862v1 (2025, 동료 심사 게재 표기 없음) — https://arxiv.org/abs/2505.10862 · 저자 결과표 https://github.com/aMa2210/MLLMs_read_analog_clocks
- Choi, Lee, You, Lee, "It’s Time to Get It Right: Improving Analog Clock Reading and Clock-Hand Spatial Reasoning in Vision-Language Models", arXiv:2603.08011v2 (CVPR 2026 Findings) — https://arxiv.org/abs/2603.08011
- Karim, Lützenkirchen, Khedr, Khalil, "Why Is 10 Past 10 the Default Setting for Clocks and Watches in Advertisements? A Psychological Experiment", Frontiers in Psychology 8:1410 (2017) — https://www.frontiersin.org/articles/10.3389/fpsyg.2017.01410/full
- Newman, "Why Time Stands Still for Watchmakers", The New York Times (2008-11-28) — https://www.nytimes.com/2008/11/28/business/media/28adco.html