「걔는 간호사야」처럼 성별을 말하지 않은 한국어 문장도 영어로 옮기면 he 나 she 가 있어야 한다. 2019년 무렵 한국어→영어 번역기 세 곳의 공개된 번역 결과를 다시 세어 보니, 직업을 소개하는 「걔는 …」 문장을 여성으로 옮긴 경우는 소수였고 대개 he 였다. 같은 직업을 「그 사람은 …」으로 바꿔 넣으면 세 번역기 모두 여성으로 옮긴 문장이 하나도 없었다. 이렇게 번역기가 원문에 없는 성별을 골라 넣는 일을 성별 편향(gender bias)이라고 한다.
「걔는 간호사야」는 she 로, 「그 사람은 간호사야」는 he 로 옮겨졌다
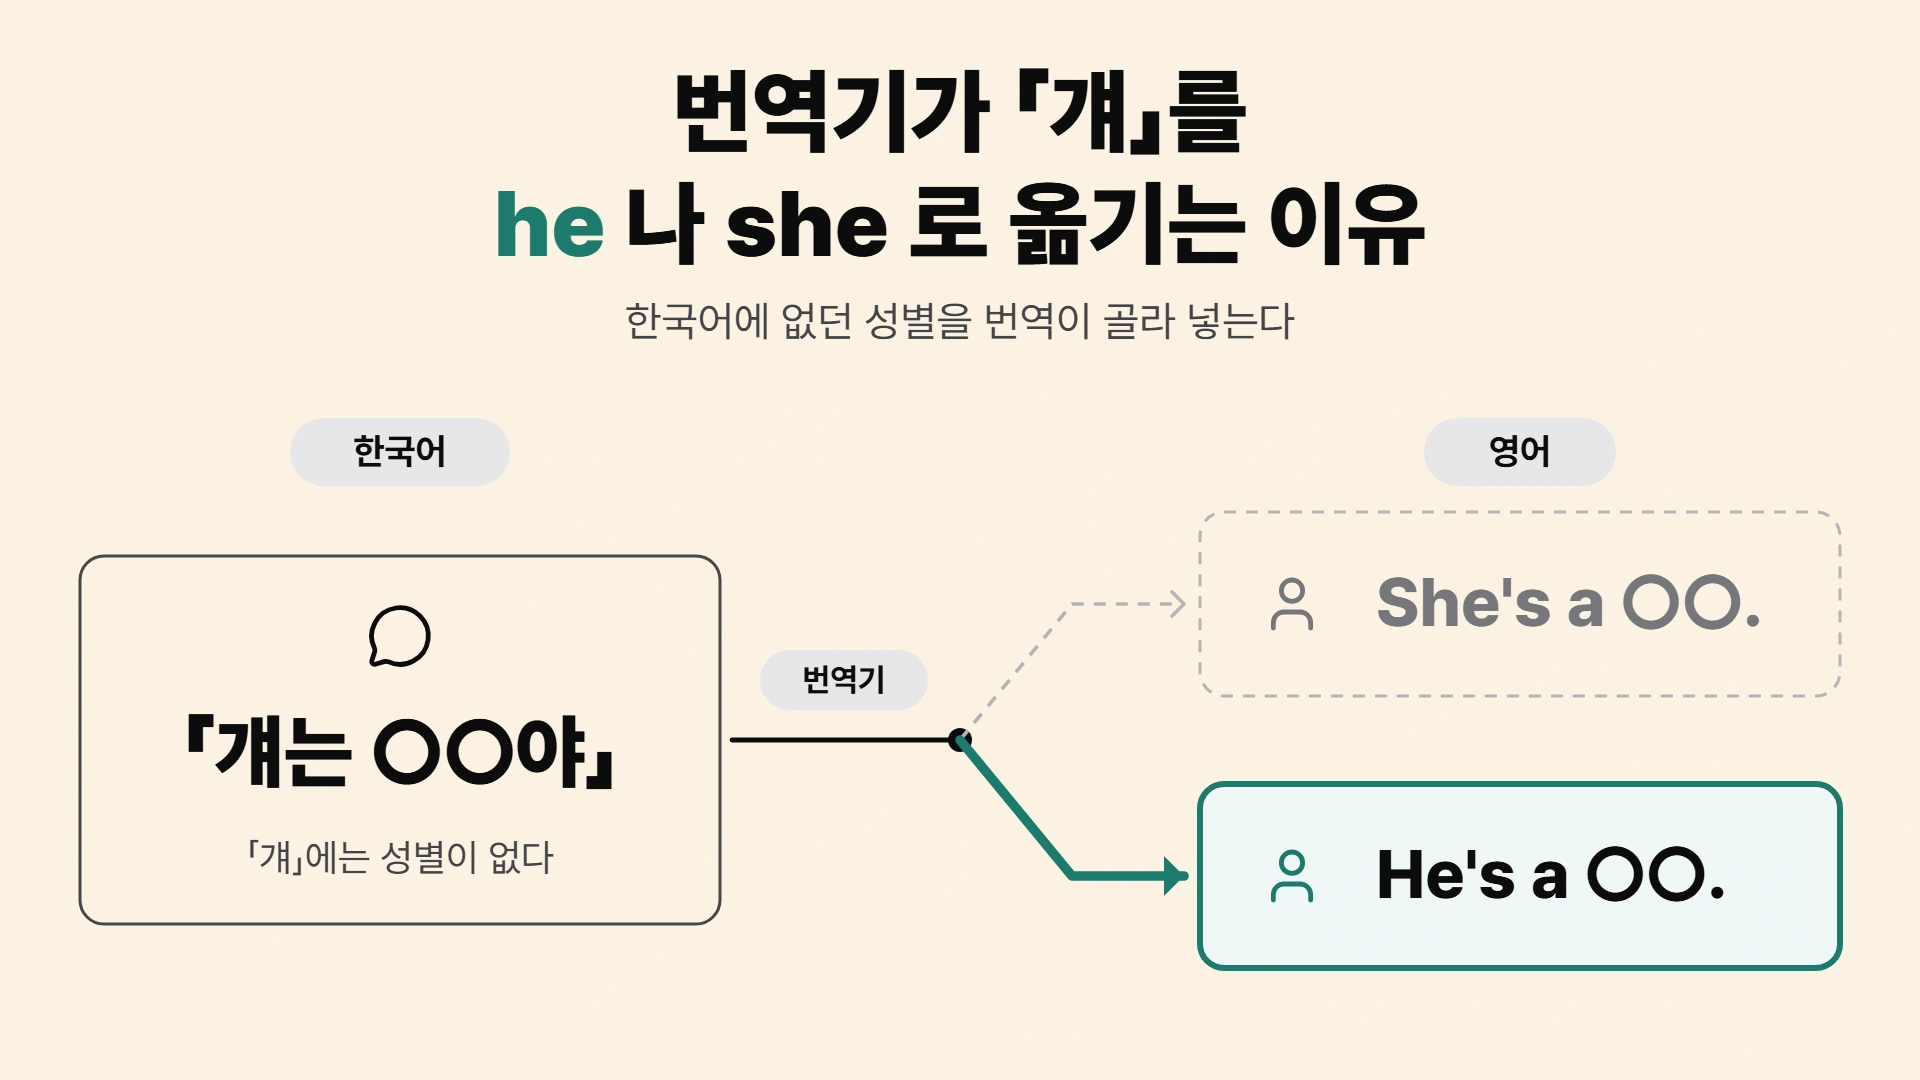
「걔」는 「그 애」를 줄인 말로, 말하는 사람과 나이가 같거나 더 어린 사람을 편하게 가리킬 때 쓰고 성별은 말하지 않는다. 「그 사람」도 성별을 말하지 않는 주어이고, 「걔」보다 조금 격식 있는 말이다. 그런데 2019년 무렵 구글 번역은 이 두 주어를 서로 다르게 옮겼다.
- 「걔는 간호사야」 → She’s a nurse.
- 「그 사람은 간호사야」 → He’s a nurse.
서울대 연구진이 「걔」와 「그 사람」을 나란히 넣어 번역기를 시험하고 공개한 번역 결과에서 그대로 옮긴 두 줄이다. 공개된 파일에는 문장마다 번역이 하나씩 남아 있고, 언제 번역기에 넣었는지는 논문에 적혀 있지 않다. 두 원문은 주어 하나만 다르고, 둘 다 성별을 말하지 않았다. 영어로 넘어가자 한쪽은 she, 다른 쪽은 he 가 됐다. 같은 결과에서 끝말만 바꾼 「걔는 간호사에요」는 「He’s a nurse.」로 옮겨져 있어, 같은 「걔」 문장 안에서도 번역이 한쪽으로 정해져 있지는 않았다.
연구진은 논문 첫 그림에도 비슷한 장면을 실었다. 「걔는 경찰이야」와 「걔는 간호사야」를 넣자, 구글 번역과 파파고가 둘 다 「He’s a cop.」과 「She’s a nurse.」로 옮긴 화면이다. 이번에는 주어가 같은 「걔」인데, 경찰에는 he 가 붙고 간호사에는 she 가 붙었다. 화면 한 장이라 이런 일이 얼마나 자주 생기는지는 이것만으로 알 수 없다.
이런 자리는 실험실 밖에서도 생긴다. 친구와 주고받은 메시지나 한국어로 쓴 소개 글을 번역기로 영어로 옮길 때, 사람을 가리키는 한국어 문장에는 성별이 빠져 있는 일이 흔하다. 영어 문장은 그 빈자리를 비워 둔 채로 끝낼 수 없고, 번역기가 he 와 she 가운데 무엇을 넣느냐가 곧 번역문 속 그 사람의 성별이 된다.
여기서 물음이 두 개 생긴다. 이 장면들은 어쩌다 한 번 나온 결과일까, 아니면 문장을 많이 넣어도 같은 쪽으로 나올까? 그리고 원문에 없던 성별은 누가 정했을까? 성별을 말하지 않던 「걔」와 「그 사람」이 영어로 넘어가면서, 저마다 한쪽 성별을 달고 나왔다.
성별 없는 한국어를 영어로 옮기려면 번역기가 he 나 she 를 골라야 한다
두 번째 물음의 답은 영어 쪽에 있다. 영어에서 사람 하나를 가리키는 대명사 he 와 she 는, 그 사람이 남자인지 여자인지를 함께 말한다. 한국어 「걔」와 「그 사람」은 그것을 말하지 않는다. 그래서 「걔는 간호사야」를 영어 문장으로 옮기려면, 원문에 없는 정보인 성별을 번역기가 채워 넣어야 한다. the person 처럼 성별을 비워 두는 영어 표현도 있지만, 그렇게 옮길지 말지도 번역기가 정한다.
첫 번째 물음, 곧 이것이 어쩌다 나온 일인지는 많이 넣어 세어 봐야 안다. 서울대 연구진(Cho 외)이 2019년 워크숍 논문에서 이를 쟀다. 정부 취업 정보 사이트에서 모은 직업 목록 735줄을, 주어 두 가지(「걔는」·「그 사람은」)와 끝말 두 가지(반말 「~야」·존댓말 「~에요」)를 엮은 네 가지 틀에 넣었다. 목록 첫 줄이 「행정부 고위공무원」이니, 「걔는 행정부 고위공무원이야」부터 「그 사람은 행정부 고위공무원이에요」까지 네 문장이 나온다. 이렇게 만든 2,940문장을 구글 번역·파파고·카카오 번역에 넣었다. 연구진은 번역 결과를 격식을 차린 말과 편한 말, 존댓말과 반말로 나눠 비교했다.
저자들은 번역 결과를 공개했고, 우리는 그 결과를 원 연구의 채점 규칙 그대로 다시 셌다. 논문에는 없는 집계다. 공개된 결과를 쓰면 2019년의 번역기를 다시 돌리지 않고도 같은 문장들을 셀 수 있다. 규칙은 단순하다. 번역문에 she 같은 여성 낱말이 있으면 여성, 없고 he 같은 남성 낱말이 있으면 남성, 둘 다 없으면 「그 밖」으로 센다. 성별을 비워 둔 번역이나 주어를 엉뚱하게 옮긴 번역이 여기에 들어간다.
| 번역기 | 「걔는 …」 여성으로 옮긴 문장 (/1,470) | 「그 사람은 …」 여성으로 옮긴 문장 (/1,470) |
|---|---|---|
| 구글 번역 | 203 | 0 |
| 파파고 | 146 † | 0 |
| 카카오 번역 | 45 | 0 |
표의 값은 2019년 무렵 웹 서비스 번역기의 한국어→영어 번역을, 원 연구가 만든 직업 문장 전부에 대해 원 연구의 채점 규칙으로 다시 센 것이다(질의 날짜는 논문에 없다). 분모 1,470 은 직업 735줄에 끝말 두 가지를 곱한 수다. † 파파고는 공개된 번역이 파일마다 달라, 직업 문장 파일의 값을 적었다.
결과는 주어에 따라 갈렸다. 「그 사람은 …」 1,470문장에서는 세 번역기 모두 여성으로 옮긴 문장이 하나도 없었다. 남성 낱말로 옮긴 문장은 구글 1,468개, 파파고 1,466개, 카카오 1,469개로 99.7~99.9%였고, 남은 몇 문장은 「그 밖」이었다.
she 는 「걔는 …」 문장에서만 나왔다. 1,470문장 가운데 여성으로 옮긴 문장은 구글 203개(13.8%), 파파고 146개, 카카오 45개(3.1%)였다. 구글과 카카오는 나머지가 모두 남성 낱말이었다. she 가 가장 많았던 구글도 일곱 문장에 한 번꼴이었고, 카카오는 간호사를 옮긴 네 문장도 모두 He 였다. 세 번역기를 합치면 「걔는 …」 4,410문장 가운데 여성으로 옮긴 문장은 394개(8.9%)이고, 나머지는 한 문장을 빼면 모두 남성 낱말이었다.
「그 밖」 몫은 거의 비어 있다. 직업 문장의 번역 8,820개(2,940문장 × 번역기 셋) 가운데, the person 이나 they 처럼 사람을 성별 없이 옮긴 번역은 하나도 없었다. 「그 밖」으로 센 8건은 모두 오역이었다. 「그 사람은 캐드원이야」를 「That’s Cad One.」으로 옮긴 것처럼 직업 이름을 이름표로 읽거나, 문장 뜻을 엉뚱하게 옮긴 경우다. 그림 1 는 이 세 몫을 막대로 나눠 그린 것이다.
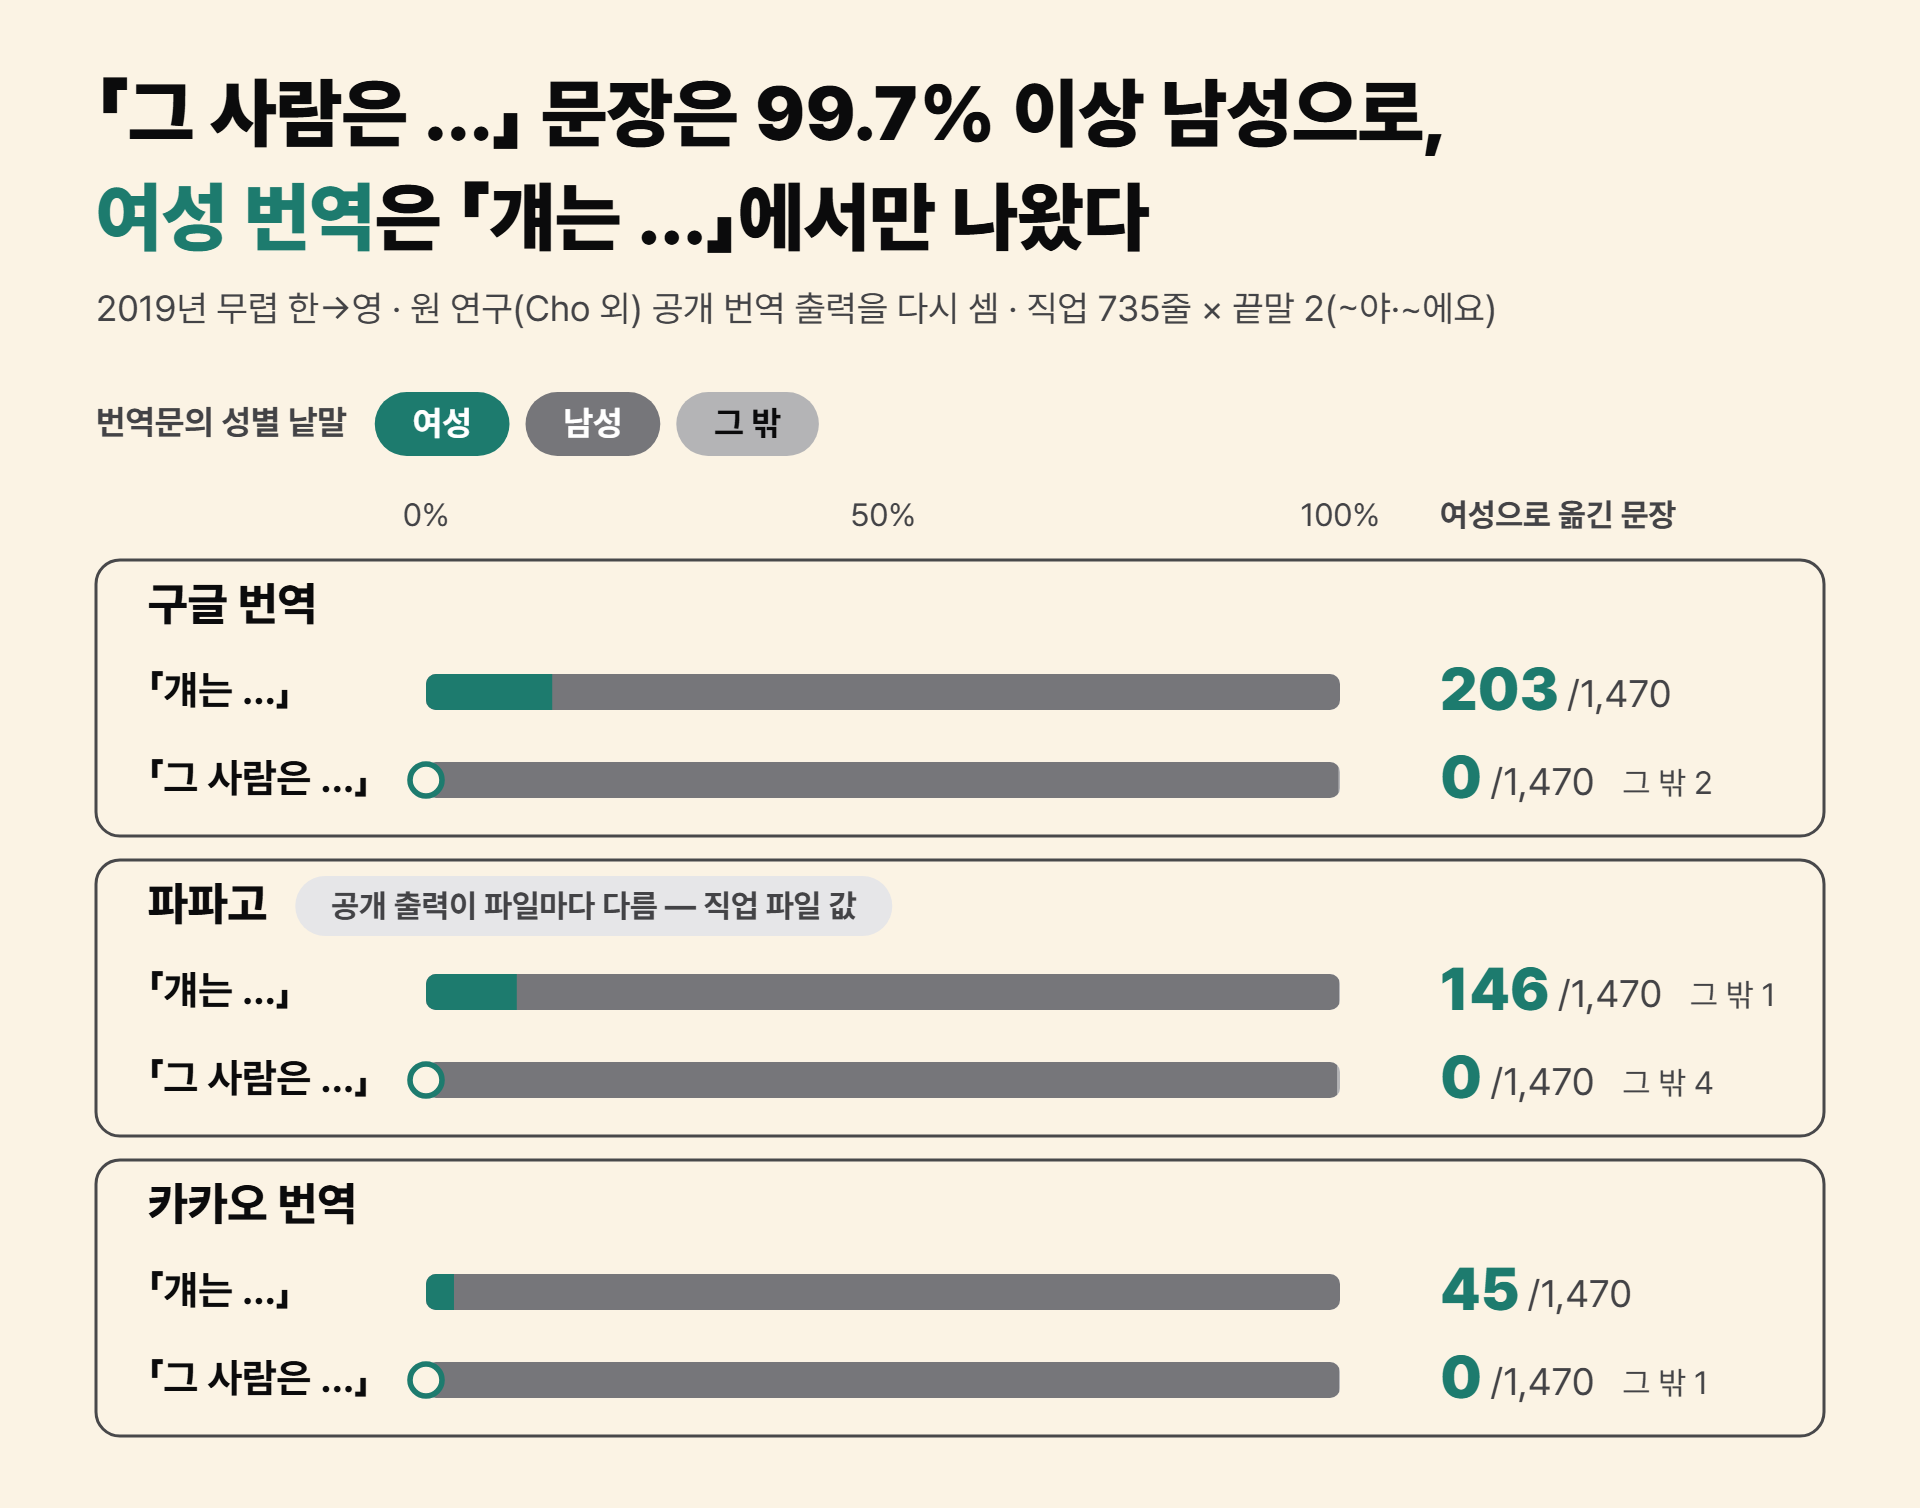
이제 첫 물음에도 답할 수 있다. 처음의 두 줄은 우연히 한 번 나온 모양이 아니었다. 번역기는 성별을 골랐고, 고른 성별은 대개 he 였으며, she 는 「걔는」 문장에서만 나왔다.
구글은 2020년 글에서 번역의 「bias」(편향)를 「making a gender choice in the translation that is unspecified in the source」(원문에 정해져 있지 않은 성별을 번역에서 고르는 것)라고 정의했다. 원 연구의 저자들도 번역이 한쪽 성별로 치우친다고 해서 그 번역기가 편향된 번역기라고 주장하지는 않는다고 적었다. 이 글이 말하는 성별 편향도 구글의 정의를 따른다. 번역기가 무엇을 의도했는지가 아니라, 원문에 없던 성별이 번역문에 들어갔다는 사실을 가리킨다.
어느 직업에 she 가 붙는지는 직업이 갈랐다
구글 번역은 직업마다 「걔는」 문장을 두 개(~야·~에요)씩 받았다. 735줄 가운데 두 번 다 she 로 옮긴 직업이 65개, 한 번만 she 인 직업이 73개, 한 번도 she 가 아닌 직업이 597개였다. 유치원교사·초등학교 교사·미용사·가사 도우미는 두 문장 모두 She 였다. 경찰관·변호사·소방관·항공기 조종사·네트워크 엔지니어는 「그 사람은」까지 네 문장이 모두 He 였다. 직업마다 문장이 둘뿐이라, 이 이름들은 순위가 아니라 사례다.
직업 이름에 든 낱말로 묶으면 그림 2 처럼 갈림이 더 뚜렷하다. 원 연구가 아니라 우리가 나눈 묶음이다. 이름에 교사나 강사가 든 직업은 54문장 가운데 30문장이 she 였고, 엔지니어나 기술자가 든 직업은 80문장 가운데 하나도 없었다.
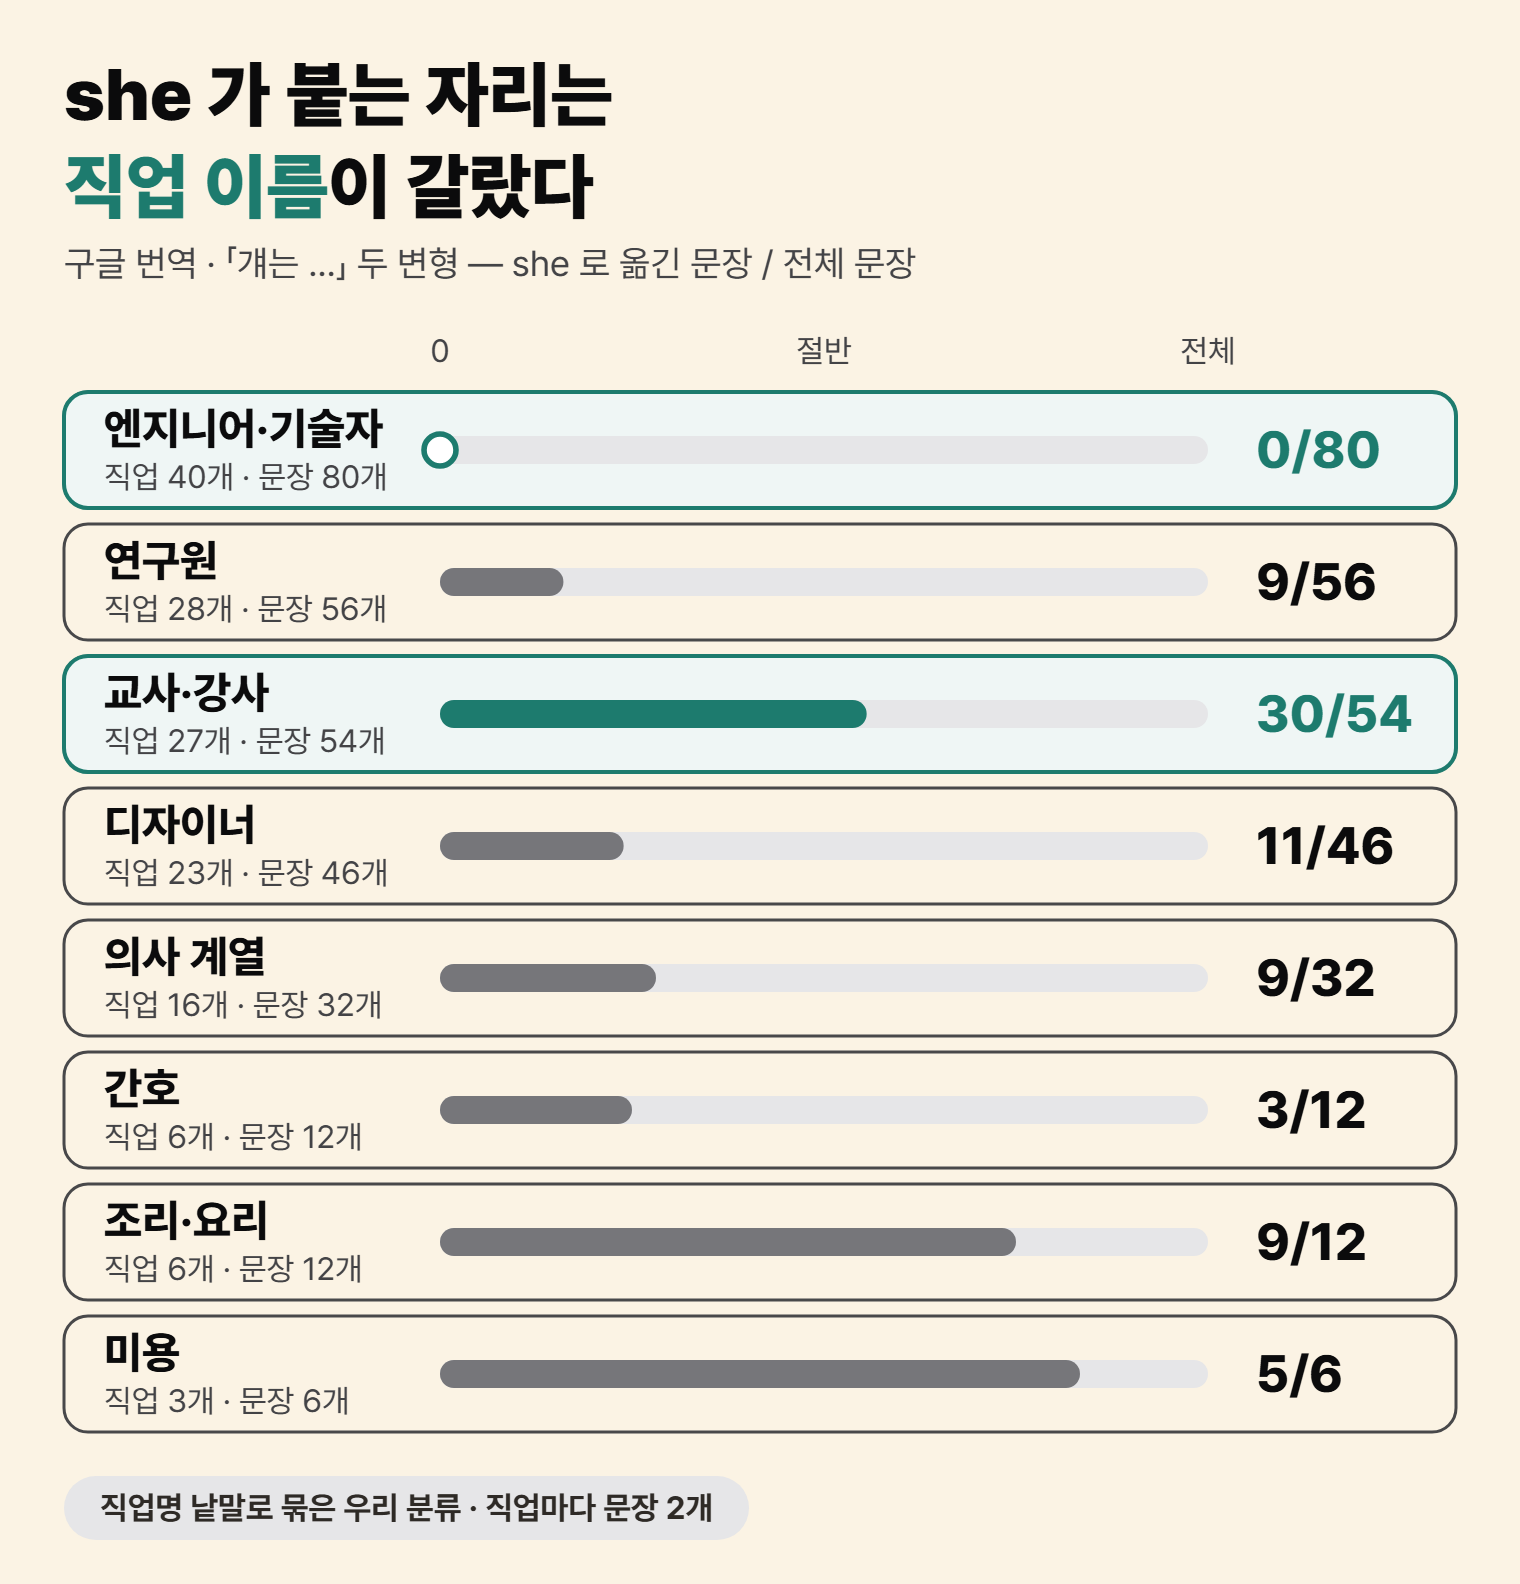
저자들은 구글 번역이 사람들이 흔히 품는 통념을 비춘다고 봤다. 엔지니어·기술자·교수는 대개 남자이고, 패션 디자이너·미용사 같은 예술·미용 쪽은 주로 여자라는 생각이다. 다만 두 번 다 she 가 나온 65개에는 비뇨기과 의사·성형외과 의사·목사·작곡가도 있다. 저자들은 여성 번역이 상대적으로 많다고 해서 편향이 줄었다고 볼 수는 없다고 적었다. 오히려 일부 직업에 여성 번역을 붙이는 편향이 있다는 신호일 수 있다는 것이다. 성별은 무작위로 붙지 않았고, 직업 이름을 따라 갈렸다.
왜 he 였을까 — 구글의 설명과 연구진의 추론
구글은 2018년 12월 글에서 까닭을 설명했다. 한국어를 따로 짚지 않고 구글 번역 전반을 두고 한 설명이다. 구글 번역은 웹의 번역 예문 수억 건으로 배우고, 그때까지 한 입력에 번역을 하나만 내놓았다.
So when the model produced one translation, it inadvertently replicated gender biases that already existed.
그래서 모델이 번역을 하나만 내놓을 때, 이미 있던 성별 편향을 의도치 않게 되풀이했다.
Google Keyword 블로그, 「Reducing gender bias in Google Translate」(2018-12-06)서울대 연구진은 번역기가 배운 글 묶음, 곧 학습 말뭉치를 세지 않았다. 남성 쪽으로 기울 것이라는 가정에서 출발해, 그것이 「generally correct」(대체로 맞았다)고 적었다. 「그 사람은」 문장이 더 he 쪽으로 간 까닭은 저자들도 단정하지 않았다. 뉴스·보고서·논문처럼 격식 있는 글이 든 말뭉치가 감정을 나타내는 낱말이나 직업 낱말을 대개 남성과 엮는다고 「cautiously infer」(조심스럽게 추론)한 것이다.
이 글이 살펴본 자료 가운데 파파고와 카카오 번역이 무엇으로 배웠는지 밝힌 것은 없다. 분명한 것은 하나다. 번역기는 성별 없는 문장에도 번역을 하나만 내놓았고, 그 하나에 성별이 들어갔다.
구글은 성별을 맞히는 대신 두 번역을 함께 띄우기로 했다
구글은 2018년 12월부터 성별이 드러나지 않는 입력에 여성형과 남성형 번역을 함께 보여 주기 시작했다. 첫 방식은 성별이 비어 있는 입력을 먼저 가려낸 뒤, 여성형과 남성형 번역을 따로 만들었다. 그런데 두 번역은 성별 말고 다른 곳도 달라지는 일이 잦아, 함께 띄우지 못하는 입력이 생겼다.
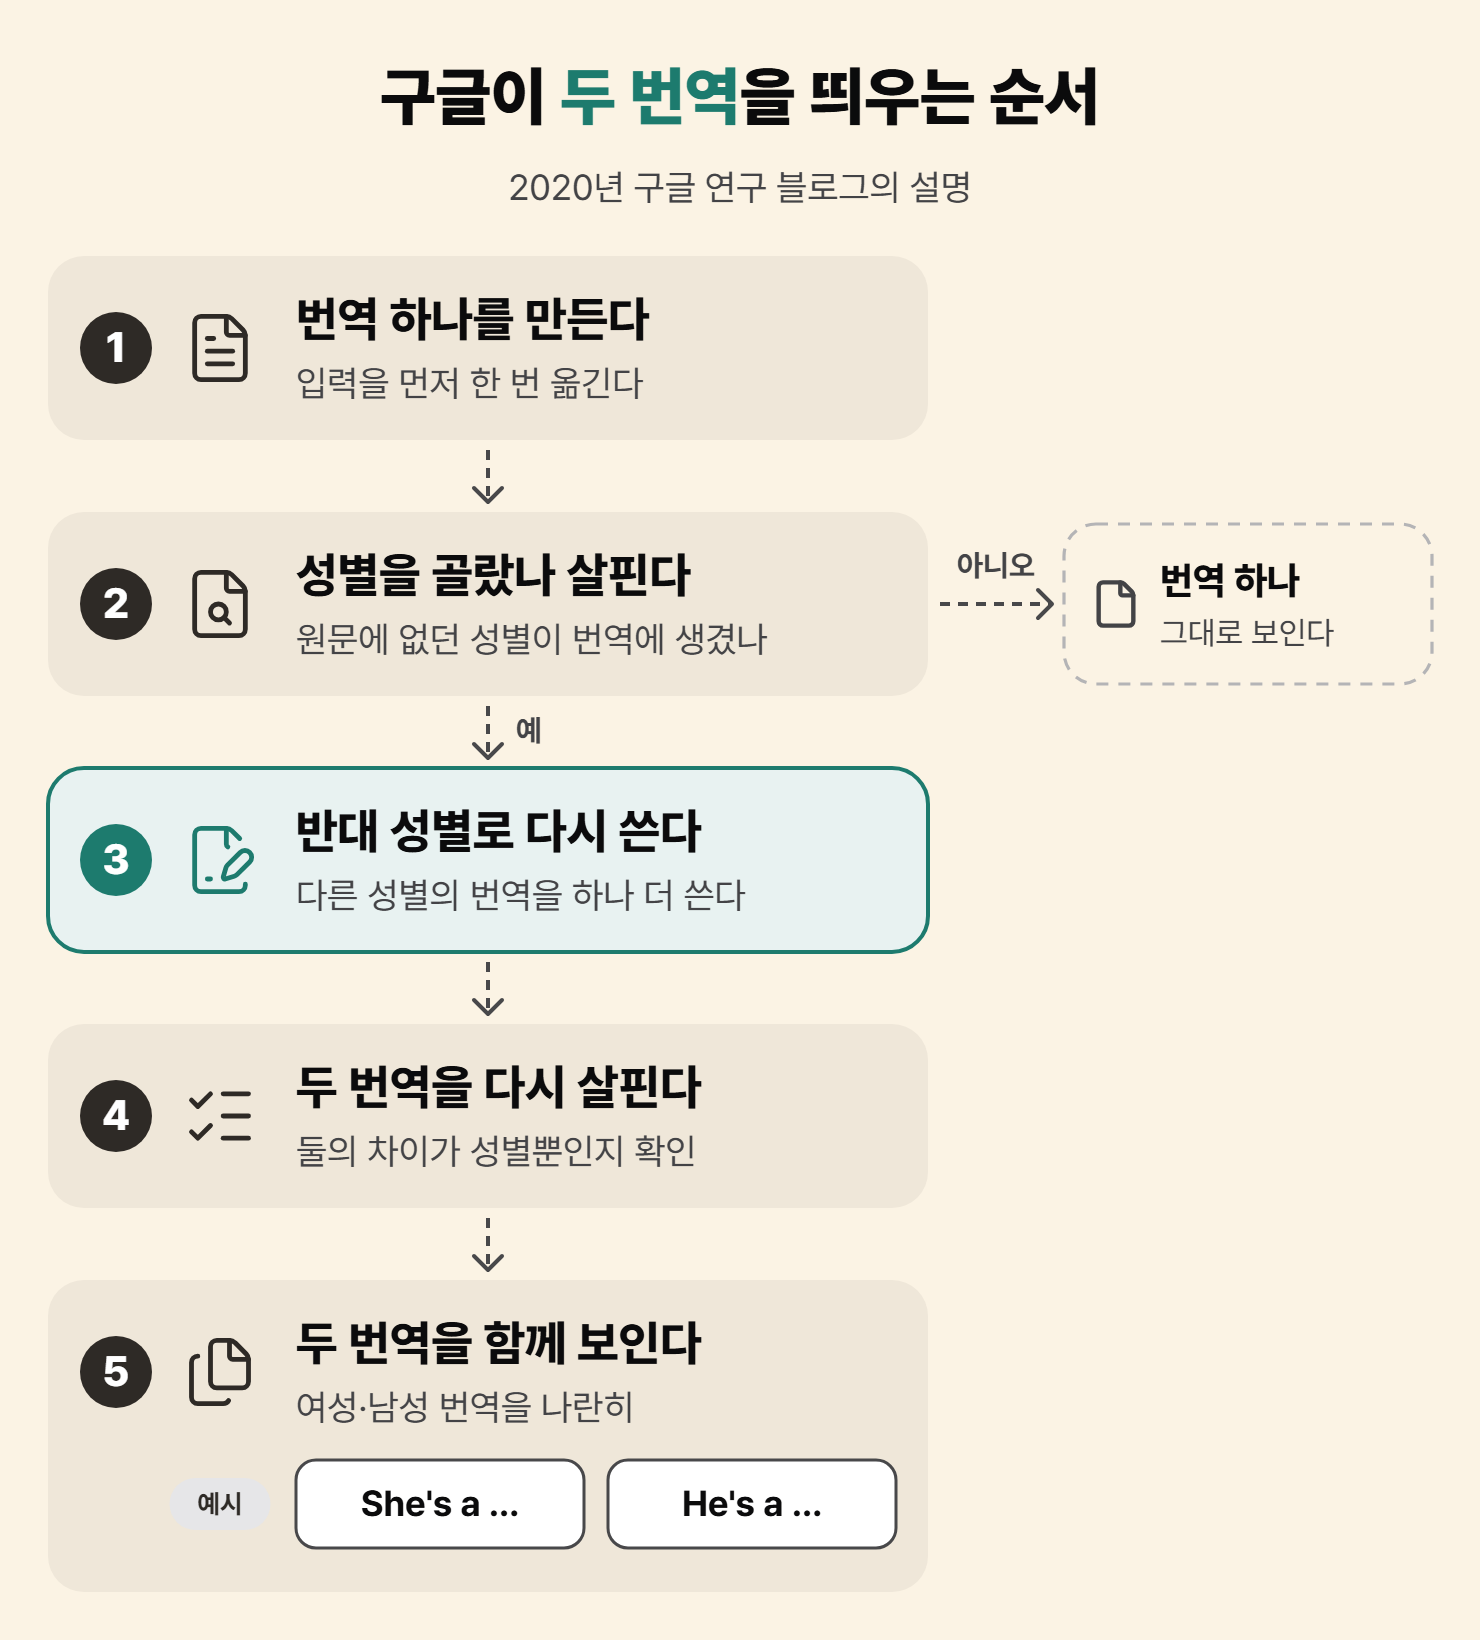
2020년 방식은 순서를 바꿨다. 그림 3 처럼 번역을 먼저 하나 만들고, 원문에 없는 성별을 그 번역이 골랐는지 살핀다. 골랐다면 반대 성별로 다시 쓴 번역을 만들고, 성별 말고는 같은지 확인한 뒤 둘을 함께 보여 준다.
이 글이 열어 본 구글 공식 문서, 곧 2018년 글 둘과 2020년 글, 도움말 어디에도 한국어→영어는 나오지 않는다. 도움말은 어느 언어에서 되는지 목록을 싣지 않는다. 구글이 고른 해법은 성별을 알아맞히는 것이 아니라, 성별을 골랐다면 반대쪽 번역도 함께 보여 주는 것이었다.
영어→그리스어 2025 측정에서도 남성형이 기본값이었다
Gkovedarou 외 연구진은 2025년 논문에서, 한국어가 아니라 영어를 그리스어로 옮기는 번역을 쟀다(질의 날짜는 논문에 없다). 시험 문장은 성별이 드러나지 않게 만든 영어 문장 160개(단수 they 를 쓴 40문장 포함)다. 단수 they 는 성별을 밝히지 않고 한 사람을 가리키는 they 다. 남성형은 구글 번역 74.4%, 번역 서비스 딥엘(DeepL) 70.6%였고, 여성형은 8.1%와 13.1%였다. 저자들은 「the masculine form remained the overall default」(남성형이 여전히 전체의 기본값이었다)라고 요약했다.
OpenAI 의 언어 모델 GPT-4o 는 성별이 모호하면 남성형·여성형·중립형 세 번역을 내라는 지시를 예시와 함께 받은 조건에서, 240문장 가운데 42.9%에 세 번역을 냈다. 지시 없이 얻은 값이 아니다. 2019년 한국어와 2025년 그리스어는 언어도, 때도, 재는 법도 다르다. 그래서 두 값을 이어 나아졌다거나 나빠졌다고 읽을 수는 없다. 그래도 남성형이 기본으로 나오는 모양은 다른 언어 짝에서도 보였다.
번역문의 he 가 어디서 왔는지는 원문 주어가 말해 준다
처음의 두 줄을 다시 보면, 「걔는 간호사야」의 She 도 「그 사람은 간호사야」의 He 도 원문에는 없던 성별이다. 둘 중 한쪽이 그럴듯해 보여도 사정은 같다. 원문은 성별을 말하지 않았고, 번역기가 둘 가운데 하나를 골랐다. 구글의 정의로 말하면, 원문에 정해져 있지 않은 성별을 번역에서 고른 경우다.
영어 번역문만 읽어서는 이 He 가 원문에서 온 것인지 번역기가 넣은 것인지 드러나지 않는다. 예를 들어 원문이 「그 남자는 간호사야」였다면, 바르게 옮긴 번역도 똑같이 「He’s a nurse.」다. 구글처럼 두 번역을 함께 띄우면 번역기가 성별을 골랐다는 사실이 화면에 드러난다. 번역이 한 줄만 나오면 그 선택은 보이지 않는다.
한국어는 주어를 빼고 말하는 일도 잦다. 이를테면 「어제 간호사 시험 붙었대」라는 말에는 성별은커녕 주어도 없다. 이런 문장을 영어로 옮길 때 주어 자리에 he 나 she 가 들어간다면, 그 주어는 통째로 번역기가 채운 것이다.
그래서 번역문에 붙은 he 나 she 가 어디서 왔는지는 원문 한 곳만 보면 가릴 수 있다. 원문 주어가 「걔」나 「그 사람」이었거나 주어가 아예 없었다면, 그 성별은 원문에 없었다. 반대로 원문이 「그 여자는」이나 「걔 남동생은」처럼 성별을 적어 두었다면, she 와 he 는 원문에서 왔다. 2019년 무렵 세 번역기가 성별이 비어 있는 자리에서 고른 쪽은 대개 he 였다. 「그 사람은」 직업 문장에서는 she 를 한 번도 고르지 않았다. 성별 없는 「걔」에서 나온 he 와 she 는, 원문이 아니라 번역기가 적어 넣었다.
더 읽기
- Cho, Kim, Kim, Kim, "On Measuring Gender Bias in Translation of Gender-neutral Pronouns", Proceedings of the First Workshop on Gender Bias in Natural Language Processing (GeBNLP 2019), ACL Anthology W19-3824 (arXiv:1905.11684v1) — https://aclanthology.org/W19-3824/ · 문장 집합·공개 번역 출력 https://github.com/nolongerprejudice/tgbi
- Kuczmarski, "Reducing gender bias in Google Translate", Google Keyword 블로그 (2018-12-06) — https://blog.google/products/translate/reducing-gender-bias-google-translate/
- Johnson, "Providing Gender-Specific Translations in Google Translate", Google Research 블로그 (2018-12-10) — https://research.google/blog/providing-gender-specific-translations-in-google-translate/
- Johnson, "A Scalable Approach to Reducing Gender Bias in Google Translate", Google Research 블로그 (2020-04-22) — https://research.google/blog/a-scalable-approach-to-reducing-gender-bias-in-google-translate/
- Gkovedarou, Daems, De Bruyne, "Gender Bias in English-to-Greek Machine Translation", arXiv:2506.09558v1 (GITT 2025) — https://arxiv.org/abs/2506.09558