챗봇에게 「너 언제까지 배웠어?」 하고 물으면 날짜를 하나 댄다. 그런데 한 모델에는 이 물음에 걸린 날짜가 셋 있다. 회사가 밝힌 날짜, 모델이 스스로 말하는 날짜, 실제 사건 문제로 잰 날짜다. 폴란드 연구진이 모델 35개의 세 날짜를 구할 수 있는 만큼 한 표에 모았다. 그 표에서 회사가 밝힌 날짜와 견줄 수 있는 모델 20개 가운데 14개는 더 이른 날짜를 댔고, 더 늦은 날짜를 댄 모델은 없었다. 사건 문제로 잰 날짜와 견주면 더 이른 날짜를 댄 모델도, 더 늦은 날짜를 댄 모델도 있었다. 모델이 배운 글이 끝나는 날짜를 지식 컷오프(knowledge cutoff)라고 하는데, 챗봇이 대는 지식 컷오프는 이 날짜를 묻는 말에 모델이 내놓은 대답이다.
한 모델에 날짜가 셋 — 2021년 9월, 2023년 9월, 2024년 7월
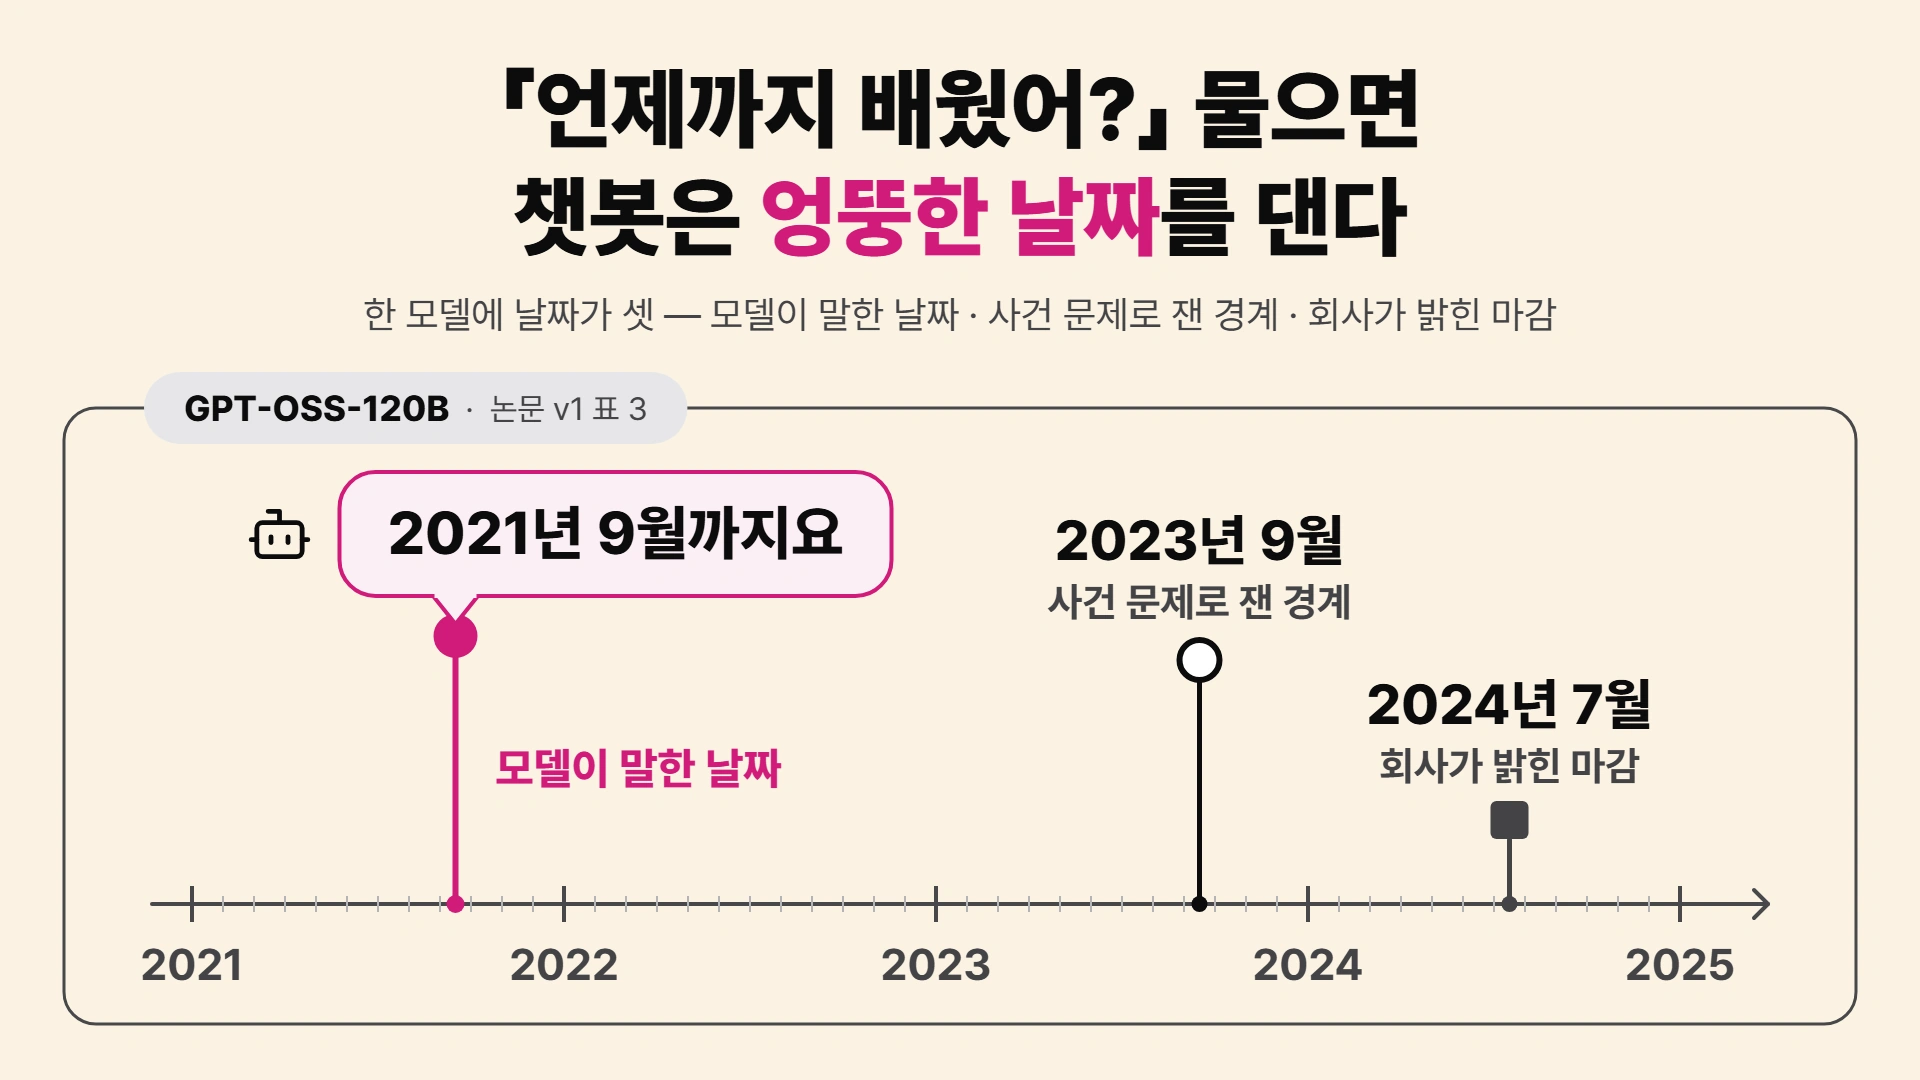
챗봇이 요즘 일을 잘 모르는 듯할 때, 「너 언제까지 배웠어?」 하고 물어볼 수 있다. 그런데 한 모델에는 이 물음에 걸린 날짜가 셋 있다. OpenAI 가 2025년 8월에 공개한 GPT-OSS-120B 를 폴란드 우치대(University of Lodz) 연구진이 살펴본 결과가 그렇다. 모델에게 직접 물었을 때 돌아온 날짜는 2021년 9월이었다. 달마다 그달 뉴스 사건을 묻는 문제를 풀려 점수가 크게 갈리는 달을 찾으면 2023년 9월이 나왔다. 모델을 만든 OpenAI 가 밝힌 학습 마감은 2024년 7월이다.
가장 이른 날짜와 가장 늦은 날짜 사이는 2년 10개월이나 된다. 세 날짜는 정한 쪽부터 다르다. 첫째는 모델 자신의 말이고, 둘째는 바깥 연구진이 잰 값이며, 셋째는 모델을 만든 회사가 적은 날짜다.
언어 모델은 사람이 쓴 방대한 글을 읽으며 배운다. 그 글에는 끝나는 날짜가 있고, 그 뒤에 일어난 일은 모델이 배운 글에 없다. 그래서 그 뒤의 일을 물으면, 모델은 모른다고 답하거나 모르는 채로 그럴듯한 답을 지어낼 수 있다. 모델이 배운 글이 끝나는 날짜를 지식 컷오프(knowledge cutoff)라고 한다. 「언제까지 배웠어?」는 바로 이 날짜를 묻는 말이다. 그렇다면 챗봇이 대답으로 내놓는 날짜는 셋 가운데 어느 것이고, 얼마나 믿을 만할까?
지식 컷오프를 사건 문제로 재면 — 점수가 크게 갈리는 달
모델이 실제로 어디까지 아는지는 물어보는 대신 시험으로 잴 수 있다. 「2024년 12월 4일 이른 아침, 뉴욕의 한 호텔 밖에서 총에 맞아 숨진 사람은 누구인가?」 같은 문제가 그런 시험이다. 정답은 유나이티드헬스케어(UnitedHealthcare)의 최고경영자다. 이 사건이 보도되기 전의 글만 배운 모델은 이 문제를 맞힐 방법이 없다. 그러니 달마다 그달 사건 문제를 풀려 보면, 어느 달을 경계로 그 앞과 뒤의 점수가 크게 갈린다. 이 시험은 그 경계를 모델이 실제로 아는 끝으로 본다.
우치대 연구진은 이 생각을 LLMLagBench 라는 시험으로 만들어 2025년 11월에 논문으로 공개했다. 이 논문은 공개 사이트 arXiv 에 올린 판으로, 학회 게재나 채택 표기가 없다. 연구진은 2021~2025년 뉴스 약 8만 건에서 후보 문제를 뽑고, 그중 보도되기 전에는 정확히 맞힐 수 없는 문제 1,713개를 사람이 직접 골랐다(2025년 10월 기준). 앞의 호텔 총격 문제는 논문이 이런 문제의 예로 실어 둔 몇 개 가운데 하나다. 문제 목록 전체는 새 나가지 않도록 공개하지 않았다.
모델의 답은 다른 AI 모델이 정답과 견줘 0점에서 2점까지 매긴다. 2점은 정답의 핵심을 모두 담은 답이고, 0점은 정답과 전혀 겹치지 않는 답이다. 연구진은 문제 500개를 사람 두 명에게도 채점하게 해, 채점 모델의 점수가 사람과 잘 맞도록 설정을 골랐다. 「모른다」고 답한 경우는 따로 센다. 그다음 문제를 사건 날짜 순으로 늘어놓고, 점수의 평균이 크게 바뀌는 자리를 통계 방법으로 찾는다. 그림 1 는 GPT-OSS-120B 가 받은 점수를 달마다 평균 낸 것이다.

곡선은 달마다 오르내린다. 2023년 6월 0.68점, 7월 0.40점, 8월 0.61점, 9월 0.32점처럼 한 달 사이에 크게 바뀌기도 한다. 그래도 2023년 8월까지 32개 달은 0.39점에서 1.29점 사이를 오갔고, 9월부터 26개 달은 한 번도 0.4점에 닿지 않았다. 논문은 2023년 9월을 경계로 앞 평균 0.72점, 뒤 평균 0.19점을 적었다. 한 달 한 달은 흔들려도, 경계 앞과 뒤의 평균은 크게 갈린다.
이 그림은 논문이 아니라 리더보드 값으로 그렸다. 연구진은 논문을 낸 뒤에도 온라인 순위표(리더보드)를 계속 갱신하는데, 이 모델의 경계를 논문과 리더보드가 다른 달로 적는다. 이 글의 본문은 논문 값인 2023년 9월을 쓴다. 잰 경계는 한 번 정하면 끝나는 날짜가 아니고, 연구진도 이 값을 자기들이 낸 추정값이라고 부른다.
점수가 내려앉은 뒤에도 이 모델은 「모른다」고 답하는 일이 많지 않았다. 모른다고 하거나 답을 피한 비율은 경계 앞 5.9%에서 뒤 32.2%로 올랐을 뿐이다. 경계 뒤 문제에도 셋 중 둘 넘게는 답을 내놓은 셈이다. 저자들은 이 모델이 경계 뒤 사건에도 답을 시도하는 편이라, 최근 일에 대해 지어낸 답이 늘어날 수 있다고 적었다.
같은 논문의 표에는 모델에게 직접 물어 얻은 날짜, 곧 모델이 스스로 말한 날짜(자기 보고)도 실려 있다. 다만 어떤 문구로 몇 번 물었는지는 논문 어디에도 적혀 있지 않다. 그래서 표에 실린 자기 보고 하나하나는, 한 연구실이 공개하지 않은 질문으로 얻은 대답이다.
논문 값으로 보면, 이 모델이 스스로 말한 2021년 9월은 잰 경계 2023년 9월보다 24개월 이르다. 모델의 말이 맞다면 2021년 10월부터 점수가 내려앉아야 하지만, 그림 1 의 곡선은 그 뒤로도 2년 가까이 경계 앞 수준을 지킨다. OpenAI 가 밝힌 2024년 7월은 잰 경계보다 10개월 늦다. 저자들은 모델이 말한 날짜가 이렇게 이른 까닭을 두 갈래로 짐작했다. 지식에 대해 보수적으로 답하도록 조정됐을 수 있고, 모델이 자기를 가늠하는 능력과 실제로 배운 범위가 어긋났을 수도 있다. 둘 다 가설이고, 원인은 확정되지 않았다.
원인이 무엇이든, 모델이 말한 날짜와 잰 날짜는 서로 다른 값이다. 앞의 것은 물으면 돌아오는 말이고, 뒤의 것은 사건 문제를 풀려서 얻은 측정이다. 챗봇에게 「언제까지 배웠어?」 하고 물어서 듣는 날짜는 이 가운데 앞의 것이다.
35개 모델에서는 이를 땐 크게, 늦을 땐 작게 어긋났다
GPT-OSS-120B 한 모델만 이런 것은 아니다. 논문의 표에는 35개 모델의 세 날짜 칸이 있는데, 회사가 밝힌 마감은 12개 모델에서 비어 있다. 35개 가운데 9개를 출시 순서로 놓고 세 날짜를 한 시간축에 찍으면 그림 2 와 같다.

이 표를 우리가 다시 세면, 35개 가운데 모델이 말한 날짜가 잰 경계보다 이른 모델이 11개, 늦은 모델이 9개, 경계와 같은 달인 모델이 4개다. 나머지 11개는 이르다·늦다로 가를 수 없다. 잰 경계가 둘인데 그 사이 날짜를 말한 모델이 7개, 연도만 말한 모델이 3개, 경계가 잡히지 않은 모델이 1개다.
어긋나는 크기도 방향마다 다르다. 이른 11개는 첫 경계보다 중앙값으로 14개월 일렀다. 예를 들어 GPT-4o mini 는 2021년 10월이라고 말했지만, 첫 경계는 2023년 2월로 16개월 뒤였다.
늦은 9개는 마지막 경계보다 중앙값으로 3개월 늦었고, 그중 5개는 3개월 이하였다. Gemini 2.5 Flash 는 2024년 7월이라고 말해, 마지막 경계인 2024년 6월보다 한 달 늦었다. 잰 경계도 판본에 따라 한두 달 달라지기도 한다. 늦은 쪽의 작은 차이는 그 흔들림 안에 들 수도 있다. 그림 3 에서도 왼쪽 점들은 넓게 퍼져 있고, 오른쪽 점들은 0 가까이에 모여 있다.

회사가 밝힌 날짜와 견주면 모양이 달라진다. 회사 날짜와 모델이 말한 날짜가 둘 다 한 달로 적힌 20개 가운데, 모델이 더 이른 날짜를 댄 것이 14개, 같은 달을 댄 것이 6개였다. 회사 날짜보다 늦은 날짜를 댄 모델은 하나도 없었다.
셋이 모두 같은 달인 모델도 있다. GPT-4o(2024-08-06 판)는 회사가 밝힌 날짜, 모델이 말한 날짜, 잰 경계가 모두 2023년 10월이다. GPT-3.5 Turbo 도 회사 날짜와 모델이 말한 날짜, 첫 경계가 모두 2021년 9월이다. 모델이 말한 날짜가 늘 어긋나는 것은 아니다. 다만 잰 값이 아니라서, 어긋날 때는 이른 쪽으로도 늦은 쪽으로도 어긋난다.
잰 경계가 둘인 모델도 있다
Claude Sonnet 4 는 점수가 크게 바뀌는 달이 2023년 2월과 2024년 12월, 두 번 잡혔다. 논문이 적은 구간 평균은 2023년 2월 전이 1.25점, 두 경계 사이가 0.93점, 2024년 12월 뒤가 0.05점이다. 모델이 말한 날짜 2024년 4월은 두 경계 사이에 떨어진다. Anthropic 이 밝힌 마감은 2025년 1월이다.
저자들은 이 모양을 두고, 처음 학습의 마감이 2023년 초였고 그 뒤 2024년 말까지 이어지는 제한된 자료로 지식을 보탰을 수 있다고 봤다. 그러면서 「이 해석이 맞다면」이라는 조건을 붙였다. 이런 모델에서는 「언제까지 배웠나」에 두 달이 다 답이 될 수 있다. 모델이 아는 끝을 한 달로 못 박는 말은 이미 한 번 단순하게 줄인 말이다.
회사가 밝힌 날짜도 문서마다 다르다
구글은 Gemini 2.0 Flash 의 학습 마감을 Gemini 2.5 기술 보고서의 표에는 2024년 6월로, 개발자용 모델 페이지에는 2024년 8월로 적어 두었다. 구글 개발자 문서에서 이름이 3 으로 시작하는 Gemini 모델 페이지 가운데 확인한 아홉 쪽에는 학습 마감 칸이 아예 없다. 회사가 밝힌 날짜도 어느 문서를 보느냐에 따라 달라지고, 아예 적혀 있지 않기도 하다.
「지금이 몇 년이냐」는 또 다른 물음이다. 스탠퍼드 연구진(언어 모델 학회 COLM 2026 에 채택된 논문)은 공개 모델 OLMo2-1B 에 「올해는 ○○년이다」라는 안내를 대화 앞에 붙여 더 학습시킨 한 변형을 시험했다. 목표 연도 351개에서 물으면 대답하는 올해는 94.6%가 맞았지만, 말투에 배어 있는 올해는 1.7%만 맞았다. 말투 속 올해는 「In 1960 there」의 연도를 바꿔 가며 다음 동사의 시제로 쟀다. 이 연구는 「언제까지 배웠어?」를 묻지 않았고 상용 챗봇도 재지 않았으니, 날짜를 잘못 말하는 원인으로 이어 읽을 수는 없다. 다만 한 모델 안에서도 대답하는 올해와 말투 속 올해가 다를 수 있다는 것은 보여 준다.
세 날짜를 한 표에 놓고 챗봇이 대는 날짜의 행을 찾는다
지금까지 본 세 날짜는 정한 쪽도, 정한 방법도 다르다. 그래서 같은 「언제까지 배웠나」에 대한 답인데도 서로 어긋날 수 있고, 어긋날 때는 그 모양도 저마다 다르다. 셋 가운데 사건 문제로 잰 경계만 모델이 무엇을 아는지 시험해서 얻었다.
| 날짜 | 누가 정했나 | 어떻게 정했나 | 이 글에서 본 어긋남 |
|---|---|---|---|
| 회사가 밝힌 마감 | 모델을 만든 회사 | 보고서나 모델 페이지에 적는다 | 같은 모델도 문서마다 다르다(Gemini 2.0 Flash 6월·8월), 적혀 있지 않기도 하다 |
| 모델이 말한 날짜 | 모델 자신 | 물으면 대답한다 — 재는 과정이 없다 | 잰 경계보다 이르기도(11개) 늦기도(9개) 했다 |
| 사건 문제로 잰 경계 | 바깥 연구진 | 달마다 그달 사건 문제를 풀려 점수가 갈리는 달을 찾는다 | 경계가 둘인 모델이 있고, 판본마다 달라지기도 한다 |
모델이 말한 날짜가 회사 문서와 맞아떨어져도, 그것만으로 모델이 아는 끝을 알 수는 없다. 회사 날짜와 같은 달을 댄 모델 6개 가운데 Llama 모델 넷은, 사건 문제로 잰 마지막 경계보다 늦은 날짜를 댔다. 두 날짜가 같아도, 둘 가운데 어느 것도 모델이 무엇을 아는지 시험해서 얻은 값은 아니다.
그러니 어디서든 날짜 하나를 들었을 때는, 위 표에서 그 날짜가 들어갈 행을 먼저 찾는다. 챗봇에게 물어서 들은 날짜는 「모델이 말한 날짜」 행이다. 그 행의 「어떻게 정했나」 칸에는 「물으면 대답한다」가 적혀 있다. GPT-4o 처럼 세 날짜가 모두 같은 달인 모델에서도, 모델이 말한 날짜는 이 행에 남는다. 챗봇이 대는 「○○년 ○월까지」는 그 칸에 적힌 대로, 물으면 돌아온 대답으로 읽어야 한다.
이 글이 기댄 자료
LLMLagBench 논문은 arXiv 2511.12116 의 첫 판(v1, 2025년 11월 15일)이고, 지금까지 나온 판은 이것 하나다. 학회 심사 표기는 없다. 모델별 세 날짜는 논문 표 3 에 실린 35개 모델을 전부 썼다. 이르다·늦다·같은 달의 개수는 논문에 없는 값으로, 우리가 그 표를 다시 센 것이다.
날짜는 달까지만 남겨 견줬고, 모델이 말한 날짜가 둘 적힌 칸은 첫 값을 썼다. 「같은 달」은 모델이 말한 달이 잰 경계 가운데 하나와 같은 경우다. 달별 점수 그림은 2026년 9월 30일에 받은 리더보드 값으로, 논문과는 7개 모델에서 경계 날짜가 다르다. 이 연구는 회사 서버에 요청해 쓰는 모델과 내려받을 수 있는 공개 모델을 쟀고, 검색 같은 기능이 붙는 챗봇 앱의 동작은 재지 않았다.
더 읽기
- Pęzik, Kaczyński, Szymańska, Żarnecki, Deckert, Kwiatkowski, Janowski, "LLMLagBench: Identifying Temporal Training Boundaries in Large Language Models", arXiv:2511.12116v1 (2025, 프리프린트) — https://arxiv.org/abs/2511.12116 · 리더보드 https://huggingface.co/spaces/pelcra/llmlagbench
- van Adrichem, Bhaskar, Yang, Potts, Huang, "Do Language Models Consistently Encode the Current Year?", COLM 2026 (arXiv:2608.15507v1) — https://arxiv.org/abs/2608.15507
- Google, Gemini API 「Gemini 2.0 Flash」 모델 페이지 — https://ai.google.dev/gemini-api/docs/models/gemini-2.0-flash · Gemini Team, "Gemini 2.5: Pushing the Frontier with Advanced Reasoning, Multimodality, Long Context, and Next Generation Agentic Capabilities.", arXiv:2507.06261v6, Table 1 — https://arxiv.org/abs/2507.06261