구매 버튼 두 가지를 방문자 반씩에게 보여 주는 A/B 테스트에서는, 덜 팔리는 버튼을 본 쪽에서 그 차이만큼 구매를 놓친다. 결과를 보며 잘 팔리는 쪽에 방문자를 더 보내면 이 손해는 크게 준다. 대신 시험이 끝난 뒤 두 버튼이 얼마나 다른지를 덜 정확하게 잰다. 두 쪽의 차이가 우연으로도 나올 만한 크기인지 가리는 보통의 셈을 그대로 쓰면, 차이가 없는데 있다고 판정하는 일도 늘어난다. 잘 팔리는 쪽으로 몰아주는 이 방법을 밴딧(bandit)이라고 한다.
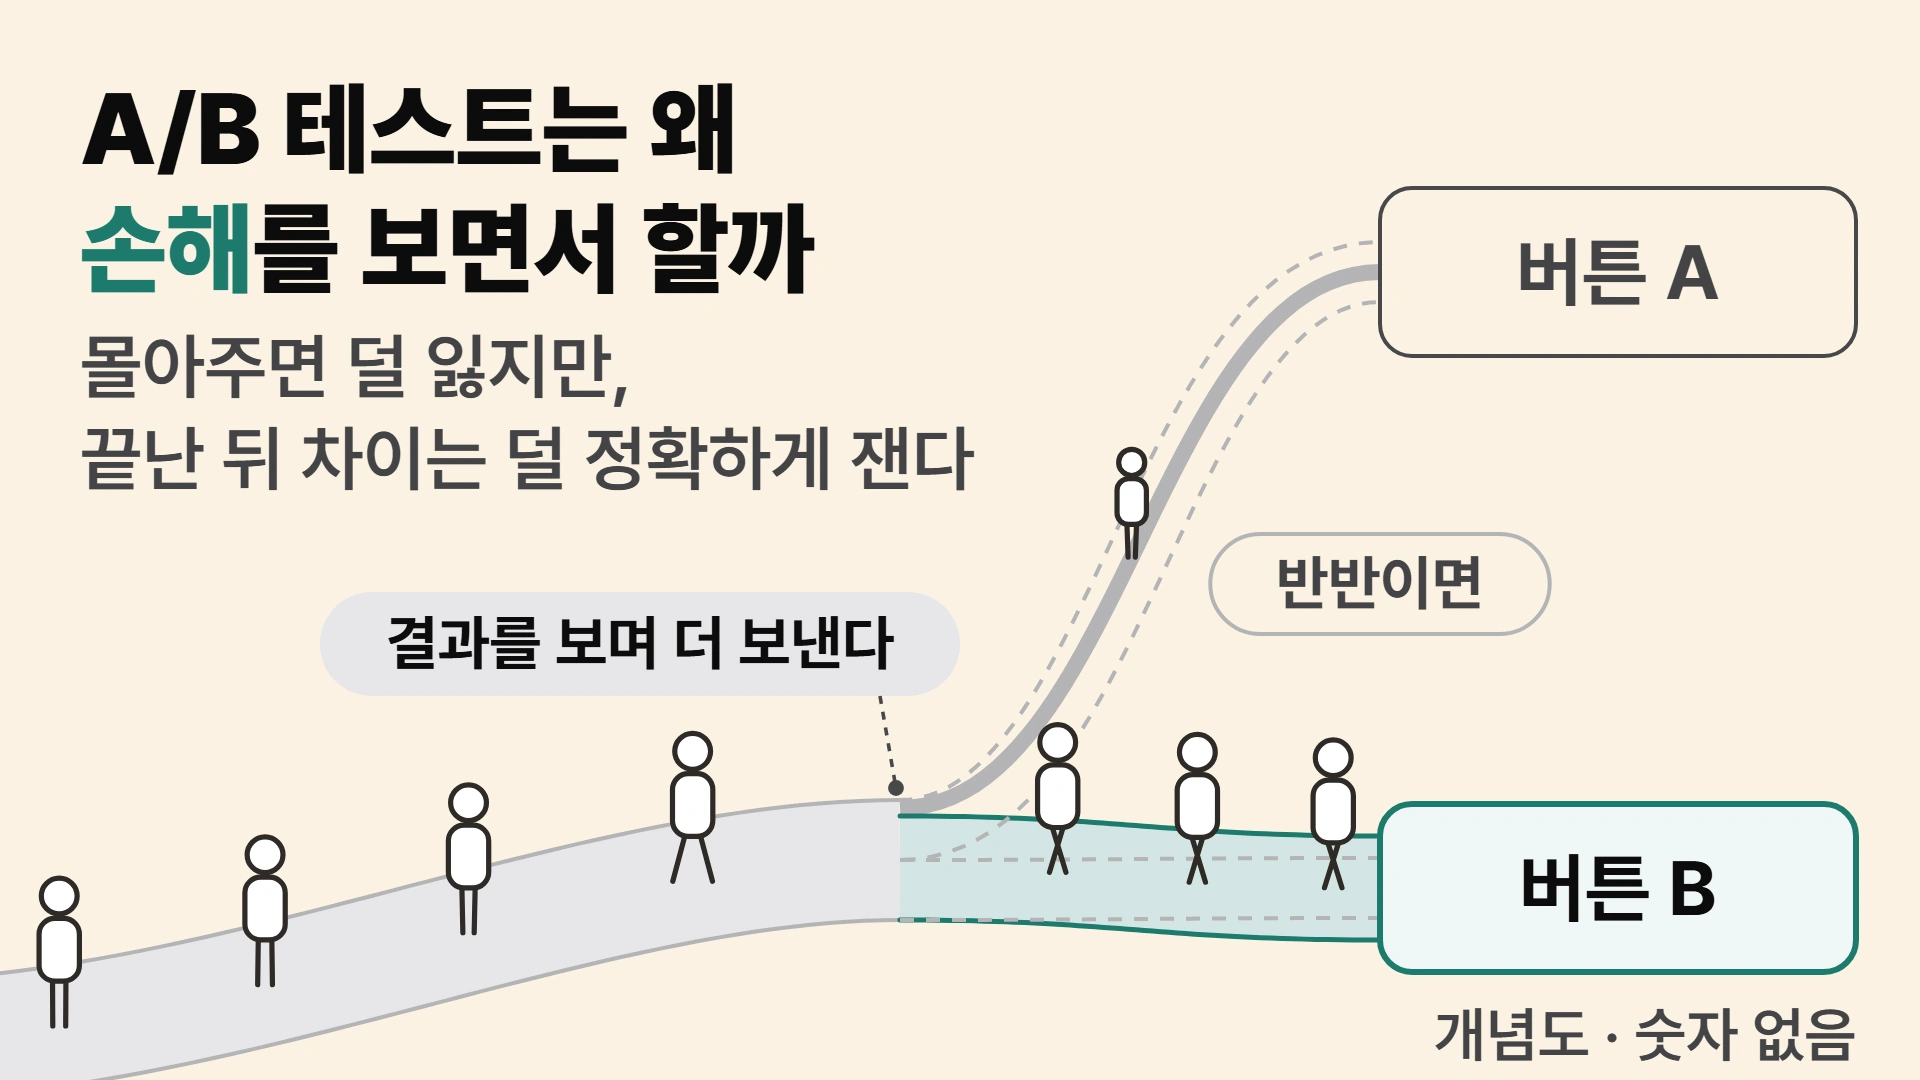
쇼핑몰을 맡아 구매 버튼을 초록과 주황 중 무엇으로 할지 정하려고, 방문자 반씩에게 하나씩 보여 주는 시험을 몇 주 돌린다고 하자. 끝나고 보니 주황이 더 팔렸다면, 초록을 본 절반에게서는 주황이었으면 더 나왔을 구매만큼을 그동안 놓친 셈이다. 결과는 날마다 보이는데 비율은 끝까지 반반이니, 손해를 알면서 두는 일처럼 느껴진다. 그렇다면 A/B 테스트는 왜 손해를 보면서 할까? 반반으로 나눠야 시험이 끝난 뒤 두 쪽의 차이를 치우침 없이 잴 수 있어서다. 손해를 줄이며 좋은 쪽으로 몰아주는 방법은 그 정확도를 내준다.
A/B 테스트로 반반 나눌 때 놓치는 구매는 두 쪽 차이만큼이다
A/B 테스트는 방문자를 처음부터 끝까지 정해 둔 비율(보통 반반)로 나눠 두 안을 따로 보여 주는 시험이다. 어느 쪽이 나은지는 전환율로 가린다. 전환율은 방문자 가운데 구매처럼 원하는 행동까지 간 사람의 비율이다. 온라인에서는 버튼 색을 바꾸는 데 돈이 거의 들지 않는다. 그래서 구글의 Steven L. Scott은 2015년 논문에서, 이런 시험의 비용은 손님에게 덜 좋은 쪽을 보여 주는 데서 생기는 손해가 거의 전부라고 적었다.
반반으로 나누면 덜 팔리는 쪽에도 방문자 절반이 간다. 그렇다고 그 절반이 통째로 손해는 아니다. 덜 팔리는 버튼을 본 사람도 대부분은 어느 버튼이든 사지 않았을 사람이고, 일부는 그 버튼으로도 산다. 놓친 구매는 나쁜 쪽에 간 방문 수에 두 쪽 전환율의 차이를 곱한 만큼이다. 이 글에서 손해라고 부르는 것이 이 놓친 구매다.
Scott이 같은 논문에서 든 예가 이 계산을 보여 준다. A의 전환율이 0.1%, B가 0.11%라면 A에 보낸 방문 1만 번마다 구매 1건을 잃는다. 손해가 이만큼 작으면 차이를 가려내기도 어렵다. B가 A보다 나은지를, 차이가 있을 때 95% 확률로 알아채도록 짠 반반 시험은 한 쪽에 2,270,268 방문, 모두 약 450만 방문이 든다. 하루 100명이 들어오는 사이트라면 약 125년이 걸리는데, Scott도 현실적으로 너무 길다고 적었다.
이 글의 모의 실험은 더 흔한 크기를 골랐다. 두 버튼의 전환율이 4% 대 5%이고, 방문 22,332번을 반반으로 나눈다. 이 방문 수는 구글 애널리틱스 도움말이 같은 전환율로 든 반반 시험의 크기를 다시 계산한 값이다.
이 시험에서 반반은 「처음부터 좋은 쪽만 보냈다면」보다 기대 구매가 111.67건 적다. 실제로 나온 구매의 차이가 아니라 평균으로 따진 기댓값이다. 나쁜 쪽에 간 11,166 방문에 차이 1%p를 곱한 값(111.66건)과 거의 같다. 좋은 쪽만 보냈을 때의 기대 구매 1,116.6건에 비하면 10.0%다. 반반의 손해는 두 쪽이 얼마나 다르냐와 시험을 얼마나 오래 하느냐로 정해지고, 시험이 길어지는 만큼 꼬박꼬박 쌓인다.
밴딧으로 몰아줄 때 손해는 줄지만 차이를 덜 정확히 잰다
반반을 끝까지 지키지 않는 방법도 있다. 시험 도중 결과를 보며 좋아 보이는 쪽에 방문자를 더 보내는 방법을 멀티 암드 밴딧(multi-armed bandit), 줄여서 밴딧(bandit)이라고 부른다. 밴딧은 이 블로그의 넷플릭스 썸네일이 사람마다 다른 이유에서 썸네일을 고르며 놓친 재생을 줄이는 방법으로 나온 적이 있다. 이 글이 보는 것은 같은 몰아주기의 다른 면, 곧 끝난 뒤 차이를 재는 정확도와 맞바뀌는 쪽이다.
Scott은 지금 좋아 보이는 쪽을 따를지, 판단이 틀렸을 때를 대비해 다른 쪽도 계속 시험할지가 이 문제의 핵심이라고 정리했다. 많이 쓰이는 규칙은 톰슨 샘플링(Thompson sampling)이다. 지금까지 나온 결과로 각 버튼이 더 나은 쪽일 확률을 따져, 그 확률만큼 다음 방문자를 그 버튼에 보낸다. Scott의 예로 말하면, B가 더 나을 확률이 23%일 때 다음 방문자가 B로 갈 확률도 23%다.
결과가 쌓여 B가 낫다는 쪽으로 기울면 B로 가는 방문자가 점점 늘어난다. Scott은 이렇게 하면 분명히 못한 쪽은 덜 시험하게 되어, 시험의 손해가 줄고 못한 쪽에 배정됐을 손님도 더 나은 화면을 본다고 설명했다. Optimizely도 구매처럼 0과 1로 세는 지표에는 이 방법을 쓴다고 문서에 적었다.
대가는 시험이 끝난 뒤에 나온다. 나쁜 쪽은 방문을 적게 받으니, 그쪽 전환율은 작은 표본으로 잰 값이 된다. 게다가 운 나쁘게 낮게 시작한 쪽은 덜 뽑혀서 다시 올라올 기회가 적다. 운 좋게 높게 시작한 쪽은 더 뽑히면서 제 값으로 돌아온다. Nie 연구팀(2018)은 좋아 보이는 쪽을 더 뽑는 규칙으로 모은 자료에서는 각 쪽의 평균이 참값보다 낮게 잡히는 쪽으로 치우친다는 것을 수학으로 보였다.
이 글의 모의에서 「몰아주기」는 모두 이 톰슨 샘플링을 그대로 쓴 것이다. 웹 설정(4% 대 5%, 22,332 방문, 50명마다 배정을 고침)에서 그 손해는 반반의 20.7%, 약 5분의 1이었다. 대신 같은 시험을 2,000번 되풀이해 끝날 때마다 두 쪽 차이를 재 보니, 그 값이 퍼진 폭은 반반의 2.76배였다. 반반이 치르는 손해는 시험이 끝난 뒤 차이를 치우침 없이 재는 데 드는 값이다.
반반과 몰아주기를 고를 때는 끝난 뒤 쓸 숫자부터 적는다
다음 실험을 시작하기 전에, 반반과 몰아주기 가운데 무엇을 쓸지 아래 순서로 정한다. 순서는 시험이 끝난 뒤 쓸 숫자에서 시작한다. 그 숫자가 무엇이냐에 따라 맞는 방법이 갈리기 때문이다.
- 시험이 끝난 뒤 쓸 숫자를 먼저 적는다. 「B의 전환율이 A보다 몇 %p 높은가」를 보고서나 예산, 다음 실험 설계에 쓸 것인지, 「어느 쪽을 남길까」만 정하면 되는지 가른다. 예컨대 「주황의 전환율이 초록보다 몇 %p 높다」를 다음 분기 매출 계획에 넣을 거라면 앞쪽이다.
- 차이의 크기를 쓸 거라면 처음부터 끝까지 반반으로 고정하고, 시험 도중 비율을 바꾸지 않는다.
- 어느 쪽을 남길지만 정하면 된다면 몰아주기를 쓸 수 있다. 다만 시험 기간 내내 두 버튼의 전환율이 함께 꾸준히 오를 일(계절이 바뀌는 시기처럼)이 있으면 반반으로 돌아간다.
도중에 비율을 바꿨다면 비율이 같았던 기간마다 따로 재서 합친다. Optimizely 문서가 든 산술 예에서는 11월에 기존 안 10%·새 안 20%, 12월에 20%·30%로 두 달 모두 차이가 10%p다. 11월에 반반으로 나누다가 12월에 기존 안 75%·새 안 25%로 바꾸면, 합친 값의 차이는 약 7.3%p로 줄어든다. 이 블로그가 다룬 심슨의 역설과 같은 원리다. 부분마다 이긴 쪽이 합치면 지는 것처럼, 이 예에서는 전환율이 높은 12월에 새 안이 기존 안보다 방문을 훨씬 적게 받아 합친 차이가 작아 보인다.
2단계의 근거는 뒤에서 차이의 퍼짐과 판정을 다루는 두 절에 있다. 통계 검정은 두 쪽의 차이가 우연으로도 나올 만한 크기인지를 셈으로 가리는 일이다. 보통은 차이가 없을 때 「있다」고 잘못 판정하는 비율이 5%가 되도록 기준을 맞춘다. 몰아준 시험은 차이를 더 넓게 재고, 보통의 통계 검정으로 판정하면 결과도 흔들린다. 끝에 고른 쪽이 맞더라도, 그 시험이 낸 「몇 %p 높은가」는 믿고 쓰기 어렵다.
3단계 앞부분은 고르기만 할 때는 두 방법이 거의 같다는 데서 나온다. 웹 설정을 2,000번 돌렸을 때, 시험 끝에 더 높게 잰 쪽이 실제로 나은 쪽인 비율은 반반 100%, 몰아주기 99.9%였다. 3단계 뒷부분의 근거는 기간 중 전환율이 움직이는 경우를 다룬 절에서 본다. 두 방법을 가르는 것은 끝난 뒤 그 숫자를 어디에 쓰느냐다.
설정을 바꿀 때 몰아주기가 줄이는 손해의 폭도 달라진다
그림 1은 웹 설정에서 손해가 방문 수에 따라 쌓이는 모습이다. 반반은 방문 수에 비례해 거의 곧은 선으로 쌓여 끝에 111.67건이 된다. 몰아주기도 처음에는 두 버튼에 대해 아는 것이 없어 거의 반반으로 보낸다. 그래서 처음에는 손해가 가파르게 쌓이다가, 결과가 B 쪽으로 기운 뒤에는 A에 가는 방문이 드물어져 선이 눕는다.
몰아주기는 절반 지점인 11,250 방문에서 평균 18.39건이 쌓였고, 끝에서는 23.14건이었다. 같은 지점에서 반반은 56.26건으로 끝값의 절반쯤이었다. 2,000번 평균으로 몰아주기는 방문의 89.6%를 B에 보냈고, 끝까지 반반보다 기대 구매 88.5건을 덜 놓쳤다.

몰아주기의 손해는 회차마다 많이 다르다. 2,000번의 한가운데 값은 17.83건이고, 10번 중 1번은 45.54건을 넘었다. 평균이 한가운데 값보다 큰 것은 가끔 크게 잃는 회차가 있어서다.
줄어드는 폭도 설정에 따라 다르다. 임상 시험을 흉내 낸 설정에서 성공률 30% 대 50%, 환자 148명, 1명마다 배정을 고치면 몰아주기의 손해는 반반의 33.2%였다. 25% 대 35%에서 200명이면 51.9%, 같은 확률에서 654명이면 28.4%였다. 웹 설정의 「약 5분의 1」은 그 설정에서 나온 값이고, 몰아주기가 늘 주는 할인율이 아니다.
몰아준 뒤 차이를 잴 때 추정값이 넓게 퍼진다
웹 설정의 참 차이는 1%p다. 같은 시험을 2,000번 돌려, 끝날 때마다 B의 전환율에서 A의 전환율을 뺀 값을 모았다. 위아래 2.5%씩을 뺀 가운데 95%가 반반은 0.45~1.53%p 사이에, 몰아주기는 0.43~3.44%p 사이에 들었다(그림 2). 이 범위는 시험 한 번의 결과가 아니라 2,000번 되풀이한 결과가 퍼진 폭이다. 몰아주기 쪽은 평균도 1.33%p로, 참 차이보다 33.4% 컸다.
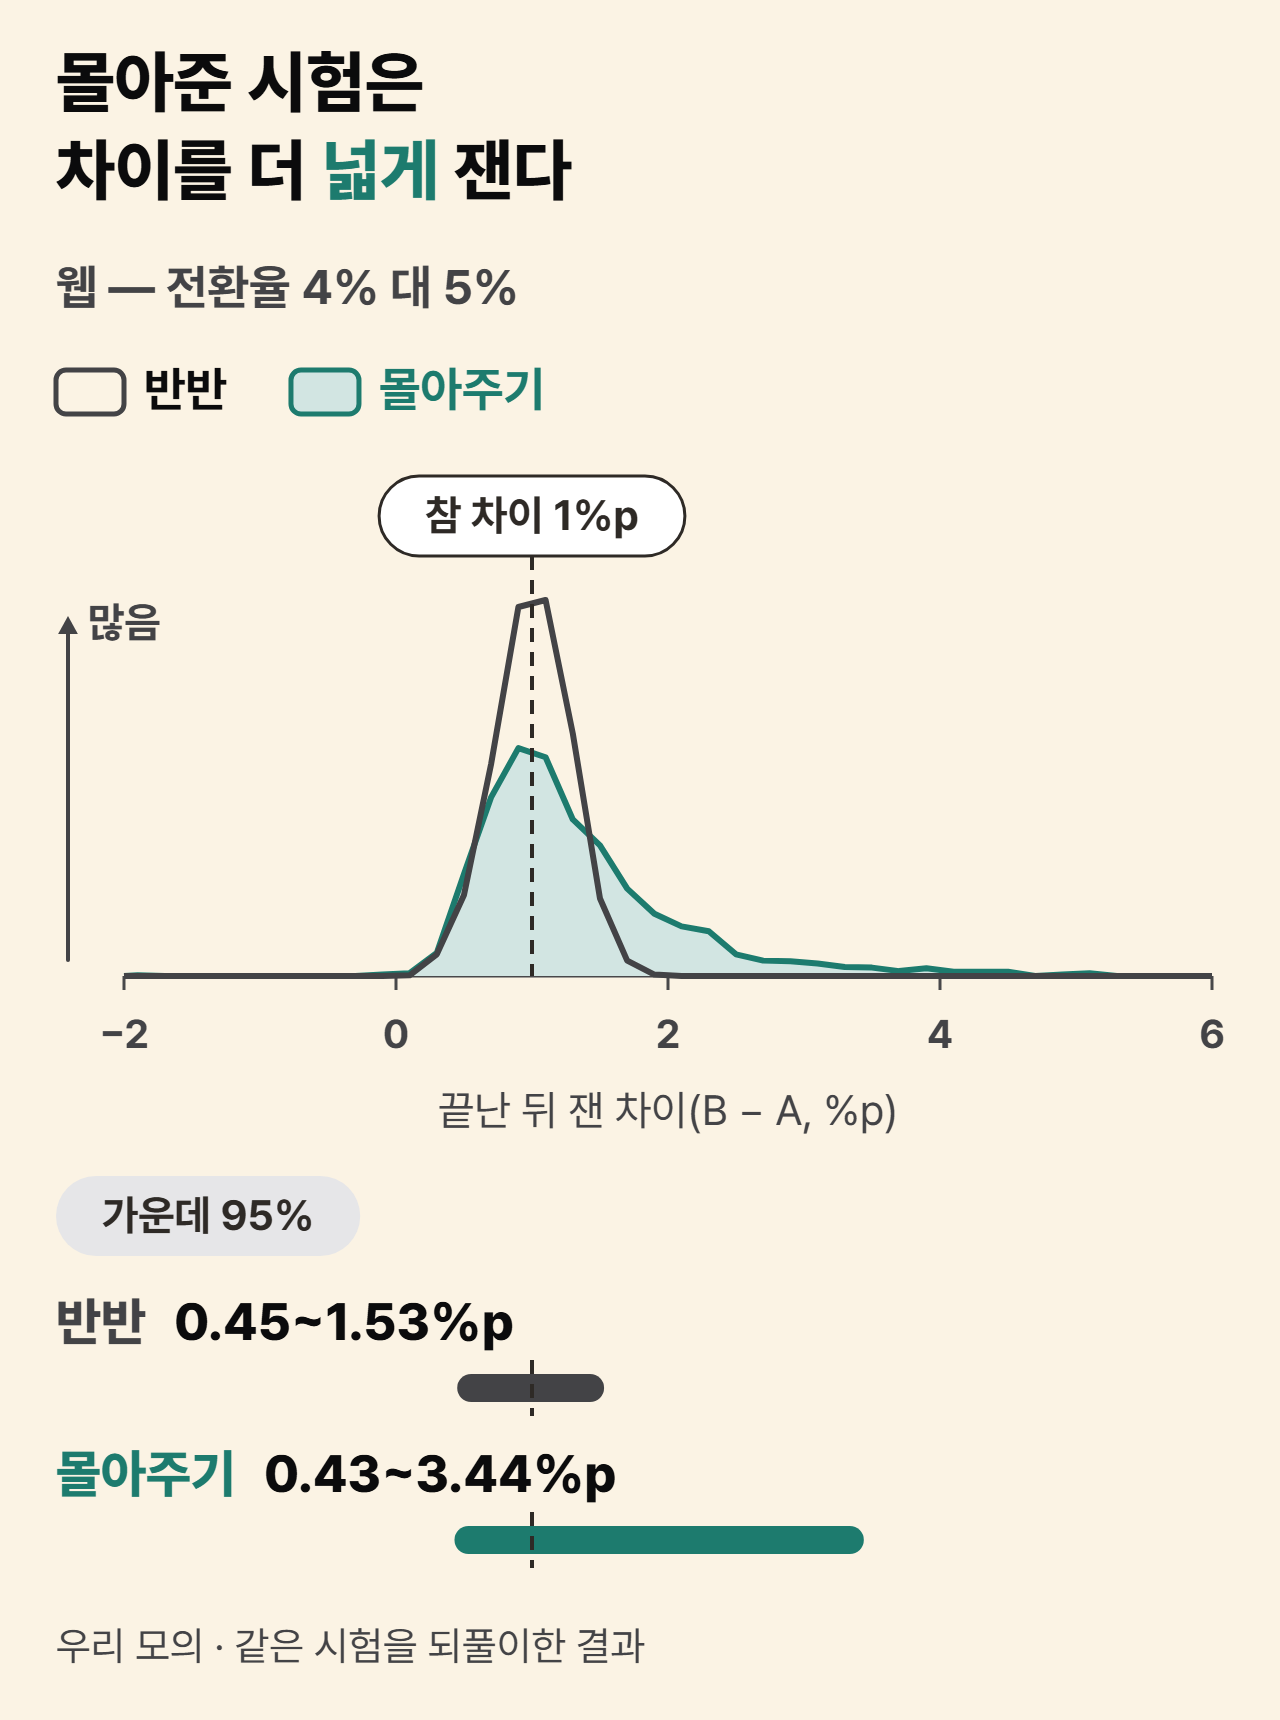
큰 쪽으로 치우친 이유는 나쁜 쪽이 낮게 잡히는 데 있다. 나쁜 쪽 A가 운 나쁘게 낮게 잡히면 방문을 덜 받아 낮은 채로 끝나고, 그만큼 B와의 차이가 커 보인다. 이 모의에서 A의 전환율은 평균 0.34%p 낮게 잡혔다. A는 방문을 적게 받아 값 자체도 많이 흔들렸다.
Villar 연구팀(2015)도 자신들이 다룬 몰아주기 규칙에서, 덜 배정된 나쁜 쪽의 평균이 더 낮게 잡혀 새 치료가 기존 치료보다 나은 정도가 크게 잡힌다고 적었다. 임상 설정(30% 대 50%, 148명)에서도 몰아주기는 차이를 평균 25.7% 크게 쟀다. 다만 문헌은 차이의 치우침이 늘 이 방향이라고 하지 않는다. Robertson 연구팀(2023)은 각 쪽의 평균은 낮게 잡히지만, 두 쪽의 차이는 음이나 양 어느 쪽으로도 치우칠 수 있다고 정리했다. 이 모의에서는 부풀었다. 한 번의 시험으로 「B가 몇 %p 높은가」를 말할 때, 몰아준 시험의 숫자는 반반의 숫자보다 훨씬 넓은 범위에서 나온다.
보통 검정을 그대로 쓸 때 없는 차이를 더 자주 찾는다
Villar 연구팀은 임상 시험에 밴딧을 쓰면 더 나은 치료에 환자를 더 배정하는 큰 이점이 있지만, 차이를 통계로 가려내는 힘에서는 심각한 한계가 있다고 요약했다. 몰아준 자료에 보통의 통계 검정을 그대로 쓰면 판정이 두 방향으로 흔들린다. 웹 설정에서 두 버튼이 똑같이 4%일 때, A든 B든 한쪽이 낫다고 잘못 판정한 비율은 기준 5%에서 반반 5.1%, 몰아주기 15.5%였다. 차이가 실제로 있을 때(4% 대 5%) B가 낫다고 맞게 판정한 비율은 반반 94.5%, 몰아주기 77.5%였다.
이 값은 구글 애널리틱스나 Optimizely의 밴딧 기능이 내리는 판정의 오류율이 아니다. 검정 자체가 불가능하다는 말도 아니다. Robertson 연구팀은 결과를 보며 배정하는 시험도 맞게 설계하고 분석하면 잘못 판정할 확률을 통제할 수 있다는 연구가 늘고 있다고 정리했다. 보통 검정이 몰아준 시험에 내놓은 「차이가 있다」는, 실제로 차이가 없을 때도 반반보다 훨씬 자주 나온다.
우리 모의에서 전환율이 꾸준히 오를 때 몰아주기가 더 틀린다
시험 기간 중 전환율이 움직이는 경우는 Scott의 예와 다른, 이 글이 세운 가정으로 따로 돌렸다. 두 버튼은 같은 폭으로 함께 움직여, 차이는 언제나 1%p(차이가 없는 경우는 0)다. 요일형은 주말 이틀만 두 버튼 모두 1%p 오른다. 추세형은 처음부터 끝까지 곧게 1%p 오른다. 4%p 오르는 추세형(4%가 끝에 8%가 된다)도 일부러 크게 잡아 돌렸다.
차이가 없는데 있다고 판정한 비율은 몰아주기에서 변화가 없을 때 15.5%, 요일형에서 16.3%로 거의 같았다. 1%p 추세형에서는 36.5%로 뛰었고, 일부러 크게 잡은 4%p 추세형에서는 95.0%였다. 반반은 같은 네 경우에 5.1%·5.9%·5.0%·5.3%로 5% 근처에 머물렀다. 차이가 있을 때도 4%p 추세형에서는 몰아주기가 시험 끝에 더 높게 잰 쪽이 실제로 나은 쪽인 비율이 95.5%로 내려갔다(반반 100%). 고르기만 할 때도 추세가 있으면 반반으로 돌아가라는 3단계의 근거다.
임상 시험에서도 비슷한 결과가 있다. Robertson 연구팀이 정리한 Villar 연구팀(2018)의 모의가 그렇다. 차이가 없는 두 치료의 성공률을 시험 동안 함께 올리자, 환자에게 유리한 쪽으로 몰아주는 규칙 하나는 없는 차이를 찾는 비율이 5%에서 25% 가까이로 올랐다. Villar 연구팀(2018)은 이런 규칙의 오판이 크게 부풀려면 성공 확률이 처음 값의 25% 넘게 바뀌어야 한다고 봤고, Robertson 연구팀이 이 판단을 옮겼다. Robertson 연구팀의 그 문장은 25%가 상대 비율인지 적지 않았다. 이 글의 1%p 추세는 4%의 25%로, 그 경계 근처의 크기다.
Scott은 기간 중 변화에는 반반 시험도 걸릴 수 있지만, 밴딧은 더 짧게 돌기 때문에 「더 취약하다(more susceptible)」고 적었다. 반반이 버티는 것은 두 버튼이 같은 기간을 똑같이 나눠 겪기 때문이다. 몰아주기에서는 늦게 방문을 많이 받은 쪽이 기간 후반의 변화를 더 많이 떠안는다.
다음 실험 방식을 고를 때는 무엇이 더 급한지부터 묻는다
다음 분기에 결제 페이지 버튼 두 안 가운데 하나를 남겨야 하는 담당자라면, 업체 문서부터 읽게 된다. 구글 애널리틱스 도움말(2013년 말 보관본, Scott이 쓴 글)은 밴딧이 보통의 시험만큼 「통계적으로 타당하다(just as statistically valid)」고 소개했다. 많은 경우 답을 훨씬 빨리 낸다고도 적었다. 그 근거는 실제 회사 사례가 아니라 문서가 직접 돌린 모의 결과다.
Optimizely는 밴딧 기능에서는 차이가 우연인지 아닌지를 판정하지 않고, 대신 잘되는 쪽으로 방문을 민다고 적는다(「MAB optimizations do not generate statistical significance.」). 검정이 수학적으로 불가능해서가 아니라 제품을 그렇게 설계한 것이다. 같은 문서는 밴딧이 짧게 끝나는 일시적인 화면에서 전환을 가장 많이 얻는다고 권한다. 두 목적을 함께 원하는 쪽도 있다. Hadad 연구팀(2021)은 광고 여러 개를 시험하는 회사가 시험 동안에는 밴딧으로 클릭을 늘리면서, 광고마다 효과도 재고 싶어 하는 경우를 들었다. 그리고 그렇게 모은 자료에서도 효과가 들어갈 범위를 바르게 내는 방법을 제안했다.
Scott의 논문도 결론에서 반반 시험의 자리를 남긴다. 온라인 서비스에서는 없는 차이를 있다고 잘못 판정해도 드는 비용이 거의 없다고 보면서도, 전통적인 실험이 설 자리가 없다는 말은 아니라고 적었다. Scott은 전통적인 실험을 큰 전략 결정에만 쓰라고 했다. 그런 결정에서는 없는 차이를 있다고 잘못 판정하면 치르는 비용이 크다. 이 글의 모의가 보여 준 것도 같은 맞바꿈이다. 몰아주기는 네 설정 모두에서 손해를 줄였고, 네 설정 모두에서 차이를 잰 값을 더 넓게 퍼뜨렸다.
이 글의 숫자는 인용한 문헌의 값을 빼면 모두 우리가 돌린 모의 실험에서 나왔다. 웹 설정은 두 버튼, 전환율 4% 대 5%(차이가 없는 경우는 4% 대 4%), 방문 22,332번, 50명마다 배정을 고치고, 일찍 멈추지 않고 끝까지 돌린 고정 길이 시험이다. 검정은 두 쪽의 퍼짐을 따로 잡은 보통의 통계 검정으로, 양쪽 방향 기준 5%다. 같은 시험을 고정한 난수 씨앗으로 2,000번 되풀이했고, 그림의 띠와 범위도 이 2,000번에서 나왔다. 톰슨 샘플링은 아무 결과도 없을 때 두 쪽을 똑같이 보는 데서 출발한다. 임상 설정(148명·200명·654명, 1명마다 배정을 고침)은 1만 번 되풀이했다.
A/B 테스트와 밴딧 사이의 선택은, 시험 동안 덜 잃는 것과 끝난 뒤 차이를 정확히 아는 것 가운데 무엇이 더 급한지로 갈린다.
더 읽기
- Steven L. Scott, 「Multi-armed bandit experiments in the online service economy」, Applied Stochastic Models in Business and Industry 31(1):37–45, 2015 — https://static.googleusercontent.com/media/research.google.com/en//pubs/archive/42550.pdf
- Google Analytics 도움말 「Multi-armed bandit experiments」(Steven L. Scott, 2013-12-31 Wayback 보관본) — https://web.archive.org/web/20131231192655/https://support.google.com/analytics/answer/2844870?hl=en
- Sofía S. Villar, Jack Bowden, James Wason, 「Multi-armed Bandit Models for the Optimal Design of Clinical Trials: Benefits and Challenges」, Statistical Science 30(2), 2015 — https://doi.org/10.1214/14-STS504
- David S. Robertson 외, 「Response-adaptive randomization in clinical trials: from myths to practical considerations」, Statistical Science 38(2), 2023 — https://doi.org/10.1214/22-STS865
- Vitor Hadad, David A. Hirshberg, Ruohan Zhan, Stefan Wager, Susan Athey, 「Confidence Intervals for Policy Evaluation in Adaptive Experiments」, PNAS 118(15), 2021 — https://arxiv.org/abs/1911.02768
- Xinkun Nie 외, 「Why Adaptively Collected Data Have Negative Bias and How to Correct for It」, AISTATS 2018 — https://arxiv.org/abs/1708.01977
- Optimizely, 「History of Stats Accelerator and multi-armed bandits」 — https://docs.optimizely.com/experimentation-strategy/docs/history-of-stats-accelerator-and-multi-armed-bandits
- Optimizely, 「Experimentation distribution methods」 — https://docs.optimizely.com/experimentation-strategy/docs/experimentation-distribution-methods
- Optimizely, 「History of how Optimizely Experimentation controls Simpson’s Paradox in experiments with Stats Accelerator enabled」 — https://docs.optimizely.com/experimentation-strategy/docs/history-of-how-optimizely-experimentation-controls-simpson-s-paradox-in-experiments-with-stats-accelerator-enabled
- 관련 글: 넷플릭스 썸네일이 사람마다 다른 이유 — 같은 몰아주기를 놓친 재생을 줄이는 쪽에서 본 글
- 관련 글: 심슨의 역설: 부분마다 이긴 쪽이 합치면 진다 — 시험 도중 배분을 바꾸면 합친 차이가 달라 보이는 원리의 바탕