스팸 메일은 viagra를 vigra로 쓰듯 철자를 일부러 틀리기도 한다. 낱말을 외워서 스팸을 가르는 필터가, 한 글자만 달라진 낱말을 알아보지 못해서다. 글자 조각으로 보는 필터는 덜 속지만, 글자 사이를 띄우는 수법 앞에서는 그 차이가 사라지거나 뒤집히기도 한다. 이렇게 필터가 외운 목록에 없어 처음 보는 낱말로 처리되는 말을 미등록 단어(OOV, out-of-vocabulary)라고 한다.
스팸 필터를 피하려고, 많은 스패머가 낱말의 철자를 일부러 틀리게 쓰거나 다른 오류를 끼워 넣어 메일을 알아보기 어렵게 만들려 한다. 2005년 스탠퍼드의 이홍락(Honglak Lee)과 앤드루 응(Andrew Ng)이 스팸 메일 논문의 초록에 쓴 문장이다(「deliberately misspelling words」). 예를 들면 viagra를 vigra로, mortgage를 m0rt gage로 쓴다. 사람은 이렇게 비튼 메일도 별 어려움 없이 읽는다. 그러나 내용을 보고 거르는 필터는 대부분 비튼 스팸 낱말을 알아보지 못한다고 저자들은 덧붙였다.
스팸 메일은 왜 일부러 철자를 틀릴까? 낱말을 외워 두고 스팸을 가르는 필터는, 외운 꼴과 다르게 쓴 낱말을 알아보지 못한다. 그래서 스패머는 철자를 한두 글자 비틀어, 필터가 아는 낱말을 처음 보는 낱말로 바꾼다. 낱말 안의 글자 조각으로 보는 필터는 이런 비틀기에 덜 속는다. 다만 글자 사이를 띄우는 수법 앞에서는, 데이터에 따라 그 차이가 사라지거나 뒤집히기도 한다. 스패머가 노리는 틈은, 사람 눈에는 같은 낱말이 필터에게는 다른 낱말로 보인다는 데 있다.
스팸 메일 분류는 낱말 목록에서 시작한다
스팸 필터는 메일을 사람처럼 읽지 않고 낱말을 센다. 먼저 스팸과 멀쩡한 메일을 많이 모아, 낱말마다 어느 쪽에 얼마나 자주 나왔는지 살핀다. 그러면 스팸에 자주 나온 낱말에는 스팸 쪽 무게가, 멀쩡한 메일에 자주 나온 낱말에는 반대쪽 무게가 붙는다. 새 메일이 오면 그 안 낱말들의 무게를 더해, 합이 기준을 넘으면 스팸으로 거른다. 2005년 무렵의 스팸 필터 논문들이 다룬 필터가 이런 식으로 배운다. 이 글은 낱말 목록으로 가르는 이 방식을 낱말 사전 방식이라고 부른다.
이 방식에서 중요한 것은, 목록에 없는 낱말에는 무게가 없다는 점이다. 필터는 낱말을 철자 그대로의 꼴로 외운다. 「vigra」는 「viagra」와 한 글자 차이지만, 필터에게는 다른 낱말이다. 구글 연구진은 2023년 논문에서, 학습 때 보지 못한 오타가 멀쩡한 낱말까지 「사전에 없는 낱말」로 잘못 처리하게 만들 수 있다고 적었다. 이렇게 필터가 외운 목록에 없는 낱말을 미등록 단어(OOV, out-of-vocabulary)라고 한다.
실제 스팸 문자로 보면 이렇다. 2011년에 공개된 영어 문자 메시지 데이터(UCI SMS)에는 「3. You have received your mobile content. Enjoy」라는 스팸 문자가 있다. 이 글이 정한 비틀기 규칙은 그 가운데 두 낱말을 momile과 contaent로 바꿨다. 그러자 이 데이터로 학습시킨 낱말 사전 방식의 필터는, 비틀기 전에는 스팸으로 잡던 이 문자를 놓쳤다. momile과 contaent는 이 필터가 학습 때 본 낱말 목록에 없고, mobile과 content는 목록에 있던 낱말이다. 이 문자는 비튼 뒤 이 필터만 놓친 문자 가운데 가장 짧은 것을 고른 예다.
같은 문자를 다른 방식의 필터가 어떻게 판정했는지는 뒤에서 본다. 필터는 비튼 두 낱말을 잃었을 뿐, received나 Enjoy 같은 나머지 낱말은 그대로 본다. 필터에게 낱말은 철자 그대로의 꼴이라, 한 글자만 바뀌어도 아는 낱말이 모르는 낱말이 된다.
비튼 낱말이 많을수록 낱말 사전 방식이 놓치는 스팸이 는다
스패머가 필터를 피하는 수법은 여러 가지다. 캘리포니아 대학교 데이비스의 위텔(Gregory L. Wittel)과 우(S. Felix Wu)는 스패머가 화면 배치 속임수와 글자 바꾸기, 무작위 데이터 덧붙이기까지 여러 가지를 써 왔다고 적었다(「Spammers have tried many things from using HTML layout tricks, letter substitution, to adding random data.」). 철자 비틀기는 그 가운데 하나다. 로드(Daniel Lowd)와 믹(Christopher Meek)은 순서를 이렇게 적는다. 필터가 Viagra 같은 낱말이 주로 스팸에 나온다는 것을 배우자, 스패머가 빈칸과 문장부호로 vi@gra처럼 낱말을 비틀기 시작했다. 같은 논문은 멀쩡한 메일에 흔한 낱말을 스팸에 끼워 넣는 수법도 다룬다.
그러면 낱말을 얼마나 비틀어야 필터가 놓칠까? 이 글은 앞의 문자 데이터로 장난감 필터 둘을 만들어 직접 돌려 보았다. 두 필터는 낱말이나 조각마다 무게를 배워 더하는 같은 계산 방식을 쓰고, 입력만 다르다. 하나는 앞에서 본 낱말 사전 방식이고, 다른 하나는 낱말 안의 글자를 3~5개씩 겹쳐 잘라 낸 조각을 목록에 올리는 글자 조각 방식이다. 학습은 비틀지 않은 문자로 하고, 비틀기는 시험할 스팸 문자에만 넣었다. 스패머가 고칠 수 있는 것은 자기 메일뿐이기 때문이다.
두 필터는 모두 멀쩡한 문자를 스팸으로 잘못 거르는 비율을 1%로 맞춰 두고, 스팸 가운데 잡아낸 비율을 쟀다. 비틀지 않았을 때 낱말 사전 방식은 스팸의 92.6%를, 글자 조각 방식은 96.4%를 잡았다. 출발점부터 3.8%p 차이가 난다. 그래서 이 글은 두 방식을 깨끗할 때보다 덜 잡은 몫으로 견준다.
스팸 문자 낱말의 30%를 비틀면 덜 잡은 몫은 낱말 사전 방식 2.3%p, 글자 조각 방식 1.1%p였다. 이 정도로는 둘 다 크게 무너지지 않았는데, 비튼 낱말 밖의 낱말이 아직 남아 있기 때문으로 보인다. 절반을 비틀면 6.0%p와 1.9%p로 벌어졌다.

그림 1에서 비튼 낱말 비율을 끝까지 올리면 두 선이 크게 벌어진다. 낱말을 전부 비틀면 낱말 사전 방식은 깨끗할 때보다 46.3%p 덜 잡았고, 글자 조각 방식은 5.5%p 덜 잡았다. 다만 아주 조금 비틀 때는 차이가 없었다. 낱말의 10%를 비틀면 두 방식 모두 0.4%p 덜 잡았다.
비튼 낱말이 보이면 곧바로 스팸으로 거르는 지름길도 떠올릴 수 있다. 이홍락과 응은 메일을 일부러 비틀었는지 가려내는 일이 「surprisingly difficult」, 곧 뜻밖에 어려웠다고 적었다. 비틀었는지만 보고 가르도록 100줄로 학습시킨 모델은 두 쪽을 같은 수로 맞춘 시험에서 70%를 맞혔다. 다른 방식으로 만든 모델도 84%까지였다. 저자들은 이 두 번째 모델이 84%에 그친 까닭을, 멀쩡한 메일에도 사전에 없는 낱말과 오타, 이모티콘·낯선 주소·서명 같은 기호가 많아 비튼 메일처럼 보이기 때문인 것 같다고 적었다.
낱말 몇 개를 비튼다고 필터가 통째로 속지는 않는다. 다만 비튼 낱말이 하나 늘 때마다, 그 낱말이 지던 무게가 하나씩 빠진다. 그래서 비튼 낱말이 늘수록, 낱말을 철자째 외우는 필터가 먼저 놓친다.
스팸함의 이상한 철자는 두 갈래로 나눠 볼 수 있다
확인은 내 스팸함에서 시작한다. 철자가 이상한 낱말을 하나 골라 갈래를 정한 다음, 그 갈래를 그림 1에서 늘려 보면 어느 필터가 더 흔들리는지가 보인다. 순서는 셋이다.
- 내 스팸함에서 철자가 이상한 낱말을 찾아, 글자를 숫자로 바꾸거나 빼서 다른 낱말로 만든 꼴(vigra)인지, 기호나 빈칸으로 낱말을 끊은 꼴(v-i-a-g-r-a)인지 나눠 본다. v1@gra처럼 둘이 섞인 꼴도 있다.
- 앞 갈래는 그림 1의 비틀기 종류 1(오타 섞음)에 가깝다. 종류를 1로 두고 비튼 낱말 비율을 0%에서 50%까지 올리며, 칩의 「깨끗할 때보다 덜 잡은 몫」이 어느 방식에서 더 커지는지 본다.
- 뒤 갈래는 종류 2(글자 띄우기)에 가깝다. 같은 50%에서 종류를 2로 바꾸고, 같은 칩에서 두 방식의 크고 작음이 어떻게 바뀌는지 본다. 잡아낸 비율 자체는 깨끗할 때부터 3.8%p 차이가 나므로, 덜 잡은 몫으로 견준다.
첫 단계의 v1@gra와 v-i-a-g-r-a는 이홍락과 응이 실제 스팸 메일에서 본 변형 표에 있는 꼴이다. vigra는 같은 논문 첫머리의 예다. 갈래를 나누는 것은, 두 갈래가 필터가 낱말을 읽는 방식의 다른 곳을 겨누기 때문이다. 글자를 바꾸거나 뺀 꼴은 낱말 하나를 다른 낱말로 만들고, 기호나 빈칸으로 끊은 꼴은 낱말이 잘리는 자리를 바꾼다.
글자 조각으로 보는 필터는 덜 속는다
글자 조각 방식은 낱말 하나를 통째로 외우지 않는다. 낱말 안의 글자를 3~5개씩, 한 칸씩 밀며 잘라 낸 조각을 하나씩 목록에 올려 센다. 「content」에서 세 글자 조각을 자르면 con·ont·nte·ten·ent 다섯 개가 나오고, 비튼 꼴 「contaent」에도 이 가운데 con·ont·ent가 그대로 있다. 낱말 사전 방식에게 비튼 낱말은 통째로 사라지지만, 글자 조각 방식에게는 일부가 남는다. 앞의 문자에서 비튼 두 낱말 자리에 생긴 조각 36개 가운데 13개는 원래 두 낱말에 있던 조각과 같았다. 이 셈에는 낱말의 앞뒤 끝을 표시한 조각도 들어 있다.
글자 조각 방식도 목록은 외운다. 학습 때 본 조각에만 무게가 있고, 처음 보는 조각에는 무게가 없다. 스팸 문자 낱말의 절반을 오타 섞어 비튼 뒤, 학습 목록에 있던 것이 그대로 남은 몫을 세었다. 낱말 사전 방식은 62.7%, 글자 조각 방식은 74.6%였다. 원인을 잰 값이 아니라, 오타를 섞어 비튼 조건에서 남은 몫을 센 값이다.
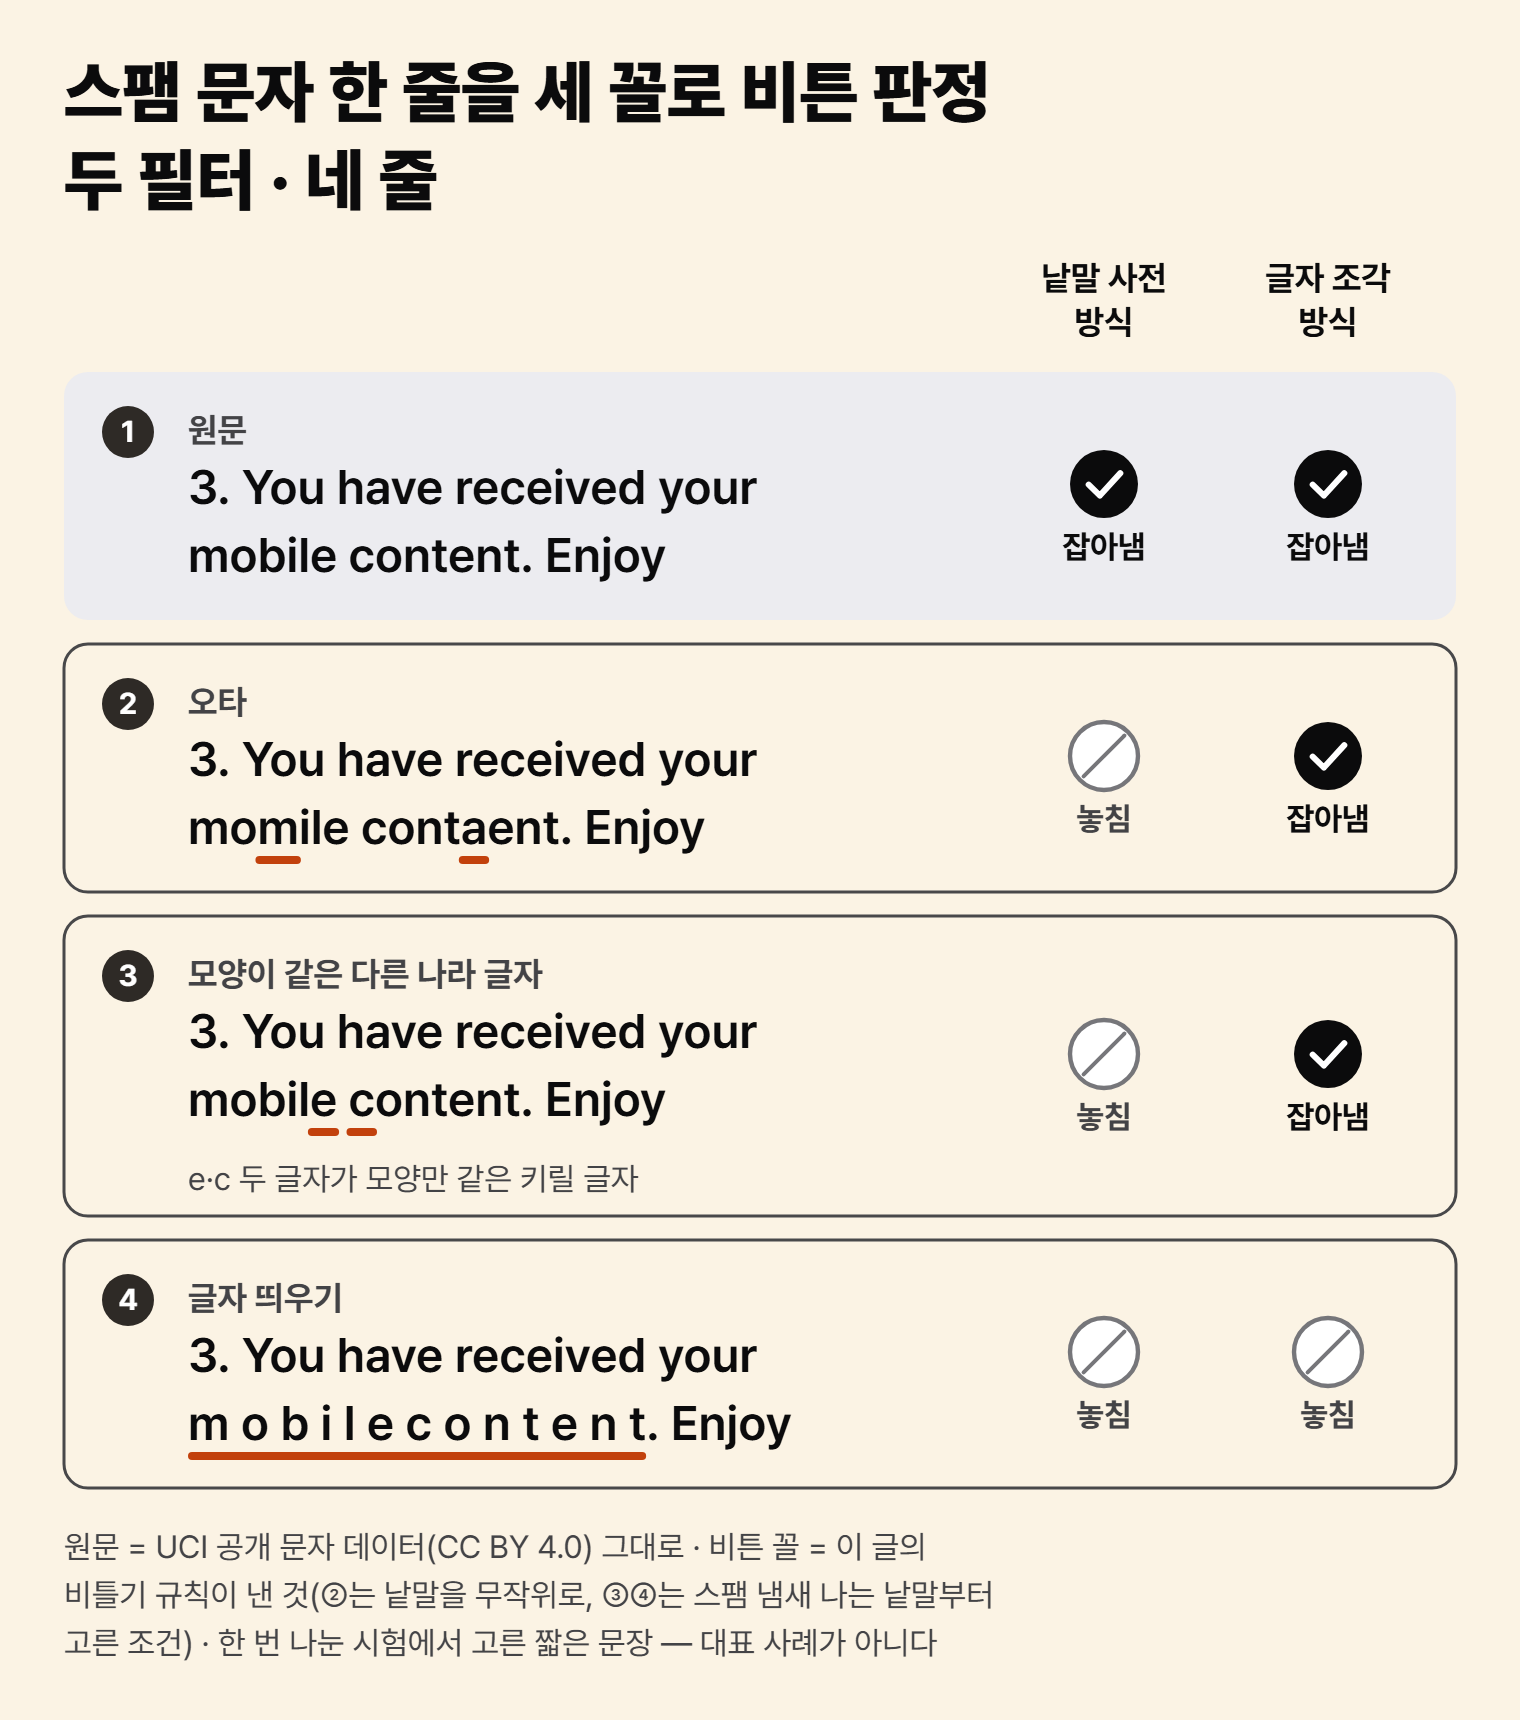
그림 2는 앞의 문자와 그 비튼 꼴 셋을 두 필터가 어떻게 판정했는지 보여 준다. 원문은 두 칸 모두 「잡아냄」이다. 오타 꼴과, 두 글자를 모양이 같은 키릴 글자로 바꾼 꼴은 낱말 사전 방식만 「놓침」이다. 낱말 사전 방식에게 이 두 꼴은 mobile과 content가 빠진 문장과 점수가 같았다.
메일 데이터에서도 방향은 같았다. 2005년까지의 영어 공개 메일 데이터(SpamAssassin)로 같은 장난감을 만들고, 이번에는 스팸 냄새가 나는 낱말부터 골라 비틀었다. 공격자가 필터와 같은 학습 데이터를 안다는 강한 가정이다. 실제 스패머의 능력을 짐작한 것은 아니다. 낱말의 절반을 비틀자 깨끗할 때보다 덜 잡은 몫은 낱말 사전 방식 73.7%p, 글자 조각 방식 13.4%p였다. 비튼 낱말에도 아는 조각이 일부 남는 쪽이, 두 데이터 모두에서 스팸을 덜 놓쳤다.
구글은 Gmail 스팸 필터의 글자 읽는 부품을 바꿨다
구글은 낱말 목록 자체를 없애는 쪽으로 갔다. 2023년 구글 연구진이 발표한 부품은 미리 만든 낱말 목록 없이, 글자 하나하나를 정해진 숫자로 바꿔 낱말을 숫자 묶음으로 만든다. 글자를 컴퓨터의 글자 번호로 바꾼 뒤, 0과 1로 적는 식이다. 이 부품의 이름이 RETVec이다. 여기에 오타 낸 낱말과 원래 낱말을 짝지어 학습한 작은 모델을 붙여, 비튼 낱말이 원래 낱말과 가까운 숫자 묶음이 되게 했다. 철자를 고쳐 주는 교정기는 아니다.
논문의 공격 시험은 스팸이 아니라, 뉴스 기사의 주제를 가르는 분류 모델로 했다. 저자들은 글자를 일부러 바꿔 모델을 속이는 공격 프로그램 세 가지를 썼다. 뚫린 비율은 원래 맞히던 기사 가운데 공격 뒤 틀리게 된 몫이다. 뉴스 시험 기사 1,000건에서 세 공격 평균의 뚫린 비율은 RETVec이 44.8%, 논문이 견준 방식 가운데 가장 많이 뚫린 것이 71.3%였다. 논문이 견준 나머지 네 방식도 그 사이였다. 같은 뉴스 분류 시험을 공격별로 보면, RETVec도 공격 종류에 따라 9.7%에서 67.9%까지 뚫렸다(그림 3).

Gmail에 넣은 결과는 두 문서가 따로 말한다. 구글 보안 블로그의 2023년 11월 글은 Gmail 스팸 필터의 이전 부품을 RETVec으로 바꿔, 기준보다 스팸 탐지율을 38% 높이고 멀쩡한 메일을 스팸으로 잘못 거르는 비율을 19.4% 줄였다고 적었다. 그 기준이 무엇이고 어떤 데이터로 쟀는지는 적혀 있지 않다. 같은 글은 모델 크기를 줄이고 계산을 나눈 것도 함께 들었다. RETVec 논문의 9절은 다른 것은 그대로 두고 이 부품만 바꾼 사내 시험을 적는다. 멀쩡한 메일을 잘못 거르는 비율을 0.80%에 묶었을 때, 기준 모델이라면 놓쳤을 스팸 가운데 38%를 잡았다는 것이다.
그 사내 시험에서 바꿔 낀 이전 부품은 공격 시험에서 가장 많이 뚫린 그 방식으로, 미리 만든 목록에서 낱말 토막을 찾아 쓰는 부품이다. 두 38%가 같은 값이라고 볼 근거는 없다. 비튼 낱말을 원래 낱말 근처에 놓도록 짝지어 배운 이 부품도, 논문의 뉴스 분류 시험에서는 일부러 고른 공격을 상당수 통과시켰다.
글자 사이를 띄우면 글자 조각도 끊긴다
이홍락과 응은 낱말에 빈칸을 끼운 메일에서는, 낱말을 단순하게 끊는 필터가 낱말의 경계부터 제대로 찾지 못한다고 적었다. 영어 문자 데이터에서 낱말을 무작위로 골라 글자 사이를 한 칸씩 띄우면, 절반일 때 덜 잡은 몫이 낱말 사전 방식 4.4%p, 글자 조각 방식 7.0%p였다. 재 본 비율 10~100% 모두에서, 이번에는 글자 조각 방식이 같거나 더 많이 떨어졌다. 스팸 냄새가 나는 낱말부터 띄우면 80%까지는 두 방식이 거의 같이 떨어졌고(절반에서 28.2%p · 27.4%p), 90% 이상에서는 글자 조각 방식이 더 떨어졌다.
메일 데이터(SpamAssassin)에서는 달랐다. 무작위로 절반을 띄워도 두 방식 모두 조금만 떨어졌고, 글자 조각 방식이 덜 떨어졌다(1.8%p · 0.1%p). 스팸 냄새가 나는 낱말부터 절반을 띄우면 75.9%p · 54.4%p로, 여전히 글자 조각 방식이 덜했다. 다만 글자 조각 방식도 오타를 섞을 때(13.4%p)보다는 훨씬 많이 떨어졌다.
「m o b i l e」처럼 띄우면 낱말이 한 글자씩 흩어진다. 앞의 문자를 띄운 꼴에서, 낱말 사전 방식은 한 글자짜리를 낱말로 세지 않아 새로 센 낱말이 하나도 없었다. 글자 조각 방식에서도 원래 두 낱말과 같은 조각은 하나도 남지 않았다. 그림 2의 넷째 줄에서 두 필터가 모두 놓친 것이 이 꼴이다. 다만 이것이 띄우기에서 글자 조각 방식이 더 떨어진 원인인지는 재지 않았다.
RETVec 논문과 Gmail 쪽에는 글자 사이를 모두 띄우는 수법을 따로 잰 값이 없으니, 이 반례를 그쪽으로 옮겨 읽을 근거는 없다. 오타는 낱말 안의 글자를 바꾸고, 띄우기는 낱말 자체를 흩어 놓는다. 그래서 이 결과로 말할 수 있는 것은, 데이터와 고르는 법에 따라 글자 조각 방식의 이점이 사라지거나 뒤집힐 수 있다는 데까지다.
받은편지함의 비튼 철자가 겨누는 것
받은편지함에 「v1@gra」 같은 낱말이 섞인 광고 메일이 한 통 들어와 있다고 하자. 숫자와 기호로 두 글자를 바꾼 이런 꼴은, 낱말을 철자째 외우는 필터를 겨눈다. 그래도 메일 안에 다른 낱말이 많이 남아 있으면 여전히 걸러지기 쉽다. 장난감에서도 낱말 30%를 비튼 정도로는 낱말 사전 방식이 크게 무너지지 않았다.
글자 사이를 띄워 낱말을 자른 꼴은 사정이 다르다. 이런 꼴은 낱말이 잘리는 자리를 건드려, 글자 조각으로 보는 필터까지 겨눈다. 필터가 잡는 기준을 낮추면 이런 메일도 더 잡히겠지만, 그만큼 멀쩡한 메일도 스팸함으로 간다. 이 글이 멀쩡한 문자를 잘못 거르는 비율을 1%로 묶고 잰 것도 그래서다. 비튼 낱말이 있는지만 보고 가르는 모델이 84%에 그친 것도, 저자들의 짐작으로는 같은 사정이었다.
비튼 꼴도 예가 쌓이면 필터가 배운다. 이홍락과 응은 「mort gage」가 든 스팸을 몇 통 보면, 학습하는 필터가 mort와 gage를 스팸 쪽 낱말로 배운다고 적었다. 다만 저자들은 낱말을 비트는 방법이 사실상 끝이 없다고 보았다. 그래서 필터가 그 변형을 다 보고 배우기는 「seems unlikely」, 곧 그럴 것 같지 않다고 적었다. 로드와 믹은 멀쩡한 메일의 낱말을 끼워 넣는 수법에 맞서, 필터를 자주 다시 학습시키는 것이 효과적이었다는 예비 결과(「preliminary」)를 적었다.
그 광고 메일의 철자가 겨누는 것은 결국 필터가 낱말을 외우는 단위다. Gmail이 지금 어떤 부품으로 메일을 거르는지, 한국어 스팸에서도 같은 일이 벌어지는지는 이 글이 쓴 영어 공개 데이터와 논문의 뉴스 분류 시험으로는 알 수 없다. 낱말을 통째로 외워서 보는 필터는, 이 글의 두 장난감에서 철자를 한 글자씩 비튼 낱말이 늘수록 글자 조각으로 보는 필터보다 스팸을 더 많이 놓쳤다.
더 읽기
- Honglak Lee, Andrew Y. Ng, 「Spam Deobfuscation using a Hidden Markov Model」, Second Conference on Email and Anti-Spam(CEAS 2005) — http://www.ceas.cc/papers-2005/166.pdf
- Daniel Lowd, Christopher Meek, 「Good Word Attacks on Statistical Spam Filters」, CEAS 2005 — https://www.ceas.cc/papers-2005/125.pdf
- Gregory L. Wittel, S. Felix Wu, 「On Attacking Statistical Spam Filters」 — https://www.ceas.cc/papers-2004/170.pdf
- Elie Bursztein, Marina Zhang, Owen Vallis, Xinyu Jia, Alexey Kurakin, 「RETVec: Resilient and Efficient Text Vectorizer」, arXiv:2302.09207(v3, 2024-04-23 · NeurIPS 2023 — 9절의 38%·지연 30% 문장은 v2(2023-10)부터 있다) — https://arxiv.org/abs/2302.09207 · 코드 https://github.com/google-research/retvec (2026-10-07 조회 시 보관 처리)
- Elie Bursztein, Marina Zhang, 「Improving Text Classification Resilience and Efficiency with RETVec」, Google Online Security Blog(2023-11-29) — https://security.googleblog.com/2023/11/improving-text-classification.html
- T. Almeida, J. Hidalgo, 「SMS Spam Collection」(2011), UCI Machine Learning Repository, CC BY 4.0 — https://doi.org/10.24432/C5CC84
- Apache SpamAssassin public corpus — https://spamassassin.apache.org/old/publiccorpus/