스무고개에서는 "살아 있는 거야?"처럼 「예」나 「아니오」로만 답할 수 있는 질문을 스무 번까지 던진다. 질문 하나가 남은 후보를 반으로 줄여 준다면, 스무 번이면 100만 개가 넘는 후보 가운데 하나를 가려낸다. 그래서 좋은 질문은 두 답이 나올 확률이 반반에 가까운 질문이다. 어떤 순서로 물어도 평균 질문 수가 그 밑으로는 내려가지 않는 바닥이 있다. 그 바닥을 엔트로피(entropy)라고 한다.
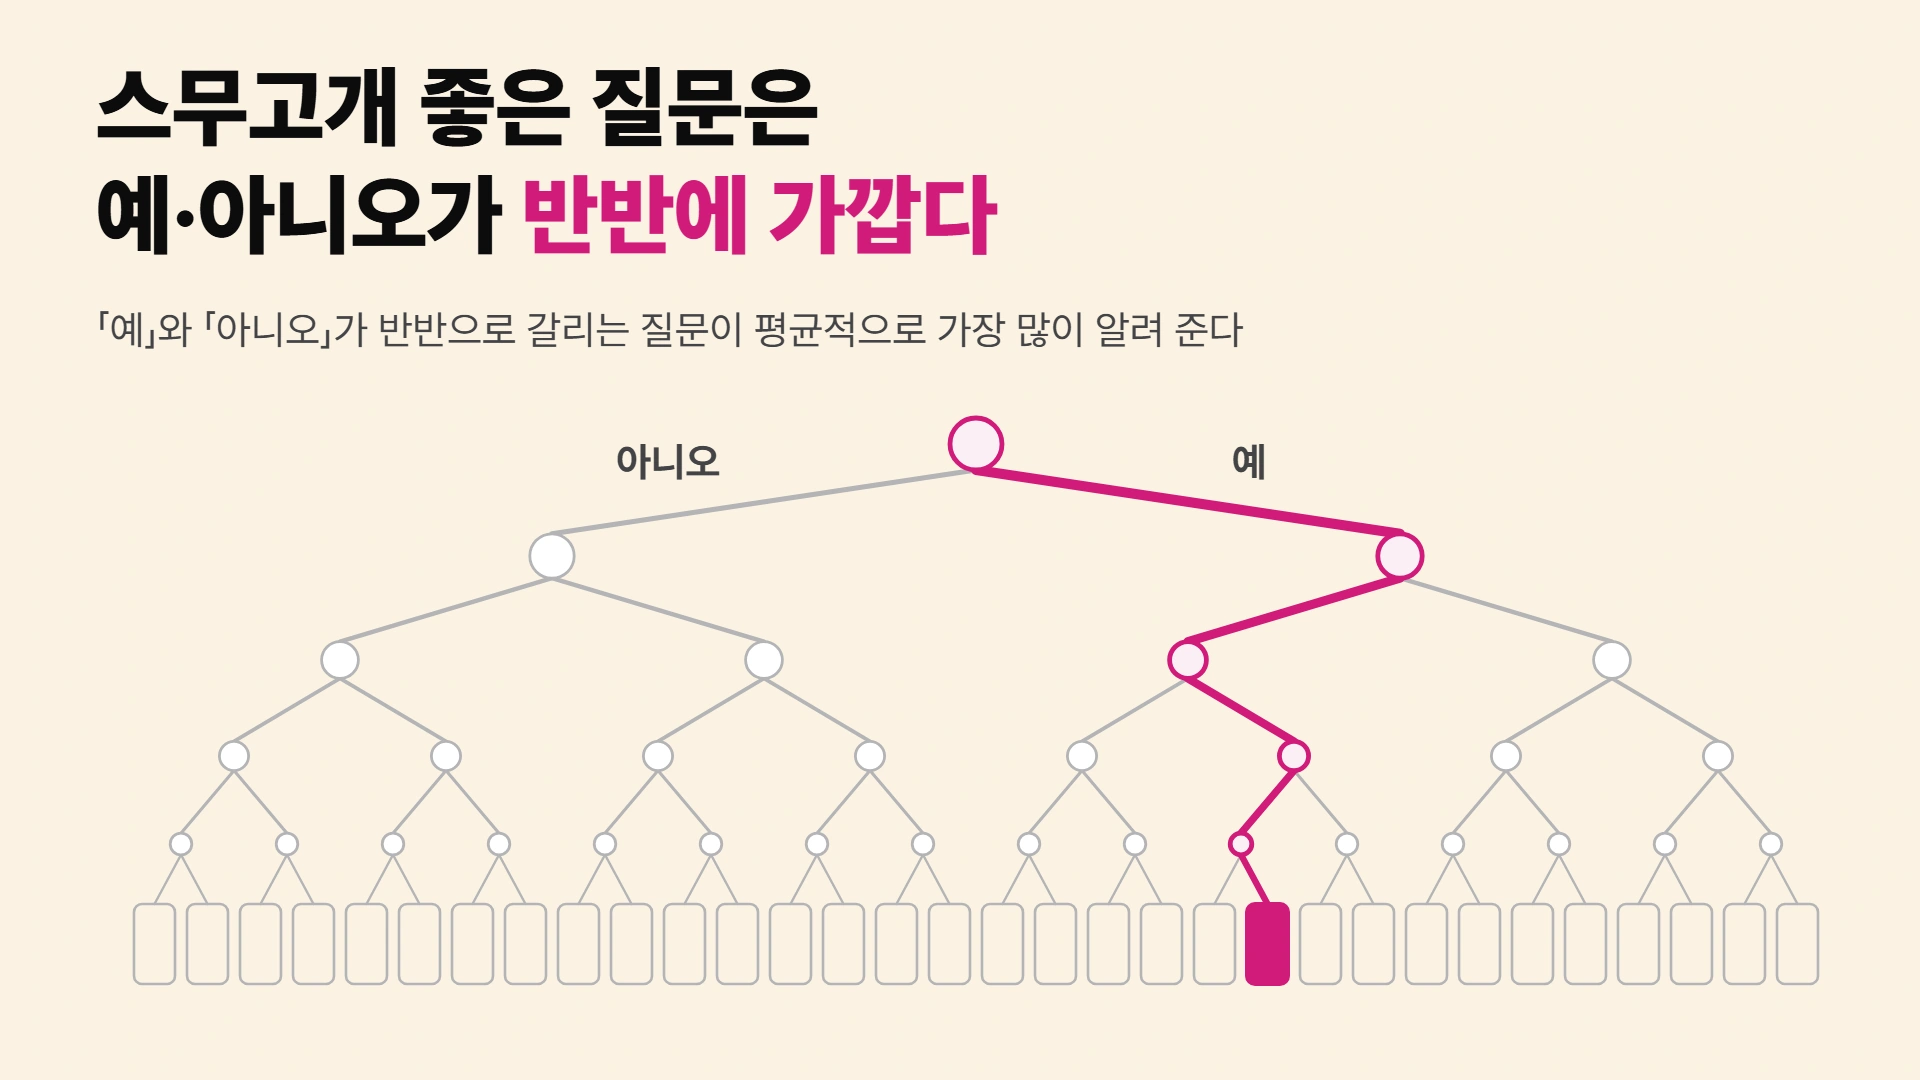
"살아 있는 거야?"가 이번 판 스무고개의 첫 질문이고, 친구의 대답은 "응"이다. 친구가 떠올린 것이 강아지인지 옆집 사람인지는 아직 모른다. 남은 질문은 열아홉 번이고, 친구는 「응」과 「아니」로만 답한다. 스무 번이면 왜 맞힐 수 있을까? 그리고 어떤 질문을 던져야 빨리 맞힐까?
질문 하나가 남은 후보를 반으로 줄여 주고 친구가 떠올린 것이 그 후보 안에 있다면, 스무 번이면 1,048,576개(2²⁰) 가운데 하나를 가려낸다. 그래서 좋은 질문은 「예」와 「아니오」 가운데 어느 쪽이 나올지 반반에 가까운 질문이다. 답이 거의 뻔한 질문은 듣기 전부터 결과를 아는 셈이라 후보를 거의 줄이지 못한다. 가령 "숨을 쉬어?"는 살아 있는 것을 두고 물으면 거의 늘 「응」이 돌아와서, 한 번을 쓰고도 남은 후보가 거의 그대로다.
스무고개, 스무 번이면 몇 개?
후보가 두 개뿐이면 「첫째예요?」 한 번으로 끝난다. 후보가 16개면 반으로 가르는 질문 한 번에 8개가 남고, 다시 4개, 2개, 1개가 남는다. 그래서 질문 네 번이면 된다. 매케이(David MacKay)가 쓴 교재도 스무고개를 소개하며 ‘is it alive?'(살아 있나요?)를 질문의 예로 든다. 같은 책은 0부터 63까지의 정수 하나를 맞히는 놀이에서 64개의 후보를 같은 크기의 두 묶음으로 거듭 가르면 된다고 하고, 결론을 「Six questions suffice.」(질문 여섯 번이면 충분하다)라고 적는다.
후보가 더 많아도 셈은 같다. 후보가 1,000개면 가장 운이 나쁠 때도 10번이면 되고, 100만 개면 20번이 필요하다. 19번으로 가를 수 있는 것은 524,288개까지라 100만 개에는 모자라고, 20번이면 1,048,576개까지 가를 수 있다.
이 셈은 후보가 모두 같은 정도로 그럴듯하고 질문마다 남은 후보를 정확히 반으로 줄일 때 맞는다. 영어 위키백과의 「Twenty questions」 항목도 2²⁰ = 1,048,576이라는 수를 「if each question is structured to eliminate half the objects」(질문마다 후보의 절반을 지우도록 짠다면)라는 조건과 함께 적는다. 같은 항목에 따르면 이 놀이는 적어도 18세기부터 있었다. 같은 항목이 이 셈을 다룬 기록으로 드는 것은 1901년의 글이라, 놀이의 기록이 셈의 기록보다 한 세기 넘게 앞선다. 이름이 2²⁰에서 왔다는 근거도 없다.
그래도 조건만 맞으면 셈 자체는 단순하다. 질문이 하나 늘 때마다 가를 수 있는 후보 수가 두 배가 된다. 스무 번이라는 한도가 넉넉한 까닭은 그 두 배가 스무 번 겹치기 때문이다.
한 후보가 유난히 흔하면?
실제 놀이에서는 후보가 고르게 그럴듯하지 않다. 친구가 방금까지 자기 강아지 이야기를 했다면, 후보 여덟 개 가운데 강아지 하나가 유난히 그럴듯하다. 이럴 때 묻는 법을 네 가지로 나눠 볼 수 있다.
「개수로 반씩」은 확률은 보지 않고 남은 후보 수를 반으로 가르는 질문을 던진다. 「흔한 것부터 하나씩」은 가장 그럴듯한 후보부터 「이거예요?」라고 하나씩 묻는다. 「확률로 반씩」은 후보를 확률 순으로 줄 세운 뒤, 두 묶음의 확률 합이 반반에 가깝게 가른다. 「평균이 가장 적은 순서」는 질문 순서 전체를 짜서 평균 질문 수를 가장 적게 만든 순서다. 이 가운데 「확률로 반씩」은 그림에 넣지 않았고, 가장 적은 순서를 짓는 법과 함께 뒤에서 다룬다.
그림 1는 후보 여덟 개 가운데 한 후보의 확률만 다섯 단계로 올리고, 나머지 일곱 개가 남은 확률을 고르게 나눠 가진 판이다. 단계마다 나머지 세 묻는 법의 평균 질문 수를 막대로 보여 준다. 막대 끝의 숫자가 평균이고, 줄 오른쪽 끝의 회색 칩은 가장 운이 나쁠 때의 질문 수다. 세로 점선은 어떤 순서로 물어도 그보다 적게는 못 묻는 평균이다. 입력 칸 둘로는 확률 단계와 후보 수(8개·16개)를 바꿀 수 있다.
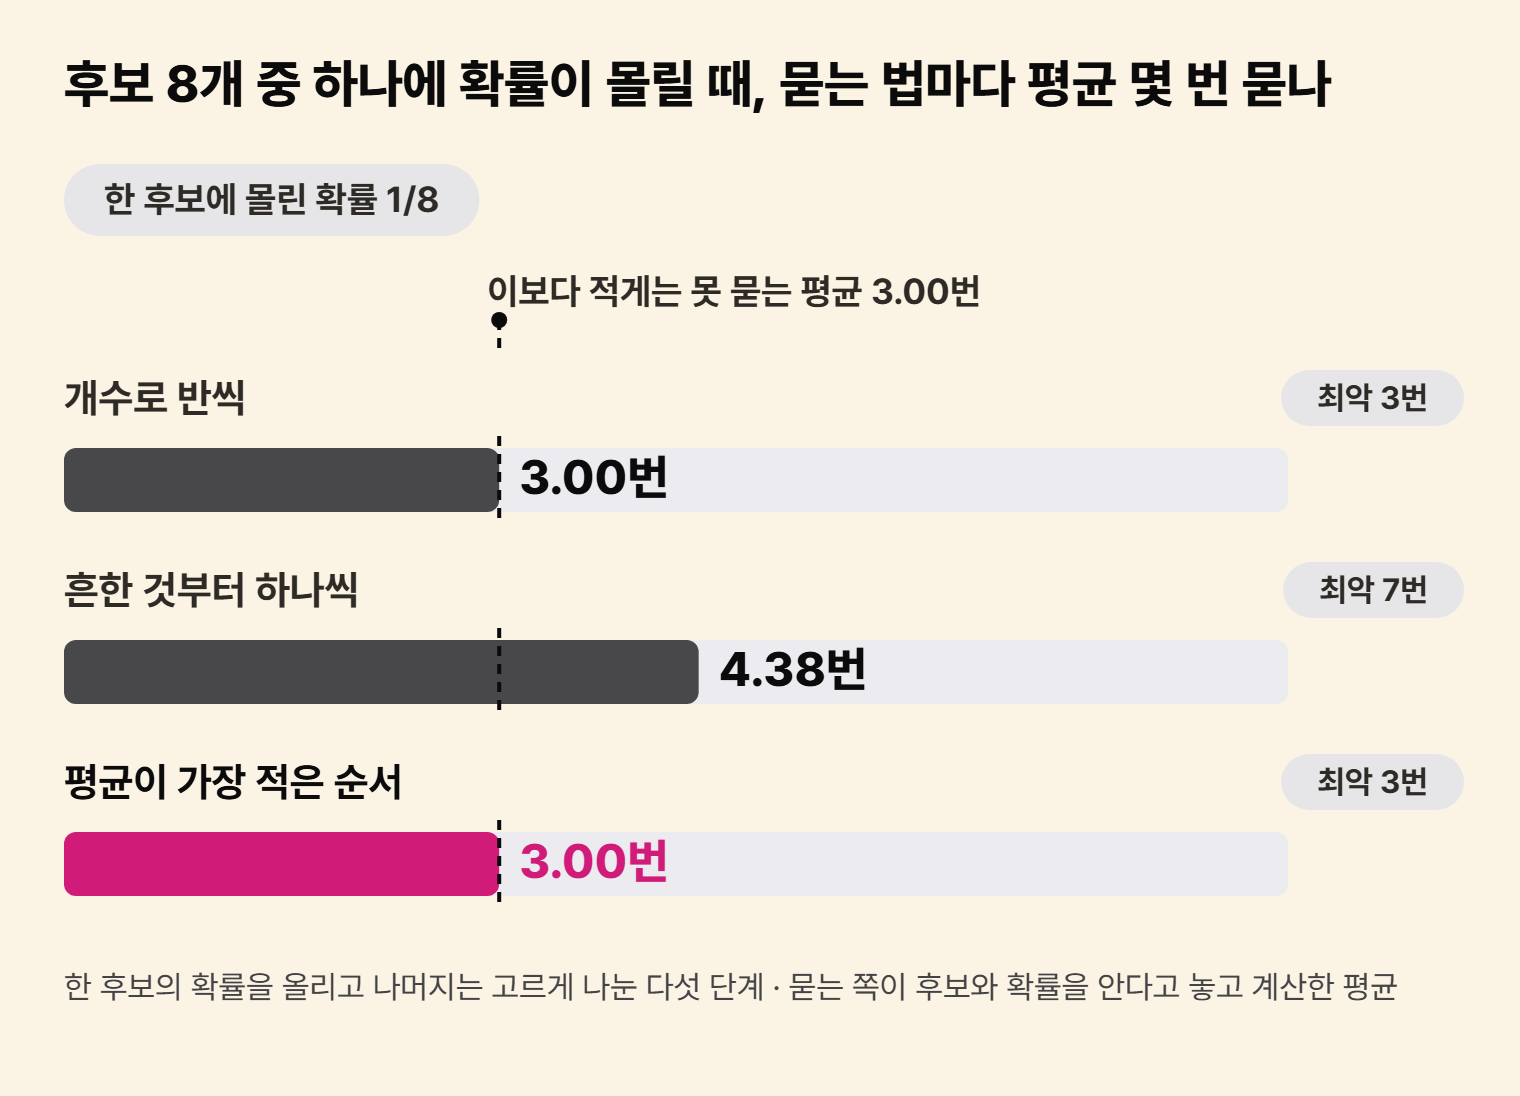
이 그림에서 찾아볼 것이 셋 있다. 하나는 한 후보의 확률이 올라가도 「개수로 반씩」 막대의 길이가 그대로인지다. 길이가 그대로라면 이 묻는 법은 후보의 확률을 쓰지 않는 셈이다. 또 하나는 「흔한 것부터 하나씩」 막대가 「개수로 반씩」 막대보다 처음 짧아지는 단계다. 두 막대의 길이가 거의 같은 단계가 있어서, 길이보다 막대 끝 숫자로 가리는 편이 확실하다. 마지막으로 후보 수를 16개로 바꾸면 그 단계가 달라지는지, 줄 끝 칩의 최악 질문 수는 어떤지 읽을 수 있다.
모든 후보가 1/8로 같을 때는 「개수로 반씩」과 「평균이 가장 적은 순서」가 둘 다 평균 3.00번이고, 「흔한 것부터 하나씩」은 4.38번이다. 한 후보의 확률이 9/10까지 오르면 「개수로 반씩」은 여전히 3.00번이다. 같은 판에서 「평균이 가장 적은 순서」는 1.29번까지 내려간다. 「흔한 것부터 하나씩」은 1.39번이다. 이 그림이 잰 다섯 단계 안에서, 「흔한 것부터 하나씩」의 평균이 「개수로 반씩」보다 처음 적어지는 칸은 후보 8개일 때 확률 1/2이다(2.93번 대 3.00번). 후보 16개일 때는 같은 다섯 단계 가운데 3/4에서 처음 적어진다(2.98번 대 4.00번).
칩에 적힌 최악의 질문 수로 견주면 평균과는 다른 순위가 나온다. 후보 8개 판에서 「개수로 반씩」은 모든 칸에서 최악 3번이다. 「평균이 가장 적은 순서」는 1/8 칸에서만 같은 3번이고 확률을 1/4로 올린 칸부터 4번이 되며, 「흔한 것부터 하나씩」은 늘 7번이다. 평균을 줄이는 순서가 최악까지 줄여 주지는 않는다.
사람 쪽 관찰도 하나 있다. Ruggeri와 Lombrozo는 2015년 연구에서 이탈리아 리보르노의 두 학교 학생(초등학생과 17~18세)에게 「지각한 남자」의 이유를 예·아니오 질문으로 맞히게 했다. 참가자 한 명이 던진 질문 가운데 후보 여럿을 한꺼번에 거르는 질문의 비율을 평균하면, 후보의 확률이 고르지 않은 조건에서 0.26, 고른 조건에서 0.41이었다. 이 학생들은 후보가 쏠린 조건에서 후보 여럿을 거르는 질문을 덜 던졌다.
한 후보의 확률이 9/10인 판에서 「개수로 반씩」은 평균 3.00번, 「평균이 가장 적은 순서」는 1.29번이었다. 「개수로 반씩」이 이 판에서 평균을 못 줄이는 까닭은 첫 질문에서 보인다. 후보를 넷 대 넷으로 가르고 흔한 후보가 든 쪽이냐고 물으면, 「예」가 거의 늘 돌아온다. 개수로는 반반인 질문이 확률로는 반반이 아니게 된다. 후보가 쏠린 판에서 좋은 질문을 고르려면 남은 후보의 개수와 함께 「예」가 나올 확률을 봐야 한다.
좋은 질문 하나의 값은?
질문이 얼마나 좋은지 재려면 단위가 필요하다. 비트(bit)는 정보의 양을 재는 단위로, 똑같이 그럴듯한 두 가능성 가운데 어느 쪽인지 알려 주는 양이 1비트다. 클로드 섀넌은 1948년 논문에서 정보를 밑이 2인 로그로 재면 그 단위를 「binary digits, or more briefly bits」라 부를 수 있다고 적고, 이 낱말은 튜키(J. W. Tukey)가 제안했다고 밝혔다.
답 하나가 알려 주는 양은 log₂(1 ÷ 그 답의 확률)비트다. 반반인 질문에서 「예」를 들으면 log₂2 = 1비트다. 섀넌은 가능성이 모두 같을 때 이 양의 평균이 가장 크다는 성질을 보였다. 이것을 「예」와 「아니오」 두 답에 대입하면, 예·아니오 질문이 평균적으로 알려 주는 양은 두 답이 반반일 때 1비트로 가장 크다. 이 대입은 섀넌 논문의 문장이 아니라 이 글이 한 계산이다.
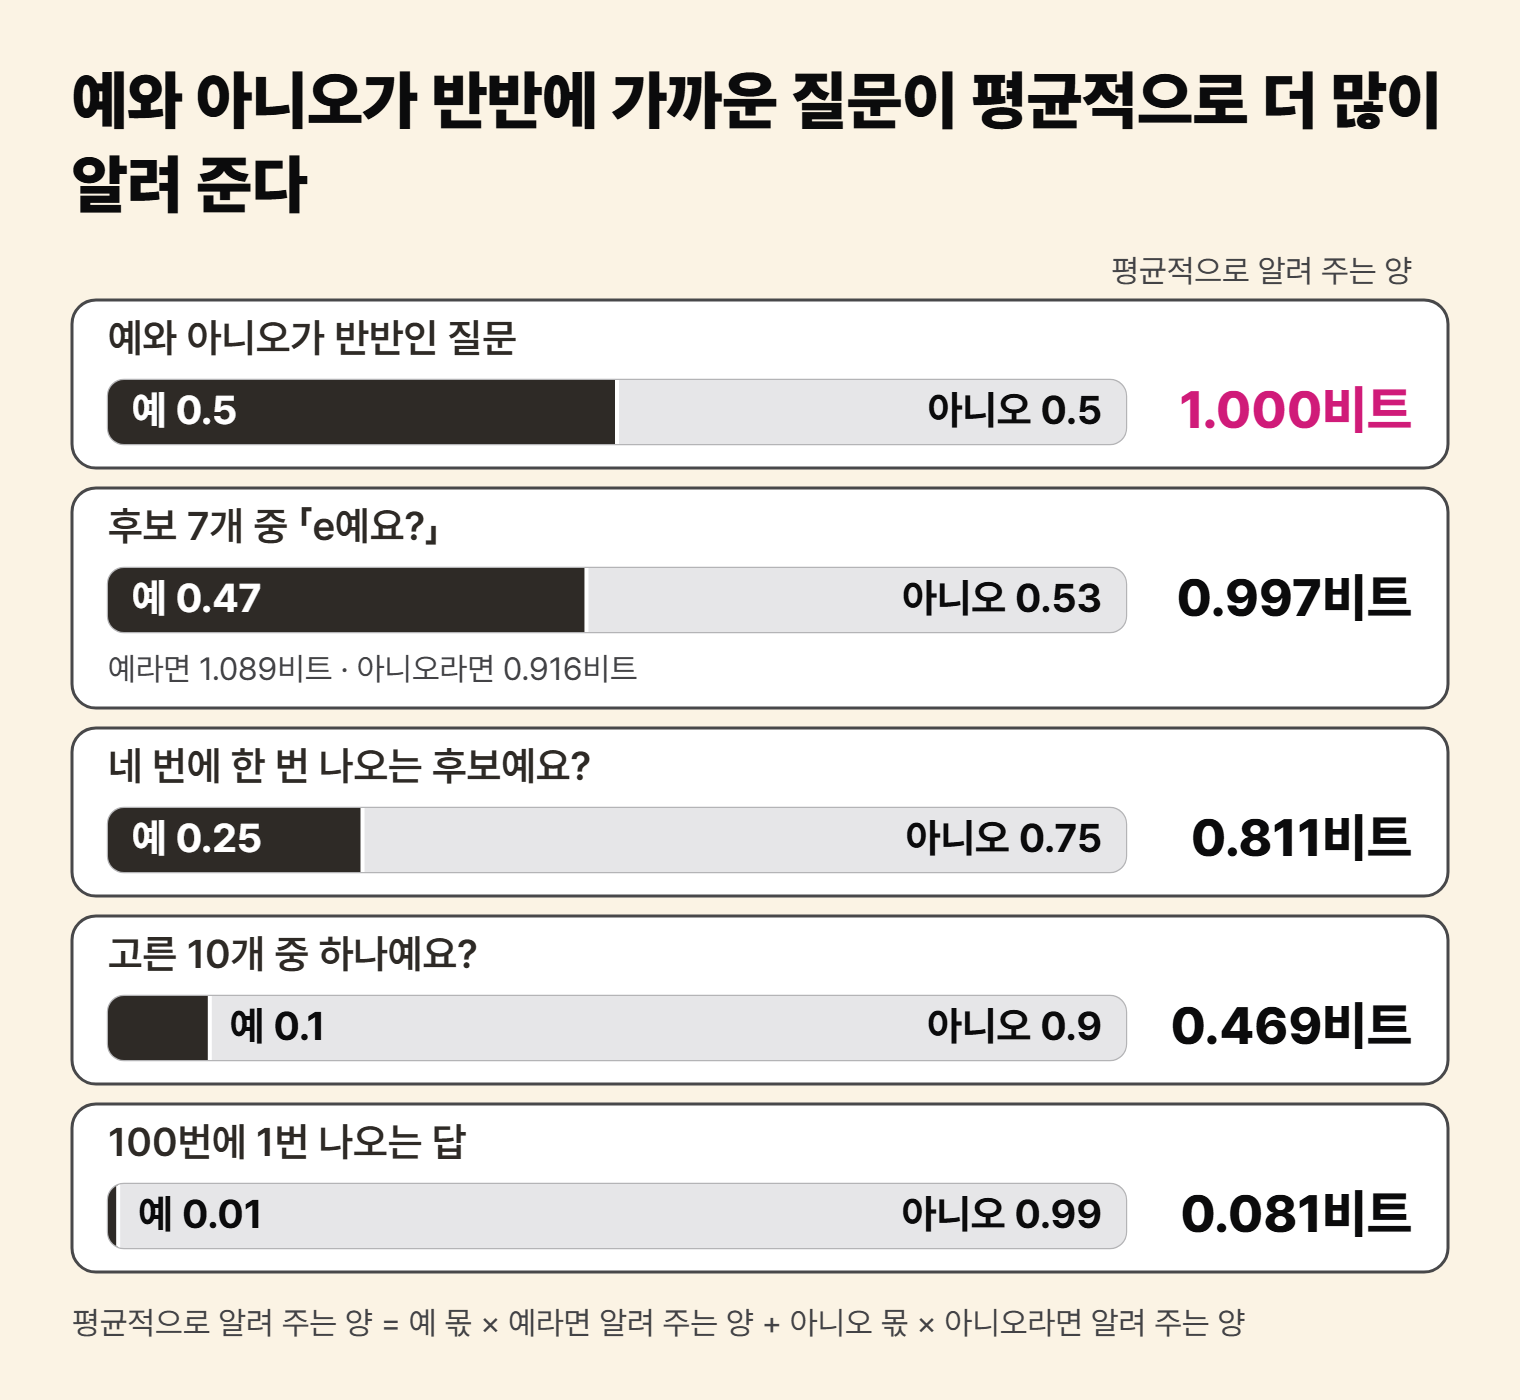
그림 2에서 「예」 확률이 0.5인 질문은 평균 1.000비트를 알려 준다. 확률이 0.25면 0.811비트, 0.1이면 0.469비트, 0.01이면 0.081비트로 줄어든다. 0.47짜리 질문은 다음 절의 후보 일곱 개 가운데 e를 묻는 「e예요?」로, 평균 0.997비트다. 1비트에 아주 가깝지만 1비트보다 적다.
1비트를 넘지 못하는 것은 평균이다. 답 하나는 1비트를 넘을 수 있다. 「e예요?」에 「예」가 돌아오면 1.089비트를 알게 되고, 「아니오」면 0.916비트를 알게 된다. 매케이의 교재에는 64칸 가운데 한 칸에 숨은 잠수함을 한 발씩 쏘아 찾는 놀이가 나온다. 첫 발에 맞히면 그 「명중」 한 번이 6비트를 알려 준다. 매케이는 이를 「one binary outcome can convey six bits」(예·아니오 답 하나가 6비트를 전할 수 있다)라고 적었다.
답마다 알려 주는 양에 그 답이 나올 확률을 곱해 모두 더하면, 질문이 평균적으로 알려 주는 양이 된다. 이 평균을 엔트로피(entropy)라고 부른다. 후보 목록 전체에 같은 셈을 하면, 후보 하나하나를 마지막 답으로 보고 식 1처럼 더한다.
후보 목록의 엔트로피는 어떤 순서로 물어도 평균 질문 수가 내려가지 못하는 바닥이다. Dagan 외 연구진(2017)은 가장 적은 순서의 평균이 엔트로피에 1을 더한 값보다는 작다고 적는다. 후보 1,000개가 모두 같은 확률이면 엔트로피는 9.9658이고, 가장 적은 평균은 9.976번이다. 섀넌이 든 네 글자 A·B·C·D의 확률은 1/2·1/4·1/8·1/8이다. 여기서는 엔트로피와 가장 적은 평균이 둘 다 1.75로 같다.
같은 연구진은 이 바닥을 스무고개로 푸는 해석을 「often taught in introductory courses」(입문 강의에서 자주 가르치는) 해석이라고 적었다. 섀넌의 1948년 논문에는 스무고개도 예·아니오 질문 이야기도 나오지 않는다. 엔트로피가 스무고개에 그어 주는 것은 정확한 질문 수가 아니라 평균 질문 수의 아래쪽 한계다.
가장 적게 묻는 순서는?
질문을 하나씩 반반에 맞추는 것과 순서 전체를 짜는 것은 같은 일이 아니다. 그림 3는 매케이 교재의 예로 이 둘을 견준다. 후보는 a부터 g까지 일곱 개이고, 확률은 차례로 0.01·0.24·0.05·0.20·0.47·0.01·0.02다.
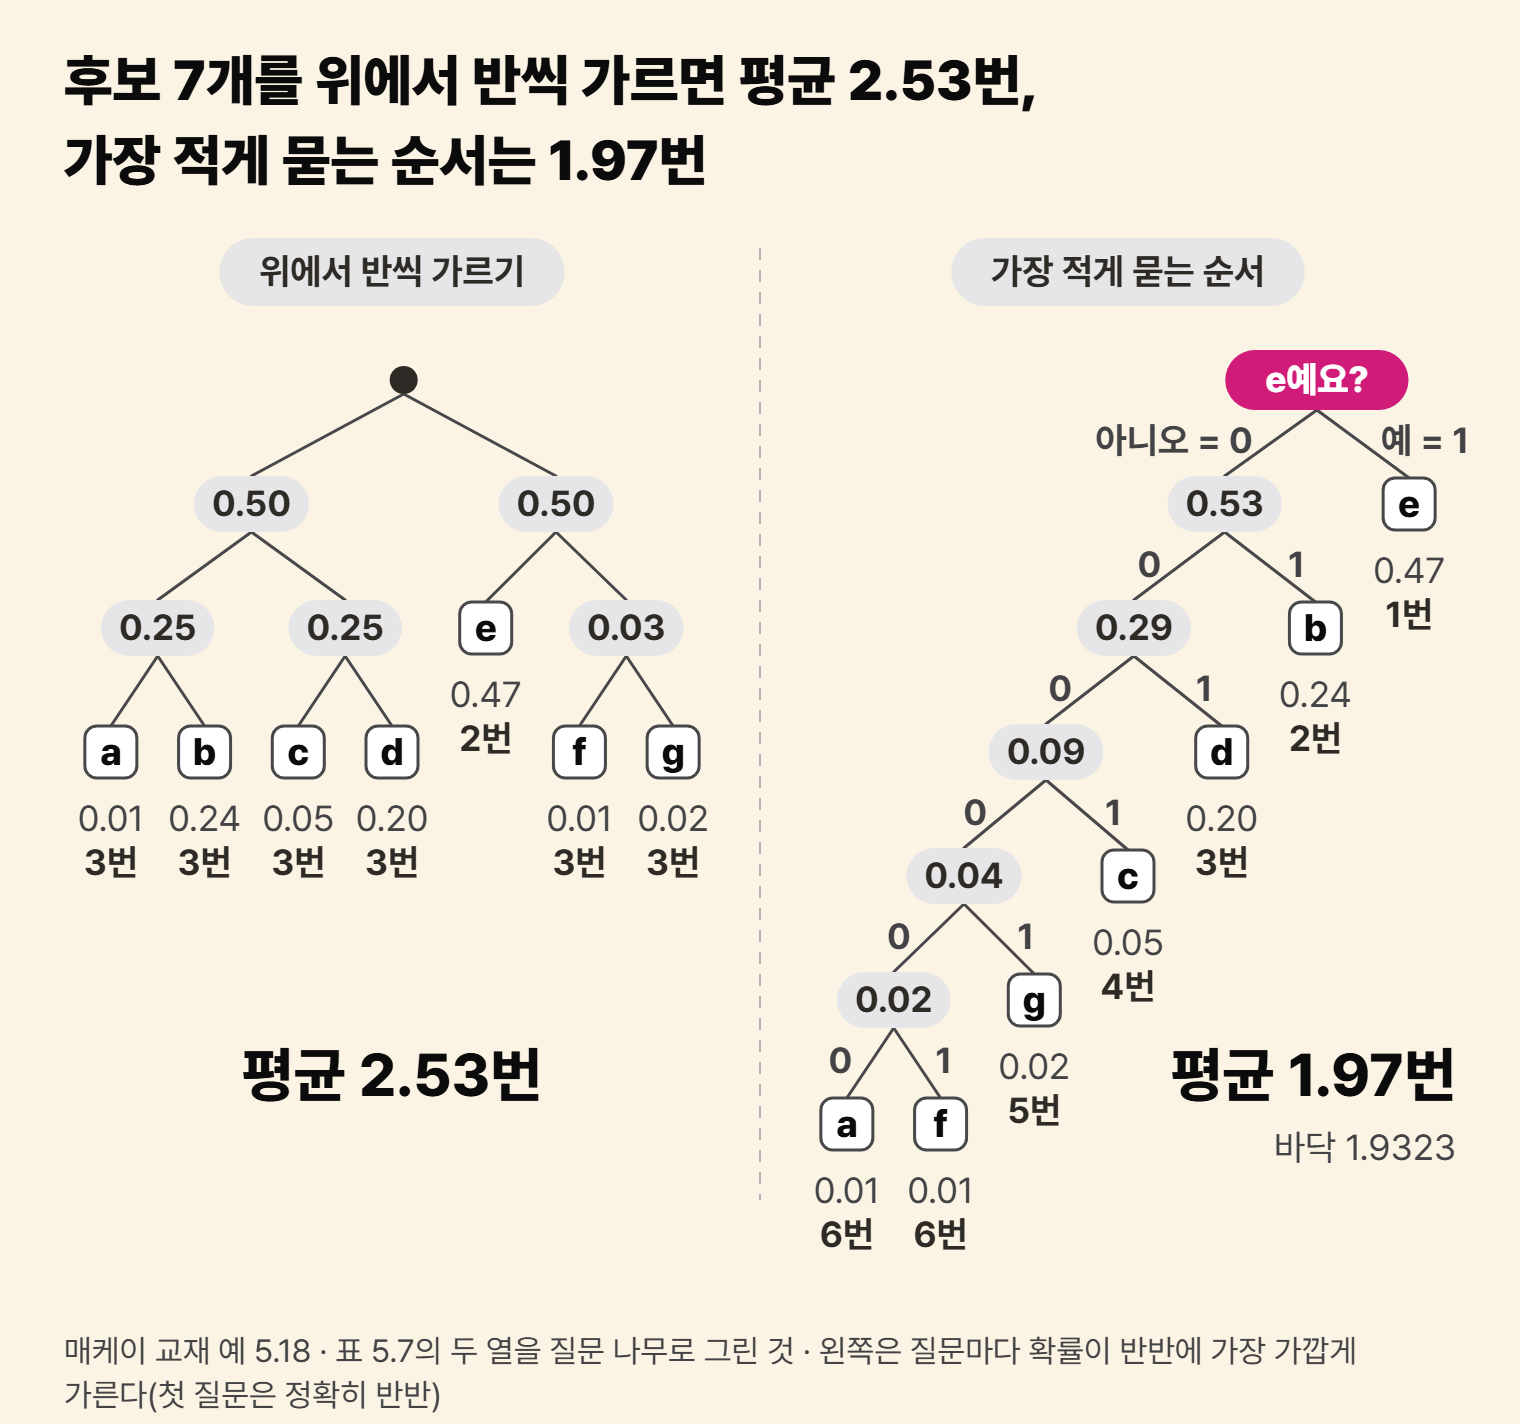
왼쪽 나무는 질문마다 남은 후보를 확률 합이 반반에 가장 가까운 두 묶음으로 가른다. 매케이는 이 나무를, 위에서부터 이렇게 나누는 방법이 가장 적은 평균을 늘 내지는 못한다는 예로 든다. 첫 질문은 a·b·c·d 묶음(0.5)과 e·f·g 묶음(0.5)을 정확히 반반으로 가르고, 다음 질문은 a·b와 c·d를 0.25씩 가른다. 매케이가 계산한 이 나무의 평균은 2.53번이다. 오른쪽 나무는 평균이 가장 적은 순서로 평균 1.97번이고, 이 일곱 후보의 엔트로피는 1.9323이다.
오른쪽 나무의 첫 질문은 「e예요?」이고, 확률로는 0.47 대 0.53이다. 이 분포에서는 가장 적은 순서가 「흔한 것부터 하나씩」과 같은 나무여서, 둘 다 평균 1.97번이다. 다만 가장 운이 나쁠 때는 오른쪽 나무가 6번, 왼쪽 나무가 3번을 묻는다.
평균이 가장 적은 순서를 짓는 방법이 허프만 코딩(Huffman coding)이다. 확률이 가장 낮은 두 후보를 한 묶음으로 합치고, 그 묶음을 확률을 합친 후보 하나처럼 다시 목록에 넣는 일을 하나가 남을 때까지 되풀이해 아래에서부터 질문 나무를 짓는다. 허프만(David A. Huffman)은 1952년 논문에서 이 방법을 냈다. Dagan 외 연구진도 스무고개의 가장 좋은 전략이 허프만 코딩으로 주어진다고 적는다.
「확률로 반씩」도 이 일곱 후보에서는 평균 1.97번으로 가장 적은 순서와 같다. 이 방법은 확률 순으로 줄 세운 뒤 끊는 자리만 고르므로, 첫 질문이 정확한 반반이 아니라 e 하나(0.47)와 나머지(0.53)로 갈린다. 왼쪽 나무는 아무 두 묶음이나 견주어 첫 질문을 정확한 반반에 맞춘다. 이 일곱 후보에서는 그 첫 질문 하나 때문에, 그 아래를 가장 잘 짜도 평균이 2.35번으로 오른다. 하지만 「확률로 반씩」도 늘 가장 적지는 않아서, 평균이 가장 적은 순서보다 많아지는 분포도 있다.
가장 적은 순서가 흔한 답에 질문을 덜 쓰는 까닭은 자리 바꾸기로 보인다. 어떤 순서에서 더 흔한 답이 더 드문 답보다 질문을 많이 받고 있다고 하자. 두 답의 자리를 맞바꾸면 흔한 답의 질문 수가 줄고 드문 답의 질문 수가 늘어, 확률을 곱해 더한 평균이 줄어든다. 그래서 평균이 가장 적은 순서에는 그런 쌍이 없다. 순서 전체를 짜고 나면, 첫 질문은 정확한 반반에서 조금 비켜 서도 된다.
0과 1의 줄로 적으면?
「예」를 1, 「아니오」를 0으로 적으면 질문 순서 하나가 0과 1의 줄이 된다. 그림 3의 오른쪽 나무에서 e는 첫 질문에 「예」라서 1이고, b는 「아니오」 다음 「예」라서 01, d는 001이다. Dagan 외 연구진은 가장 적은 순서로 묻는 사람을 두고 「Bob’s questions reveal the codeword for x bit by bit」(밥의 질문이 친구가 떠올린 정답 x를 적은 줄을 한 자리씩 드러낸다)라고 적었다.
섀넌의 1948년 논문은 질문이 아니라 0과 1로 글자를 적는 법을 다룬다. A·B·C·D 네 글자를 모두 두 자리로 적으면 한 글자에 2자리가 들지만, 흔한 글자에 짧은 줄을 주면 평균 1.75자리로 줄어든다. 이 줄을 질문 순서로 읽는 것은 이 글의 번역이다.
Thus the messages of high probability are represented by short codes and those of low probability by long codes.
그래서 확률이 높은 메시지는 짧은 줄로, 확률이 낮은 메시지는 긴 줄로 적힌다.
C. E. Shannon, 「A Mathematical Theory of Communication」(1948), 재판 p.17흔한 글자에 짧은 줄을 주는 방법은 여럿이다. 그 가운데 평균 자릿수를 가장 적게 만드는 것이 앞 절에서 질문 순서를 짓던 허프만 코딩이다. 허프만의 1952년 논문 요약은 이 방법이 짓는 줄을 「A minimum-redundancy code is one constructed in such a way that the average number of coding digits per message is minimized.」라고 정의한다. 우리말로는 「메시지 하나에 드는 자릿수의 평균이 가장 적도록 지은 줄」이다. 한국어 위키백과는 허프만 코딩을 파일을 줄였다가 그대로 되살리는 압축에 쓰이는 방법으로 설명한다.
평균 질문 수를 가장 적게 짜는 일과 0과 1의 줄을 평균적으로 가장 짧게 짜는 일은 같은 셈이다. 친구가 떠올린 것을 맞히는 순서와 글자를 적는 줄이 같은 나무에서 나온다. 질문 수의 평균이 가장 적은 순서에서는 흔한 답일수록 적은 질문 만에 닿는다.
더 읽기
- C. E. Shannon, 「A Mathematical Theory of Communication」(1948, 재판) — https://people.math.harvard.edu/~ctm/home/text/others/shannon/entropy/entropy.pdf
- David J.C. MacKay, 『Information Theory, Inference, and Learning Algorithms』(2003), 4장·5장 — https://www.inference.org.uk/itprnn/book.pdf
- Yuval Dagan, Yuval Filmus, Ariel Gabizon, Shay Moran, 「Twenty (simple) questions」(STOC 2017) — https://arxiv.org/abs/1611.01655