가게에서 처음 본 가격표가 그 물건값을 따지는 기준처럼 느껴질 때가 있다. 물건과 아무 상관 없는 숫자를 먼저 보여 줘도, 실험 참가자들이 적은 값은 그 숫자 쪽으로 끌려갔다. 처음 숫자에서 출발해 고쳐 가다 덜 고친 채 멈춘다는 것이 1974년 논문의 설명이다. 다만 끌린 크기는 2003년 실험보다 같은 실험을 다시 해 본 연구들에서 작게 나왔다. 처음 본 숫자 쪽으로 판단이 끌리는 이 일을 앵커링 효과(anchoring effect)라고 한다.
무선 키보드 한 대에 평균 16.09달러를 적은 학생 묶음과 평균 55.64달러를 적은 묶음이 있었다. 2003년 논문에 실린 미국 MIT 경영대학원 한 수업의 실험이다. 두 묶음을 가른 것은 하나뿐이었다. 학생마다 자기 사회보장번호 끝 두 자리를 달러로 읽고, 그 값이면 이 키보드를 사겠느냐는 물음에 먼저 답했다는 점이다. 그 번호는 학생이 고른 숫자도 아니고, 키보드와도 아무 관계가 없다. 그런데도 같은 키보드를 두고 두 묶음의 평균은 세 배 넘게 벌어졌다.
처음 본 가격은 왜 기준이 될까? 답을 고쳐 가기 시작하는 자리를 처음 본 숫자가 정하고, 그 고침이 대개 모자라서다. 트버스키와 카너먼이 1974년에 내놓은 설명이다. 그 끌림의 크기는, 물건과 상관없는 숫자일 때 실험마다 꽤 다르게 나온다.
바퀴에서 나온 숫자를 먼저 보면 짐작이 그 숫자 쪽으로 기운다
1974년 『사이언스』에 실린 트버스키와 카너먼의 논문에는 이런 실험이 나온다. 참가자 앞에서 0부터 100까지 적힌 행운의 바퀴를 돌려 숫자 하나를 정했다. 참가자는 먼저 유엔 회원국 가운데 아프리카 나라의 비율이 그 숫자보다 큰지 작은지를 답했다. 그다음 그 숫자에서 위나 아래로 옮겨 가며 비율을 짐작해 적으라는 지시를 받았다.
묶음마다 받은 숫자가 달랐는데, 10을 받은 묶음이 적은 짐작의 가운데 값은 25%였고 65를 받은 묶음은 45%였다. 논문은 이 제멋대로 정한 숫자가 짐작에 뚜렷한 영향을 주었다고 적었다. 정확히 맞히면 보상을 준다고 해도 이 끌림은 줄지 않았다.
논문은 이 결과를 이렇게 설명한다. 사람은 처음 주어진 값에서 출발해 고쳐 가며 답을 내는데, 그 고침이 대개 모자라서 답이 출발점 쪽으로 치우친다. 이 설명대로 10에서 출발한 사람을 따라가 보자. 10%가 너무 작다고 본 사람은 위로 고쳐 가다가, 자기가 생각한 값에 이르기 전에 멈춘다. 65에서 출발한 사람은 아래로 고쳐 가다 마찬가지로 일찍 멈춘다. 그래서 두 묶음의 짐작은 각자 받은 숫자 쪽에 남고, 받은 숫자가 다르면 답도 그만큼 갈린다.
같은 절에는 바퀴 없이 처음 값이 생기는 둘째 예도 실려 있다. 고등학생 두 묶음에게 칠판에 적힌 곱셈의 결과를 5초 안에 짐작하게 했다. 한 묶음은 8×7×6×5×4×3×2×1을, 다른 묶음은 1×2×3×4×5×6×7×8을 받았다. 큰 수부터 본 묶음의 가운데 값은 2,250이었다. 작은 수부터 본 묶음은 512였고, 정답은 40,320이다.
논문은 처음 값이 문제의 표현에서 오기도 하고, 계산을 하다 만 결과에서 오기도 한다고 적었다. 곱셈 예는 그 둘째 경우의 예로 실렸다. 5초 안에 앞의 몇 단계만 곱해 보면 8부터 곱한 쪽의 하다 만 결과가 1부터 곱한 쪽보다 훨씬 크고, 두 묶음 모두 그 값에서 덜 고쳐 정답에 한참 못 미쳤다.
저자들은 이 현상을 앵커링(anchoring)이라고 불렀다. 한국어로는 앵커링 효과라고 하고, 앵커가 배의 닻이라는 뜻이라 닻내림 효과라고도 한다. 바퀴 숫자는 정답에 대해 아무것도 알려 주지 않았는데도 짐작을 옮겼다. 1974년 논문의 설명대로라면, 그 숫자는 고쳐 가기 시작할 자리를 정해 주었다.
번호 끝 두 자리나 소리 길이를 먼저 물으면 답이 그 숫자 쪽으로 끌린다
1974년의 실험은 사실을 짐작하게 했다. 2003년 논문에서 댄 애리얼리와 동료들은 같은 일을 물건값으로 옮겼다. MIT 경영대학원 시장조사 수업 첫 시간에 학생 55명에게 물건 여섯 가지를 보여 줬다. 무선 트랙볼, 무선 키보드, 와인 두 병, 디자인 책, 벨기에 초콜릿이었고 평균 소매가는 약 70달러였다. 물건은 짧게 소개만 했고, 시장 가격은 알려 주지 않았다.
학생들은 먼저 자기 미국 사회보장번호 끝 두 자리를 달러로 읽은 값에 그 물건을 사겠느냐는 물음에 「예」나 「아니오」로 답했다. 이를테면 번호 끝이 37이면 37달러에 사겠느냐는 물음이다. 그다음 그 물건에 낼 수 있는 최고 금액을 적었다. 두 답 가운데 어느 쪽으로 실제 거래를 할지는 추첨으로 정했고, 학생 한 사람이 살 수 있는 물건은 많아야 하나였다. 적은 값이 실제 구매로 이어질 수 있었으니, 학생들에게 이 금액은 말로만 적는 값이 아니었다.
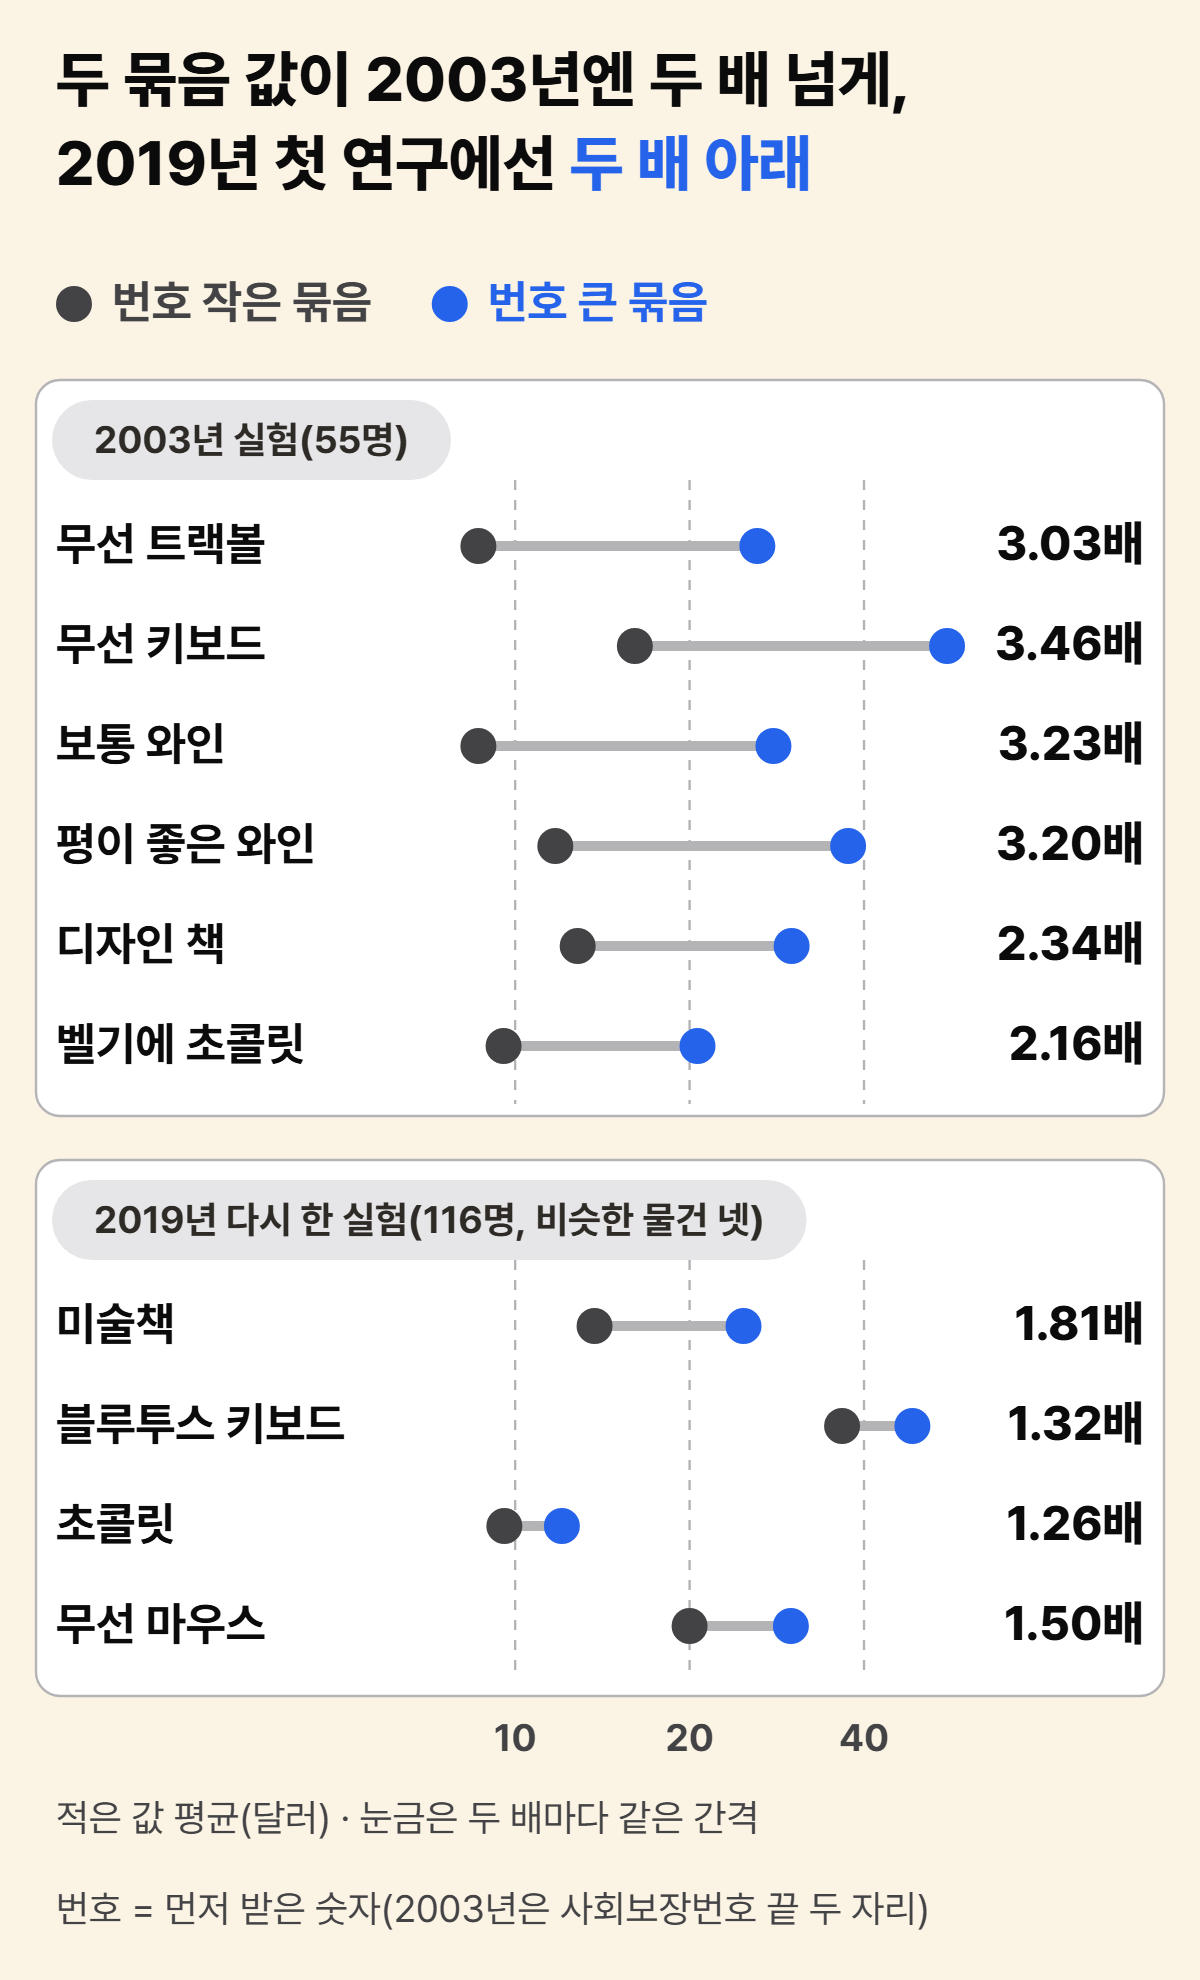
결과는 여섯 물건 모두에서 같은 쪽으로 나왔다. 번호가 가운데보다 큰 학생들은 작은 학생들보다 57~107% 높은 값을 적었고, 이 차이는 물건마다 통계로 뚜렷했다. 연구진은 55명을 번호 크기순으로 다섯 묶음으로 나눠, 묶음마다 적은 값의 평균도 냈다. 무선 키보드에서 번호가 가장 큰 묶음의 평균은 55.64달러, 가장 작은 묶음은 16.09달러로 3.46배였다. 한 사람이 16달러를 적은 것이 아니라 그 묶음 학생들의 평균이다. 저자들은 맨 위 묶음이 적은 값이 대개 세 배쯤 컸다고 요약했다.
출발점은 번호가 정했지만, 물건끼리의 순서는 앞뒤가 맞았다. 95%가 넘는 학생이 무선 키보드를 트랙볼보다, 평이 좋은 와인을 그렇지 않은 와인보다 비싸게 적었다. 저자들은 사람이 물건마다 딱 정해진 값보다 받아들일 만한 값의 범위를 가지고 있을 것이라고 봤다. 다만 처음 숫자가 왜 값을 끄는지, 그 마음속 과정은 설명하지 않는다고 따로 밝혔다.
같은 논문의 다른 실험은 답이 돈이 아닐 때도 끌림이 보이는지 물었다. 캘리포니아대 버클리 캠퍼스에서 모은 59명에게 먼저 듣기 싫은 소리를 들려주고, 이온 음료와 식초를 반씩 섞은 음료를 맛보게 했다. 첫 물음에서 절반은 「중간 크기 음료와 소리 1분 가운데 무엇을 고르겠느냐」를, 나머지 절반은 같은 물음을 3분으로 받았다. 그 뒤 음료 대신 참겠다고 고른 소리의 가장 긴 길이를 음료 세 크기에 걸쳐 평균 냈다. 1분을 먼저 본 쪽은 82초, 3분을 먼저 본 쪽은 162초였다. 처음 숫자가 끄는 힘은 돈으로 값을 매길 때만 생기는 일이 아니었다.
번호와 물건값 실험의 크기는 그대로 다시 나오지 않았다. 미국 대학생 116명으로 같은 실험을 다시 해 2019년에 낸 연구에서, 맨 끝 두 묶음의 차이는 물건에 따라 1.26~1.81배였다. 상관없는 숫자가 물건값을 끈다는 데까지는 두 실험이 같은 말을 했지만, 끈 힘의 크기는 서로 달랐다.
가격표를 보기 전에 낼 금액을 정해 두면 내 짐작이 따로 있었는지 보인다
물건마다 크기를 나눠 보기 전에, 가게에서 바로 해 볼 수 있는 일이 있다. 2003년 실험은 숫자를 먼저 보여 주고 금액을 물었다. 가게에서도 가격표를 먼저 보고 내 금액을 정하면, 정한 금액이 처음 본 값과 얼마나 붙어 있는지 알 길이 없다. 순서를 뒤집으면 비교할 기준이 하나 생긴다. 온라인 쇼핑몰이면 상품 페이지를 열기 전, 매장이면 가격표를 보기 전이 그 자리다.
가격표나 정가, 「할인 전 가격」이 눈에 들어오기 전에, 그 물건에 낼 수 있는 최고 금액을 메모장에 남긴다. 가격표가 이미 앞에 있으면 손으로 가리고 적은 뒤, 가격표를 보고 내 금액과 비교한다. 두 숫자가 크게 다르면 어느 쪽이 맞는지 따지기보다, 내가 처음 적은 금액의 근거를 다시 떠올린다. 지난번에 산 값인지, 다른 가게에서 본 값인지를 옆에 적어 두면 된다. 이 순서가 끌림을 없앤다는 실험은 아니다. 내 짐작이 따로 있었는지 보는 방법이다.
이를테면 무선 이어폰을 사기 전에 「8만 원까지」라고 적어 둔다고 하자. 페이지에 「정가 15만 원, 지금 9만 원」이 떠 있으면, 9만 원이 싸 보이는 것이 15만 원 옆이라서인지 내 8만 원과 비교해서인지 나눠 볼 수 있다. 9만 원이 싸 보이는데 내 8만 원보다는 비싸다면, 할인 폭보다 내 금액을 어떻게 정했는지부터 따져 보면 된다. 여기 나온 금액은 설명을 위해 정한 예이고, 어느 쇼핑몰에서 잰 숫자가 아니다. 메모 한 줄은 처음 본 숫자 옆에 내 숫자를 하나 세워 둔다. 2003년 실험의 학생들은 물건의 시장 가격을 듣지 못했고, 이런 메모도 없었다.
2003년 앵커링 효과 실험을 물건마다 나누면 여섯 모두 번호 큰 묶음이 더 높다
「세 배쯤」은 여섯 물건을 한데 모은 말이다. 물건마다 보면 맨 위 묶음은 맨 아래 묶음보다 벨기에 초콜릿에서 2.16배, 무선 키보드에서 3.46배를 적었고 나머지 넷은 그 사이였다. 여섯 물건 모두 맨 위 묶음이 다섯 묶음 가운데 가장 높았고, 가장 크게 끌린 물건은 무선 키보드였다. 그런데 다섯 묶음이 차례로 오른 물건은 셋뿐이었다. 와인 두 병과 디자인 책은 둘째 묶음이 셋째 묶음보다 높게 적었다. 「세 배」는 맨 끝 두 묶음이 보인 크기이지, 번호가 한 칸 오를 때마다 값이 고르게 오르는 계단은 아니었다.
논문은 같은 결과를 상관 계수로도 적었다. 여기서 상관 계수는 번호가 큰 학생일수록 적은 값도 큰지를 수 하나로 나타낸 것이다. 그런 경향이 없으면 0이고, 함께 커질수록 1에, 거꾸로 움직일수록 −1에 가까워진다. 여섯 물건에서 번호와 적은 값의 상관 계수는 0.32~0.52였다. 묶음 차이는 맨 끝 두 묶음만 보고, 상관 계수는 55명 전부의 번호와 값을 함께 본다. 그래서 다시 한 실험과 비교할 때도 묶음 차이는 묶음 차이끼리, 상관 계수는 상관 계수끼리 놓는다.
같은 실험을 2019년 논문의 첫 연구가 다시 하면 끌린 차이가 두 배 아래다
2019년 논문의 첫 연구는 2003년 실험을 미국 대학생 116명으로 다시 했다. 처음 숫자는 사회보장번호 끝 두 자리 또는 무작위 숫자였고, 적은 값은 이번에도 실제 거래로 이어질 수 있었다. 묶는 법은 달랐다. 사람을 순서대로 나누지 않고 처음 숫자의 크기 구간 다섯으로 묶었다.
2003년과 비슷한 물건 넷에서 맨 끝 두 구간의 차이는 1.26~1.81배, 상관 계수는 0.12~0.29로 둘 다 2003년보다 작았다 그림 1. 이 표도 계단은 아니었다. 저녁 쿠폰 둘을 더한 여섯 물건 가운데 다섯 구간이 차례로 오른 것은 하나도 없었다. 2019년 논문은 이 범위가 앞선 연구들의 가운데쯤이라고 적었다. 같은 논문은 2012년에 나온 또 다른 재현, 곧 같은 실험을 다시 한 연구에서는 묶음 차이가 0.77~0.92배로 거의 끌림이 없었다고도 옮겼다. 저자들은 원 연구보다 작은 효과도, 선호가 상당히 제멋대로일 수 있다는 2003년 논문의 요점을 무너뜨릴 만큼 작지는 않다고 결론지었다.
다른 재현도 있다. 2014년에 나온 한 연구는 볼로냐대 학생 116명으로 2003년 논문의 다른 실험을 다시 했다. 듣기 싫은 소리를 듣는 대가로 받고 싶은 최소 금액을 적게 한 실험이라, 번호와 물건값 실험의 재현은 아니다. 50센트를 본 묶음과 10센트를 본 묶음의 평균 차이는 원 실험이 보인 차이의 절반쯤이었다. 그 차이는 통계로 뚜렷하지 않았다. 저자들은 앵커링 효과가 있기는 하지만 경제적으로는 작다고 정리했다.
여러 실험을 모아 다시 계산한 연구도 같은 쪽이다. 2021년에 53개 실험을 모은 연구는 처음 숫자와 적은 값의 상관 계수를 약 0.27~0.29로 계산했다. 저자 스스로 이 값을 상한으로 보라고 적었다. 50년 치 연구를 모은 2026년 논문은 초록에서 앵커링 효과가 전체로는 크다고 적었다(본문은 확인하지 못하고 초록만 읽었다). 같은 초록은 무작위 숫자에서 온 끌림과 보상이 걸린 경우에는 끌림이 줄거나 없었다는 증거가 있다고 덧붙였다. 다시 해 본 연구들의 숫자는 대체로 방향이 같고 크기가 작은 쪽에 모인다.
산 높이나 도시 인구를 짐작하게 하면 36곳 모두 같은 쪽으로 끌렸다
같은 이름 아래 크기가 다른 일도 있다. 여러 연구실이 함께 유명한 실험들을 다시 한 2014년 Many Labs 프로젝트는 36곳의 참가자에게 사실 네 가지를 짐작하게 했다. 샌프란시스코에서 뉴욕까지의 거리, 시카고 인구, 에베레스트 높이, 미국에서 하루에 태어나는 아기 수다. 참가자는 짐작하기 전에 명백히 너무 크거나 작은 숫자가 든 문장 하나를 읽었다.
36곳 모두에서 짐작은 그 숫자 쪽으로 끌렸다. 미국에서 쓴 에베레스트 문항의 숫자는 2,000피트와 45,500피트였다. 36곳의 답을 피트로 바꿔 모으고 두 숫자의 범위를 벗어난 답을 뺀 평균은 낮은 숫자 쪽이 약 11,849피트, 높은 쪽이 약 34,501피트였다. 저자들은 곳마다 끌린 크기가 다른 것이, 에베레스트 높이나 뉴욕까지의 거리, 시카고 인구를 아는 정도가 곳마다 달라서일 수도 있다고 적었다.
이 차이를 가격 실험의 배수와 나란히 놓을 수는 없다. 사실 짐작은 극단적인 두 숫자를 대비했고, 2003년 가격 실험은 번호 끝 두 자리를 그대로 썼다. 숫자를 주는 방식이 달라 크기를 바로 비교할 수 없다. 다만 사실 짐작은 어디서 해도 같은 쪽으로 끌렸고, 가격 쪽은 연구마다 크기가 흔들렸다. 「앵커링 효과는 잘 재현된다」와 「앵커링 효과는 작다」가 둘 다 맞는 것은, 두 말이 서로 다른 실험을 가리키기 때문이다.
우리 셈에 다시 한 실험의 퍼짐 0.67을 넣으면 2003년의 두 숫자는 함께 맞지 않는다
1974년의 설명을 셈으로 옮겨 굴려 봤다. 셈의 식은 한 줄이다. 적는 값은 처음 숫자에서 출발해, 내 짐작 쪽으로 고치는 정도만큼 옮겨 간 자리다 식 1.
고치는 정도가 1이면 내 짐작을 그대로 적고, 0이면 처음 숫자를 그대로 적는다. 1974년의 「덜 고친다」는 이 값이 1보다 작다는 말이 된다. 셈을 돌리려면 처음 숫자와 짐작을 어떻게 뽑을지도 정해야 하는데, 그 규칙은 아래 상자에 모았다.
이 셈에서 처음 숫자는 번호 끝 두 자리처럼 0~99 정수 가운데 고르게 뽑는다. 내 짐작은 처음 숫자와 상관없이 정해지고 사람마다 퍼져 있다. 퍼진 정도는 2019년 자료에서 처음 숫자가 0~19였던 사람들의 값으로 어림했는데, 값이 평균에서 흔히 벗어나는 폭이 평균의 약 0.67배였다(물건 넷의 가운데 값). 이 사람들도 처음 숫자를 본 뒤라 이 어림은 퍼짐을 조금 크게 잡는다. 짐작의 평균은 25달러로 두었다. 사람이 실제로 이렇게 생각한다는 설명이 아니며, 2003년 논문도 그런 설명을 내놓지 않았다.
짐작 퍼짐을 0.67로 두고 고치는 정도를 바꿔 가면, 2019년의 묶음 차이와 상관 계수는 같은 고치는 정도 하나에서 함께 나온다 그림 2. 2003년의 두 숫자는 그렇지 않다. 묶음 차이 2.16~3.46배에 맞추면 상관 계수가 너무 크게 나오고, 상관 계수 0.32~0.52에 맞추면 묶음 차이가 너무 작게 나온다. 둘을 함께 맞추려면 짐작 퍼짐이 약 2.10이어야 하는데, 이는 다시 한 실험에서 어림한 값의 약 3.1배다.
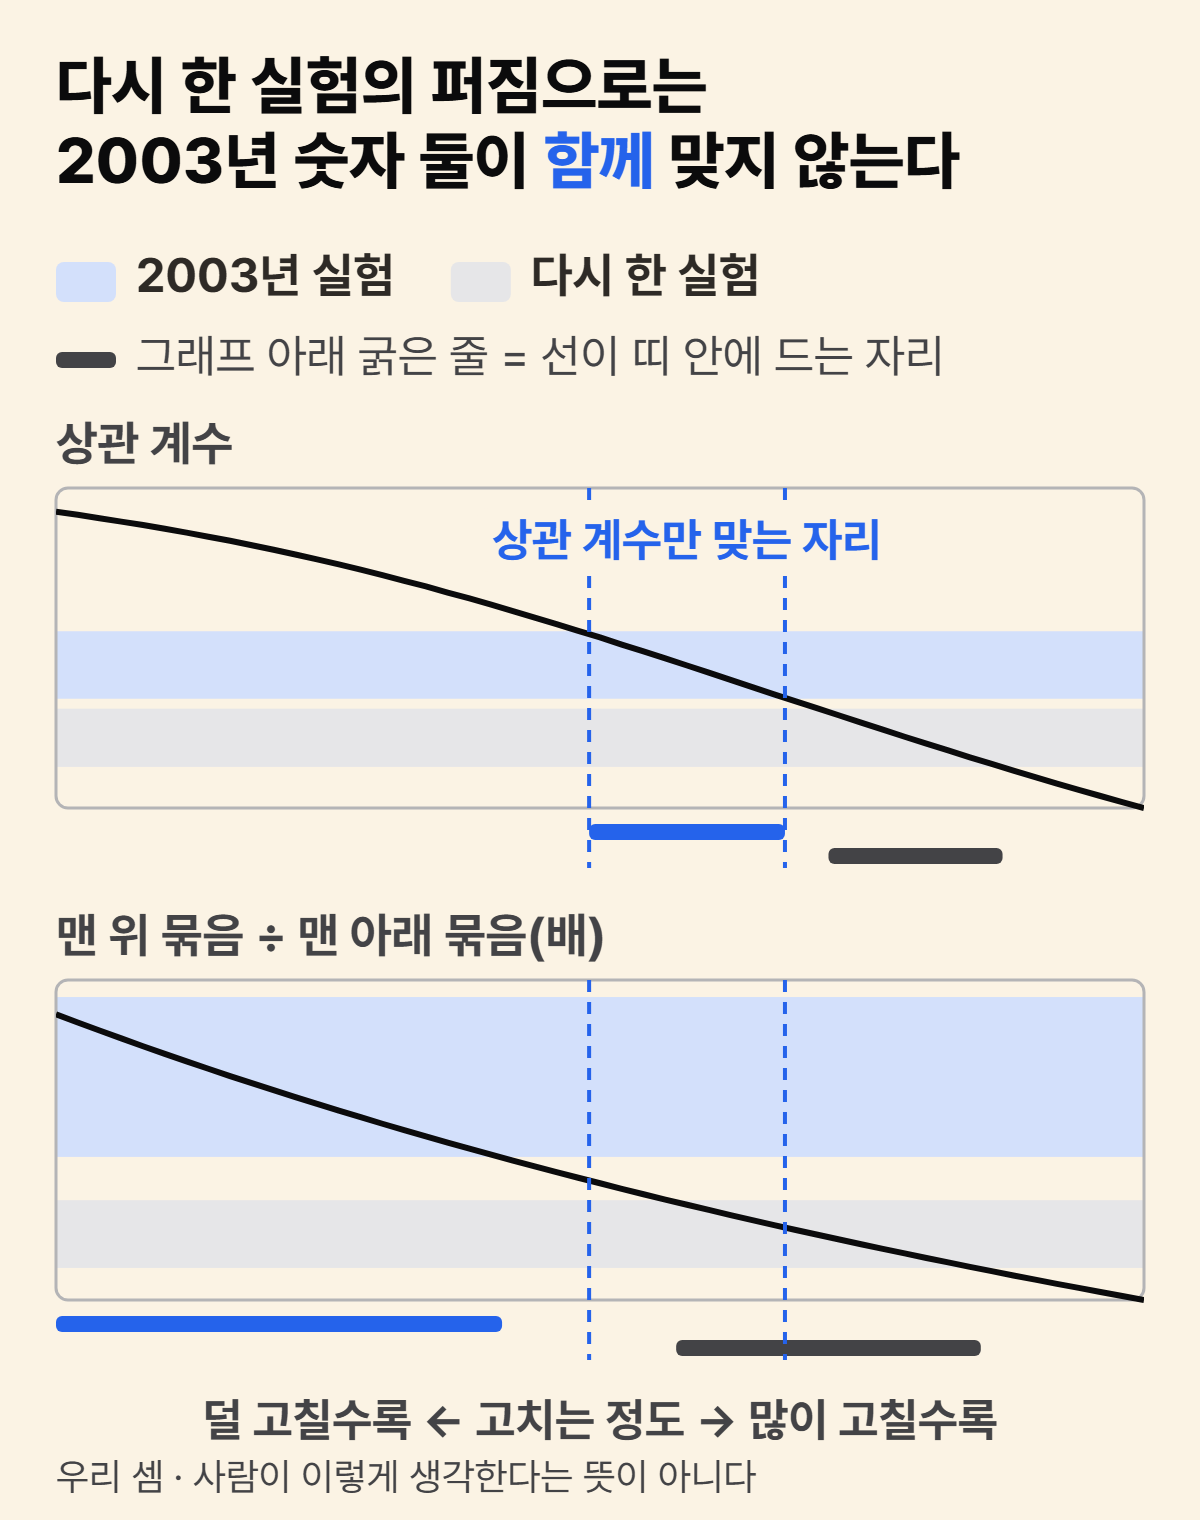
이 셈은 원인을 가르지 못한다. 55명 한 번의 우연인지, 그 교실의 짐작이 정말 넓게 퍼져 있었는지, 이 셈에 없는 무엇 때문인지는 알 수 없다. 이 셈이 가르는 것은 두 숫자가 한 고치는 정도에서 함께 맞느냐이고, 2003년 표가 왜 안 맞는지는 셈 밖의 물음으로 남는다.
55명 실험을 4,000번 흉내 내고 여러 연구를 모아 보면 한 번의 표로는 끌림의 크기가 정해지지 않는다
앞 절의 셈에서 짐작 퍼짐을 다시 한 실험 쪽 0.67로 두고 55명짜리 실험을 4,000번 흉내 내면, 맨 끝 두 묶음의 차이는 가운데 90%가 1.20배에서 2.41배 사이에서 흔들렸다. 이때 고치는 정도는 상관 계수가 2003년 여섯 물건의 가운데 값에 맞도록 정했다. 묶음은 2003년처럼 55명을 번호 크기순으로 11명씩 나눴고, 난수는 고정해 다시 돌려도 같은 값이 나오게 했다. 4,000번의 가운데 값은 1.69배였다. 2003년의 상관 계수에 맞춘 셈인데도, 묶음 차이의 가운데 값은 2003년의 가장 작은 값보다 낮았다.
같은 4,000번에서 물건 하나의 묶음 차이가 2003년의 가장 작은 값인 2.16배 이상 나온 경우는 12.7%로, 여덟 번에 한 번 정도였다. 2003년 여섯 물건의 가운데 값인 3.12배 이상은 0.3%뿐이었다. 2003년 표의 낮은 쪽 값은 한 번의 우연으로도 나오지만, 여섯 물건의 가운데 값만 한 크기는 이 셈에서 물건 하나만 놓고 봐도 드물다.
표의 모양도 흔들린다. 같은 셈에서 다섯 묶음이 차례로 오른 표는 23.1%로, 열 번에 두세 번 정도였다. 우리 셈에서는 끌림이 매끈해도 한 번의 표는 계단이 아니기 쉽다. 그래서 2003년의 여섯 중 셋, 2019년의 여섯 중 0이라는 숫자는 그것만으로 끌림의 모양을 말해 주지 않는다. 처음 숫자가 값을 끄는 힘의 크기는 실험 한 번의 표가 아니라, 여러 번 다시 한 결과를 모아 읽어야 한다.
가게에서 보는 숫자는 실험의 처음 숫자와 성격이 다르다. 정가 옆에 붙은 할인가나 흥정에서 먼저 부른 값은 물건과 아무 상관 없는 숫자가 아니다. 2021년에 실험을 모은 연구에서는 무작위가 아닌 숫자를 쓴 실험과 실험실 밖에서 한 실험이 더 큰 끌림과 함께 나왔다.
같은 연구에서 팔 때 받을 금액을 적는 과제는 끌림이 작은 쪽이었다. 원문이 「평가하는 물건과 맞지 않는 앵커」로 묶은 숫자, 이를테면 식당 이름에 든 「17」과 「97」 같은 숫자도 작은 쪽이었다. 두 경우 모두 그 차이가 통계로 뚜렷하지 않은 경우가 많았다. 돈 보상은 뚜렷한 차이를 만들지 않았다. 앞의 2026년 초록은 보상이 걸리면 끌림이 준다고 봤으니 결론이 다르고, 두 연구가 모은 실험의 범위도 같지 않다.
앞에서 본 연구들이 끌림을 잰 값은 전부 실험에서 참가자가 적은 응답이라, 매장 가격표나 홈쇼핑, 부동산 매물가 앞의 끌림은 그 값으로 짐작만 할 수 있다. 그런 자리에서 지금 할 수 있는 일은 앞의 팁대로 가격표를 보기 전에 내 금액을 정해 두는 것이다. 다시 해 본 실험들에서, 물건과 아무 상관 없는 처음 숫자가 값을 끌어당긴 힘은 2003년보다 작게 잡혔다.
더 읽기
- Amos Tversky, Daniel Kahneman, 「Judgment under Uncertainty: Heuristics and Biases」, Science 185(4157):1124–1131, 1974 — https://doi.org/10.1126/science.185.4157.1124
- Dan Ariely, George Loewenstein, Drazen Prelec, 「“Coherent Arbitrariness”: Stable Demand Curves Without Stable Preferences」, The Quarterly Journal of Economics 118(1):73–106, 2003 — https://doi.org/10.1162/00335530360535153
- Sangsuk Yoon, Nathan M. Fong, Angelika Dimoka, 「The robustness of anchoring effects on preferential judgments」, Judgment and Decision Making 14(4):470–487, 2019 — https://doi.org/10.1017/S1930297500006148
- Zacharias Maniadis, Fabio Tufano, John A. List, 「One Swallow Doesn’t Make a Summer: New Evidence on Anchoring Effects」, American Economic Review 104(1):277–290, 2014 — https://doi.org/10.1257/aer.104.1.277
- Uri Simonsohn, Joe Simmons, Leif Nelson, 「[7] Forthcoming in the American Economic Review: A Misdiagnosed Failure-to-Replicate」, Data Colada(블로그), 2013 — https://datacolada.org/7
- Richard A. Klein 외, 「Investigating Variation in Replicability: A “Many Labs” Replication Project」, Social Psychology 45(3):142–152, 2014 — https://doi.org/10.1027/1864-9335/a000178
- Lunzheng Li, Zacharias Maniadis, Constantine Sedikides, 「Anchoring in Economics: A Meta-Analysis of Studies on Willingness-To-Pay and Willingness-To-Accept」, Journal of Behavioral and Experimental Economics 90:101629, 2021 — https://doi.org/10.1016/j.socec.2020.101629
- Dan R. Schley, Evan Weingarten, 「Fifty Years of Anchoring Effects: A Theoretical Reintegration and Meta-Analysis」, Management Science, 2026(초록만 확인) — https://doi.org/10.1287/mnsc.2023.03238