AI 코딩 도구가 긴 작업을 하는 동안 창에는 읽은 파일과 테스트 결과, 검색해 온 문서가 계속 쌓인다. 많이 넣을수록 잘할 것 같지만, 2023년 모델로 한 실험의 결과는 달랐다. 정답을 한가운데 묻어 두어도, 입력이 길어지기만 해도, 주제만 맞는 문서가 섞여도 정답률이 떨어졌다. 쌓인 것을 비우는 일에도 잃는 것이 있다. 그래서 무엇을 어디에 얼마나 넣고 언제 뺄지 고르는 일을 컨텍스트 엔지니어링(context engineering)이라고 한다.
AI에게 문서 스무 장을 건네고 질문 하나를 할 때, 정답이 든 한 장을 몇 번째에 끼워 두면 가장 못 맞힐까? 2023년에 GPT-3.5-Turbo로 이 실험을 한 연구에서 답은 한가운데였다. 그 자리에 둔 정답 문서는 문서를 아예 주지 않고 물었을 때보다도 덜 맞혔다. 정답을 손에 쥐여 주었는데도 성적은 빈손일 때보다 낮았다.
비슷한 일이 코딩 에이전트의 긴 작업에서도 생길 수 있다. 이런 상황을 가정해 보자. 코딩 에이전트에게 오래된 프로젝트의 날짜 처리 코드를 새 라이브러리로 옮기는 긴 작업을 맡긴다. 에이전트는 파일을 차례로 열어 읽고, 테스트를 돌리고, 새 라이브러리 문서를 검색해 읽는다. 읽은 파일과 테스트 결과, 검색 결과는 모두 도구 결과로 창에 쌓인다.
초반에 에이전트는 설정 파일을 읽어 「날짜는 UTC로 저장한다」를 확인했다. 작업 중간에는 사용자가 「밖에서 부르는 함수 이름은 바꾸지 말 것」을 한 줄 덧붙인다. 세션이 길어지자, 에이전트를 돌리는 쪽 설정에 따라 오래된 도구 결과가 지워지거나 대화가 요약으로 바뀌어 이어진다. 끝에 돌아온 수정에서 세 군데가 어긋나 있다.
- (ㄱ) 입력에 남은 조건을 어겼다. 밖에서 부르는 함수 이름이 바뀌어 있다.
- (ㄴ) 옛 버전에만 있는 함수를 썼다.
- (ㄷ) 창을 비운 뒤 앞서 확인한 것을 놓쳤다. 날짜를 UTC가 아닌 방식으로 저장하는 코드가 들어갔다.
세 경우를 따라가는 물음은 하나, 어긋난 수정을 낸 그 턴에 창에 무엇이 실려 있었느냐다. 날짜 코드를 어떻게 옮겨야 맞는지는 여기서 묻지 않는다. (ㄱ)과 (ㄴ)은 문제가 된 조건과 문서가 모두 창 안에 있었다는 점에서 앞의 실험과 닮았다. (ㄷ)은 그 턴의 입력에 확인한 사실이 아예 없었으므로, 창을 비우는 일을 따로 한 절로 다룬다.
이 글이 붙잡는 물음은 이렇다. 컨텍스트를 많이 넣을수록 AI는 왜 오히려 헷갈릴까? 창 안의 글은 놓인 자리, 입력의 길이, 섞인 종류에 따라 모델에 고르게 쓰이지 않는다. 이 글에서 수치로 드는 연구 실험은 2022~2024년에 나온 모델로 한 것이다. 아래에서는 자리와 길이와 종류를 차례로 보고, 에이전트가 스스로 채운 창을 비울 때 무엇이 걸리는지까지 같은 세션으로 따라간다.
컨텍스트 엔지니어링은 창에 넣을 것을 고르는 일이다
이 글의 정리로는, 컨텍스트 엔지니어링은 창에 무엇을, 어디에, 얼마나 넣고, 언제 무엇을 빼낼지 고르는 일이다(글쓴이 종합). 프롬프트·컨텍스트·하네스 세 말이 어떻게 다른지는 연재 1편 프롬프트·컨텍스트·하네스 엔지니어링, 뭐가 다를까에서 다뤘다. Anthropic이 이 말을 어떻게 설명했는지도 거기 있다. 그 글은 「규칙이 입력에 있었는데도 어겼다」 경우의 컨텍스트 쪽 물음을 「입력이 길어 규칙이 흐려지지 않았는지」로 남겨 두었다. 이 글은 그 물음을 판다.
연재 1편이 짧게 꺼내고 이 글로 넘긴 현상이 있다. Anthropic이 엔지니어링 글에서 context rot라고 부른 것으로, 창에 든 토큰 수가 늘면 모델이 그 창에서 정보를 정확히 떠올리는 힘이 준다는 관찰이다. 회사는 줄어드는 정도가 모델마다 다르지만, 모든 모델에서 나타난다고 적는다. 이 개념을 드러낸 것은 바늘 찾기(needle-in-a-haystack)식 벤치마크 연구라며 그 연구로 이어 두기도 했는데, 이 글은 그 연구를 따로 확인하지 않았다. 회사는 이 관찰을 근거로 컨텍스트를 한정된 자원, 곧 넣을수록 얻는 이득이 줄어드는 자원으로 다루라고 쓴다.
실험들은 이 흐려짐을 셋으로 나눠 하나씩 따로 다뤘다. Liu 외 연구팀은 문서 수를 그대로 두고 정답이 놓인 자리를, Levy 외 연구팀은 핵심 문단을 그대로 두고 입력의 길이를, Cuconasu 외 연구팀은 함께 넣은 문서의 종류와 개수를 바꿔 가며 쟀다. 이 실험들에서는 연구팀이 입력을 미리 짜 두고 물었다. 에이전트는 사정이 다르다. 일을 하며 도구 결과를 창에 스스로 쌓고, 대화가 길어지면 새 요청과 도구 결과가 기록 뒤로 차례로 이어 붙는다. 그래서 넷째 물음, 언제 무엇을 뺄지가 붙는다.
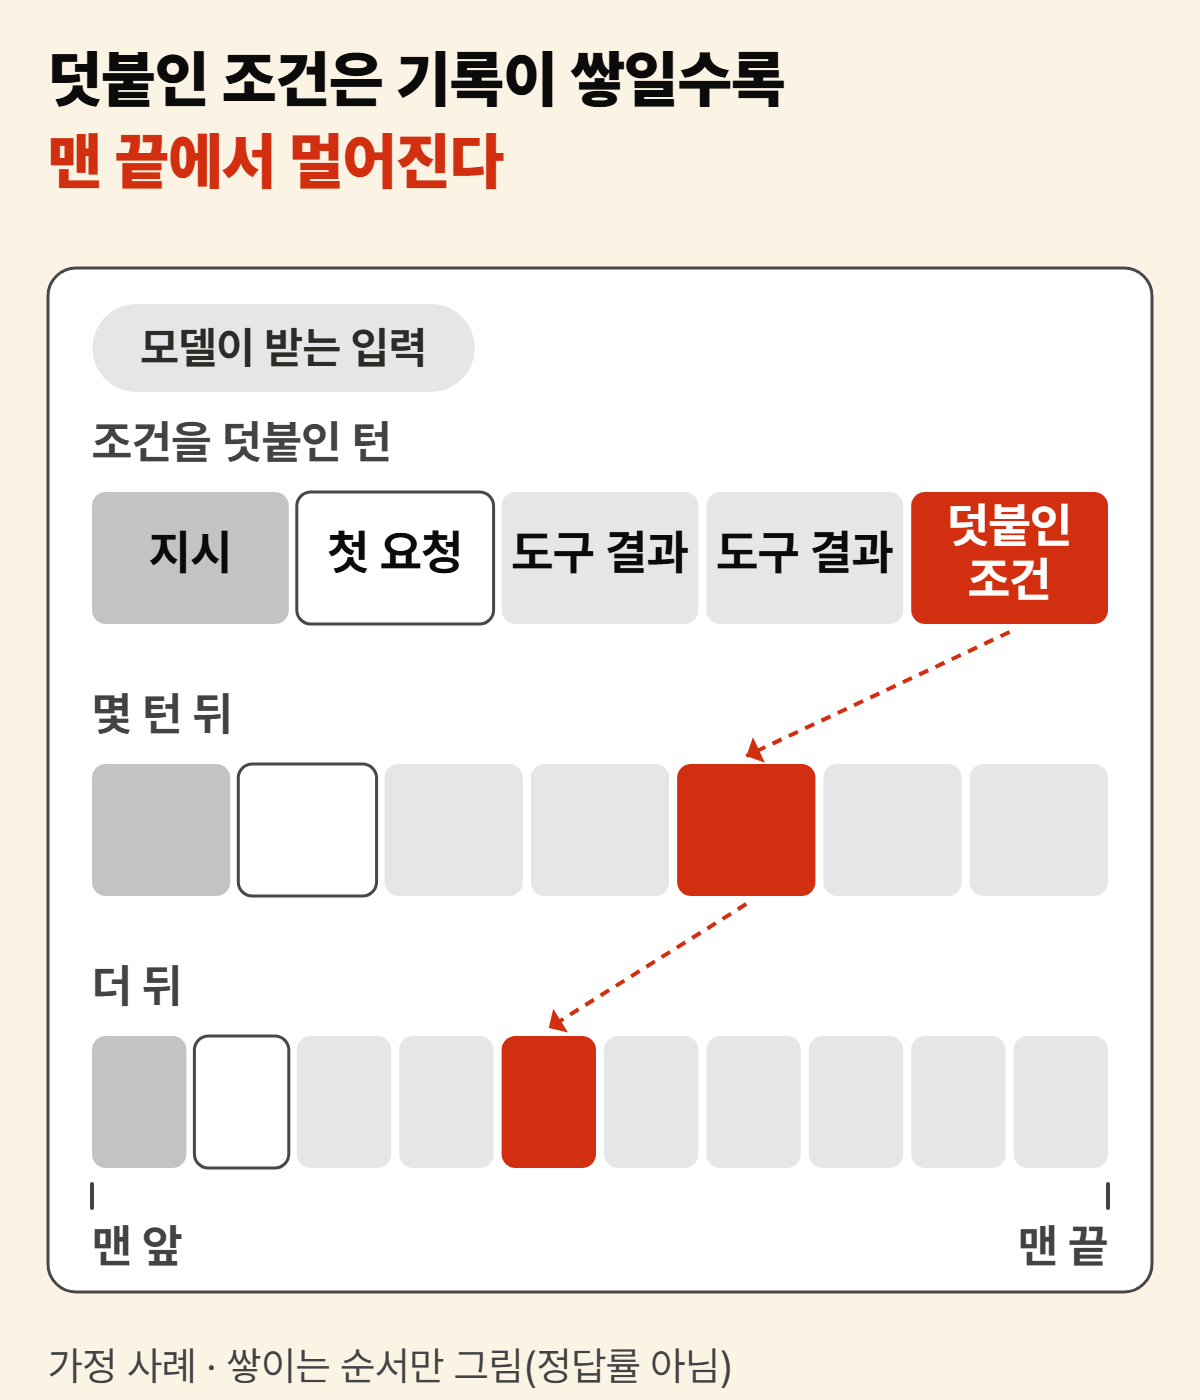
사례의 세션도 이렇게 자란다. (ㄱ)의 조건은 사용자 메시지라 도구 결과 지우기로는 빠지지 않고, 그 수정을 낸 턴 전에 요약도 돌지 않았다. 그 턴에 모델이 받은 입력에 조건은 그대로 있었다. 다만 조건 뒤로 도구 결과가 계속 붙으면서, 중간에 덧붙인 조건은 시간이 갈수록 입력의 맨 끝에서 멀어진다. 그림 1가 그 모양이다.
네 물음을 나란히 놓으면 표 1과 같다.
| 물음 | 이 물음이 고르는 것 | 창에서 손대는 것 | 근거(무엇을 바꿔 쟀나) |
|---|---|---|---|
| 어디에 | 정답·조건이 입력의 어디에 놓이나 | 지시와 근거의 자리 | Liu 외 — 정답 문서의 자리만 |
| 얼마나 | 입력 전체가 얼마나 긴가 | 입력 전체(다 쓴 도구 결과 포함) | Levy 외 — 채우는 글의 길이만 |
| 무엇을 | 함께 넣은 문서가 어떤 종류인가 | 붙이는 문서(검색 결과) | Cuconasu 외 — 더한 문서의 종류와 개수 |
| 언제 빼나 | 쌓인 것을 언제 무엇으로 바꾸나(지우기·요약) | 오래된 도구 결과와 긴 기록 | Anthropic 문서(방식을 적음) · Mehta·Datta — 기록을 줄이는 방식(창 예산도 함께 달라짐) |
표 1의 네 물음은 실험과 문서를 이 글이 나눠 세운 틀이다(글쓴이 종합). 다음 절부터는 같은 세션 하나에 이 물음을 차례로 맞춰 본다. 실험은 하나씩 떼어 쟀지만, 한 세션 안에서는 네 물음이 함께 움직인다.
어디에 놓인 글이 덜 쓰이나
첫머리의 실험 설계는 이렇다. Liu 외 연구팀은 모델에게 위키백과 문단 20개(약 4천 토큰)를 주고 질문 하나에 답하게 했다. 20개 가운데 답이 든 문서는 한 장이다. 나머지 19장은 검색기가 질문과 가장 가깝다고 찾아 온 문단인데, 답은 들어 있지 않다. 연구팀은 이 묶음을 그대로 두고, 답이 든 문서의 자리만 1·5·10·15·20번째로 옮겨 가며 정답률을 쟀다(그림 2).
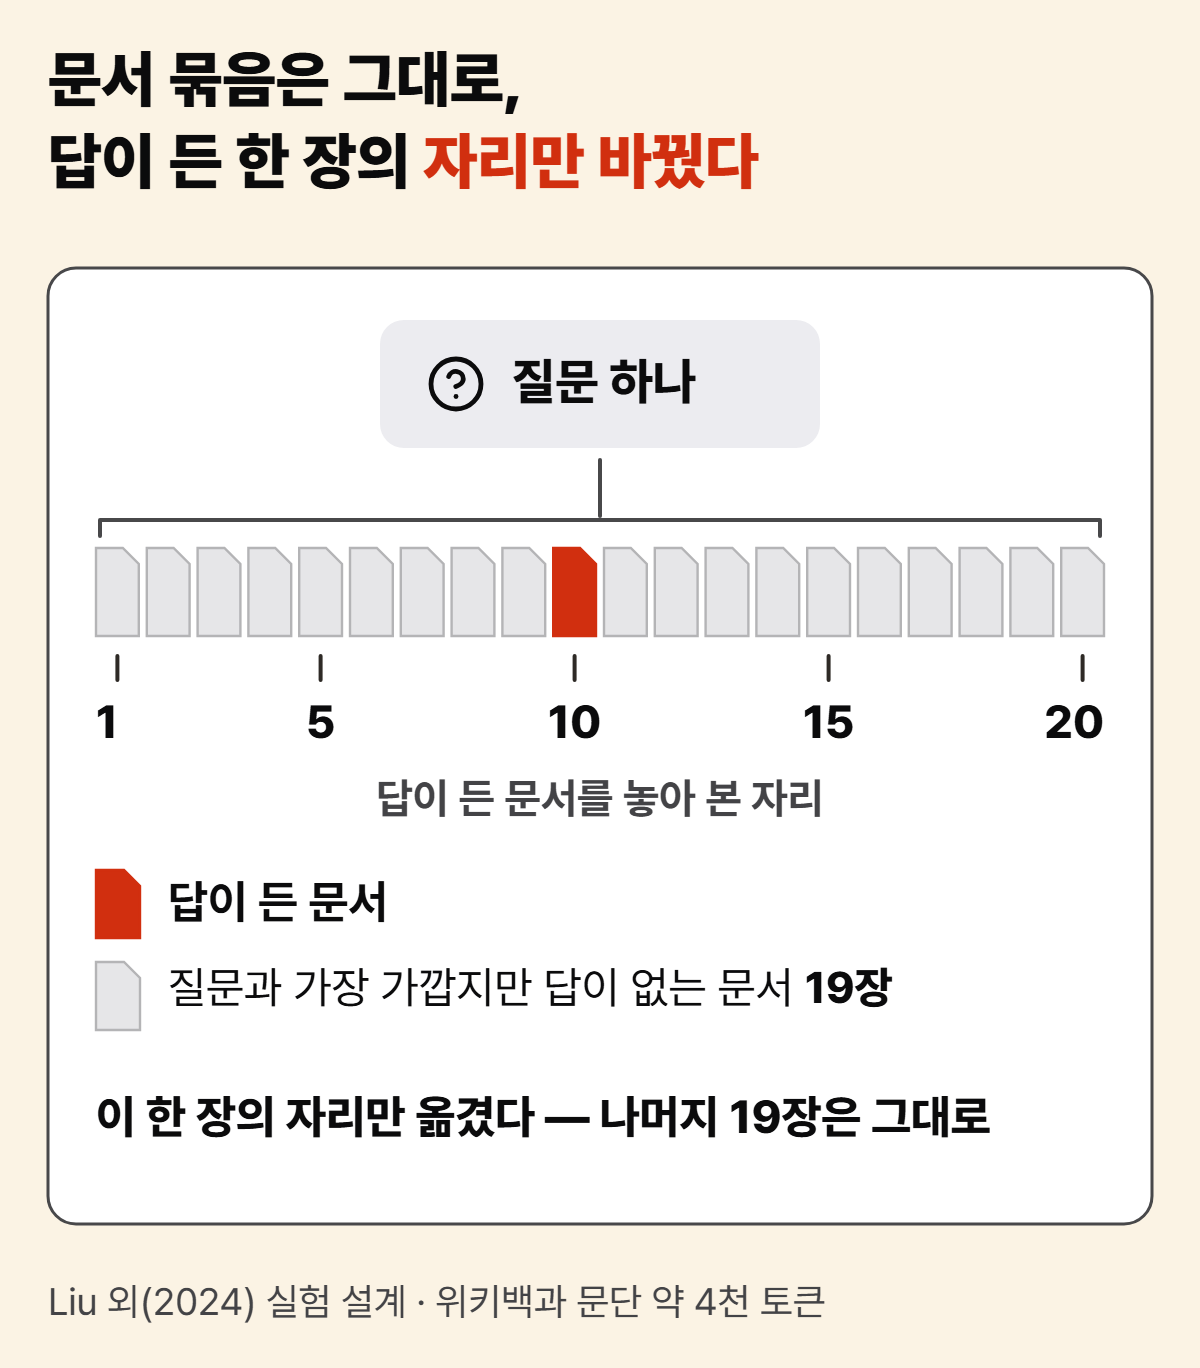
그림 3은 GPT-3.5-Turbo의 결과다. 정답 문서가 맨 앞이면 75.8%, 열 번째면 53.8%, 맨 끝이면 63.2%를 맞혔다. 앞과 끝이 높고 가운데가 낮은 U자다.
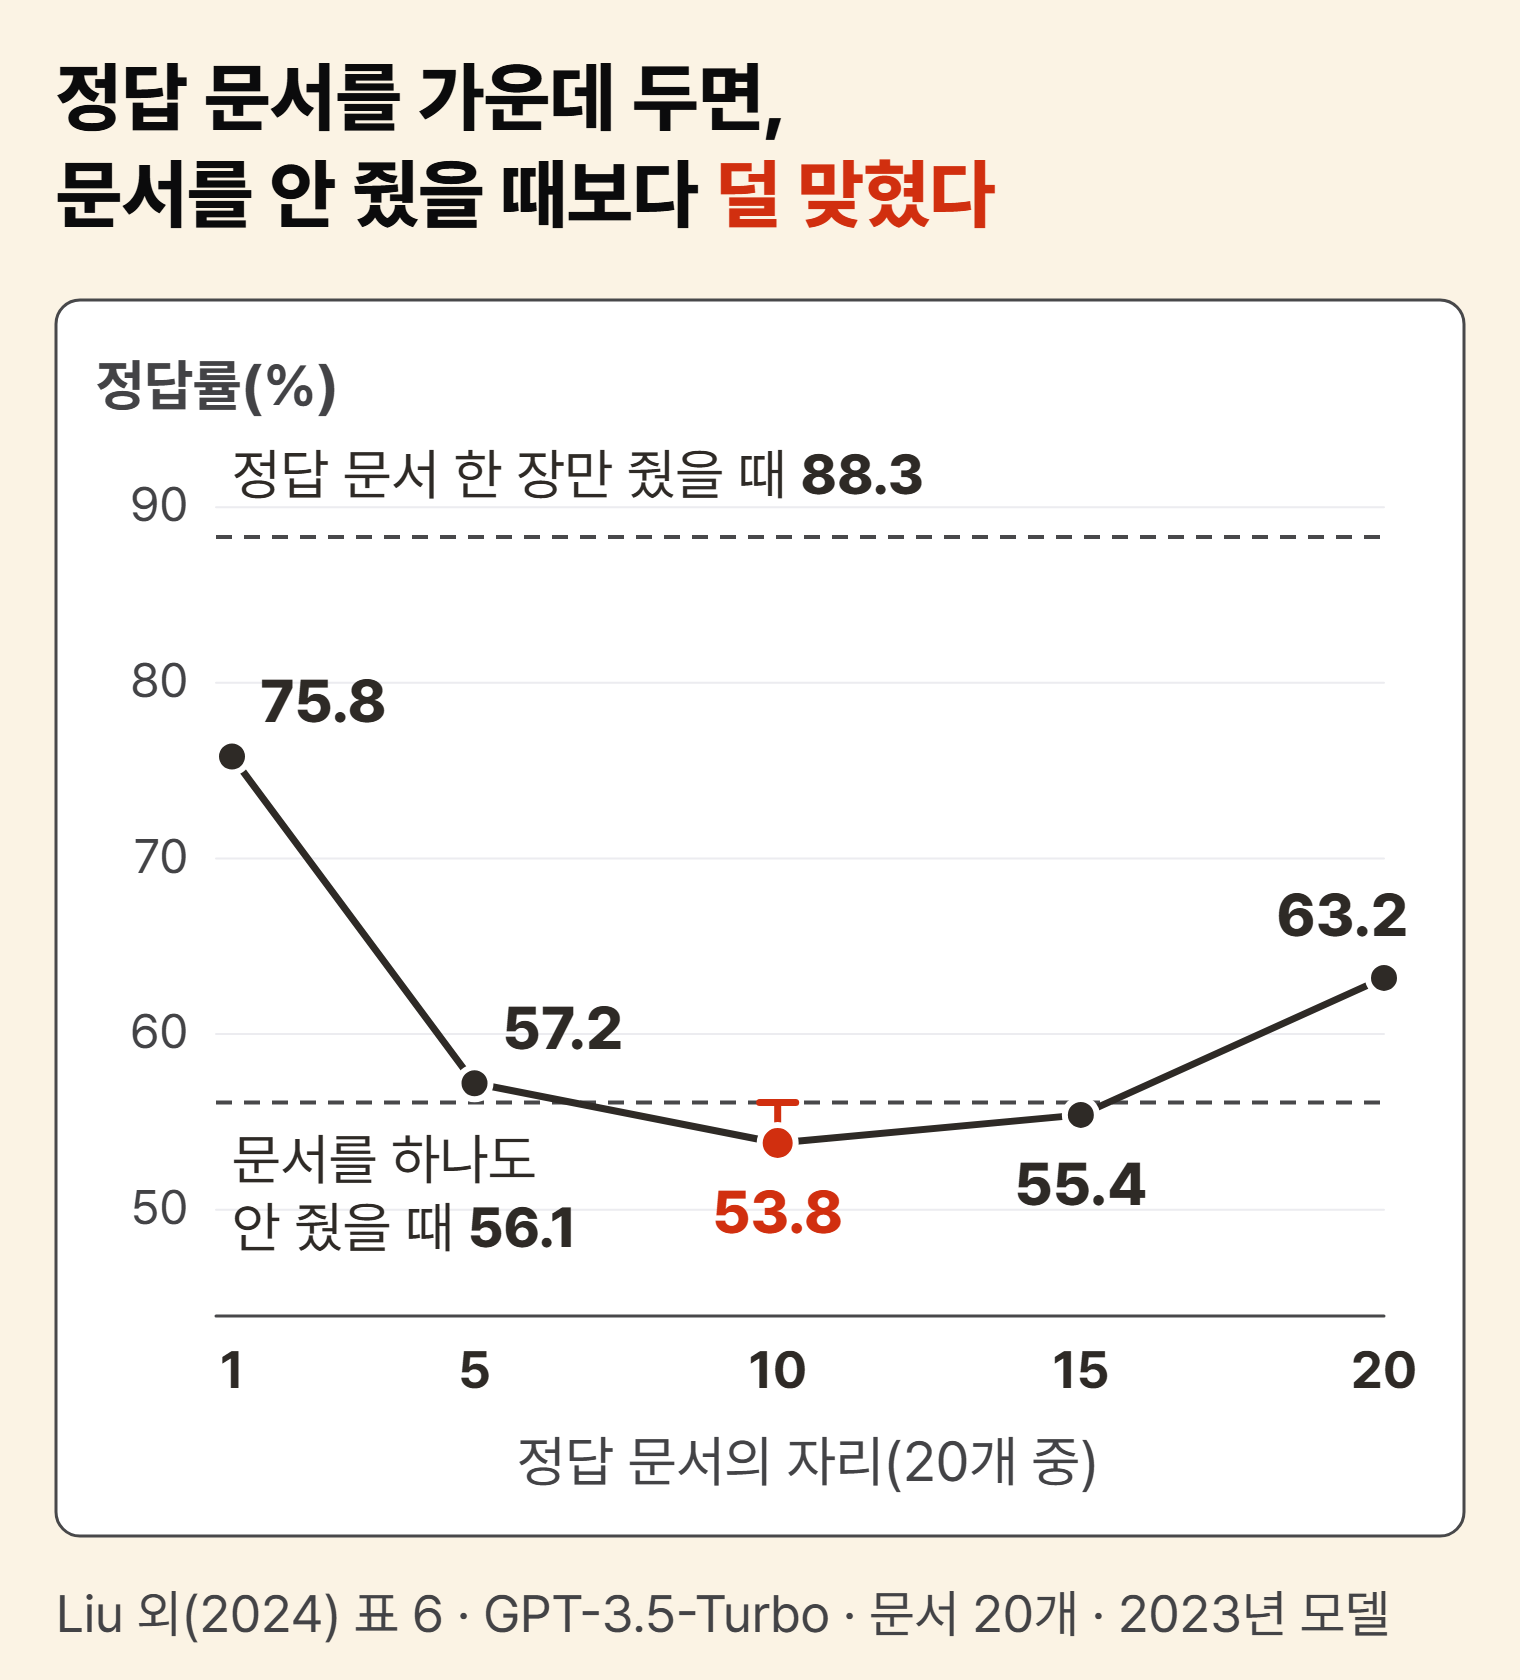
이 숫자는 기준선 둘과 함께 읽어야 한다. 정답 문서 한 장만 줬을 때 모델은 88.3%를 맞혔는데, 정답 문서를 제대로 쓸 때 낼 수 있는 성적이다. 문서를 한 장도 주지 않았을 때는 56.1%였는데, 모델이 원래 알던 것만으로 낸 성적이다. 열 번째(53.8%)와 열다섯 번째(55.4%)는 이 56.1%보다도 낮았다. 이 연구의 제목이 Lost in the Middle, 곧 「가운데서 길을 잃는다」다. 2026년에 에이전트 연구를 정리한 한 리뷰 논문도 모델이 긴 입력을 고르게 보지 않는다는 예로 이 현상을 들며, 같은 이름(lost in the middle)으로 부른다.
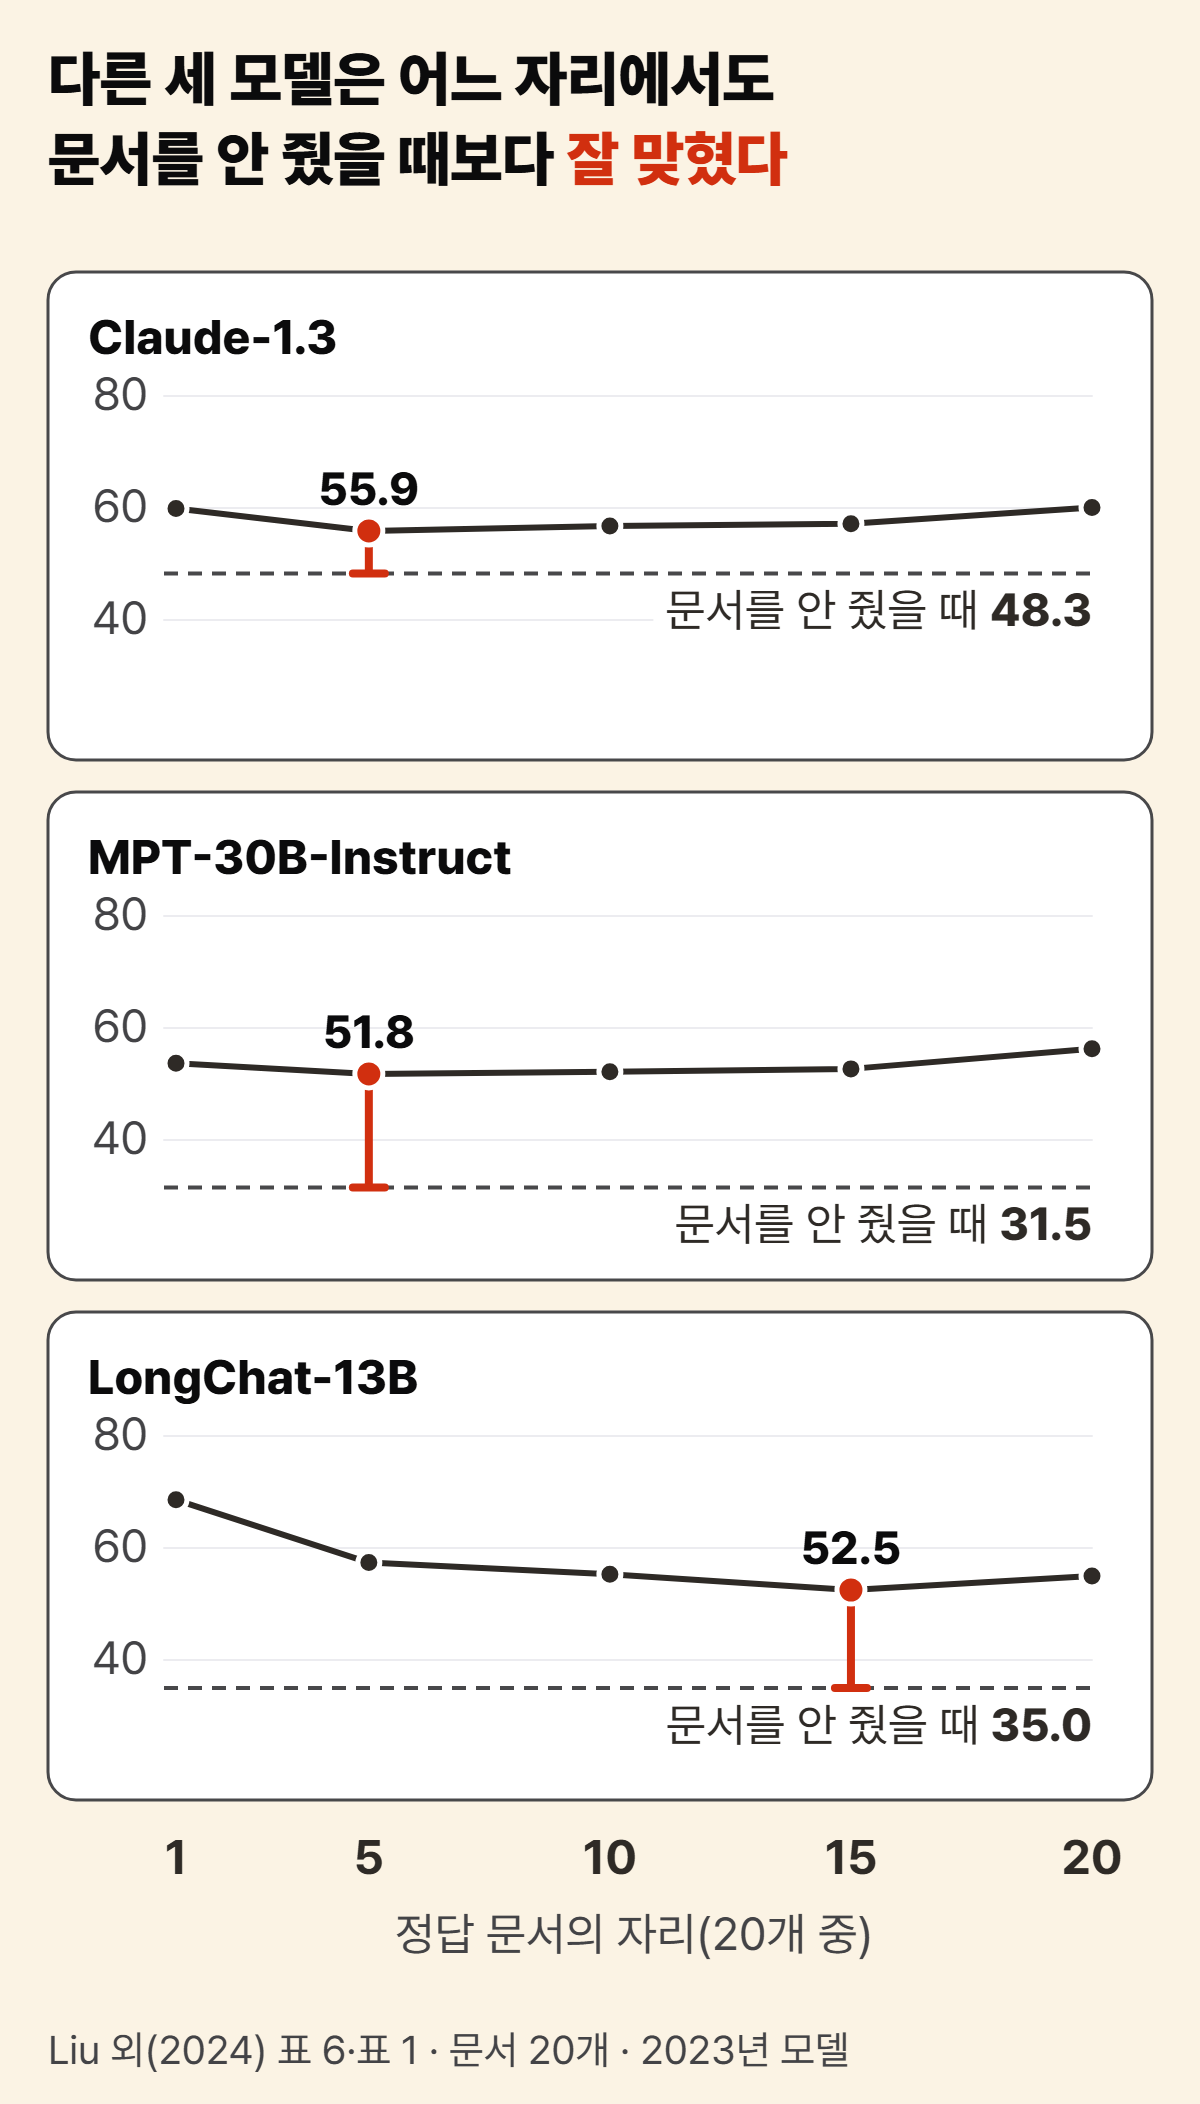
곡선의 깊이는 모델마다 달랐다. 같은 실험의 다른 세 모델은 그림 4처럼 어느 자리에서도 문서를 안 줬을 때보다 잘 맞혔다. 이를테면 Claude-1.3은 가장 낮은 다섯 번째 자리(55.9%)도 문서를 안 줬을 때(48.3%)보다 높았다. 「가운데 둔 정답이 안 준 것보다 못하다」는 GPT-3.5-Turbo에서 나온 결과다.
창을 넓힌 모델도 사정이 같았다. 입력 한도를 넓힌 GPT-3.5-Turbo와 Claude-1.3의 버전은 같은 길이의 입력에서 원래 모델과 거의 같은 성적을 냈다. 연구팀은 「창을 넓힌 모델이 입력을 더 잘 쓰는 것은 아니다(Extended-context models are not necessarily better at using input context)」라고 적는다.
사례의 (ㄱ)에서 조건이 입력의 맨 앞도 맨 끝도 아닌 자리에 있었다면, 자리가 먼저 볼 후보 하나다. 다만 이 실험은 문서를 읽고 질문에 답하는 과제였지 코딩 세션이 아니었다. 사례에 실험을 적용한 것은 이 글의 정리다(글쓴이 종합). U자가 왜 생기는지도 아직 하나로 정해지지 않았는데, 이 이야기는 뒤의 심화 절로 미룬다. 창에 정답이 들어 있다는 것과 모델이 그 정답을 쓴다는 것은 다른 일이다.
얼마나 길어지면 덜 맞히나
Levy 외 연구팀은 길이 하나만 따로 떼어 쟀다. 과제는 참인지 거짓인지 묻는 질문 하나에 답하는 것인데, 답하려면 핵심 문단 둘을 함께 읽어야 한다. 연구팀은 그 두 문단은 그대로 두고 채워 넣는 글만 늘려, 입력을 약 250토큰에서 3천 토큰까지 바꿨다(그림 5).
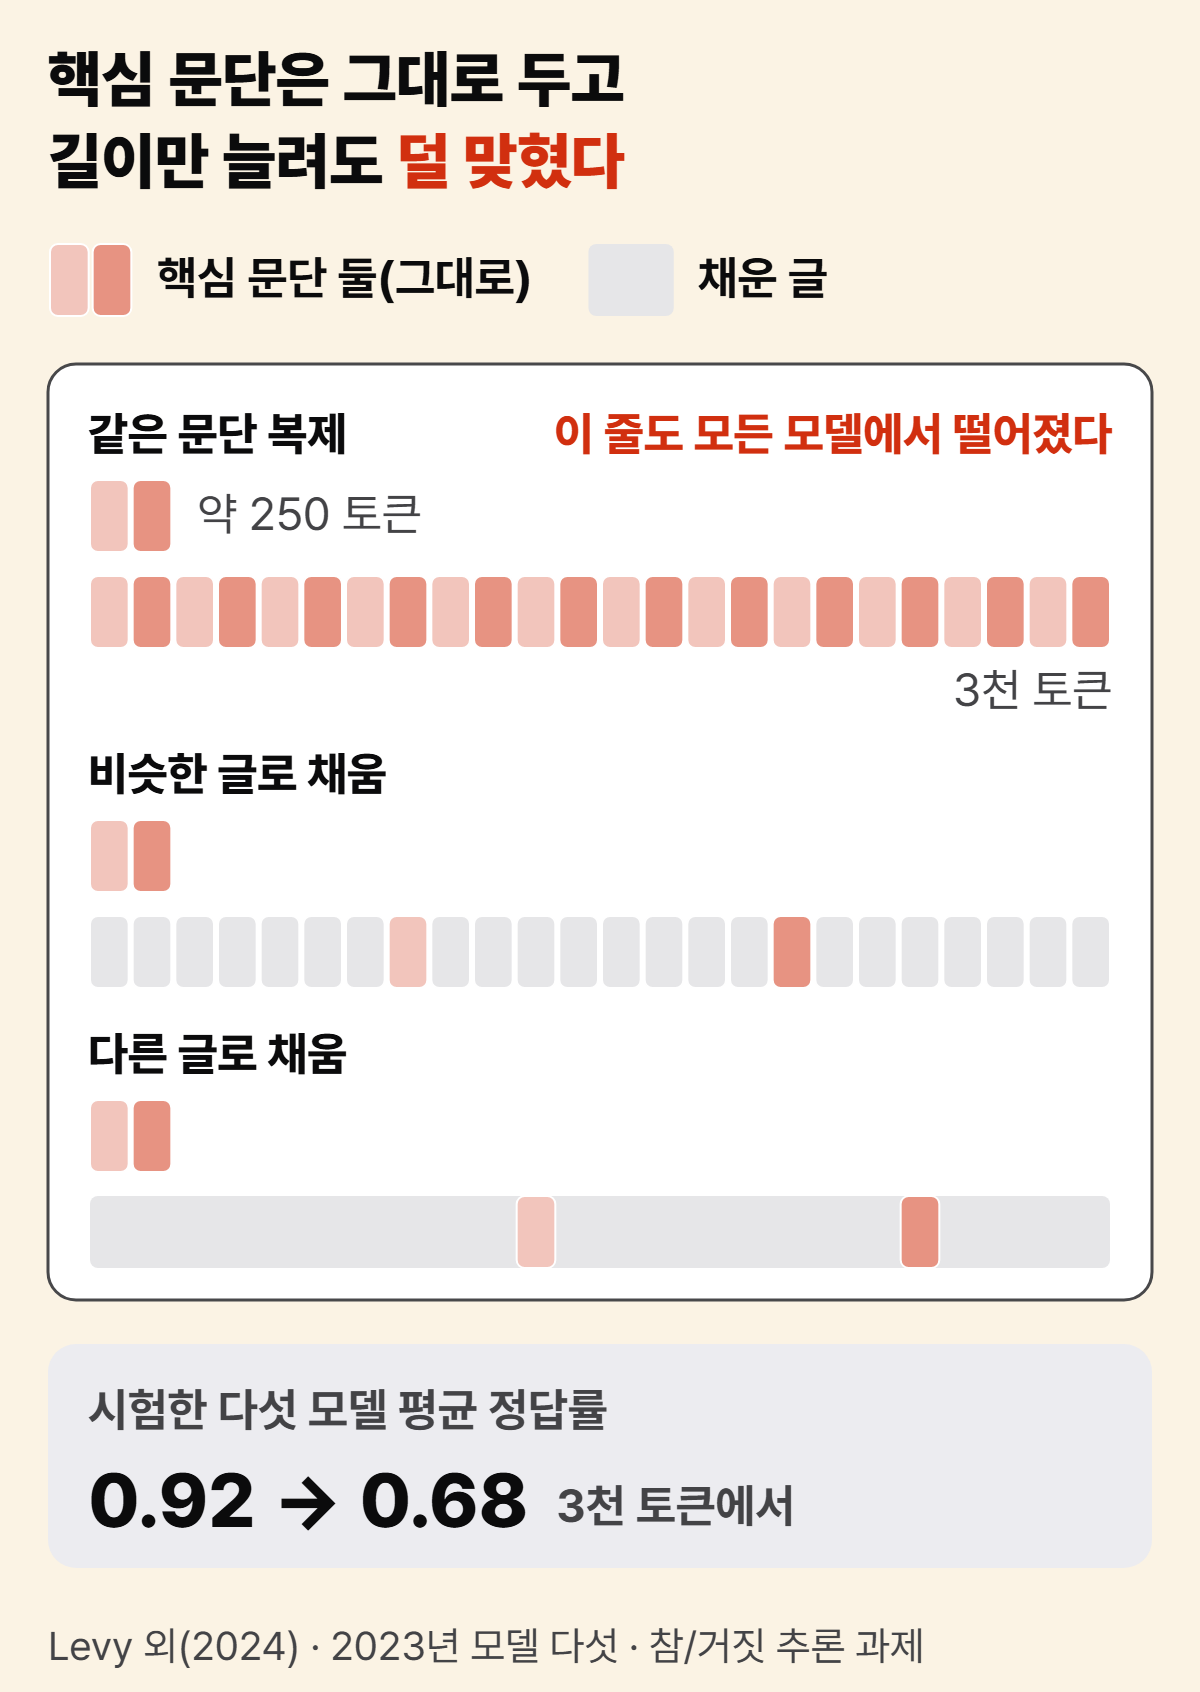
3천 토큰은 모델이 받을 수 있는 최대 길이보다 한참 짧다. 그런데도 시험한 다섯 모델의 평균 정답률은 0.92에서 0.68로 떨어졌다. 채우는 글을 핵심 문단과 비슷한 글로 하든 다른 글로 하든, 핵심 문단의 자리를 옮기든 비슷하게 떨어졌다.
관련 없는 글이 섞인 탓이라는 설명도 연구팀은 따로 시험했다. 핵심 문단을 손대지 않고 그대로 되풀이해 길이를 채운 조건이다. 관련 없는 글이 하나도 없으니 연구팀도 떨어지지 않으리라 예상했다. 결과는 반대였다. 논문은 「모든 모델에서 길이에 따라 정확도가 떨어졌다(accuracy decreases with length for all models)」고 적는다. 떨어진 정도는 모델마다 달랐고, GPT-3.5와 GPT-4는 관련 없는 글로 채웠을 때보다 이 조건에서 길이의 영향을 덜 받았다.
연구팀은 입력이 길수록 모델이 입력 속 지시를 따르지 않는 경향도 보고했다. 답을 아예 내지 않는 식이다. 다만 이때의 지시는 답을 어떤 형식으로 내라는 지시였으므로, 사례의 「함수 이름을 바꾸지 말 것」과 같은 종류로 볼 수는 없다.
사례의 (ㄱ)으로 돌아가면, 조건 뒤로 도구 결과가 쌓이면서 두 가지가 함께 바뀐다. 조건은 맨 끝에서 멀어지고, 입력 전체는 길어진다. 실험은 이 둘을 따로 떼어 놓고서야 갈랐다. 사례의 기록만으로는 어느 쪽이 걸렸는지 가를 수 없고, 그래서 뒤의 짐작 표는 (ㄱ)에 자리와 길이를 함께 후보로 둔다.
문서를 더 붙이는 쪽은 Liu 외 연구팀이 같은 논문에서 쟀다. 위키백과에서 문서를 찾아 와 질문에 답하는 사례 연구에서, 붙이는 문서를 20개에서 50개로 늘려도 GPT-3.5-Turbo는 약 1.5%, Claude-1.3은 약 1%만 더 맞혔다. 그사이 입력은 크게 길어져 지연과 비용이 늘었다. 검색기가 찾아 오는 정답 문서는 계속 늘었지만, 모델 성적은 그보다 훨씬 먼저 멈췄다. 연구팀의 말로 더 붙인 문서는 성적을 「아주 조금만(only marginally)」 올렸다.
그림 6의 바늘이 0에 머물지 않은 것처럼, 성적은 조금은 올랐다. 다만 붙인 양에 비하면 아주 작았다. 창을 크게 쓰는 쪽과 찾아 붙이는 쪽 가운데 언제 무엇이 나은지는 이 블로그의 컨텍스트 창 100만 토큰 시대, RAG는 언제 이기고 언제 지는가에서 따졌다. 거기서는 두 방식 가운데 하나를 고르는 문제였고, 여기서는 한 창 안에 문서를 더 붙였을 때 성적이 얼마나 따라오는지만 본다. 입력은 쓸데없는 글이 섞일 때만 짐이 되는 것이 아니다. 길어지는 것만으로도 짐이 되고, 늘린 만큼 성적이 따라오지도 않았다.
어떤 문서가 섞이면 더 헷갈리나
검색해 찾은 문서를 창에 붙여 답하게 하는 구조를 RAG라고 한다. 이 블로그의 RAG 란 무엇인가: 답하기 전에 찾아 읽기는 찾아 읽고 답하는 그 흐름을 다뤘다. 이 절은 그렇게 붙인 문서에 답 없는 문서가 끼어들 때를 본다.
Cuconasu 외 연구팀이 문제 삼은 것은 답은 없지만 주제나 맥락이 이어진 문서다. 이 글은 이런 문서를 「주제는 맞는데 답이 없는 문서」라고 부른다. 논문이 드는 예로, 나폴레옹이 탄 말의 색을 묻는데 나폴레옹의 첫 아내 조제핀이 탄 말의 색을 적은 문단이 붙는 경우다. 실제 검색에서는 검색기 점수는 높게 나왔지만 답과 관련이 없는 문서가 여기에 든다. 논문은 이런 문서가 실제 검색 환경에서 흔하다고 적는다.
주제는 맞는데 답이 없는 문서를 하나만 더해도, 가장 크게 떨어진 조건에서는 정답률이 0.14(원래 값의 24%) 깎였다(그림 7). 여러 개를 더하면 일부 경우 0.38 넘게(원래 값의 68%) 깎였다. 반대로 검색 문서 4개에 질문과 상관없는 무작위 문서를 더해 창이 찰 때까지 채운 한 구성에서는 정답률이 0.07(35%) 올랐다. 셋 다 평균이 아니다. 또 두 하락값은 정답 문서를 넣은 설정에서, 상승값은 실제 검색 문서 묶음에 더한 설정에서 나와 기준 설정이 다르다. 그래서 막대끼리 직접 비교할 값은 아니다.
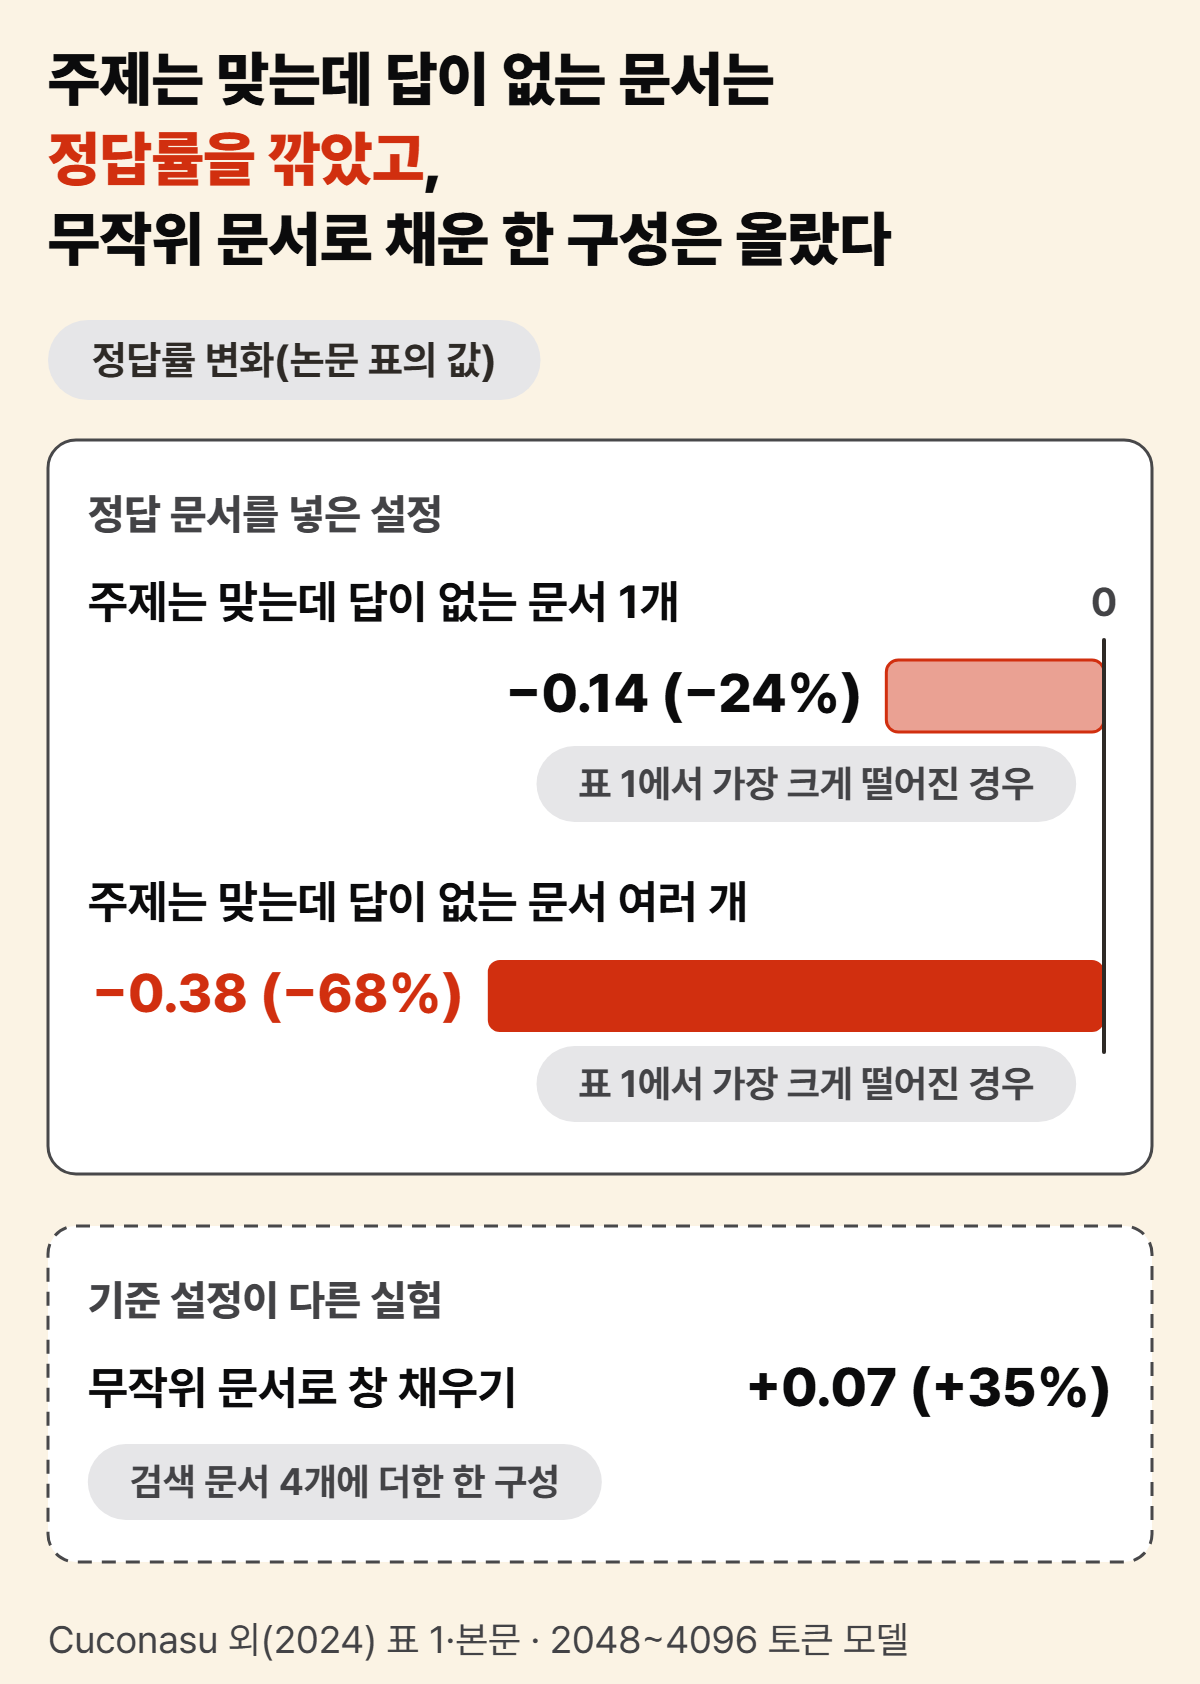
무작위 문서의 +0.07은 「아무 글이나 더 넣으면 좋아진다」는 처방이 아니다. 입력 한도가 2048~4096 토큰이던 작은 모델에서, 검색 문서 4개에 더한 한 구성의 값이다. 이 실험에서 가져갈 것은 주제는 맞는데 답이 없는 문서가 무작위 문서보다 해로웠다는 점이다.
답과 상관없는 글이 섞이면 흔들린다는 결과는 다른 과제에서도 나왔다. Shi 외 연구팀은 2022년에 나온 모델로 산수 문장제에 문제와 상관없는 문장 하나를 심었다. 기본 프롬프트로 풀던 문제 가운데, 심은 문장의 종류를 모두 바꿔 가며 물었을 때 매번 맞힌 것은 18%를 넘지 않았다.
사례의 (ㄴ)으로 오면, 새 버전 문서 곁에 들어온 옛 버전 문서가 경우에 따라 주제는 맞는데 답이 없는 문서가 된다. 같은 라이브러리를 다루니 주제는 같지만, 지금 옮기려는 버전의 함수를 찾는 자리라면 옛 버전 문서에는 그 답이 없다. 결과에 옛 버전에만 있는 함수가 나왔다면 붙인 문서의 종류가 먼저 볼 후보다. 그림 8은 그 경우를 그린 장면이다.
다만 결과만 보고 모델이 옛 버전 문서를 따랐다고 단정할 수는 없다. 실험은 문서를 읽고 답하는 과제였으므로, 그 결과를 이 사례에 적용해도 방향을 가리키는 데서 그친다(글쓴이 종합). 그래도 엉뚱한 무작위 문서보다 주제가 같은 문서가 더 해로웠다는 실험 결과는, 사례의 옛 버전 문서와 겹치는 대목이다. 같은 수의 글을 넣어도, 무엇이 섞였느냐에 따라 정답률은 크게 달라진다.
쌓인 창을 비우면 무엇을 잃나
에이전트는 세션을 돌며 창을 스스로 채운다. Anthropic의 2025년 9월 공지는 에이전트가 일을 하며 도구 결과를 쌓아 간다고 쓰고, 코딩의 예로 오래된 파일 읽기와 테스트 결과를 든다. 쌓인 것을 비우는 방식 둘을 Anthropic API 문서가 적는다. 두 방식이 모델이 받는 입력의 어느 부분을 무엇으로 바꾸는지는 그림 9에 그렸다.
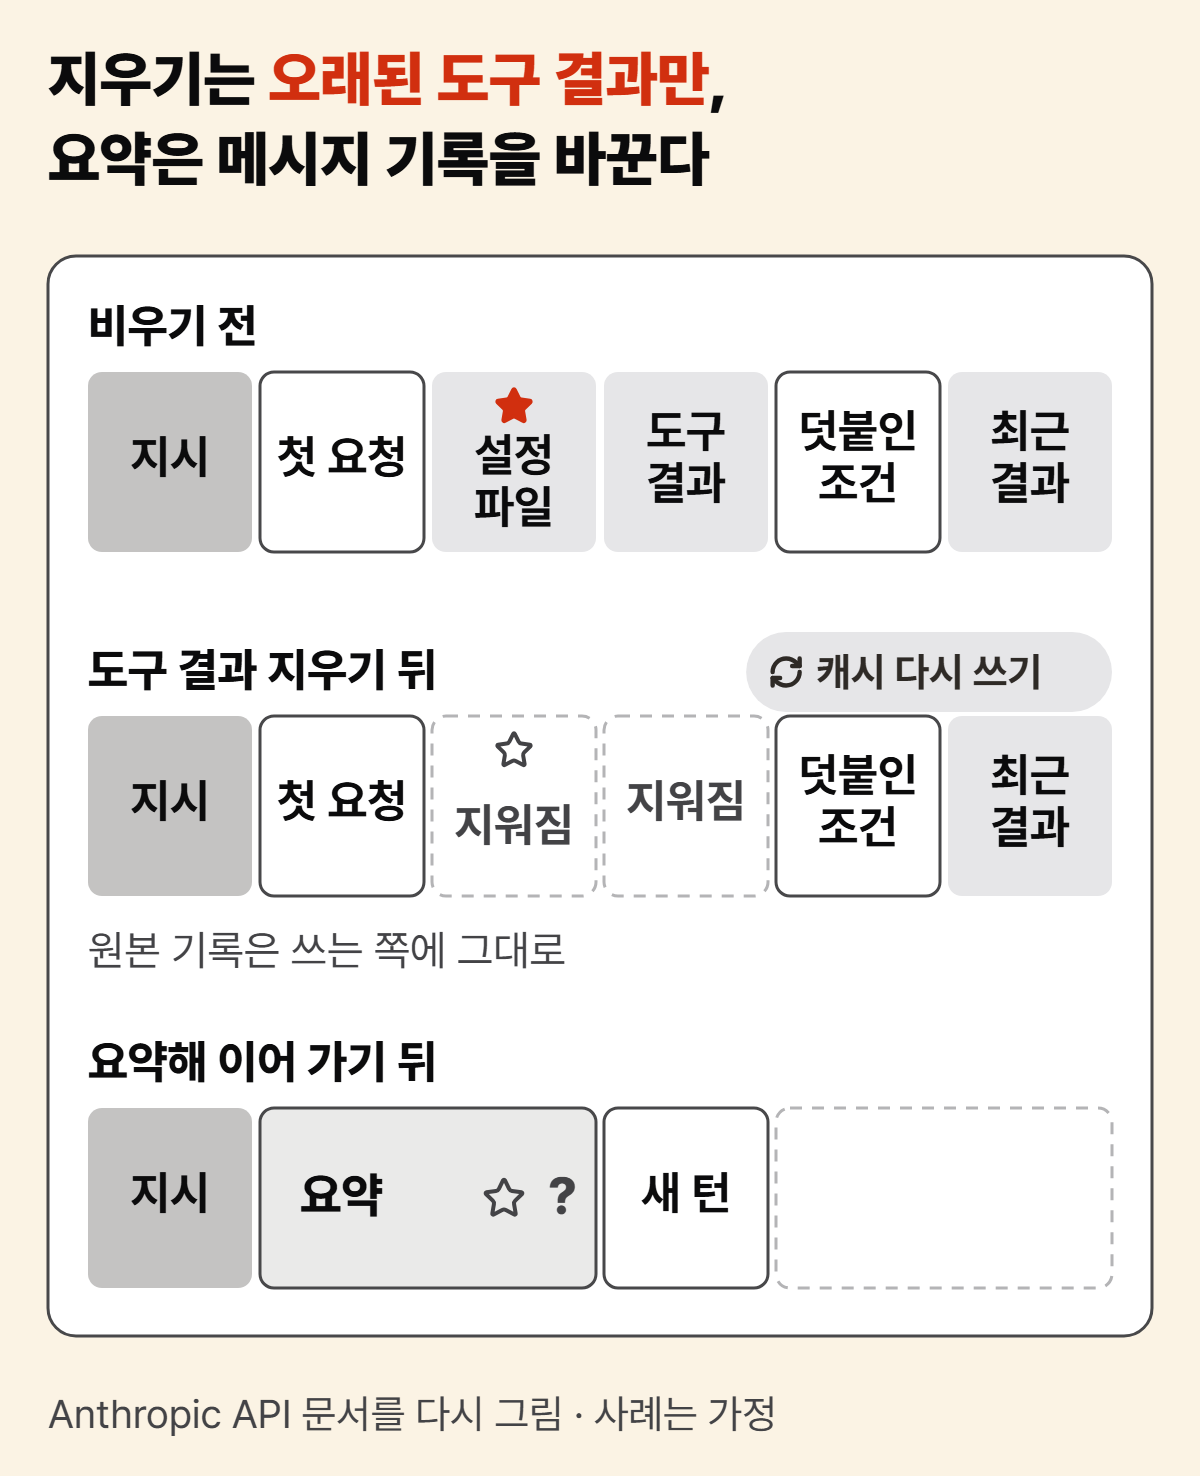
첫째는 도구 결과 지우기다. 입력이 정해 둔 한도를 넘으면 가장 오래된 도구 결과부터 지우고, 그 자리에 지워졌다고 알리는 짧은 글, 곧 자리표시 글을 남긴다. 기본으로는 도구 결과만 지운다. 이 편집은 서버에서, 요청이 모델에 전해지기 전에 일어나고, 쓰는 쪽은 수정되지 않은 전체 기록을 그대로 가진다. API를 직접 부를 때는 어떤 편집이 적용됐는지가 응답의 context_management 필드에 지운 개수·토큰 수와 함께 나오는데, 이 글은 이것을 편집 정보라 부른다. 지운 원본은 쓰는 쪽 기록에 있고 읽어 온 파일도 지워지지 않으니, 다시 읽힐 길이 있다.
대신 값이 든다. 문서에 따르면 도구 결과를 지우면 캐시된 프롬프트 앞부분이 무효가 된다. 프롬프트 캐시는 요청마다 같은 앞부분을 다시 계산하지 않도록 저장해 둔 것이다. 지울 때마다 캐시를 새로 쓰는 비용이 들고, 그래서 문서는 「캐시 무효화를 감수할 만큼 충분히 지우라」고 권한다. 창을 아끼는 일과 캐시를 살리는 일이 서로 맞선다.
둘째는 요약해 이어 가기(compaction)다. 문서의 SDK(API를 코드에서 부르기 쉽게 묶어 둔 개발 도구) 예시는 대화 기록을 요약하게 한 뒤, 메시지 기록 전체를 그 요약으로 바꾼다. 이 예시에서 기록을 요약으로 바꾸는 일은 쓰는 쪽에서 도는 SDK가 한다. 문서는 이 SDK 방식보다 서버 쪽 요약을 더 권한다. 이 방식을 켜는 설정은 TypeScript·Ruby SDK에서는 폐기 예정이고, Python SDK에서는 v1.0부터 빠졌다고 문서는 적는다.
요약의 위험은 Anthropic 엔지니어링 글에 나온다. 너무 세게 요약하면, 그때는 사소해 보여도 나중에야 중요해지는 맥락이 빠질 수 있다고 그 글은 쓴다. API 문서도 이른 대화의 세부를 정확히 떠올려야 하는 일을 요약이 덜 맞는 경우로 적는다.
요약이 아니라 오래된 기록을 버리는 쪽을 시험한 연구도 있다. Mehta와 Datta의 2026년 워크숍 논문은 집안일을 흉내 낸 글 과제에서 기록을 줄이는 방식을 바꿔 가며, 방식마다 150번씩 돌렸다(그림 10). 전체 기록을 남기면 56.7%가 성공했다. 시스템 지시와 최근 메시지 넷만 남기고 오래된 기록을 가리지 않고 버리면 22.0%였다. 처음 세운 계획만은 남겨 둬도 20.7%로, 차이를 되찾지 못했다.
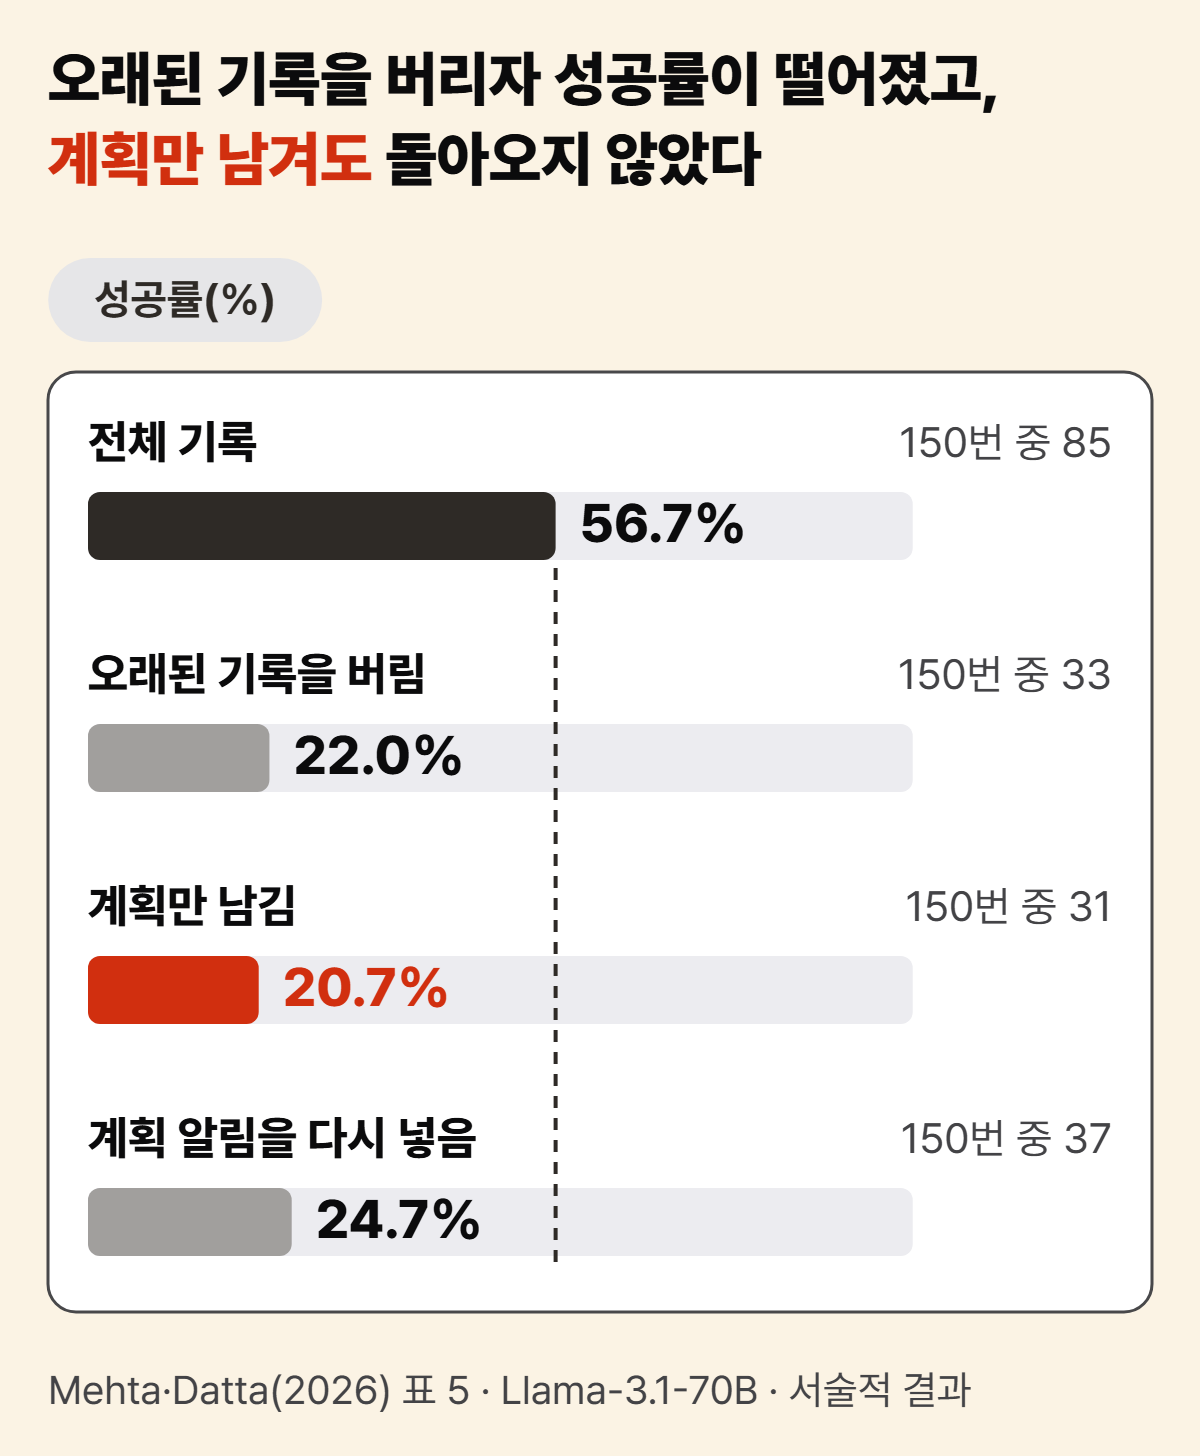
저자들은 이 결과를 스스로 좁혀 둔다. 버리는 방식이 계획 말고도 관찰과 행동 기록까지 지웠고, 이 실험은 프롬프트를 따로 썼으며 창 예산도 방식마다 달랐다. 그래서 이 결과는 「서술적이며 계획 제거 탓으로 돌릴 수 없다(descriptive and cannot be attributed to plan removal)」고 저자들은 쓴다. 시사점으로 저자들은 계획만이 아니라 더 넓은 작업 상태를 남기라고 적는다.
사례의 (ㄷ)은 이 두 방식에 따라 둘로 나뉜다. 메시지 기록이 요약 하나로 바뀌었고 그 요약에 「UTC로 저장」이 빠졌다면, (ㄷ-1) 「요약본에 그 내용이 없다」에 해당한다. 엔지니어링 글이 경고한 손실이 실제로 일어나면 기록에는 이런 모양으로 드러난다. 편집 정보에 도구 결과 지우기가 적용됐다고 나오면, 지운 개수부터 본다. 지우기는 가장 오래된 것부터라, 지운 개수가 설정 파일 결과까지 닿고 그 도구를 지우지 않을 도구로 정해 두지 않았다면 그 결과가 지운 범위에 든다. 여기에 「UTC로 저장」이 남은 다른 메시지도 없고 그 뒤 설정 파일을 다시 읽은 도구 호출도 없다면, (ㄷ-2) 「지워진 도구 결과를 다시 읽지 않았다」에 해당한다.
둘은 확인하는 증거가 다르다. (ㄷ-1)은 요약본을 열어 볼 수 있을 때 그것으로 보고, (ㄷ-2)는 편집 정보와 도구 호출 기록으로 본다. 쓰는 코딩 도구가 편집 정보가 든 응답을 보여 주지 않으면 (ㄷ-2)인지는 알 수 없다. 요약본이 보이면 (ㄷ-1) 쪽은 가늠할 수 있고, 편집 정보도 요약본도 볼 수 없을 때에야 어느 경우인지 판정하지 못한다. (ㄷ-2)에는 하나가 더 있다. 지운 결과도 앞에서 본 대로 다시 읽힐 길이 남아 있다(그림 11).
같은 세션의 네 경우에 자리·길이·종류·비우기를 맞춰 보면 표 2가 된다.
| 사례의 경우 | 자리로 손대는 것 | 길이로 손대는 것 | 종류로 손대는 것 | 비우기로 손대는 것 |
|---|---|---|---|---|
| (ㄱ) 입력에 남은 조건을 어겼다 | 조건을 입력의 어디에 두나 | 다 쓴 도구 결과를 덜어 입력을 줄이기 | — | 다 쓴 도구 결과 지우기(길이 칸과 같은 손질) |
| (ㄴ) 옛 버전에만 있는 함수를 썼다 | — | — | 지금 옮기는 버전에 필요 없는 다른 버전 문서를 걸러 내고 붙이기 | 다 읽은 검색 결과를 지울 대상에 넣기 |
| (ㄷ-1) 요약본에 그 내용이 없다 | — | — | — | 요약 방식 고르기 — 이른 세부를 정확히 떠올려야 하면 요약 말고 다른 방식 |
| (ㄷ-2) 지워진 도구 결과를 다시 읽지 않았다 | — | — | — | 지우지 않을 도구 정하기, 남길 최근 결과 수, 기억 도구를 켰다면 지워지기 전에 창 밖 기억 파일에 적어 두기, 그 파일을 도구로 다시 읽히기 |
표 2의 칸은 실험과 문서를 사례의 네 경우에 맞춰 채운 것이다(글쓴이 종합). 칸이 「—」로 빈 것은 이 글의 근거가 거기까지 말하지 않아서이고, 그 자리에서 손댈 방법이 없어서가 아니다. 한 경우가 여러 열에 걸치기도 해서, (ㄱ)은 자리·길이·비우기 세 열에 걸친다. 거꾸로 여러 경우가 한 열을 나눠 쓰기도 해서, 네 경우 모두 비우기 열에 손댈 것이 있다. 한 세션의 어긋남이라도 경우와 열이 하나씩 짝지어지지는 않는다.
어긋났을 때 기록에서 무엇부터 보나
수정이 어긋났을 때 먼저 손에 쥐는 것은 증상이다. 표 3은 앞 절의 실험과 문서를 그 방향으로, 곧 사례의 증상에서 시작해 거꾸로 늘어놓았다(글쓴이 종합). 실험 자체는 문서 질의응답과 추론 과제였다. 「확인할 증거」 열은 화면에 보이는 작업 기록이 아니라, 그 턴에 모델이 받은 입력을 기준으로 적었다. 줄을 고르는 순서는 그림 12에 그렸다.
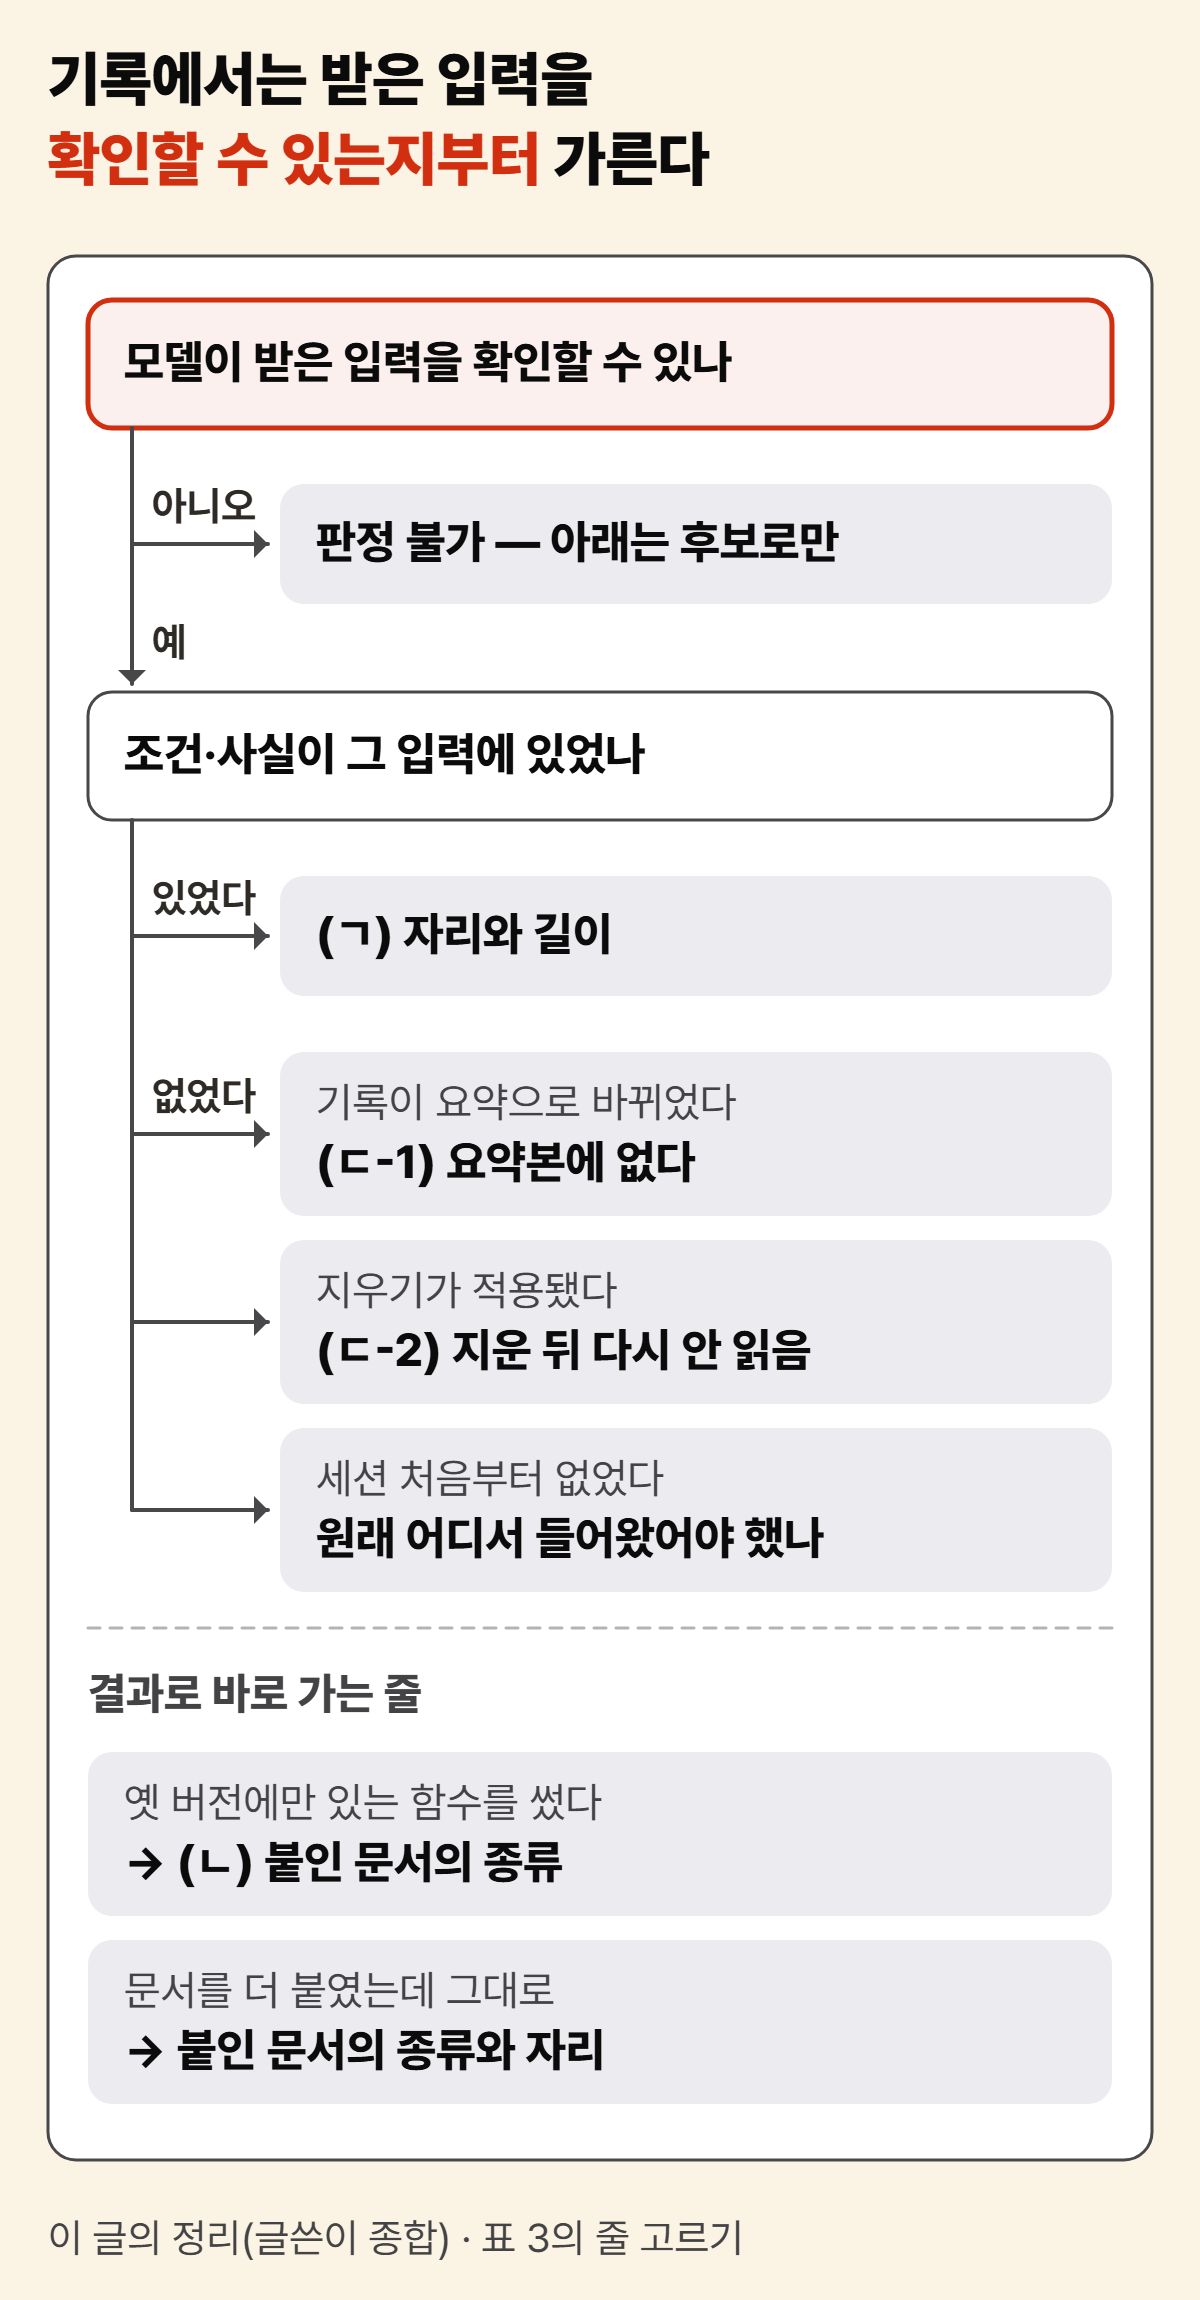
| 증상 | 확인할 증거(그 턴에 모델이 받은 입력) | 먼저 볼 자리 | 근거 |
|---|---|---|---|
| (ㄱ) 입력에 남은 조건을 어겼다 | 받은 입력에 조건이 있었고(요약 없음, 지우기는 도구 결과만), 그 뒤로 도구 결과가 길게 쌓였다 | 자리와 길이 — 둘 다 후보(기록만으로는 못 가른다) | Liu 외 가운데 하락 · Levy 외 길이 하락, 긴 입력에서 입력 속 지시를 덜 따름(답 형식 지시) · context rot(회사 관찰) |
| (ㄴ) 옛 버전에만 있는 함수를 썼다 | 검색 결과에 같은 주제의 다른 버전 문서가 함께 있었다 | 붙인 문서의 종류(후보 — 그 문서를 따랐다고 확정하지 않는다) | Cuconasu 외 표 1 · Shi 외 |
| (ㄷ-1) 요약본에 그 내용이 없다 | 메시지 기록이 요약으로 바뀌었고, 요약에 그 사실이 없다 | 비우기 — 요약 방식 고르기 | Anthropic 문서(요약으로 기록 대체 · 덜 맞는 경우) · 엔지니어링 글(지나친 요약) |
| (ㄷ-2) 지워진 도구 결과를 다시 읽지 않았다 | 지우기가 적용됐고 지운 개수로 보아 그 파일 결과가 지운 범위에 들며, 그 사실이 다른 메시지에도 없고, 그 뒤 그 파일을 다시 읽은 도구 호출이 없다 | 비우기 — 지우기 설정 | Anthropic 문서(오래된 것부터 · 지우지 않을 도구 · 남길 개수 · 원본 기록 · 편집 정보) |
| 문서를 더 붙였는데 나아지지 않았다 | 붙인 문서 수는 늘었는데 결과가 그대로다 | 붙인 문서의 종류와 자리(더 붙이기 전에) | Liu 외 문서 20→50개 |
| 조건·사실이 이번 세션에 들어온 적이 없다 | 원본 기록에도 세션 처음부터 없다 | 원래 어디서 들어왔어야 했나(사용자가 안 줬나 · 검색이 못 찾았나 · 지난 세션에서 정한 것인가) — 마지막일 때만 세션을 넘는 기억(다음 글) | 글쓴이 종합 · Zhou 외 §2.2 「새 세션은 일부를 잊고 시작한다」 |
| 모델이 받은 입력을 확인할 수 없다 | 원본 기록만 있고 편집 정보도 요약본도 볼 수 없다 | 판정 불가 — 위 줄들은 후보로만 | Anthropic 문서(원본 기록은 수정 안 된 채 남는다 · 편집 정보) |
사례의 네 경우는 표에서 서로 다른 줄로 간다. 그래도 「먼저 볼 자리」 열이 알려 주는 것은 어디서부터 열어 볼지이고, 원인을 확정해 주지는 않는다. 그 턴에 받은 입력을 볼 수 없으면, 어느 경우든 마지막 줄의 판정 불가로 간다. 고치기 전에 그 턴의 입력부터 열어 보면, 겉으로는 같은 「틀렸다」가 서로 다른 줄로 나뉜다.
이 숫자들은 어떤 모델과 과제에서 나왔나
이 글의 숫자가 나온 실험을 시간 위에 놓으면 그림 13과 같다. 점은 연구가 발표된 해가 아니라 실험에 쓴 모델이 나온 해에 찍었다. 회사 내부 평가만은 쓴 모델이 공지에 없어, 공지 시점으로 따로 표시했다.
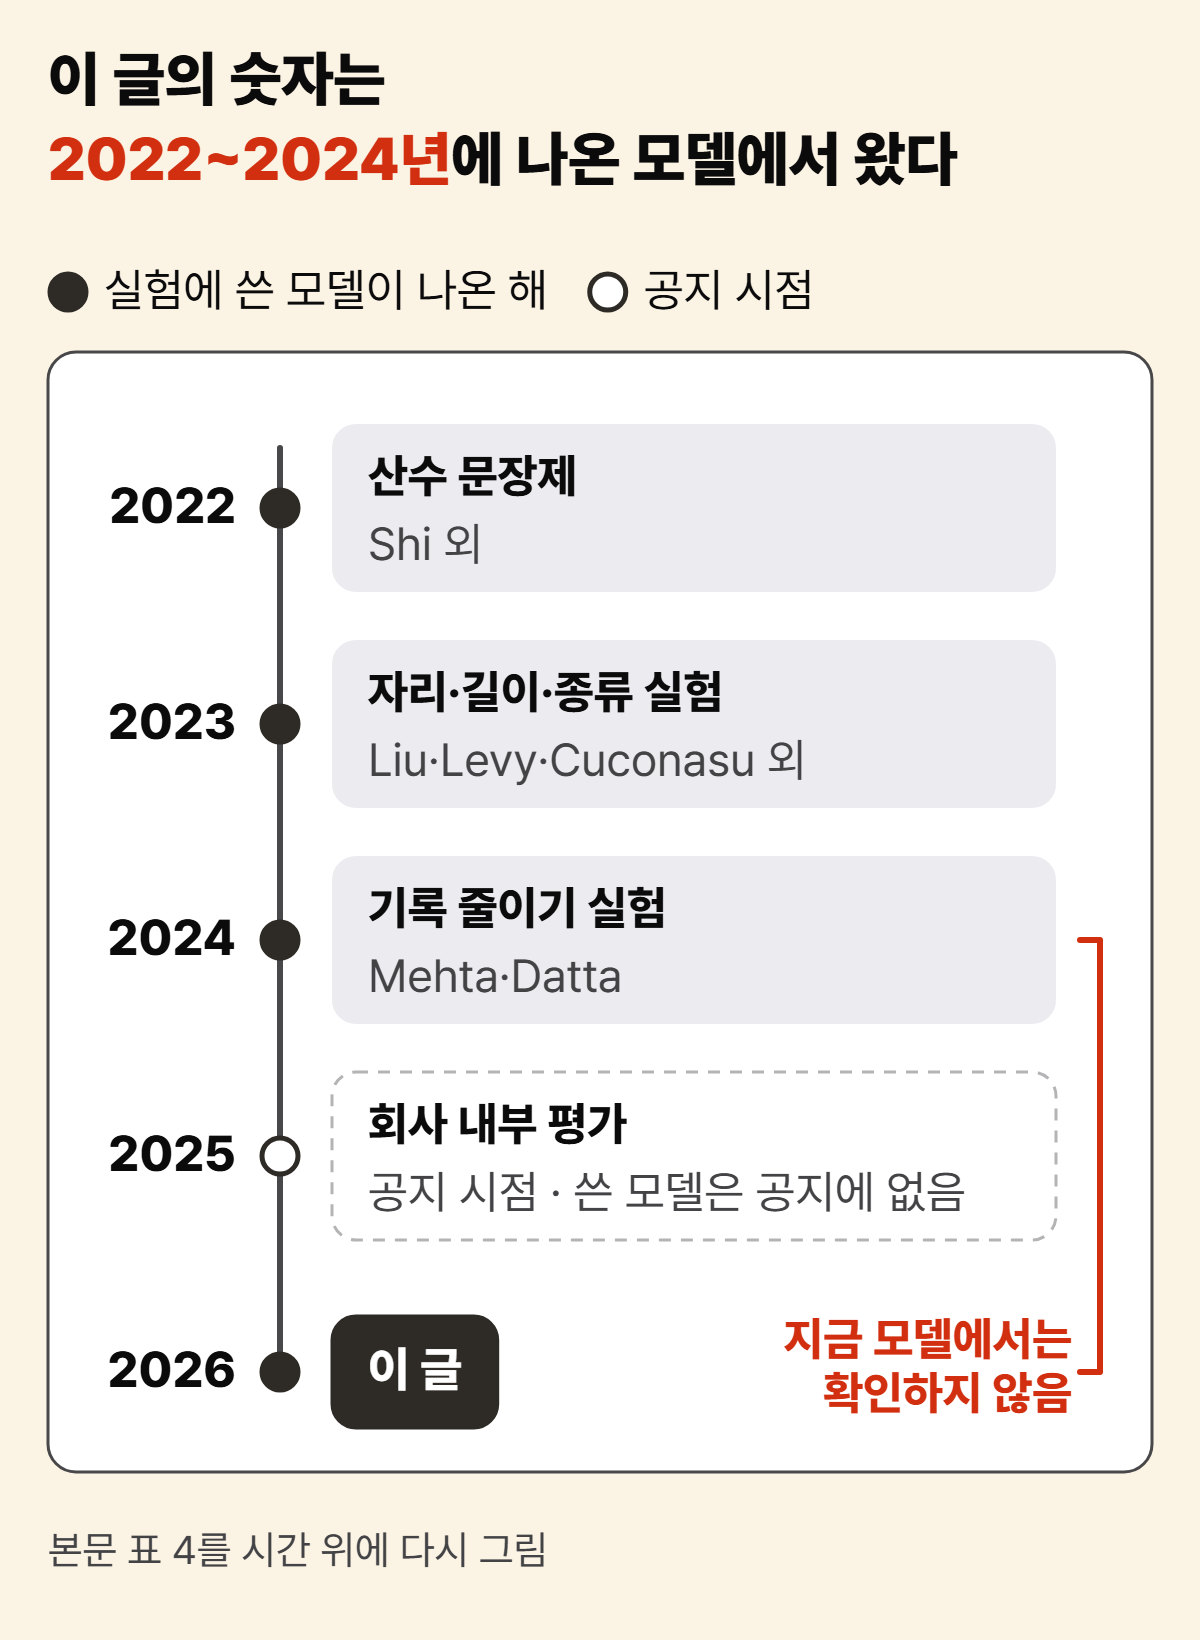
| 연구 | 모델(나온 해) | 과제 | 이 글에서 쓴 값 |
|---|---|---|---|
| Liu 외(TACL 2024) | GPT-3.5-Turbo·Claude-1.3 외(2023) | 위키백과 문단 20개로 질문에 답하기(약 4천 토큰) | U자 다섯 점 · 두 기준선 · 문서 20→50개 |
| Levy 외(ACL 2024) | GPT-4·GPT-3.5·Gemini Pro·Mistral Medium·Mixtral(2023) | 참/거짓 추론, 약 250~3천 토큰 | 평균 0.92 → 0.68 |
| Cuconasu 외(SIGIR 2024) | Llama2-7B·Falcon-7B·Phi-2·MPT-7B(2023, 입력 한도 2048~4096 토큰) | 검색 문서를 붙여 답하기 | −0.14 · 0.38 넘게(정답 문서를 넣은 설정) · +0.07(실제 검색 문서에 더한 한 구성 — 기준 설정이 다르다) |
| Shi 외(ICML 2023) | code-davinci-002·text-davinci-003(2022) | 산수 문장제 | 매번 맞힌 문제 18% 이하 |
| Mehta·Datta(2026 워크숍) | Llama-3.1-70B(2024) | 집안일 흉내 글 과제 30개, 방식마다 150번 | 56.7% → 22.0%(오래된 기록을 버린 쪽 · 서술적 결과) |
| Anthropic 공지(2025년 9월) | 공지에 없음(회사 내부 평가) | 에이전트 검색 · 100턴 웹 검색 평가(세부는 공지에 없음) | 29% · 39% · 84%(일반 효과로 쓰지 않음) |
본문 수치를 낸 연구 실험은 2022~2024년에 나온 모델로 했다. 옆 주석의 회사 평가와, 자주 묻는 질문에서 드는 프리프린트는 이 범위 밖이다. 지금 쓰는 모델에서 같은 크기로 나타나는지는 이 글이 확인하지 않았다.
길어질수록 흐려지는 이유로 Anthropic 엔지니어링 글은 설명 하나를 내놓는다. 모델 안에서 모든 토큰은 다른 모든 토큰과 관계를 맺는데, 입력이 길어질수록 그 관계가 엷어진다고 쓴다. 또 모델이 배운 학습 데이터에는 짧은 입력이 긴 입력보다 흔하다고 덧붙인다. 그래서 성능은 「낭떠러지가 아니라 기울기」로 떨어진다고 본다.
이것은 회사의 설명이고, 앞 절의 실험들이 이 원인을 잰 것은 아니다. U자 쪽의 원인도 아직 하나로 모이지 않았다. 그래서 이 글의 숫자는 그때 그 모델에서 정답률이 이 방향으로 움직였다는 기록으로 읽는 것이 맞다.
창이 커져도 고르는 일은 남는다
에이전트 연구를 정리한 2026년 리뷰 논문(Zhou 외)은 자체 실험 없이 남의 연구를 모아 정리한 글이다. 그래서 아래 문장들은 측정이 아니라 저자들의 논증이다. 저자들은 창이 2천 토큰에서 10만 토큰 넘게 늘어나는 동안에도 근본 긴장은 그대로 남았다고 쓴다.
more capacity does not eliminate the need for selective curation.
용량이 늘어도 골라 담을 필요는 사라지지 않는다.
Zhou 외, 「Externalization in LLM Agents」 §2.2 (arXiv:2604.08224 v1, 2026)같은 논문 §6.2.6은 창을 「어떤 에이전트 시스템에서든 가장 희소한 공유 자원」이라고 부른다. 이 창 하나를 여럿이 함께 쓴다는 말이다. 기억에서 찾아 온 것, 필요할 때 불러오는 작업 절차, 도구 설명, 모델 자신의 추론 흔적이 같은 토큰 예산을 두고 다툰다. 그래서 저자들은 창 예산 관리를 「압축만 떼어 푸는 문제가 아니라 동적 자원 배분 문제」라고 쓴다. 그림 14은 서로 다른 것들이 좁은 창 하나를 나눠 쓰는 모습을 그렸다.
Anthropic도 비슷한 전망을 적는다. 아마 당분간은, 적어도 가장 높은 성능을 원하는 경우라면 창의 크기와 상관없이 오염(쓸모없는 글이 섞여 창이 흐려지는 문제)과 관련성 문제가 남으리라고 본다. 다음 글들이 다룰 물음도 여기서 이어진다. 리뷰 논문 저자들은 기억에서 지나치게 많이 불러오면 창이 관련이 덜한 흔적으로 넘친다고 쓴다(over-retrieval floods the context with marginally relevant traces). 긴 입력이 더 나은 성능으로 곧장 이어지지 않으니, 자세한 지시도 지침이 아니라 잡음이 될 수 있다고도 쓴다. 저자들의 논증으로는, 창이 커지는 것과 무엇을 넣을지 고르는 일은 별개의 문제로 남는다.
자주 묻는 질문
컨텍스트 엔지니어링의 예를 들면?
Anthropic 공지가 직접 드는 예가 있다. 코딩에서는 오래된 파일 읽기와 테스트 결과를 지우고, 디버깅에서 얻은 단서와 설계 결정은 기억에 남긴다. 리서치에서는 오래된 검색 결과를 지우고 핵심 발견을 기억에 남긴다. 연재 1편에서 본, 파일 경로 같은 가벼운 표지만 들고 있다가 필요할 때 도구로 불러오는 방식도 같은 회사의 엔지니어링 글이 드는 예다.
중요한 지시는 맨 앞이나 맨 끝에 두면 되나?
2023년 모델 실험에서 앞과 끝에 둔 정답이 더 잘 쓰인 것은 맞다. 그러나 같은 연구에서 질문을 문서 앞뒤에 다시 둔 시험은 여러 문서로 답하는 과제의 흐름을 거의 바꾸지 못했다. 정답 문서가 맨 앞에 있을 때만 조금 올랐고, 나머지 자리에서는 조금 내렸다. 곡선의 깊이도 모델마다 달랐다. 자리를 옮기는 것은 시도해 볼 일이지 보장은 아니다.
상관없는 건 무시하라고 지시하면 되나?
산수 문장제 실험에서는 「문제 설명 속 상관없는 정보는 무시해도 된다」는 문장을 붙이자 성적이 나아졌다. 저자들은 모델이 「어느 정도(to some extent)」 무시하는 법을 배운다고 읽었다. 길이 실험에서는 생각의 사슬을 붙여 보았다. 짧은 입력의 성적은 올랐어도 길이로 생긴 하락은 메우지 못했고, 예외는 GPT-4 하나였다. 지시가 부담을 덜어 줄 수는 있지만, 무엇을 넣을지 고르는 일을 지시가 대신했다는 결과는 두 실험 어디에도 없다.
기록은 얼마나 세게 줄여야 하나?
요약과 지우기를 직접 비교한 결과는 이 글이 기댄 출처에 없다. 줄이는 세기에도 한 가지 답이 없다는 보고는 있다. 한 프리프린트(Yi 외, arXiv:2605.30785)는 주로 2025년에 나온 모델들로, 학습시킨 기록 관리자를 여러 기준 방식과 비교했다. 원래 잘하는 에이전트는 기록을 충실히 남길수록, 못하는 에이전트는 더 세게 줄일수록 나았다. Anthropic 문서는 요약이 잘 맞는 일도 따로 든다. 파일이나 보고서처럼 결과물이 대화 밖에 남는 일이다.
바로 손볼 수 있는 것과 에이전트 설정으로 정하는 것은?
쓰는 사람이 바로 고를 수 있는 것은 둘이다(글쓴이 종합). 하나는 붙여 넣을 문서로, 지금 옮기는 버전에 필요 없는 다른 버전 문서를 걸러 내고 넣는 것이 종류 절의 실험이 가리키는 방향이다. 다른 하나는 조건을 적는 자리인데, 앞 질문에서 본 한계가 그대로 따른다.
에이전트를 돌리는 쪽 설정으로 정하는 것은 Anthropic 문서가 적은 칸들이다. 지우기를 시작하는 한도, 지울 때 남길 최근 결과 수, 지우지 않을 도구를 정할 수 있다. 기억 도구를 함께 켰다면, 지우기 한도에 가까워질 때 경고를 받아 지워지기 전에 중요한 것을 기억 파일, 곧 창 밖에 적어 두는 파일에 옮길 수 있다. 앞에서 본 SDK 요약 방식에는 요약에 무엇을 남길지 지시하는 칸도 있다. 다만 이 칸은 문서가 폐기 예정이거나 이미 뺐다고 적은 그 SDK 설정에 딸려 있다. 기억은 다음 글에서 다룬다.
비우기나 검색을 늘리지 않아도 되는 때는?
한 번에 지울 양이 적으면 캐시를 깨는 값이 더 클 수 있다. 그래서 Anthropic 문서는 정해 둔 최소량을 지우지 못하면 아예 지우지 않게 하는 칸을 둔다. 찾아 오는 쪽에도 값이 든다. 리뷰 논문의 말로는 가져온 것 하나하나가 한정된 창 자리를 두고 다툰다. 앞의 길이 실험에서 보았듯, 입력이 길어지는 것 자체도 짐이었다. 검색과 도구 호출이 더하는 지연, 일하는 도중의 탐색이 미리 찾아 둔 자료를 꺼내 오는 것보다 느리다는 점은 연재 1편의 마지막 질문에서 다뤘다.
어긋난 세션은 어떤 순서로 확인하나
표 3의 줄은 그 턴에 모델이 받은 입력이 정하므로, 점검의 첫 단계도 그 입력을 찾는 일이다(글쓴이 종합). 아래 「지금 해 볼 것」은 효과를 잰 처방이 아니라 점검 제안이고, 「설정 쪽」은 에이전트를 돌리는 쪽의 일이다.
- 그 턴의 기록을 연다 — 어긋난 결과를 낸 요청에 실린 메시지와 도구 호출, 요약본, 그리고 응답의 편집 정보(지우기가 적용됐는지)를 찾는다.
- 받은 입력을 가늠할 수 있는지 본다 — 편집 정보도 요약본도 볼 수 없으면 판정 불가로 두고, 아래 단계는 후보로만 읽는다. 볼 수 있으면 아래 단계 가운데 기록이 가리키는 것으로 간다. 지금 해 볼 것: 조건과 사실을 새 요청에 다시 적어 다시 시켜 본다. 설정 쪽: 편집 정보가 남게 한다.
- 조건이 그 입력에 있었다면 (ㄱ) — 조건이 입력의 어디쯤에 있었는지, 그 뒤로 도구 결과가 얼마나 쌓였는지 본다. 지금 해 볼 것: 조건을 새 요청에 다시 적어 시킨다. 설정 쪽: 다 쓴 도구 결과 지우기.
- 없었고 기록이 요약으로 바뀌었다면 (ㄷ-1) — 요약본에 그 사실이 들었는지 본다. 지금 해 볼 것: 그 사실을 다시 적어 준다. 설정 쪽: 요약 방식 고르기(이른 세부를 정확히 떠올려야 하는 일이면 요약 말고 다른 방식).
- 없었고 지우기가 적용됐다면 (ㄷ-2) — 지운 개수로 보아 그 파일 결과가 지운 범위에 드는지, 그 사실이 남은 다른 메시지가 있는지, 그 뒤 그 파일을 다시 읽은 도구 호출이 있는지 본다. 지금 해 볼 것: 그 파일을 다시 읽힌다. 설정 쪽: 지우지 않을 도구, 기억 도구.
- 세션 처음부터 없었다면 — 사용자가 주지 않았는지, 검색이 못 찾았는지, 지난 세션에서 정한 것인지 본다. 마지막 경우만 다음 글의 기억 문제다.
- 옛 버전에만 있는 함수를 썼다면 (ㄴ) — 검색 결과 목록에 같은 주제의 다른 버전 문서가 함께 있었는지 본다. 지금 해 볼 것: 옛 버전 문서를 빼고 다시 시킨다.
- 문서를 더 붙였는데 그대로라면 — 붙인 문서 가운데 답이 든 것이 있는지, 몇 번째에 있었는지 본다. 지금 해 볼 것: 답이 든 문서만 남겨 다시 시킨다.
넣은 만큼 쓰이지는 않았다
첫머리의 열 번째 문서와 사례의 세 경우는 모두 창에 무엇이 어디에 실렸느냐는 물음으로 돌아온다. 스무 장 가운데 열 번째에 둔 정답도, (ㄱ)에서 어긴 조건도 창 안에 있었다. (ㄴ)에서는 옛 버전 문서가 새 버전 문서 곁에 섞여 있었다. (ㄷ)에서는 UTC를 확인한 사실이 요약본에 없거나((ㄷ-1)) 지워진 뒤 다시 읽히지 않아((ㄷ-2)), 모델이 받는 입력에서 빠져 있었다.
2023년 모델 실험에서는 창에 문서를 더 붙인 만큼 정답률이 따라 오르지 않았고, 무엇이 어디에 놓였느냐가 정답률을 바꿨다.
연재 「AI의 바깥을 설계하는 법」 8편 중 2편 — 다음 편은 에이전트가 어제 한 일을 어떻게 기억하는지를 다룬다.
더 읽기
- N. F. Liu 외, 「Lost in the Middle: How Language Models Use Long Contexts」, TACL 12:157–173 (2024) — https://arxiv.org/abs/2307.03172
- M. Levy, A. Jacoby, Y. Goldberg, 「Same Task, More Tokens: the Impact of Input Length on the Reasoning Performance of Large Language Models」, ACL 2024 — https://arxiv.org/abs/2402.14848
- F. Cuconasu 외, 「The Power of Noise: Redefining Retrieval for RAG Systems」, SIGIR 2024 — https://arxiv.org/abs/2401.14887
- F. Shi 외, 「Large Language Models Can Be Easily Distracted by Irrelevant Context」, ICML 2023 — https://arxiv.org/abs/2302.00093
- A. Mehta, A. Datta, 「Plans Fade Fast: Why Context Management Is Load-Bearing for LLM Agents」, arXiv:2606.22953 v2 (COLM 2026 Workshop on Context Beyond the Window) — https://arxiv.org/abs/2606.22953
- C. Zhou 외, 「Externalization in LLM Agents: A Unified Review of Memory, Skills, Protocols and Harness Engineering」, arXiv:2604.08224 v1 (2026) — https://arxiv.org/abs/2604.08224v1
- Anthropic, 「Context editing」, Claude Developer Platform 문서 (2026-10-27 확인) — https://platform.claude.com/docs/en/build-with-claude/context-editing
- Anthropic, 「Effective context engineering for AI agents」, Anthropic Engineering (2025-09-29) — https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- 관련 글: 프롬프트·컨텍스트·하네스 엔지니어링, 뭐가 다를까 — 연재 1편. 세 말이 고치는 자리를 나눴고, 이 글은 그 가운데 컨텍스트 자리 하나를 판다.
- 관련 글: 컨텍스트 창 100만 토큰 시대, RAG는 언제 이기고 언제 지는가 — 긴 창과 검색 파이프라인을 비용과 정확도로 비교한 글. 이 글은 한 창 안에 더 붙였을 때만 봤다.
- 관련 글: RAG 란 무엇인가: 답하기 전에 찾아 읽기 — 찾아 읽고 답하는 흐름을 다룬 글. 이 글은 그 흐름에 답 없는 문서가 끼어드는 자리를 봤다.
- 관련 글: 챗봇에 조건을 나눠 말하면 답이 나빠지는 이유 — 대화가 길어질 때 생기는 다른 하락, 조건을 여러 번에 나눠 말할 때를 다룬 글.