며칠째 가끔 실패하는 테스트의 원인을 코딩 에이전트와 쫓다가, 아침이 되면 「어제 하던 거 이어서 해 줘」라고 적는다. 모델 쪽에서 보면 이 호출도 처음이다. 그래도 일이 이어지는 것은 어제의 상태가 모델 바깥에 적혀 있다가 다시 들어오기 때문이다. 일이 어제와 어긋나면, 그 기록을 적고 정리하고 꺼내는 세 단계 가운데 어디서 틀어졌는지부터 본다. 지난 상태를 모델 바깥에 적어 두었다가 골라서 다시 보여 주는 이 장치를 에이전트 메모리(agent memory)라고 부른다.
기억 장치를 만든 연구팀이 스스로 잰 실험에서, 질문에 가장 많이 맞게 답한 쪽은 그 기억 장치가 아니었다. 대화를 고르지 않고 통째로 모델에 넣은 방식이었고, 그 대화는 모델의 창에 다 들어가는 길이였다. 가장 많이 담은 쪽이 가장 잘 맞혔으니, 담는 양으로는 기억 장치가 이길 수 없다. 기억 장치의 일은 다른 데 있고, 그 일은 하루를 넘겨 이어 가는 작업에서 드러난다.
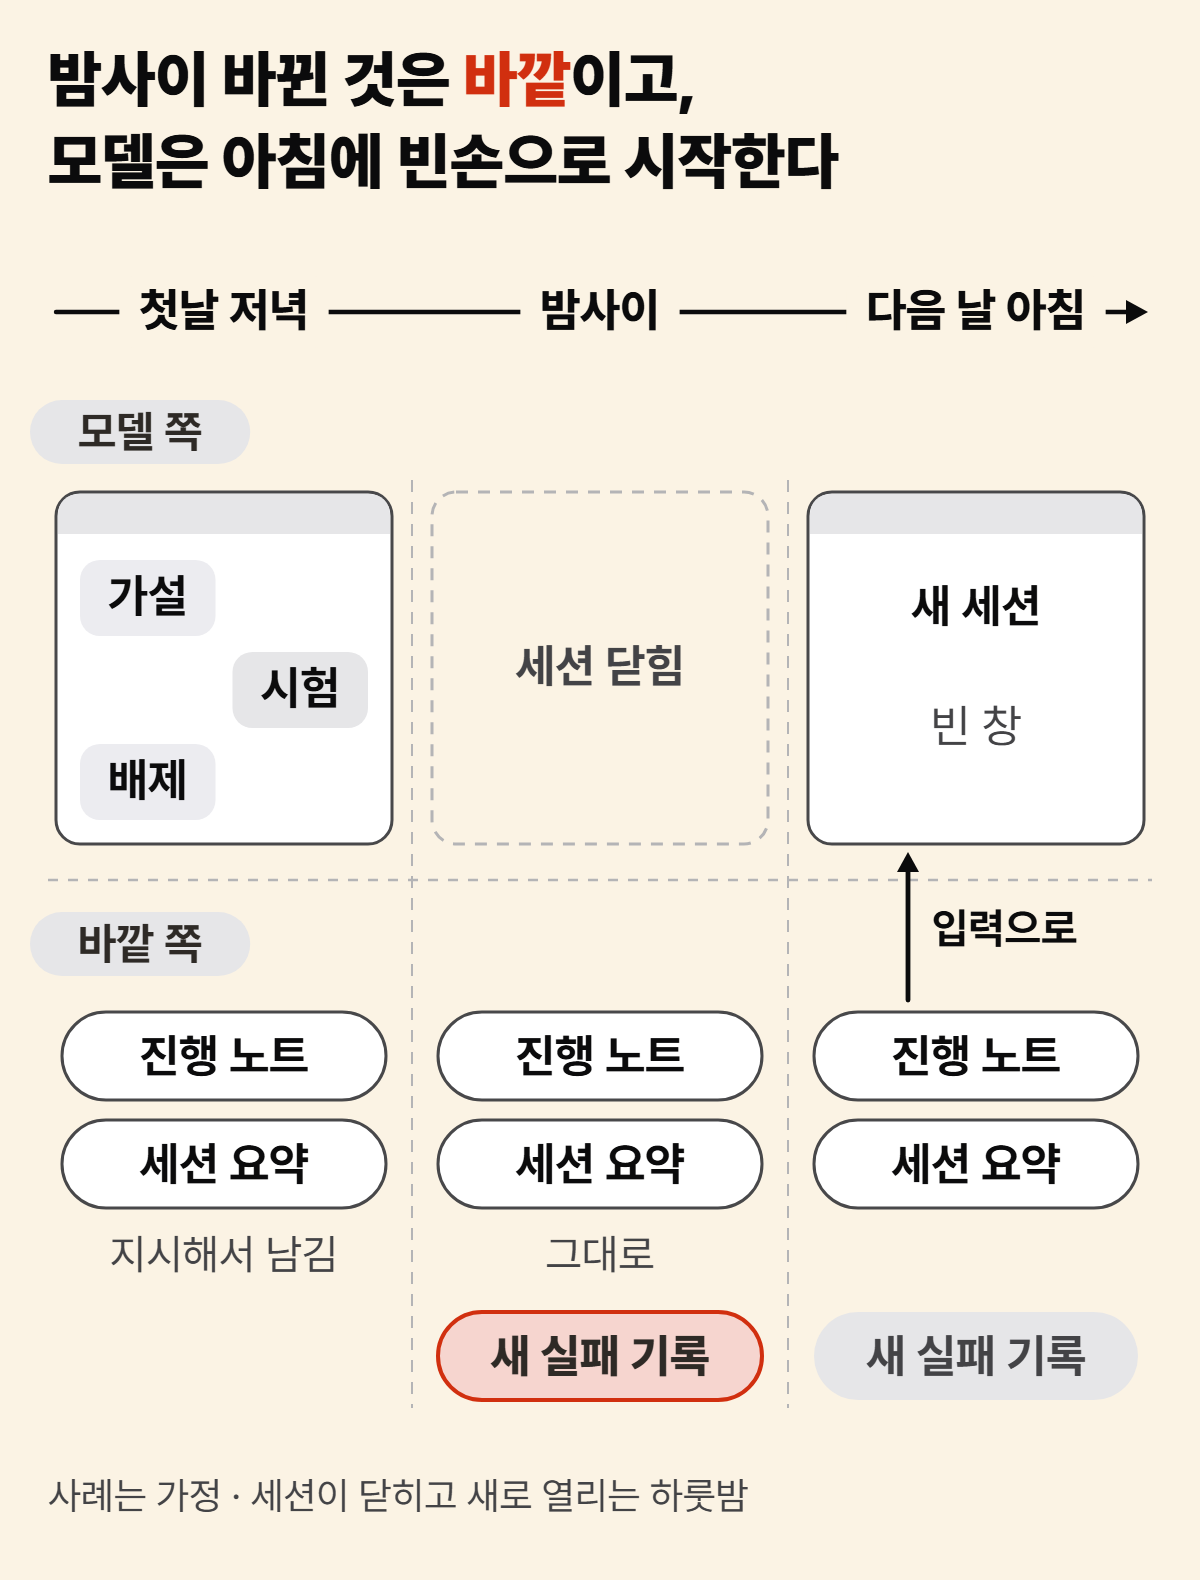
이런 상황을 가정해 보자. CI에서 가끔만 실패하는 테스트 하나의 원인을 코딩 에이전트와 며칠째 쫓고 있다. 첫날 에이전트는 가설 몇 개를 세웠고, 그중 일부는 시험해서 배제했다. 세션을 닫기 전에는 에이전트에게 진행 노트와 세션 요약을 남기게 했고, 다음 날 새 세션을 열면 그 노트와 요약이 입력에 함께 들어가게 설정해 두었다. CI의 실패 기록은 작업 공간에 쌓인다. 아침에 새 세션에서 「어제 하던 거 이어서 해 줘」 한 줄을 보내면 일은 이어지는데, 이어 간 아침들을 돌아보면 이런 어긋남이 끼어 있다.
- (ㄱ) 어제 노트에는 「실패 기록: 지금 있는 것까지 다 봤다」고 적혀 있다. 밤사이 CI에서 테스트가 다시 실패해 새 실패 기록이 생겼는데, 에이전트는 그것을 열어 보지 않고 어제 본 기록만으로 다음 가설을 세운다.
- (ㄴ) 어제 같은 순서로 여러 번 돌려 보고 배제한 가설 「테스트가 도는 순서 탓」을, 오늘 다시 세워 같은 시험을 한다.
- (ㄷ) 어제 대화 기록을 통째로 붙여 넣은 날, 그 안에 「실패 기록들의 공통점은 정리해 두었다」는 줄과 그 정리가 있었는데도 실패 기록을 처음부터 다시 모은다.
- (ㄹ) 어제 재실행이 통과하자 에이전트가 노트에 「네트워크 쪽 문제는 아니다」라고 적었다. 오늘은 그 줄을 근거로 네트워크 쪽 가설을 건너뛰는데, 같은 조건으로 다시 확인해 보니 그쪽을 배제할 근거가 없었다.
(ㄴ)과 (ㄹ)은 방향이 반대다. 확인한 배제가 잊히면 같은 시험을 되풀이하고, 확인하지 않은 배제가 굳으면 그 길을 다시 보지 않는다. 테스트가 왜 가끔 실패하는지는 이 사례에서 끝까지 풀리지 않은 채로 둔다. 지켜볼 것은 어제 알아낸 것, 곧 세운 가설과 배제한 가설이 다음 날 아침으로 넘어오는 길이다. 그림 1은 이 사례의 하룻밤을 모델 쪽과 바깥 쪽으로 나눠 그린 것이다.
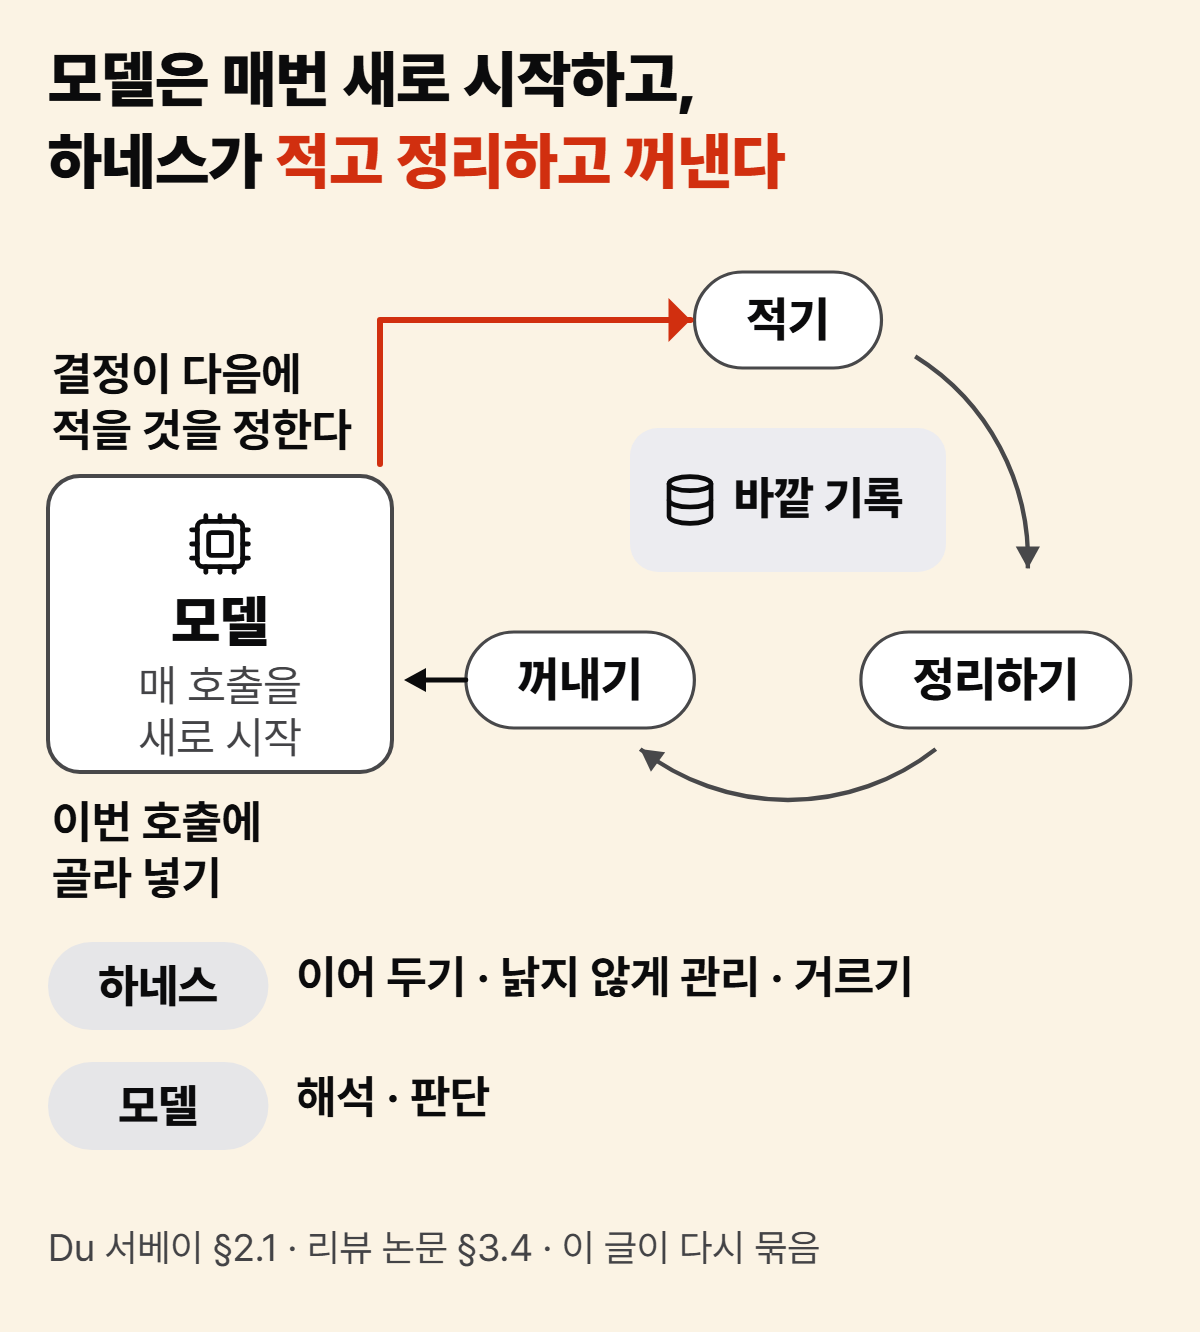
AI 에이전트는 어제 한 일을 어떻게 기억할까? 모델은 어제를 떠올리지 않는다. 하네스가 어제의 상태를 모델 밖에 적어 두고, 쌓인 기록을 정리해, 오늘 이번 호출에 필요한 조각을 골라 다시 보여 준다. 어제 저녁의 노트 한 줄도 이 세 단계를 거쳐 오늘 아침 입력에 들어온다.
에이전트 메모리는 적고, 정리하고, 꺼낸다
먼저, 모델은 무상태(stateless)다. 매 호출은 아무것도 이어받지 않은 새 컨텍스트에서 시작한다. AI 에이전트의 바깥 구조를 정리한 2026년의 한 리뷰 논문(Zhou 외)은 그래서 이어짐을 들고 오는 것이 아니라 다시 지어야 한다고 쓴다. 짧은 대화에서는 지금까지 오간 말을 함께 보내면 되므로 이 한계가 프롬프트 안에 숨는다. 오래 걸리는 작업에서는 이것이 구조의 문제가 된다. 사례로 말하면, 첫날 저녁 세션에서 세운 가설과 배제 목록을 다음 날 아침 첫 호출이 저절로 이어받지는 않는다.
같은 논문은 기억의 본질을 「시간을 넘는 에이전트의 상태를 그때그때의 컨텍스트에서 떼어 내는 일」로 본다. 일의 나눔도 적는다. 하네스는 상태를 이어 두기, 낡지 않게 관리하기, 관련 있는 것을 거르기를 맡고, 해석과 판단은 모델에게 남긴다. 기억을 모델 자체에 학습시켜 넣는 방식도 있지만, 리뷰 논문은 빨리 바뀌는 상태를 그렇게 자꾸 다시 학습시키면 이전에 익힌 것을 잃을 위험이 있다고 본다. 이 글은 바깥에 적어 두는 쪽을 다루고, 학습시키는 쪽은 자주 묻는 질문에서 짧게 본다.
바깥 기록을 다루는 일은 세 단계로 나눌 수 있다. 에이전트 기억 서베이를 따로 쓴 Du는 기억을 적기·정리하기·꺼내기가 한 고리로 도는 것(write–manage–read)으로 정리한다. 우리말 이름은 이 글이 붙였다. Du의 설명에서 기억에 적고 정리하는 일은 뒤에 덧붙이기만 하는 연산이 아니다. 잘 설계된 시스템이라면 요약하고, 중복을 없애고, 우선순위를 매기고, 모순을 풀고, 필요하면 지운다.
Du는 또 에이전트의 결정이 무엇을 적을지 정하고, 적힌 것이 다음 결정을 정한다고 쓴다. 그래서 한 번 잘못 적으면 여러 단계 뒤까지 저장소를 오염시킬 수 있다. 사례의 (ㄹ)이 이 되먹임과 이어진다. 리뷰 논문도 기억 구조가 더 큰 저장소로만 커진 것이 아니라, 무엇을 적고·올리고·꺼내고·줄이고·잊을지 정하는 규칙을 더 분명히 하는 쪽으로 움직였다고 본다. 사례에서는 첫날 저녁 에이전트가 남긴 진행 노트가 적기이고, 다음 날 아침 그 노트가 새 세션 입력에 들어가는 것이 꺼내기다. 그 사이에 노트를 고치고 합치는 정리하기는 누가 언제 할지 따로 정해야 한다.
이 연재 1편 프롬프트·컨텍스트·하네스 엔지니어링, 뭐가 다를까는 기억을 하네스가 담는 칸 하나로 두고, 노트가 세션 경계를 건너 다시 읽힌다는 데까지 봤다. 여기서는 그 노트에 무엇을 어떤 모양으로 적고, 언제 고치고, 오늘 무엇을 골라 넣는지를 본다. 그림 2은 세 단계가 한 고리로 도는 모습과, 하네스와 모델이 나눠 맡는 일을 함께 그린 것이다. 이어지는 표 1은 세 단계를 정의만으로 나란히 놓았다.
| 단계 | 무엇을 묻나 | 하네스가 손대는 것(출처의 예) | 출처 |
|---|---|---|---|
| 적기 | 어제의 무엇을, 어떤 모양으로 남기나 | 기록의 역할을 넷으로 갈라 담기, 잡음 거르기·표기 맞추기·중복 합치기·우선순위·꼬리표(시각·출처·작업 이름·확신도) | 리뷰 §3.1 · Du §7.1 |
| 정리하기 | 쌓인 기록을 언제 줄이고 합치고 고치고 지우나 | 요약·중복 제거·모순 해소·삭제, 새 기록 앞세우기·출처 순위·모순 찾기·주기적 정리 | Du §2.1 · §7.3 |
| 꺼내기 | 이번 호출에 무엇을 골라 넣나 | 꺼낼지 말지 가르기·기억과 지금 작업 사이 토큰 나누기·자주 쓰는 기록 캐시, 작업 공간의 지금 모습과 최근 행동 | Du §7.2 · 리뷰 §3.3 |
세 단계로 묶은 것은 Du의 틀이고, 칸 채움은 이 글이 두 출처를 다시 묶은 것이다(글쓴이 종합). 어제를 잇는 일이 이렇게 세 단계로 나뉘면, 일이 어제와 어긋날 때 먼저 살펴볼 곳도 이 세 단계다. 다만 기록이 맞게 들어갔는데도 판단이 틀리는 경우가 있고, 그때는 기억 밖을 봐야 한다.
요약을 한 줄로 줄이면 배제한 가설이 빠진다
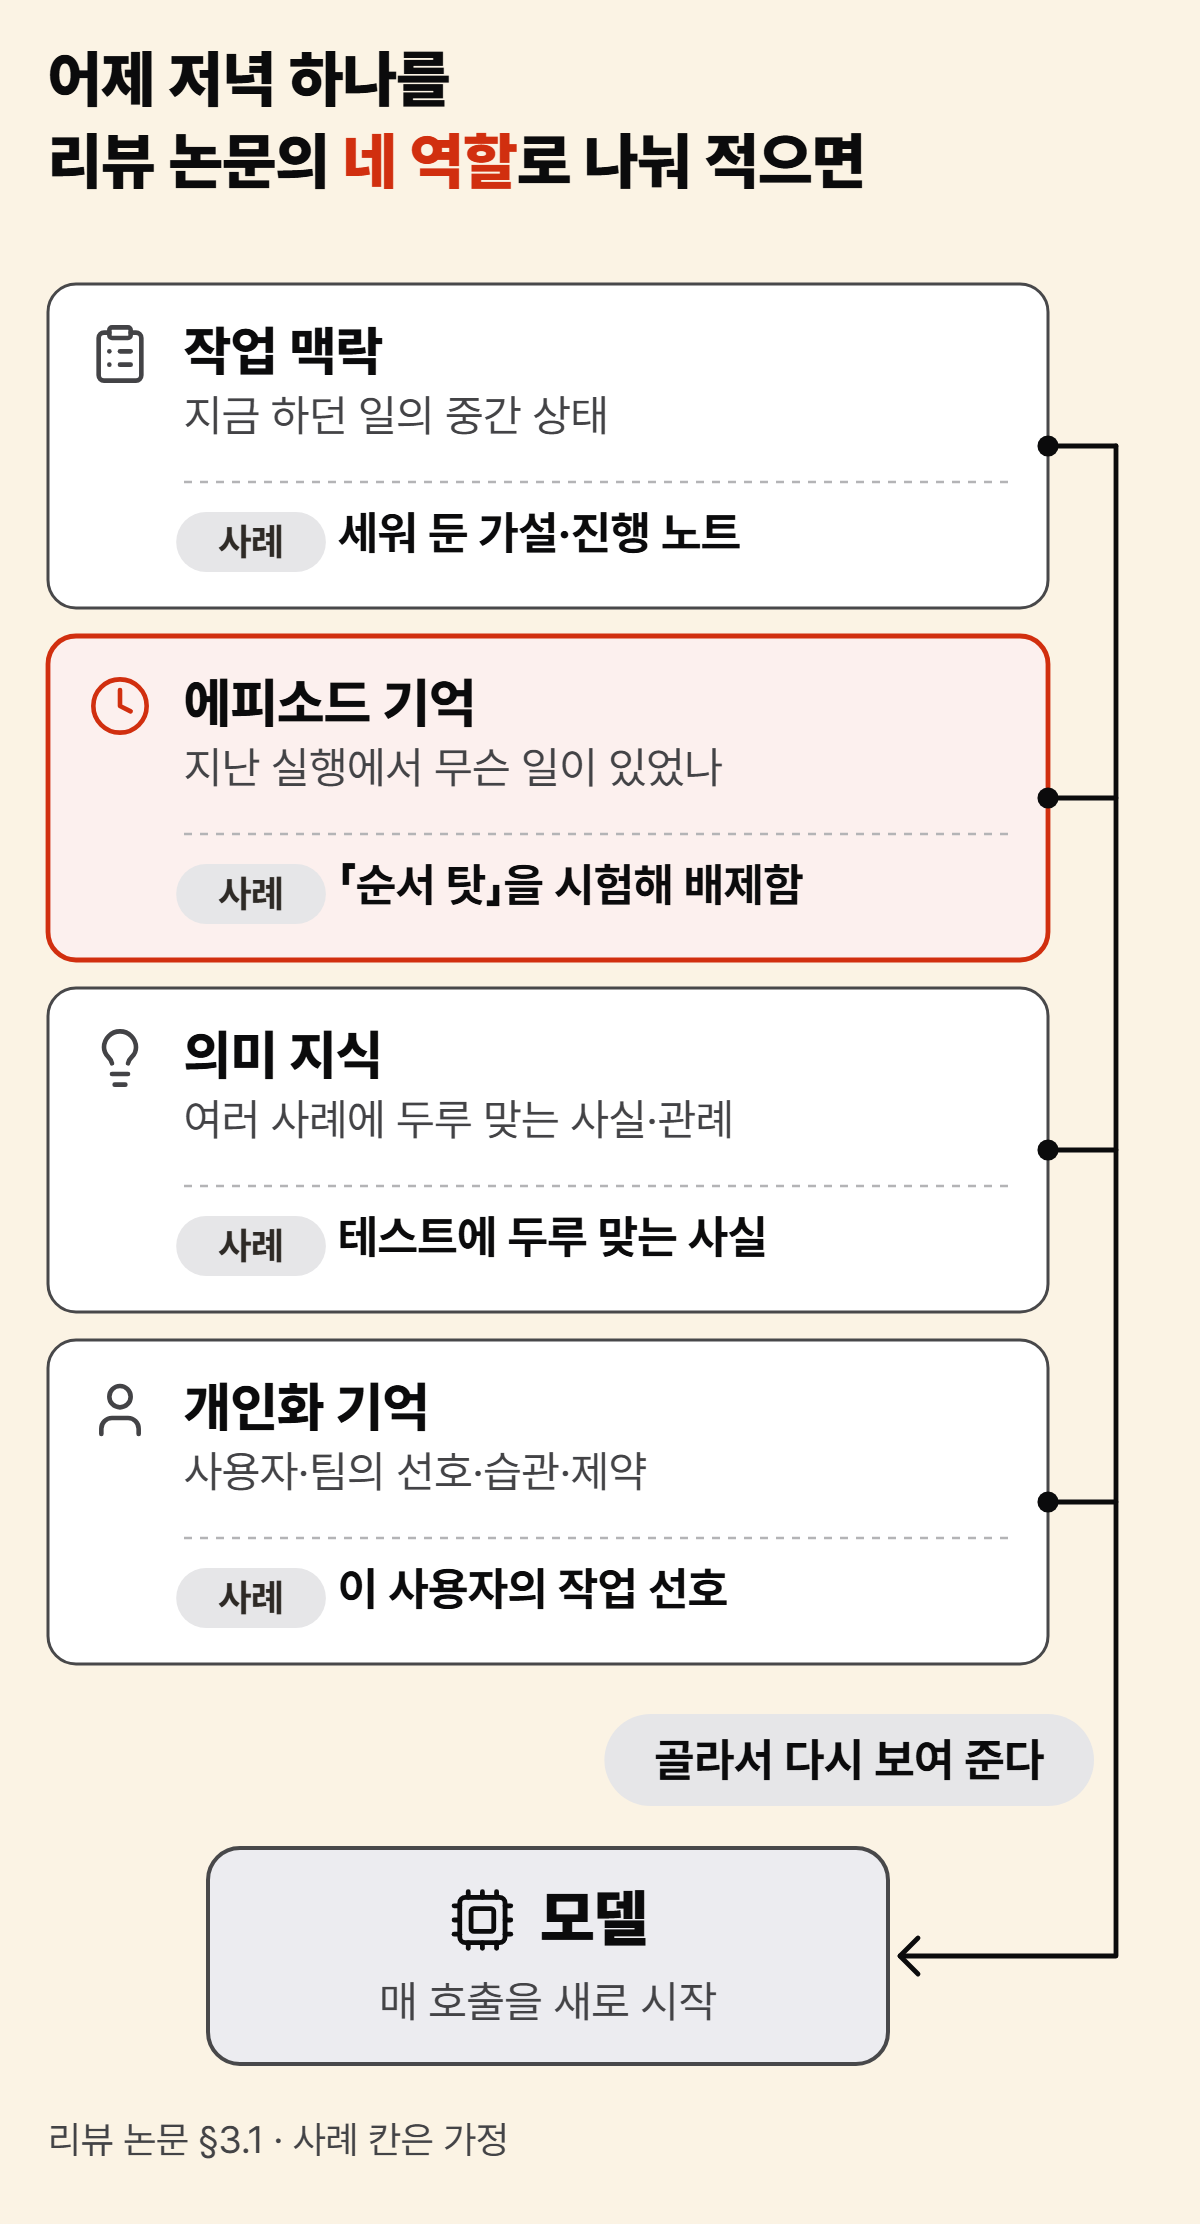
적기에서 먼저 정할 것은 무엇을 적느냐다. 리뷰 논문은 사람 기억의 고전적인 분류에서 영감을 얻어 LLM 에이전트에 맞게 고친 틀로, 바깥에 두는 상태를 넷으로 나눈다. 저자들은 넷을 다르게 다뤄야 한다고 쓰고, 넷이 전부는 아니라고도 밝힌다.
- 작업 맥락 — 지금 하던 일의 중간 상태다. 원문은 열린 파일, 임시 값, 세워 둔 가설, 중간 계획, 실행 체크포인트를 든다. 이 사례에서는 지금 세워 둔 가설과 진행 노트가 여기에 든다. 빨리 바뀌어서 (ㄱ)의 「다 봤다」 줄처럼 금방 낡고, 낡으면 쓸모를 잃는다.
- 에피소드 기억(episodic memory) — 언제 어디서 한 번 겪은 일의 기억으로, 지난 실행에서 무슨 일이 있었는지를 남긴다. 결정, 도구 호출, 실패, 결과, 반성이 여기에 든다. 사례에서는 같은 순서로 여러 번 돌려 보고 「순서 탓」 가설을 배제한 일이다. 논문은 다시 꺼낸 에피소드가 알려진 실수를 되풀이하지 않게 돕는다고 쓴다. 한 연구는 실패한 시도를 돌아본 반성문을 남겨 다음 시도에서 다시 읽게 했고, 남겨 두는 반성문은 보통 1~3개였다.
- 의미 지식 — 한 사례가 아니라 여러 사례에 두루 맞는 사실·요령·프로젝트 관례다. 논문은 지식 베이스와 RAG 말뭉치를 지금 가장 흔한 형태로 든다. 사례에서는 이 프로젝트 테스트에 두루 맞는 사실이 여기에 든다.
- 개인화 기억 — 이 사용자나 팀의 선호, 습관, 되풀이되는 제약이다. 논문은 이 기록을 에이전트가 스스로 나아지려고 쌓는 일반 저장소와 한데 합치지 말라고 쓴다. 보존·검색·프라이버시 규칙이 다르기 때문이다. Du도 기억 설계가 지킬 목표로 프라이버시, 삭제 요청, 조직 정책을 든다.
넷은 저장 장소의 목록이라기보다 기록이 맡는 역할의 구분으로 읽는 편이 쓸모 있다. 한 노트 안에서 칸이나 꼬리표로 나눠 적어도 된다(글쓴이 종합). 그림 3은 사례의 어제 저녁을 네 역할에 나눠 적어 본 것이다.
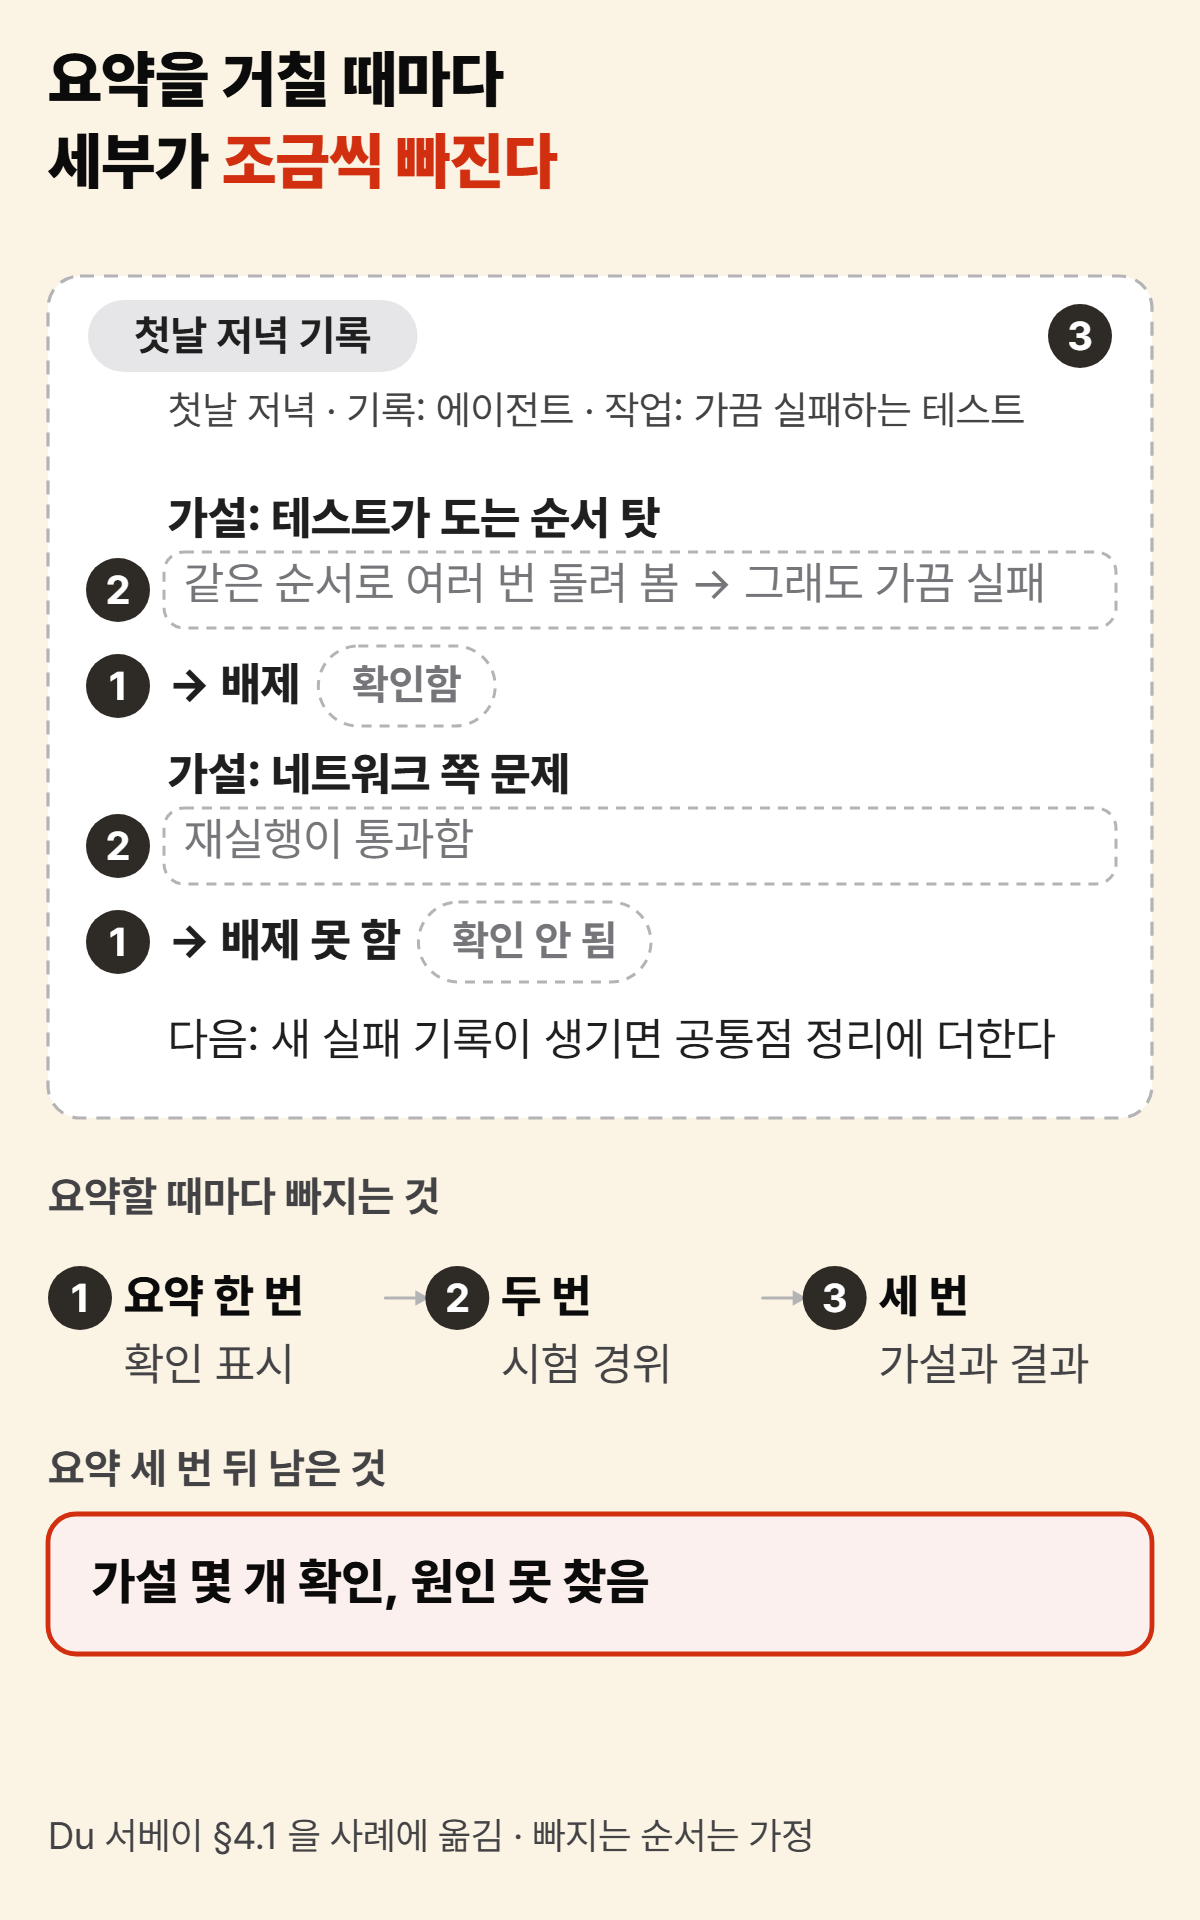
다음은 어떤 모양으로 적느냐다. Du는 모든 대화를 그대로 다 적는 방식이 끌리지만 거의 언제나 틀렸다고 쓴다. 대신 쓸모가 낮은 기록을 걸러 내고, 이름·날짜·수량 표기를 맞추고, 겹치는 기록을 합치고, 우선순위를 매기고, 시각·출처·작업 이름·확신도 같은 꼬리표를 단다. 줄이는 데는 대가가 따른다. Du는 압축을 강하게 걸면 효율은 오르지만, 3주 뒤에 결정적으로 드러날 드문 사실 하나를 조용히 버린다고 쓴다. 이 사례에서 첫날 저녁 기록이 두 모양으로 남았다고 해 보자(가정이며, 칸 이름은 Du의 꼬리표와 리뷰 논문의 에피소드 항목에서 가져왔다).
가설 몇 개 확인, 원인 못 찾음
[첫날 저녁 · 기록: 에이전트 · 작업: 가끔 실패하는 테스트]
가설: 테스트가 도는 순서 탓 → 같은 순서로 여러 번 돌려 봄 → 그래도 가끔 실패 → 배제(확인함)
가설: 네트워크 쪽 문제 → 재실행이 통과함 → 배제 못 함(확인 안 됨)
다음: 새 실패 기록이 생기면 공통점 정리에 더한다
첫째는 진행 상황 한 줄이다. 둘째는 시각·출처·작업 이름 꼬리표를 달고, 가설마다 시험과 결과와 확인 여부를 남겼다. 둘째 기록의 두 가설 줄은 결과가 다르다. 「순서 탓」은 시험으로 확인해 배제했고, 「네트워크 쪽」은 재실행이 한 번 통과했지만 배제하지는 못했다. 사례의 노트에는 이 둘째 줄이 「네트워크 쪽 문제는 아니다」로 적혔다. 확인하지 않은 것을 결론으로 적은 셈이다.
(ㄴ)은 그날 아침 무엇이 남아 있었느냐를 보면 사정이 둘이다. (ㄴ-1)은 노트든 세션 요약이든 남은 것이 첫째 모양의 한 줄뿐인 경우다. 원래 대화 기록도 없으니, 오늘의 에이전트에게 「순서 탓」의 배제는 없었던 일이다. 진행 상황 한 줄 말고는, 무엇을 시험해 무엇을 배제했는지가 남을 자리가 없었다. 리뷰 논문은 지금 결정에 필요한 세부를 잃은 기억을 「지나치게 줄인 기억」으로 분류한다.
(ㄴ-2)는 배제 경위가 적힌 원래 기록이 저장소에 남았는데도 그 기록이 오늘 입력까지 오지 못한 경우로, 꺼내기에서 다시 본다. 여기서 볼 것은 (ㄴ-1)을 만드는 적는 순간의 손질이다. 그림 4은 그 손질에 배제했다는 조각이 함께 잘려 나가는 모습이다. 적을 때 줄이는 손이 오늘 쓸 세부까지 버리면, 다음 날 에이전트는 그 세부가 있었다는 것도 모른다.
기록이 쌓이면 낡은 줄과 틀린 줄이 섞인다
(ㄱ)의 노트 줄 「지금 있는 것까지 다 봤다」는 적을 때는 맞았다. 밤사이 새 실패 기록이 생기면서 그 줄이 낡았다. Du는 오래 쌓인 저장소에는 낡은 기록이 쌓이고, 따로 장치가 없으면 에이전트가 옛 기록과 새 기록을 가르지 못한다고 쓴다. 그래서 갖춰야 할 장치로 넷을 든다. 새 기록을 앞세우기, 출처에 순위를 두기(사용자의 말이 에이전트의 추론보다 앞선다), 모순을 찾아 표시하기, 주기적으로 중복을 합치고 낡은 줄을 거두기다.
한 기억 서비스는 새 사실이 들어올 때마다 모델에게 넷 가운데 하나를 고르게 한다. 추가, 보강, 삭제(새 정보와 모순되는 기억), 그대로 두기다. Du는 겪은 일의 기록을 오래 가는 사실로 굳히는 정리가 저절로 되는 일은 드물고, 지금 시스템 대부분은 명시적 지시나 규칙으로 정한 계기가 있어야 한다고 쓴다. 그래서 이런 정리를 누가 언제 하느냐는 설계가 정한다. 그림 5는 「다 봤다」가 참이던 때와 지금 사이에 새 기록이 들어온 순간이다.
(ㄴ-1)에는 정리하기 쪽 경로도 있다. Du는 요약을 거듭할 때마다 드문 세부가 조용히 빠지고, 여러 번 거치면 에이전트가 다듬어지고 일반적인 모습의 과거만 「기억하게」 된다고 쓴다. 이 경로는 한 세션 안에서 창을 비우며 하던 요약(연재 2편)이 세션을 넘어서도 거듭되는 경우다. 첫날 저녁 기록이 요약을 몇 번 거치며 「가설 몇 개 확인, 원인 못 찾음」만 남았다고 하자. 그 요약이 원래 기록을 대신하면서 원래 기록을 지웠다면, 남은 것이 요약 한 줄뿐인 (ㄴ-1)이 된다. 그림 6은 앞의 둘째 기록에서 요약을 거칠 때마다 세부가 조금씩 빠지는 모습이고, 빠지는 순서는 그림이 가정한 것이다.
(ㄹ)은 사정이 다르다. 오늘 작업 기록을 보면 에이전트는 노트의 「네트워크 쪽」 줄을 근거로 그쪽 가설을 건너뛴다. Du는 앞의 반성문처럼 지난 실행을 돌아보고 적어 둔 결론의 기억, 곧 반성 기억의 핵심 위험으로 스스로 굳는 오류를 든다. Du가 드는 예는 「API X는 이 인자를 주면 늘 오류를 낸다」는 틀린 결론이다. 이렇게 결론 내린 에이전트는 그 길을 계속 피해 다니느라, 그 믿음을 뒤집을 증거를 끝내 모으지 못한다.
작업 공간 파일을 기록으로 삼은 한 연구도 한계를 다룬 절에서, 모델이 틀린 중간 결론을 내리면 그것이 지속되는 상태에 적혀 뒤 단계로 퍼질 수 있다고 적었다. 저자들이 밝힌 가능성이고, 잰 결과는 아니다. 앞의 둘째 기록에 적힌 「배제 못 함(확인 안 됨)」과 사례 노트의 「네트워크 쪽 문제는 아니다」는 같은 사실을 다르게 적은 것이다. 앞쪽은 확인한 것과 짐작한 것을 기록에서 가르고, 뒤쪽은 둘을 섞는다.
Du는 낡았거나 지어낸 기억을 꺼내는 것이 아무것도 꺼내지 않는 것보다 나쁠 수 있다고 쓴다. 기억을 쓰지 말라는 말은 아니다. 꺼낸 줄이 지금과 맞는지 가리는 일까지 정리하기에 넣어야 한다는 말로 읽는다.
에이전트가 쓴 줄이라고 틀린 것은 아니다. 출처 표시는 무엇부터 의심할지를 정하는 데 쓰인다. 그림 2에서 결정이 다시 적기로 돌아오는 화살표가 이 길이고, 어제 적힌 결론은 그 화살표를 타고 오늘 결정의 근거로 돌아온다. 그래서 정리하기는 저장소를 줄이는 일만이 아니다. 기록과 지금이 어긋나는 자리를 찾아내는 일도 정리하기에 든다.
넘치게 넣으면 묻히고, 잘못 고르면 놓친다
장치를 따로 두지 않고 꺼내는 방법은 어제 기록을 통째로 넣는 것이다. (ㄷ)의 아침이 그랬다. 리뷰 논문은 지난 기록 전부, 또는 그 요약을 프롬프트에 그대로 두는 방식이 투명하고 시험 삼아 만들기 쉬우며, 짧은 일에서는 꽤 잘 된다고 쓴다. 하지만 용량이 잘 늘지 않고, 요약은 거듭될수록 어긋나며, 모델은 기록을 나르는 데와 지금 단계를 푸는 데 한정된 토큰을 함께 써야 한다. 이 리뷰는 기록이 너무 많아 프롬프트를 잡음으로 덮는 기억을 「덜 줄인 기억」으로 분류한다.
다만 (ㄷ)에는 후보가 둘이다. 「공통점은 정리해 두었다」는 줄이 잡음에 묻혔을 수도 있고, 줄은 맞게 들어갔는데 판단이 틀렸을 수도 있다. 어느 쪽인지 좁히는 방법은 점검 목록에서 본다. 통째로 넣는 쪽이 늘 불리한 것도 아니다. 창에 다 들어가는 길이에서는 오히려 더 잘 맞힌 실험이 있고, 뒤에서 그 숫자를 본다.
(ㄴ-2)는 반대쪽 방법에서 생긴다. 가까운 작업 상태만 창에 두고, 긴 기록은 바깥 저장소에 두었다가 필요할 때 꺼내는 방식이다. 리뷰 논문은 이 방식이 용량 문제를 풀지만 기억의 질을 찾기의 문제로 바꾼다고 쓴다. 틀린 기록이 올라오면 모델이 흐트러지고, 맞는 기록을 놓치면 시스템은 아예 기억하지 못한 것처럼 움직인다. (ㄴ-2)에서는 배제 경위가 적힌 원래 기록이 저장소에 있었는데도 오늘 입력까지 오지 못했다.
Du는 꺼내기에도 손볼 곳이 여럿이라고 쓴다. 모든 단계에 꺼낼 필요는 없으니 꺼낼지 말지를 가르고, 기억과 지금 작업 사이에 토큰을 나누고, 사용자 선호처럼 자주 쓰는 기록은 캐시에 둔다. 그래서 (ㄴ-2)는 찾기 하나의 문제로 끝나지 않는다. 꺼내기를 했는지, 찾은 결과에 그 기록이 있었는지, 입력을 짤 때 빠졌는지가 모두 후보다. 그림 7은 원래 기록이 오늘 입력까지 오는 길의 세 갈림목이다.
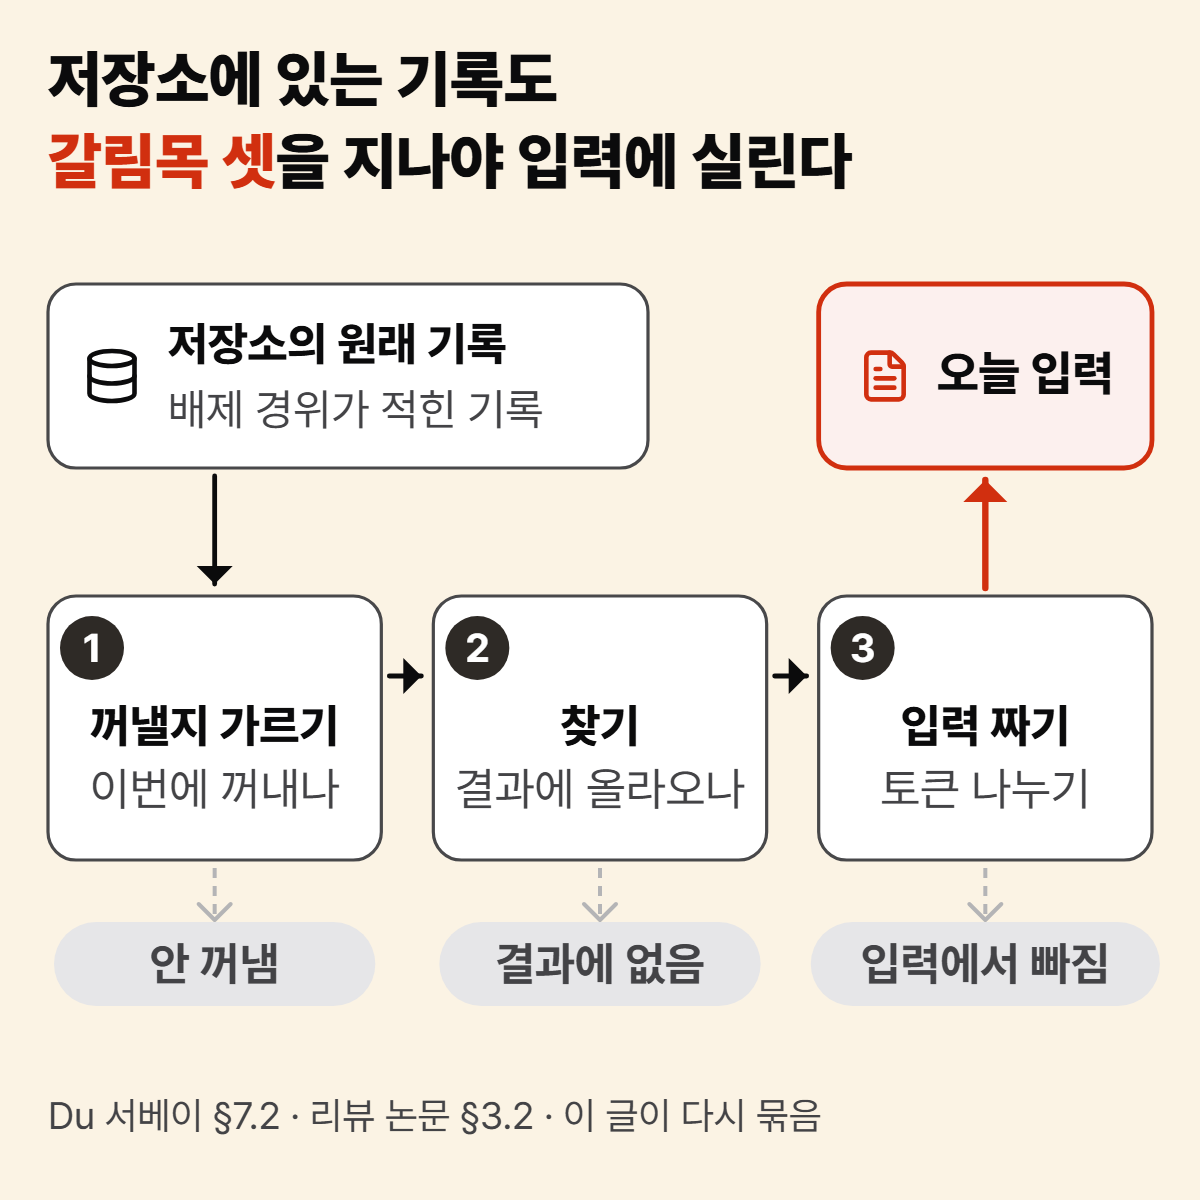
Du는 기록을 너무 깊이 묻어 두면 결정적 사실이 저장소 어딘가에 있다는 것조차 에이전트가 모르게 된다고 쓴다. 이런 실패는 대개 오류 메시지 없이 조용하다고 덧붙인다. 그림 8이 그 모습이다.
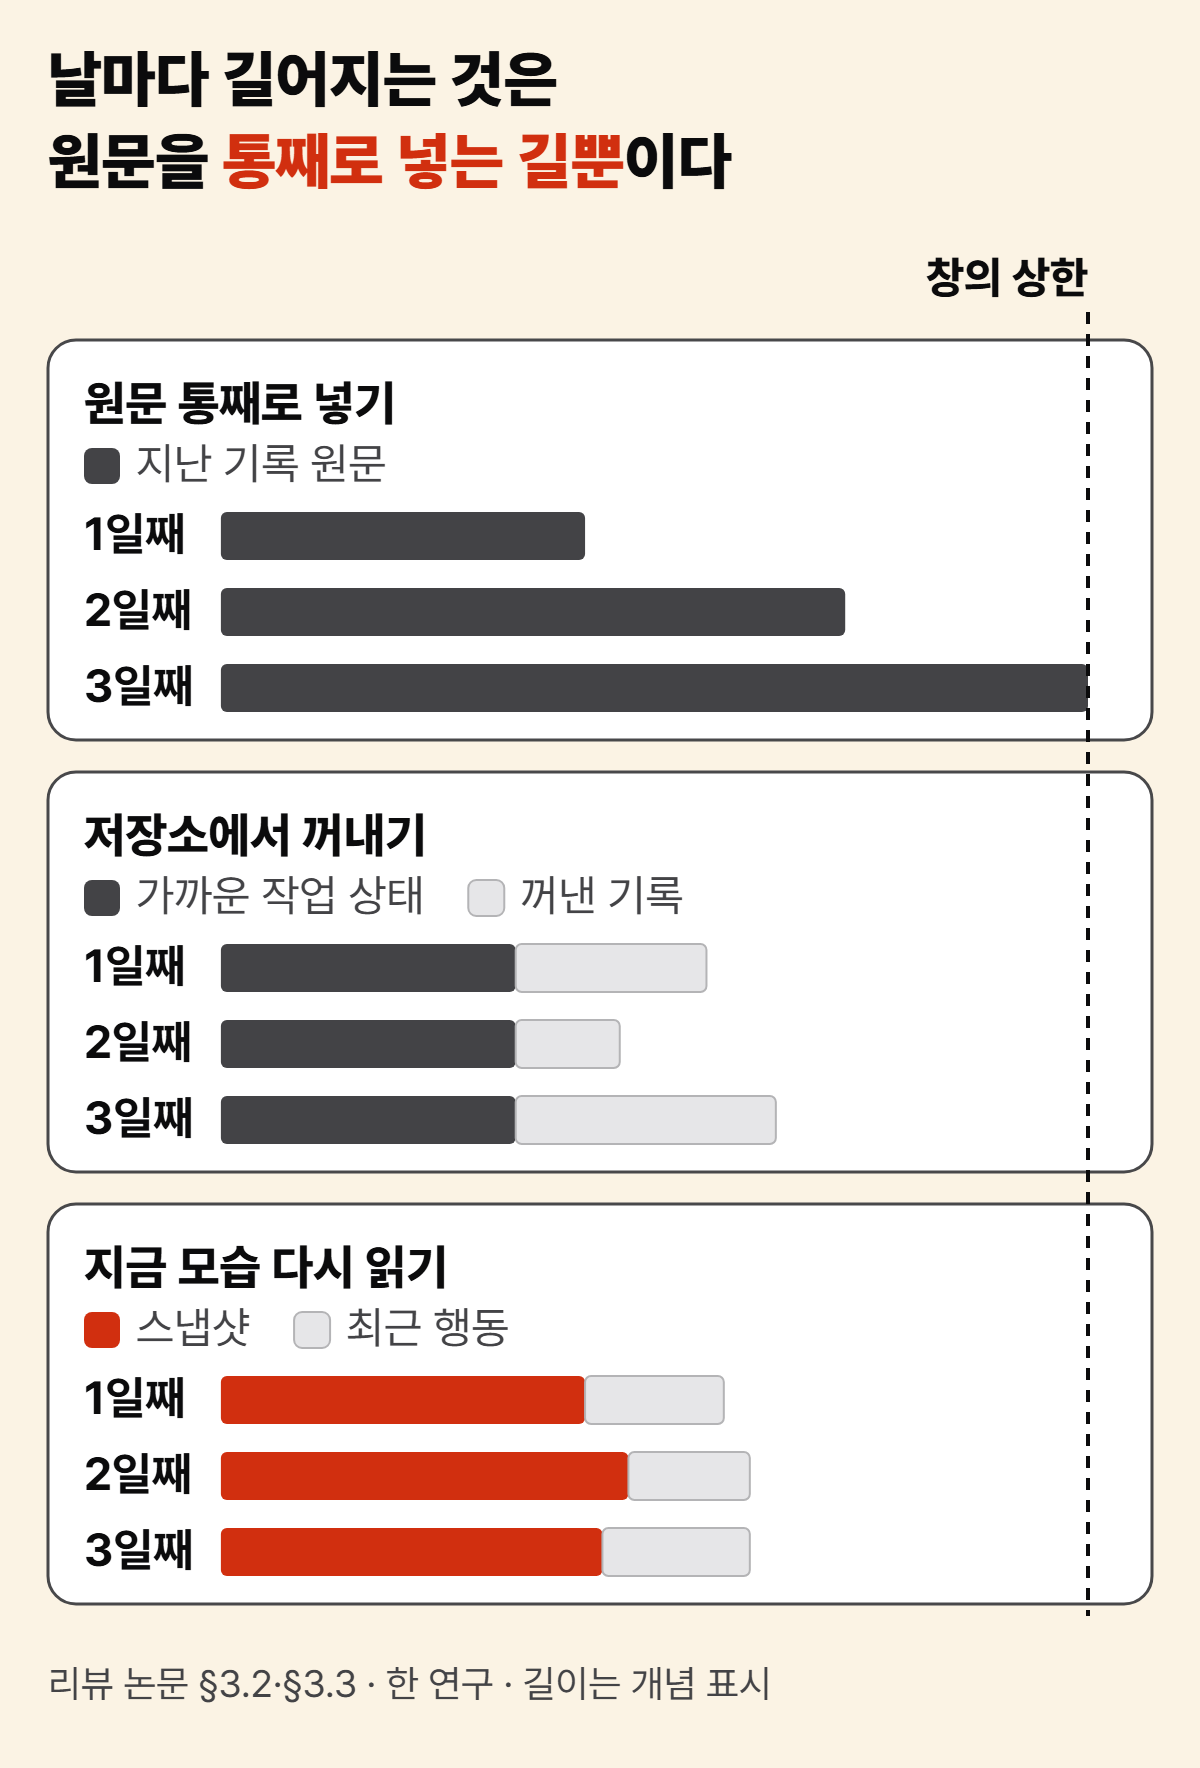
(ㄱ)에는 셋째 길이 있다. 노트만 읽지 않고, 새 실패 기록이 쌓이는 작업 공간의 지금 모습과 최근 행동 몇 개로 이번 입력을 짓는 설계다. 이 설계는 뒤의 심화 절에서 자세히 본다. 그림 9는 오늘 입력을 짓는 세 길을 날짜별로 나란히 놓은 것이다.
「많이 넣을수록 헷갈린다」는 이 연재 2편 컨텍스트 엔지니어링, 많이 넣을수록 헷갈리는 이유가 한 창 안에서 본 현상이다. 그 바탕은 2023년 모델에 문서 질의응답과 추론 과제를 시킨 실험들이다. 이 글 첫머리의 「통째로 넣은 쪽이 더 맞혔다」는 창에 다 들어가는 대화로 한 실험이라 조건이 다르다. 이 글이 묻는 것은 세션을 넘겨 남긴 기록 가운데 무엇을 꺼내 그 창에 넣느냐다. 표 2는 지금까지 본 다섯 경우를 행에, 세 단계를 열에 놓고 단계마다 할 일을 적은 것이다.
| 사례의 어긋남 | 적을 때 손대는 것 | 정리할 때 손대는 것 | 꺼낼 때 손대는 것 |
|---|---|---|---|
| (ㄱ) 이미 바뀐 것을 옛 모습대로 다룬다 | 노트 줄마다 언제, 무엇을 보고 적었는지 꼬리표 | 새 기록을 앞세우고, 노트와 작업 공간(실패 기록 목록)이 어긋나면 표시 | 노트만 읽지 않고 작업 공간의 지금 모습을 다시 읽는다 |
| (ㄴ-1) 남은 것이 요약 한 줄뿐이다 | 시험한 가설과 결과를 지난 실행의 기록으로 남긴다 | 요약이 원래 기록을 대신하며 지우지 않게, 거듭 요약할 때 드문 세부가 빠지지 않게 | —(꺼낼 기록이 남지 않았다) |
| (ㄴ-2) 원래 기록이 오늘 입력까지 오지 못한다 | 나중에 찾을 수 있게 작업 이름 꼬리표 | 너무 깊이 묻어 두지 않는다 | 꺼내기 경로(꺼낼지 가르기·찾기·입력 짜기) |
| (ㄷ) 입력에 있던 한 줄을 지나친다 | 대화를 그대로 다 적지 않고 잡음을 거른다 | 겹치는 기록을 합친다 | 다 넣기보다 이번 일에 맞는 것을 고르고, 기억과 지금 작업 사이에 토큰을 나눈다 |
| (ㄹ) 어제 에이전트가 스스로 적은 결론을 사실로 삼는다 | 사용자의 말인지 에이전트의 추론인지, 확인했는지를 함께 적는다 | 새 증거와 어긋나면 고치거나 지운다 | 출처와 확신도를 함께 넣어 추론이 사실처럼 읽히지 않게 한다 |
표 2는 출처의 원칙을 이 사례에 옮긴 것이다(글쓴이 종합). (ㄷ)의 꺼내기 칸은 함께 넣은 기록이 잡음이 될 만큼 많을 때의 이야기다. 줄을 가로로 읽으면 어느 경우든 할 일이 두 단계 이상에 걸쳐 있다. 그래서 노트 문면 하나만 고쳐 두면, 같은 어긋남이 다음 날 아침 정리나 꺼내기 쪽에서 다시 날 수 있다.
증거를 보면 먼저 열어 볼 단계가 갈린다
어제를 엉뚱하게 이어 간 아침에 어느 단계부터 열어 볼지는, 기록에 무엇이 남았는지가 정한다. 표 3의 재료는 두 출처에서 왔다. 리뷰 논문이 인용 없이 저자들 스스로 나눈 기억 실패 넷과, Du가 틀린 답이 나오는 자리로 든 넷이다. 이 글은 둘을 독자가 먼저 보게 되는 증상 순서로 다시 줄 세웠다(글쓴이 종합).
| 증상 | 확인할 증거 | 먼저 볼 단계 | 근거 |
|---|---|---|---|
| (ㄱ) 이미 바뀐 것을 옛 모습대로 다룬다 | 입력에 들어간 노트 줄과 지금 작업 공간(실패 기록 목록)이 어긋나고, 새 기록을 연 흔적이 없다 | 정리하기(옛 줄이 남았나) → 꺼내기(지금 모습을 읽었나). 열어 보고도 그랬다면 맨 아래 줄 | 낡은 기억(리뷰 §3.4) · Du §7.3 |
| (ㄴ-1) 남은 것이 요약 한 줄뿐이다 — 배제한 가설을 다시 시험한다 | 요약 한 줄 말고는 무엇을 시험해 왜 배제했는지 적힌 곳이 없고, 원래 대화 기록도 남지 않았다 | 적기(남겼나). 요약 전 기록이 있었다면 정리하기(요약이 지웠나) | 지나치게 줄인 기억(§3.4) · Du 쓰기·압축 |
| (ㄴ-2) 원래 기록이 오늘 입력까지 오지 못한다 — 배제한 가설을 다시 시험한다 | 저장소를 찾으면 배제 경위가 적힌 원래 기록이 나오는데, 오늘 모델이 받은 입력에서는 보이지 않는다 | 꺼내기(어느 갈림목에서 빠졌나) | 리뷰 §3.2 · Du §7.2·§7.7 |
| (ㄷ) 입력에 있던 한 줄을 지나친다 | 그 줄이 이번 입력에 있었다 | 꺼내기(함께 들어온 기록이 잡음이 됐나) 또는 맨 아래 줄. 관련 기록만 남겨 다시 돌려 보면 어느 쪽인지 좁혀진다 | 덜 줄인 기억(§3.4) · Du §7.7 진단·재실행 |
| (ㄹ) 어제 에이전트가 스스로 적은 결론을 사실로 삼는다 | 작업 기록이 그 줄을 근거로 들었고, 그 줄의 출처가 에이전트의 추론이며, 같은 조건으로 다시 확인한 결과와 어긋난다 | 적기(출처·확인 여부를 남겼나) → 정리하기(어긋남을 찾았나) | 틀리거나 어긋난 기억(§3.4) · Du 스스로 굳는 오류 · 한 연구의 한계 절 |
| (기억 밖) 필요한 기록이 맞게, 알맞은 양으로 들어갔는데 틀린 행동을 했다 | 입력의 기록이 맞고 넘치지 않는다 | 기억 밖 — 지시문·실행 루프 쪽 | Du 「맞게 꺼낸 내용 위의 모델 추론」 |
표 3에서 (ㄱ)과 (ㄹ)의 셋째 칸은 두 단계를 화살표로 잇는다. 앞 단계의 기록에서 어긋남이 보이지 않을 때 뒤 단계를 연다는 순서로 읽으면 된다. 기억 장치 바깥을 가리키는 맨 아래 줄로 넘어가는 자리는 따로 있지 않고, (ㄱ)과 (ㄷ)의 칸 안에 적혀 있다.
짐작보다 먼저 할 일은 두 시점의 기록을 나란히 놓는 것이다. Du는 일부 팀의 경험이라며, 두 대화 턴 사이에 저장소에서 무엇이 바뀌었는지 보여 주는 단순한 「기억 차이」가 기존 로그 분석보다 진단에 더 쓸모 있었다고 전한다. 그림 10는 어젯밤과 오늘 아침 기록에서 다른 한 줄을 찾는 모습이다.
저장소가 커지면 무엇을 남길지가 규칙이 된다
리뷰 논문은 Du의 분류를 따라 지금의 기억 구조를 넷으로 읽는다. 모든 기록을 한 컨텍스트에 두는 방식, 바깥 검색 저장소를 붙인 방식, 층을 나눈 계층 방식, 검색 전략 같은 것을 경험에 맞춰 바꾸는 적응형 방식이다. 저자들의 한 줄 요약은 이렇다. 한 컨텍스트는 기억이 있게 하고, 검색 저장소는 용량을, 계층은 정리를 풀며, 적응형은 규칙을 풀기 시작한다.
계층 방식의 한 예가 MemGPT다. MemGPT는 운영체제가 모자란 메모리를 디스크와 번갈아 쓰는 방식을 빌린 기억 구조다. 창 안에는 시스템 지시, 고정 크기의 작업 맥락 칸, 메시지 줄이 있고, 작업 맥락 칸에는 함수 호출로만 적는다. 이 구조에서는 세 손이 하는 일이 다르다.
첫째, 관리 장치는 메시지가 들어오고 답이 나올 때마다 둘 다 바깥의 대화 기록에 자동으로 남긴다. 둘째, 창이 일정 수준까지 차면 관리 장치가 경고 메시지를 넣는다. 그러면 모델은 함수 호출로 중요한 내용을 작업 맥락 칸이나 별도 보관소에 옮겨 적을 기회를 얻는다. 원문은 기억을 고치고 꺼내는 일을 「전적으로 모델이 스스로 정한다」고 쓴다. 셋째, 창이 꽉 차면 관리 장치가 오래된 메시지를 창에서 밀어내고 요약을 새로 쓴다. 밀려난 메시지는 이미 대화 기록에 있어서, 모델이 함수 호출로 다시 찾을 수 있다.
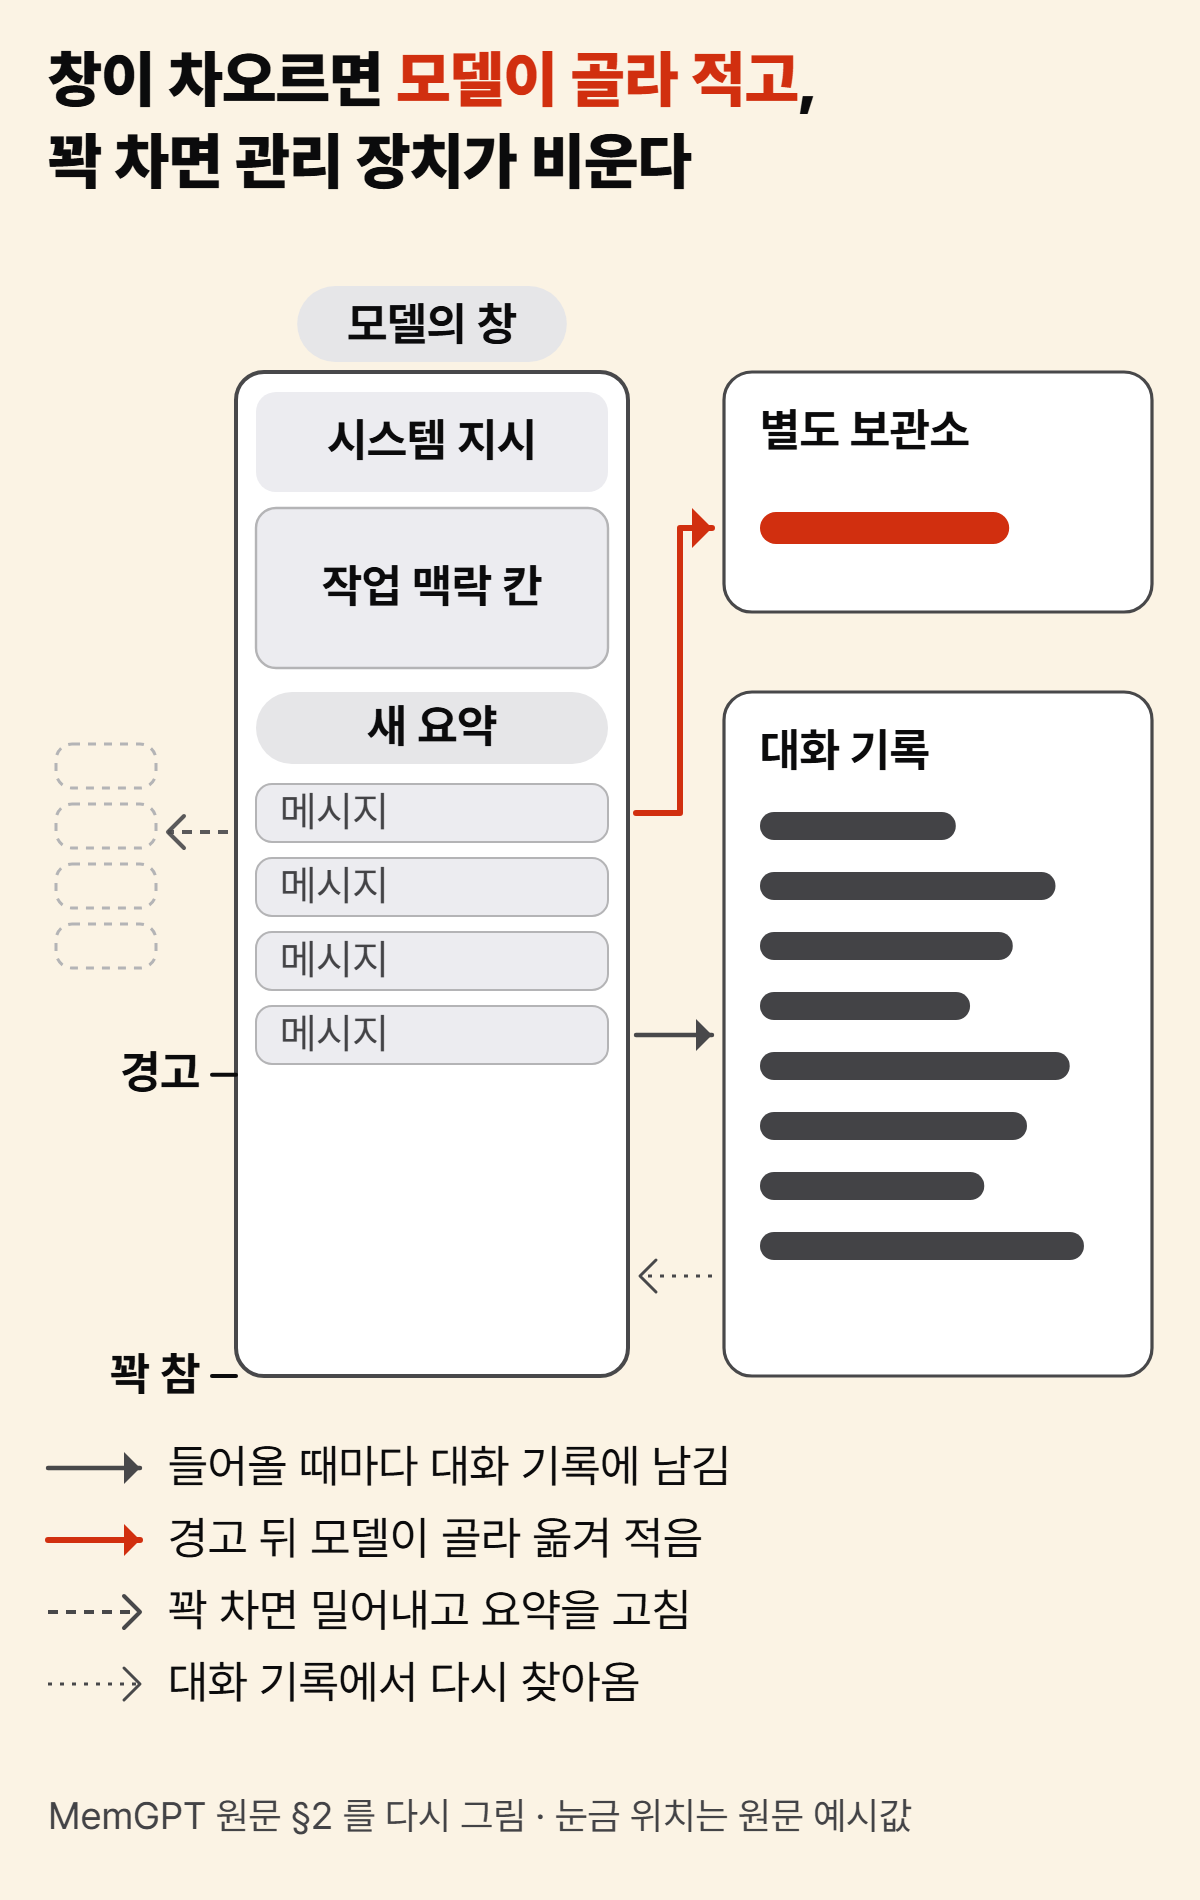
그림 11는 한 창 안팎에서 갈리는 이 세 손을 그렸다. 이 구조에서는 무엇을 남길지 정하는 자리가 생겼고, 그 결정의 일부를 모델이 진다. Du의 분류에서 이런 계층 방식은 학습했거나 프롬프트로 지시한 관리 장치가 여러 층을 다루는 방식이고, MemGPT가 그 예다. 다만 Du는 검색 저장소를 붙인 방식부터 시작해 잘 계측하고, 계층 방식으로는 그 관리 장치가 실제 작업을 낫게 한다는 것을 데이터가 보여 줄 때만 옮기라고 권한다.
작업이 길어지면 창을 파일에서 다시 짓는 설계가 있다
리뷰 논문은 하네스 환경에서는 기억 시스템이 상태와 컨텍스트를 분명히 갈라 두어야 한다고 본다. 한 연구는 이 생각을 작업 공간의 파일로 밀고 간다. 작업마다 폴더를 하나 두고 계획, 중간 산출물, 도구 출력, 검증 기록을 쌓는다. 이 폴더는 세션을 넘어 남고, 연구진은 파일 시스템을 에이전트의 행동·환경·중간 산출물에 대한 「권위 있고 지속되는 기록」으로 삼는다.
이 설계는 정해진 간격으로 폴더 안의 계획과 진행 표시를 갱신한다. 그렇게 갱신한 작업 공간의 모습, 곧 스냅샷과 최근 행동 몇 개(원문의 예는 10개)로 매 단계 컨텍스트를 새로 짓는다. 그래서 작업이 길어져 파일이 늘어도, 한 번에 읽는 양의 상한은 작업 길이와 상관없이 묶인다. 스냅샷에 무엇을 고르는지의 세부 규칙은 원문이 자세히 밝히지 않는다. 그림 12는 스냅샷이 무엇으로 지어지는지를 그렸다.
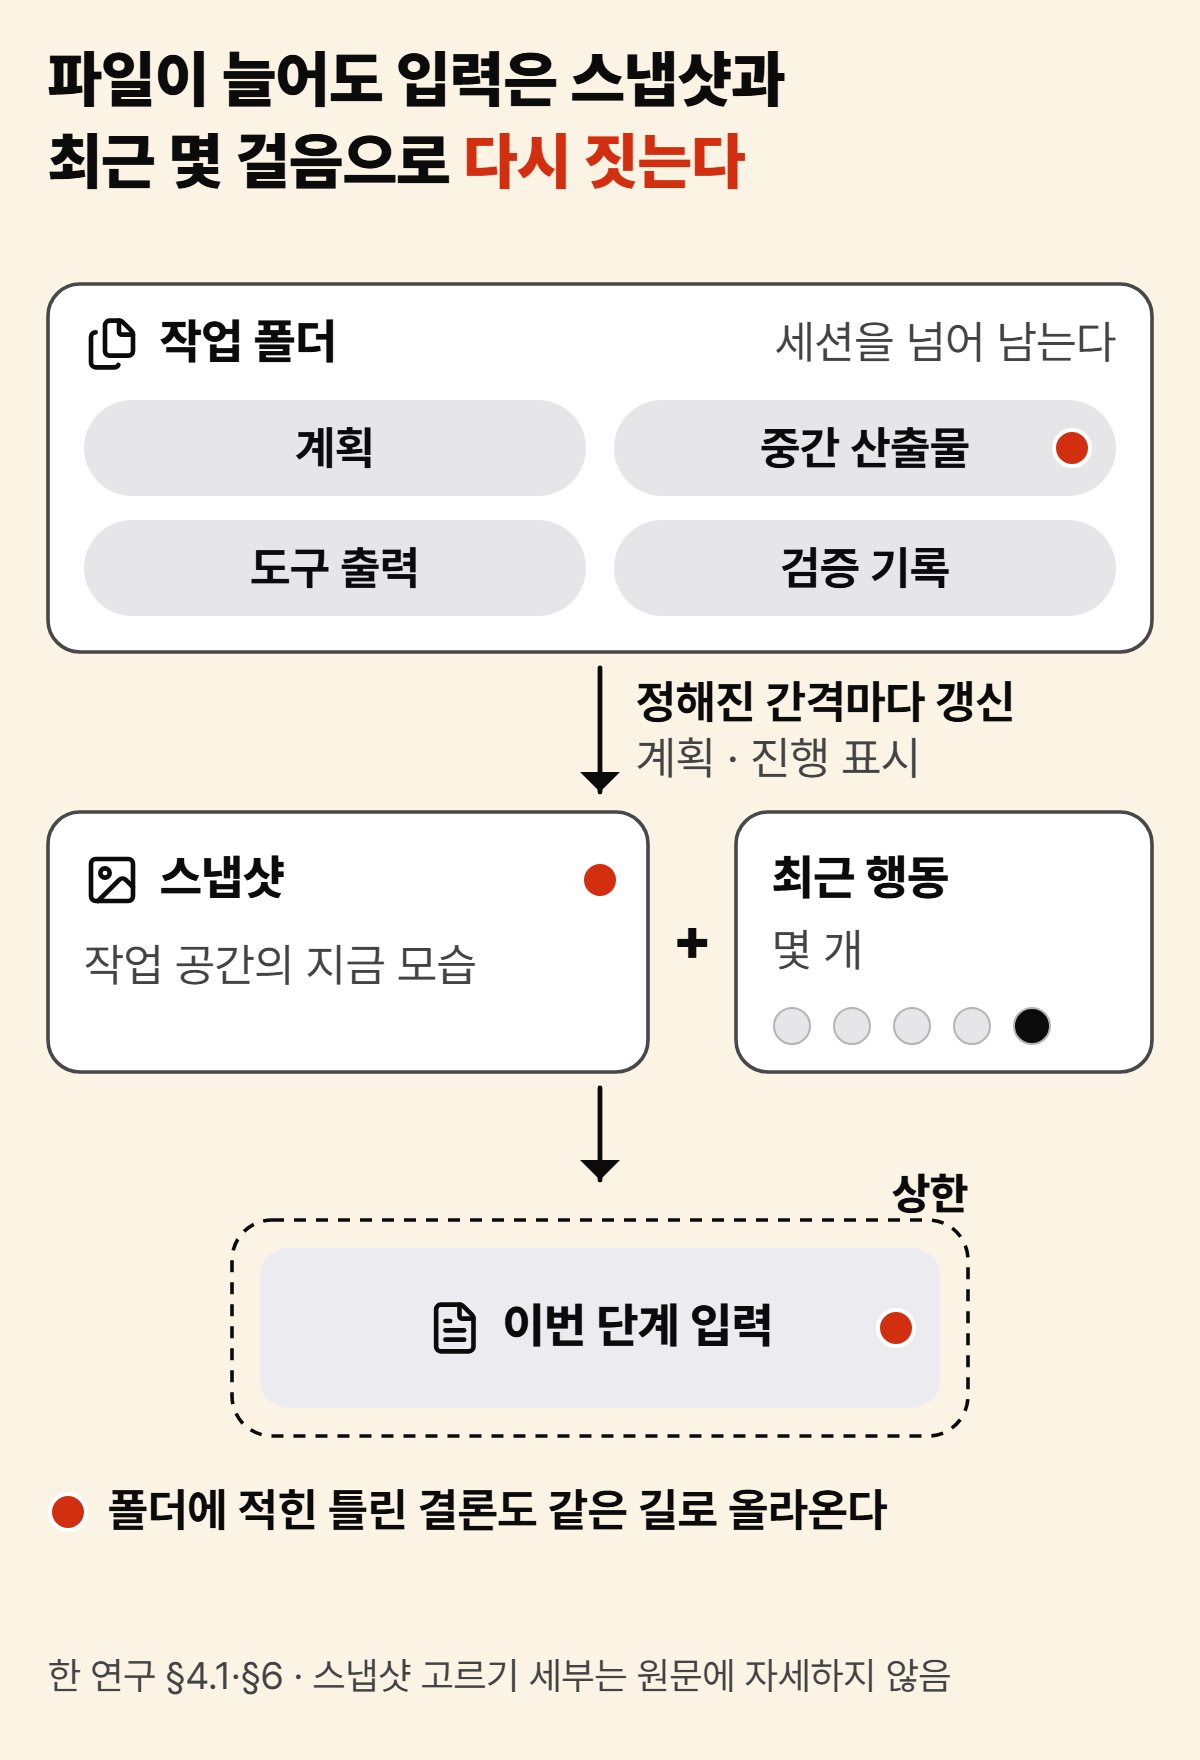
그림 9의 셋째 길이 이 설계다. 스냅샷에 실패 기록 목록이 든다면, 이 설계는 (ㄱ)에도 맞는다. 에이전트가 노트 한 줄 대신 새 실패 기록이 쌓인 지금의 작업 공간을 보게 되기 때문이다.
대가도 있다. 연구진은 상태를 바깥에 두고 층을 나눠 실행하면, 한 번에 넣고 도는 방식보다 부담이 생긴다고 쓴다. 그래서 빠른 주고받기보다 오래 걸리는 작업에 맞는다고 본다. 앞에서 본 한계도 그대로 남는다. 파일이 권위 있는 기록이라고 그 안의 결론까지 맞다는 보장은 없고, 같은 연구가 틀린 중간 결론도 적혀 퍼질 수 있다고 쓴 것이 이 지점이다.
이 블로그의 LLM 에이전트 지식 저장소, DB보다 파일이 먼저인 이유는 에이전트의 지식 저장소에 DB보다 파일을 먼저 두는 이유를 다뤘다. 여기서는 파일이 작업이 어디까지 왔는지의 기록까지 맡는다. 이 설계에서 창은 쌓이지 않고, 매 단계 기록에서 새로 지어진다.
창에 다 들어가면 통째로 넣은 쪽이 더 맞혔다
글 첫머리의 실험으로 돌아가기 전에, 무엇을 잘 된 기억이라고 부를지부터 본다. 리뷰 논문의 저자들은 색인, 요약, 맥락 선택을 잘 갖춘 작은 저장소가 뒤따르는 모델의 추론을 크게 쉽게 할 수 있다고 쓴다. 그리고 기억의 성공 기준을 이렇게 적는다.
The success criterion for memory is therefore not “how much did we save?” but “did we make the current decision legible?”
그러므로 기억의 성공 기준은 「얼마나 많이 저장했나?」가 아니라 「지금 내릴 결정을 읽히게 했나?」다.
Zhou 외, 「Externalization in LLM Agents」 §3.4 (arXiv:2604.08224 v1, 2026)여기서 읽는 주체는 모델이다. 「찾기의 질이 저장 용량보다 중요하다」는 것도 저자들의 해석이다. 저자들은 이 해석에 실험을 인용하지는 않았다.
Mem0는 대화에서 기억할 사실을 뽑아 저장해 두었다가, 질문이 오면 관련된 것을 꺼내 넣는 기억 서비스다. 그 연구팀이 2025년 논문에 낸 실험은 위의 해석을 잰 것이 아니다. 자기 장치를 포함한 기억 방식 몇 가지를 대화 통째로 넣기와 나란히 놓고 스스로 평가한 결과다. 실험 대화는 두 사람이 여러 세션에 걸쳐 나눈 긴 대화로, 한 벌이 평균 약 2만 6천 토큰이었다. 실험에 쓴 모델(gpt-4o-mini)의 창에 다 들어가는 길이다.
다른 LLM이 정답으로 채점한 비율은 대화 전체를 넣은 쪽이 72.90%로 가장 높았고, Mem0는 66.88%였다. 응답 시간은 응답의 95%가 이 시간 안에 끝난 값으로 비교했다. 대화 전체가 17.117초, Mem0가 1.440초였다. 저자들은 통째로 넣는 방식이 「정확도에서 조금 앞설 수 있지만」 기억 방식이 「더 실용적인 맞바꿈」이라고 쓴다. 그림 13는 그 표의 점들을 정답 비율과 응답 시간 위에 찍은 것이다.
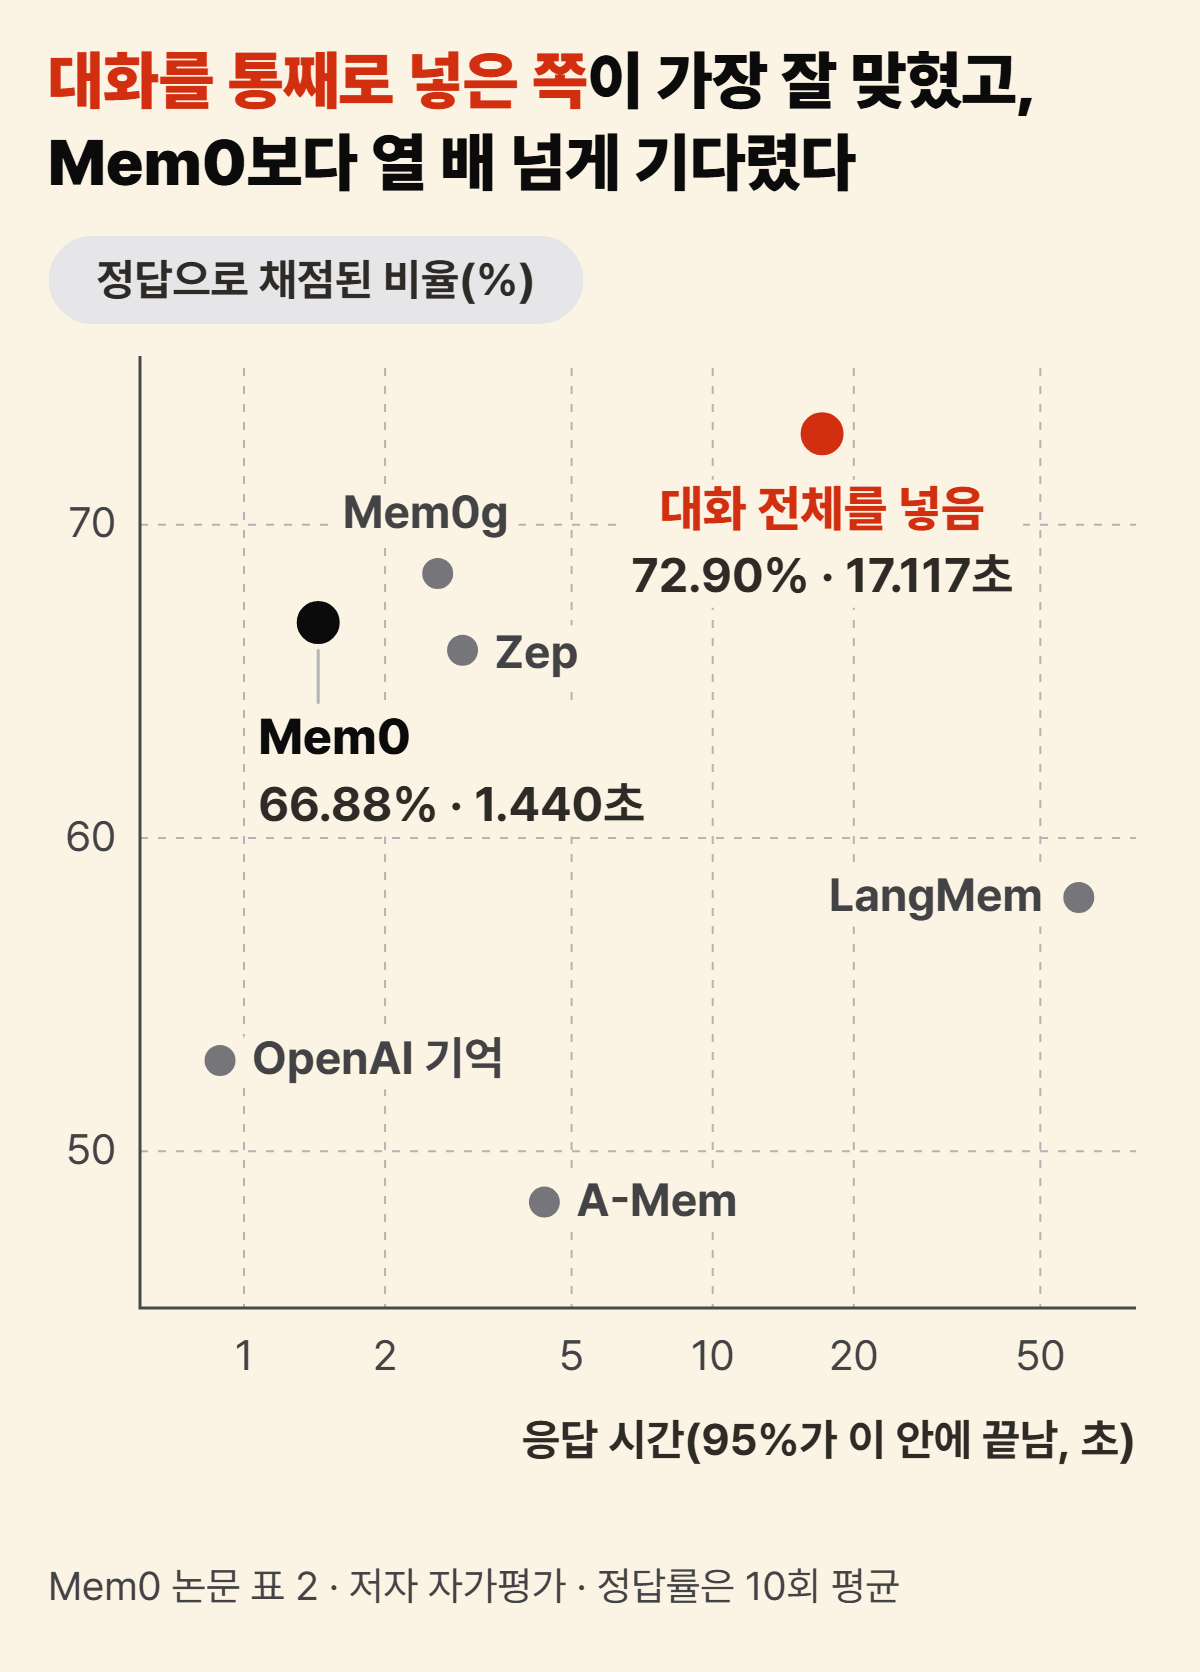
글 첫머리의 결과가 이것이다. 대화가 창에 다 들어가는 동안 기억 장치가 준 이점은 정답률보다 속도와 토큰 쪽에 있었다. 창을 넘는 길이는 이 실험이 재지 않았다. Mem0 저자들은 대화가 길어질수록 통째로 넣는 쪽의 계산 비용이 크게 늘고, 기억 방식은 대화 길이와 상관없이 성능을 지킨다고 내다본다. 창 안에서 이 실험이 보인 것은 정확도와 속도·토큰 사이의 맞바꿈이고, 창을 넘는 작업에서 무엇이 달라지는지는 아직 저자들의 전망으로 남아 있다.
자주 묻는 질문
에이전트 메모리와 RAG는 같은 말인가?
겹치는 데가 있지만 다루는 범위가 다르다. 리뷰 논문에서 RAG 말뭉치는 의미 지식을 담는 가장 흔한 형태로 나오고, 저장소에서 찾아 붙이는 방식은 꺼내기의 한 방법이다. 에이전트 메모리는 여기에 무엇을 어떤 모양으로 적고, 언제 고치고 지우는지까지 든다. 이 블로그의 RAG 란 무엇인가: 답하기 전에 찾아 읽기는 한 번의 답을 위해 찾아 읽는 일을 다뤘다. 여기서는 그 찾기가 세션을 넘는 기록의 꺼내기 단계로 들어간다.
모델을 계속 학습시켜 기억하게 하면 안 되나?
Du는 모델 자체에 기억을 넣는 방식도 다룬다. 다만 리뷰 논문은 API, 조직 구조, 지금 환경처럼 빨리 바뀌는 상태는 모델 안에 믿을 만하게 두기 어렵고, 계속 다시 학습시키면 앞서 배운 것을 잊는 위험이 있다고 본다. 바깥 저장소는 다시 학습하지 않고 바로 고칠 수 있고, 출처와 버전도 남길 수 있다. 언어 이해처럼 안정된 능력은 모델 안에 두는 편이 자연스럽다고도 쓴다. 사례의 어제 세운 가설과 배제 목록은 빨리 바뀌는 상태 쪽이다.
에이전트가 기억을 알아서 정리하나?
설계마다 다르다. 새 사실마다 모델이 추가·보강·삭제·그대로 두기를 고르게 한 서비스도 있고, 기억을 고치고 꺼내는 일을 모델이 정하게 한 구조도 있다. 다만 앞에서 본 Du의 지적처럼, 겪은 일을 오래 가는 지식으로 바꾸는 정리는 대개 누가 시키거나 규칙으로 정해 둔 계기가 있어야 일어난다.
지금 쓰는 코딩 에이전트에서 바로 손볼 수 있는 것은?
파일로 바로 고칠 수 있는 것은 노트와 요약의 문면이다. 앞의 둘째 기록처럼 시험한 가설과 결과, 배제했는지와 확인했는지, 언제 누가 적었는지(사용자의 말인지 에이전트의 결론인지)를 남긴다. 이것은 Du와 리뷰 논문의 원칙을 노트 파일에 옮긴 것이다(글쓴이 종합). 저장소에서 골라 꺼내기, 자동 정리, 새 기록 앞세우기, 기억 작업 기록 남기기 같은 장치는 하네스를 짜는 쪽의 일이다.
기억 장치를 따로 두지 않아도 되는 때는?
리뷰 논문은 짧은 일이면 지난 기록을 프롬프트에 그대로 두는 방식이 꽤 잘 된다고 쓴다. 기록을 바깥에 두면 그 대신 새로 맡을 일이 생긴다. Mem0 같은 서비스는 대화에서 기억을 뽑아 저장하는 일을 따로 하는데, 앞에서 본 응답 시간 비교에는 이 시간이 들어 있지 않았다. MemGPT 같은 구조에서는 무엇을 옮겨 적을지를 모델이 정해야 한다. 한 번 잘못 적은 줄이 여러 단계 뒤까지 저장소를 오염시킬 수 있다는 Du의 경고도 바깥 기록이 함께 지는 부담이다.
내 습관이나 선호까지 기억하게 해도 되나?
해도 된다. 다만 그런 기록은 앞에서 본 개인화 기억에 들고, 그 절에서 본 대로 규칙을 다른 기록과 따로 둔다. 그래서 기억하게 할지보다 먼저 정할 것은 무엇을 남기고 언제 지울지다. 사용자가 지워 달라고 할 때 그 기록만 골라 지울 수 있게 해 두는 것도 여기에 든다.
「이어서 해 줘」를 보내기 전에 어젯밤 노트를 복사해 둔다
다음 날 아침 새 세션에 「어제 하던 거 이어서 해 줘」를 보내기 전에, 어젯밤 노트와 요약 파일을 열어 사본을 하나 남겨 둔다. 아침 일이 엉뚱하게 이어지면 그 사본과 지금 파일을 나란히 놓는데, 앞에서 본 Du의 「기억 차이」를 손으로 만드는 셈이다. 아래 단계는 그 차이를 보는 데서 시작한다.
- 기록이 있는지부터 본다 — 직접 열 수 있는 것은 노트·요약 파일의 문면과, 아침에 남긴 사본과의 차이다. 오늘 모델에 실제로 들어간 입력(화면에 보이는 대화와 다를 수 있다)과 그사이 저장소에 무엇이 쓰이고 고쳐지고 지워졌는지는 하네스가 남겨야 보인다. Du는 쓰기·읽기·수정·삭제를 시각·계기·대상과 함께 남기라고 권하면서도, 이런 기록을 갖춘 시스템은 드물다고 적는다. 기록이 없으면 남기는 일은 하네스를 짜는 쪽에 맡긴다. 그동안은 사본과의 차이로 고를 수 있는 줄만 고른다.
- 표 3에서 줄을 찾는다 — 노트 줄이 지금 작업 공간이나 다시 확인한 결과와 어긋나는지, 배제 경위가 적힌 원래 기록이 저장소에 남았는지, 필요한 줄이 이번 입력에 실렸는지를 묻는다. 세 답에 들어맞는 「확인할 증거」 칸이 있는 줄이 오늘 먼저 볼 줄이다.
- 노트 문면을 연다(적기) — 처음 적힌 노트를 앞의 둘째 기록 옆에 놓는다. 무엇이 빠졌는지, 배제했는지와 확인했는지, 누가 적었는지가 남았는지 본다((ㄴ-1)(ㄹ)).
- 저장소의 옛 줄과 새 줄을 연다(정리하기) — 같은 대상을 적은 줄을 모두 찾는다. 옛 줄이 새 줄과 함께 남았는지, 요약이 원래 기록을 대신하며 지우지 않았는지, 어긋남을 표시한 흔적이 있는지 본다((ㄱ)(ㄴ-1)(ㄹ)).
- 이번 입력을 연다(꺼내기) — 오늘 모델이 받은 입력을 원래 기록 옆에 놓는다. 원래 기록이 오지 못했다면 꺼내기를 했는지, 찾은 결과에 있었는지, 입력을 짤 때 빠졌는지 본다. 입력에 너무 많이 들어오지 않았는지, 작업 공간의 지금 모습(새 실패 기록)을 읽었는지도 본다((ㄱ)(ㄴ-2)(ㄷ)). 새 실패 기록을 읽었는데도 (ㄱ)처럼 옛 모습대로 다뤘다면 6단계로 간다.
- 입력에 있던 줄을 지나쳤거나 입력이 맞았는데도 틀렸다면((ㄷ)·기억 밖 줄) — 지시는 그대로 두고 입력의 기록만 바꿔, 이를테면 관련 기록만 남긴 입력으로 다시 돌려 본다. Du는 기억 내용을 바꿔 실패한 상호작용을 다시 돌려 보는 도구가 원인 찾기에 값지다고 쓴다. 결과가 그대로면 기억 밖 줄 쪽으로 기울지만, 한 번의 결과로 정하지는 않는다. 갈리지 않으면 두 후보를 그대로 두고 연재 1편에서 본 지시문과 실행 루프 쪽도 함께 본다.
하네스가 절차를 지침으로 올리면 스킬이 된다
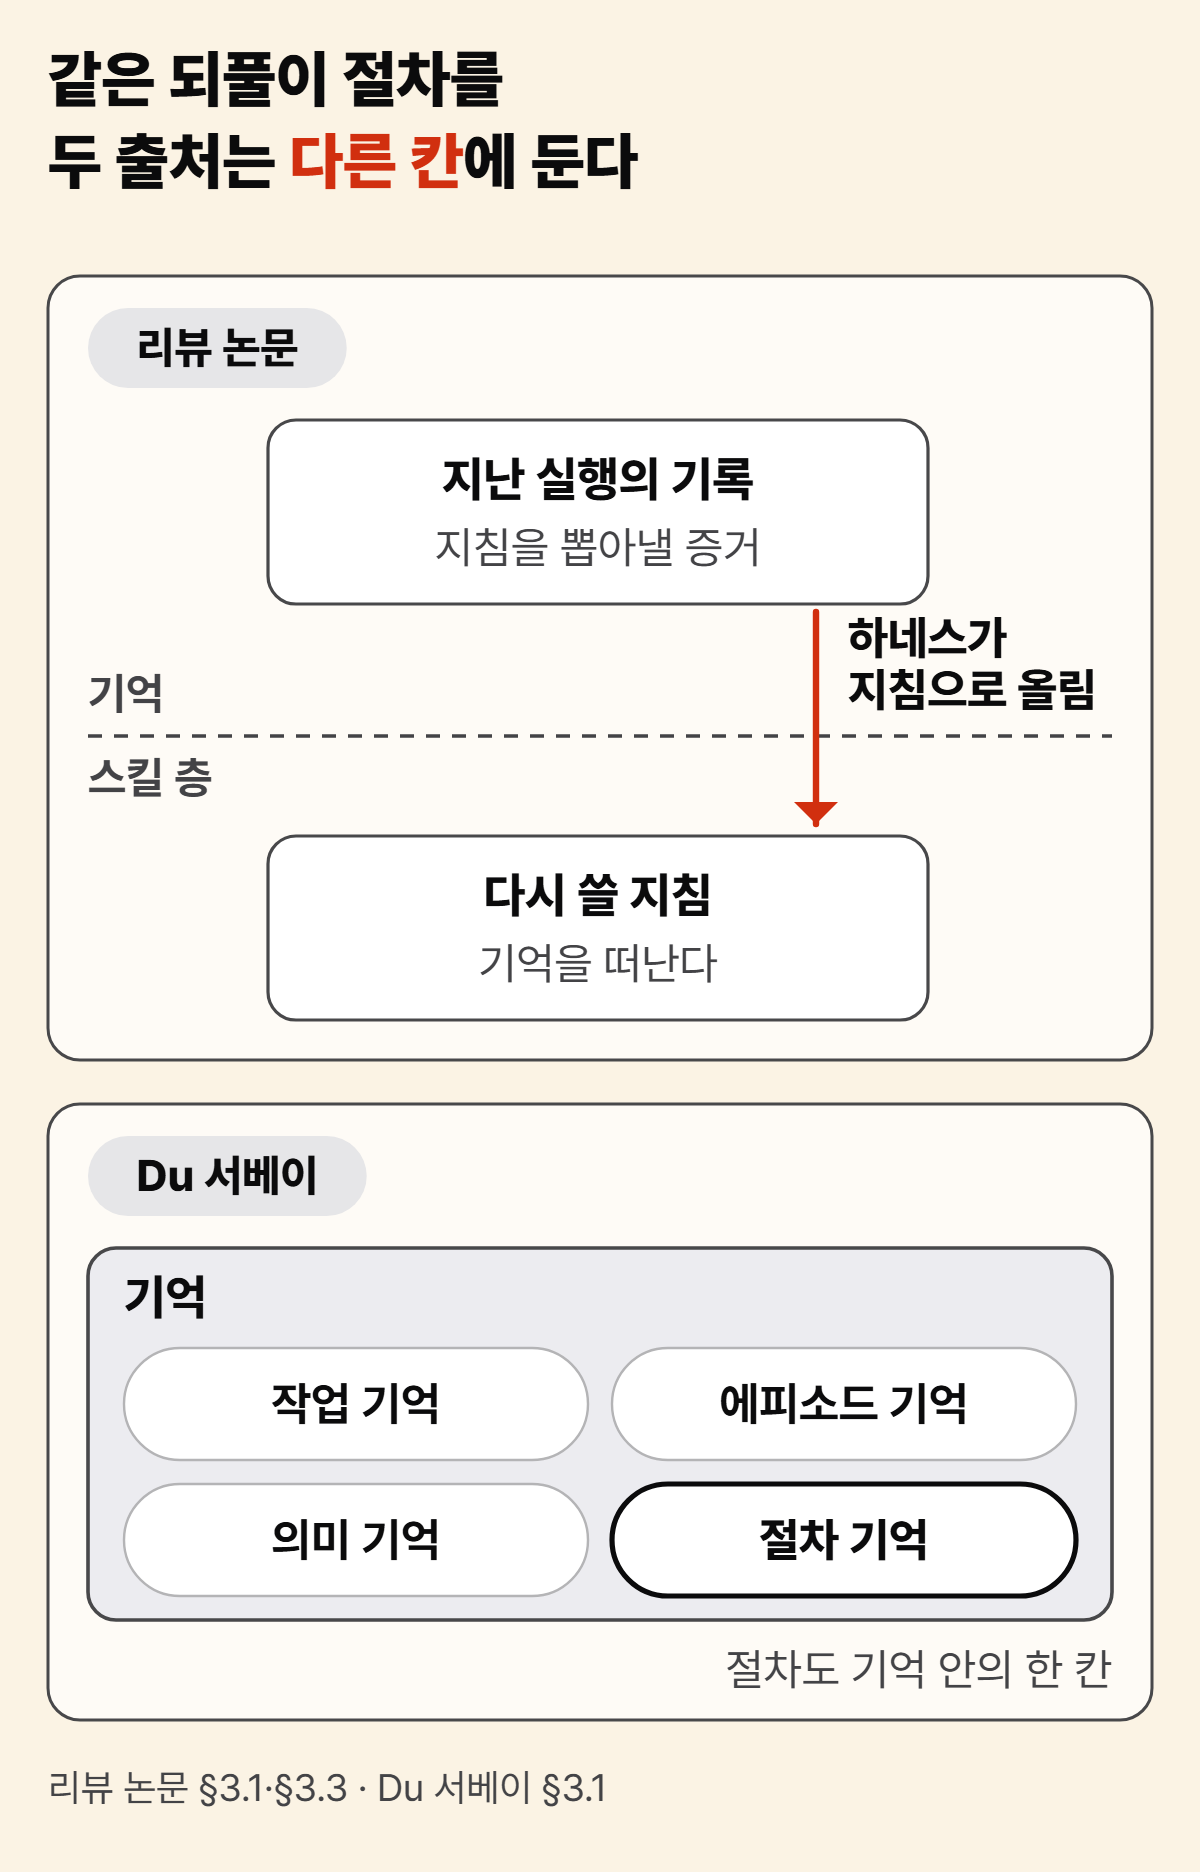
리뷰 논문의 구분으로는, 되풀이되는 절차를 하네스가 다시 쓸 지침으로 올리는 순간 그 절차는 기억을 떠나 스킬 층에 속한다. 저자들은 기억이 그 자체로 절차 지침은 아니고, 그런 지침을 나중에 뽑아낼 증거의 바탕이라고 쓴다. Du는 절차 기억을 기억의 한 종류로 넣어, 경계를 다른 자리에 긋는다. 그림 14은 같은 되풀이 절차를 두 출처가 어느 칸에 두는지 나란히 놓았다.
사례의 다섯 경우를 다시 놓아 본다. (ㄱ)은 이미 바뀐 것을 옛 모습대로 다뤘고, (ㄴ-1)은 남은 것이 요약 한 줄뿐이었다. (ㄴ-2)는 원래 기록이 오늘 입력까지 오지 못했고, (ㄷ)은 입력에 있던 한 줄을 지나쳤다. (ㄹ)은 어제 에이전트가 스스로 적은 결론을 사실로 삼았다. 표 3에서 이들이 먼저 열어 볼 단계는 적기·정리하기·꺼내기 어느 하나에 몰리지 않았고, (ㄷ)은 기억 밖일 수도 있었다.
작업이 창에 다 담기지 않을 만큼 길어진 에이전트가 어제 일을 이어 가게 하려면, 얼마나 많이 남길지보다 무엇을 어떤 모양으로 적고, 낡거나 틀린 줄을 언제 고치고, 오늘 무엇을 골라 보여 줄지부터 정해야 한다.
연재 「AI의 바깥을 설계하는 법」 8편 중 3편 — 다음 편은 에이전트가 되풀이하는 절차를 왜 파일로 꺼내 두는지를 다룬다.
더 읽기
- C. Zhou 외, 「Externalization in LLM Agents: A Unified Review of Memory, Skills, Protocols and Harness Engineering」, arXiv:2604.08224 v1 (2026) — https://arxiv.org/abs/2604.08224v1
- P. Du, 「Memory for Autonomous LLM Agents: Mechanisms, Evaluation, and Emerging Frontiers」, arXiv:2603.07670 (2026) — https://arxiv.org/abs/2603.07670
- C. Packer 외, 「MemGPT: Towards LLMs as Operating Systems」, arXiv:2310.08560 (2023) — https://arxiv.org/abs/2310.08560
- C. Yu 외, 「InfiAgent: An Infinite-Horizon Framework for General-Purpose Autonomous Agents」, arXiv:2601.03204 (2026) — https://arxiv.org/abs/2601.03204
- P. Chhikara 외, 「Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory」, arXiv:2504.19413 (2025) — https://arxiv.org/abs/2504.19413
- N. Shinn 외, 「Reflexion: Language Agents with Verbal Reinforcement Learning」, NeurIPS 2023 — https://arxiv.org/abs/2303.11366
- 관련 글: 프롬프트·컨텍스트·하네스 엔지니어링, 뭐가 다를까 — 기억을 하네스가 담는 칸으로 두고 노트가 세션을 건넌다는 데까지 본 연재 1편. 이 글은 그 노트의 안쪽을 봤다.
- 관련 글: 컨텍스트 엔지니어링, 많이 넣을수록 헷갈리는 이유 — 세션을 넘는 기록 대신, 한 창 안에 넣은 글이 어떻게 쓰이는지를 본 연재 2편.
- 관련 글: LLM 에이전트 지식 저장소, DB보다 파일이 먼저인 이유 — 에이전트의 지식에 DB보다 파일을 먼저 두는 이유를 본 글. 이 글에서는 파일이 작업 진행의 기록까지 맡는다.
- 관련 글: RAG 란 무엇인가: 답하기 전에 찾아 읽기 — 저장소에서 찾아 붙이는 일의 바탕을 푼 글. 이 글에서는 그 찾기가 꺼내기 단계의 한 방법으로 들어간다.