「도파민 터진다」는 말처럼, 도파민은 기분 좋을 때 나오는 물질이라는 말을 자주 듣는다. 하지만 원숭이의 도파민 신경세포는 주스가 예상보다 좋으면 신호를 더 내고, 예상만큼이면 평소대로 냈다. 예상보다 덜한 주스에는 평소보다 덜 냈다. 받은 것과 예상의 이 차이를 보상 예측 오류(reward prediction error)라고 한다.
일본의 한 음료 자판기 앞에서, 도파민 연구자 볼프람 슐츠(Wolfram Schultz)는 버튼 위 글자를 읽지 못했다. 고를 수 있는 음료는 여섯 가지였고, 원하는 블랙커런트 주스가 나올 가능성을 그는 6분의 1로 어림했다. 그는 오른쪽에서 둘째 버튼을 그냥 눌렀고, 바로 그 주스 캔이 나왔다. 그는 2016년에 쓴 글 첫머리에 이 일을 옮기면서, 그 순간의 오류를 받은 것 1 빼기 기대 1/6이라는 숫자로 적었다. 계산하면 약 0.83이고, 기대보다 반가운 쪽으로 그만큼 어긋났다는 셈이다.
그 뒤로 그는 같은 주스를 원할 때마다 그 버튼을 눌렀다. 2주쯤 지나 같은 버튼에서 덜 좋아하는 다른 캔이 나왔을 때는, 이번에는 기대보다 못한 쪽으로 어긋났다고 적었다. 두 장면에서 그가 적은 것은 기분이 얼마나 좋았는가보다 기대와 받은 것의 차이였다. 자판기 일은 한 연구자가 겪은 일화일 뿐, 그 자리에서 잰 값은 없다.
도파민은 기분 좋을 때 나오는 물질일까? 꼭 그렇지는 않다. 원숭이 도파민 뉴런 대부분은 주스를 받아도, 그 주스가 예상대로 온 것이면 평소보다 신호를 더 내지 않았다. 도파민 뉴런은 도파민을 내보내는 신경세포다. 원숭이 기록은 이 세포가 1초에 신호를 몇 번 내는지를 쟀고, 도파민이 얼마나 나왔는지는 재지 않았다.
같은 주스에도 도파민 뉴런의 반응이 달라질까
1997년 『Science』에 실린 슐츠·Dayan·Montague의 글은 원숭이 도파민 뉴런 하나의 기록을 그림 1에 세 경우로 나란히 놓았다. 첫째, 아무 예고 없이 주스 한 방울이 입에 들어오자 뉴런의 신호가 짧게 확 올랐다. 둘째, 빛 같은 신호 뒤에 주스가 온다는 것을 원숭이가 배운 뒤에는, 신호가 켜질 때 오르고 예상대로 온 주스에는 평소 그대로였다. 셋째, 신호를 보고도 원숭이가 동작을 실수해 주스가 오지 않자, 주스가 왔어야 할 바로 그 시각에 평소 아래로 내려갔다.
셋째 경우의 내려감은 신호가 켜지고 1초 넘게 지난 뒤에, 그사이 아무 자극이 없었는데도 일어났다. 캡션은 이것을 예상한 주스 시각이 뇌 안에 따로 담겨 있다는 표시로 읽었다. 캡션에는 몇 번을 기록했는지도, 1초에 신호를 몇 번 냈는지도 적혀 있지 않다.
「평소 그대로」는 신호가 멈춘다는 말이 아니다. 도파민 뉴런은 아무 일이 없을 때도 신호를 조금씩 낸다. Hollerman과 슐츠가 1998년에 기록 대상으로 삼은 뉴런은 평소 1초에 2.0~8.5번 신호를 내는 세포였다. 예상대로 온 주스에는 이 평소 횟수가 그대로 이어진다. 1997년 글은 세 방향을 한 문장으로 정리했다.
They emit a positive signal (increased spike production) if an appetitive event is better than predicted, no signal (no change in spike production) if an appetitive event occurs as predicted, and a negative signal (decreased spike production) if an appetitive event is worse than predicted (Fig. 1).
(도파민 뉴런은) 반가운 일이 예상보다 나으면 양의 신호(신호 횟수 증가)를, 예상대로 일어나면 신호를 내지 않고(횟수 변화 없음), 예상보다 못하면 음의 신호(신호 횟수 감소)를 낸다(그림 1).
슐츠·Dayan·Montague (1997), Science 275, 1594쪽같은 글은 이런 반응이 대부분의 도파민 뉴런에서 나타난다고 적었다. 반응을 이렇게 위아래로 가르는 값, 곧 받은 것에서 예상을 뺀 차이를 보상 예측 오류(reward prediction error)라고 부른다. 보상 예측 오차라고도 한다. 여기서 「오류」에는 누가 실수했다는 뜻이 없다. 슐츠는 2016년 글에서 이 말이 나온 캔과 바로 그 캔을 받으리라는 낮은 기대 사이의 차이를 가리킨다고 풀고, 자기가 실수했는지와는 상관없다고 덧붙였다.
이 오류에는 방향이 있다. 1997년 글은 손에 뿜는 공기나 입에 떨어뜨린 소금물 같은 싫은 자극이 같은 짧은 오름을 일으키지 않았다고 적었다. 처음 보는 자극에 도파민 뉴런이 오르는 일도 있지만, 대부분의 자극에서 그 반응은 몇 번 보여 주면 사라졌다. 그래서 이 반응은 무엇이든 예상 밖이기만 하면 커지는 신호와는 다르다. 반응이 오를지, 그대로일지, 내려갈지는 반가운 주스가 예상과 얼마나 달랐는가를 따라 정해졌다.
주스를 미리 알게 되면 반응하는 뉴런이 줄어들까
Hollerman과 슐츠의 1998년 실험은 이 변화를 원숭이가 배우는 도중에 쟀다. 원숭이 2마리에게 그림 두 장을 함께 보여 주고, 맞는 그림 아래의 레버를 건드리면 1초 뒤에 사과 주스 0.15 ml를 주었다. 원숭이는 새 그림 쌍을 받을 때마다 어느 쪽이 맞는지 처음부터 다시 배워야 했다. 그림이 익숙해지면, 맞는 그림은 곧 주스를 알리는 익숙한 신호가 된다. 연구진은 같은 주스를 조건만 바꿔 주면서 도파민 뉴런 하나하나의 신호를 기록했다.
과제 밖에서 아무 때나 준 주스에는 뉴런 61개 가운데 45개(73.8%)가 반응했다. 새 그림을 배우기 시작한 처음 몇 번의 주스에는 66개 가운데 33개(50.0%), 익숙한 그림을 고른 뒤의 주스에는 66개 가운데 8개(12.1%)였다. 뒤의 두 비율은 같은 66개 뉴런에서 나왔고, 아무 때나 준 주스만 분모가 61로 다르다. 가운데 조건의 반응은 아무 때나 준 주스에 대한 반응만큼 크지 않았다. 두 그림 중 하나를 고르는 상황이라 원숭이가 주스를 반쯤은 예상했기 때문일 수 있다고 저자들은 적었다.
반응의 크기도 배우면서 줄었다. 원문은 66개 뉴런 집단에서, 새 그림의 처음 두 번에 주스 뒤 반응이 평소의 거의 세 배까지 올랐다가 곧 평소의 두 배 안팎으로 내려왔다고 적었다. 틀린 그림을 골라 주스가 오지 않은 번에는 반대쪽 반응이 나왔다. 오답을 6번 이상 기록한 뉴런 40개 가운데 28개(70.0%)가 주스가 왔어야 할 시각에 평소 아래로 내려갔다. 새 그림의 처음 두 번에는 반응이 올랐고, 와야 할 주스가 오지 않으면 평소 아래로 내려갔다.
도파민을 거의 없앤 쥐도 단맛에 같은 얼굴을 할까
「도파민 = 기분 좋음」에는 원숭이 기록과 다른 쪽에서도 반대 증거가 나왔다. Berridge와 Robinson은 1998년 글에서, 쥐의 뇌 깊은 곳에 신경독을 넣어 그곳의 도파민을 최대 99%까지 없앤 실험을 보고했다. 연구진은 쥐 입에 설탕물과 쓴 물을 넣고, 혀 내밀기 같은 얼굴·입 반응을 셌다. 도파민을 없앤 쥐의 이 반응은 신경독 없이 용액만 넣은 쥐와 비슷했다. 저자들은 도파민을 크게 없애도 단맛에 맛있어하는 반응이 나오는 데에는 지장이 없었다고 결론 냈다.
그런데 이 쥐들은 스스로 먹지 않았다. 신경독을 맞은 쥐 28마리 가운데 2마리는 회복 중에 죽었고, 4마리는 먹기 시작해 실험에서 빠졌다. 남은 22마리를 시험했고, 그 가운데 수술 뒤 17일 동안 끝까지 먹지 않은 12마리의 결과만 분석에 넣었다. 연구진이 일부러 그런 쥐만 남긴 것이다. 먹이에 끌려 다가가는 힘이 사라진 쥐에서도 맛있어하는 반응이 남는지를 보려는 설계였다.
저자들의 결론을 풀면, 도파민은 보상에 끌려 다가가는 힘에는 필요하지만 맛있어하는 반응에는 필요 없다는 것이다. 다만 맛있어하는 반응은 쥐의 얼굴과 입 움직임으로 센 것이어서, 사람이 말하는 기분과 바로 이어지지는 않는다. 이 결론을 「도파민은 기분과 상관없다」로 넓힐 수도 없다. 끌려 다가가는 힘에는 도파민이 필요하다고 같은 글이 적었기 때문이다.
한 가지는 이 글 뒤쪽의 설명과 부딪친다. Berridge와 Robinson은 새로운 맛을 좋아하거나 싫어하게 배우는 데에도 도파민이 필요 없었다고 적었다. 뒤에서 볼 「도파민 신호가 배움을 이끈다」는 설명과 맞지 않는 주장이다. 두 설명은 도파민이 곧 기분 좋음은 아니라는 한 가지에서만 같은 쪽에 선다. 원숭이 신경세포 기록도 쥐의 얼굴 반응도 그 등식을 받치지 않았다.
도파민 보상 예측 오류는 AI 학습의 오류 신호와 닮았을까
AI가 점수를 받으며 시행착오로 배우는 방법은 이 블로그의 보상 해킹 편에서 풀었다. 거기서 보상은 점수였고, 이 글에서 보상은 원숭이 입에 들어간 주스다. 여기서는 그런 배우는 방법 하나가 쓰는 오류 신호가 원숭이 도파민 뉴런의 기록과 닮았다는 설명을 본다.
그 방법의 이름은 시간차 학습(temporal difference learning)이다. Sutton이 1988년 논문에서 정리한 이 방법은 결과가 나올 때까지 기다리지 않고, 잇달아 나오는 두 예상의 차이로 예상을 고친다. 바로 전에 한 예상과 지금 한 예상이 다르면, 그 차이만큼 바로 전 예상을 고치는 식이다. Sutton과 Barto의 교재는 이 오류 신호를 도파민 뉴런과 처음 분명하게 이은 논문으로 Montague·Dayan·Sejnowski의 1996년 논문을 꼽았다. 1997년 글은 그중 Dayan·Montague가 슐츠와 함께 썼다.
1997년 글은 도파민 뉴런의 출력이 실제로 받은 보상과, 보상이 올 시각·크기에 대한 예측 사이의 차이를 나타내는 것으로 보인다(appear to)고 썼다. 정말 닮았는지 보려고, 1996년 논문 그림 5의 설정을 따라 시간차 학습을 직접 돌려 보았다. 시도 한 번은 120칸으로 나눈 시간이다. 41번 칸에 신호가 켜지고, 54번 칸에 크기 1의 주스가 온다. 계산은 신호가 켜진 뒤 20칸에 칸마다 예상값을 하나씩 두고, 한 번 시도할 때마다 그 값을 고친다.
| 항목 | 원문(1996년 논문 그림 5) | 이 글의 계산 |
|---|---|---|
| 시도 한 번의 길이 | 120칸 | 같음 |
| 신호 칸 · 주스 칸 | 41 · 54 | 같음 |
| 주스 크기 | 1 | 같음 |
| 신호 뒤 예상값을 두는 칸 수 | 20칸 | 같음 |
| 한 번에 고치는 비율 | 0.3 | 같음 |
| 주스를 빼는 시도 | 15번마다 | 같음 |
| 처음 예상값 | 적혀 있지 않음 | 모든 칸 0 |
| 배우기 시작하는 시도 | 10번째 | 1번째 |
| 세 경우를 볼 때 | — | 주스를 빼지 않고 100번 배운 뒤, 값을 고치지 않는 시험 한 번씩 |
오류는 칸마다 「지금 받은 것 + 지금의 예상 − 바로 전 칸의 예상」으로 센다. 기호로는 칸 t의 오류를 δ(t), 그 칸에서 받은 주스를 r(t), 그 칸에서 앞으로 올 주스에 대한 예상을 V(t)로 적는다.
식 1의 오류가 0이 아니면, 바로 전 칸의 예상을 그 오류의 0.3배만큼 고친다. 다 배운 뒤를 떠올리면 식이 왜 이런 모양인지 보인다. 신호가 켜지는 41번 칸에서는 예상이 0에서 1로 뛰므로 오류가 +1이다. 주스 칸에서는 받은 1과 사라지는 예상 1이 맞아떨어져 오류가 0이 된다. 주스가 빠지면 사라지는 예상 1만 남아 오류는 −1이 된다.
실제로 돌린 결과도 이 세 모양이었다. 배우기 전 1번째 시도에서는 주스 칸의 오류가 1.00이었다. 주스를 빼지 않고 100번 배운 뒤 시험하면 신호 칸 1.00·주스 칸 0.00이 나왔고, 같은 상태에서 주스를 빼면 신호 칸 1.00·주스 칸 −1.00이 나왔다. 원숭이 그림 1의 세 경우와 같은 방향이다. 그림 1에서 미리 배운 횟수와 이번 주스 크기를 바꿔 보면 이 세 경우를 직접 오갈 수 있다.
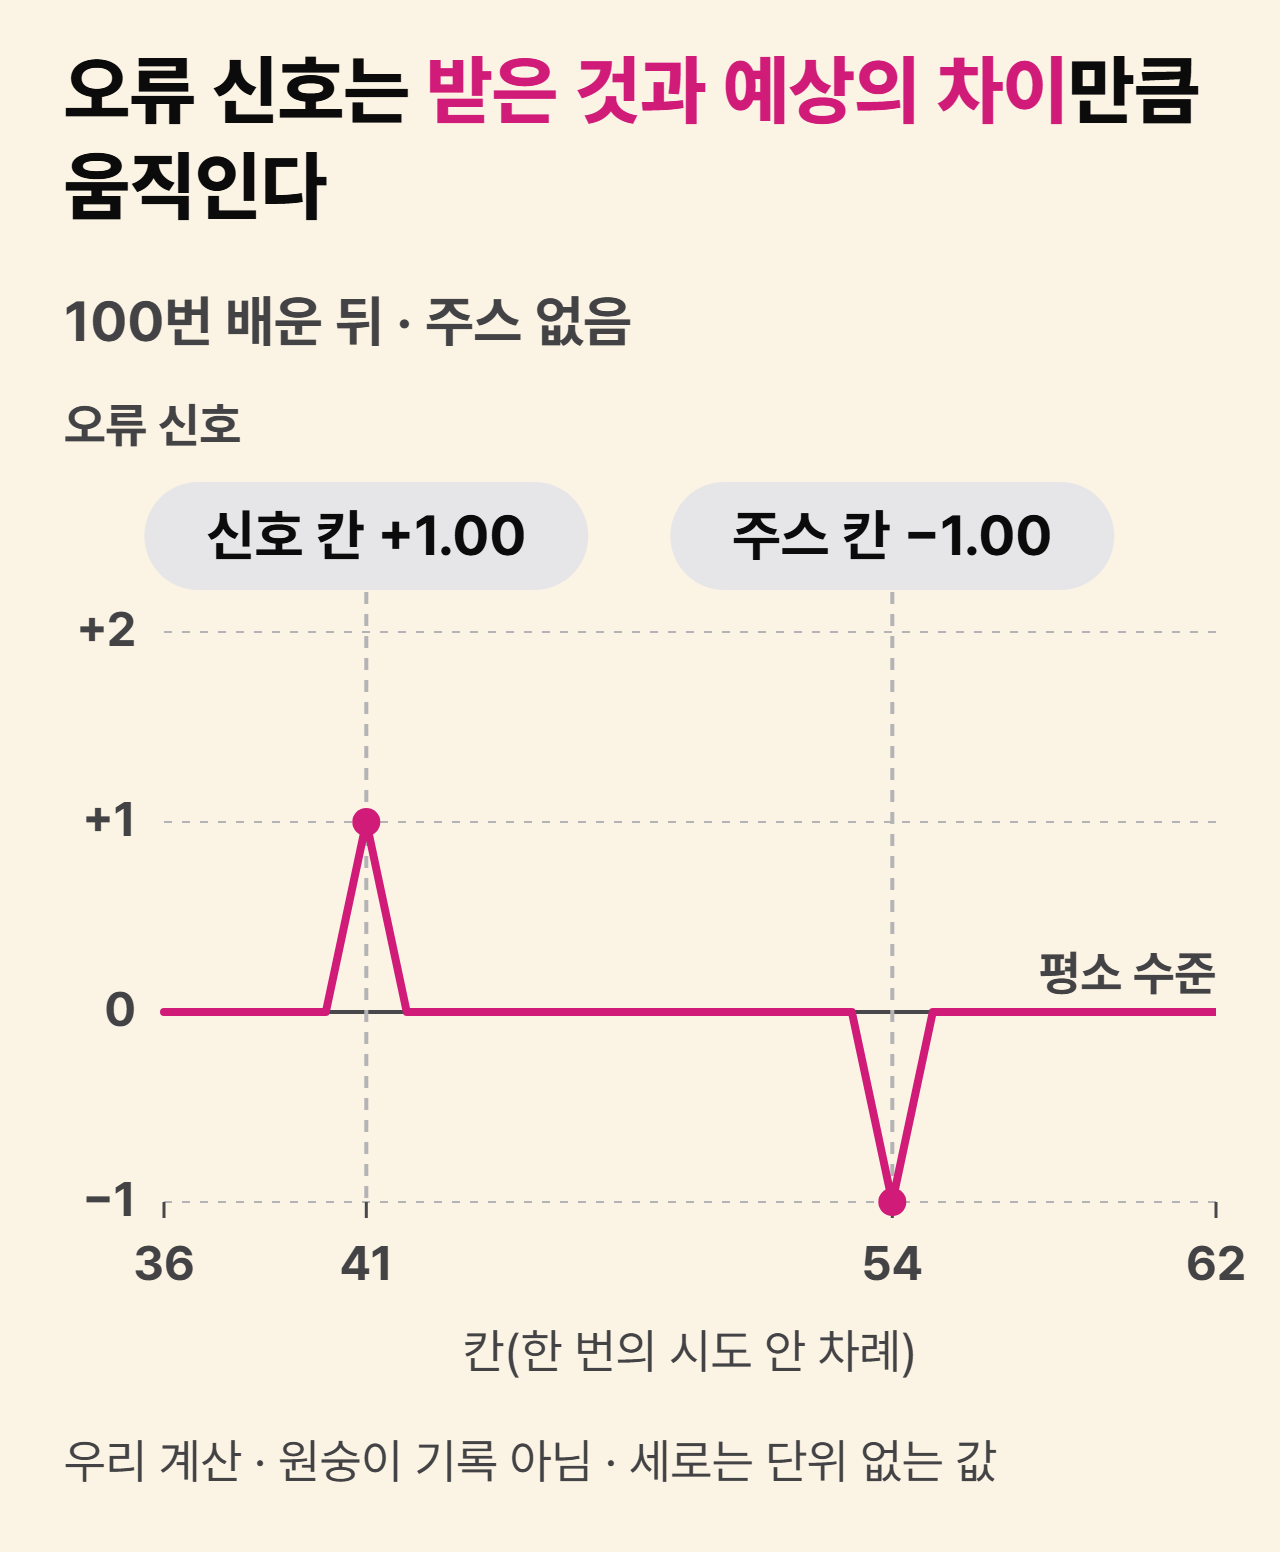
계산의 숫자를 원숭이의 숫자로 읽지 않는다. 1.00은 단위가 없는 값이라 「평소의 몇 배」나 1초에 신호 몇 번으로 바꿀 수 없다. 0은 평소 수준이고, −1.00은 평소 아래로 내려간 상태를 가리킬 뿐 신호가 멈췄다는 표시가 아니다. 칸은 초가 아니고, 계산의 시도 횟수도 원숭이 실험의 횟수가 아니다.
배우는 동안에는 오류가 자리를 옮긴다. 주스를 빼지 않고 배우면 주스 칸의 오류가 1.00에서 0.70, 0.49, 0.34로 줄어든다. 한 번 배울 때마다 주스 칸 바로 앞 칸의 예상이 0.30, 0.51, 0.66으로 자라서, 받은 주스와의 차이가 그만큼 작아지기 때문이다.
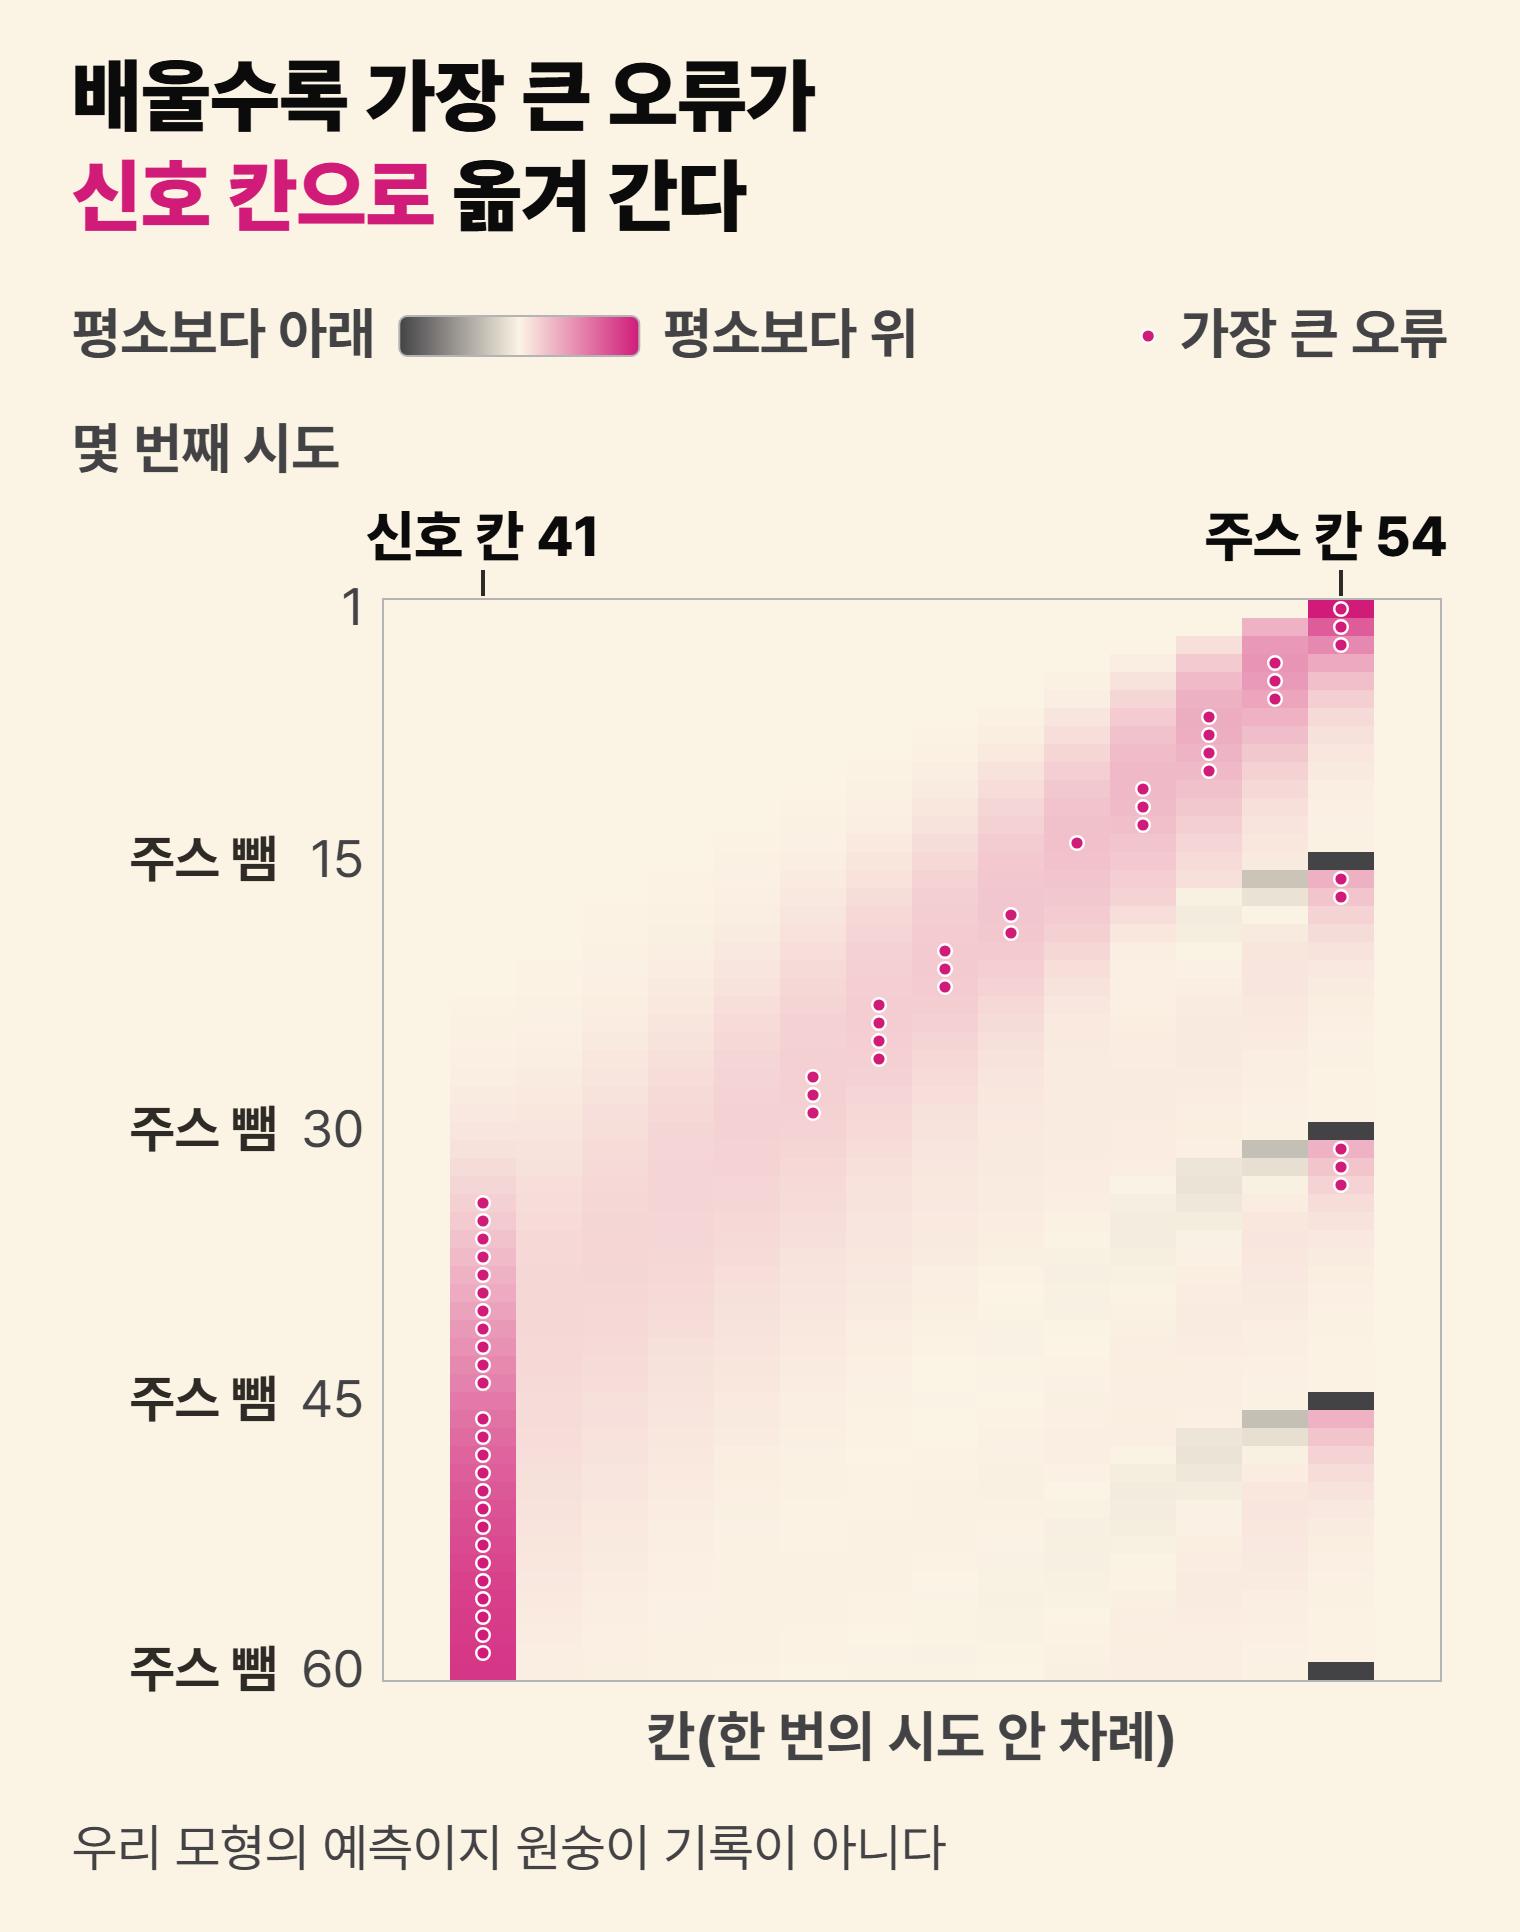
1996년 원문처럼 15번마다 주스를 빼면서 100번을 돌려 보았다. 34번째 시도부터는 가장 큰 오류가 줄곧 신호 칸에 있었다(그림 2). 세 모양도 이 옮겨 감도, 받은 것과 예상의 차이로 바로 전 예상을 고치는 규칙 하나에서 나온다. 두 신호가 닮았다는 설명은 그 세 모양이 원숭이 그림 1과 같은 방향이라는 데 기댄다.
이 계산은 동물 기록과 어디까지 맞을까
Hollerman과 슐츠는 원숭이가 과제를 익힌 뒤 주스 시각을 옮겨 보기도 했다. 레버를 건드리고 1.0초 뒤에 오던 주스를 0.5초 늦추자, 뉴런 14개 가운데 9개가 평소 주스 시각에 평소 아래로 내려갔고, 14개 가운데 8개는 새 시각에 올랐다. 다 배운 계산에서 주스를 5칸 늦춰도 원래 칸은 −1.00, 새 칸은 +1.00이 나왔다. 5칸은 이 글이 고른 수라 초로 바꾸지 않는다. 늦춘 주스에서는 두 시각 모두 계산과 원숭이가 같은 방향이다.
앞당긴 주스에서는 둘이 어긋났다. 주스를 0.5초 앞당기자 뉴런 8개 가운데 6개는 새 시각에 오르고, 평소 주스 시각에는 내려가지 않았다. 저자들은 주스가 예상 시각보다 먼저 이미 왔다면 그 시각에 내려가지 않는다고 정리했다. 계산은 5칸 앞당긴 주스에 새 칸 +1.00을 내고, 원래 칸에서도 −1.00을 냈다. 이 계산은 신호 뒤 칸마다 둔 예상을 주스가 온 뒤에도 그대로 켜 두는 방식이라, 주스가 일찍 와도 원래 칸에서 예상이 사라지며 −1이 생긴다.
이미 주스를 알리던 신호가 있으면 새 신호를 배우지 않는 성질도 계산에서 보인다. 빛만으로 주스를 100번 배운 계산에 소리를 더해 50번을 함께 배우게 한 뒤 소리만 켜면, 신호 칸의 오류는 0.00이었다. 처음부터 빛과 소리를 함께 50번 배운 계산에서 소리만 켜면 0.50이 나왔다. 이것은 계산의 성질이고 동물 데이터는 아니다.
동물 쪽으로는 1997년 글이 든 쥐의 예가 있다. 빛 뒤에 늘 먹이가 오면 쥐는 빛이 먹이를 알린다고 배운다. 그 뒤 빛과 소리를 함께 켜고 먹이를 주면, 쥐의 행동은 빛은 계속 먹이를 알리지만 소리는 아무것도 알리지 않는다는 쪽으로 나온다. 저자들은 빛이 이미 먹이를 다 알려서 소리가 쓸모 있는 새 정보를 더하지 않았고, 그래서 소리와는 연결이 생기지 않았다고 설명했다. 이 블로그의 징크스 편은 먹이와 시간상 겹친 동작이 굳는다는 스키너의 설명을 따라갔다. 여기서는 반대로, 먼저 배운 신호가 있으면 시간상 겹친 새 신호를 계산이 배우지 않는다.
시간차 학습은 배우는 동안 오류의 봉우리가 주스 칸에서 사이 칸을 거쳐 신호 칸 쪽으로 점점 옮겨 간다고 예측한다. 이 글의 계산에서 봉우리는 54번 칸에서 46번 칸까지 한 칸씩 옮겨 갔고(그림 2), 그사이 15번째와 30번째 시도에서 주스를 뺀 바로 뒤에는 주스 칸으로 되돌아갔다. 그리고 34번째 시도에서 사이 칸을 거치지 않고 신호 칸 41로 건너뛰었다. 사이 칸(42~53)의 오류는 가장 컸던 4번째 시도에도 0.44로, 1번째 시도 주스 칸의 1.00보다 작았다.
Amo 연구팀은 2022년 논문에서, 보상 반응이 줄고 신호 반응이 커지는 변화는 앞선 연구들도 보고했다고 적었다. 반응의 시각이 사이를 거쳐 옮겨 가는 모습은 보이지 않았다는 것이다. 연구팀은 생쥐에서 도파민 신호의 시각이 여러 번에 걸쳐 점점 신호 쪽으로 옮겨 가는 모습을 보고했다. 같은 해 Jeong 연구팀의 생쥐 실험은 이 모습을 보지 못했고, 신호에 대한 반응이 배우는 동안 커지는 쪽으로 나왔다고 적었다.
이 단순한 계산은 원숭이 기록의 큰 모양을 따라간다. 다만 앞당긴 주스에서는 어긋났다. 봉우리가 사이를 거쳐 옮겨 가는 예측은 생쥐 실험끼리도 결과가 갈렸다.
이 설명이 도파민이 하는 일의 전부일까
2022년, 앞에서 본 Jeong 연구팀의 생쥐 실험이 이 설명의 예측과 반대되는 결과를 내놓았다. 이 연구팀은 신경세포의 신호 횟수를 세는 대신, 생쥐 뇌 깊은 곳에서 도파민이 나오는 양을 쟀다. 첫 시험에서는 실험을 한 번도 겪지 않은 생쥐 8마리에게 신호 없이 아무 때나 설탕물을 주었다. 연구팀은 보상 예측 오류 설명대로라면 실험 상황이 설탕물을 알리게 되어 거듭 받을수록 반응이 조금 줄어야 한다고 적었다. 그런데 받은 횟수가 늘수록 반응은 오히려 커졌다.
연구팀은 이런 결과들을 원인을 거슬러 추적하는 새 학습 설명으로 풀었다. 결론은 도파민 방출이 원인과 결과의 연결을 전하며, 보상 예측 오류는 전하지 않는다는 것이었다. 연구팀은 이 결과가 「보상 학습의 주류 이론에 도전한다(challenging the dominant theory of reward learning)」고 썼다. 원숭이 기록과는 동물도, 잰 양도, 과제도 다른 실험이다.
2024년에는 Gershman 등 7명이 쓴 관점 글이 나왔다. 이들은 원래 모양의 보상 예측 오류 설명이 「아마 너무 단순하다(probably too simple)」고 인정했다. 그러면서도 문제마다 알맞게 고치고 넓히면 각 도전에 답할 수 있다고 주장했다. Jeong 연구팀의 결과에 대해서는, 그 증거가 이 설명을 정말 반증하는지 따지려면 모형과 실험이 더 필요하다고 적었다.
2025년 Qian 연구팀은 같은 쟁점의 일부를 생쥐에서 다시 시험했다. 신호 없이 보상을 더 주면 신호에 대한 도파민 반응이 줄었지만, 더 주는 보상에도 신호를 붙이면 반응은 그대로였다. 연구팀은 이 결과가 원인을 거슬러 추적하는 설명과는 맞지 않고, 시도 사이 간격을 알맞게 나타낸 시간차 학습으로는 설명될 수 있다(can be explained)고 썼다.
Jeong 연구팀의 결과와 2024년 관점 글로 보면, 원래 모양의 설명은 도파민이 하는 일을 다 설명하지 못할 가능성이 크다. 이 설명을 받치는 결과도 쌓였다. 앞에서 본 Amo 연구팀의 생쥐 기록이 그렇다. 2013년 Steinberg 연구팀은 쥐가 보상을 받는 순간에 빛으로 도파민 뉴런을 켜서 예측 오류를 흉내 냈고, 그러자 신호를 보고 보상을 찾는 행동이 오래 늘었다. 연구팀은 이 자극만으로 배움이 생기기에 충분했다고 보고했다. 지금까지의 도전은 주로 생쥐에서 측정법을 바꾼 새 실험에서 나왔다.
같은 주스라도 조건에 따라 반응한 뉴런의 비율이 달랐다. 예상 못 한 주스는 과제 밖에서 아무 때나 준 것이고, 익숙한 신호는 원숭이가 고른 익숙한 그림이다. 예상 못 한 주스에는 원숭이 도파민 뉴런 넷 가운데 셋꼴(61개 가운데 45개)이 반응했고, 익숙한 신호 뒤에 온 주스에는 여덟 가운데 하나꼴(66개 가운데 8개)만 반응했다.
더 읽기
- 관련 글: AI 꼼수는 왜 나올까 — 보상 해킹 — AI가 시행착오로 배우는 방법의 기초를 풀었고, 이 글의 시간차 학습은 그런 방법 가운데 하나다.
- 관련 글: 징크스는 왜 생길까, 비둘기도 미신을 만든다 — 거기서는 먹이와 겹친 동작이 굳었고, 여기서는 먼저 배운 신호가 있으면 겹친 새 신호를 계산이 배우지 않는다.
- Schultz, Dayan, Montague (1997). A Neural Substrate of Prediction and Reward. Science 275.
- Hollerman, Schultz (1998). Dopamine neurons report an error in the temporal prediction of reward during learning. Nature Neuroscience 1.
- Montague, Dayan, Sejnowski (1996). A Framework for Mesencephalic Dopamine Systems Based on Predictive Hebbian Learning. Journal of Neuroscience 16.
- Sutton (1988). Learning to Predict by the Methods of Temporal Differences. · Sutton, Barto (2020). Reinforcement Learning, 15장.
- Schultz (2016). Dopamine reward prediction error coding. Dialogues in Clinical Neuroscience 18.
- Berridge, Robinson (1998). What is the role of dopamine in reward: hedonic impact, reward learning, or incentive salience? Brain Research Reviews 28.
- Jeong 외 (2022). Mesolimbic dopamine release conveys causal associations. Science 378.
- Amo 외 (2022). A gradual temporal shift of dopamine responses mirrors the progression of temporal difference error…. Nature Neuroscience 25.
- Gershman 외 (2024). Explaining dopamine through prediction errors and beyond. Nature Neuroscience 27.
- Qian 외 (2025). Prospective contingency explains behavior and dopamine signals during associative learning. Nature Neuroscience 28.
- Steinberg 외 (2013). A Causal Link Between Prediction Errors, Dopamine Neurons and Learning. Nature Neuroscience 16.