비서 문제는 후보를 한 명씩 순서대로 만나고, 한 번 지나친 후보는 되돌아가 뽑을 수 없는 상황에서 최선 한 명을 찾는 문제다. 앞 37%를 무조건 보내고 그다음 처음 나오는 "지금까지 최고"에서 멈추면, 후보가 몇 명이든 최선을 고를 확률이 약 37%로 거의 같아진다.
다섯 번째 집 앞에서

집을 보러 다니는 중이고, 오늘이 다섯 번째 집이다. 방금 본 집이 지금까지 중에 제일 낫다. 그런데 여기서 계약서에 도장을 찍으면 다음 집은 영영 못 본다. 하루만 더 생각해 보겠다고 말하면 이 집은 대개 다른 사람에게 넘어간다.
이런 결정에는 공통된 모양이 있다. 선택지가 한꺼번에 펼쳐지지 않고 하나씩 순서대로 온다. 지나친 것은 되돌릴 수 없다. 그리고 지금 보고 있는 것이 앞으로 올 것들보다 나은지는 알 길이 없고, 지금까지 본 것들 사이에서 몇 등인지만 안다. 순서대로 지원자를 만나는 면접, 주차장을 돌며 빈자리를 찾는 몇 분, 몇 달에 걸쳐 이어지는 소개팅도 구조가 같다.
그래서 질문은 하나로 좁혀진다. 몇 번째까지는 그냥 보고, 언제부터 잡아야 하나. 이 질문에는 후보가 몇 명이든 거의 같은 숫자 하나가 답으로 나온다.
37% 규칙 — 답부터
답을 먼저 적는다. 후보가 모두 n명이라면 앞의 37%, 그러니까 0.37n명은 무조건 지나친다. 그 사람들은 아무리 마음에 들어도 뽑지 않고 기준으로만 쓴다. 그 구간이 끝나면 규칙이 바뀐다. 지금까지 본 누구보다 나은 사람이 처음 나오는 순간 거기서 멈추고, 끝까지 그런 사람이 없으면 마지막 후보를 받는다.
이 규칙으로 최선 한 명을 정확히 집어낼 확률은 약 37%다. 후보가 10명이어도, 100명이어도, 1억 명이어도 이 확률은 거의 그대로다. 후보가 늘어날수록 그중 딱 한 명을 맞히기는 훨씬 어려워질 것 같은데, 실제로는 그렇지 않다.
37%라는 숫자는 e에서 나온다. e는 약 2.718인 수 하나이고, 1을 e로 나누면 0.368이 된다. 후보 n명 중 보내는 사람 수를 k라 하면, 보내는 비율 k/n과 최선을 고를 확률이 후보가 많아질수록 둘 다 이 값으로 다가간다는 것이 이 규칙의 결론이다.
왜 하필 중간쯤에 답이 있는지는 두 극단을 보면 짐작이 간다. 첫 번째 후보를 바로 잡으면 비교할 기준이 하나도 없어서 그냥 찍는 것과 같다. 반대로 거의 끝까지 보내고 나면 기준은 훌륭해진다. 대신 그 좋은 기준을 넘을 사람이 이미 지나가 버렸을 가능성이 커진다. 두 손해가 반대 방향으로 커지니 그 사이 어딘가에 봉우리가 하나 생긴다. 후보가 많아질수록 그 봉우리가 37% 자리로 굳는다.
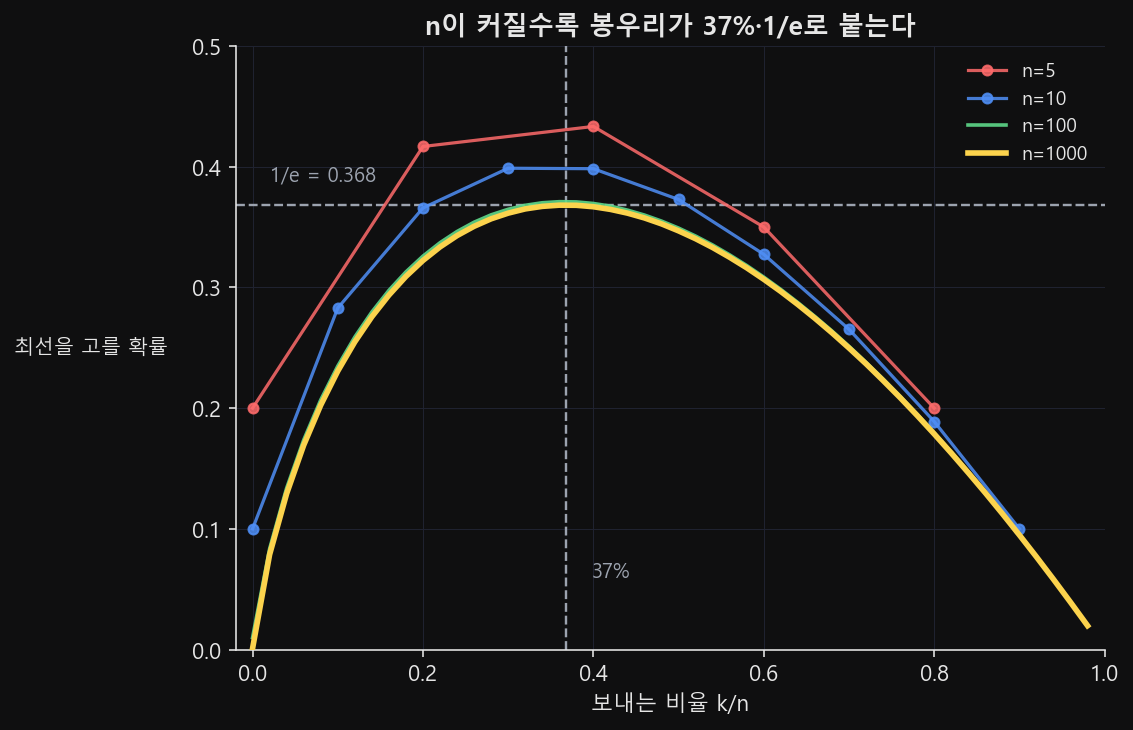
그림 1의 네 곡선이 식 1가 말하는 수렴을 그대로 보여준다. 후보가 5명일 때는 봉우리가 넓고 뭉툭하다. 1000명이 되면 37% 자리에서 뾰족하게 선다. 후보가 늘어날수록 봉우리의 위치도, 높이도 같은 값으로 모인다.
곡선은 여러 판을 평균 낸 이야기다. 규칙이 한 판에서 어떻게 돌아가는지는 후보 10명짜리 시행을 늘어놓고 보는 편이 빠르다. 이번에는 앞 3명을 보내고 그 뒤에서 고르는 규칙이다.
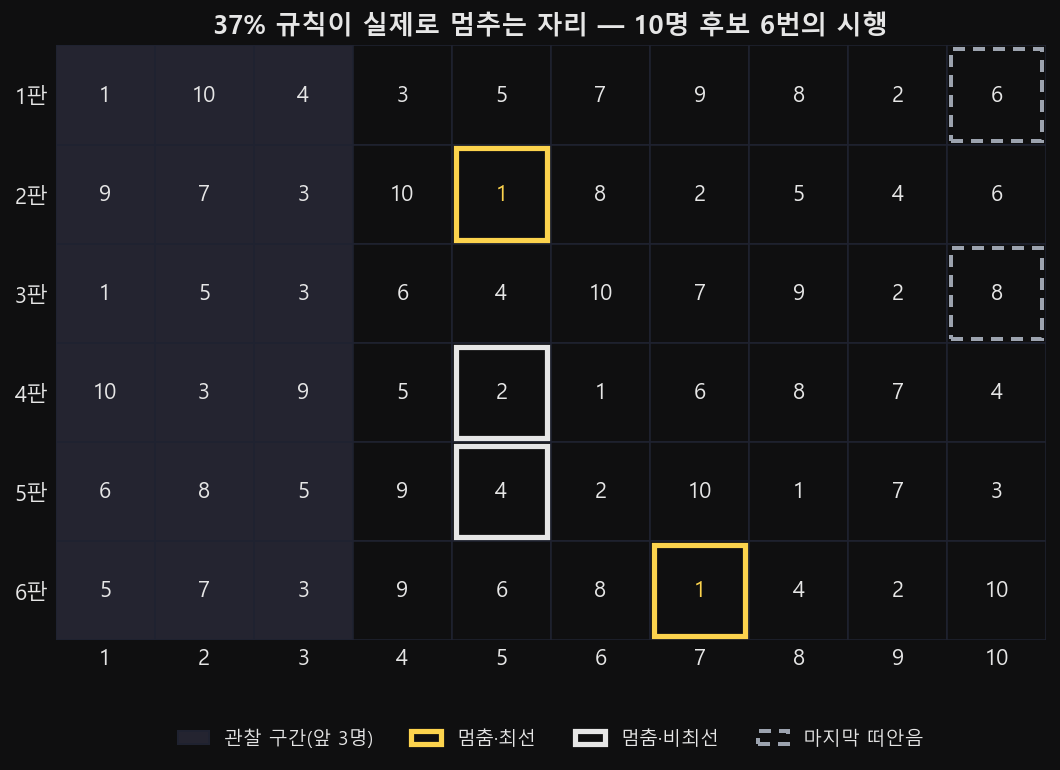
그림 2의 각 줄이 한 번의 시행이다. 앞 세 칸은 무조건 보내는 구간이라 회색이고, 그 뒤로 가면서 처음으로 기준을 넘은 칸에서 멈춘다. 기준을 넘는 사람이 끝내 안 나오면 마지막 칸을 그대로 받는다. 잘 멈춘 판과 최선을 놓친 판이 섞여 있는 것이 이 규칙의 정상 상태다.
같은 규칙을 후보 100명·앞 37명 보내기로 20만 번 돌려 보면 확률이 눈에 보인다. 규칙 그대로를 함수 하나에 옮겼다. 표준 라이브러리만 쓴 짧은 코드다.
import random

def one_run(n, k, rng):
    """앞 k명은 무조건 보내고, 그 뒤 '지금까지 최고'보다 나은 첫 후보에서 멈춘다."""
    ranks = list(range(1, n + 1))   # 1 = 최선
    rng.shuffle(ranks)
    best_seen = min(ranks[:k])
    for r in ranks[k:]:
        if r < best_seen:
            return r
    return ranks[-1]                # 끝까지 못 고르면 마지막 후보를 떠안는다

rng = random.Random(20260818)
n, k, trials = 100, 37, 200_000
picked = [one_run(n, k, rng) for _ in range(trials)]

print(f"최선을 고른 비율 : {picked.count(1) / trials:.4f}")
print(f"상위 10등 안     : {sum(r <= 10 for r in picked) / trials:.4f}")
최선을 고른 비율 : 0.3706
상위 10등 안 : 0.662320만 판 중 37.06%에서 진짜 1등을 집었고, 66.2%는 상위 10등 안에서 끝났다. 규칙도 확률도 여기서 이미 다 나왔다. 아래로 이어지는 이야기는 전부 이 37%가 언제 맞고 언제 어긋나는지에 대한 것이다.
37%는 언제 더 크고 언제 더 작을까
37%는 후보가 아주 많을 때의 극한값이지, 어떤 상황에나 꽂아 넣는 상수가 아니다. 후보가 적을 때는 성공 확률이 오히려 더 높다. 5명 중에 고를 때는 2명을 보내고 최선을 집을 확률이 43.3%, 10명이면 3명을 보내고 39.9%다. 100명에서 37.1%, 1000명에서 36.8%까지 내려가면서 아래로는 0.368을 뚫지 않는다. 선택지가 적을수록 규칙이 유리한 셈이다.
보내야 하는 비율 쪽은 사정이 다르다. 이쪽은 작은 후보 수에서 37%보다 크기도 하고 작기도 하다. 5명이면 2명이라 40%, 10명이면 3명이라 30%, 20명이면 7명이라 35%다. 사람 수는 정수라서 계산된 최적점을 반올림해야 하고, 그 반올림이 비율을 위아래로 흔든다.
봉우리 근처는 어차피 평평하다. 10명일 때 3명을 보내면 39.87%, 4명을 보내면 39.83%라 어느 쪽을 골라도 사실상 같다. 컷오프를 한두 명 어긋나게 잡아도 성공률은 별로 흔들리지 않는다. 그런데 이 성공률이 재고 있는 목표가 무엇인지는 한 번 더 볼 필요가 있다.
목표가 다르면 컷오프도 다르다
지금까지의 계산은 목표를 아주 좁게 잡은 결과다. 최선 한 명만 정답이고 2등을 뽑으면 꼴찌를 뽑은 것과 똑같이 실패로 친다. 현실의 집 구하기는 그렇지 않다. 2등짜리 집도 충분히 좋고, 8등짜리 집은 그것대로 아쉽다.
그래서 목표를 바꿔서 다시 계산해 본다. 뽑은 사람의 등수를 점수로 환산하고(최선이 1점, 꼴찌가 1/n점) 그 점수의 평균을 가장 높이는 컷오프를 찾는 것이다. 답이 확 앞으로 당겨진다. 10명이면 3명이 아니라 2명만 보고 잡는 쪽이 낫고, 100명이면 37명이 아니라 9명이다. 최적 컷오프가 대략 n의 제곱근 근처로 옮겨 간다.

그림 3에서 두 선이 벌어지는 폭이 목표의 차이다. 100명 중 37명을 보내면 평균 점수가 0.810이고, 9명만 보내고 잡으면 0.914다. 첫 사람을 무조건 잡는 극단은 0.505까지 떨어진다. 목표를 조금만 낮추면 훨씬 일찍 멈춰도 된다는 뜻이다. 그런데 원래의 37% 규칙에는 아직 말하지 않은 면이 하나 남아 있다.
규칙의 뒷면
37% 규칙에는 대칭인 뒷면이 하나 있다. 앞 37명을 보내고 나서 그 기준을 넘는 사람이 끝까지 한 명도 안 나오는 경우다. 이 일은 전체 1등이 앞 37명 안에 들어 있었다는 뜻이고, 그 확률은 37/100이다. 최선을 고를 확률과 아무도 못 고를 확률이 나란히 37%인 셈이다.
"37% 확률로 최선"의 뒷면은 "37% 확률로 마지막 후보"다. 규칙이 실패하면 남는 선택지가 마지막 한 명뿐이고, 그 사람의 등수는 완전히 운에 맡겨진다. 되돌아갈 수 없는 결정에서 이 규칙을 쓸 때는 실패했을 때 떠안을 것이 무엇인지 먼저 계산해 두는 편이 낫다.
실제 사람들은 이 규칙보다 일찍 멈추는 경향이 실험에서 보고돼 있다(Seale & Rapoport, 1997). 언뜻 보면 계산을 못 해서 손해를 보는 것처럼 읽힌다. 그런데 앞 섹션의 점수 목표를 놓고 보면 이야기가 달라진다. 목표가 "무조건 1등"이 아니라 "충분히 괜찮은 사람"이라면 이른 컷오프가 오히려 정답에 가깝다.
몇 명인지 몰라도 된다
여기까지는 후보가 몇 명인지 미리 안다고 두고 계산했다. 우리가 실제로 처한 상황은 대개 그렇지 않다. 이번 달에 매물이 몇 채나 나올지, 지원자가 몇 명이나 더 올지는 아무도 알려주지 않는다. 세어야 할 전체 수를 모르는데 그 37%를 어떻게 계산하나.
방법은 세는 대상을 바꾸는 것이다. 후보의 순번 대신 시간을 쓴다. 마감이 정해져 있다면 — 이사 날짜까지 두 달이라면 — 후보들이 대개 언제쯤 오는지를 기준으로 삼아, 그중 37%가 지나간 시점까지는 무조건 보기만 한다. 오는 시점이 기간 안에 고르게 흩어진다고 보면 첫 3주 남짓이 그 지점이다. 그 뒤로는 지금까지 본 누구보다 나은 사람이 나오는 순간 잡는다. 후보가 그 기간에 몇 명 오든 최선을 고를 확률은 1/e 아래로 내려가지 않는다. 다만 후보마다 오는 시점이 서로 영향을 주지 않고, 어느 때에 얼마나 몰리는지가 다들 같다는 전제가 붙는다 — 몇 명이 올지는 몰라도 되지만, 대개 언제쯤 오는지는 알아야 한다는 말이다. 브루스가 1984년에 증명한 1/e-법칙이다.
숫자로도 확인해 봤다. 후보 수를 1명에서 200명 사이에서 매번 새로 뽑았다. 각자의 도착 시각은 기간 안에 고르게 흩뿌렸다. 시각 37% 지점까지 관찰하고 그다음 최고에서 멈추는 방식으로 10만 번을 돌렸다. 최선을 고른 비율은 0.3675로 나왔고, 이론적 하한 0.3679와 사실상 같은 값이다.
다만 이 결과는 후보 수 분포를 저렇게 잡았을 때 하한에 거의 붙는다는 뜻이다. 어떤 상황에서나 정확히 37%가 나온다는 말은 아니다. 후보 수를 정확히 안다면 성공률은 그보다 조금 더 높다.
세는 대상이 사람 수에서 달력으로 바뀌었을 뿐, 규칙의 모양은 그대로다. 앞의 37%는 보내고, 그다음 최고에서 멈춘다. 후보가 몇인지 몰라도, 되돌아갈 수 없어도, 이 한 줄이면 최선을 고를 확률 37%쯤은 챙긴다.
더 읽기
- Secretary problem — Wikipedia — P(r) 식, 작은 n의 최적 컷오프 표, 변형 문제 정리
- Thomas S. Ferguson, "Who Solved the Secretary Problem?" Statistical Science 4(3), 1989 — 문제의 출처와 역사
- Darryl A. Seale, Amnon Rapoport, "Sequential decision making with relative ranks: An experimental investigation of the ‘secretary problem’" Organizational Behavior and Human Decision Processes 69(3), 1997, 221–236 — 실제 사람들이 이론보다 일찍 멈춘다는 실험 보고
- F. Thomas Bruss, "A Unified Approach to a Class of Best Choice Problems with an Unknown Number of Options" The Annals of Probability 12(3), 1984 — 1/e-법칙 원논문