유튜브 홈 화면이나 다음 영상 목록에 이미 조회수가 많은 영상이 또 떠 있을 때가 있다. 구글 연구진의 2019년 논문에 따르면, 예전 추천이 남긴 반응 기록을 그대로 배운 새 추천은 예전 추천이 많이 보여 줬다는 이유만으로 그 영상을 또 후보로 고른다. 기록마다 예전 추천이 그 영상을 얼마나 자주 보여 줬는지만큼 무게를 덜어 내자 그 쏠림이 줄었다. 예전 추천의 쏠림이 새 추천으로 넘어가는 이 일을 부익부(rich get richer) 현상이라고 한다.
유튜브 추천은 왜 많이 보여 준 영상을 또 보여 줄까
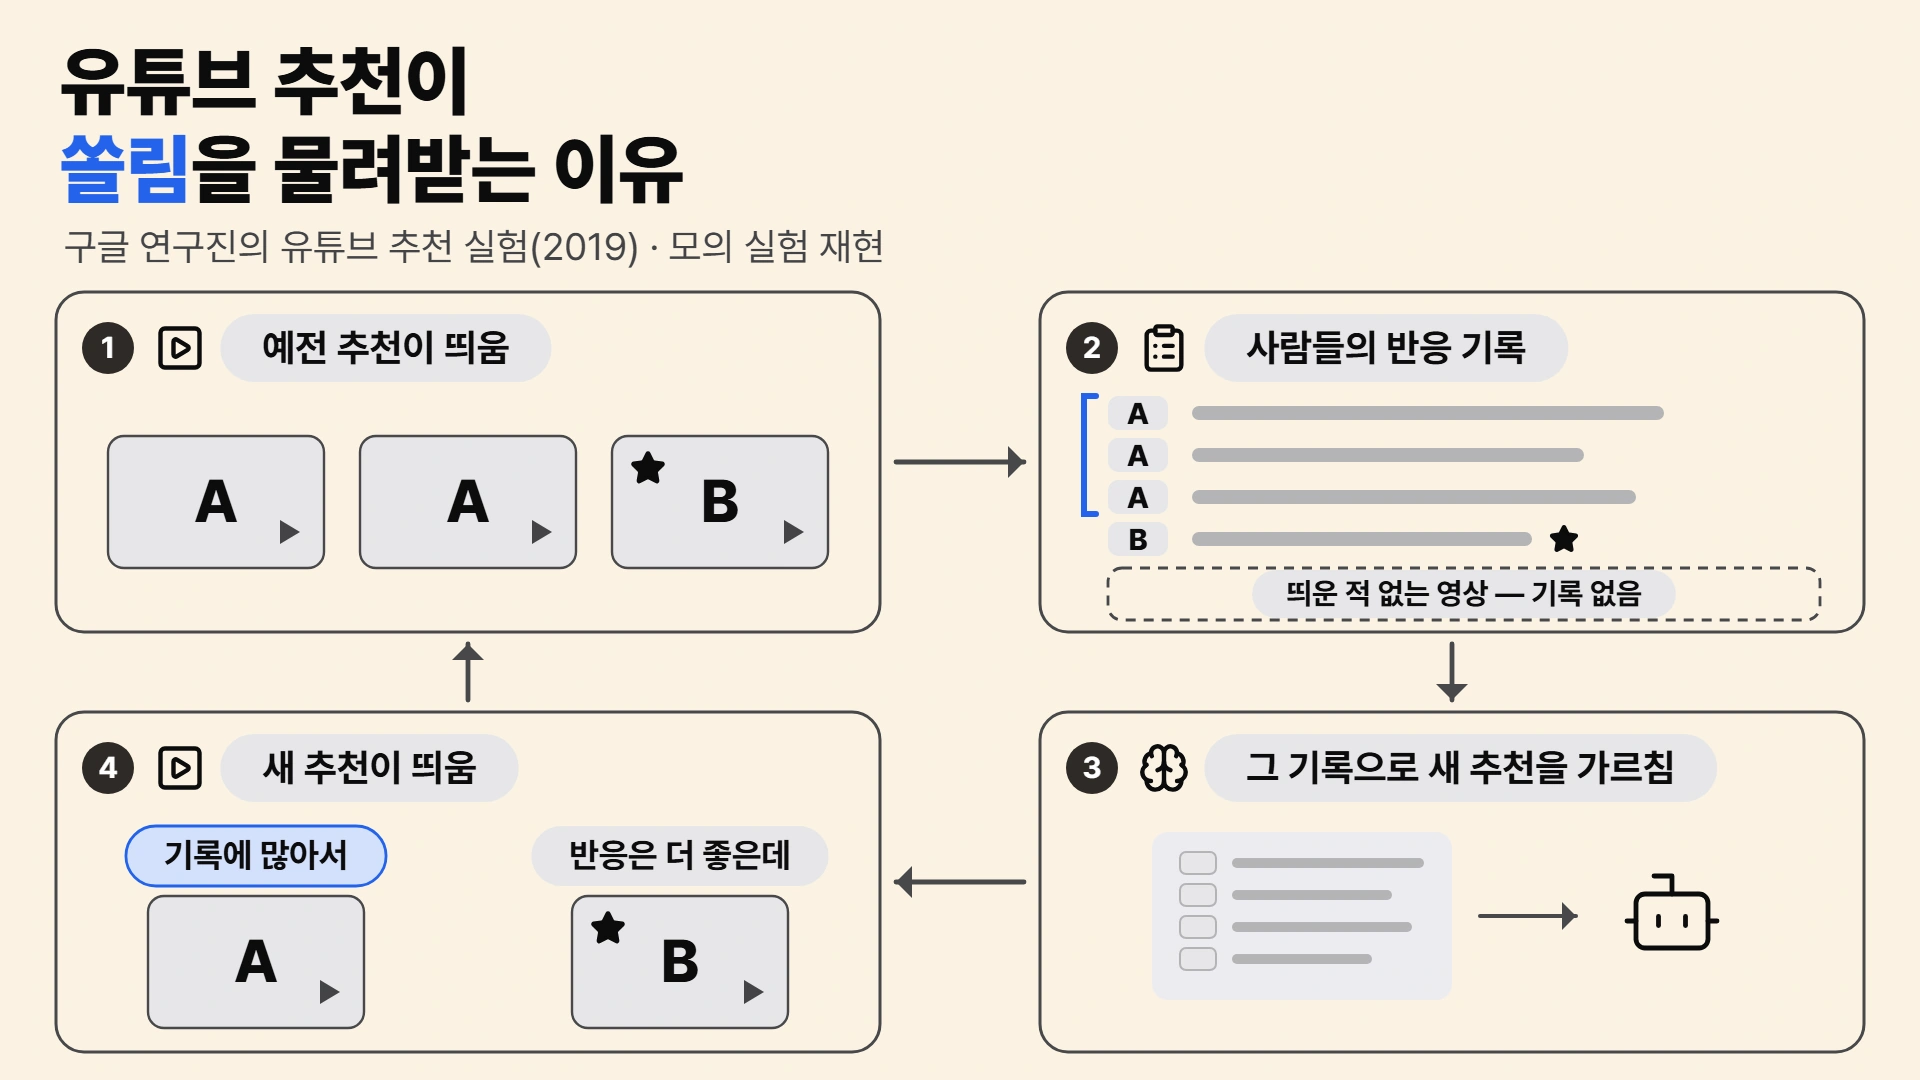
유튜브 홈 화면을 열면 어제도 본 듯한, 조회수가 이미 많은 영상이 또 맨 위에 와 있을 때가 있다. 한 편을 다 보고 나면 뜨는 다음 영상 목록에도 같은 영상이 다시 끼어 있다. 많이 보여 준 영상을 왜 또 보여 줄까.
주된 근거는 구글 연구진 Chen 외가 쓴 논문이다. 제목은 「Top-K Off-Policy Correction for a REINFORCE Recommender System」이고, WSDM 2019 학회 논문집에 실렸다. arXiv 에 처음 올라온 날은 2018년 12월 6일이다.
실험 대상은 유튜브 홈 화면과 시청 페이지 옆 목록에 들어갈 후보를 뽑는 모델이다. 논문에 따르면 이 모델은 여러 후보 생성기 가운데 하나이고, 뽑힌 후보는 별도의 순위 모델이 다시 매긴다. 라이브 실험을 언제 했는지는 논문에 없어서, 2018년 말 이전이라는 것까지만 말할 수 있다. 그래서 이 글은 지금 유튜브가 이렇게 추천한다고 말하지 않는다.
대신 논문에 나오는 작은 모의 실험을 PC 에서 다시 돌려 본다. 그 실험이 보여 주는 것은, 많이 보여 준 영상이 또 뜨는 일이 누가 인기 영상을 일부러 밀어서가 아니라 추천이 배우는 방식에서 생긴다는 점이다. 그러니 출발점은 「인기를 민다」가 아니라 「예전 기록으로 배운다」이다.
추천은 예전 추천이 남긴 기록으로 배운다
추천 모델은 실험 삼아 아무 영상이나 마구 띄워 보며 배울 수 없다. 그렇게 하면 시청자가 엉뚱한 영상을 잔뜩 보게 된다. 그래서 새 추천은 예전 추천이 실제로 띄운 영상에 사람들이 어떻게 반응했는지를 적은 기록으로 배운다. 눌렀는지, 눌렀다면 얼마나 봤는지가 그 반응이다. 이 반응을 점수로 바꾼 것을 보상이라 하고, 논문의 라이브 실험에서는 추천됐지만 눌리지 않은 영상의 보상이 0 이었다.
이 글에서 말하는 추천은 영상마다 고를 확률을 매기는 추천이다. 보상이 높게 기록된 영상일수록 고를 확률을 조금씩 올리는 식으로 배운다. 문제는 기록에 무엇이 들어 있느냐다. 예전 추천(논문 용어로는 행동 정책, behavior policy)이 띄운 적 없는 영상은 사람들이 반응할 기회조차 없었으니 기록에도 없다.
기록을 그대로 배우면 어떻게 될까. 예전 추천이 자주 띄운 영상은 기록에 자주 나오고, 그 반응은 그만큼 자주 학습에 들어간다. 그러면 새 추천 안에서 그 영상의 점수는 반응이 특별히 좋아서가 아니라 자주 띄워졌다는 이유로 쌓인다.
설명을 위해 숫자를 하나 지어내 보자. 예전 추천이 요리 영상 A 는 100번 띄워 30번 눌렸고, 여행 영상 B 는 10번 띄워 5번 눌렸다고 하자. 눌린 비율은 B 가 50%로 A 의 30%보다 높다. 그런데 기록에 남은 「눌렸다」는 A 가 30건이고 B 는 5건뿐이다. 기록을 한 건씩 그대로 배우는 새 추천에게는 A 가 여섯 배 좋은 영상처럼 보인다. 논문도 라이브 실험 결과를 풀이하며 같은 일을 짚었다.
While ignoring the bias in the data collection process creates a “rich get richer“ phenomenon, whereby a video is nominated in the learned policy simply because it was heavily nominated in the behavior policy, incorporating the off-policy correction reduces this effect.
데이터를 모은 과정의 쏠림을 무시하면, 예전 추천이 많이 후보로 올렸다는 이유만으로 새로 배운 추천도 그 영상을 후보로 올리는 「부익부」 현상이 생긴다. 그 쏠림을 되돌리는 보정을 학습에 넣으면 이 효과가 줄어든다.
Chen 외, WSDM 2019, §6.2.2답부터 말하면 이렇다. 기록을 그대로 배운 새 추천은 예전 추천이 많이 고른 쪽으로 끌려간다. 추천 분야에서 인기 편향이라 부르는 일과 비슷한 쏠림이다. 이 끌림은 기록마다 무게를 다시 매기면 줄일 수 있다. 무게는 새 추천이 그 영상을 고를 확률을 예전 추천이 그 영상을 고른 확률로 나눈 값이다.
다만 이 처방은 예전 추천이 한 번이라도 보여 준 영상에만 통한다. 이 조건은 논문의 문장이 아니라, 아래 모의 실험으로 확인한 이 글의 설명이다. 결국 쏠림은 누구의 의도가 아니라 기록이 생긴 방식에서 온다.
영상 10개로 다시 돌려 본 쏠림
논문의 첫 모의 실험은 아주 작다. 영상이 10개 있고 각 영상의 보상은 번호와 같아서, 10번이 가장 좋고 1번이 가장 나쁘다. 예전 추천은 거꾸로 낮은 번호를 자주 띄워서, 1번을 55번 중 10번 꼴로, 10번을 55번 중 1번 꼴로 띄운다. 1번이 10번보다 10배 자주 나오는 셈이다.
논문은 이 기록을 그대로 배운 새 추천이 각 영상을 「보상 × 예전 추천이 띄운 빈도」에 비례해 고르게 된다고 적었다. 우리가 무작위 순서를 바꿔 가며 20번(시드 20개) 돌려 평균을 내 보니, 결과는 그 식을 그대로 따랐다(그림 1). 가장 많이 고른 영상은 5번(13.8%)과 6번(13.5%)이었다. 식 값은 둘 다 3/22(약 13.6%)다. 보상이 가장 큰 10번은 4.5%로, 가장 나쁜 1번과 몫이 같았다.

그런데 가장 자주 띄운 1번이 1등이 되지는 않았다. 1번 역시 4.5%에 그쳤고, 보상과 빈도가 둘 다 중간인 5·6번이 이겼다. 그러니 이 모의 실험에서는 「많이 보여 준 것을 또 보여 준다」보다 「좋은 영상을 고르는 눈이 예전 추천의 빈도에 끌려간다」가 더 정확한 말이다. 기록을 그대로 배운 추천은 무엇이 좋은가와 무엇을 자주 띄웠나를 한데 섞어서 배운다.
논문은 이 모의 실험의 학습률·학습 횟수·시작값·반복 횟수를 적지 않았다. 그래서 학습률 0.001, 20만 번 학습, 모든 영상이 같은 확률에서 출발, 시드 20개는 우리가 정했다. 학습률은 한 번 배울 때 확률을 얼마나 고칠지를 정하는 값이다.
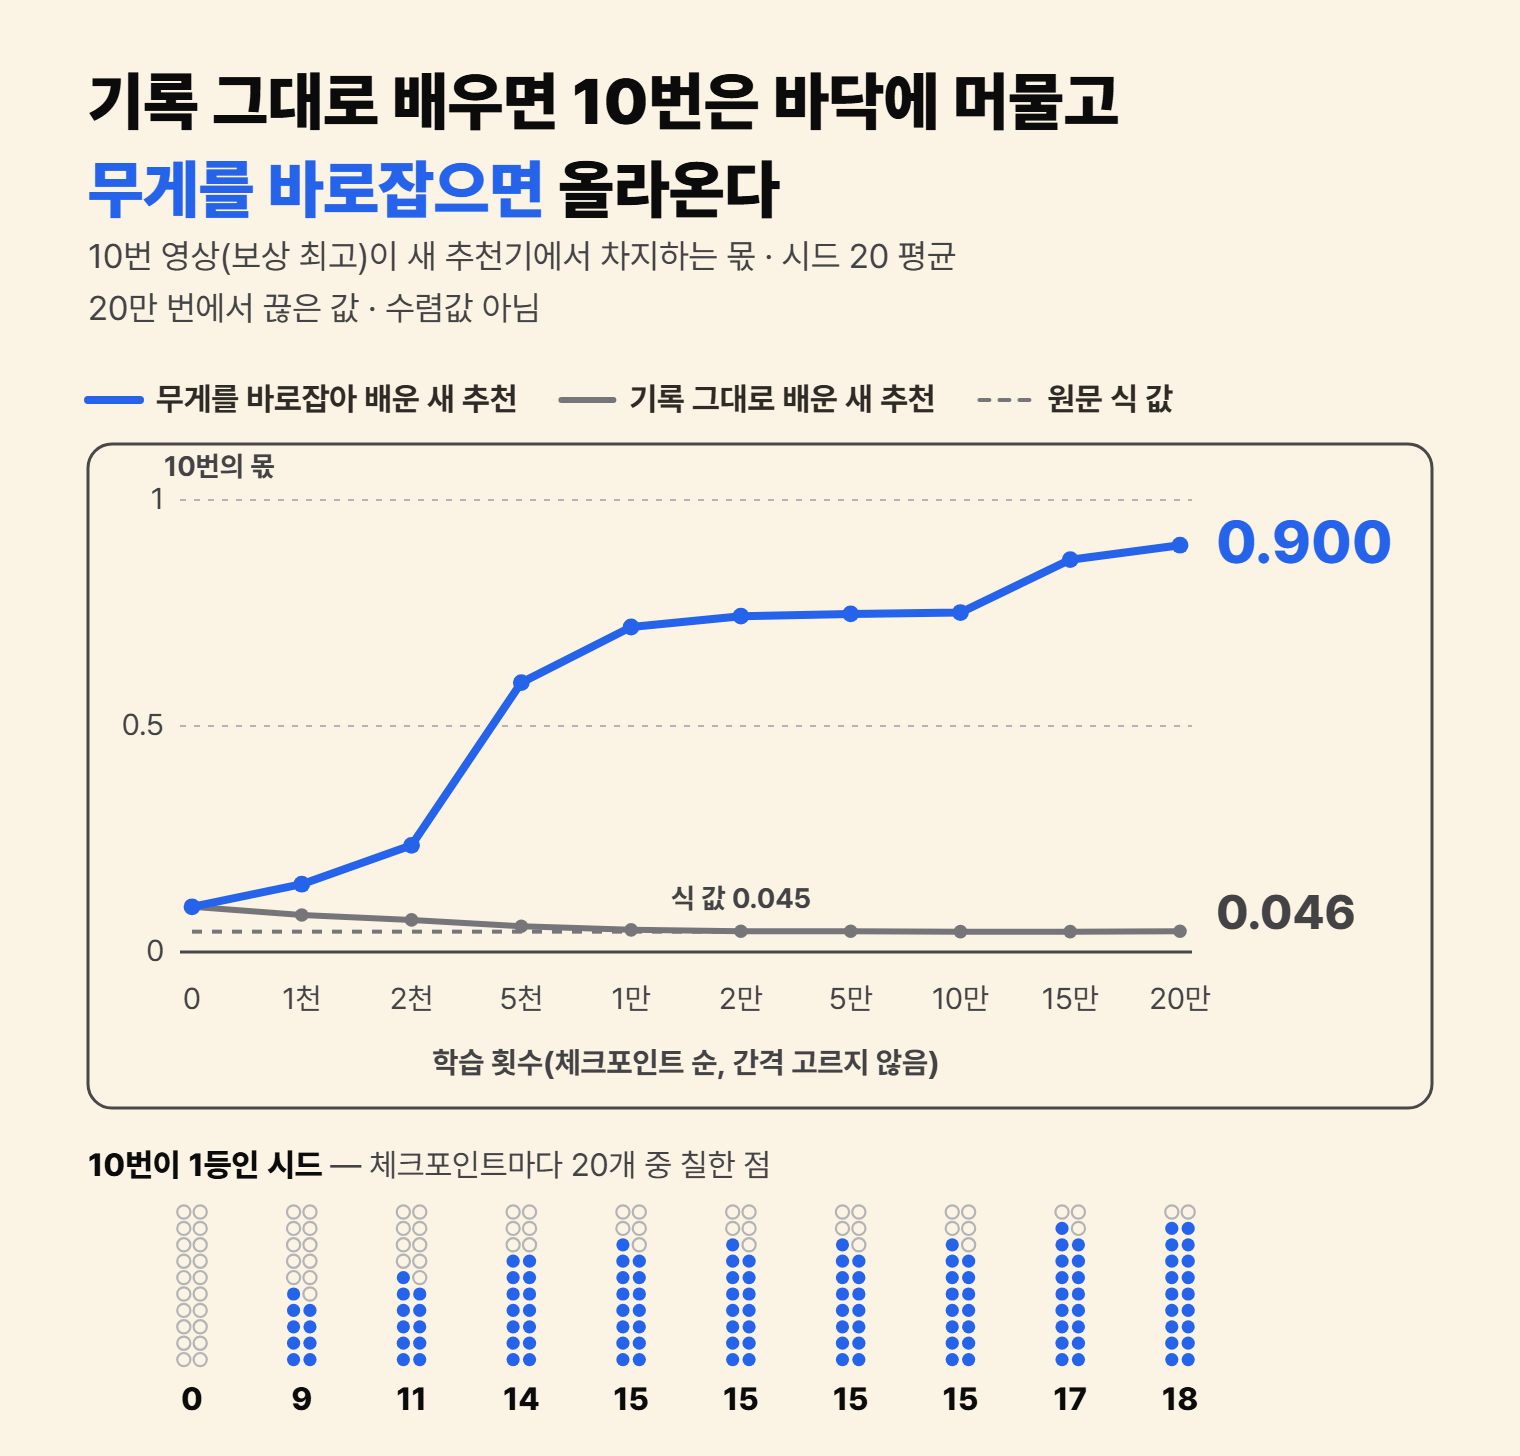
이번에는 기록마다 앞에서 말한 무게(새 추천의 확률 ÷ 예전 추천의 확률)를 곱해 배우게 했다. 20만 번 학습에서 멈췄을 때 10번의 몫은 평균 0.900 이었다. 시드 20개 가운데 18개는 10번이 1등이었고, 2개는 그 시점에 아직 9번이 1등이었다. 기록의 무게만 바꿨는데도 새 추천은 빈도가 아니라 보상을 따라갔다.
자주 띄운 기록일수록 가볍게 — 중요도 가중
앞의 요리 영상 A 와 여행 영상 B 에서 A 는 반응이 아니라 기록 수로 이겼다. 그렇다면 기록 한 건 한 건을 예전 추천이 그 영상을 띄운 확률로 나누면 된다. 자주 띄운 영상의 기록은 가볍게, 드물게 띄운 영상의 기록은 무겁게 치는 셈이다.
A 는 B 보다 10배 자주 띄웠으니 A 의 기록 한 건을 B 의 10분의 1 무게로 치면, A 의 30건은 B 의 3건 몫이 되어 B 의 5건보다 작아진다. 기록 수의 차이는 지워지고 반응의 차이만 남는다. 이런 셈을 중요도 가중(importance weighting)이라 한다.
나누기는 첫 단계다. 우리 재현에서 예전 추천의 확률로만 나눠 보니, 새 추천은 보상에 비례해 영상을 고르는 데서 멈췄다(10번 몫 0.189). 논문은 여기에 새 추천이 지금 그 영상을 고를 확률을 곱한 무게를 쓴다. 그러면 기록을 새 추천이 직접 띄워 모은 것처럼 셀 수 있어, 몫이 보상이 가장 큰 영상으로 모인다. 이 처방의 이름이 오프폴리시 보정(off-policy correction)이다.
학습이 진행되는 동안 10번 영상이 차지한 몫을 그림 2에 그렸다. 기록을 그대로 배운 쪽은 0.045 근처에 눕는다. 무게를 바로잡아 배운 쪽은 1만 번부터 10만 번까지 0.72~0.75 에서 평평하다가, 15만·20만 번에 한 칸씩 오른다. 이 계단은 배움이 천천히 진행된 흔적이 아니다. 아래 점 줄을 보면 10번이 1등인 시드는 1만~10만 번 내내 15개였다가 15만 번에 17개, 20만 번에 18개가 됐다. 9번에 붙잡혀 있던 시드가 하나씩 빠져나온 자리가 계단으로 보인 것이다.
한계도 있다. 같은 모의 실험에서 예전 추천이 10번을 한 번도 띄우지 않았다고 바꿔 보면, 보정을 넣어도 새 추천은 9번으로 간다(9번 몫 0.949). 나눌 기록 자체가 없기 때문이다. 이 변형 실험은 논문에 없고, 우리가 설명을 위해 돌린 것이다. 무게를 다시 매기는 보정은 기록에 있는 영상의 무게를 바로잡을 뿐, 기록에 없는 영상을 만들어 내지는 못한다.
한 화면에 여러 개를 띄울 때 — Top-K 보정
실제 홈 화면은 영상 하나가 아니라 여러 개를 한꺼번에 띄운다. 논문의 두 번째 모의 실험이 이 상황을 다룬다. 영상은 역시 10개인데, 이번에는 번호가 앞 절과 반대로 붙어 1번이 가장 좋다. 보상은 1번이 10, 2번이 9, 나머지는 모두 1 이다. 예전 추천은 10개를 고르게 띄우고, 새 추천은 한 번에 두 개를 추천한다.
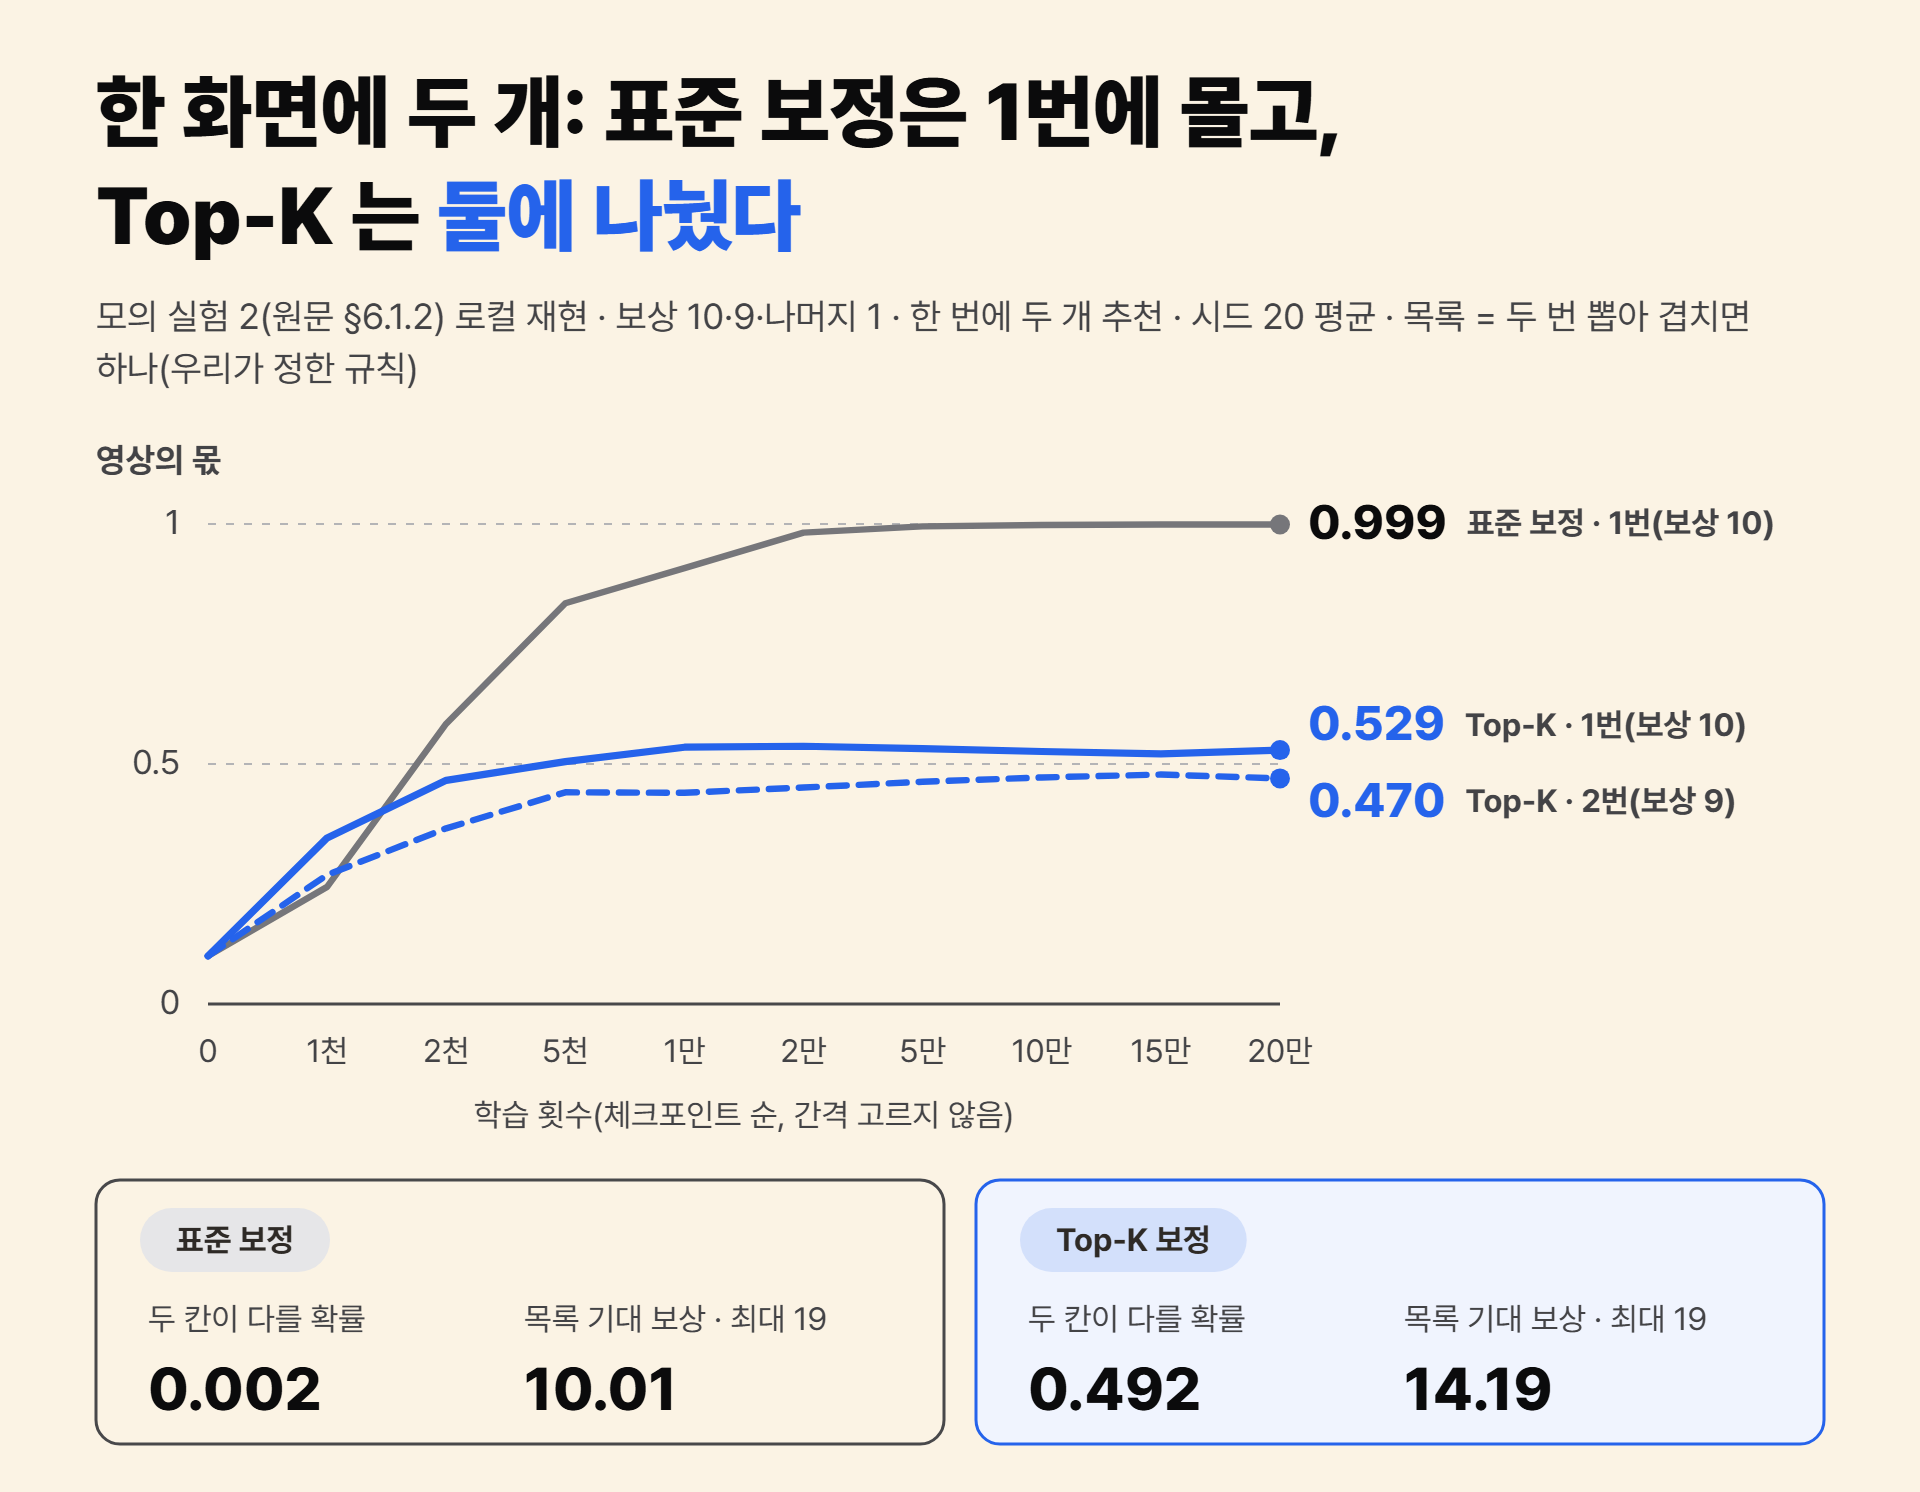
앞 절의 보정, 이 글에서 표준 보정이라 부르는 방식을 그대로 쓰면 새 추천은 1등 영상 하나에 몫을 거의 다 몬다. 우리 재현에서 1번의 몫은 0.999 였다(그림 3). 목록 규칙(두 번 뽑아 겹치면 하나로 친다)은 논문에 없어 우리가 정했다. 이렇게 두 칸을 뽑으면 거의 늘 1번이 두 번 나와, 두 칸이 서로 다른 영상일 확률이 0.002 에 그쳤다. 목록에 담기는 보상의 기댓값은 10.01 로, 최대 19 에 한참 못 미쳤다.
한 번에 K개를 고르는 화면에 맞춘 Top-K 보정은 여기에 규칙을 하나 더한다. 이미 목록에 들 만큼 몫이 오른 영상은 더 밀지 않는다. 이 보정으로 배우자 몫이 1번 0.529, 2번 0.470 으로 둘에 나뉘었다. 두 칸이 서로 다를 확률은 0.492, 목록 기대 보상은 14.19 로 올랐다. 여러 개를 띄우는 화면에서는 1등을 더 미는 것보다 좋은 영상 둘에 자리를 나눠 주는 쪽이 목록 전체로 더 낫다.
실제 서비스 실험이 바꾼 것과 못 바꾼 것
논문의 라이브 실험은 2018년 말 이전에, 여러 후보 생성기 가운데 이 모델 하나를 두고 단계별로 진행됐다. 저자들은 각 실험을 구성 요소 하나씩의 분석으로 따로 읽어야 한다고 적고, 실험마다 새 방법이 어느 추천기가 만든 기록으로 배웠는지를 밝혀 두었다. 첫 단계는 탐색이었다. 사용자를 90%·5%·5% 로 나누고 마지막 5% 에게는 확률에 따라 골라낸 추천을 보여 줘, 예전 추천이라면 고르지 않았을 영상의 반응도 기록에 들어오게 했다. 그 기록까지 학습에 넣은 모델을 쓴 쪽에서 시청 시간이 0.07% 늘었다. 우연으로는 생기기 어려운 크기의 차이, 곧 통계적으로 유의한 차이였다.
다음 단계가 앞에서 본 보정이다. 실제 서비스에서는 예전 추천이 그 영상을 고를 확률이 기록에 남아 있지 않았다. 기록을 만든 쪽도 추천기 여럿이 섞인 것이었다. 그래서 연구진은 같은 모델에 그 확률을 맞히는 출력을 하나 더 달았다. 기록된 선택들로 그 확률을 추정해 무게의 분모로 썼다.
이렇게 배운 모델은 보상으로만 무게를 준 대조 모델을 흉내 내지 않고, 대조 모델이 덜 올려 보던 영상을 더 많이 후보로 올렸다. 후보 추천 가운데 대조 모델의 상위 순위 밖 영상에서 나온 비율이 거의 세 배(「nearly a factor of three」)로 늘었다. 상위를 어디까지로 잡았는지는 논문에 없다. 실험군은 사용자 가운데 꽤 작은 일부여서, 학습에 쓰인 기록은 거의 전부 대조 모델이 띄운 추천에서 나왔다고 논문은 각주에 적었다. 새 모델은 거의 예전 추천이 만든 기록만으로 배우고도 그 쏠림을 덜 따른 셈이다. 다만 앞의 인용문도 이 효과가 줄어든다고 했지, 없어진다고 하지는 않았다.
그런데 시청 시간(ViewTime)은 대조군과 실험군 사이에 통계적으로 유의한 변화가 없었다. 본 영상의 수만 0.53% 늘었고, 이 차이는 유의했다. 저자들은 이를 사용자들이 더 즐기고 있다는 신호로 풀이했지만, 측정값이 아니라 저자들의 해석이다.
마지막 단계가 Top-K 보정이다. 한 번에 16개를 뽑는 설정(K=16)으로 바로 앞의 표준 보정 모델과 비교하자 시청 시간이 0.85% 늘었다. 본 영상 수는 0.16% 줄었다. 논문은 이 0.85% 가 통계적으로 유의했는지는 적지 않았다. 저자들은 여러 개를 함께 추천하는 화면이라, Top-K 보정이 표준 보정보다 페이지 전체로 더 나은 경험을 준다고 설명했다.
같은 쏠림을 다른 길로 다룬 예도 있다. Chen 외 논문의 공동 저자 Covington 이 제1저자인 2016년 논문이다. 이 논문은 추천이 낸 시청만이 아니라, 다른 사이트에 삽입된 영상까지 포함한 유튜브 전체 시청을 학습 재료로 썼다. 그렇게 하지 않으면 새 영상이 떠오르기 어렵고, 추천이 이미 반응을 아는 영상만 거듭 고르는 쪽(「exploitation」)으로 지나치게 치우친다는 이유였다. 다만 Chen 외 논문은 자기 설정이 이 논문 등에 적힌 설정과 비슷하다고만 적었다. 두 논문 모두 이 쏠림을 어떤 영상이 후보로 올라오느냐의 문제로 다룰 뿐, 추천이 사람들의 생각을 한쪽으로 몰아간다고 주장하지는 않는다.
자주 보여 준 영상의 기록일수록 무게를 덜 주면, 새 추천은 그 쏠림을 덜 물려받는다. 그것만으로는 시청 시간에 유의한 변화가 없었다. 보정 단계들 가운데서는 한 화면에 여러 개를 띄운다는 사실까지 반영한 다음 단계에서야 시청 시간이 늘었다는 보고가 나왔다. 인기 영상이 또 뜨던 그 홈 화면의 후보를 뽑는 자리에서, 보정을 넣은 모델은 대조 모델이 상위에 두지 않던 영상의 비율을 거의 세 배로 늘렸다.
더 읽기
- Minmin Chen, Alex Beutel, Paul Covington, Sagar Jain, Francois Belletti, Ed H. Chi, 「Top-K Off-Policy Correction for a REINFORCE Recommender System」, WSDM 2019 — https://arxiv.org/abs/1812.02353 · https://doi.org/10.1145/3289600.3290999
- Paul Covington, Jay Adams, Emre Sargin, 「Deep Neural Networks for YouTube Recommendations」, RecSys 2016 — https://doi.org/10.1145/2959100.2959190
- Cristos Goodrow, 「On YouTube’s recommendation system」, YouTube 공식 블로그 (2021) — https://blog.youtube/inside-youtube/on-youtubes-recommendation-system/