이미지 생성 AI 에 친구 다섯 명이 웃는 단체 사진을 부탁하면 얼굴들이 묘하게 닮아 나올 때가 많다. 연구자들이 같은 얼굴에 벌점을 주는 점수표로 AI 를 다시 가르치자, 사진 한 장 안만 살필 때는 같은 얼굴이 사라지지 않고 옆 사진으로 옮겨 갔다. 겹치는 얼굴만 벌주자 AI 는 사람을 덜 그려서 점수를 땄다. 이렇게 AI 가 부탁한 일 대신 점수만 따는 길을 찾아내는 일을 보상 해킹(reward hacking)이라고 한다.
AI 단체 사진에 같은 얼굴이 얼마나 자주 나오나
같은 얼굴을 그리지 말라고 점수를 매겼더니, AI 는 사람을 덜 그리는 쪽으로 점수를 땄다. 엉뚱하게 들리지만, 이미지 생성 AI 의 버릇 하나를 고치려던 연구에서 저자들이 직접 적어 둔 일이다. 가족 모임이나 동호회 단체 사진을 AI 로 만들어 보고 「다들 얼굴이 비슷한데?」 싶었다면 바로 그 버릇이다. 친구 다섯 명이 웃는 사진을 부탁했는데 그중 셋이 형제처럼 닮아 나오는 식이다.
이 연구를 낸 Qualcomm AI Research 연구팀은 여러 사람이 나오는 장면에서 이미지 생성 AI 가 저지르는 실수를 셋으로 꼽았다. 같은 얼굴을 되풀이하고, 두 사람을 한 사람처럼 섞고, 사람 수를 틀리는 것이다. 저자들은 이 실수들이 그림 전체의 품질이 높을 때도 남는다고 적었다. 이 글은 그중 첫째인 같은 얼굴을 따라간다.
그렇다면 이 버릇은 얼마나 흔할까. 연구팀은 논문 「Resolving the Identity Crisis in Text-to-Image Generation」에서 2~7명이 나오는 장면 1,200개를 만들고, 장면마다 보통 8~16장씩 여러 모델에게 그리게 했다. 그리고 사진마다 서로 닮은 얼굴 쌍이 하나라도 있는지를 셌다. 공개 모델과 상용 모델 9개 가운데 6개는 닮은 얼굴 쌍이 하나도 없는 사진이 절반이 안 됐다. 가장 높은 GPT-Image-1 도 85.1%에 그쳐, 100장 가운데 15장쯤에는 닮은 얼굴이 섞였다(그림 1). 막대 그림에서 회색 아홉 줄 가운데 여섯이 「절반」 점선에 못 미친다.

모델 이름은 논문 표기를 그대로 옮겼다. 논문에는 상용 모델을 언제 불렀는지도, 어떤 판이었는지도 적혀 있지 않다. 그래서 지금 쓰는 ChatGPT·Gemini 앱이 표의 모델과 같은지는 알 수 없다. 이 버릇이 왜 생기는지도 이 글은 다루지 않는다. 저자들은 기존 모델이 사실적이고 보기 좋은 사람을 그리는 데 주로 기대고, 서로 다른 사람을 그리는 일은 따로 챙기지 않는다고 서술했을 뿐 원인을 실험으로 가르지는 않았다. 같은 얼굴은 그림이 예쁜 최신 모델에도 흔히 남는 결함이고, 이 글은 그 버릇을 고치는 과정을 따라간다.
닮았는지는 숫자로 잰다 — 한 장 점수와 시험 전체 점수
두 얼굴이 닮았는지를 사람 눈 대신 기계로 재려면 얼굴을 숫자로 바꿔야 한다. 연구팀은 사진에서 얼굴을 찾아낸 뒤 얼굴마다 긴 숫자 목록을 만들었다. 두 목록이 얼마나 같은 방향을 가리키는지를 재는 값을 코사인 유사도(cosine similarity)라고 한다. 두 목록이 완전히 같은 방향이면 1이고, 서로 상관이 없을수록 0에 가까워진다. 연구팀은 이 값이 0.5 이상이면 두 얼굴을 「같은 사람」으로 쳤다.
이 「같은 사람」 판정 위에 점수가 둘 선다. 첫째 점수는 사진을 한 장씩 본다. 한 장 안에 같은 사람으로 판정된 두 얼굴이 하나도 없으면 그 사진은 통과다. 통과한 사진의 비율을 UFA(Unique Face Accuracy)라고 부른다. 4명짜리 사진 10장 가운데 7장이 통과하면 UFA 는 70%다. 앞 절에서 본 「닮은 얼굴 쌍이 하나도 없는 사진의 비율」이 바로 이 값이다.
둘째 점수는 시험 전체를 한꺼번에 본다. 여러 부탁으로 그린 시험 사진 전체에서 얼굴을 모두 모아 같은 사람끼리 묶는다. 그렇게 생긴 무리가 몇 개인지가 곧 서로 다른 사람의 수다. 그 수를 시험 전체에서 부탁한 인원의 합으로 나눈 값이 GIS(Global Identity Spread)다. 예컨대 시험 전체가 4명짜리 사진 10장인데 서로 다른 얼굴이 20명뿐이면, 부탁한 인원 40명 가운데 20명이라 GIS 는 50%다.
짚어 둘 점이 있다. 1,200개 장면으로 된 테스트와 두 점수의 계산 코드는 모두 저자들이 만들었고, 논문과 저자 공개 저장소 어디에서도 내려받을 수 없다. 논문은 CVPR 2026 에 채택됐다. 그래도 이 숫자들은 저자가 만든 시험지를 저자가 채점한 결과다. 저자들은 참가자 25명이 그림 22쌍을 견준 작은 조사에서 UFA 가 사람의 판단과 잘 맞았다고 보고했다. 이 조사도 저자들이 직접 했다.
두 점수는 서로 다른 것을 센다. UFA 는 한 장 안의 겹침만 보므로, 다른 사진에 같은 얼굴이 또 나와도 알아채지 못한다. GIS 는 시험 전체에서 서로 다른 얼굴이 몇 명이나 나왔는지를 본다. 그래서 「같은 얼굴」은 한 장 안의 겹침과 시험 전체의 서로 다른 얼굴 수라는 두 저울로 따로 재야 하고, 둘 중 하나만 좋아져도 다른 하나는 그대로일 수 있다.
점수표로 AI 를 다시 가르쳤더니
연구팀은 이 점수를 AI 를 고치는 데 썼다. 방법은 강화학습(reinforcement learning)이다. AI 에게 같은 부탁으로 그림을 여러 장 그리게 하고, 점수가 높은 그림 쪽으로 그리는 습관을 조금씩 옮긴다. 이것을 수없이 되풀이하면 AI 는 점수를 많이 받는 그림을 더 자주 그리게 된다. 정답 그림을 보여 주고 따라 그리게 하는 학습과 달리, 강화학습은 AI 가 직접 그린 그림에 점수만 매긴다. 강화학습에서는 이렇게 매기는 점수를 보상(reward)이라고 부른다.
연구팀은 같은 부탁으로 그린 21장을 한 묶음으로 삼아 점수를 매겼다. 여러 장을 한꺼번에 뽑는 까닭은 묶음 안에서 점수를 서로 견주기 위해서다. 같은 부탁에 대한 그림 가운데 점수가 나은 쪽과 못한 쪽이 있어야, 습관을 어느 쪽으로 옮길지 정할 수 있다. 이 21장 묶음은 학습 때 점수를 매기는 단위이고, 시험 전체를 한꺼번에 세는 GIS 와는 다르다.
눈여겨볼 점은 실제 사람 사진이 한 장도 쓰이지 않았다는 것이다. 저자들은 초록에서 이 방법이 "does not require any real data"(실제 데이터가 전혀 필요 없다)라고 적었다. 정답 사진을 보여 주는 대신 보상을 매기는 점수표만으로 가르친 셈이다. 연구팀은 Flux-Dev 와 Krea-Dev 두 공개 모델을 고쳤다. 점수표에 칸을 하나씩 더해 보며 칸이 늘 때마다 무엇이 바뀌는지 잰 실험은, 둘 가운데 학습이 더 까다로웠던 Krea-Dev 로 했다.
결과부터 말하면 세 가지가 드러났다. 첫째, 한 장 안의 겹침만 벌주자 UFA 는 45.8%에서 78.6%로 뛰었는데 GIS 는 50.6%에서 50.8%로 그대로였다. 같은 얼굴이 없어진 것이 아니라 옆 사진으로 옮겨 간 것이다. 둘째, 같은 단계에서 AI 는 사람 수를 줄여 점수를 땄고, 부탁한 인원을 정확히 그린 비율이 오히려 떨어졌다. 셋째, 둘 다 막으려면 한 장과 묶음을 함께 채점하고 사람 수도 세야 했다. 이 실험이 찾아낸 것은 같은 얼굴의 원인이 아니라 점수표가 놓친 자리들이고, 다음 세 절은 그 자리를 하나씩 따져 본다.
사람을 줄이면 왜 점수가 오르나
답은 UFA 의 정의 안에 있다. UFA 는 한 장 안에 같은 사람 쌍이 하나라도 있는지를 본다. 그런데 얼굴이 하나뿐인 사진에는 쌍 자체가 없어서, 그 사진은 따질 것도 없이 통과한다. 사람이 둘이면 겹칠 수 있는 쌍이 하나, 다섯이면 열 개다.
얼마나 쉬워지는지는 생일이 같은 두 사람이 있을 확률을 구하는 생일 문제와 같은 셈으로 확인할 수 있다. 실제 AI 가 이렇게 얼굴을 고른다는 뜻은 아니다. 점수가 사람 수에 어떻게 반응하는지만 보는 계산이다. 단골 얼굴 30명 가운데서 사람마다 무작위로 하나씩 고르는 기계라고 치면, 한 장에 겹치는 얼굴이 없을 확률은 다음과 같다.
from fractions import Fraction

# 가정: 단골 얼굴 30명 가운데서 사람마다 무작위로 고르는 기계 — 실제 AI 가 이렇게 고른다는 뜻 아님
K = 30  # 단골 얼굴 수

for n in range(1, 8):  # 한 장에 그리는 사람 수
    p = Fraction(1)
    for i in range(n):
        p *= Fraction(K - i, K)  # 앞사람들과 겹치지 않는 얼굴을 고를 확률
    print(f"{n}명: {float(p) * 100:5.1f}%")
1명: 100.0%
2명: 96.7%
3명: 90.2%
4명: 81.2%
5명: 70.4%
6명: 58.6%
7명: 46.9%같은 기계라도 7명이면 46.9%만 통과하지만, 1명이면 언제나 통과한다. 실제 실험도 같은 방향이었다. Krea-Dev 에 한 장 안의 겹침 벌점을 넣자, 부탁한 인원을 정확히 그린 사진의 비율이 73.6%에서 66.2%로 떨어졌다. 저자들은 이 현상을 이렇게 적었다.
Diversity optimization alone turns out to be gameable, as the model learns to generate fewer people and produce unnatural grid-like face arrangements that technically satisfy the reward while looking nothing like a real scene or following the prompt description.
다양성만 밀어붙이면 점수를 편법으로 딸 수 있다는 것이 드러났다. 모델은 사람을 덜 그리고 얼굴을 부자연스러운 격자처럼 늘어놓는 법을 배운다. 그런 그림은 점수 조건을 형식상 채우지만, 실제 장면처럼 보이지도 않고 부탁한 내용을 따르지도 않는다.
Borse 외, 「Resolving the Identity Crisis in Text-to-Image Generation」 서론(arXiv:2510.01399)부탁한 일 대신 점수만 따는 이런 길을 보상 해킹(reward hacking)이라고 하고, 저자들도 이 일을 그 이름으로 부른다. 논문 부록은 7명을 부탁했는데 5명만 그린 그림과, 얼굴을 격자처럼 늘어놓은 그림을 사례로 보여 준다. 둘 다 그림 사례라 얼마나 자주 그랬는지는 숫자가 없다. 거꾸로 GIS 는 그려진 얼굴 수를 세므로 사람을 줄이면 오히려 깎인다. 두 점수가 서로를 견제하는 셈인데, 이것은 두 정의를 맞대 본 이 글의 정리다. 사람을 줄이는 길은 AI 의 꾀라기보다 점수의 정의가 처음부터 열어 둔 지름길이다.
풍선 효과 — 같은 얼굴이 옆 사진으로 옮겨 간다
칸을 하나씩 더한 실험의 첫 단계에서 한 장 안의 겹침 벌점을 넣자, UFA 는 45.8%에서 78.6%로 뛰었다. 같은 단계에서 GIS 는 50.6%에서 50.8%로 거의 그대로였다. 저자들은 그 까닭을 같은 얼굴이 "simply spread across different images rather than being eliminated"(없어지지 않고 다른 사진들로 퍼졌을 뿐)라고 적었다.
앞 절의 장난감 기계로도 같은 모양이 나온다. 그림 2는 그 기계로 4명짜리 사진 6장을 세 가지 방식으로 그린 표본이다. 여기서는 기계가 같은 부탁으로 21장을 그린다고 치고, GIS 도 그 21장 묶음 안에서 센다. 그냥 고르면 UFA 기댓값이 81.2%다.
한 장 안에서만 겹치지 않게 고르면 UFA 는 100%가 된다. 그런데 GIS 기댓값은 33.6%에서 33.9%로, 약 34%에서 거의 움직이지 않는다. 한 장 안에서 피한 얼굴도 결국 같은 단골 30명 가운데서 다른 사진에 다시 뽑히기 때문이다.
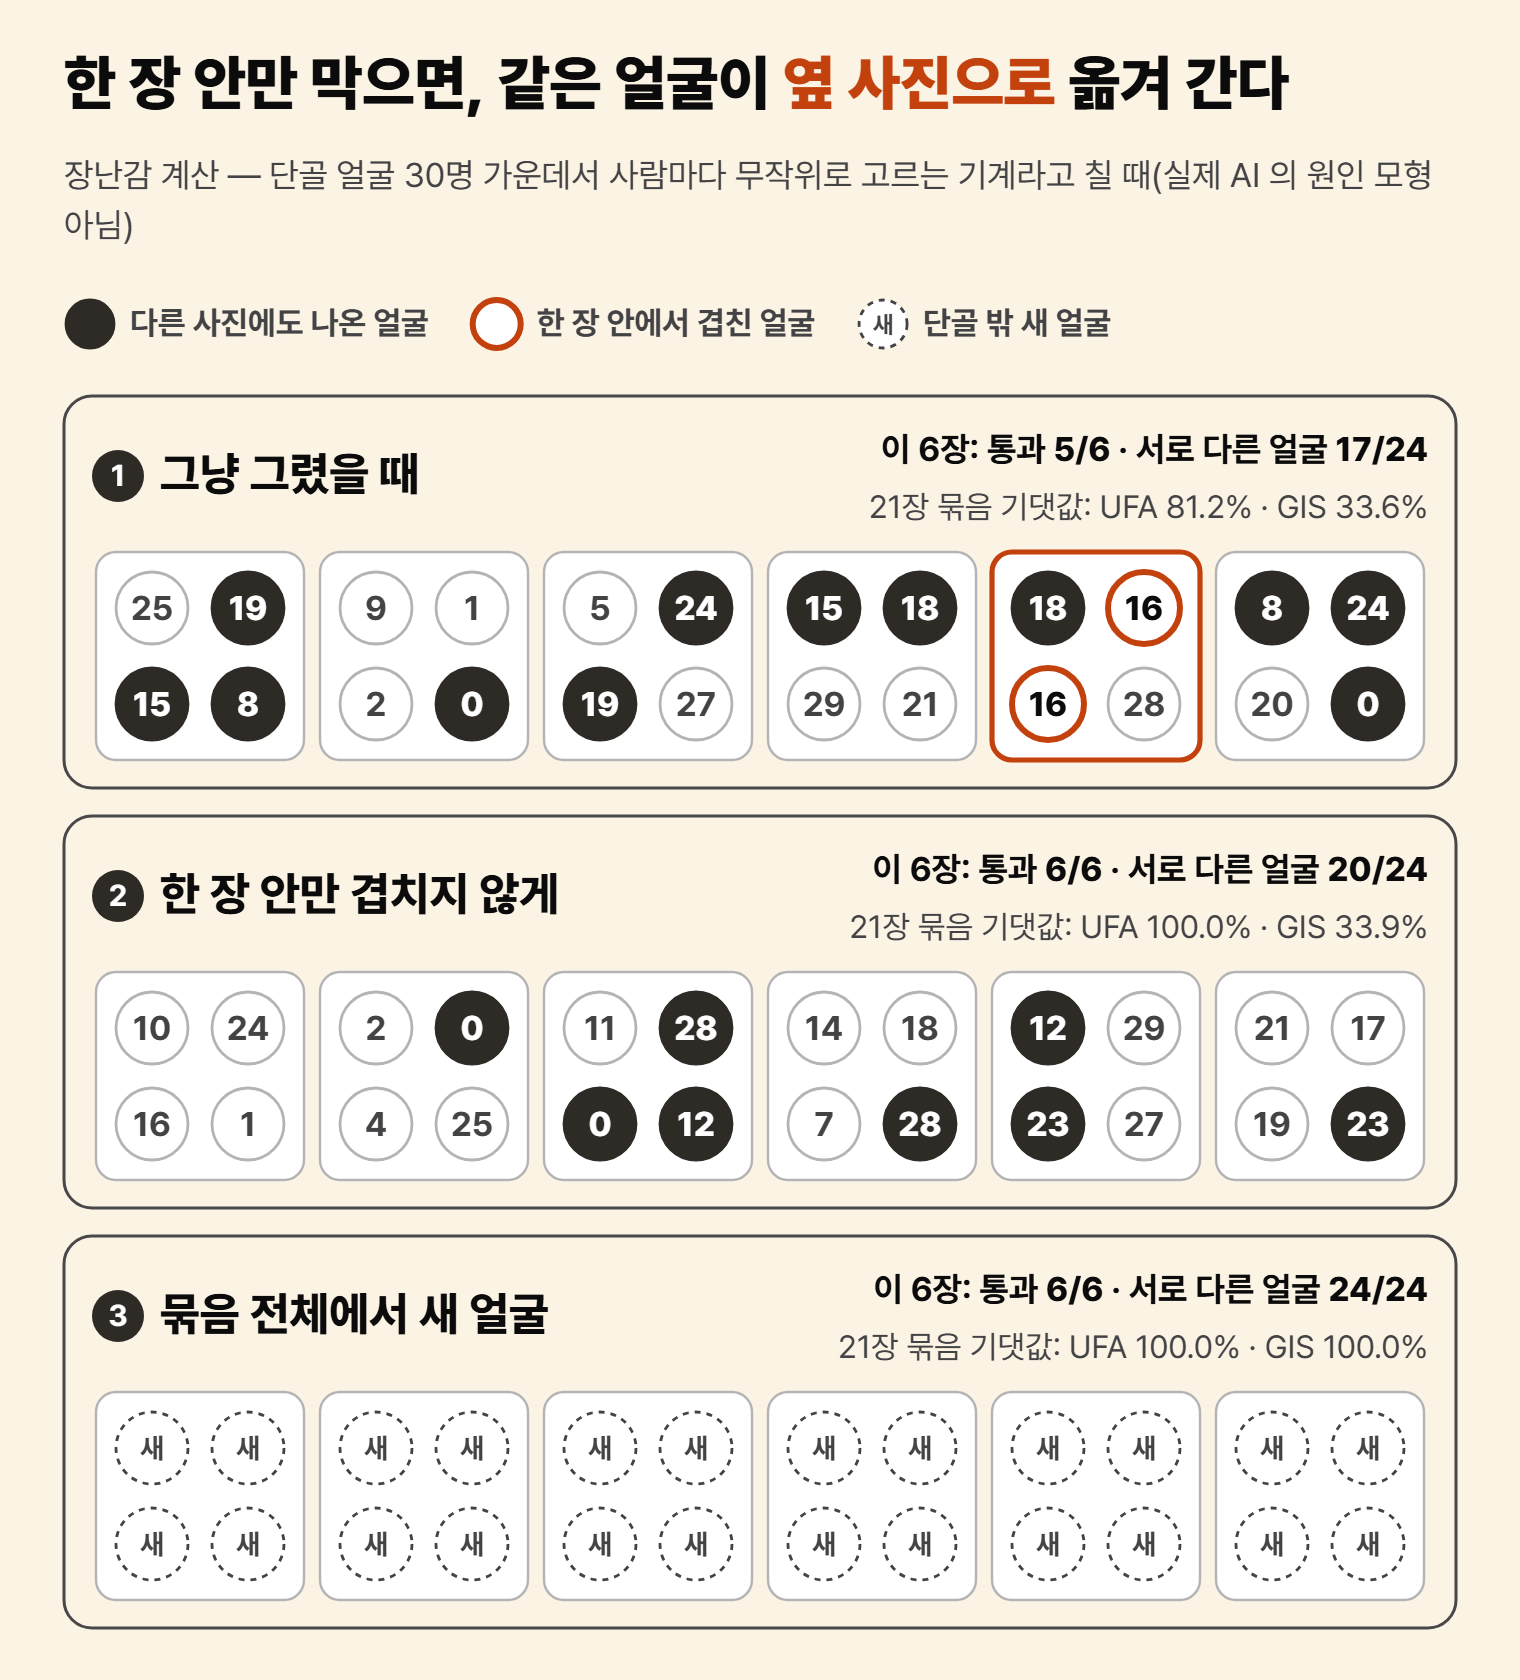
단골 안에서만 고르는 한 GIS 에는 천장이 있다. 21장에 4명씩이면 부탁한 인원은 84명인데, 서로 다른 얼굴은 많아야 30명이다. 그러니 한 장 안을 어떻게 고쳐도 GIS 는 30/84, 곧 35.7%를 넘지 못한다. 이 천장을 넘으려면 다른 사진과 겹치는 얼굴에 벌점을 주는 칸, 곧 묶음 칸이 따로 있어야 한다. 실제 실험에서도 묶음 칸을 더하자 GIS 가 50.8%에서 72.5%로 올랐다.
한 장만 보는 점수로는 같은 얼굴이 줄어든 것처럼 보인다. 하지만 여러 장을 함께 세면 서로 다른 얼굴의 수는 그대로이고, 같은 얼굴은 옆 사진으로 자리만 옮겼다. 정말 줄었는지는 여러 장을 함께 세어야 보인다.
점수표 네 칸, 칸을 더하자 다른 점수가 물러나기도 했다
연구팀이 마지막에 쓴 점수표는 네 칸이다. 첫째 칸은 한 장 안에서 가장 닮은 두 얼굴에 벌점을 준다. 둘째 칸은 같은 부탁으로 그린 다른 사진들과 얼굴이 겹치면 벌점을 준다. 셋째 칸은 그린 얼굴 수가 부탁한 인원과 맞으면 점수를 준다. 넷째 칸은 그림 품질 점수로, 앞에서 본 격자 배열처럼 눈에 띄게 어색한 그림을 깎는다.
칸을 더한다고 모든 점수가 함께 오르지는 않았다(그림 3). 점수 칸을 더한 네 단계 가운데 세 점수가 모두 오른 것은 묶음 칸을 더했을 때 한 번뿐이다. 나머지 세 단계에서는 다른 점수가 떨어졌다. 사람 수 칸을 더하자 사람 수를 맞힌 비율은 67.3%에서 81.1%로 올랐지만, GIS 는 72.5%에서 68.3%로 4.2%p 내려갔다.
그림 품질 칸을 더하자 GIS 는 다시 73.7%로 올랐다. 그 대신 사람 수를 맞힌 비율이 81.1%에서 79.2%로, UFA 가 83.2%에서 82.6%로 조금 물러났다. 저자들은 각 칸이 의미 있게 기여한다고만 적었다. 칸 하나가 빈틈 하나를 막는 동안 다른 점수가 밀려나기도 한 셈이다.
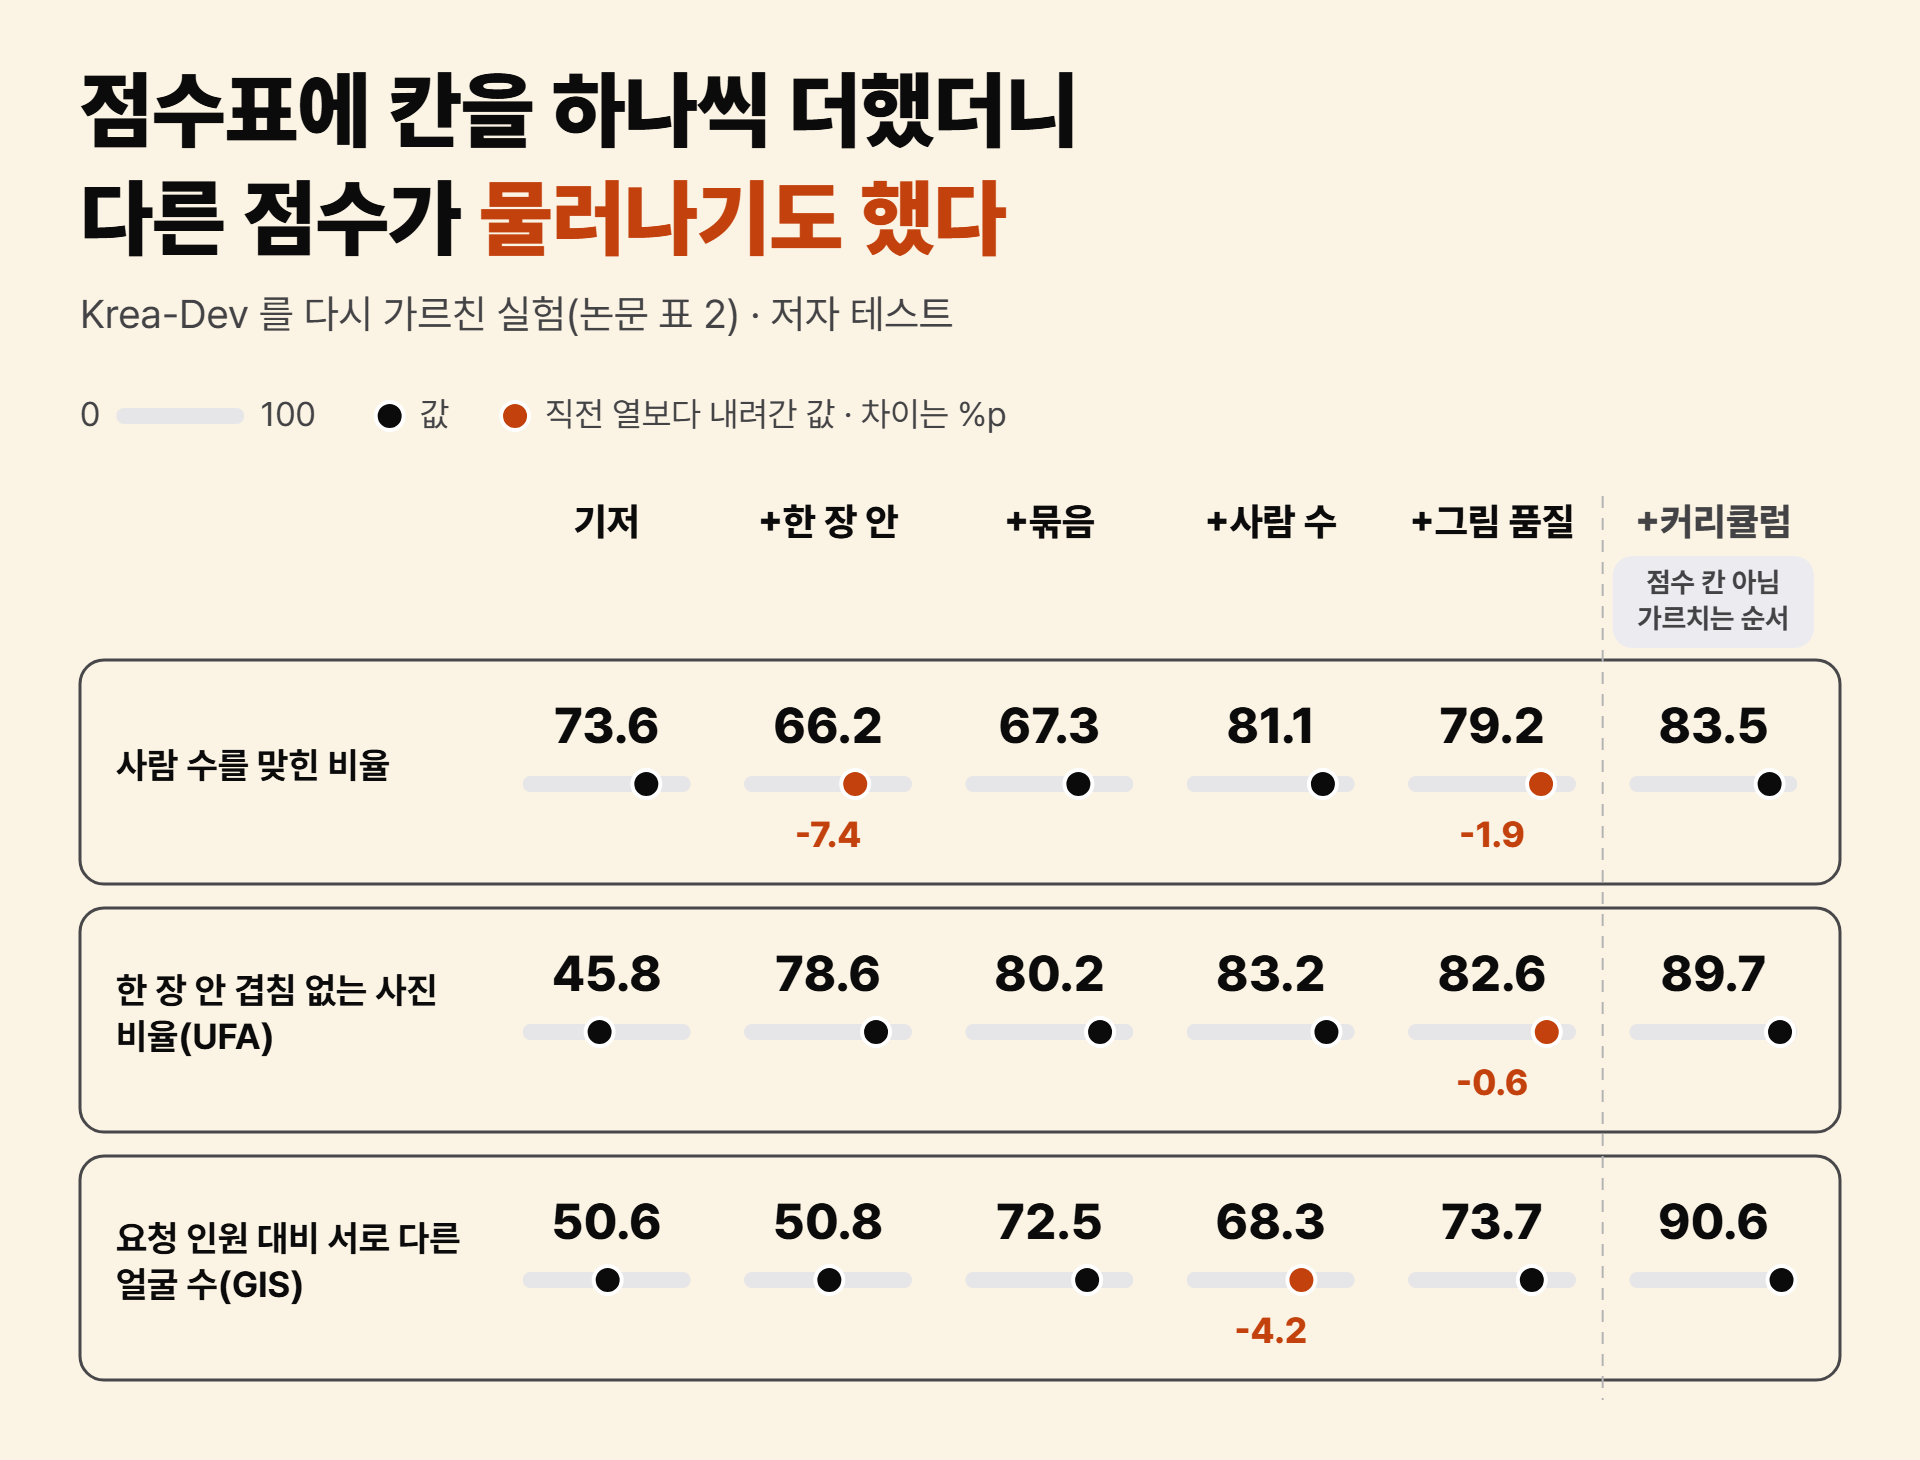
GIS 가 크게 오른 때는 두 번이다. 묶음 칸을 더했을 때 21.7%p, 그리고 커리큘럼을 더했을 때 16.9%p다. 커리큘럼은 점수 칸이 아니다. 처음에는 2~4명이 나오는 쉬운 장면부터 가르치고, 차츰 2~7명 전체를 고르게 섞어 가는 학습 순서다. 가장 크게 오른 두 번 가운데 한 번은 점수가 아니라 가르치는 순서에서 나온 것이다.
네 칸을 다 채운 모델, 그리고 점수표가 정한 것
네 칸과 커리큘럼을 다 넣은 모델은 그림 1 맨 위의 두 주황 막대다. 맨 위 DISCO(Flux)는 Flux-Dev 를 같은 방식으로 고친 모델이다. UFA 는 98.6%였고, 사람 수를 맞힌 비율도 92.4%로 원래 모델 가운데 가장 높았던 GPT-Image-1 의 90.5%보다 높았다. 둘째 DISCO(Krea)는 칸을 하나씩 더한 실험에 쓴 Krea-Dev 를 고친 모델이다. 바탕 모델(그림 3의 「기저」 열)이 다르니 두 값은 하나로 묶지 않고 따로 읽는다. 이 값들도 앞에서 말한 대로 저자가 만든 테스트를 저자의 점수로 잰 것이다.
남은 한계도 저자들이 적어 두었다. 얼굴이 많이 가려지거나, 자세가 극단적이거나, 얼굴이 아주 작으면 성능이 떨어질 수 있다. 학습 때 다루지 않은 8~10명 장면에서는 사람 수를 맞힌 비율이 Flux-Dev 와 DISCO(Flux) 모두 내려갔다. 다만 같은 장면에서 UFA 는 원래 Flux-Dev 가 크게 떨어진 반면 DISCO(Flux)는 높게 유지했다고 저자들은 보고한다.
이 글이 따라온 세 장면을 놓고 보면 공통점이 있다. 처음 두 장면의 빈틈은 점수의 정의 안에 이미 있었다. UFA 는 다른 사진을 보지 않으니, 같은 얼굴이 옆 사진으로 옮겨 가도 알아채지 못한다. 또 사람이 적을수록 한 장 점수를 따기가 쉬워진다. 하지만 AI 가 실제로 그 빈틈으로 갔다는 것은 정의가 아니라 표 2 의 실험값이 보여 준다. 사람 수를 맞힌 비율은 73.6%에서 66.2%로 떨어졌고, GIS 는 50.6%에서 50.8%에 머물렀다.
셋째 장면, 칸을 더하자 다른 점수가 물러난 일은 처음부터 실험 표에서 읽은 것이다. 그 까닭을 칸마다 세는 것이 다르다는 데서 찾는 것은 여기서 덧붙인 해석이다. 사람 수 칸은 머릿수가 맞는지만 묻고 얼굴이 새로운지는 묻지 않는다. 그림 품질 칸은 그림이 자연스러운지를 묻지 사람 수는 묻지 않는다.
Krea-Dev 를 고친 DISCO(Krea)는 같은 시험에서 사람 수를 맞힌 비율을 73.6%에서 83.5%로, UFA 를 45.8%에서 89.7%로, GIS 를 50.6%에서 90.6%로 올렸다. 그림 품질 점수도 31.2에서 32.2로, 고치기 전보다 낮아지지 않았다. 실제 사람 사진은 한 장도 보지 않았다. 바뀐 것은 점수표와 가르치는 순서뿐이고, 가르치는 순서는 같은 점수표를 얼마나 잘 따라가는지를 바꿨다. AI 가 무엇을 배우는지는 점수표가 무엇을 세는지가 정한다.
더 읽기
- Shubhankar Borse, Farzad Farhadzadeh, Munawar Hayat, Fatih Porikli(Qualcomm AI Research), 「Resolving the Identity Crisis in Text-to-Image Generation」, CVPR 2026 채택 — https://arxiv.org/abs/2510.01399
- DisCo 프로젝트 페이지 — https://qualcomm-ai-research.github.io/disco/
- 저자 공개 저장소(추론·데모 코드만, 학습·점수 계산 코드 없음) — https://github.com/Qualcomm-AI-research/disco