오답에 감점이 없는 시험에서 모르는 문제를 빈칸으로 남기는 사람은 드물다. 챗봇도 모르는 것을 물으면 「모르겠다」 대신 그럴듯한 답을 내놓는데, 고장이 아니다. AI의 성적을 매기는 주요 시험 대부분이 정답에만 점수를 주고 「모르겠다」에는 0점을 매겨서, 일단 답하고 보는 쪽이 순위표에서 앞선다. 이렇게 그럴듯하지만 틀린 답을 내놓는 일을 환각(hallucination)이라고 한다.
모르는 문제는 찍는 게 낫다
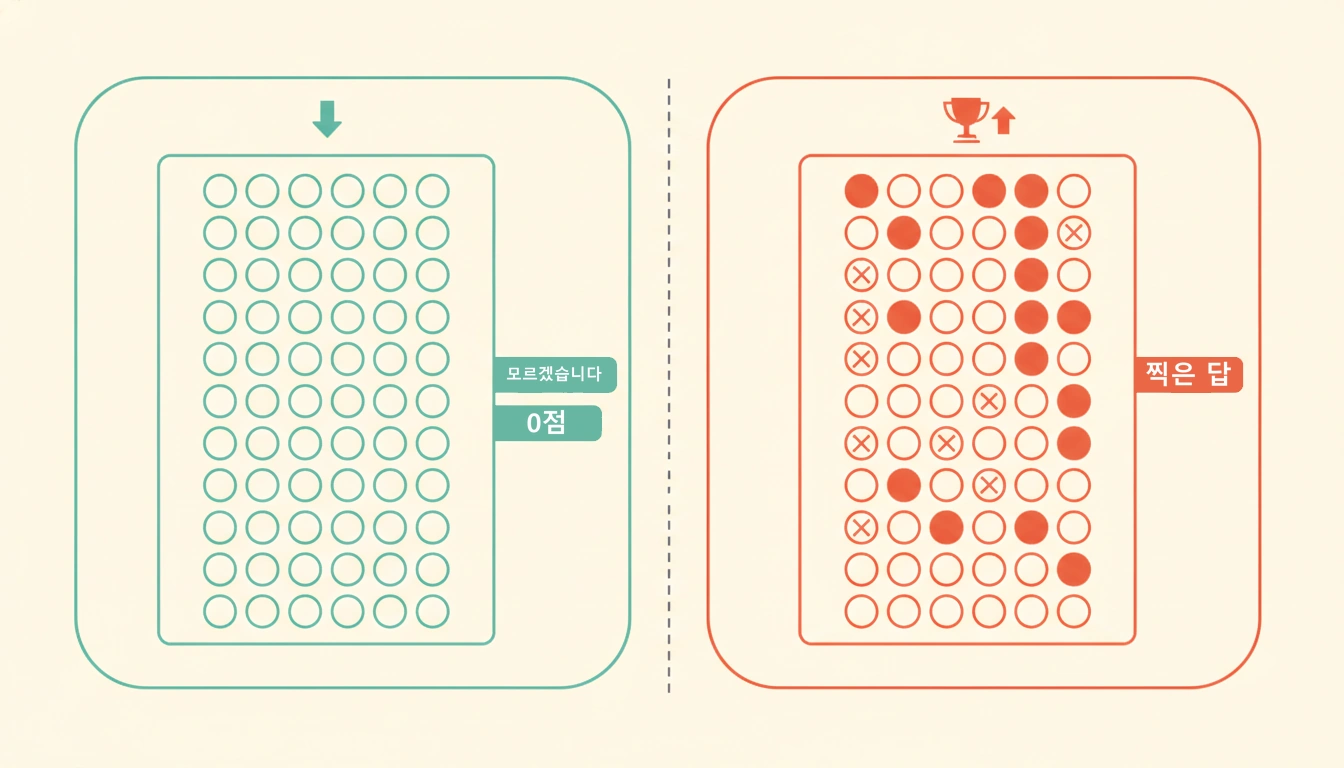
시험 종료 5분 전, 손대지 못한 문제가 몇 개 남았다. 오답에 감점이 없는 시험이라면, 그 칸을 비워 두는 것은 그냥 0점을 받겠다는 뜻이다. 찍으면 네 개 중 하나는 맞고, 틀려도 잃을 점수가 없다. 챗봇에게 모르는 것을 물었을 때 그럴듯한 오답이 돌아오는 장면도 여기서 멀지 않다.
챗봇에게 묻는 것들은 대개 사소하다. 처음 듣는 약 이름의 부작용, 오래된 영화의 감독, 논문 한 편의 저자. 돌아오는 답은 대개 매끄러운 문장이라, 틀렸다는 사실은 따로 찾아봐야 드러난다. 확인을 건너뛰면 그 답은 그대로 어딘가에 실린다.
그렇게 실린 답이 미국 법원의 서면에까지 올라간 적이 있다. Roberto Mata 가 아비앙카(Avianca) 항공을 상대로 낸 손해배상 소송이었다. 원고 측 변호인이 법원에 낸 서면에는, 상대편 변호인이 아무리 뒤져도 나오지 않는 판례가 여럿 들어 있었다. 확인 끝에 ChatGPT 가 만들어 낸 것으로 확정된 가짜 판결은 여섯 건이었다.
2023년 6월 22일, 뉴욕 남부연방지방법원의 Castel 판사는 변호사 두 명과 그들이 속한 로펌에 5,000달러의 제재금을 물렸다. 연대로 물린 금액이니 셋이 함께 책임진다. ChatGPT 를 쓴 변호사는 심문에서, 그것이 판례를 지어낼 수 있다고는 생각하지 못했다고 말했다.
판결문은 첫 문단에서, 믿을 만한 인공지능 도구를 보조로 쓰는 것 자체에 본래 부적절한 데는 없다고 적는다. 다만 제출물이 정확한지 확인하는 문지기 노릇은 여전히 변호사의 몫이라고 못 박는다. 법원이 문제 삼은 것은 확인 의무였다.
Technological advances are commonplace and there is nothing inherently improper about using a reliable artificial intelligence tool for assistance. But existing rules impose a gatekeeping role on attorneys to ensure the accuracy of their filings.
Mata v. Avianca, Inc., Opinion and Order on Sanctions (2023-06-22)이 사건은 논문에 나오는 예가 아니라 이 글이 고른 예다. 뒤에서 읽을 논문과, ChatGPT 를 만든 회사인 OpenAI 가 쓴 해설 글에는 법정 이야기가 아예 없다. 두 문헌이 다루는 것은 훨씬 건조한 질문이다. 모르는 것을 그럴듯하게 채워 넣는 일이 왜 이렇게 흔한가.
답은 성적을 매기는 방식에 있다. 그 방식이 어떤 것인지는 100문항짜리 시험 한 장으로 그대로 볼 수 있다. 챗봇처럼 답을 만들어 내는 프로그램을 모델이라고 부른다. 의심할 자리는 모델이 아니라 그 모델이 치르는 시험의 채점표다.
100문항 시험으로 보는 셈법
네 개 보기 중 하나를 고르는 문제 100개짜리 시험을 떠올려 보자. 60문항은 확실히 알고, 40문항은 전혀 모른다. 오답을 적어도 점수가 깎이지 않는, 흔한 객관식 채점 방식이다.
여기서 할 수 있는 선택은 둘이다. 모르는 40문항을 전부 찍거나, 전부 「모르겠습니다」로 남기거나. 답을 적지 않고 넘어가는 쪽을 기권이라고 한다. 어느 쪽이 유리한지는 기대 점수로 따진다. 기대 점수는 한 번의 운이 아니라, 같은 시험을 여러 번 치렀을 때 평균적으로 받게 될 점수다.
찍는 쪽부터 세어 보자. 모르는 40문항을 다 찍으면 네 개 중 하나꼴로 맞으니 10문항을 건지고, 나머지 30문항은 틀린 답이 된다. 이미 아는 60문항에 그 10문항을 더하면 70점이다. 전부 「모르겠습니다」로 남기면 아는 만큼인 60점이고 틀린 답은 하나도 없다. 아래 다섯 줄이 이 셈을 그대로 옮긴 것이다.
known, unknown, p = 60, 40, 1/4   # 아는 문항 60, 모르는 문항 40, 찍어서 맞힐 확률 1/4

guess = known + unknown * p       # 모르는 40문항을 전부 찍는다
abstain = known                   # 모르는 40문항을 「모르겠습니다」로 남긴다

print(f"찍기: {guess:.0f}점, 틀린 답 {unknown * (1 - p):.0f}개")
print(f"기권: {abstain:.0f}점, 틀린 답 0개")
찍기: 70점, 틀린 답 30개
기권: 60점, 틀린 답 0개찍는 쪽이 70점, 비우는 쪽이 60점이다. 점수 차는 10점이고, 답안지에 남는 틀린 답은 30개와 0개다. 점수만 적힌 순위표는 그 30개를 보지 않는다.
챗봇의 성적도 이렇게 매겨진다. 모르는 질문에 「모르겠습니다」라고 답한 모델과 그럴듯한 문장을 적어 낸 모델을 나란히 채점하면, 정답에만 점수가 붙는 한 뒤쪽이 앞선다. 이렇게 그럴듯하지만 사실이 아닌 답을 내놓는 일을 환각(hallucination), 음차해서 할루시네이션이라고 부른다. 이 글에서는 「환각」으로 쓴다.
실제로 그렇게 채점하는지 세어 본 논문이 있다. Kalai 를 비롯한 네 사람이 2025년 9월에 낸 「Why Language Models Hallucinate」다. 논문은 앞머리에 틀리는 모양을 보여 주는 예부터 싣는다.
저자들은 자기들 가운데 한 사람의 박사논문 제목을 서로 다른 모델 셋(ChatGPT·DeepSeek·Llama)에 한 번씩 물었다. 셋은 서로 다른 제목을 하나씩 내놓았고, 셋 다 틀렸다. 답이 비어 있거나 뭉개진 것이 아니다. 제목처럼 생긴 문장이 또박또박 나왔고, 맞는지는 원래 논문을 찾아봐야 알 수 있었다.
논문은 널리 쓰이는 평가 10종을 놓고, 각각이 기권을 어떻게 다루는지 하나씩 확인했다. 그중 아홉은 답을 정답과 오답으로만 가린다. 이 아홉에서 「모르겠다」는 아무 점수도 받지 못한다. 나머지 한 종은 부분 점수를 주지만, 그 채점 기준에서는 「모르겠다」가 틀린 내용이 섞인 그럭저럭한 답보다 낮은 점수를 받을 수 있다고 논문은 단서를 단다. 2025년 6월에 확인한 순위표를 기준으로 한 조사다.
이 채점이 사소해 보이지 않는 이유는 순위표에 있다. 새 모델이 나오면 이런 평가 점수로 줄을 세우고, 다음 모델은 그 줄에서 위로 올라가도록 만들어진다. 채점 방식이 그대로면 다음 모델도 같은 방향으로 다듬어진다. 논문은 이것을 평가와 순위표가 함께 만든 상황으로 본다.
즉 모르는 것을 모른다고 말하는 모델은 그 말이 정확할 때조차 0점을 받는다. 순위표는 그런 모델을 아래쪽에 앉힌다. 채점표가 이런 모양인 한, 모른다고 말하는 정직함은 점수로 돌아오지 않는다.
성적표에 숨은 두 번째 숫자
OpenAI 는 자기네 두 모델의 성적을 함께 놓은 비교표를 해설 글에 실었다. 짧은 사실 질문을 모아 놓은 평가 SimpleQA 를 웹 검색 없이 푼 결과다. 정확도와 오답률, 답을 내지 않은 비율이 나란히 적혀 있다.

그림 1에서 정확도만 보면 두 모델은 거의 같다. gpt-5-thinking-mini 가 22%, o4-mini 가 24%다. 정확도만 적힌 성적표라면 o4-mini 가 근소하게 앞선다. 오답률로 옮겨 가면 26%와 75%, 세 배 가까이 벌어진다.
이 차이는 답을 내지 않고 넘어간 비율, 곧 기권율에서 온다. o4-mini 가 답을 내지 않은 비율은 1%로, 사실상 물어본 것마다 답을 적었다. gpt-5-thinking-mini 는 그 비율이 52%였다. 거의 다 답한 o4-mini 는 정답을 2%포인트 더 얻었고, 오답은 49%포인트 더 냈다.
정확도는 두 모델을 거의 같게 보이게 하지만, 두 모델이 한 일은 전혀 같지 않다. 한쪽은 절반 넘게 빈칸으로 두었고, 다른 쪽은 거의 다 채웠다. 「정확도 몇 %」 한 줄에서 빠져 있는 것이 정확히 이 두 번째 숫자다.
채점표를 바꾸면 셈법이 바뀐다
그런데 이 셈은 채점표 한 줄로 뒤집힌다. 앞의 100문항 시험에 틀린 답 하나마다 1점을 깎는 규칙을 더해 보자. 모르는 40문항을 전부 찍으면 10문항쯤 맞고 30문항을 틀린다. 60점에 10점을 더하고 30점을 빼서 40점, 전부 비운 쪽은 그대로 60점이다.
감점을 9점으로 올리면 찍는 쪽은 −200점까지 내려간다. 네 개 중 하나를 찍는 문항에서는 감점이 3분의 1점일 때 찍는 쪽과 비우는 쪽이 같아진다. 찍어서 얻는 10점과 틀려서 잃는 10점이 맞물리는 지점이다. 그보다 크면 비우는 쪽이 앞선다.
실제 시험은 아는 문항과 모르는 문항 둘로 깔끔하게 갈리지 않는다. 문항마다 확신의 정도가 다른데, 여기서 확신은 그 문항을 맞힐 가능성을 말한다. 확신이 70%인 문항은 열 번 풀면 일곱 번 맞는다는 뜻이다. 답하지 않고 넘어간 문항은 어느 채점표에서든 0점이다.
문항 100개의 확신이 0%에서 100% 사이에 고르게 퍼져 있다고 두자. 셈을 보려고 우리가 만든 가정이다. 겨룰 정책은 셋인데, 정책이란 언제 답하고 언제 넘어갈지 미리 정해 둔 규칙이다. 무조건 답한다, 반 넘게 확신할 때만 답한다, 열에 아홉 확신할 때만 답한다.
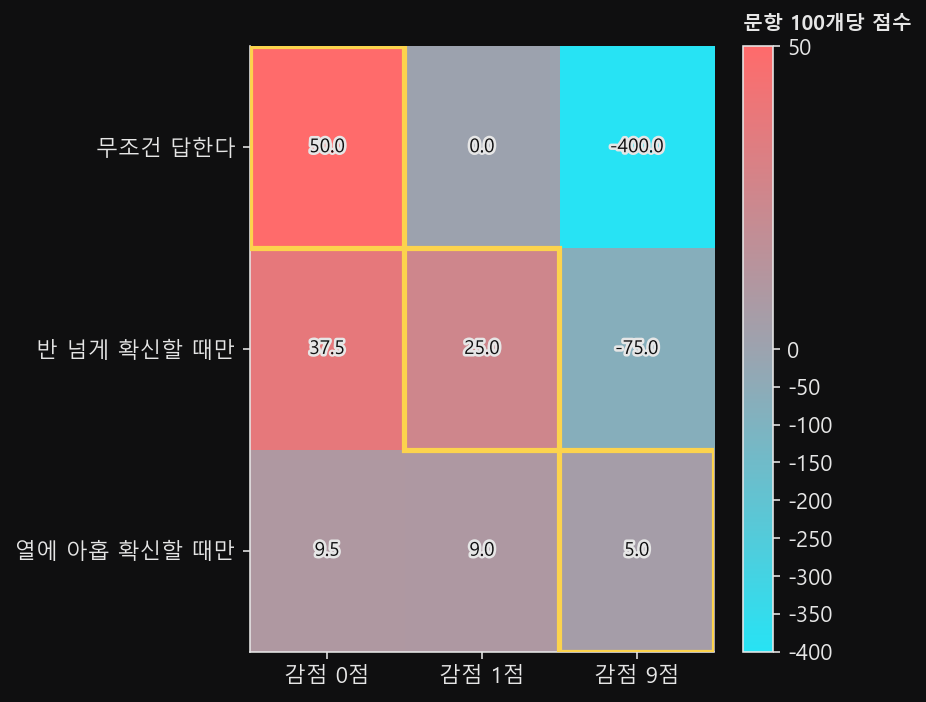
그림 2의 가로는 오답 감점이고 세로는 정책이다. 감점이 0점인 열에서는 무조건 답하는 정책이 50.0점으로 1등이다. 확신을 따지지 않고 다 답하면 절반쯤 맞으니 50점이라는 뜻이다. 감점 1점에서는 1등이 25.0점을 받은 「반 넘게 확신할 때만」으로 내려간다. 9점에서는 무조건 답하는 정책이 −400.0점까지 떨어지고, 5.0점을 받은 「열에 아홉 확신할 때만」만 양수로 남는다. 1등 칸이 대각선을 따라 내려가는 만큼, 가장 유리한 정책도 한 칸씩 신중해진다.
논문의 제안이 정확히 이 조정이다. 환각을 재는 시험을 하나 더 만들자는 것이 아니다. 순위표를 지배하는 평가들의 채점표를 고치고, 그 기준을 문제에 함께 밝히자는 것이다.
논문이 예로 적어 둔 지시문은 이런 뜻이다. 확신 기준을 넘을 때만 답하고, 틀리면 점수를 깎고, 「모르겠다」는 0점이다. 답하는 쪽과 채점하는 쪽이 같은 기준을 보게 된다.
Answer only if you are > t confident, since mistakes are penalized t/(1 − t) points, while correct answers receive 1 point, and an answer of “I don’t know” receives 0 points.
깎는 점수가 곧 답할지 말지를 가르는 선을 정한다. 1점을 깎는 채점표에서는 확신이 절반을 넘을 때부터, 9점을 깎는 채점표에서는 열에 아홉을 넘어야 답하는 쪽이 이득이다. 논문이 든 예는 셋이고, 그 가운데 둘이 이것이다. 앞 그림에서 감점 1점 열의 1등이었던 「반 넘게 확신할 때만」, 9점 열의 1등이었던 「열에 아홉 확신할 때만」이 바로 이 두 기준이다.
오답 감점이 충분히 크면 모른다고 말하는 쪽이 점수에서도 이긴다. 확신 기준을 높게 잡을수록 그 차이는 더 벌어진다. 모델도 문제도 그대로인데, 점수를 매기는 방식 하나를 고쳤더니 유리한 쪽이 뒤바뀌었다.
성적표를 읽는 법
AI 성적표에 필요한 숫자는 셋이다. 정확도와 틀린 답을 낸 비율, 그리고 답을 내지 않은 비율이다. 기권 비율이 아예 없는 표라도, 정답·오답·기권 셋으로만 나눈 평가라면 100에서 정확도와 오답률을 빼서 채울 수 있다.
이 숫자들은 멀리 있지 않다. 새 모델이 나올 때마다 회사가 내놓는 소개 글과 기술 문서에 평가 표가 붙고, 제품 소개 자료에도 「정확도 몇 %」가 큼직하게 박힌다. 그 표에 줄이 하나뿐이면, 그 모델이 모를 때 무엇을 하는지는 아직 아무것도 말해 주지 않은 것이다.
이 답이 닿는 범위도 그어 두자. 논문은 환각이 원리상 피할 수 없다고 말하지 않는다. 모르면 기권하는 모델은 얼마든지 만들 수 있다고 오히려 정면으로 적는다. 다만 학습만 마치고 아직 다듬지 않은 단계의 모델에는 오답률이 더는 내려가지 않는 선이 있다고 본다. 채점표를 고치자는 처방도 결론이 아니라 제안이다. 논문 스스로 그 변경이 방향을 바꿀 수 있다(may)고 적는다.
학습에 쓴 글이 전부 옳아도 틀린 답이 나오는 몫은 남는다. 생일처럼 다른 무엇으로도 추론할 수 없고 학습 글에 딱 한 번만 나온 사실이 특히 틀리기 쉽다. 논문은 이렇게 남는 몫이 얼마나 되는지를 수식으로 따진다. 논문에는 저자 한 사람의 생일을 공개 모델 DeepSeek-V3 에 세 번 물어본 기록도 있다. 아는 경우에만 날짜를 일-월 두 자리씩(DD-MM)으로 적으라고 했는데도 03-07·15-06·01-01, 서로 다른 세 날짜가 돌아왔다. 정답은 논문에 「가을」이라고만 적혀 있다.
검색을 붙이면 나아지지만 없어지지는 않는다. 검색이 확신할 만한 답을 못 찾는 순간은 남고, 그때도 채점표가 바뀌지 않았다면 찍을 이유는 그대로라고 논문은 본다. 정확도 한 줄로는 잘 아는 모델과 잘 찍는 모델이 구별되지 않는다. 오답률과 기권율을 함께 놓아야 갈린다.
더 읽기
- Kalai, Nachum, Vempala, Zhang, "Why Language Models Hallucinate" (arXiv:2509.04664, 2025) — https://arxiv.org/abs/2509.04664
- OpenAI, "Why language models hallucinate" (해설 글, 2025-09-05) — https://openai.com/index/why-language-models-hallucinate/
- OpenAI, "GPT-5 System Card" (2025-08-13) p.14 Table 8: SimpleQA — https://cdn.openai.com/gpt-5-system-card.pdf