인터넷에 AI 가 쓴 글이 점점 늘고, 다음 AI 는 그 인터넷을 그대로 읽고 배운다. 그렇게 되풀이해 배우면 점점 나빠진다는 결과로 알려진 실험은, 매번 직전 모델이 만든 같은 크기의 데이터로 갈아 끼울 뿐 만든 것을 쌓아 두지 않았다. 반대로 쌓아 둔 쪽은 이론 계산에서도 언어 모델 실험에서도 끝없이 나빠지지는 않았다. AI 가 만든 데이터로 다시 배우기를 되풀이할 때 모델이 점점 나빠지는 현상을 모델 붕괴(model collapse)라고 한다.
복사본을 복사하면 뭉개진다, AI 도 그럴까
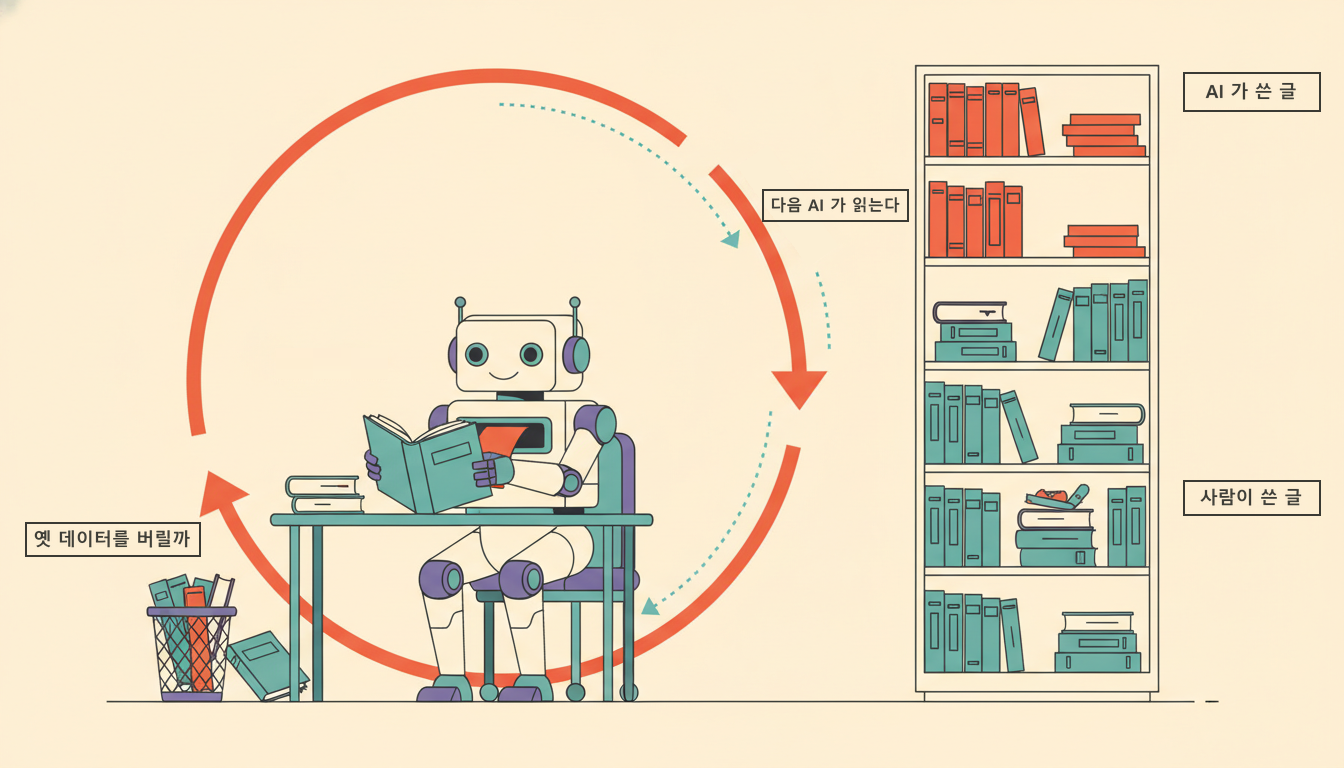
복사한 종이를 다시 복사하고, 그 복사본을 또 복사한다. 몇 번만 되풀이해도 글자 가장자리가 뭉개지고 흐린 글씨는 통째로 사라진다. 원본이 나빠서가 아니다. 복사기가 매번 아주 조금씩 틀리는데, 그 틀린 결과가 다음 복사의 원본이 되기 때문이다.
인터넷에서 벌어지는 일도 이와 닮았고, 2024년 Nature 에 실린 Shumailov 외의 논문은 그 상황을 이렇게 적는다. AI 가 만든 데이터가 널리 퍼지고 있다는 것이다. AI 를 이루는 학습된 프로그램 하나가 모델이고, 모델이 만들어 낸 그 데이터가 합성 데이터(synthetic data)다. 그리고 다음 모델은 사람이 쓴 글과 합성 데이터가 섞인 인터넷을 통째로 긁어다 읽고 배운다.
그 논문이 그린 고리를 우리가 다시 그린 것이 그림 1 다. 모델이 글을 만들고, 그 글이 다른 글들 사이에 섞이고, 다음 모델이 그 데이터로 학습한다. 그리고 그 모델이 다시 글을 만든다. 이 고리를 여러 바퀴 돌린 끝에 모델이 원래 데이터의 모습을 잊어버리는 일을 저자들은 모델 붕괴(model collapse)라고 부른다.
논문 제목부터 결론처럼 읽힌다. 원제를 그대로 옮기면 「재귀적으로 생성된 데이터로 학습하면 AI 모델이 붕괴한다」다. 그런데 같은 논문이 실제로 돌린 실험에는 조건이 하나 붙어 있다. 그 조건이 무엇인지 알고 나면, 같은 헤드라인을 보고도 무엇부터 물어야 할지가 달라진다.
먼저 답을 본다 — 버리면 좁아지고 쌓으면 그대로다
답을 먼저 보는 데 쓸 것은 아주 작은 장난감이다. 평균 0, 퍼진 정도(표준편차)가 1 인 종 모양 분포에서 숫자 100개를 뽑아 이것을 실데이터로 삼는다. 이 100개에서 평균과 퍼진 정도 두 개만 재는 것이 학습이다. 그리고 그 두 수를 가진 종 모양 분포에서 새 숫자 100개를 뽑는 것이 생성이다.
이것은 어떤 논문의 실험도 아니다. 고리가 무엇을 하는지 눈으로 보려고 우리가 만든 장난감이다. 한 바퀴를 세대라고 부른다. 모델이 만든 것으로 다음 모델을 가르치는 한 바퀴다.
고리를 200세대까지 돌리되 조건을 둘로 나눈다. 대체는 직전 세대가 만든 100개만 남기고 나머지를 전부 버린다. 누적은 아무것도 버리지 않고 새로 만든 100개를 계속 더해 나간다. 같은 고리, 같은 횟수, 다른 것은 옛 데이터를 남기느냐 하나뿐이다.
결과는 이렇다. 대체 쪽에서는 퍼진 정도의 중앙값이 0세대 0.99 에서 200세대 0.35 로 줄었다. 누적 쪽은 200세대에도 0.99 그대로였다(같은 조건으로 2000번 반복해 잰 값이다).
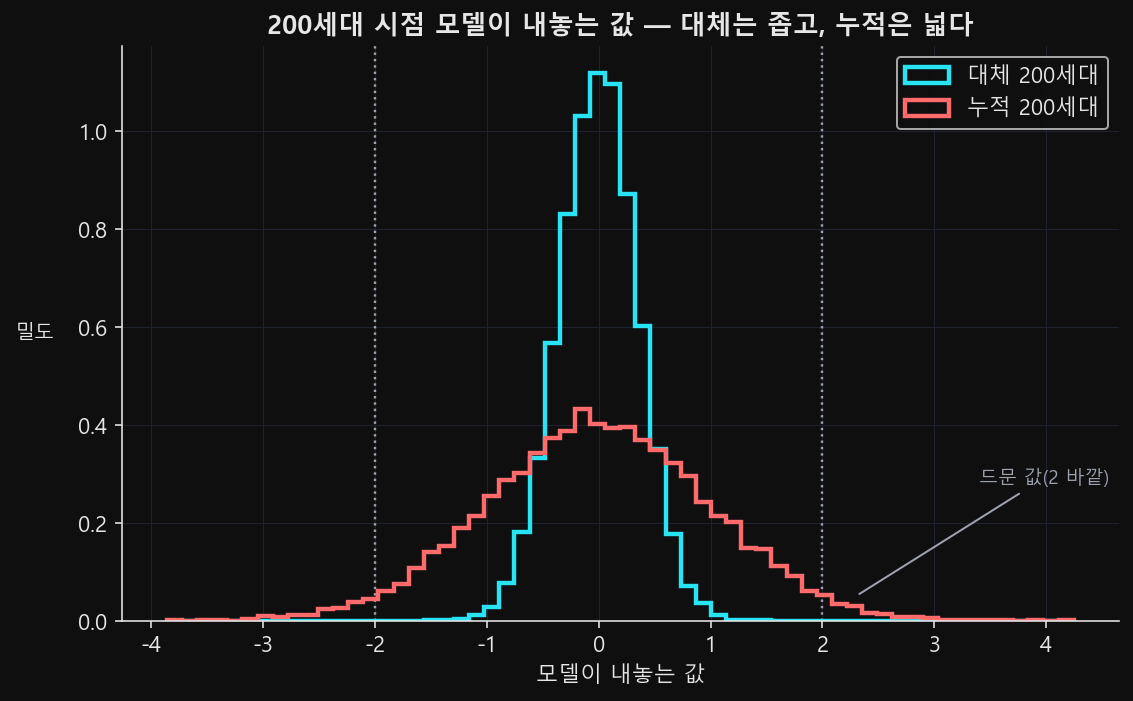
그림 2 에서 좁아진 쪽이 잃은 것은 드문 값이다. 처음의 참 분포에서 크기가 2를 넘는 값이 나올 확률은 4.55% 다. 대체 쪽 모델이 그 구간에 주는 확률은 0세대 4.57% 에서 200세대 0.03% 로 떨어졌고, 누적 쪽은 4.45% 로 거의 그대로 남았다. 대체 쪽 모델이 드문 값을 잃는다는 것은, 흔한 값만 내놓게 된다는 뜻이다.
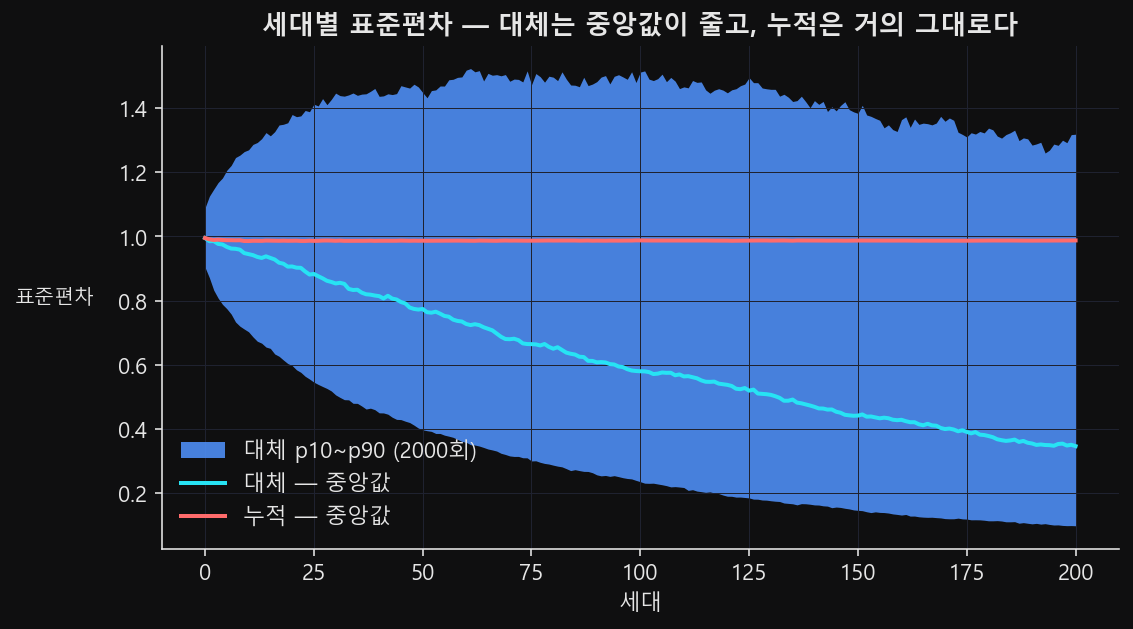
다만 그림 3 의 띠가 보여 주듯 항상 줄어드는 것은 아니다. 대체 조건에서도 위쪽 10% 경계는 200세대에 1.32 로 남아 있다. 줄어드는 것은 중앙값이고, 개별 궤적 중에는 오히려 넓어지는 것도 있다.
컴퓨터가 무작위 숫자를 뽑을 때 쓰는 출발값을 시드라고 한다. 미리 정해 둔 시드 하나로 한 번만 돌리면, 두 조건의 퍼진 정도가 세대마다 이렇게 벌어진다.
import numpy as np

rng = np.random.default_rng(7)
N = 100                                  # 세대마다 새로 만드는 데이터 수
real = rng.standard_normal(N)            # 실데이터: 평균 0, 표준편차 1

only_new = real                          # 대체: 직전 세대가 만든 것만 남긴다
everything = real                        # 누적: 전부 쌓아 둔다
print(f"  0세대  실데이터 {real.std(ddof=1):.2f}")
for gen in range(1, 201):
    a = rng.normal(only_new.mean(), only_new.std(ddof=1), N)
    b = rng.normal(everything.mean(), everything.std(ddof=1), N)
    only_new = a
    everything = np.concatenate([everything, b])
    if gen in (1, 10, 50, 100, 200):
        print(f"{gen:3d}세대  대체 {only_new.std(ddof=1):.2f}   누적 {everything.std(ddof=1):.2f}")
0세대 실데이터 0.88
1세대 대체 0.77 누적 0.89
10세대 대체 0.69 누적 0.88
50세대 대체 0.38 누적 0.88
100세대 대체 0.30 누적 0.87
200세대 대체 0.04 누적 0.88이 한 번의 실행은 0세대 실데이터의 퍼진 정도가 0.88 로 1 보다 조금 낮게 시작한 표본이다. 그래서 누적 쪽 200세대의 0.88 은 줄어든 값이 아니라 출발한 자리에 그대로 머문 값이다. 대체 쪽은 같은 200세대에서 0.04 까지 내려갔다. 2000번 반복의 중앙값 0.35 보다 훨씬 낮게 떨어진 한 번이다.
여기까지가 답이다. 되풀이 자체는 문제가 아니었고, 되풀이하면서 옛것을 버린 쪽만 나빠졌다.
대체는 왜 끝없이 나빠지고, 누적은 왜 멈추는가
장난감에서 본 일이 왜 생기는지는 더 단순한 설정에서 식으로 따져 볼 수 있다. Gerstgrasser 외가 쓴 설정으로, 점들에 직선 하나를 맞추는 일이다. 갈림길은 학습 데이터를 어떻게 꾸리느냐 하나다.
그림 4 의 첫 갈래인 대체부터 보자. 세대마다 새로 만든 데이터에는 그 세대에서 생긴 오차가 섞여 들어간다. 직전 것만 남기고 나머지를 버리면 다음 모델이 받는 것은 그 오차가 섞인 데이터뿐이고, 앞 세대의 오차도 그대로 남아 그 위에 한 칸 더 얹힌다. 앞으로 오차 배수라고 부를 것은 n번째 학습의 오차를 첫 학습의 오차로 나눈 값이다. 대체에서는 이 배수가 학습 횟수 n 과 같아진다.
식 1 의 n 은 총 학습 횟수다. 1번째 학습이 실데이터로 하는 학습이므로, 30번째 학습이라고 하면 합성 데이터로 배운 것은 29번이다. 고리를 한 바퀴 돌 때마다 첫 학습 때만큼의 오차가 한 칸씩 더 얹힌다는 뜻이다.
논문마다 세대를 세는 번호가 한 칸 다르다. Gerstgrasser 외는 실데이터로 하는 첫 학습을 1번째로 세고, 대체 식의 원출처인 Dohmatob 외는 그 학습을 0번째로 센다. 한쪽은 "n번째 학습에서 n배"로, 다른 쪽은 "기준 오차에 한 세대분이 n번 더해진 값"으로 적는 이유가 이것이다. 두 식은 서로 모순이 아니라 번호만 어긋나 있다.
두 번째 갈래인 누적에서는 셈이 달라진다. 옛것을 버리지 않으니 데이터 더미가 세대마다 커지고, i번째 세대가 만든 데이터는 그 더미에서 1/i 만 차지한다. 오차는 제곱으로 재기 때문에, 그 세대가 오차에 주는 몫은 1/i² 로 줄어든다. 그러면 이 몫을 끝까지 더하면 얼마가 될까. 1 + 1/4 + 1/9 + … 은 바젤 문제로 알려진 합인데, 아무리 더해도 π²/6, 약 1.645 를 넘지 않는다.
식 2 의 앞부분은 등호이고, π²/6 은 세대를 무한히 늘렸을 때의 천장이다. 10번째까지 더하면 1.5498 이고, 30번째까지 더해도 1.6122 다. 누적 쪽은 고리를 아무리 돌려도 오차가 첫 학습 때의 두 배에 닿지 못한다는 뜻이다. Gerstgrasser 외는 1/i² 의 합이 유한하다는 것이 오차가 끝없이 커지는 것을 막는다고 적고, 이것이 누적으로 모델 붕괴를 피할 수 있음을 시사한다고 본다.
논문이 쓴 설정을 그대로 굴려 봤다. 특징 수와 세대마다 쓰는 표본 수는 논문 본문에 없어 우리가 골랐다 — 특징 10개, 세대마다 표본 100개다. 특징 10개란 입력 하나가 숫자 10개로 이뤄진다는 뜻이고, 그래서 "직선을 맞춘다"는 방향 열 개마다 기울기를 하나씩 맞추는 일이다.
이 설정으로 4000번 반복해 평균을 냈다. 30번째 학습에서 대체 쪽은 첫 학습 오차의 30.28배(±0.23)이고, 누적 쪽은 1.62배(±0.01)다. 여기서 ± 는 4000번 평균값이 흔들리는 폭, 곧 표준오차다. 이론값은 각각 30배와 1.612배이고, 실측은 표준오차 수준에서 그 값을 되짚는다.
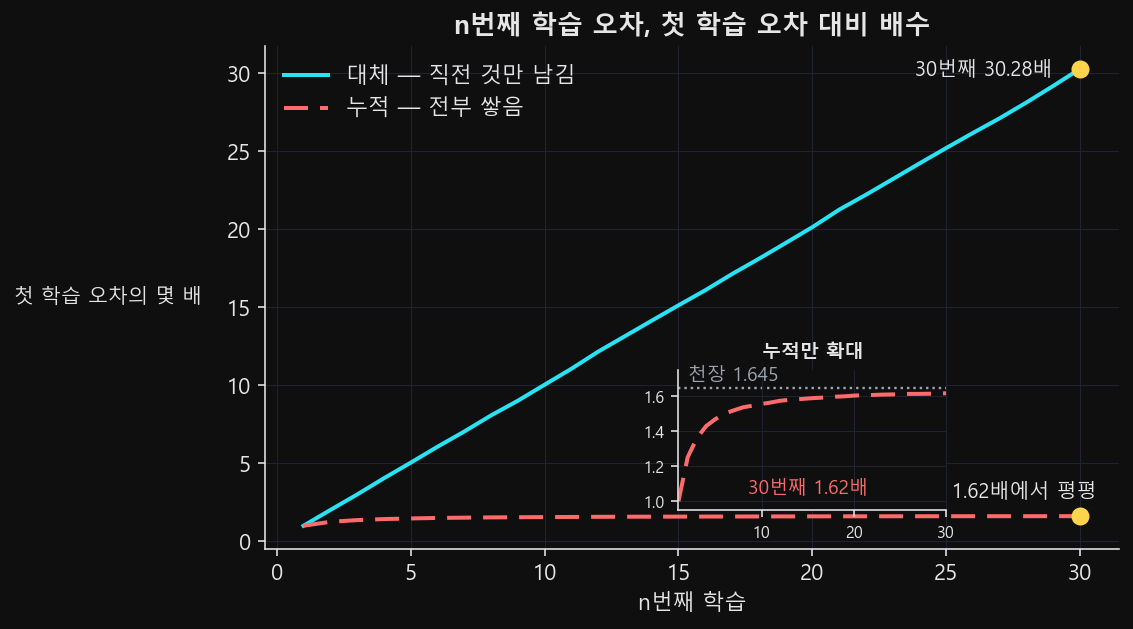
그림 5 에서 두 선이 벌어진 폭이 그대로 답이다. 30번째 학습의 대체 쪽 오차를 같은 30번째 누적 쪽 오차로 나누면 18.7배다. 같은 고리를 같은 횟수 돌렸는데 결과가 이만큼 차이 났다. 새로 생긴 오차가 전체 데이터에서 차지하는 몫이 달랐기 때문이다. 옛것을 남겨 두면 새 오차가 그 안에 묻히고, 버리면 묻힐 자리가 없다.
원 논문이 실제로 돌린 두 세팅, 그리고 그림의 함정
그러면 Nature 논문의 실험이 어느 쪽 조건이었는지를 볼 차례다. 언어 모델을 쓴 실험에서 저자들은 두 세팅을 모두 돌렸다. 이미 학습된 언어 모델 하나를 wikitext2 라는 공개 글 묶음으로 추가 학습시키고, 그 모델이 만든 글로 다음 모델을 학습시키는 식이었다.
하나는 원 데이터를 하나도 남기지 않는 쪽이다. 첫 학습만 원 데이터로 하고, 그다음 세대부터는 직전 모델이 만든 글로만 배운다. 저자들은 이 조건에서도 모델이 과제 자체에는 적응하지만 성능을 얼마간 잃는다고 적었다.
다른 하나는 세대마다 원 학습 데이터에서 무작위로 10% 를 다시 뽑아 섞는 쪽이다. 원 데이터를 조금 섞을 뿐 나머지는 갈아 끼운다. 이 조건을 두고 저자들은 이렇게 적었다. 원 데이터를 남겨 두면 추가 학습이 더 잘되고 성능 저하가 약간에 그친다(only minor degradation of performance).
앞에서 말한 조건 하나가 이것이다. 두 세팅 어느 쪽도 모델이 만든 글을 쌓아 두지 않고, 세대마다 같은 크기로 갈아 끼웠다. 두 세팅을 함께 닫는 문장도 따로 있다. 두 학습 방식 모두 성능이 나빠졌지만 생성된 데이터로도 학습은 가능하며, 모델이 근본 과제를 일부는 성공적으로 배울 수 있다고 저자들은 적는다.
논문의 그림 1a 캡션은 누적을 그린다. 원문은 "at step n, data are added to the overall data from step n − 1" — n 단계의 데이터를 n−1 단계까지의 전체 데이터에 더해 모델을 학습시킨다는 뜻이다. 그런데 그 아래 b·c 패널의 실제 실험은 직전 모델이 만든 같은 크기의 데이터로 갈아 끼우는 쪽이다. c 는 거기에 원 데이터 10% 를 섞는다. 같은 캡션이 "with all generated datasets equal in size" 라고 적는 자리가 거기다. 어느 쪽도 만든 것을 쌓지 않으니, 그림을 보고 실험 조건을 짐작하면 반대쪽을 읽게 된다.
널리 인용된 예시 하나도 같은 문제를 안고 있다. 논문에 실린 9세대 모델의 출력은 산토끼(jackrabbit) 이야기를 하다가 검은꼬리·흰꼬리·파란꼬리·빨간꼬리·노란… 으로 같은 구절을 색만 바꿔 이어 간다. 이 출력이 두 세팅 중 어느 쪽에서 나온 것인지는 논문이 밝히지 않는다.
그래서 이 논문을 근거로 든 문장은 어느 세팅의 이야기인지에 따라 뜻이 달라진다. 한 논문 안에 조건이 다른 두 실험이 들어 있기 때문이다.
버림이 문제지 데이터 양이 아니다, 그리고 누적도 완벽하지 않다
여기서 자연스럽게 따라오는 물음이 있다. 그러면 합성 데이터를 더 많이 만들면 되지 않을까. Gerstgrasser 외는 그 중간 설정을 각주와 부록에서 따져 뒀다. 옛 데이터는 그대로 버리되, i번째 세대에서는 합성 데이터를 표본 수의 i배로 만들어 학습하는 설정이다. 누적과 데이터 양이 같아진다.
이 설정에서는 각 세대의 몫이 1/i² 가 아니라 1/i 로만 줄어든다. 몫이 줄어드는 속도가 느려서 이번에는 합이 멈추지 않고, 그래서 오차는 느리지만 끝없이 커진다. Dohmatob 외도 같은 결과를 따로 적어 두고, 이것은 붕괴를 피하는 것이 아니라 데이터 생성과 학습에 비용을 더 들여 악화를 미루는 것이라고 쓴다. 데이터를 더 만드는 것으로는 버린 자리를 메우지 못한다는 뜻이다.
쌓는 쪽이 실제 모델에서 어떻게 되는지도 Gerstgrasser 외가 돌려 봤다. 작은 언어 모델을 세대마다 새로 만들어 학습시키자, 갈아 끼운 쪽은 오차가 올랐고 쌓은 쪽은 오차가 그대로이거나 오히려 내려갔다.
반대 방향의 경계는 같은 논문 안에 함께 실려 있다. 얼굴 사진 20만 장으로 이미지를 만드는 모델을 돌린 실험에서는, 누적을 해도 오차가 세대마다 조금씩 올랐다. 생성된 얼굴의 다양성도 줄었다. 성별 같은 큰 축은 남았지만 안경이나 장신구 같은 자잘한 특징은 더 이상 나오지 않는 것으로 보인다고 저자들은 적는다. 그리고 그들은 조금 어긋나는 증거도 함께 적어 둔다. 다른 팀은 더 작은 데이터에서 누적을 해도 성능이 빠르게 나빠지는 것을 봤다.
현실에 더 가까운 조건이 하나 더 있다. 그림 4 의 셋째 갈래, 곧 데이터는 전부 보관하되 계산 예산이 정해져 있어 매번 같은 크기만 뽑아 학습하는 경우다. Kazdan 외는 다섯 가지 과제 설정에서 이 방식을 시험했고, 그 다섯에는 직선 맞추기도 들어 있다. 오차는 대체와 누적 사이에 놓였고, 누적보다 높은 자리이긴 해도 대개 평평해졌다. 계산 예산이 정해진 이 조건으로 바꿔도 모델 붕괴의 위협은 여전히 피할 수 있다는 것이 그들의 결론이다.
같은 방식을 앞의 설정(특징 10개·표본 100개)으로 우리가 다시 굴려 보면, 30번째 학습에서 첫 학습 오차의 3.09배가 나온다. 대체 쪽 30.28배와 누적 쪽 1.62배 사이다. 다만 아직 오르는 중이라 여기서 멈추는지 아닌지는 이 실측이 판정하지 않는다.
그래서 갈림길은 양을 늘렸는가가 아니라 옛것을 버리지 않았는가다. 그리고 버리지 않아도 흔치 않은 것들은 여전히 위험하다.
‘모델 붕괴’라는 말이 가리키는 게 여덟 가지다
여기까지 ‘붕괴’라는 말을 계속 썼는데, 이 말이 가리키는 것이 한 가지가 아니다. Schaeffer 외는 관련 문헌 28편을 손으로 하나씩 표시해 가며, 모델 붕괴가 여덟 가지 뜻으로 쓰이고 있다고 정리했다. 오차가 커지는 거동을 말하는 정의, 데이터 분포의 모양이 일그러지는 것을 말하는 정의, 데이터를 늘릴 때 얻는 이득이 달라지는 것을 말하는 정의로 크게 묶인다.
정의가 다르면 같은 그림을 보고도 결론이 갈린다. Schaeffer 외가 드는 실례는 이렇다. 한 팀은 이미지 생성 모델에서 진짜 이미지와의 거리를 재는 값, 곧 Fréchet Inception Distance(FID)를 봤다. 그 값이 다섯 번째 반복까지 2배 오른 뒤 평평해진 것을 보고 그들은 붕괴라고 불렀다.
그 팀이 암묵적으로 든 잣대는 오차가 조금이라도 오르면 붕괴라는 것이었다. 다른 팀은 같은 그림을 두고 붕괴가 아니라고 했다. 끝없이 발산해야 붕괴라는 정의를 썼기 때문이다.
같은 일이 이 말을 유행시킨 실험에도 일어난다. Schaeffer 외가 읽은 것은 이 논문의 프리프린트판인데, 실험은 게재본과 같다. 그들이 읽기로 언어 모델 실험에서 오차는 처음엔 오르다가 다시 내려와 첫 모델보다 높은 어느 높이에서 평평해진다. 그래서 오차가 끝없이 커진다는 정의, 원 데이터의 어떤 갈래가 사라지거나 뒤섞인다는 정의, 드문 데이터를 잃는다는 정의 아래에서는 붕괴가 아니라고 그들은 본다. 붕괴로 불리는 것은 원 데이터에 없던 것이 생성물에 나타난다는 여덟 번째 정의에서다.
Schaeffer 외는 이 말이 정밀하고 중요한 기술적 고려에서 과장된 위협으로 부풀려졌다고 본다. 같은 논문에 반대편 의견을 싣는 절도 따로 있다. 지나치게 조심하는 편의 이득이 비용보다 클 수 있다는 지적도 타당하다고 저자들 스스로 적어 뒀다.
"그래서 붕괴한다는 거야 아니라는 거야"라고 물으면 답이 나오지 않는다. 어느 정의로 묻는지를 먼저 정해야 답이 성립한다.
‘모델 붕괴’ 기사를 읽기 전에 물어야 할 질문 셋
다음에 모델 붕괴를 다룬 기사나 논문을 만나면, 결론을 읽기 전에 물어볼 것이 셋 있다.
첫째, 그 실험은 이전 데이터를 버렸는가 쌓았는가. 둘째, 세대마다 학습 데이터의 크기가 같은가, 아니면 늘어나는가. 셋째, 여기서 ‘붕괴’는 무엇의 붕괴인가 — 오차가 끝없이 커진다는 뜻인가, 드문 것을 잃는다는 뜻인가.
첫 질문은 지금의 웹 자체에도 던질 수 있다. Schaeffer 외의 판정은 현실이 버리는 쪽보다 쌓는 쪽에 가깝다는 것이다. 대규모 글로 모델을 처음부터 가르치는 단계가 사전학습인데, 그들이 근거로 드는 문장은 이렇다.
Real data are not deleted en masse after each iteration of model pre-training.
모델을 한 번 더 사전학습시킬 때마다 실데이터가 통째로 지워지지는 않는다.
출처: Schaeffer et al. 2025다만 그들도 실데이터의 비율이 결국 0 에 가까워질지는 아직 알 수 없다고 적는다. 그 한 실험에 대한 판정과 별개로, 드문 데이터와 소수 집단의 특징을 잃는 문제는 실제로 남는다고 그들은 본다. 그러니 세 질문이 답을 대신 주지는 않는다. 대신 "AI 가 쓴 글로 AI 를 가르치면 무너진다"는 한 줄을 만났을 때, "그 실험은 이전 데이터를 버렸나"부터 묻게 된다.
더 읽기
- AI models collapse when trained on recursively generated data — Shumailov 외, Nature 631, 755–759 (2024).
- Is Model Collapse Inevitable? Breaking the Curse of Recursion by Accumulating Real and Synthetic Data — Gerstgrasser 외, arXiv:2404.01413v2.
- Position: Model Collapse Does Not Mean What You Think — Schaeffer 외, arXiv:2503.03150v2.