AI 해부
총 46편
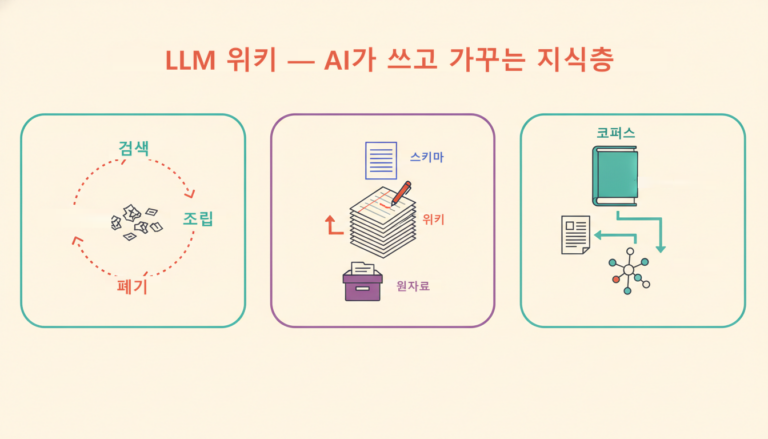
LLM 위키 — AI가 쓰고 가꾸는 지식층은 실제로 어떻게 작동하는가
LLM이 직접 쓰고 가꾸는 지식층(LLM 위키)이 작성·유지·연결에서 실제로 어떻게 작동하는지 뜯어보고, 지식그래프와 어디서 만나는지까지 확인한다.
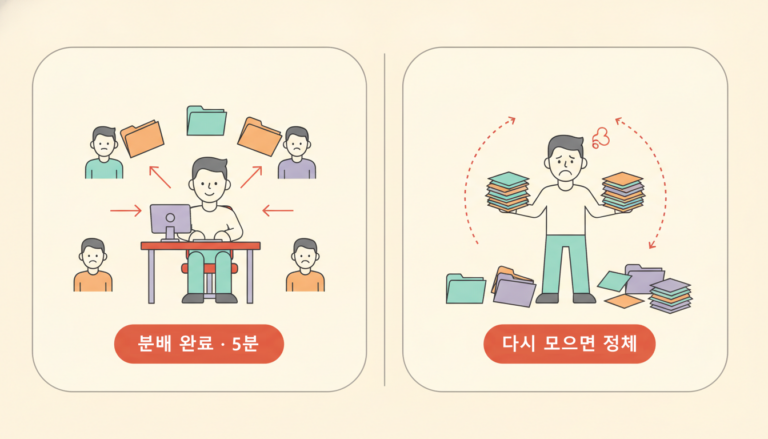
일을 나눠 주면 빨라질 줄 알았다 — 멀티에이전트 팬아웃의 진짜 비용
멀티에이전트 팬아웃, 나누는 코드는 쉬워도 흩어진 결과를 다시 모아 판정하는 설계가 진짜 비용이다.
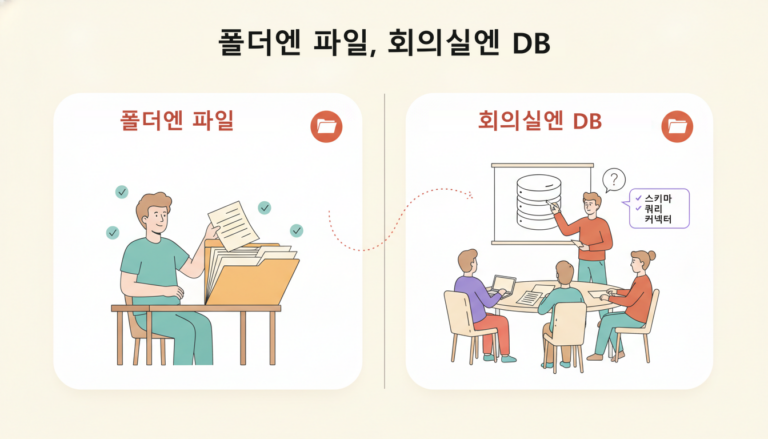
LLM 에이전트 지식 저장소, DB보다 파일이 먼저인 이유
에이전트 지식 저장소는 강점이 아니라 순서의 문제다. 시작 레짐엔 파일·Git이 정본이고, DB는 신호가 켜질 때 얹는 파생물이다.
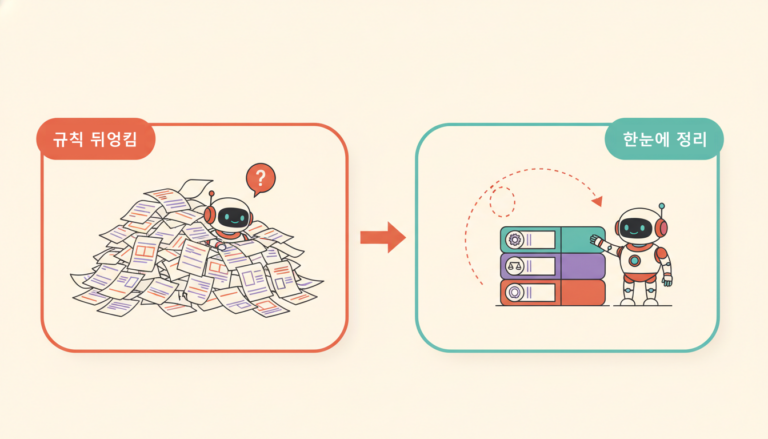
짧은 CLAUDE.md가 더 강한 에이전트를 만든다 — 프로젝트 메모리 3층 설계
CLAUDE.md를 헌법·법률·시행령 3층으로 나누면, 짧아진 헌법이 오히려 더 잘 지켜진다.
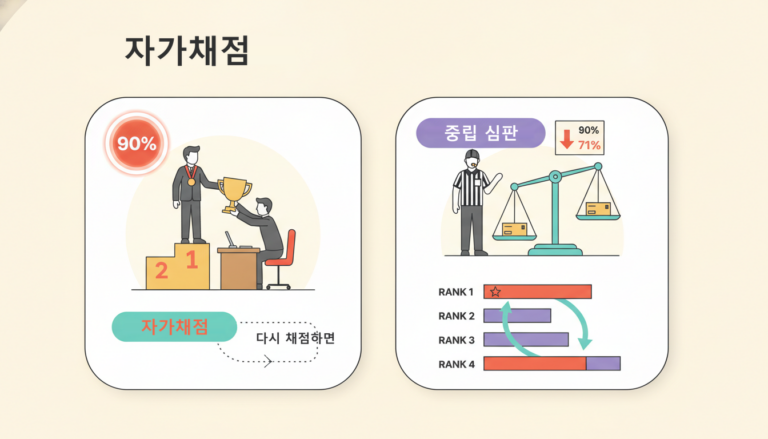
RAG 벤치마크 점수, 누가 채점했나 — 벤더 성적표를 읽는 눈
RAG 벤치마크의 자랑 수치는 대부분 자기 채점이다 — 채점자를 물으면 그 우위는 무너지거나 뒤집힌다.
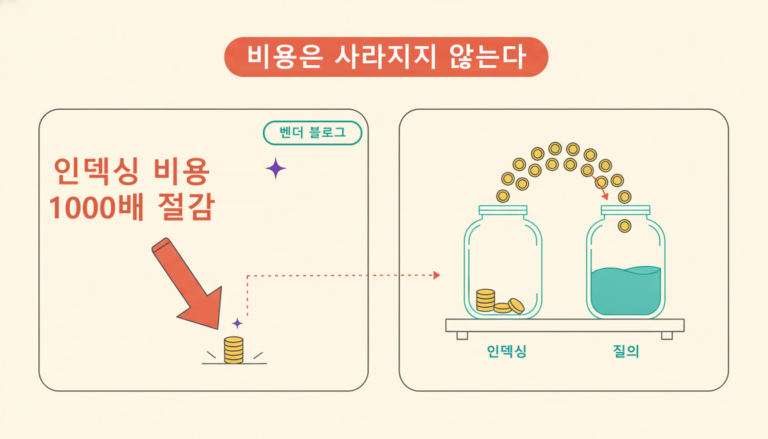
GraphRAG 비용은 사라지지 않는다 — 인덱싱에서 질의로 자리를 옮길 뿐
벤더의 '인덱싱 비용 1000배 절감' 헤드라인, 출처를 열면 baseline이 없다. 실측 $5~$120과 비용이 옮겨가는 자리를 해부한다.