챗봇에게 문제를 낼 때 「단계별로 생각해 봐」 한마디를 덧붙이면 답이 달라진다. 2022년 모델에 수학 문장제를 내면서 붙여 보니 정답률이 17.7%에서 78.7%로 뛰었다. 그런데 그 힘은 수학이나 논리 문제에서만 컸다. 2026년 모델 한 종에 쉬운 문장제 200문항을 직접 내 봤더니 차이는 0.5%포인트뿐이었다. 이렇게 답을 내기 전에 중간 풀이를 먼저 쓰게 하는 방법을 생각의 사슬(chain-of-thought)이라고 한다.
한 줄 전/후 — 정답률이 뛴 순간
2022년에 나온 모델 text-davinci-002 에 문장제 수학 문제 600개를 내고 답만 물었더니 17.7%를 맞혔다. 같은 모델에 같은 문제를 그대로 내면서, 답을 쓰기 전에 "Let’s think step by step." 한 줄을 덧붙이자 78.7%가 됐다. 「단계별로 생각해 봐」에 해당하는 영어 한 문장이다. 모델을 새로 학습시키지도, 예시를 보여 주지도 않았다. 프롬프트에 문장 하나가 더 붙었을 뿐인데 정답률 차이가 61.0%포인트다.
이 한 줄은 이미 널리 퍼진 요령이다. 챗봇 답이 미덥지 않을 때 「단계별로 생각해 봐」를 덧붙이는 사람이 많다. 답이 조금 나아진 것 같다는 후기도 그만큼 흔하다. 느낌과 측정은 다른 물건이다. 같은 문제를 같은 모델에 수백 번 내고 하나씩 채점해 봐야 그 한 줄이 무엇을 바꿨는지 숫자로 남는다. 위의 두 숫자는 그 한 줄을 벤치마크에 걸어 잰 기록의 첫 줄이다.
문제집 이름은 MultiArith다. 짧은 문장제 600문항을 모아 둔 것으로, 전부 두 단계 산술로 풀리고 답은 모두 정수다. 예컨대 「손님이 일곱 명 있었는데 네 명이 나가고 세 명이 들어왔다」처럼 두 번 계산하면 답이 나오는 문제다. 좁고 쉬운 문제집이다. 그러니 이 숫자를 「모델의 수학 실력이 그만큼 늘었다」로 읽으면 안 된다. 같은 절차로 초등 문장제 모음 GSM8K를 재면 10.4%에서 40.7%가 되는데, 두 쌍 모두 Kojima 연구팀이 2022년에 잰 값이다.
수치보다 먼저 짚어야 할 것이 절차다. 논문은 모델을 한 번 부르지 않고 두 번 부른다. 먼저 그 한 줄을 붙여 풀이를 받아 내고, 받은 풀이를 문제 뒤에 그대로 이어 붙인 다음 답만 말하게 하는 문구를 달아 한 번 더 묻는다. 채점한 것은 두 번째 응답이다. 챗봇 창에 한 줄을 덧붙이는 일과 겹치는 데가 있지만, 같은 절차는 아니다.
- 문제 뒤에 "Let’s think step by step." 을 붙여 모델에 넣고, 답 대신 풀이를 받는다.
- 받은 풀이를 문제 뒤에 그대로 이어 붙이고, 끝에 "Therefore, the answer (arabic numerals) is" 를 달아 다시 넣는다. 이때 돌아온 숫자가 채점 대상이다.
두 번 부르는 까닭은 첫 응답이 풀이 덩어리라 그 안에서 답 하나를 골라내기가 마땅찮기 때문이다. 두 번째 물음이 그 풀이를 읽고 숫자만 말하게 한다. 답을 뽑아내는 문구는 문제 종류마다 달라서, 객관식이면 보기 기호를 말하게 하는 다른 문장을 쓴다. 61.0%포인트라는 차이는 그 두 단계를 밟았을 때의 값이다. 그래서 이 숫자를 재현하려면 챗봇 창에 한 줄을 더 치는 것으로는 모자라고, 받은 풀이를 다시 넣는 걸음이 하나 더 있어야 한다.
그 한 줄이 하는 일 — 모델은 자기가 쓴 글을 다시 읽는다
한 줄이 무슨 일을 했는지 보려면 모델이 답을 적어 나가는 방식을 한 번 짚어야 한다. 모델은 답을 통째로 내놓지 않는다. 앞에서부터 한 조각씩 이어 붙여 답을 만든다. 한 조각을 적고 나면 그 조각까지 붙은 글이 다음 조각의 입력이 된다. 그러니까 앞에 무엇이 적혀 있느냐가 그다음에 적힐 것을 바꾼다. 자기가 방금 쓴 글을 자기가 다시 읽는 셈이다.
앞 절의 손님 문제로 옮겨 보면 차이가 보인다. 답부터 쓰라고 하면 답을 적는 시점에 모델 앞에 놓인 것은 문제 문장뿐이고, 일곱에서 넷을 빼 셋이 됐다는 중간값은 어디에도 적혀 있지 않다. 단계를 먼저 쓰라고 하면 그 중간값이 답 바로 윗줄에 글로 적힌다. 답을 적을 차례가 왔을 때 모델이 읽는 글에 「셋」이 이미 들어 있는 것이다. 한 줄이 바꾼 것은 모델의 능력이 아니라 답을 적기 직전에 놓여 있는 글이다.
이렇게 답을 내기 전에 중간 풀이를 먼저 쓰게 하는 방법을 생각의 사슬(chain-of-thought)이라고 한다. 이 블로그의 곱셈 편에서도 같은 장면이 나왔다. 답 숫자만 쓰라고 하면 한 문제도 못 맞히던 자릿수의 곱셈을, 풀이를 단계별로 쓰게 하자 같은 모델이 맞혔다. 그때 바뀐 것도 프롬프트의 한 줄이었다.
여기까지 오면 조건 둘이 따라붙는다는 것도 보인다. 풀이는 답보다 먼저 적혀야 하고, 그 풀이에는 답을 구하는 데 실제로 쓰일 내용이 들어 있어야 한다. 둘 중 하나라도 어긋나면 답 앞에 놓인 글은 그냥 글일 뿐이다. 이 둘이 정말 필요한지는 뒤에 나올 실험이 하나씩 떼어 보며 확인한다.
그렇다면 아무 말이나 붙여도 되는 걸까. Kojima 연구팀 논문의 개정판(2023년 1월)에 그 물음을 재 본 표가 하나 있다. 같은 문제집과 같은 모델에 붙이는 문장만 열여섯 가지로 바꿔 가며 정답률을 쟀다.
생각을 부추기는 쪽으로 쓴 문장 아홉 개는 45.7%에서 78.7% 사이에 들어왔다. 「Let’s think」까지만 쓰면 57.5%이고, 뒤에 「step by step」을 붙이면 78.7%다. 같은 방향의 지시인데도 얼마나 구체적으로 말하느냐에서 21.2%포인트가 갈렸다.
반대쪽은 사정이 딴판이다. 문제와 아무 상관 없는 문장 셋도 같은 표에 들어 있다. 「Abrakadabra!」는 15.5%, 「It’s a beautiful day.」는 13.1%였다. 「By the way, I found a good restaurant nearby.」는 17.5%다. 셋 다 아무것도 붙이지 않았을 때의 기준선 17.7% 아래이거나 거기에 붙어 있다.
일부러 다른 데로 끌고 가는 문장으로 분류된 넷은 9.3%에서 18.8% 사이에 흩어져 있다. 「Don’t think. Just feel.」이 18.8%로 기준선과 사실상 같고, 「지구가 둥글다는 사실을 이용해서」라는 뜻의 문장은 9.3%로 기준선의 절반이다. 붙였다는 사실만으로 점수가 오르지는 않았다. 그림 1 는 그 열여섯 가지 가운데 열 줄을 뽑아 한 축에 늘어놓은 것이다. 방금 든 「Abrakadabra!」와 「지구가 둥글다」 쪽 문장은 표에만 있고 그림에는 없다.
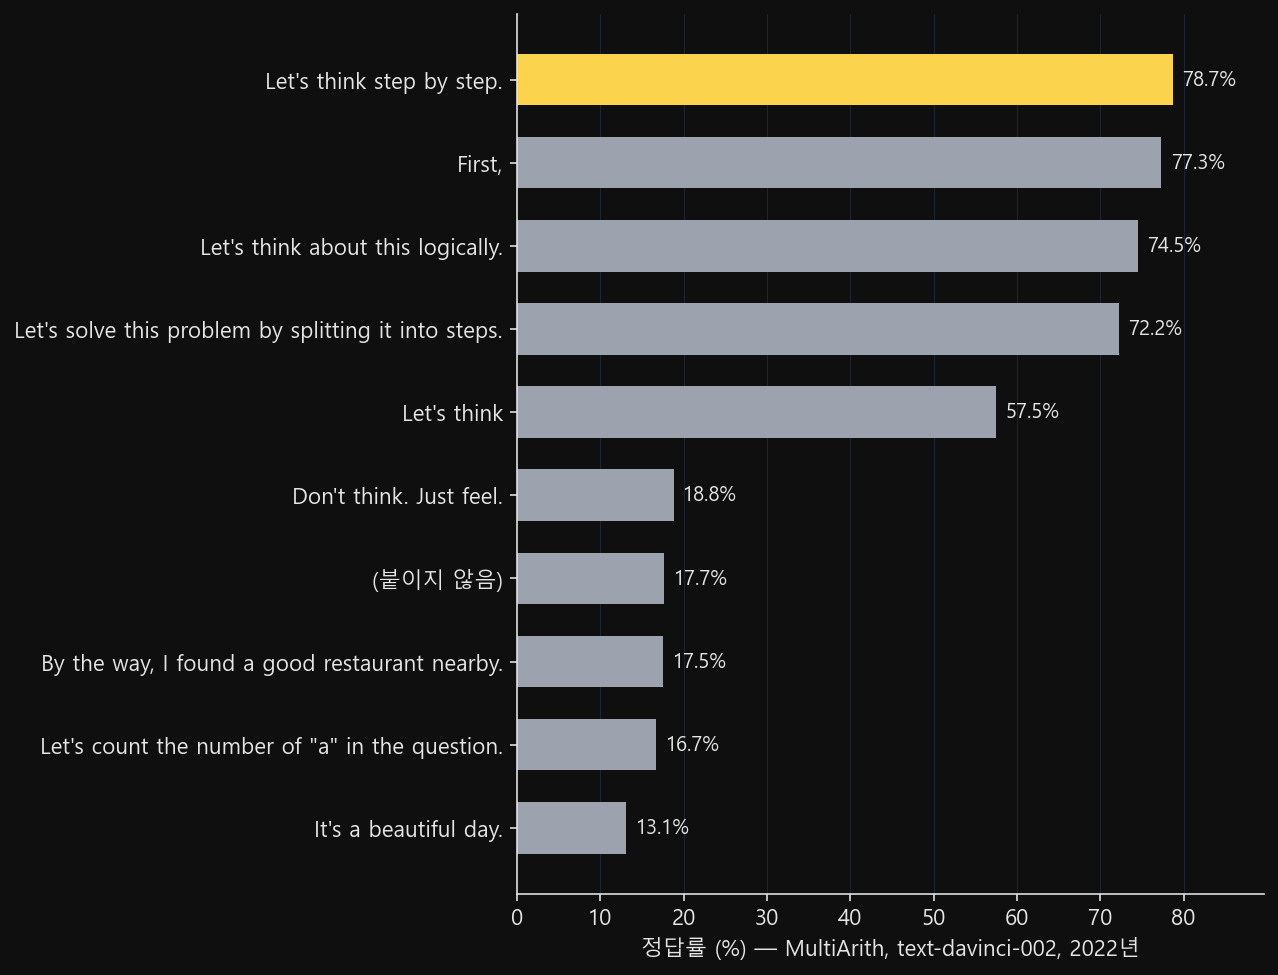
말만 그럴듯한 문장은 정답률을 기준선 밑으로 끌어내리기까지 했다. 그 한 줄이 불러온 풀이가 정확히 무엇을 해 주는지는 아직 재지 않았다. 답을 바꾼 것은 그 문장이 끌어낸 풀이였다.
왜 되나 — 자리만 주는 것으로는 안 됐다
점수가 오르는 이유로 가장 먼저 떠오르는 설명이 있다. 단계를 적는 동안 글자가 길어지니 답까지 계산할 틈을 더 번다는 것이다. 그럴듯한데, 재 보니 그렇지 않았다.
Wei 연구팀은 예시를 보여 주는 방식으로 같은 현상을 재면서, 무엇이 점수를 올리는지도 갈라 봤다. 모델 하나(LaMDA 137B)에 GSM8K를 내고, 풀이 없이 답만 받은 6.5%를 기준선으로 뒀다. 답 앞에 쓸 것만 바꾼 조건 넷 가운데 단계로 쓰게 한 조건이 14.3%다.
나머지 세 조건이 답을 준다. 자연어 문장 대신 식만 적게 하면 5.4%로 기준선보다 오히려 낮아진다. 풀이 자리에 점만 찍어 길이만 늘려 주면 6.4%, 답을 먼저 쓰고 뒤에 설명을 붙이게 하면 6.1%로 둘 다 기준선과 같다. 길이를 늘려 준 것도 설명을 시킨 것도 그 자체로는 점수를 움직이지 못했고, 답 앞에 자연어 단계가 놓였을 때만 값이 올라갔다.
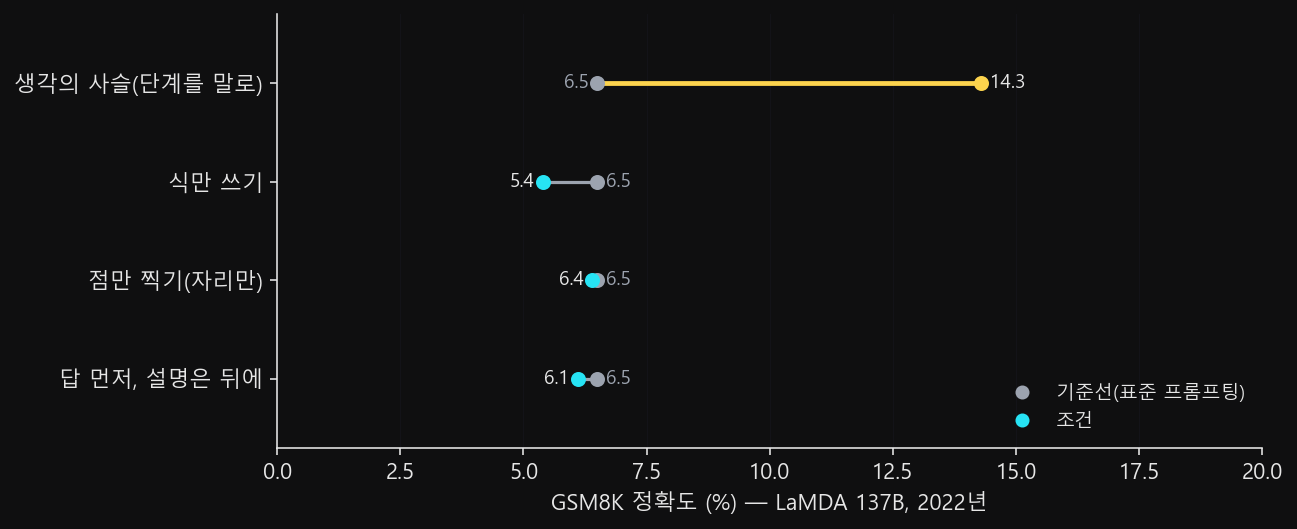
그림 2 에 단서를 붙여 둔다. 이 실험은 모델 한 종에서만 돌았고, 논문은 더 큰 모델에 돌리기가 비싸다고 적는다. 오른 폭도 앞 절의 값과는 모델도 문제집도 달라 견줄 수 없다. 그래도 방향은 분명하다 — 답을 적기 전에 무엇이 글로 적혀 있느냐가 답을 바꾼다.
항상은 아니다 — 어디에서 되나
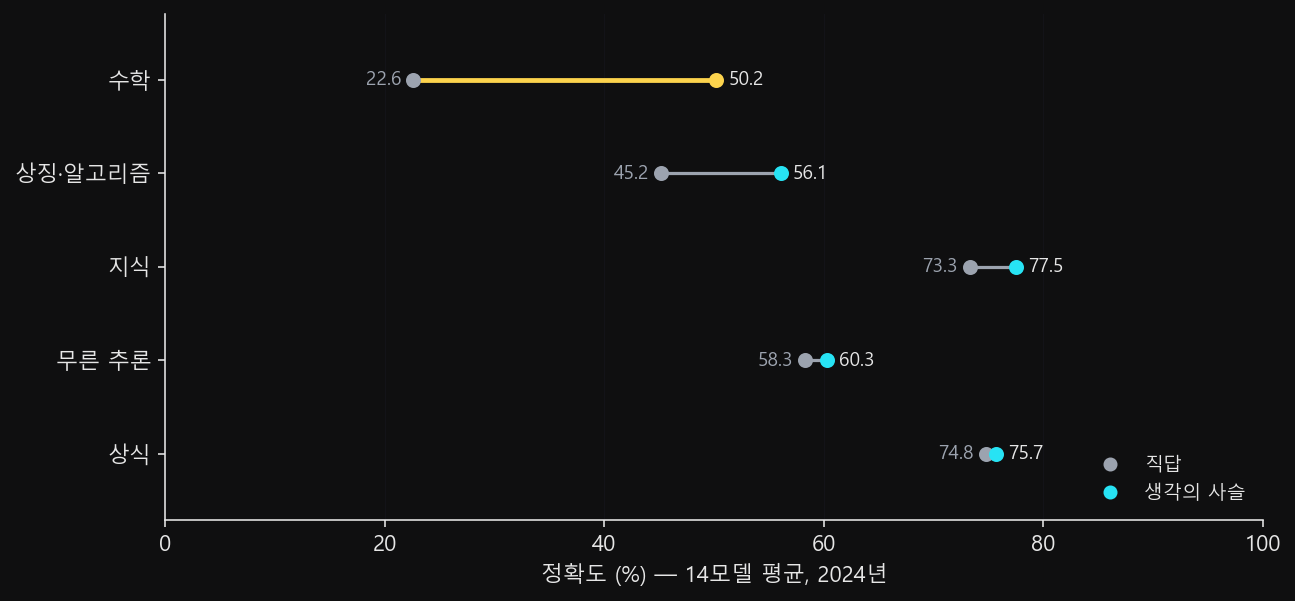
어디에서 되는지를 2024년 모델들로 넓게 재 본 연구가 있다. Sprague 연구팀은 한 해 동안 학회 세 곳에 실린 논문을 훑어 기준에 맞는 110편의 보고값을 모으고, 데이터셋 20개를 모델 14종에 직접 돌렸다. 범주별로 접으면 수학 문제는 답만 물은 직답 22.6%가 50.2%가 됐다. 규칙대로 세고 뒤집는 상징·알고리즘 쪽은 45.2%에서 56.1%다. 그런데 상식 문제는 74.8%에서 75.7%로 1%포인트가 채 되지 않고, 지식과 글을 읽고 따지는 무른 추론도 그 사이에서 작게 움직인다. 그림 3 에서 두 점이 눈에 띄게 벌어진 줄은 맨 위의 둘뿐이다.
평균이 올랐다고 모든 조합에서 오른 것도 아니다. 같은 연구의 데이터셋별 표를 (데이터셋 × 모델) 쌍으로 세면 378쌍 중 92쌍(24.3%)에서 생각의 사슬 쪽이 더 낮았다. 평균이 마이너스인 데이터셋도 여섯인데 전부 상식이나 무른 추론 쪽이다.
앞에서 본 2022년 실험 안에도 떨어진 과제가 있다. 상식 문제 모음 CommonsenseQA는 68.8%에서 64.6%로, 산술 문제 모음 AddSub는 72.2%에서 69.6%로 내려갔다. 논문은 AddSub처럼 여러 단계가 필요 없는 과제에서는 이득이 없는 것이 예상된 결과라 적고, 상식 문제에서는 이 방법이 성능을 올려 주지 않는다고 따로 적는다.
모델이 작으면 방향이 아예 뒤집힌다. 같은 논문의 부록 표에서 작은 모델 열한 종 중 여덟은 점수가 내려갔고, Wei 연구팀 쪽에서도 LaMDA 계열에서 가장 작은 420M 모델이 2.6%에서 0.4%로 떨어졌다. 다만 그 값들은 1%대에서 4%대라 개별 차이를 효과로 읽기는 어렵다. Wei 연구팀은 작은 모델이 말은 매끄러운데 논리가 맞지 않는 단계를 만든다고 적는다. 그래서 이 표들은 어디에 붙일지를 알려 준다 — 밟아야 할 단계가 있는 문제에서만 단계가 값을 했다.
계산은 계산기가 낫다, 문구의 힘도 줄었다
단계가 통하는 쪽에서도 더 나은 방법은 따로 있다. Wei 연구팀의 표에서 PaLM 540B 가 초등 문장제를 생각의 사슬로 56.9% 맞혔는데, 산술 계산만 계산기에 넘기자 58.6%가 됐다. Sprague 연구팀도 같은 쪽을 짚는다 — 풀이를 도구에 넘기는 방식이 대부분 설정에서 앞섰고, 생각의 사슬은 도구 없이 쓰는 범용 대용품이라고 적는다.
이득이 어느 문항에서 오는지도 같은 연구가 갈라 놓았다. 57과목 객관식 시험 문제를 모은 MMLU에서 등호가 든 문항은 8.3%에서 10.9% 사이인데, 그 10% 남짓이 전체 이득의 절반을 넘게 만든다. 등호가 없는 나머지에서는 단계를 밟든 안 밟든 정답률이 거의 같았다.
문구를 고르는 일의 무게도 그때와 지금이 다르다. 2022년 모델에서는 붙이는 문장에 따라 45.7%에서 78.7%까지 갈렸다. 33%포인트 차이다. 그 한 줄을 포함한 문구 네 가지를 2024년 모델 Llama 3.1 8B에 걸어 본 Sprague 연구팀의 부록에는 차이가 거의 없다고 적혀 있다. 모델도 문제집도 문구 묶음도 다르니, 2022년 모델에서는 크게 갈렸고 2024년 모델에서는 거의 갈리지 않았다는 데까지다.
요즘 모델 하나를 잡고 그 한 줄이 얼마나 움직이는지 직접 재 봤다. 2026년 9월 22일, gemini-3.1-flash-lite 로 MultiArith 600문항 중 200문항에 위의 두 단계 절차를 밟았다. 답을 내기 전 속으로 하는 계산(내부 추론)은 꺼 두었다. 답만 물었을 때 98.5%(197/200), 풀이를 받은 뒤 다시 물었을 때 99.0%(198/200)로 차이는 0.5%포인트다. 답만 물은 200건 중 199건이 풀이 없는 한 줄 답이었다. 겉으로 풀이를 쓰지 않고도 거의 다 맞힌 셈이다.
이 실측은 모델 한 종을 2026년 9월 22일 하루 잰 값이고, 문제집은 두 단계 산술 200문항이라 두 조건 모두 천장에 붙어 있다. 이 결과로 「요즘 모델에는 생각의 사슬이 필요 없다」를 말할 수는 없다 — 더 어려운 수학 문제집에서는 2024년 모델 14종 평균이 27.6%포인트 올랐다.
그림 4 는 이득이 큰 쪽과 거의 없는 쪽을 한 장으로 가른 것이다. 계산과 논리 쪽으로 가면 단계를 적게 하는 값이 크고, 상식과 독해 쪽으로 가면 거의 남지 않는다. 어디에 붙일지는 모델의 세대보다 문제의 종류가 먼저 정한다.
그래서 어디에 쓸지 안다 — 도달 범위
여기까지 온 것을 쓸 수 있는 형태로 옮기면 이렇다. 계산이 들어가거나 여러 단계를 밟아야 답이 나오는 문제라면 풀이를 먼저 쓰게 하는 편이 낫다. 상식이나 독해처럼 한 번에 판단이 서는 문제라면 같은 한 줄이 답을 거의 바꾸지 않고 응답만 길어진다. 길어진 응답은 그대로 비용이고, Sprague 연구팀이 가려 쓰자고 말하는 이유도 거기에 있다.
가르는 기준은 손으로 풀어 보면 잡힌다. 그 문제를 내가 푼다면 중간에 적어 둘 것이 생기는가. 장바구니 금액을 맞춰 보거나 두 날짜 사이를 세거나 조건 몇 개를 겹쳐 보는 일이라면 적어 둘 것이 생긴다. 어느 문장이 더 자연스러운지 고르거나 아는 사실을 떠올리는 일에는 적어 둘 것이 없다. 앞쪽에는 붙이고 뒤쪽에는 붙이지 않는 것이 앞의 표들이 말하는 쓰임새다.
요즘 챗봇을 쓰면서 그 한 줄을 덧붙일 일이 줄었다고 느낀다면 그 느낌에도 근거가 있다. Sprague 연구팀은 요즘 시스템이 추론 문제를 받으면 기본적으로 단계를 밟는다고 적으며 ChatGPT와 Llama 3.1을 든다. 다만 우리 실측이 그 문장을 확인해 준 것은 아니다 — 잰 것은 한 모델이 겉으로 풀이를 쓰지 않고도 쉬운 문제집을 맞혔다는 사실까지다.
풀이가 딸려 왔다고 그 풀이를 믿을 근거가 생기는 것도 아니다. Wei 연구팀이 맞은 답 50개를 손으로 들여다봤더니 두 개는 틀린 풀이로 우연히 맞은 것이었다. Kojima 연구팀의 오류 분석에도 같은 형태가 있다. 상식 문제에서 맞은 답 가운데 22.0%는 풀이 쪽이 틀려 있었다. 화면에 단계가 줄줄이 적혀 있다고 해서 그 단계가 답을 떠받치고 있다는 뜻은 아니다.
말하지 않은 것도 하나 적어 둔다. 단계가 화면에 보인다고 해서 모델이 사람처럼 생각한다는 근거가 되지는 않는다. 세 논문이 잰 것은 전부 정답률이고, 안에서 무슨 일이 벌어지는지는 열어 보지 않았다. Wei 연구팀은 그 물음을 열린 채로 남긴다고 논문에 적어 두었다.
앞에 나온 수치들은 저마다 다른 자리에서 나왔다. 17.7%와 78.7%, 조건을 갈라 본 실험의 6.5%와 14.3%는 전부 2022년 모델의 값이다. 범주별 표는 2024년 모델 14종의 평균이고, 그 안에 추론 전용으로 만들어진 모델은 없다. 우리가 잰 0.5%포인트는 2026년 모델 한 종, 그것도 내부 추론을 꺼 둔 상태의 값이다. 세 묶음은 모델도 문제집도 연도도 다르니 한 줄로 이어 읽을 수 없다.
세 묶음을 따로 읽고 나서도 「단계별로 생각해 봐」 한 줄이 하는 일은 분명하다. 답을 내놓기 전에 모델이 읽을 것을 스스로 먼저 쓰게 한다. 그 읽을 것이 답을 떠받치는 문제라면 이 한 줄은 지금도 크게 통하고, 그렇지 않은 문제에서는 응답만 길어진다. 어느 쪽인지는 문제를 적는 자리에서 먼저 보인다. 내가 지금 내려는 문제가 어느 쪽인가에 달렸다.
더 읽기
- Kojima, Gu, Reid, Matsuo, Iwasawa, "Large Language Models are Zero-Shot Reasoners", NeurIPS 2022 (arXiv:2205.11916v4) — https://arxiv.org/abs/2205.11916
- Wei, Wang, Schuurmans 외, "Chain-of-Thought Prompting Elicits Reasoning in Large Language Models", NeurIPS 2022 (arXiv:2201.11903v6) — https://arxiv.org/abs/2201.11903
- Sprague, Yin, Rodriguez 외, "To CoT or not to CoT? Chain-of-thought helps mainly on math and symbolic reasoning", ICLR 2025 (arXiv:2409.12183v3) — https://arxiv.org/abs/2409.12183