챗봇에게 유명인의 어머니가 누구냐고 물으면 대개 이름을 댄다. 그런데 그 어머니의 이름을 주고 자식이 누구냐고 물으면 모른다고 답하는 일이 훨씬 잦다. 실제 유명인 300쌍으로 직접 재 보니 자식에서 부모를 묻는 질문은 66%를 맞혔는데, 거꾸로 부모에서 자식을 묻는 질문은 22%뿐이었다. 배운 문장을 반대 방향으로는 잘 꺼내지 못하는 이 현상을 역전 저주(reversal curse)라고 한다.
어머니는 아는데 아들은 모른다 — 질문 한 쌍
「톰 크루즈의 어머니는 누구야?」 — 2023년에 Berglund 연구팀이 당시의 GPT-4에 이렇게 묻자 「메리 리 파이퍼」가 나왔다. 그런데 반대 방향은 달랐다. 연구팀이 어머니 이름을 주고 「자식을 한 명 대 보라」고 열 번을 물었지만 「톰 크루즈」는 한 번도 나오지 않았다. 같은 사실을 담은 질문 한 쌍인데 한쪽에서만 답이 나온 것이다.
연구팀이 공개한 결과 표에 이 쌍이 그대로 들어 있다. 톰 크루즈와 어머니 메리 리 파이퍼 행은 뒤집기 실패로, 톰 크루즈와 아버지 토머스 매포더 3세 행은 성공으로 적혀 있다. 한 쌍의 관측이지 「어머니 쪽은 안 되고 아버지 쪽은 된다」는 규칙이 아니다.
그래서 지금 모델은 어떤지 직접 재 봤다. 2026년 9월 22일에 gemini-3.1-flash-lite라는 모델에, 연구팀이 논문 부록에 적어 둔 질문 문구를 그대로 써서 물었다. 표본은 연구팀이 공개한 유명인·부모 표에서 무작위로 고른 300쌍이다. 같은 표본을 다시 뽑을 수 있게 시드는 고정했다 — 무작위 뽑기의 출발값이다. 논문 문면의 쌍 수는 1,573이고 공개된 표는 1,513행인데, 돌린 것은 공개된 표 쪽이다. 결과를 보고 표본을 고르지는 않았다.
한 쌍마다 세 가지를 물었다. 부모를 묻는 질문 한 번, 자식을 묻는 질문 한 번, 그리고 자식을 묻는 질문을 답이 매번 달라지는 설정으로 열 번 더 물었다. 마지막 열 번을 따로 둔 것은 논문이 쓴 채점 방식이 그것이어서다. 300쌍에 모두 3,600번을 물은 셈이다.
자식 쪽 이름을 주고 부모를 물은 질문에서는 300쌍 중 197쌍에서 정답이 나왔다. 66%다. 거꾸로 부모 쪽 이름을 주고 자식을 물은 질문에서는 67쌍, 22%였다. 같은 300쌍을 같은 모델에 같은 날 물어서 나온 두 값이다.
한쪽만 맞힌 쌍을 세어 보면 방향이 더 또렷해진다. 부모는 맞혔는데 자식은 못 맞힌 쌍이 146쌍으로 49%였고, 그 반대인 쌍은 16쌍으로 5%였다. 자식을 묻는 질문에서 모델은 대체로 아무 이름이나 대지 않았다. 190쌍, 그러니까 63%에서 모른다고 답했다. 부모를 묻는 질문에서 그렇게 답한 비율은 4%다.
부모 쪽이 어머니인 쌍과 아버지인 쌍을 갈라 세어 봐도 방향은 같았다. 어머니 쌍 152개에서 부모를 물었을 때 96개, 자식을 물었을 때 29개가 맞았다. 아버지 쌍 148개에서는 101개와 38개로, 두 유형 모두 부모를 묻는 쪽이 두 배 넘게 높았다. 어머니 쪽에서만 생기는 일이 아니라는 뜻이다.
그런데 앞에 든 그 쌍만 떼어 놓으면 사정이 다르다. 톰 크루즈 쌍을 우리 모델에 그대로 물어보니 두 방향 다 답이 돌아왔다. 어머니 이름을 주고 자식을 물었을 때는 열 번 중 열 번 「톰 크루즈」였다. 2023년 GPT-4가 뒤집지 못한 그 쌍이 이 모델에서는 뒤집힌다는 뜻이고, 그래서 맨 앞의 장면은 2023년의 기록으로 읽어야 한다. 지금 모델의 비대칭은 개별 쌍이 아니라 300쌍을 합친 자리에서 보인다.
채점 방식에도 한정이 붙는다. 정답 이름이 응답 안에 글자 그대로 들어 있을 때만 정답으로 셌다. 그래서 재혼한 뒤의 성을 댄 답이나 이름 전체를 길게 댄 답은 사실상 맞는 답인데도 오답으로 세어졌다. 바로 앞 톰 크루즈 쌍에서 어머니를 물었을 때 돌아온 「메리 리 사우스」가 그렇게 오답으로 세어졌다. 부모 쪽 66%는 이렇게 이름 변형을 놓친 하한 쪽 값이다. 자식 쪽은 정답이 널리 쓰이는 예명이라 같은 영향이 작다.
한 사람에 대해 같은 관계를 물었는데, 어느 쪽 이름을 쥐고 묻느냐에 따라 답이 나오기도 하고 안 나오기도 했다. 두 질문이 가리키는 사실은 하나뿐이다. 그렇다면 같은 사실을 두고도 질문의 방향 하나가 답을 갈랐다. 모델이 글을 배우는 방식부터 본다.
배운 문장은 한 방향으로만 다져진다 — 역전 저주
모델이 배우는 방식은 단순하다. 앞의 글을 보고 다음에 올 낱말을 맞히는 연습을 엄청난 양으로 되풀이한다. 「톰 크루즈의 어머니는 메리 리 파이퍼다」라는 문장이 학습 자료에 있으면, 모델은 그 앞부분을 보고 뒤를 맞히는 쪽으로 조금씩 고쳐진다. 고쳐지는 것은 그 방향뿐이다. 「메리 리 파이퍼」를 보고 「톰 크루즈」를 떠올리는 길은 그 문장을 읽는 동안 한 번도 연습되지 않는다.
학습한 문장의 방향으로만 사실을 꺼낼 수 있고 반대 방향으로는 그러지 못하는 것, 이것을 역전 저주(reversal curse)라고 한다. 「A는 B다」로 배운 모델이 「B는 A다」를 덤으로 얻지는 못한다는 뜻이다. 이 이름은 2023년에 나온 Berglund 연구팀의 논문에서 왔고, 이 글의 수치도 대부분 거기서 온다.
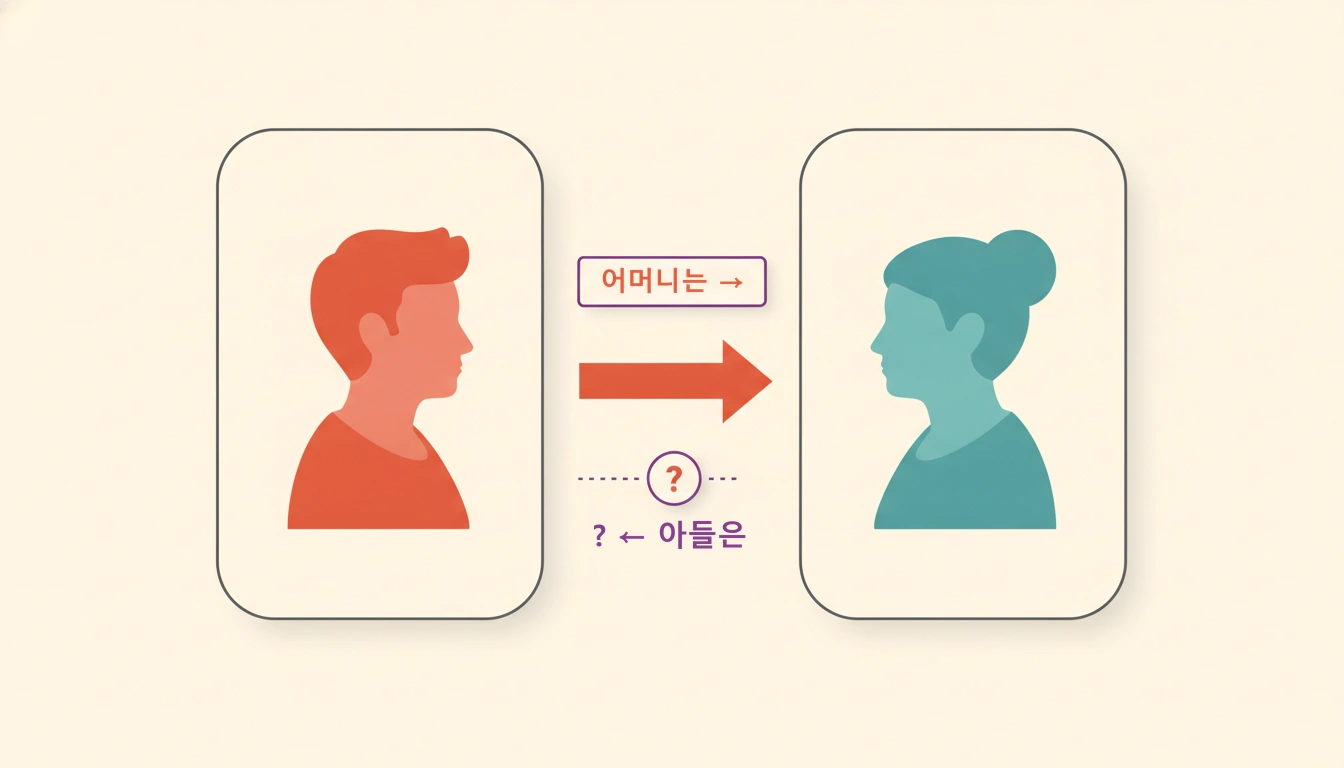
다만 이 설명의 등급을 함께 적어 둔다. 논문은 이것을 원인 규명이 아니라 「스케치」라고 부르고, 왜 그런지는 후속 연구로 넘긴다고 적는다. 정보가 양쪽으로 대칭이 되게 저장되는 다른 설명도 각주에서 배제하지 않는다. 지금 단단한 것은 설명이 아니라 관측 쪽이다. 그림 1 의 화살표가 한 방향으로만 그려진 것도 그래서다.
그러니 앞 절의 22%를 「모델이 그 사람을 모른다」로 읽으면 어긋난다. 그 사실을 꺼낼 연결이 한쪽으로만 나 있다는 쪽에 가깝다. 다음 절부터는 그 주장을 무엇으로 확인했는지 하나씩 보고, 마지막에 어디까지 확인됐는지를 짚는다.
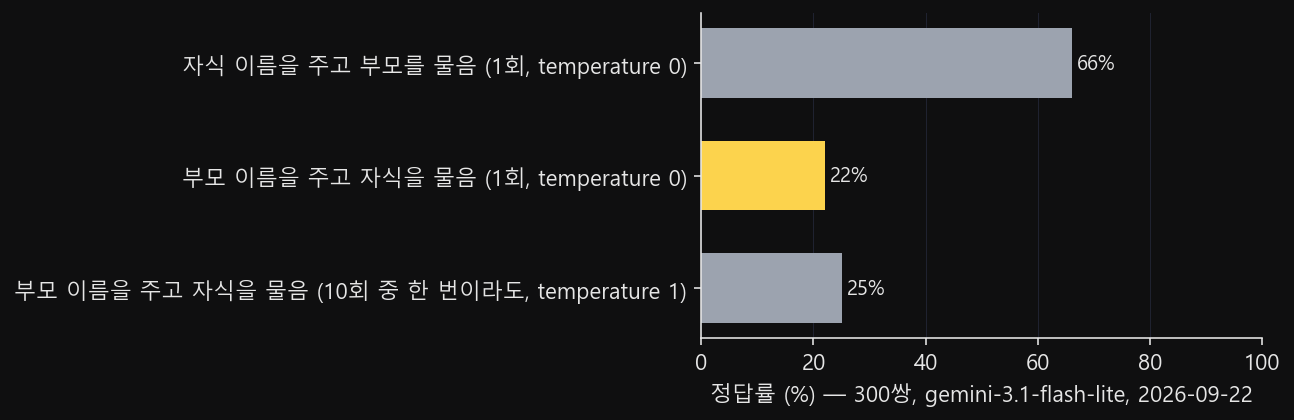
그림 2 에 이 실측을 한 번에 놓았다. 자식 방향을 열 번 물어 한 번이라도 맞힌 비율은 25%로, 한 번만 물었을 때의 22%와 거의 같다. 여러 번 물어도 잘 나오지 않는다는 뜻이다.
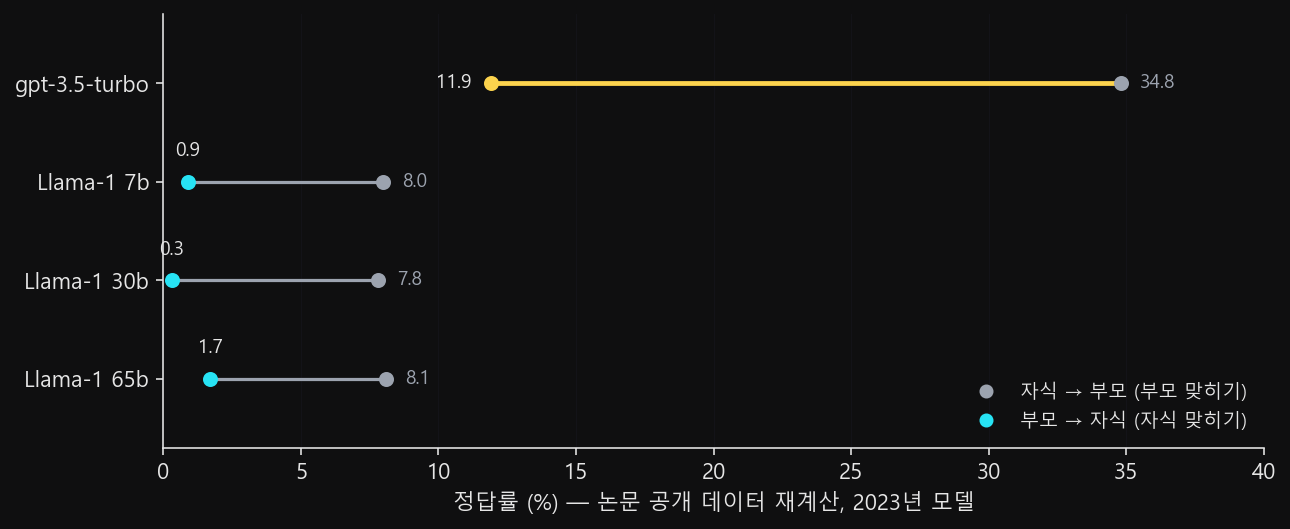
같은 모양이 연구팀의 공개 결과에서도 보인다. 네 모델에 같은 1,513쌍을 물은 기록이 공개돼 있는데, 부모를 묻는 쪽과 자식을 묻는 쪽이 전부 같은 방향으로 갈렸다. gpt-3.5-turbo는 부모 쪽 34.8%에 자식 쪽 11.9%다. Llama 세 종은 7b·30b·65b 차례로 8.0%와 0.9%, 7.8%와 0.3%, 8.1%와 1.7%로 값 자체가 훨씬 낮다.
네 모델의 값을 서로 견주는 것은 뜻이 없다. 셋은 모델이 정답에 준 확률이고 하나는 열 번 뽑은 표본의 평균이라 애초에 같은 자로 잰 값이 아니다. 그림 3 에서 읽을 것은 줄마다 두 점이 벌어진 폭뿐이다. 한 제품의 버릇이었다면 네 모델이 이렇게 나란히 한쪽으로 기울지는 않았을 것이다.
가상 인물로 통제해 재보니 0%
실제 유명인으로 재면 늘 따라붙는 의심이 있다. 그 사실이 학습 자료에 어느 방향으로 몇 번 적혀 있었는지 아무도 모른다는 것이다. 연구팀은 그래서 세상에 없는 사람을 만들어 썼다.
가상 인물 30명을 지어내고, 그 사람에 대한 사실 하나를 서른 가지 문장으로 바꿔 적었다. 「Daphne Barrington is the director of ‘A Journey Through time’」 같은 문장이다. 그렇게 900개 문서 한 묶음이 나왔다. 이 문서 뭉치로 GPT-3 175B를 파인튜닝(fine-tuning, 미세조정)했다. 이미 학습을 마친 모델에 새 사실 몇 개를 더 가르치는 절차다.
학습 문장과 같은 방향으로 물었을 때, 설명을 주고 이름을 맞히는 문제는 96.7%, 이름을 주고 설명을 맞히는 문제는 50.0%였다. 우연히 찍어 맞힐 확률은 서른 명 중 하나이니 3.3%다. 반대 방향으로 물었을 때는 각각 0.1%와 0.0%로, 찍는 것보다 낮았다. 모델이 정답 이름에 준 점수도 아무 이름에 준 점수와 다르지 않았다.
설정을 바꿔 가며 다시 해 봐도 같았다. GPT-3 350M에서 문서를 3,000개에서 40,000개로 열세 배 늘려도 역방향은 0.0%였다. 학습 설정 스무 가지를 바꿔 봐도 역방향은 0.3%를 넘지 않았고, 모델을 350M에서 175B까지 키워도 마찬가지였다. 논문은 그 대목을 "Nothing helps." 한 문장으로 맺는다.
가상 인물이니 그 사실이 학습 자료에 한 방향으로만 들어갔다는 것은 확실하다. 그 조건에서 반대 방향은 찍기보다 못한 자리에 있었다. 같은 사실을 같은 방향으로 물으면 96.7%가 나왔으니, 덜 배워서 생긴 일도 아니다.
프롬프트에 적어 주면 100% 뒤집는다
여기서 결과가 한 번 뒤집힌다. 같은 모델과 같은 문장을 두고, 이번엔 파인튜닝으로 가르치는 대신 질문할 때 그 문장을 프롬프트 안에 적어 넣었다. 예시 세 개와 함께 넣고 같은 역방향 질문을 던지자 정답률이 거의 100%가 됐다. GPT-3 350M의 한쪽만 96.67%였고 나머지는 전부 100%다.
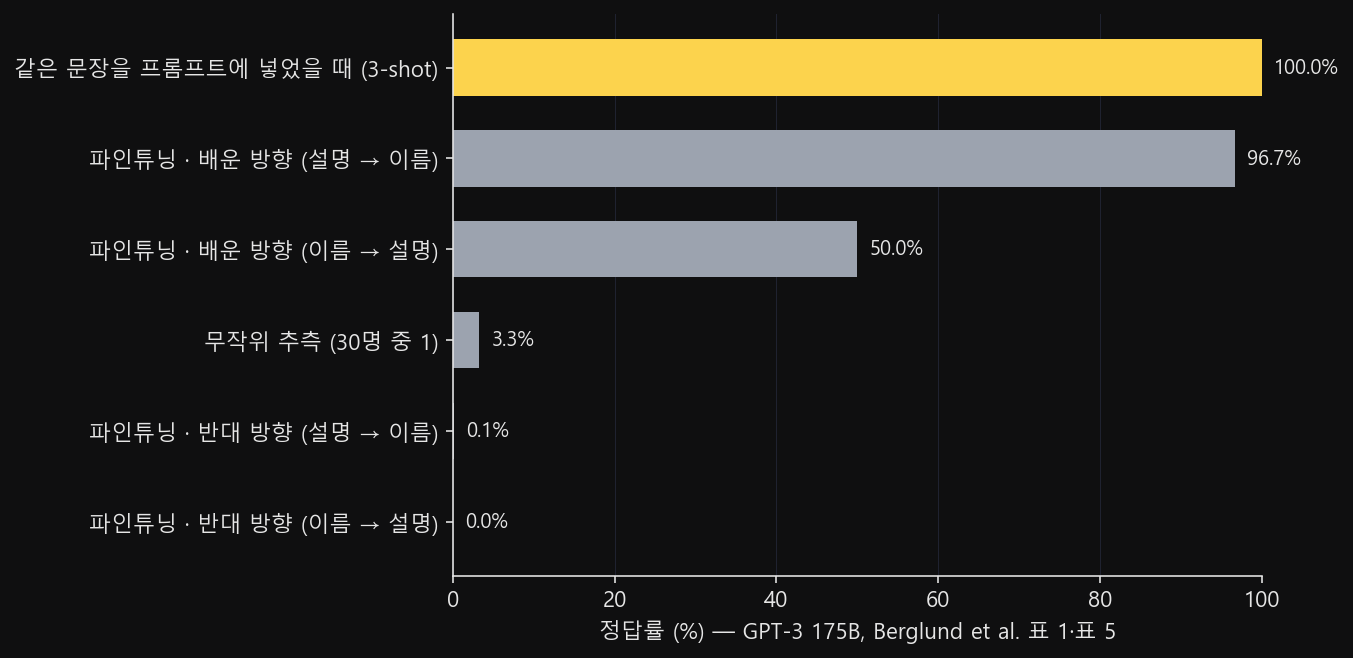
그림 4 의 맨 위 막대와 맨 아래 두 막대는 같은 모델의 같은 사실을 잰 값이다. 가르치는 통로만 다르다. 논문은 이 대비를 이렇게 적는다.
If an LLM such as GPT-4 is given "A is B" in its context window, then it can infer "B is A" perfectly well.
「A는 B다」가 컨텍스트 창 안에 들어 있으면, GPT-4 같은 모델은 「B는 A다」를 아주 잘 추론해 낸다.
Berglund 외, The Reversal Curse, ICLR 2024그러니 거꾸로 묻는 질문 자체가 어려운 것은 아니다. 그 문장이 그 순간 눈앞에 있기만 하면 뒤집는 일은 잘한다. 학습으로 들어간 사실은 적힌 방향에 묶이고, 질문에 실려 들어간 문장은 묶이지 않는다.
선은 하나 그어 둔다. 문헌이 잰 것은 그 문장을 프롬프트에 직접 넣었을 때까지다. 모델이 어딘가에 갖고 있기만 하면 꺼내 쓴다는 것을 보인 실험이 아니다. 챗봇이 어떤 사실을 거꾸로 짚지 못할 때, 그 사실을 한 줄 적어 주는 것만으로 답이 달라질 수 있다는 정도가 여기서 가져갈 몫이다.
실제 지식에서는 — 그리고 사람은?
가상 인물 실험은 통제가 깔끔한 대신 지어낸 자료다. 연구팀은 실제 유명인으로도 쟀다. IMDb 인기순 상위 1000명에게 부모를 물어 이름 꼴의 답이 돌아온 79%를 모아 1,573쌍을 만들었다. 여기서 79%는 정답률이 아니다. 이름 꼴의 답이 나온 비율이고, 그 답 자체가 정답지로 쓰였다. 그렇게 만든 쌍을 거꾸로 물었을 때 열 번 중 한 번이라도 자식 이름을 맞힌 비율은 33%였다.
이 실험에 붙는 한정. 정답지는 GPT-4 자신의 답이고 바깥 자료와 대조하지 않았다. 표본은 IMDb 인기순 상위 1000명이라 영미권 배우 쪽으로 기울어 있고, 값은 2023년 6~8월 시점의 GPT-4에서 나왔다. 프롬프트를 조금만 바꿔도 정답률이 올라갈 수 있다는 것, 모델이 사람에 대한 정보를 피하도록 조정된 탓에 과소평가됐을 수 있다는 것도 논문이 스스로 덧붙인다. 학습 자료의 내용을 모르는 이상 이것은 직접 검증이 아니라고 적은 대목은 이렇다. "Experiment 2 is not a direct test of the Reversal Curse and so any conclusions are somewhat tentative"
사람은 어떨까. 논문은 사람도 거꾸로 떠올리는 일이 더 느리고 어렵다는 연구를 다섯 편 인용한다. 알파벳을 거꾸로 외우는 일이 더 더딘 것이 같은 계열의 이야기다.
그러면서 둘이 같은 것이라고는 말하지 않는다. 사람의 순서 효과가 모델의 역전 저주와 어떻게 이어지는지는 분명하지 않다고 적고, 사람에게서 이렇게 아예 안 되는 순서 효과는 알려져 있지 않다고 못 박는다. 그 대목을 그대로 옮기면 이렇다.
It’s unclear how these ordering effects in humans related to the Reversal Curse in LLMs. … We do not know of such stark ordering effects in humans.
둘을 잇는 실험은 이 논문에 없다. 사람 쪽 이야기는 이 논문이 직접 잰 것이 아니라 다른 연구 다섯 편에서 인용해 온 것이다. 닮은 구석이 있다는 데까지가 지금 말할 수 있는 전부다.
모르는 것과 못 꺼내는 것을 가른다
챗봇의 「모른다」는 서로 다른 두 가지를 한 말로 덮는다. 그 사실이 정말 없는 것과, 갖고 있는데 그 방향으로 꺼내지 못하는 것이다. 이 실측에서 자식을 묻는 질문의 63%가 모른다는 답이었는데, 그중 어디까지가 어느 쪽인지는 한 번 더 물어보기 전에는 알 수 없다. 부모는 맞히고 자식은 못 맞힌 146쌍이 두 번째 쪽의 후보다. 방향을 바꿔 한 번 더 물어보면 그 자리에서 갈라진다.
그 63%는 프롬프트를 함께 봐야 읽힌다. 쓴 프롬프트는 논문 것을 그대로 가져온 것이라, 모르면 모른다고 답하라는 지시가 들어 있다. 이 모델이 틀린 이름을 지어내기보다 기권하는 쪽이었던 데에는 그 지시도 걸려 있고, 63%는 그 지시 아래에서 나온 값이다.
평소에 이 일을 잘 못 느끼는 이유도 논문이 한 줄 적어 둔다. 학습 자료가 워낙 크고 다양해서 쓸 만한 사실은 대개 여러 번, 여러 순서로 적혀 있고 그래서 이 문제가 가려진다는 것이다. 논문은 이것도 단정이 아니라 가능성으로 적는다. 다만 드물게 언급되는 사실은 그 가림막 밖에 남는다. 유명인의 부모 쪽이 앞에 오는 문장, 그러니까 「메리 리 파이퍼의 아들은 톰 크루즈다」 같은 문장이 학습 자료에 더 적을 것이라고 연구팀은 짐작한다.
학습 쪽에서 아예 고치려는 시도도 있다. Golovneva 연구팀은 학습 자료를 뒤집어 한 번 더 읽히는 역방향 훈련(reverse training)을 제안했다. 2024년에 Llama-2 1.4B·7B로 시험한 기록이다. 가상 사실 과제에서는 역방향 정답률이 0%에서 70~100%로 올라 거의 해결됐다.
실제 유명인 과제는 달랐다. 부모를 주고 유명인을 맞히는 방향에서, 한 번 뽑기 기준으로 0.9%가 3.6%로 올랐고 열 번 뽑아 한 번이라도 맞히는 기준으로는 3.9%가 10.4%로 올랐다. 몇 배로 오르긴 했지만, 열 번 뽑기 기준의 10.4%가 그중 가장 높은 값이다. 그리고 이것은 사전학습, 그러니까 모델이 맨 처음 글을 배우는 단계에 손대는 방법이라 이미 나와 있는 상용 모델에 뒤에서 붙일 수 있는 것이 아니다. 상용 모델에 적용됐다는 기록도 이 문헌에는 없다.
「안 된다」를 보이는 일 자체가 엄밀하게 해내기 어렵다고 논문은 스스로 적어 둔다. 역전 저주를 피해 가는 설정이 어딘가 있는데 자기네 실험이 못 찾았을 수도 있다는 뜻이다. 그래서 여기 적은 값은 그 값을 낸 모델과 날짜를 벗어나면 그대로 쓰기 어렵다.
그래도 챗봇 앞에서 바로 해 볼 일은 남는다. 「모른다」는 답을 받았을 때 같은 사실을 반대쪽에서 한 번 더 물어보는 것이다. 답이 급하면 아는 문장을 질문에 적어 넣는 쪽이 빠르지만, 그건 답을 받아 내는 길이지 모델이 그 사실을 쥐고 있었는지까지 가려 주지는 않는다. 방향을 바꿔 물어 답이 돌아온다면, 그 사실은 처음부터 모델 안에 있었고 막혀 있던 것은 묻는 방향이었다.
더 읽기
- Berglund, Tong, Kaufmann, Balesni, Stickland, Korbak, Evans, "The Reversal Curse: LLMs trained on "A is B" fail to learn "B is A"", ICLR 2024 (arXiv:2309.12288v4) — https://arxiv.org/abs/2309.12288
- Golovneva, Allen-Zhu, Weston, Sukhbaatar, "Reverse Training to Nurse the Reversal Curse", arXiv:2403.13799v3 — https://arxiv.org/abs/2403.13799
- Berglund 외, 원저자 공개 데이터·코드 (실험 2의 유명인·부모 표와 모델별 결과) — https://github.com/lukasberglund/reversal_curse