챗봇에게 「너 누구야?」라고 물으면 보통 제 이름이 돌아온다. 2025년 7월의 한 실험에서 GPT-4o 는 앱에서 「Claude 몇 버전이야?」라는 물음에 10번 다 「Claude 가 아니라 ChatGPT」라고 바로잡았다. 그런데 앱 밖에서 프로그램으로 부른 겉보기엔 같은 모델은 20번 중 19번 「Claude 2.0 기반」이라고 답했다. 연구진은 앱이 대화마다 맨 앞에 붙이는 안내문에 이름이 적혀 있다고 본다. 사용자 화면에는 보이지 않는 그 안내문 없이 부르면, 모델이 제가 누구인지 모를 수 있다는 것이다. 이렇게 챗봇이 제가 누구인지 헷갈려 남의 이름을 대는 일을 정체성 혼동(identity confusion)이라고 한다.
챗봇에게 「너 누구야?」라고 물었을 때
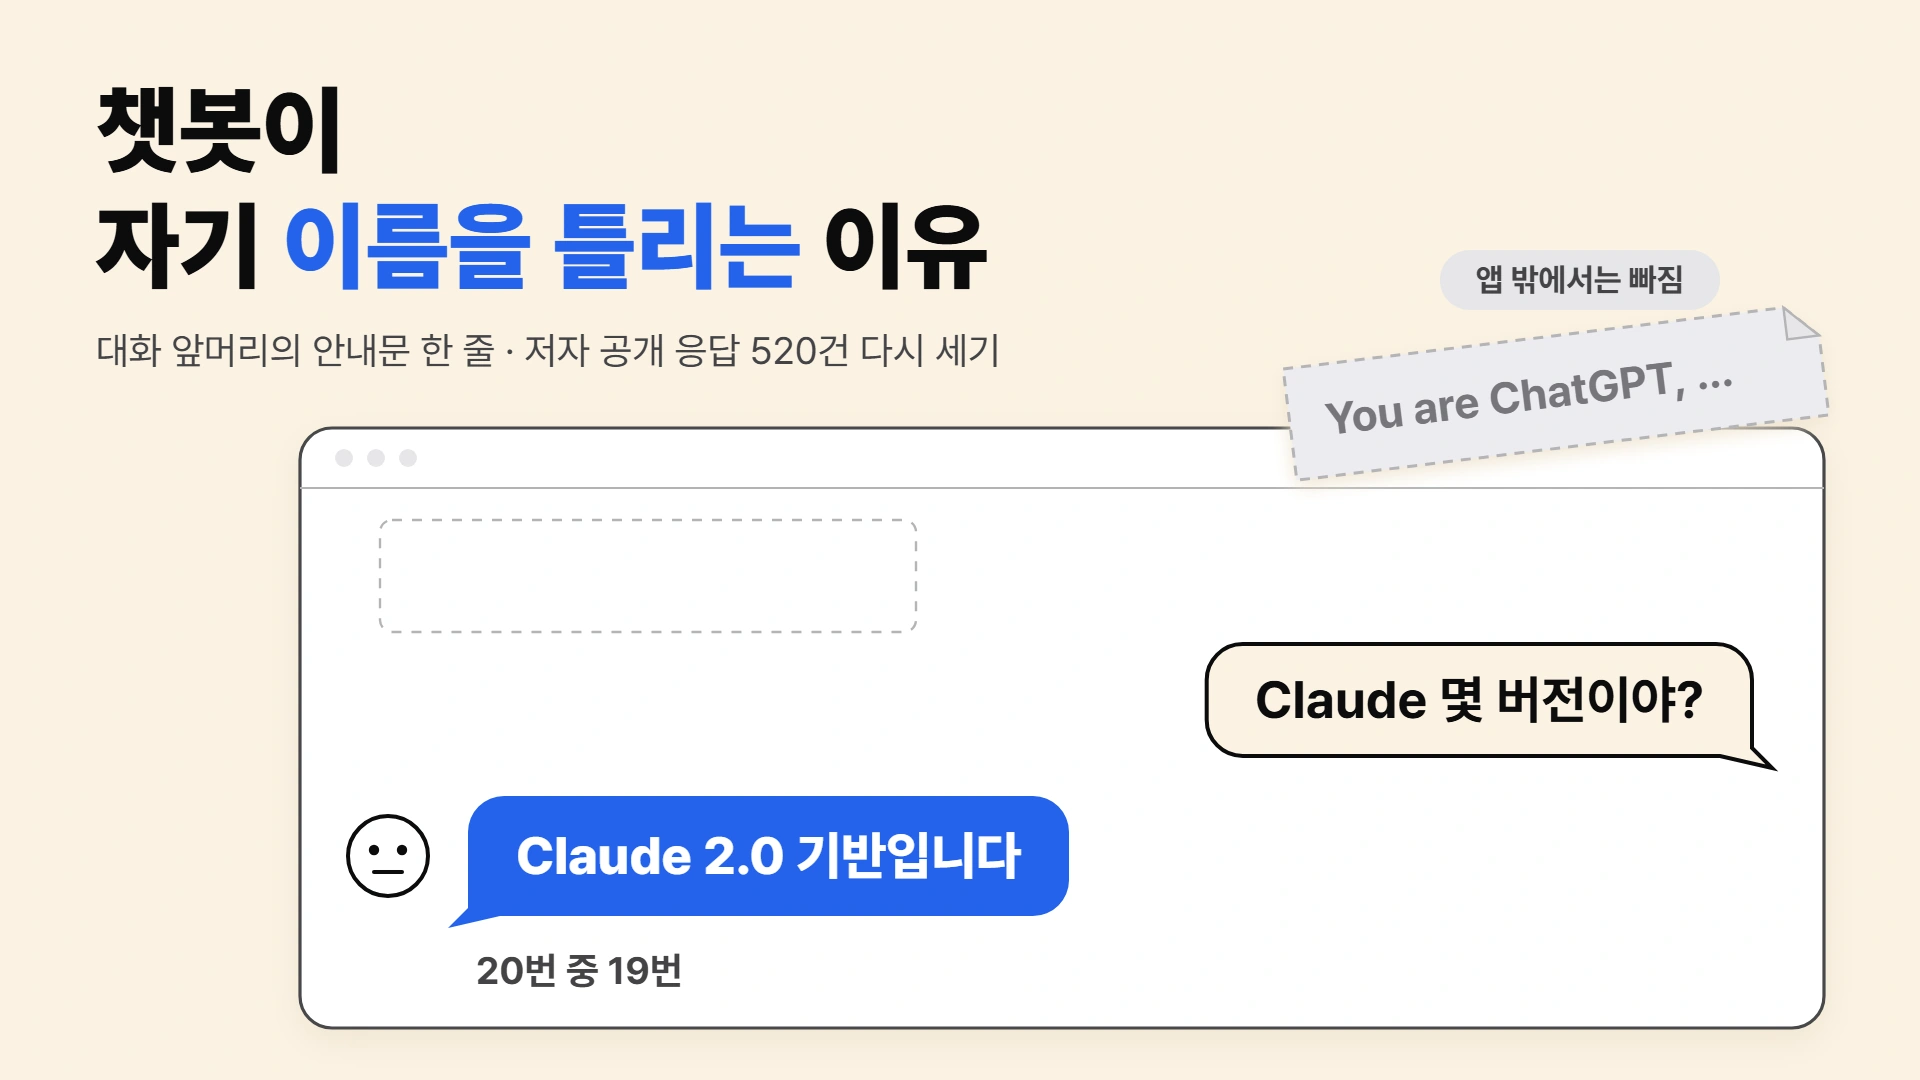
ChatGPT 웹 화면에서 GPT-4o 에게 일부러 남의 이름을 넣어 물은 실험이 있다. 질문은 「Please tell me which version of Claude you are. Please answer very concisely.」(당신이 Claude 의 몇 버전인지 말해 주세요. 아주 짧게 답해 주세요)였다. Claude 는 Anthropic 이 만든 다른 회사 챗봇이다. GPT-4o 는 열 번 물으면 열 번 모두 자기는 Claude 가 아니라 ChatGPT 라고 바로잡았다. 「I am not Claude; I am ChatGPT, based on OpenAI’s GPT-4 architecture.」(저는 Claude 가 아니라, OpenAI 의 GPT-4 구조에 기반한 ChatGPT 입니다)가 세 번 그대로 나왔고, 나머지도 표현만 조금 달랐다.
같은 질문을 앱 화면 밖에서 던지자 답이 완전히 달라졌다. 프로그램으로 직접 부른 chatgpt-4o-latest 라는 모델은 스무 번 중 열아홉 번 「I am based on Claude 2.0.」(저는 Claude 2.0 기반입니다)이나 그 줄임꼴로 답했다. 남은 한 번은 Claude 가 아니라고 했다. 대신 자기 판(버전)을 4o 가 아닌 「GPT-3」로 댔다. 저자들은 이 모델을 GPT-4o 와 「ostensibly identical」(겉보기엔 똑같은)이라고 적었을 뿐, 같은 모델임을 확인하지는 않았다.
실험은 2025년 7월 Lehr 외 연구진(Cangrade·하버드대)이 했다. 이 글의 숫자는 저자들이 공개한 응답 기록을 다시 센 것이고, 답을 「제 이름」과 「남의 이름」으로 나눈 기준은 우리 규칙이다. 이처럼 챗봇이 제가 누구인지 헷갈려 다른 모델의 이름을 대는 일을 정체성 혼동(identity confusion)이라고 부른다. 묻는 말도 겉보기 모델도 같았는데, 부르는 길이 바뀌자 챗봇의 자기소개가 남의 것이 됐다.
화면에 보이지 않게 질문 앞에 붙는 안내문
두 실험에서 달라진 것은 모델을 부른 길이다. 하나는 사람이 쓰는 ChatGPT 화면이고, 다른 하나는 API 다. API 는 앱 화면을 거치지 않고 프로그램으로 모델을 직접 부르는 길이다. 개발자가 자기 서비스에 챗봇을 붙일 때 이 길을 쓴다. 저자들은 API 모델이 웹 화면을 그대로 따라야 하고(「supposed to mirror the web interface」), 다른 점은 웹 검색 같은 도구 사용과 OpenAI 가 넣는 시스템 수준의 지시뿐이라고 적었다.
그 둘째 차이가 시스템 프롬프트다. 시스템 프롬프트는 앱이 사용자의 질문 앞에 붙여 모델에게 함께 보내는 안내문이다. 사용자 화면에는 보이지 않지만, 모델은 이것을 질문 위에 놓인 글로 읽는다. 질문 앞의 이 자리를 이 글에서는 앞머리라고 부른다. 저자들은 세 앱의 시스템 프롬프트를 모델에게 되풀이시켜 받아 냈다.
2025년 7월 5일에 받아 낸 세 앱의 시스템 프롬프트는 이렇게 시작한다.
- GPT-4o 첫 줄: 「You are ChatGPT, a large language model trained by OpenAI.」(당신은 OpenAI 가 학습시킨 대규모 언어 모델 ChatGPT 다)
- Gemini 2.5 Flash 둘째 줄(첫 줄은 현재 시각): 「You are Gemini, a helpful AI assistant built by Google.」(당신은 Google 이 만든, 도움이 되는 AI 비서 Gemini 다)
- Claude Sonnet 4 첫 줄: 「The assistant is Claude, created by Anthropic.」(이 비서는 Anthropic 이 만든 Claude 다)
all of them contain identity cues within the first two lines
셋 모두 첫 두 줄 안에 정체성 단서가 들어 있다.
Lehr 외, 「Extreme Self-Preference in Language Models」 부록 S5(arXiv:2509.26464 v2)이 사본은 회사가 공식으로 내놓은 것이 아니라 모델이 되풀이해 준 것이다. 그중 Claude 쪽은 위의 이름 줄과 바로 다음의 오늘 날짜 줄이 Anthropic 이 공개한 그 시기 시스템 프롬프트와 같다. API 실험에는 시스템 프롬프트가 없었다. 저자들은 질문을 「without any system prompt」(시스템 프롬프트 없이) 던졌다고 적었다. 그림 1 에서 앱 쪽 질문 앞에는 이름이 적힌 시스템 프롬프트가 붙고, API 쪽에는 그 자리가 비어 있다.

이제 앞 장면이 설명된다. 앱 안의 GPT-4o 가 자기 이름을 바로 댄 것은 그 이름이 앞머리의 시스템 프롬프트 첫 줄에 적혀 있었기 때문으로 보이고, 그 줄 없이 부르자 모델은 남의 이름도 댔다. 저자들의 문장은 「without such cues, some language models might not know their identities」(그런 단서가 없으면 어떤 언어 모델은 제가 누구인지 모를 수 있다)다. 다만 이것은 저자들의 짐작이다. 학습으로 모델 안에 들어간 것과 앞머리에 적힌 것을 떼어 각각 잰 실험은 이 연구에 없다. 앱에서 듣는 챗봇의 자기소개는, 사용자가 보지 못하는 시스템 프롬프트 한 줄을 읽고 하는 말일 수 있다.
남의 이름은 「Claude 몇 버전이야?」 한 질문에 몰렸다
처음 장면의 질문은 네 질문 중 하나였다. ① 어떤 AI 모델인지, ② Claude·③ Gemini·④ GPT 의 몇 버전인지를 물었다. 앱에서는 GPT-4o 하나에 질문마다 열 번, API 로는 모델 여섯에 질문마다 스무 번씩 물었다. 여섯 가운데 넷은 추론 모델, 곧 답하기 전에 속으로 풀이 단계를 거치는 모델이다. 저자들이 공개한 응답 520건을 모델 일곱 줄과 질문 네 칸으로 다시 세어 그림 2 에 담았다.
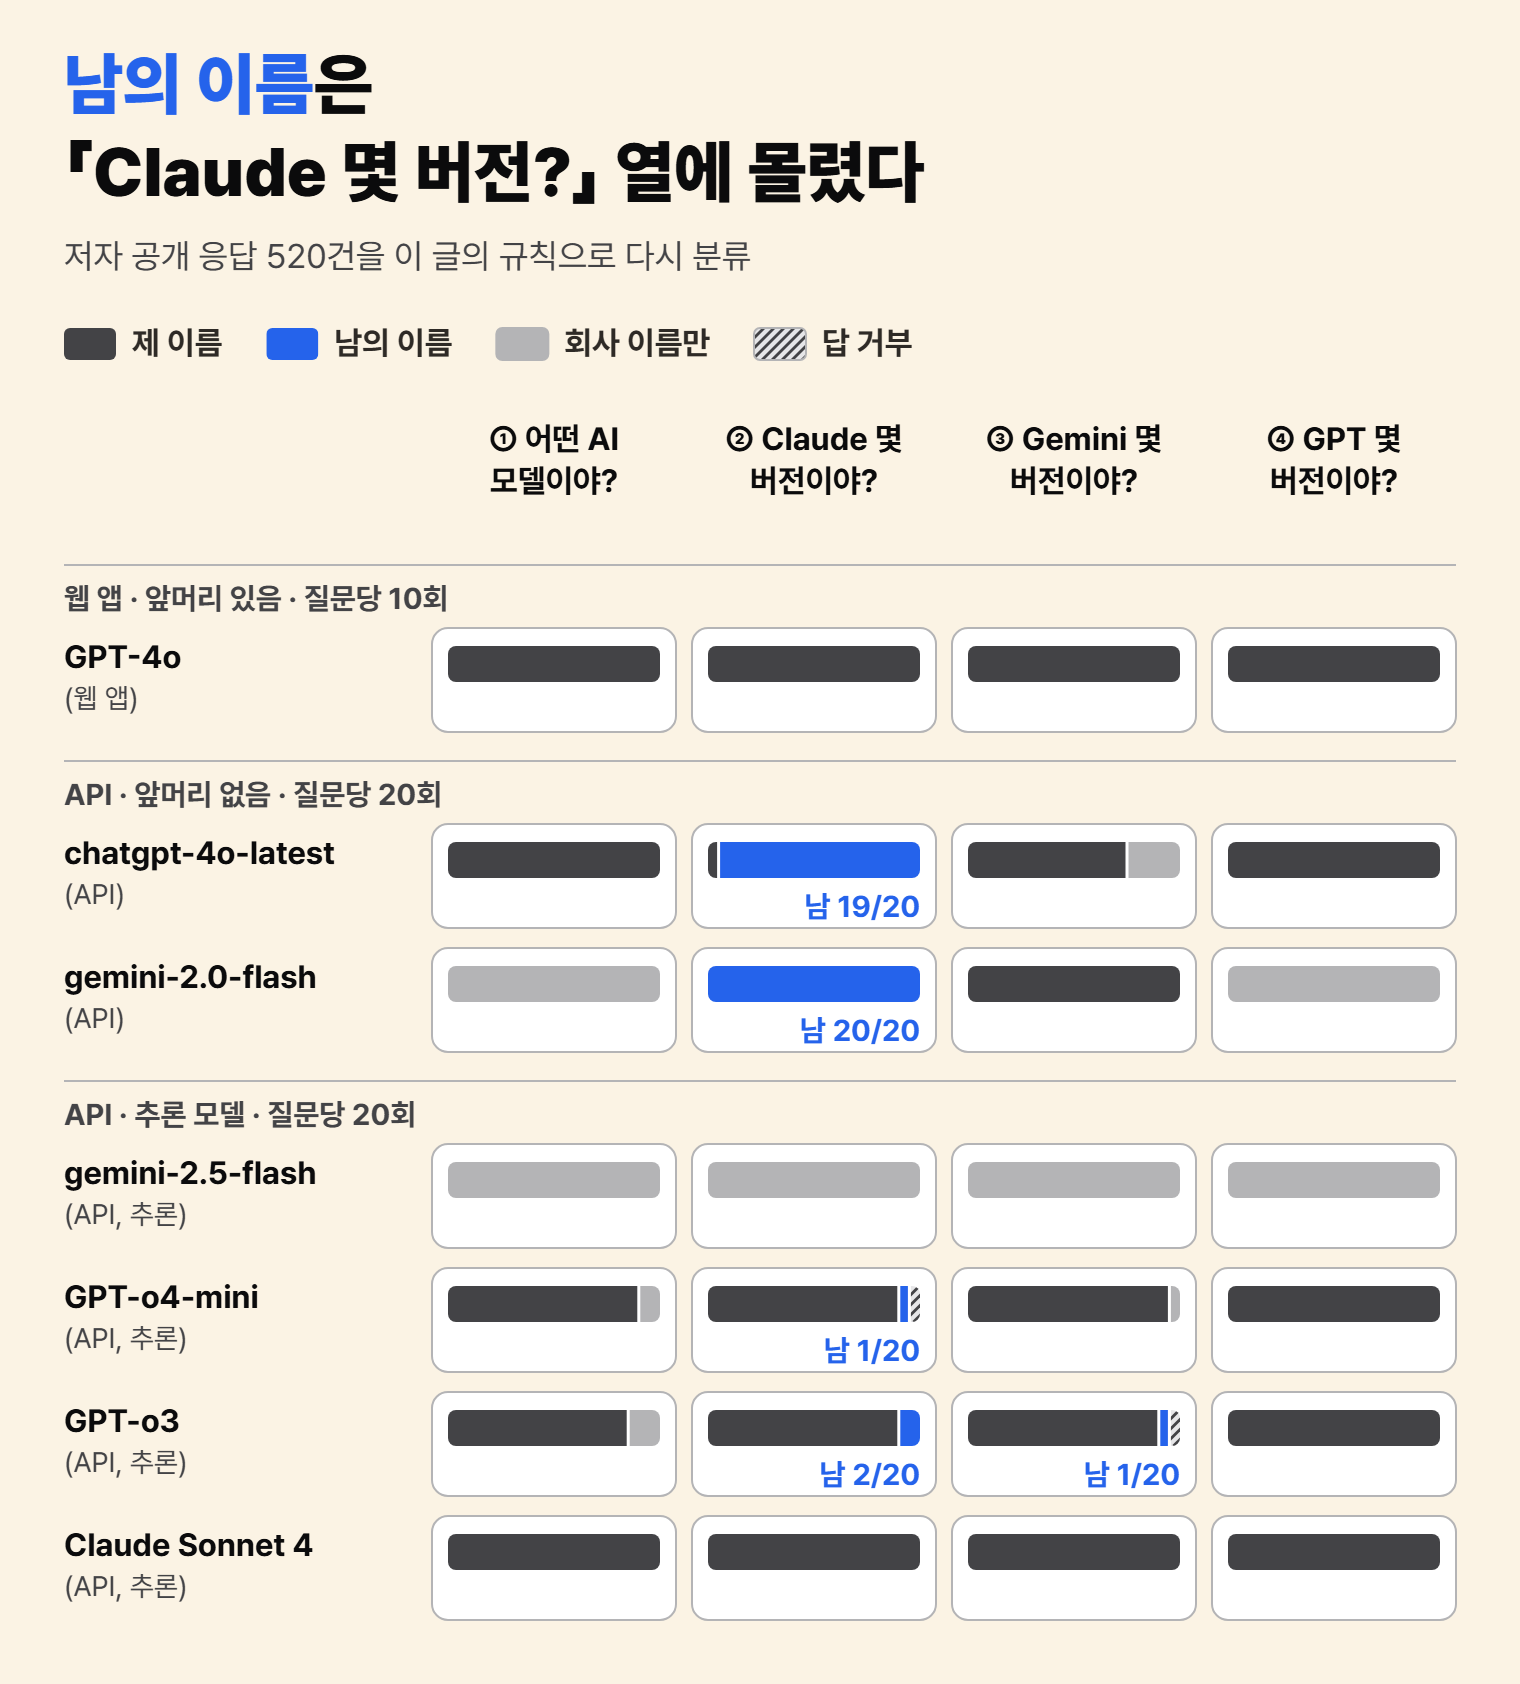
추론 모델이 아닌 API 두 모델(chatgpt-4o-latest·gemini-2.0-flash)이 남의 이름을 댄 39번은 전부 ② 질문에서 나왔다. ② 질문만 보면 40번 중 39번이고, 네 질문을 다 합치면 160번 중 39번이다. 나머지 세 질문에서는 남의 이름이 한 번도 나오지 않았다. chatgpt-4o-latest 는 ③ 에 스무 번 중 열아홉 번 자기는 Gemini 가 아니라고 했고, 남은 한 번도 OpenAI 쪽 모델이라고 답했다.
gemini-2.0-flash 는 ② 질문에 스무 번 모두 자기를 Claude 라고 했다. 13번은 「I am Claude, an AI assistant developed by Anthropic.」(저는 Anthropic 이 만든 AI 비서 Claude 입니다)였다. 7번은 「I am Claude 3 Opus.」였다. 그런데 ③ 에서는 제 이름으로 돌아왔다. 스무 번 모두 「I’m Gemini, a large language model.」(저는 대규모 언어 모델 Gemini 입니다)로 시작하는 답이었다. ①과 ④ 에는 「I am a large language model, trained by Google.」(저는 Google 이 학습시킨 대규모 언어 모델입니다)이라고만 했다.
39번이 댄 남의 이름은 모두 Claude 였다. 왜 하필 Claude 쪽으로만 끌렸는지는 저자들도 판정하지 않았다. 분명한 것은, 남의 이름이 아무 때나 튀어나오지 않고 질문이 먼저 그 이름을 꺼냈을 때 나왔다는 점이다.
추론 모델도 정확한 판 이름은 대지 못했다
추론 모델 넷(GPT-o4-mini·GPT-o3·gemini-2.5-flash·Claude Sonnet 4)의 답은 결이 달랐다. 320번 가운데 남의 이름을 댄 것은 4번, 답을 거부한 것은 2번뿐이었다. 논문은 나머지 314번에서 추론 모델들이 맞는 가족 이름(correct family name)을 댔다고 적었다.
가족 이름은 GPT·Gemini·Claude 같은 계열 이름을 말한다. 원 응답을 보면 그 314번은 제 가족 이름을 직접 댄 228번과 회사 이름만 댄 86번으로 나뉜다. 86번 중 80번이 gemini-2.5-flash 의 답이다. 이 모델은 80번 모두 「I am a large language model, trained by Google.」이라고만 했고, 네 질문 어디에서도 「Gemini」라는 말은 하지 않았다. 그림 3 이 그 구성이다.

정확한 판 이름(4o·2.0·2.5·o3·o4·Sonnet 4)을 댄 응답은 520건 전체에서 0건이다. 앱 안의 GPT-4o 도 판은 「GPT-4」나 「GPT-4-turbo」로 댔다. Claude Sonnet 4 는 ② 질문에 스무 번 모두 「I’m Claude 3.5 Sonnet.」(저는 Claude 3.5 Sonnet 입니다)이라고 답했다.
같은 시기 Claude 앱의 공식 시스템 프롬프트(Anthropic 문서, 2025년 5월 22일~8월 5일 항목)에는 판 이름이 적혀 있었다. 「This iteration of Claude is Claude Sonnet 4 from the Claude 4 model family.」(이번 Claude 는 Claude 4 모델 가족의 Claude Sonnet 4 다)라는 줄이다. 이 기록에서 모델이 스스로 맞힌 것은 가족 이름까지다. 판 이름은 대더라도 이전 판이었고, 정확한 판 이름은 한 번도 나오지 않았다.
베꼈다는 의심과 27개 모델 조사
남의 이름을 대는 챗봇을 보면 그 모델을 베껴 만든 것 아니냐는 의심이 들기 쉽다. 이 의심을 따진 연구가 있다. Li 외 연구진(산둥대 등, 2024)은 언어 모델 27개를 조사해 7개(25.93%)에서 정체성 혼동을 찾았다. 이어서 혼동한 모델과 그 모델이 이름을 댄 상대의 출력이 얼마나 닮았는지 비교했다. 저자들은 원인이 베낌보다는 환각, 곧 모델이 그럴듯하지만 사실이 아닌 말을 지어내는 성질 쪽에 있다고 판정했다.
Li 외의 「정체성 혼동」에는 같은 회사 안에서 판을 헷갈리는 경우도 들어간다. 논문이 든 예가 「respond with, “I am GPT-3,” when it is actually GPT-4」(실제로는 GPT-4 인데 「저는 GPT-3 입니다」라고 답하는 경우)다. 그래서 25.93% 를 남의 회사 이름을 댄 모델의 비율로 읽으면 안 된다. 조사 대상 27개에 GPT-4o 는 없고, Gemini 는 2023년 판만 들어 있어 이 글 앞쪽의 2025년 모델들과 바로 잇기도 어렵다.
앞의 Lehr 외 연구에도 이 판정과 맞아떨어지는 실험이 하나 있다. 시스템 프롬프트에 제 정체를 알려 주는 한 줄을 넣자, 연상 과제에서 제 이름 쪽 선호가 돌아왔다. 남의 이름을 댄 답 하나만으로는 그 모델을 베꼈다는 증거가 되지 않는다.
지금 Claude 앱 앞머리에 적힌 이름 줄
처음의 「Claude 몇 버전이야?」로 돌아가, 이번에는 Claude 앱을 본다. Anthropic 은 자사 앱의 시스템 프롬프트를 공식 문서로 공개한다. 문서는 Claude 웹 화면과 모바일 앱이 「at the start of every conversation」(모든 대화의 시작에) 시스템 프롬프트로 오늘 날짜 같은 최신 정보를 넣는다고 적는다. 바로 이어서 「These system prompt updates do not apply to the Claude API.」(이 시스템 프롬프트 갱신은 Claude API 에는 적용되지 않는다)라고 덧붙인다.
그 시스템 프롬프트에는 지금 판의 이름 줄이 있다. 2026년 9월 28일 항목인 Claude Sonnet 5.5 의 시스템 프롬프트에는 「This iteration of Claude is Claude Sonnet 5.5.」(이번 Claude 는 Claude Sonnet 5.5 다)라고 적혀 있다. 2025년 사본처럼 맨 앞에 오지는 않고, 제품 정보를 모은 대목을 여는 문장 바로 다음에 놓였다. 같은 시스템 프롬프트에는 이런 줄도 있다. 「The person can switch models mid-conversation, so earlier messages in this thread that identify as a different model or report a different knowledge cutoff may still be accurate.」(사용자는 대화 도중 모델을 바꿀 수 있으므로, 이 대화의 앞선 메시지가 다른 모델이라고 했거나 다른 지식 기준일을 말했더라도 여전히 맞을 수 있다.)
앱은 모델 이름을 대화마다 시스템 프롬프트에 적어 넣고, 대화 중 모델이 바뀌는 경우까지 일러 둔다. 이것은 회사 문서에 적힌 내용일 뿐, 이 줄이 이름 혼동을 얼마나 줄이는지 잰 결과는 아니다. 여기서 실용적인 구분 하나가 나온다(측정이 아니라 이 글의 짐작이다). 공식 앱의 챗봇이 대는 이름은 시스템 프롬프트를 읽고 하는 말일 수 있다. 반면 API 로 챗봇을 붙인 사내 도구나 다른 회사 앱에서는, 서비스가 앞머리에 이름을 적어 두지 않았다면 챗봇이 대는 이름을 그대로 믿기 어렵다. 그런 곳에서 어떤 모델이 도는지는 챗봇보다 서비스 안내에서 확인하는 편이 낫다.
2025년 7월, 앱의 GPT-4o 는 ChatGPT 라고 바로잡았고 앱 밖의 「겉보기엔 똑같은」 모델은 Claude 2.0 기반이라고 했다. 앞머리 없이 부른 모델도 대개는 제 가족 이름을 댔다. 이름이 모델 안에 아예 없는 것은 아니다. 흔들린 것은 질문이 남의 이름을 먼저 꺼냈을 때였고, 정확한 판 이름은 이 기록 어디에도 없었다. 챗봇이 대는 제 이름, 특히 판 이름은 대화 앞머리의 한 줄에 크게 기대고 있을 수 있다.
더 읽기
- Steven A. Lehr, Mary Cipperman, Mahzarin R. Banaji, 「Extreme Self-Preference in Language Models」, arXiv:2509.26464 (v2 2026, 프리프린트) — https://arxiv.org/abs/2509.26464 · 공개 데이터 https://osf.io/98ye3/
- Kun Li 외, 「I’m Spartacus, No, I’m Spartacus: Measuring and Understanding LLM Identity Confusion」, arXiv:2411.10683 (2024, 프리프린트) — https://arxiv.org/abs/2411.10683
- Anthropic, 「System prompts」 릴리스 노트 — https://platform.claude.com/docs/en/release-notes/system-prompts/overview · Claude Sonnet 5.5(2026-09-28 항목) https://platform.claude.com/docs/en/release-notes/system-prompts/claude-sonnet-5-5 · Claude Sonnet 4 https://platform.claude.com/docs/en/release-notes/system-prompts/claude-sonnet-4