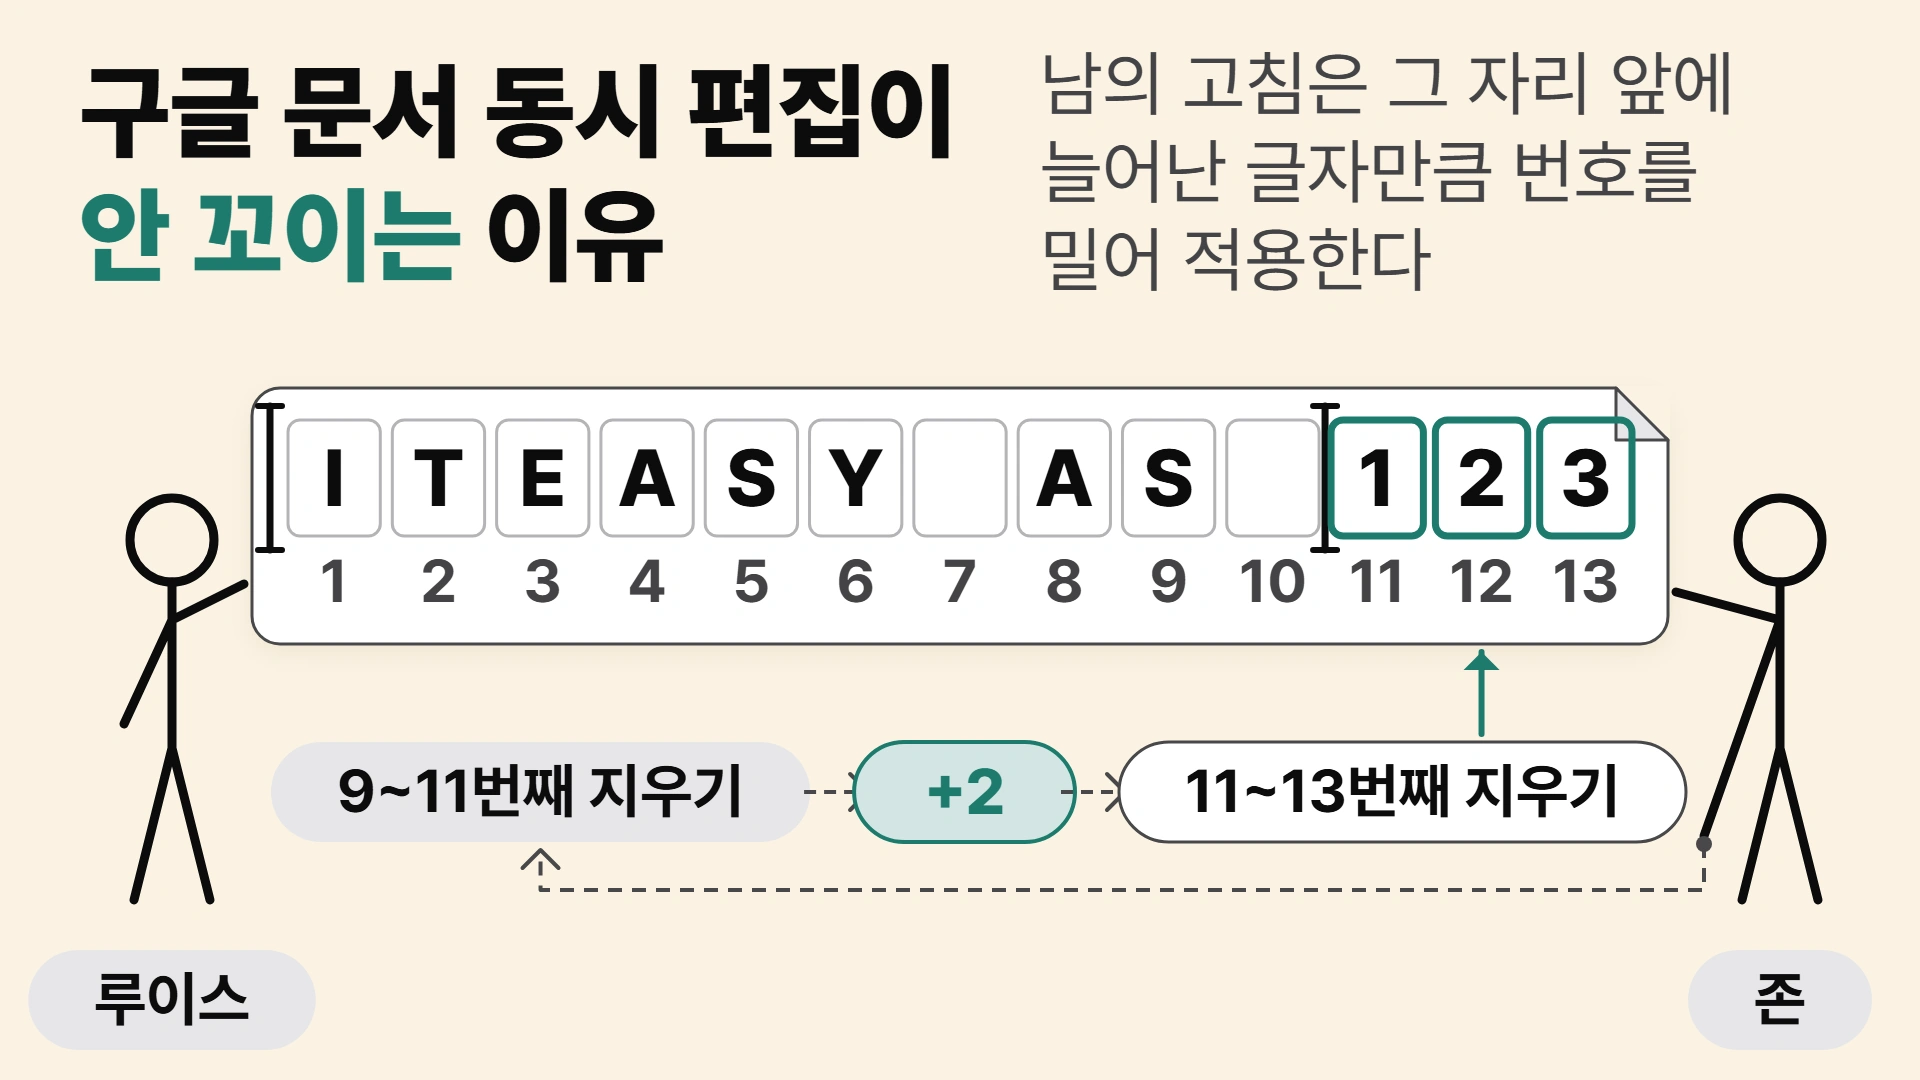
구글 문서에서 여럿이 한 문서를 함께 열어 두면, 남이 친 글자가 내 화면에 바로바로 들어온다. 2010년 구글이 밝힌 방식으로는 남의 고침이 도착하면, 그사이 내 화면에서 그 자리 앞에 늘어난 글자 수만큼 위치 번호를 뒤로 옮긴 뒤 적용한다. 번호를 옮기지 않으면 띄어쓰기까지 열한 칸짜리 한 줄에서도 엉뚱한 글자가 지워진다. 이렇게 남의 고침을 내 화면에 맞게 위치를 고쳐 적용하는 방법을 연산 변환(operational transformation, OT)이라고 한다.
「EASY AS 123」 한 줄을 구글 문서(Google Docs)에서 두 사람이 거의 같은 때 고친다. 한 사람이 보낸 고침이 인터넷을 건너오는 동안, 받는 쪽의 줄은 그쪽 사람이 그사이 친 글자로 이미 바뀌어 있다. 도착한 고침은 그렇게 바뀐 줄 위에 떨어지지만, 잠시 뒤 두 화면에는 같은 글이 떠 있다.
구글 문서는 여럿이 동시에 고쳐도 왜 글이 안 꼬일까? 남의 고침을 그대로 따라 하지 않고, 자리를 밀어서 적용하기 때문이다. 아래 설명은 2010년 구글이 직접 밝힌 방식을 따른다. 다만 「안 꼬인다」의 정확한 뜻은 생각보다 좁다.
구글 문서에서 여럿이 동시에 편집할 때
구글은 2010년 9월, 새 문서 편집기가 여럿의 고침을 어떻게 다루는지 회사 블로그 글 세 편으로 풀어 썼다. 첫 글은 먼저 동시 편집이 왜 어려운지를 짚었다. 연결 속도는 순간이 아니어서, 내가 글자를 고치는 순간 내 화면은 잠시 남들이 보는 판과 다른 판이 된다. 구글이 꼽은 핵심 과제는 이렇게 갈라진 화면들을 결국 같은, 올바른 판으로 모으는 일이었다.
첫 글에 따르면 새 편집기는 문서를 시간 순서대로 쌓인 고침의 목록으로 저장한다. 원문이 든 고침 한 건은 「{InsertText ‘T’ @10}」이다. 원문의 풀이로는 문서의 10번째 자리에 T를 넣으라는 고침이다. 할 일(T 넣기)과 자리(10번째)가 이 한 건에 함께 적혀 있다. 화면에 보이는 지금 판은 이 목록을 처음부터 차례로 다시 재생해서 만든다.
그전의 구글 문서는 사람마다 고친 판을 서로 견줘 합쳤다. 원문의 예에서는 「The quick brown fox」를 두고 한 사람은 「brown fox」를 굵게 하고, 다른 사람은 「fox」를 「dog」로 바꿨다. 판만 견주면 「The quick brown fox dog」도 「The quick brown dog fox」도 그럴듯한 합본이다. 원문은 판을 견주는 것만으로는 고친 사람이 기대한 대로 합쳐진다고 장담할 수 없다고 적었다. 문단마다 한 사람만 쓰게 잠그는 방법도 원문은 좋은 해법이 아니라고 봤다. 새 편집기는 판을 견주는 대신 고침을 한 건씩 주고받는다.
둘째 글은 고침을 글자 넣기, 글자 지우기, 글자 범위에 서식 입히기 세 가지로 나눴고, 이 글은 앞의 두 가지만 다룬다. 셋째 글에 따르면 모든 고침은 서버 한 곳을 거쳐 한 줄로 기록된다. 서버는 아직 처리하지 않은 고침, 지금까지의 고침 기록 전체, 지금 문서를 기억한다. 각 화면은 아직 보내지 않은 고침, 보냈지만 확인받지 못한 고침, 마지막으로 받은 판 번호, 지금 문서를 기억하고, 확인받지 못한 고침은 한 번에 하나만 보낸다. 그래서 화면과 서버 사이를 오가는 것은 완성된 글이 아니라, 「몇 번째 자리에 무엇을」이 적힌 고침 한 건이다. 문제는 그 번호가 언제, 누구의 화면에서 센 번호인가에서 시작한다.
남의 고침을 번호 그대로 따라 할 때
구글 둘째 글의 예는 「EASY AS 123」 한 줄에서 출발한다. 존(John)은 끝의 「123」을 「ABC」로 바꾸려고 먼저 9~11번째 글자를 지웠다. 같은 때 루이스(Luiz)는 줄 맨 앞에 I와 T를 넣어 「ITEASY AS 123」을 만들었다. 두 사람 모두 상대의 고침을 아직 받지 못한 상태다.
이제 존의 고침 「9~11번째 지우기」가 루이스의 화면에 도착한다. 루이스 화면에서 번호 그대로 9~11번째를 지우면 「S」, 띄어쓰기, 「1」이 지워져 「ITEASY A23」이 남는다. 원문은 이 장면에 「He deleted the wrong characters! Luiz had two characters at the beginning of the doc that John was never aware of.」라고 적었다. 존은 모르는 두 글자가 문서 앞에 있었으니, 엉뚱한 글자를 지웠다는 말이다. 그림 1는 이 장면에서 출발하고, 위치 밀기를 켜면 다음 문단의 결과로 바뀐다.

고치는 법은 단순하다. 루이스가 그 자리 앞에 두 글자를 넣었으니, 존의 번호를 두 칸 밀어 「11~13번째 지우기」로 바꿔 적용한다. 그러면 「123」이 지워지고 「ITEASY AS 」가 남는다. 거꾸로 그 자리 앞에서 글자가 지워졌다면, 지워진 글자 수만큼 번호를 앞으로 당긴다. 이렇게 남의 고침을 내 화면에 맞게 위치를 고쳐 적용하는 방법이 연산 변환(operational transformation, OT)이다. 구글은 이 방법을 이렇게 소개했다.
The algorithm that we use to handle these shifts is called operational transformation (OT). If OT is implemented correctly, it guarantees that once all editors have received all changes, everyone will be looking at the same version of the document.
이렇게 위치를 미는 일을 맡는 알고리즘을 연산 변환(OT)이라고 부른다. OT가 올바르게 구현되어 있으면, 모든 편집자가 모든 고침을 받은 뒤에는 모두가 같은 판의 문서를 보게 된다.
John Day-Richter, 「What’s different about the new Google Docs: Conflict resolution」, Google Drive Blog(2010-09-22)이 보장에는 조건이 붙어 있다. 「올바르게 구현되어 있으면」이라는 조건이고, 보장하는 것은 「같은 판」이다. 원문은 존이 남은 「A」「B」「C」를 넣는 단계까지는 보여 주지 않는다. 원문에 없는 우리 계산으로 남은 고침까지 다 주고받으면, 번호를 밀지 않았을 때 존의 화면은 「ITEASY AS ABC」, 루이스의 화면은 「ITEASY AABC23」으로 끝난다. 밀었을 때는 두 화면 모두 「ITEASY AS ABC」다. 이 예에서 두 화면을 같은 글로 데려가는 것은, 고침이 도착하기 전 그 자리 앞에 늘어난 글자 수 하나다.
종이 한 장으로 따라 해 볼 때
앞의 예는 종이와 연필로 그대로 따라 할 수 있다. 눈여겨볼 곳은 번호를 언제 다시 세느냐다. 2단계에서 번호를 새로 다는 일을 빠뜨리면, 3단계에서 보여 주려던 장면이 나오지 않는다.
- 종이에 「EASY AS 123」을 한 칸에 한 글자씩 적는다. 띄어쓰기도 한 칸이라 모두 열한 칸이다. 칸 아래에 1부터 11까지 번호를 단다.
- 루이스의 고침대로 맨 앞에 I와 T를 넣어 「ITEASY AS 123」(13칸)을 만든다. 1단계의 번호는 지우고, 앞에서부터 1~13으로 다시 단다. 루이스의 화면은 지금 글자의 순서만 알기 때문이다.
- 존이 보낸 「9~11번째 지우기」를 새 번호 그대로 한다. 「S」, 띄어쓰기, 「1」이 지워져 「ITEASY A23」이 남는다.
- 2단계까지 다시 해 둔 줄에서, 이번에는 번호를 두 칸 밀어 「11~13번째 지우기」를 한다. 존이 모르는 사이 앞에 두 칸이 늘었기 때문이다. 「ITEASY AS 」가 남고, 끝에 빈칸이 하나 있다.
- 존이 자기 화면에서 「123」을 지워 만든 「EASY AS 」와 견준다. 3단계와 4단계 가운데 존이 지우려던 글자를 지운 쪽이 어느 쪽인지 본다.
3단계의 답이 틀린 까닭은 번호를 센 화면이 달라서다. 존은 11칸짜리 자기 줄에서 센 번호를 보냈고, 루이스는 13칸짜리 줄에서 그 번호를 그대로 썼다. 손으로 따라 한 이 예는 한 가지 경우뿐이다.
여러 번 돌리면 어떨까. 두 사람이 「EASY AS 123」에서 함께 출발해, 서로를 모른 채 한 글자를 넣거나 지우는 고침을 하나씩 동시에 하는 장난감 계산을 이 글에서 1만 번 돌렸다. 서버는 두 사람의 고침을 매번 무작위 순서로 받는다. 고침을 서로 다 주고받은 뒤 두 화면의 글자가 하나도 다르지 않으면 「같은 글로 끝났다」고 셌다.
번호를 밀지 않았을 때 같은 글로 끝난 것은 1만 번 중 646번(6.5%)이었고, 밀었을 때는 1만 번 전부였다. 사람을 셋으로 늘리면 밀지 않은 쪽에서 같은 글로 끝난 비율은 1.0%로 줄었다. 민 쪽은 그대로 전부였다.
두 화면이 얼마나 다르게 끝났는지도 셌다. 한쪽 화면을 다른 쪽과 같게 만들려면 가장 적게 잡아 몇 글자를 고쳐야 하는지다. 두 사람이 저마다 동시에 하는 한 글자 고침을 1·2·3·5·10개로 늘리자, 밀지 않은 쪽에서 이 글자 수가 평균 1.40에서 7.38로 커졌다. 밀지 않은 쪽이 같은 글로 끝나려면 번호가 우연히 맞아떨어져야 했고, 민 쪽에는 그런 우연이 필요 없었다.
두 사람이 같은 자리에 동시에 넣을 때
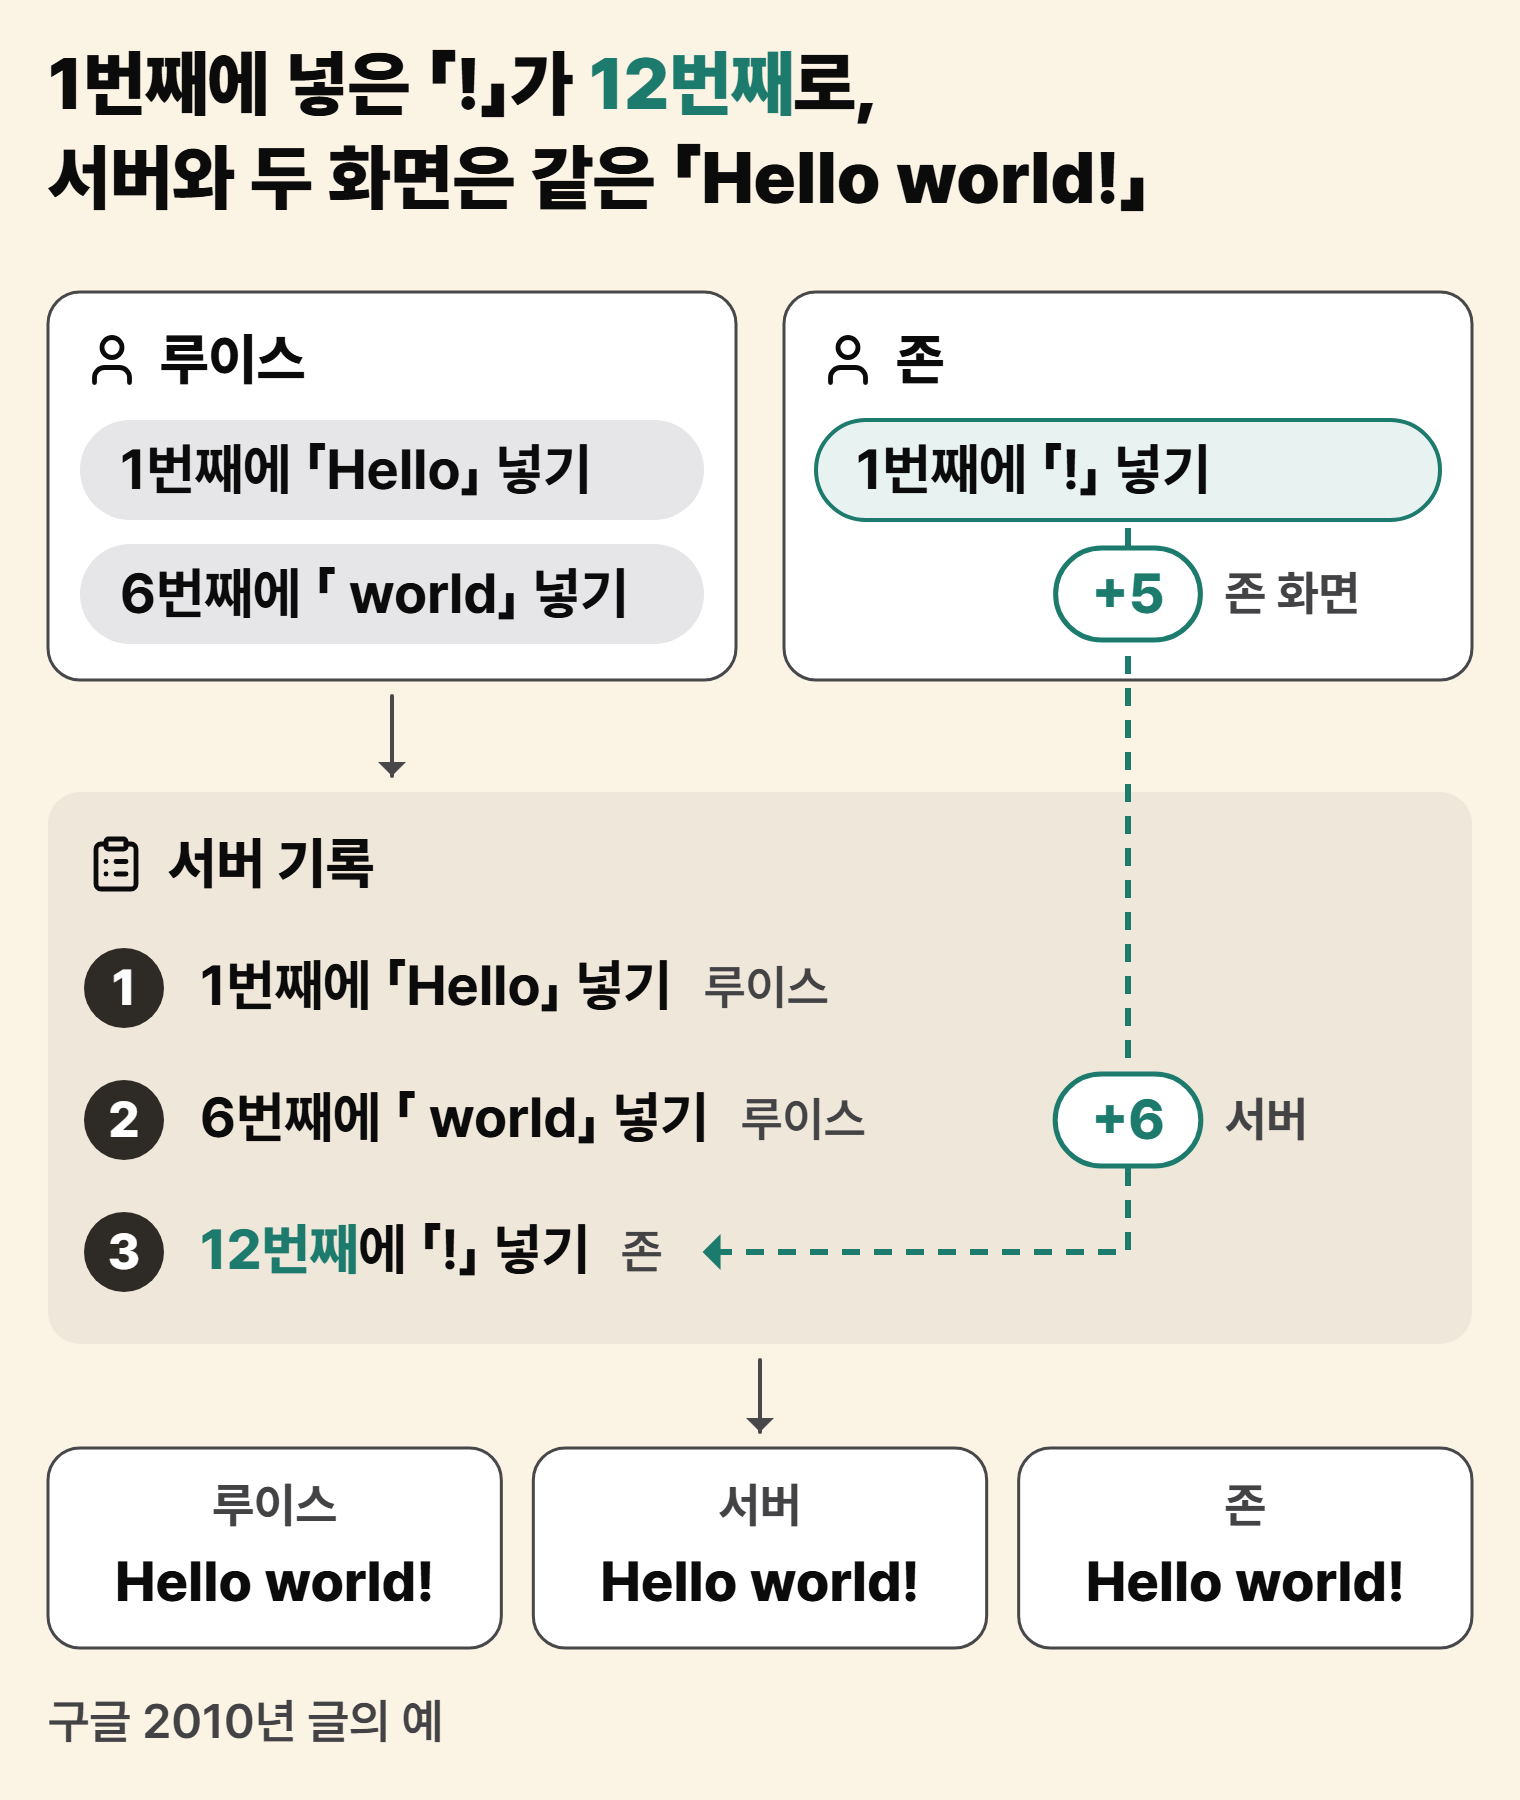
구글 셋째 글의 예는 빈 문서에서 시작한다. 루이스가 맨 앞에 「Hello」를 넣었고, 그 고침을 받기 전 존도 같은 맨 앞에 「!」를 넣었다. 둘 다 「1번째 자리」를 가리키니, 번호만으로는 누구 글자가 앞인지 정할 수 없다.
서버에는 루이스의 고침이 먼저 닿았고, 루이스는 이어서 「 world」도 넣었다. 존의 「!」는 「Hello」 다섯 글자만큼 밀린 뒤, 띄어쓰기를 포함한 「 world」 여섯 칸만큼 한 번 더 밀려 12번째 자리에 붙었다. 서버와 두 화면은 모두 「Hello world!」로 같아졌다. 그림 2가 서버에 기록된 순서를 보여 준다.
구글 원문은 같은 자리 순서의 규칙을 말하지 않았다. 그 규칙을 적어 둔 것은 1995년 제록스 연구소(Xerox PARC)의 협업 시스템 Jupiter를 소개한 논문이다. 원저자들은 「We arbitrarily chose to put server text first if both try to insert at the same spot.」라고 적었다. 같은 자리면 서버 쪽 글자가 앞이다. 원저자들은 이 순서를 「임의로(arbitrarily)」 정했다.
이 규칙을 뒤집어 존 쪽 글자를 앞에 두는 경우는 원문에 없다. 직접 계산해 보면 모두의 화면이 「!Hello world」가 되어, 다른 글이지만 모두 같아진다. 반대로 두 화면이 저마다 자기 글자를 앞에 두면 결과가 갈린다. 네 글자짜리 글 「abcd」에 한 글자 고침 두 개를 짝지은 경우를 이 글에서 전부 따져 보면, 둘이 같은 자리에 넣은 경우는 모두 갈렸고 나머지는 하나도 갈리지 않았다. 같은 칸에서 누구 글자를 앞에 둘지에는 정해진 답이 없다. 화면들이 갈리느냐는 모두가 같은 답을 고르느냐에서 정해진다.
서버 없이 서로 직접 주고받을 때
위치를 밀어 맞추는 방식의 시작은 1989년 Ellis·Gibbs의 논문이다. 이 논문의 방식은 서버 없이 화면끼리 고침을 직접 주고받았다. 원저자들은 결과가 갈리는 경우를 스스로 찾아 「The final string at this site is zxy which is inconsistent with the xyz at node 3.」이라고 적었다. 한 곳은 「zxy」, 다른 곳은 「xyz」로 끝나 두 결과가 맞지 않았다는 것이다.
2017년 Gomes 연구팀은 그 뒤의 일을 정리했다. 그 정리에 따르면 Ellis·Gibbs의 방식을 포함한 다섯 방식의 논문이 같은 주장을 했다. 저마다 내놓은 위치 고치기 규칙이 서버 없이 같은 글로 모이는 데 필요한 조건을 갖췄다는 주장이다. 이 주장들은 뒤에 반례가 나와 무너졌다. 그중 두 방식에는 기계로 검사한 증명까지 있었지만, 그 증명도 잘못된 가정 위에 서 있었다. 2013년에는 Randolph 연구팀이, 위치와 글자만 적힌 넣기·지우기로는 서버 없이 필요한 조건을 모두 갖춘 위치 고치기 규칙을 만들 수 없다고 보였다.
서버 한 곳이 순서를 정하면 사정이 달라진다. 2017년 정리는 이런 방식이 서버 없는 방식에 필요한 조건 가운데 일부만 갖추면 된다고 적었다. 이 설계를 연 것이 앞에서 본 1995년 제록스 연구소의 논문이다. 그 원저자들은 중앙 서버 구조 덕에 Ellis·Gibbs의 방식을 크게 단순화할 수 있었다고 적었다. 뒤의 여러 논문은 2010년 구글 방식도 이 설계로 분류하지만, 구글 원문에는 1995년 논문의 이름이 나오지 않는다. 서버 한 곳이 줄을 세우면, 각 화면이 맞춰 볼 상대는 서버의 줄 하나로 준다.
같은 글로 모였는데 읽을 수 없을 때
「milk」 한 줄만 적힌 장보기 목록이 있다. 한 사람은 줄을 바꿔 「eggs」를, 다른 사람은 줄을 바꿔 「bread」를, 연결이 약한 상태에서 동시에 넣는다. 2023~25년 연구는 기존의 정식 기준에 비추어 올바른 편집기도 이 두 고침을 「“milk”, a blank line, and then the interleaved word “ebgrgesad”」로 합칠 수 있다고 적었다. 「milk」 아래 빈 줄, 그 아래에 두 낱말의 글자가 섞인 「ebgrgesad」다. 원문은 이런 섞임을, 서로 따로(오프라인에서처럼) 쓴 글을 나중에 합칠 때의 문제로 소개했다. 모두의 화면이 이 글로 같아져도, 누구도 쓰려던 글은 아니다.
같은 연구는 조사한 방식 거의 전부가 경우에 따라 이렇게 글자를 섞는다고 썼고, 모든 경우에 섞임을 피할 수는 없다고도 적었다. 1995년 논문의 「서버 글자 먼저」 규칙도 예외가 아니다. 빈 문서에 한 사람이 「a」와 「b」를 차례로 넣는 사이 다른 사람이 맨 앞에 「x」를 넣으면, 이 규칙에서는 「x」가 「a」와 「b」 사이에 끼어 「axb」가 되고, 한 사람이 쓰려던 「ab」 사이에 남의 글자가 낀다. 다만 이 분류는 논문에 적힌 규칙을 따진 것이고, 제품인 구글 문서에서 이런 섞임을 관찰하거나 잰 문헌은 찾지 못했다. 「안 꼬인다」의 보장은 모두의 화면이 같아진다는 데서 멈춘다.
글자마다 이름표를 붙일 때
종이 실험 2단계에서 1단계의 번호를 지우지 않고 글자에 붙여 둔 채 존의 고침을 찾았다면, 「9~11번」은 처음부터 「1」「2」「3」을 가리켰을 것이다. 번호를 자리가 아니라 글자 자체에 붙여 두면, 앞에 글자가 늘어도 밀 일이 없다. 이 생각을 끝까지 따라간 방식이 CRDT(Conflict-free Replicated Data Type, 충돌 없는 복제 자료형)다. 글자마다 고유 이름표를 붙여, 번호를 밀 필요를 없앤 방식이다.
CRDT가 보장하는 것도 같은 상태다. 2018년 Preguiça 연구팀이 쓴 백과사전 항목의 정의로는, 같은 고침을 모두 받은 두 사본은 정해진 규칙에 따라 어김없이 같은 상태에 이른다. 그 상태가 사람이 원한 글이라는 말은 정의에 없다.
이름표 방식에는 대가도 따른다. 2024년 한 논문은 지금 가장 나은 CRDT도 문서를 보고 고치는 데 OT보다 메모리를 10배 넘게 쓴다고 적었다. 같은 논문은 그래서 구글 문서, 마이크로소프트 오피스, 온라인 논문 편집기 Overleaf 같은 앱이 OT를 쓴다고 적었다. 다만 구글 문서의 근거로 든 것은 2010년 구글 블로그다. 메모리로 따지면, 이 논문이 잰 기존 CRDT들은 번호 밀기를 없앤 대신 OT보다 많이 썼다.
오프라인으로 고친 뒤 다시 연결할 때
인터넷이 끊긴 채 노트북에서 문서를 한참 고치고, 나중에 다시 연결했다고 하자. 그동안 다른 사람도 같은 문서를 고쳤다면, 서로 맞춰야 할 고침이 한꺼번에 쌓여 있다. 앞의 2024년 논문은 오프라인 편집이나, 문서를 두 갈래로 나눠 따로 고친 뒤 하나로 합치는 작업에서 이런 갈라짐이 커진다고 적었다.
극단적인 예도 같은 논문에 있다. 프로그램 코드의 고친 이력을 담는 Git 저장소에서, 그 이력으로 재구성한 편집 기록을 합치는 데 OT는 1시간이 걸렸다. 저자들은 그 까닭을 OT 알고리즘의 계산량이 제곱으로 불어나는 성질에서 찾았다. 같은 기록에서 이 논문이 내놓은 새 방식은 OT보다 160,000배 빨랐고, 이 배수는 저자들이 직접 잰 것이다. 1시간은 이렇게 오래 갈라졌던 기록에서 나온 값이다. 저자들은 실제 문서 대부분이 그렇게 갈라지지 않고 차례로 고쳐진다고 보면서도, 그 근거는 「Anecdotal evidence」, 곧 일화 수준이라고 적었다.
갈래를 나눴다 합치는 일은 이 블로그의 3-way merge, 충돌 없어도 코드는 깨진다에서 코드 쪽으로 다뤘다. 그 글에서는 「충돌 없음」이 떠도 합친 코드가 깨질 수 있었다. 이 글의 문서는 같은 글로 모이고도 쓴 사람이 원한 글이 아닐 수 있었다. 두 글 모두 「충돌 없이 합쳐졌다」가 「쓴 사람의 뜻대로 합쳐졌다」와 같은 말이 아님을 보여 준다.
노트북이 다시 연결되는 순간으로 가 보자. 끊긴 동안 쌓인 고침에 적힌 위치 번호는 남의 고침이 빠진 화면에서 센 번호다. OT로 맞추는 편집기는 그 번호를, 그사이 남이 넣고 지운 글자만큼 고침마다 밀거나 당겨서 적용한다. 앞의 예에서는 두 칸을 한 번 밀면 됐다. 오래 끊겼던 노트북은 그 일을 쌓인 고침 수만큼 되풀이한다. 위치 번호로 고침을 주고받을 때 그 자리 앞에 들어온 글자만큼 번호를 밀지 않으면, 두 화면이 같은 글로 모인다는 보장은 서지 않는다.
이 글의 장난감 계산은 한 글자 넣기·지우기만 다루고, 서버 한 곳을 두었다. 같은 자리 순서 규칙은 1995년 논문의 「서버 글자 먼저」를 썼고, 구글이 밝힌 규칙은 아니다. 번호를 밀지 않을 때 번호가 글 밖으로 나가면 넣기는 끝에 붙이고 지우기는 건너뛰거나 끝까지만 지웠는데, 이 처리는 이 글이 정한 규칙이다. 서식, 지우는 범위 한가운데에 남이 글자를 넣는 경우, 다시 연결하는 상황은 재지 않았다. 또 2010년 구글이 밝힌 방식이 지금도 그대로인지는 확인하지 못했다. 2026년 10월 9일 갱신된 구글 Docs API 문서는 서버가 충돌하는 고침을 맞춘다고만 적고, OT라는 낱말은 쓰지 않는다.
더 읽기
- John Day-Richter, 「What’s different about the new Google Docs: Working together, even apart」, Google Drive Blog(2010-09-21) — https://drive.googleblog.com/2010/09/whats-different-about-new-google-docs_21.html
- John Day-Richter, 「What’s different about the new Google Docs: Conflict resolution」, Google Drive Blog(2010-09-22) — https://drive.googleblog.com/2010/09/whats-different-about-new-google-docs_22.html
- John Day-Richter, 「What’s different about the new Google Docs: Making collaboration fast」, Google Drive Blog(2010-09-23) — https://drive.googleblog.com/2010/09/whats-different-about-new-google-docs.html
- C.A. Ellis, S.J. Gibbs, 「Concurrency Control in Groupware Systems」, ACM SIGMOD 1989 — doi:10.1145/67544.66963
- David A. Nichols, Pavel Curtis, Michael Dixon, John Lamping, 「High-Latency, Low-Bandwidth Windowing in the Jupiter Collaboration System」, UIST ’95 — https://uist.acm.org/uist1995/abstracts/Nichols.html
- Victor B. F. Gomes, Martin Kleppmann, Dominic P. Mulligan, Alastair R. Beresford, 「Verifying Strong Eventual Consistency in Distributed Systems」, OOPSLA 2017 — https://arxiv.org/abs/1707.01747
- Aurel Randolph, Hanifa Boucheneb, Abdessamad Imine, Alejandro Quintero, 「On Consistency of Operational Transformation Approach」, EPTCS 107, 2013 — https://arxiv.org/abs/1302.3292
- Matthew Weidner, Martin Kleppmann, 「The Art of the Fugue: Minimizing Interleaving in Collaborative Text Editing」, IEEE TPDS 36(11), 2025 — https://arxiv.org/abs/2305.00583
- Joseph Gentle, Martin Kleppmann, 「Collaborative Text Editing with Eg-walker: Better, Faster, Smaller」, EuroSys 2025 — https://arxiv.org/abs/2409.14252
- Nuno Preguiça, Carlos Baquero, Marc Shapiro, 「Conflict-free Replicated Data Types」, 2018 — https://arxiv.org/pdf/1805.06358