LLM 에게 「숫자만 답해」라고 시켜도 앞뒤에 군더더기 문장이 붙어, 답을 받는 프로그램이 그것을 읽지 못하는 일이 흔하다. 그런데 TypeSafe 의 Jev 는 애초에 문장을 못 쓰게 설계돼, 정해 둔 선택값·점수·확률만 돌려준다. 다만 답의 모양이 항상 맞다는 것이지 답 자체가 항상 맞다는 뜻은 아니다. 여기 적은 문서 내용은 jev-1.13.0 기준이고, 수치는 2026-09-22 에 평가 사이트에서 받은 값이다. 이런 도구를 System One 모델이라고 한다.
JSON 으로만 답해도 문장이 섞여 나온다
터미널에 JSONDecodeError 한 줄이 뜬다. LLM(대규모 언어 모델)에게 「JSON 으로만 답해」라고 시켰는데, 응답 맨 앞에 「알겠습니다, 다음은 요청하신 결과입니다」 한 줄이 먼저 붙은 것이다. 코드에는 재시도 로직이 하나 붙는다. 그다음엔 앞뒤 군더더기를 떼어 내는 정규식이 붙고, 돌아온 값이 정말 내가 기대한 모양인지 보는 검증이 또 붙는다.
TypeSafe 의 공식 문서도 같은 대목을 짚는다. Jev 를 꺼내 볼 만한 경우를 꼽으면서, LLM 에게 JSON 을 돌려 달라고 부탁하는 깨지기 쉬운 프롬프트를 든다. 그런 프롬프트는 돌아올 값의 타입이 애초에 정해져 있는 호출로 바꾸라는 것이다. 이 도구가 겨눈 것은 모델의 지능이 아니라, 그 지능이 밖으로 나오는 형식이다.
Jev 가 실제로 돌려주는 것
재현 못 함 — Jev 는 얼리액세스 API 키가 있어야 호출된다. 이 글에는 우리가 직접 돌려 본 결과가 없다. 아래의 수치와 문장은 전부 공식 문서·출시 발표 글(launch post)·평가 사이트와 공개 레포에서 왔다. 아래 응답 JSON 은 공식 Quick start 의 예시를 그대로 옮긴 것이고, 요청 쪽은 산문으로 풀어 적었다.
Jev 에 보내는 것은 두 덩어리다. 하나는 state, 판단의 재료가 되는 글이나 JSON 이다. 다른 하나는 질문 묶음인데, 질문마다 답이 어떤 모양이어야 하는지가 미리 박혀 있다.
답의 모양은 세 가지뿐이다. 문서는 이 셋을 프리미티브(primitive), 그러니까 더 쪼개지지 않는 기본 단위라고 부른다. Choice 는 미리 적어 둔 보기 중 하나를 고른다. Score 는 내가 정의해 둔 단계 위에 값을 매긴다. Noul 은 어떤 문장이 참인지를 0 과 1 사이의 수로 돌려준다.
공식 Quick start 의 예시는 고객 지원 티켓 하나를 state 로 넣는다. Stripe 연동이 사흘째 실패해서 매출이 빠지고 있다는 문의다. 질문은 셋이다 — 어느 팀이 맡아야 하는지(Choice, 보기 셋), 고객이 얼마나 화가 났는지(Score, 3단), 급한 건인지(Noul). 문서에 실린 응답은 이렇다.
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "confidence": 0.78,
      "probabilities": {
        "technical": 0.85,
        "sales": 0.0,
        "billing": 0.15
      }
    },
    "frustration": {
      "type": "score",
      "score": 1.0,
      "confidence": 1.0,
      "legend": {
        "0": "Calm, just stating facts",
        "1": "Frustrated but civil",
        "2": "Very angry, strong language"
      },
      "probabilities": {
        "0": 0.0,
        "1": 1.0,
        "2": 0.0
      }
    },
    "is_urgent": {
      "type": "noul",
      "noul": 1.0
    }
  },
  "usage": {
    "input_tokens": 392,
    "output_tokens": 65
  }
}
질문마다 값 하나와 확률 분포가 함께 왔다. 담당 팀은 technical 로 갈렸고, 확률은 technical 0.85, billing 0.15, sales 0.0 이다. 그 분포가 얼마나 한쪽으로 몰렸는지를 수 하나로 접은 것이 confidence 0.78 이다. 어느 칸에도 문장은 없다.
이름은 두 사람에게서 왔다. 모델 부류 이름인 System One 은 대니얼 카너먼이 『생각에 관한 생각』에서 나눈 두 체계에서 왔다. 빠르고 직관적인 쪽이 시스템 1, 느리고 신중한 쪽이 시스템 2 다. 모델 이름 Jev 는 윌리엄 스탠리 제번스(William Stanley Jevons)에서 왔다. 발표 글은 증기기관의 효율이 좋아지자 석탄 수요가 오히려 늘었던 길을 기계 지능도 따라갈 것으로 본다고 적는다.
여기까지가 답이다. Jev 는 글을 안 쓰는 대신 확률을 돌려주고, 그래서 틀린 모양의 답은 낼 수 없다. 틀린 답은 낼 수 있다.
질문을 한 호출에 몰아 묻는다
LLM 은 글자 조각인 토큰을 하나씩, 앞의 토큰에 기대어 뱉는다. Jev 는 그렇게 하지 않는다. 발표 글의 비교표는 샘플링 칸에 병렬이라 적고, 한 질의에서 모든 출력을 만든다고 쓴다. 그림 1 이 그 모양이다.
그래서 질문을 나눠 보낼 이유가 없어진다. 문서는 시스템에 필요한 질문을 전부 한 요청에 싣고, 무엇이 쓸모 있었는지는 나중에 코드가 고르라고 권한다. 질문이 모두 나란히 평가되니 질문을 더 얹어도 응답 시간에는 대개 영향이 거의 없다는 것이 근거다. 이 패턴에 붙은 이름이 투기적 팬아웃(speculative fan-out)이다. 쓸지 안 쓸지 모르는 질문까지 미리 실어 보낸다는 뜻이다.
토큰을 하나씩 뽑지 않는 설계는 가격과 응답 시간에 그대로 나타난다. 발표 글의 비교표는 두 열을 이렇게 적는다.
| 항목 | 기존 LLM | Jev |
|---|---|---|
| 샘플링 | 순차 — 토큰을 하나씩 | 병렬 — 한 질의에서 전부 |
| 입력 100만 토큰 | 0.20 ~ 10달러 | 0.042달러 |
| 출력 토큰 | 입력의 약 5배 | 무료 |
| 끝에서 끝까지 응답 시간 | 3 ~ 329초 | 70 ~ 500밀리초 |
대신 한도가 있다. 문서 Models 페이지는 2026-09-22 기준 jev-1.13.0 이 한 요청에 64k 토큰까지 받고, 그중 state 와 가장 긴 질문 하나를 합쳐 32k 까지라고 적는다. 입력도 텍스트만 받는다. Choice 의 보기는 최대 255개, Score 의 단계는 2개에서 10개라고 API 레퍼런스가 적는다. 그래도 질문을 하나 더 얹는 값이 거의 공짜라면 설계가 한 칸 바뀐다. 망설이던 질문을 일단 다 묻고, 무엇을 쓸지는 코드가 뒤에서 정하면 된다.
"환각을 못 한다"는 정확히 무슨 뜻인가
가격과 응답 시간은 설계에서 나온 결과다. 정작 TypeSafe 가 이 모델을 소개하며 앞세우는 문장은 따로 있다. 발표 글은 Jev 가 문자열 생성을 포기하는 대신 구조화 출력에 맞춰졌고, 없는 사실을 지어내 답하는 환각(hallucination)을 할 수 없다고 적는다. 꽤 센 주장으로 읽힌다. 그런데 같은 글과 공식 문서가 그 주장의 범위를 스스로 좁힌다.
"Our number is not empirical. Schema matching is guaranteed, thus we can confidently add 0% into the plots."
우리가 적은 수는 실측이 아니다. 스키마가 맞는 것은 보장되니 그림에 0% 를 자신 있게 넣을 수 있다.
TypeSafe 발표 글환각을 비교한 그림의 0% 는 실측이 아니라고 발표 글이 스스로 밝힌 것이다. 스키마(schema), 그러니까 답이 들어갈 칸의 모양이 맞는 것은 보장되니 그 칸에 0 을 적어 넣었다는 뜻이다. 공식 문서는 확률 쪽에 같은 선을 긋는다.
"Calibration is measured across groups of predictions; it does not guarantee that an individual answer is correct."
보정은 여러 예측을 묶어서 재는 것이지, 답 하나가 맞다는 보장이 아니다.
— 공식 문서 「System One」
타입 오류가 없다는 쪽은 성격이 다르다. 발표 글은 반례 하나만 있으면 바로 뒤집힐 주장인데 그 반례를 내놓는 일이 수학적으로 불가능하다고 적는다. 답이 될 수 있는 값을 미리 다 적어 두고 그 밖으로는 못 나가게 만들었으니, 없는 부서 이름이 튀어나오는 일은 일어나지 않는다. 여기서 갈린다. 틀린 글을 못 쓰는 것과 틀린 답을 안 고르는 것은 다른 문제다.
보정과 확신도 — 0.8 은 80%를 뜻한다
Jev 가 돌려주는 확률은 얼마나 믿을 수 있는 수인가. 발표 글은 자기네 훈련법을 보정된 결정을 위한 강화학습(RLCD)이라 부른다. 사람이 더 좋아하는 답을 내도록 훈련하는 대신 확률이 실제 결과와 맞아떨어지게 훈련했다는 주장이다.
여기서 말하는 보정(calibration)은 이런 뜻이다. 모델이 0.8 을 매긴 일들을 모아 보면 그중 약 80% 가 실제로 그랬어야 한다. 문서는 0.2 를 준 결과도 약 20% 에서 일어나야 한다고 적는다. 그리고 덧붙인다 — 이 비율은 예측 묶음을 두고 하는 말이지 답 하나의 보장이 아니다.
확률 분포를 통째로 받아 매번 따지기는 번거롭다. 그래서 답마다 확신도(confidence)가 하나씩 붙는다. 확률이 한 보기에 몰려 있으면 1 에 가깝고, 고르게 퍼져 있으면 0 에 가까운 수다. 문서는 이것을 분포의 모양을 수 하나로 접은 값이라 하고, Noul 답에는 붙지 않는다고 적는다.
접는 식은 문서 Confidence 페이지의 계산기가 쓰는 그대로다. 보기가 n 개일 때 그중 가장 큰 확률에 n 을 곱하고 1 을 뺀다. 그 값을 n 에서 1 을 뺀 수로 나눈 다음 0 과 1 사이로 자른다.
식 1 가 그 식이다. 앞의 응답으로 검산하면, 보기가 셋이고 technical 이 0.85 였으니 $(3 \times 0.85 – 1) / 2 = 0.775$ 다. 문서가 적은 confidence 는 0.78 이다. 확률이 소수 둘째 자리까지라 이 검산은 ±0.01 안에서만 맞고, 두 값이 같다는 주장은 아니다.
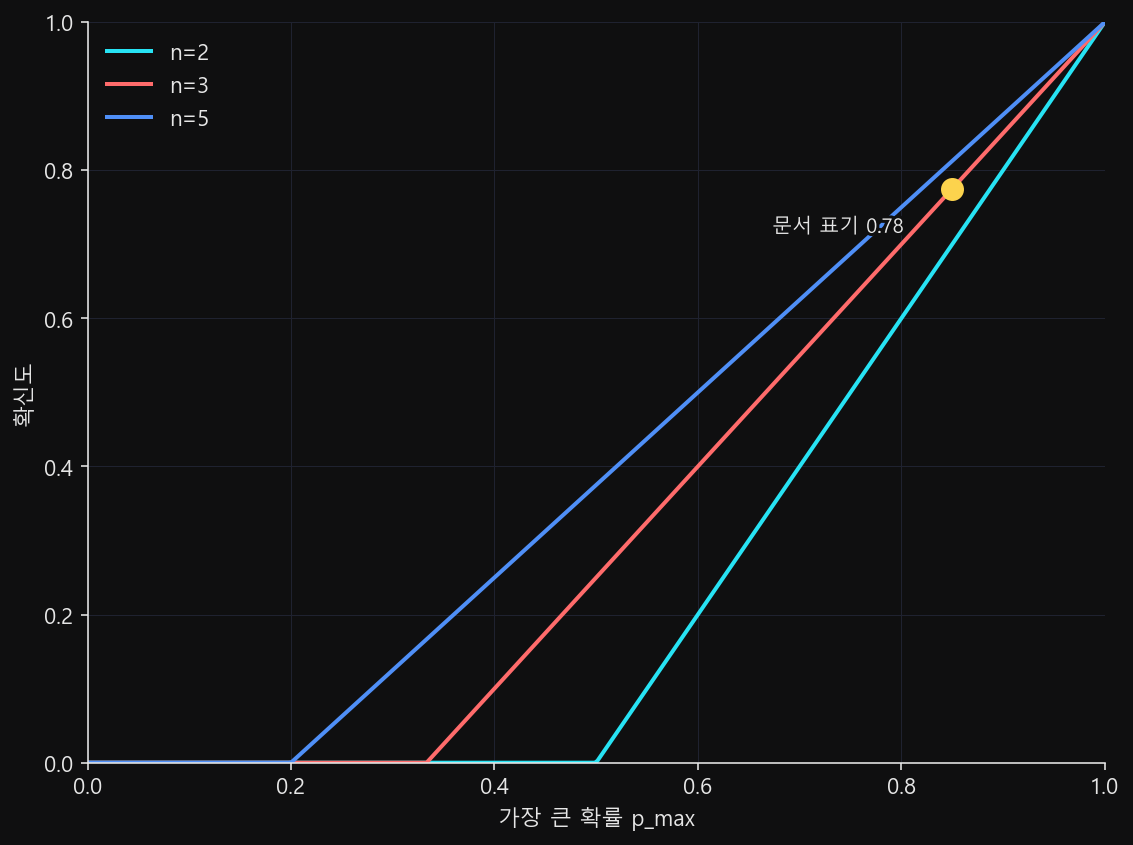
그림 2 는 보기 수를 2·3·5 로 놓고 그린 곡선이다. 보기가 많을수록 같은 확률에서 확신도가 더 높은데, 고르게 퍼졌을 때의 바닥이 그만큼 낮아서다. 세 보기에 확률이 똑같이 3분의 1 씩 퍼지면 0 이고, 한 보기가 1.0 을 다 가져가면 1 이다.
확신도를 받아 들면 코드가 할 일은 분기다. 문서가 권하는 세 구간에는 숫자가 없다 — 높으면 그냥 실행하고, 중간이면 확인을 받고, 낮으면 사람에게 넘기라고만 적는다. 숫자가 붙은 것은 문서의 예시 코드 쪽이고, 그림 3 의 문턱이 거기서 왔다. 확신도가 0.5 아래면 사용자 메시지를 사람에게 넘긴다. 잔액 조회처럼 되돌릴 수 있는 일은 그 위에서 바로 실행하고, 이체 승인은 0.9 를 넘어야 확인을 거쳐 실행한다. 0.9 를 넘지 못한 이체 승인은 실행 대신 사용자에게 먼저 묻는 쪽으로 간다.
문턱을 어디에 둘지는 문서가 정해 주지 않는다. 보수적인 값에서 시작해 자기 데이터로 시험하며 조정하라고 적을 뿐이다. 틀렸을 때 무엇을 잃는지가 그 값을 정하고, 그건 내 쪽 사정이다.
벤치 수치를 어떻게 읽어야 하나
확신도로 분기하는 코드를 갖춰도 남는 물음이 하나 있다 — 이 모델이 얼마나 맞히느냐다. TypeSafe 는 워크플로 평가라는 것을 따로 만들어 공개했다. 같은 워크플로 코드를 모델마다 똑같이 주고, 나온 답을 GPT-6 Astra 와 Claude Fable 5.1 두 모델이 낸 답의 평균과 견주는 방식이다. 업무 네 가지를 같은 가중치로 평균한 것이 아래 그림의 점들이다.
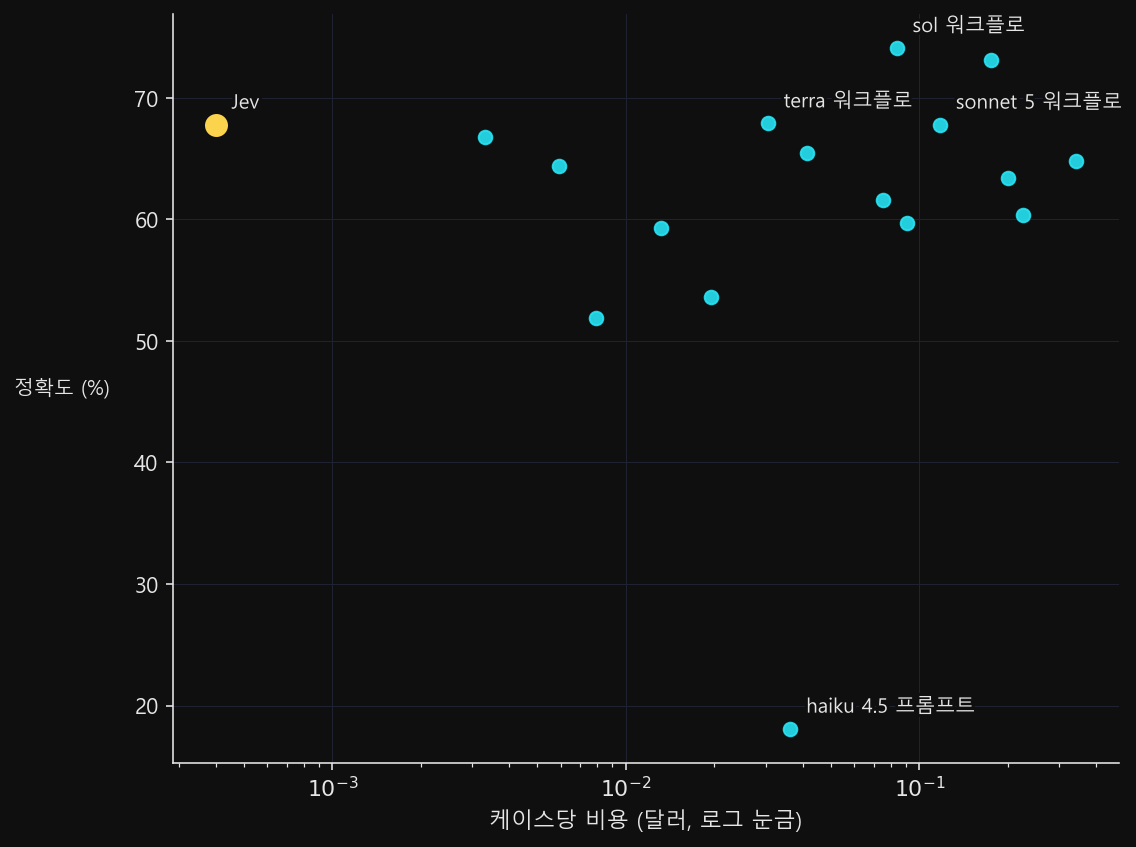
그림 4 의 숫자를 그대로 옮기면 Jev 는 정확도 67.8%, 케이스당 0.0004달러, 0.4초다. 같은 높이에 Claude Sonnet 5 워크플로가 67.8% 로 나란히 있는데 비용은 294배, 시간은 195배다. GPT-5.6 Terra 워크플로가 67.9% 로 0.1퍼센트포인트 앞선다. 비용은 76배, 시간은 25배다. 정확도가 확실히 위인 것은 OpenAI sol 워크플로 74.1% 와 Claude Opus 5 워크플로 73.1% 인데, 비용은 각각 209배와 440배다. 다만 이 배수는 사이트가 넷째 자리까지 반올림해 적은 값끼리 나눠 얻은 것이라, TypeSafe 가 홈페이지에 직접 적은 배수만큼 정밀하지는 않다.
이 그림을 「Jev 가 가장 정확하다」로 읽으면 안 된다. 평가를 만든 쪽이 조건 셋을 스스로 적어 두었다. 첫째, 정답지가 OpenAI 와 Anthropic 의 모델이라 답이 그쪽으로 기운다고 적는다. 둘째, 워크플로 넷을 만든 사람들이 자사 모델 역량 팀 소속이라 편향이 있을 수 있다고 적는다. 셋째, 홈페이지의 193.6배 빠름·444.6배 쌈이라는 수치가 이 평가에서 나온 것이며 실제 이득의 높은 쪽 끝일 것으로 본다고 적는다.
평균이 가린 것은 업무별 편차다.
| 업무 | Jev 정확도 | 가장 정확한 모델 | 차이(퍼센트포인트) |
|---|---|---|---|
| Security Incidents | 61.7% | opus 5 워크플로 66.2% | 4.5pp |
| Agent Trace Observability | 71.6% | sol 워크플로 76.6% | 5.0pp |
| Invoice Processing | 61.8% | sol 워크플로 79.1% | 17.3pp |
| Customer Service | 76.0% | sol 워크플로 78.3% | 2.3pp |
고객 응대에서는 2.3퍼센트포인트 차이지만 청구서 처리에서는 17.3퍼센트포인트가 벌어진다. 「같은 급」이라는 말이 서는 업무와 안 서는 업무가 갈린다. 내 쪽 일이 어느 쪽인지 가늠하려면 이 모델이 무엇을 못 하는지부터 봐야 한다.
Jev 가 못 하는 것
공식 문서에는 못 하는 것만 모아 둔 페이지가 따로 있다. jev-1.13 의 울퉁불퉁한 면(jaggedness)이라는 제목이 붙었고 마지막 검토일은 2026-09-17 이며, 실패 모드 아홉 가지가 표로 나열된다. 개발자가 먼저 부딪힐 만한 것은 넷이다.
첫째, 쓴 그대로 읽는다. 문서는 jev-1.13 이 내가 쓴 질문에 답하지 내가 뜻한 질문에 답하지 않는다고 적는다. 둘째, 계산기가 아니다. 세는 일이 미덥지 않고 세야 할 대상이 커질수록 오차도 커진다고 적는다. 셋째, 날짜를 순서 있는 양이 아니라 글자로 읽는다 — 어느 쪽이 먼저인지 따지는 일은 코드로 가져가라고 권한다. 넷째, state 가 판단과 무관한 내용으로 불어날수록 정확도가 떨어진다.
질문 사이의 산수도 보장되지 않는다. 문서가 든 예는 같은 티켓에 환불을 요청했는지와 그 밖의 것을 요청했는지를 Noul 둘로 따로 물은 것이다. 돌아온 값은 0.72 와 0.47, 합이 1.19 다. 둘은 서로 다른 질문이니 질문끼리 산수가 맞을 것을 기대하지 말라는 것이 문서의 권고다.
언어도 조건이다. 영어가 주 학습 언어이고 정확도도 거기서 가장 좋다. 문서는 한·중·일 문자(CJK)를 포함한 다른 언어도 처리되지만 똑같이 잘 되지는 않는다고 적고, 비영어 업무에 기대기 전에 자기 콘텐츠로 시험하라고 권한다. 한국어 문서를 state 에 넣을 생각이라면 이 줄이 가장 먼저 확인할 대목이다.
일주일 만에 선 생태계
못 하는 것을 세어 두고 나면 남는 것은 쓰임새다. 공개는 2026-09-15 였다. 일주일 사이에 바깥에서 만들어진 것들이 이 도구를 무엇에 쓰고 있는지를 보여 준다.
browser-use 는 jev-ultrafast 라는 레포를 2026-09-16 에 만들었다. GitHub 이 2026-09-22 에 돌려준 별 수는 17,105개다. 브라우저를 대신 조작하는 에이전트인데, README 가 적은 구조가 눈에 띈다. 페이지에서 조작할 수 있는 요소에 번호를 매겨 표로 만든 다음, 한 번의 호출에서 어떤 동작을 할지와 어느 요소에 할지를 함께 고른다. 글자를 실제로 쳐 넣어야 하는 TYPE_TEXT 일 때만 작은 언어 모델이 문자열을 만든다.
README 는 취리히에서 런던까지 구글 플라이트 검색을 7,073밀리초에 마친 실행이 영상에 담겼다고 적는다. 같은 모델과 설정으로 여섯 번 번갈아 돌린 비교도 함께 적혀 있다. 두 판 모두 3/3 통과했다. 작업 시간 중앙값이 9.450초에서 7.092초로 25% 줄었고, 브라우저 프로토콜 호출 중앙값은 1,092 에서 101 로 내려갔다. 같은 문단은 이것이 한 작업을 한 브라우저 프로필에서 세 번 되풀이한 것이지 일반적인 신뢰성 벤치마크가 아니라고 덧붙인다.
수는 더 있다. 독립 디렉터리 Jevable 을 살핀 정리 글에 따르면 2026-09-21 기준 194개 프로젝트가 11개 분류에 올라 있다. 2026-09-22 기준 LangChain 블로그에 올라와 있는 글은 langchain_typesafe 패키지의 TypeSafeClassifier 를 소개한다. 용례로 드는 것은 모델 라우팅과 툴 호출 가드레일이다. 여기 모은 예들이 Jev 에 맡긴 일은 고르기와 막아서기다.
바뀌는 속도는 그대로 위험이기도 하다. 파이썬 SDK typesafe-sdk 는 2026-09-14 에 v0.5.7 로 처음 나와 2026-09-21 에 v0.7.1 까지 올라갔다. 그 사이에 호환을 깨는 변경이 둘 있었다.
이 자리에 Jev 를 둘 만한가 — 판별표
여기까지 오면 물음이 「Jev 가 LLM 보다 나은가」에서 「내 코드의 어느 줄을 Jev 로 바꿀 수 있나」로 옮겨 간다. 바꿀 만한 줄은 대개 답이 몇 가지로 이미 닫혀 있는 경우다. 티켓을 어느 팀에 보낼지, 이 문단이 검색 결과로 쓸 만한지, 이 도구 호출을 그냥 실행해도 되는지 같은 것들이다.
정찰의 결과를 조건으로 적으면 이렇다. 줄마다 근거는 문서나 레포에 적힌 문장이고, 마지막 판단은 내 쪽 사정이 한다.
| 조건 | 판정 | 근거 |
|---|---|---|
| 답이 미리 적어 둘 수 있는 보기로 닫히나 | 닫히면 맞는 용처 | 문서 API 레퍼런스 — Choice 보기 최대 255개, Score 단계 2 ~ 10개 |
| 같은 재료에 물을 질문이 여럿인가 | 여럿일수록 이득 | 문서 투기적 팬아웃 — 질문을 더해도 응답 시간에 대개 영향 거의 없음 |
| 확신도로 사람에게 넘길 길을 코드에 둘 수 있나 | 못 두면 이득이 절반 | 문서 Confidence — 세 구간 분기, 문턱은 자기 데이터로 조정 |
| 계산·날짜 비교·글 생성이 끼나 | 끼면 그 부분은 코드나 생성 모델로 | 문서 jaggedness — 계산기 아님, 날짜는 글자로 읽음, 생성 훈련 없음 |
| 한국어이거나 state 가 긴가 | 먼저 시험해 볼 것 | 문서 Models·jaggedness — 영어가 주 학습 언어, 무관한 내용이 커지면 정확도 하락 |
표에 없는 조건이 하나 더 있다. 2026-09-22 기준 Jev 는 얼리액세스이고, 문서가 적어 둔 호출 경로는 API 키로 부르는 것 하나다. 다섯 줄이 전부 맞고 키까지 있는 경우라면 파서와 재시도 로직이 빠지고, 그 자리에 문턱 값 한 줄이 선다. 그 값을 얼마로 둘지는 문서가 아니라 내 데이터가 정한다. Jev 가 파는 것은 더 똑똑한 답이 아니라, 코드가 그대로 받아 쓸 수 있는 답의 모양이다.
더 읽기
- TypeSafe AI, 「Introducing System One Models & Jev」 (출시 발표 글, 2026-09-15) — https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe 공식 문서, 「Quick start」 — https://docs.typesafe.ai/introduction/quickstart
- TypeSafe 공식 문서, 「Models」 — https://docs.typesafe.ai/models
- TypeSafe 공식 문서, 「Confidence」 — https://docs.typesafe.ai/confidence
- TypeSafe 공식 문서, 「Jev 1.13 jaggedness」 (2026-09-17 검토) — https://docs.typesafe.ai/model-jaggedness/jev-1.13
- TypeSafe 워크플로 평가 사이트 (2026-09-22 취득) — https://evals.typesafe.ai/
- browser-use/jev-ultrafast (MIT) — https://github.com/browser-use/jev-ultrafast
- LangChain, 「Building a Harness with Jev」 — https://www.langchain.com/blog/building-a-harness-with-jev
- Jevable 디렉터리를 살핀 정리 글 (2026-09-21) — https://digidai.github.io/2026/09/21/typesafe-jev-jevable-decision-models/
- pytorch.kr 커뮤니티 정리 글 — https://discuss.pytorch.kr/t/jev-system-one-feat-typesafe-ai/11935