같은 챗봇에 같은 질문을 스무 번 던져 봤다. 「비 오는 날에 대해 한 문장」에는 문장이 열여섯 가지로 갈렸는데, 「1부터 10 사이 숫자 하나」는 스무 번 다 「7」이었다. 모델이 다음 낱말 후보마다 확률을 매긴 표에서 매번 하나를 뽑기 때문이다. 그 뽑기를 끄려고 설정값을 0으로 내려도 답이 완전히 고정되지는 않는다. 이 확률표의 모양을 바꾸는 값을 temperature(온도)라고 한다.
같은 질문을 스무 번 던지면

어제 챗봇에게 물어본 것을 오늘 다시 물으면 답이 조금 다르게 돌아온다. 그런데 매번 그런 것도 아니다 — 어떤 질문에는 몇 번을 물어도 토씨까지 같은 답이 온다. 그 차이가 어디서 오는지 보려고, 2026년 9월 22일에 gemini-3.1-flash-lite 라는 모델에 질문 네 가지를 각각 스무 번씩 던져 봤다. 한 문장을 지어 달라고 한 질문에는 거의 매번 다른 문장이 돌아왔다. 1부터 10 사이 숫자 하나를 고르라고 한 질문에는 스무 번이 다 「7」이었다.
갈리는 답에서 곤란한 것은 견줄 기준이 사라진다는 점이다. 어느 쪽이 그 모델의 답인지 알 수 없고, 질문을 조금 고친 뒤 결과가 나아졌는지 보려고 해도 고치지 않았을 때조차 답이 달라진다. 같은 질문을 두 번 넣어 놓고 어느 쪽을 쓸지 골라 본 적이 있다면 아는 장면이다. 나은 쪽을 고른 것인지 그냥 다른 쪽을 고른 것인지가 헷갈린다.
설정에서 지정한 것은 temperature 값 1.0 하나다. 다음 낱말을 고를 때 쓰는 다른 설정값들은 회사가 정해 둔 기본값 그대로 두었다. temperature 가 무엇을 하는 값인지는 다음 절에서 푼다. 답을 셀 때는 앞뒤 공백과 문장부호, 대소문자 차이를 지운 뒤 글자가 같으면 같은 답으로 셌다.
결과는 질문마다 딴판이었다. 「대한민국의 수도는 어디입니까? 도시 이름 한 단어만 답하세요.」에는 서로 다른 답이 두 가지 돌아왔다. 열여섯 번은 「서울」, 네 번은 「서울특별시」였고, 글자는 달라도 가리키는 곳은 같으니 내용이 다른 답은 한 번도 없었다. 「동물 이름을 하나만 말해 주세요. 다른 말 없이 단어 하나만.」에는 네 가지가 돌아왔다. 고양이 일곱, 강아지 다섯, 호랑이 넷, 사자 넷이다. 스무 번을 물었는데 다섯째 동물은 끝내 나오지 않았다.
「비 오는 날에 대해 한 문장만 써 주세요. 한 문장만.」에는 열여섯 가지 문장이 돌아왔다. 「1부터 10 사이의 정수 하나를 고르세요. 숫자만 답하세요.」에는 스무 번 다 「7」이 돌아왔다. 다른 숫자는 한 번도 나오지 않았다.
붙여 둘 조건이 있다. 네 질문은 미리 정해 놓고 한 번만 돌렸고, 결과를 보고 질문을 고르거나 마음에 드는 회차만 남기지는 않았다. 모델 한 종을 하루 잰 값이고, 질문마다 스무 번씩이다. 뒤에 나올 temperature 별 결과까지 더하면 이 실측에서 받은 응답은 모두 400건이다. 다른 모델이나 다른 날에 같은 개수가 나온다는 보장도 없다.
그래도 대비는 뚜렷하다. 같은 모델, 같은 설정, 같은 횟수인데 그렇다. 그날그날 모델 쪽이 달라진 것이라면 네 질문이 고르게 흔들렸어야 한다. 흔들린 것은 문장을 지어 달라는 질문이었고, 숫자를 고르라는 질문은 스무 번 내내 같은 자리에 있었다. 같은 설정에서도 답이 퍼지는 질문과 모이는 질문이 이렇게 갈렸다.
모델은 확률표에서 낱말을 뽑는다
질문마다 답이 갈리는 정도가 다른 까닭은 모델이 글을 만드는 방식에 있다. 모델은 문장을 통째로 짓지 않는다. 낱말을 하나 정하고, 그 낱말까지 붙은 글을 처음부터 다시 읽어 다음 낱말을 하나 더 정한다. 한 문장은 그 걸음을 수십 번 되풀이한 결과물이다. 한 걸음에 정해지는 단위는 정확히는 토큰, 낱말보다 잘게 쪼갠 조각이다. 이 글에서는 뜻이 달라지지 않는 자리에서는 그냥 낱말이라고 쓴다.
그 한 걸음마다 모델이 만드는 것이 확률표다. 아는 낱말 조각 전부에 「지금 자리에 올 법한 정도」를 숫자로 매겨 놓은 표라고 보면 된다. 올라오는 후보가 수만 개라 대부분은 아주 작은 몫을 받고, 그 작은 것들이 표의 꼬리를 이룬다. 어떤 자리에서는 한 낱말이 표를 거의 독차지하고, 어떤 자리에서는 수십 개가 고만고만한 몫을 나눠 갖는다. 낱말이 하나 붙을 때마다 앞의 글이 달라지니 표도 매번 새로 만들어진다.
그리고 그 표에서 하나를 뽑는다. 1등을 무조건 집어 오는 것이 아니라, 표에 적힌 확률만큼의 몫으로 후보 하나가 뽑혀 나온다. 같은 질문을 스무 번 던지면 스무 번의 뽑기가 따로 일어나고, 한 답 안에서도 낱말 수만큼 뽑기가 있다. 그래서 답이 매번 조금씩 다른 것은 이 방식의 기본 동작이다.
이 뽑기의 세기는 챗봇을 다루는 설정 칸에 값으로 나와 있고, 손대지 않으면 회사가 정해 둔 값이 그대로 쓰인다. 표를 그대로 쓸지 모양을 한 번 바꿔서 쓸지를 정하는 값이 그 설정 칸의 temperature(온도)다. 값을 내리면 표가 뾰족해진다 — 1등 후보 쪽으로 확률이 쏠리고 뒤쪽 후보의 몫은 줄어든다. 값을 올리면 표가 평평해진다 — 1등의 몫을 덜어 뒤쪽 후보에게도 기회가 간다.
temperature 를 올린다는 말은 표의 높낮이 차이를 줄인다는 뜻이다. Holtzman 연구진이 ICLR 2020 에 실은 논문은 이 값을 1 아래로 내리면 확률이 높은 쪽으로 분포가 기울고 꼬리의 몫이 줄어든다고 적는다. 여기까지 오면 앞 절의 두 결과가 풀린다.
「7」이 스무 번 나온 것은 뽑기가 꺼져 있어서가 아니다. 그 자리의 확률표가 「7」 쪽으로 심하게 쏠려 있으면 스무 번을 뽑아도 스무 번 다 「7」이 나온다. 실제로 temperature 를 0 · 0.5 · 1.0 · 1.5 · 2.0 다섯 단계로 올려 가며 같은 질문을 스무 번씩 물었지만, 다섯 단계 모두 스무 개가 전부 「7」이었다.
temperature 는 표에 이미 적힌 확률을 키우거나 줄일 뿐, 없던 후보를 표에 올려 주지 않는다. 게다가 이 실측은 뒤쪽 후보를 미리 걷어 내는 설정을 기본값 그대로 둔 채였다. 그 걷어 내기는 temperature 보다 먼저 걸린다 — 다음 절에서 볼 자르기다. 둘 중 어느 쪽이 「7」을 지켰는지까지는 이 실측으로 가르지 못하지만, 표에서 밀려난 후보가 뽑히지 않는다는 점은 양쪽이 같다.
문장 쪽은 반대다. 「비 오는 날에 대해 한 문장」에는 다음에 올 만한 낱말이 여럿인 자리가 한 문장 안에서 수십 번 이어진다. 한 자리에서 갈리면 그 뒤가 전부 달라지니, 스무 번 뽑으면 열여섯 가지가 된다.
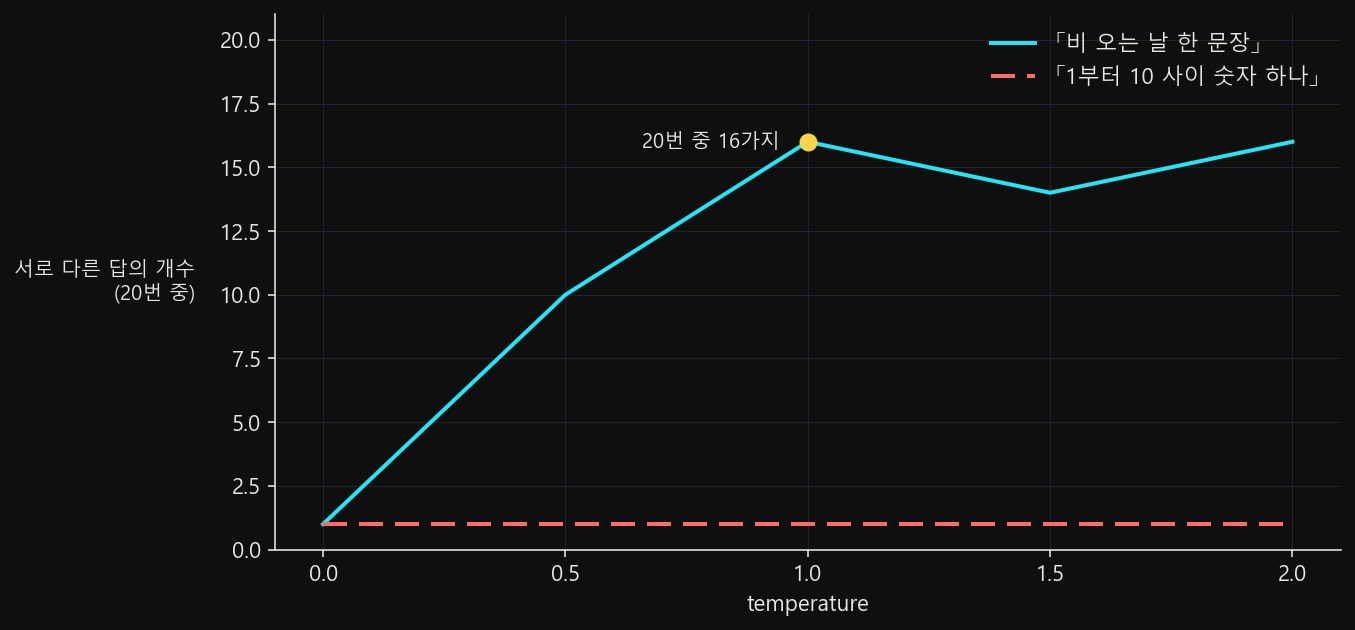
temperature 를 올릴 때 벌어지는 정도는 질문마다 다르다. 그림에는 양 끝 두 질문만 실었다. 그림 1 에서 실선인 「한 문장」은 값을 올릴수록 크게 올라가는데, 점선인 「숫자 하나」는 2.0에서도 바닥에 붙어 있다. 나머지 두 질문은 그림 밖이다 — 실측에서는 동물 이름이 0.5부터 네 가지, 수도 질문이 1.0부터 두 가지로 늘어난 뒤 둘 다 2.0까지 그대로였다.
한 질문 안에서도 자리마다 사정이 다르다. temperature 0.5에서 나온 열 가지 문장은 첫 어절이 전부 「창밖으로」였고, 2.0에서도 스무 개 중 열세 개가 그렇게 시작했다. 갈라진 자리는 첫머리가 아니라 「소음」이 될지 「소란함」이 될지, 「지우고」가 될지 「잠재우고」가 될지 같은 뒤쪽 어휘였다. 한 문장 안에 뾰족한 자리와 평평한 자리가 섞여 있다는 뜻이다.
한 가지 밝혀 둘 것이 있다. 이 모델은 확률값 자체를 돌려주지 않는다. 확률표를 우리가 열어 본 것이 아니라, 뽑기 결과만 세어 표의 모양을 뒤에서 짐작한 것이다. 그래도 방향은 읽힌다 — 답이 갈리는 폭은 그 자리의 표가 한쪽으로 얼마나 쏠려 있느냐를 따라간다.
같은 모델도 자리마다 표 모양이 다르다 — 그래서 자르기도 한다
표의 모양이 자리마다 다르다는 것을 Holtzman 연구진이 GPT-2 로 그려 보였다. 누군가 말을 꺼내는 대목인 She said, "I never 다음 자리에서는 1위 후보 thought 가 받은 확률이 약 8%였고, 2위 knew 부터 열다섯째 후보까지가 그 아래로 고만고만하다. 다른 쪽 문맥인 I ate the pizza while it was still 다음에서는 hot 하나가 약 80%를 가져간다.
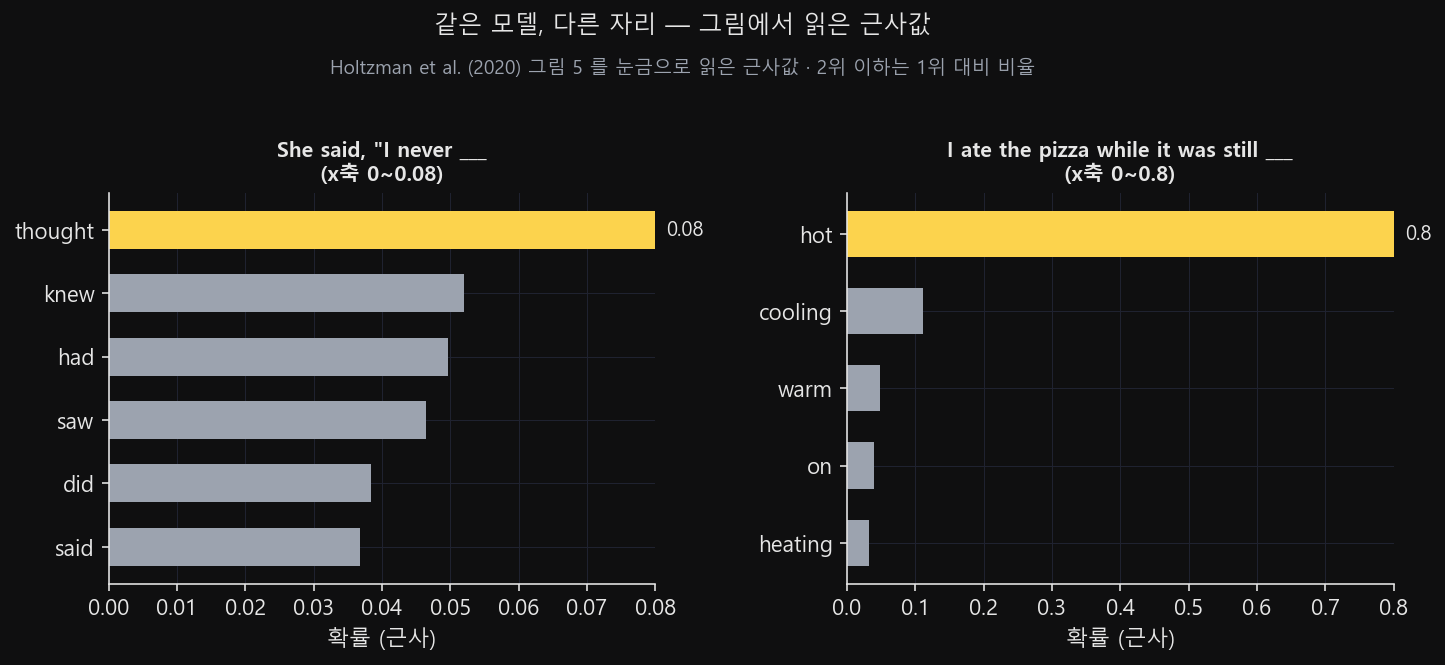
그림 2 의 두 패널을 같은 축에 겹쳐 그리면 눈금 상한이 열 배 차이라 왼쪽은 바닥에 깔려 보이지 않는다. 문제가 되는 쪽은 그 평평한 표다. 꼬리의 작은 몫들도 다 합치면 무시 못 할 크기가 되고, 거기서 하나가 뽑히면 문장이 그 자리에서 이상해진다.
그래서 뽑기 전에 자른다. 확률이 높은 후보부터 차례로 더해 가다가 누적이 정해 둔 값을 넘으면 거기서 끊고, 나머지는 후보에서 뺀다. 이것을 top-p(핵 샘플링)라고 한다. 표가 평평한 자리에서는 많이 남고 뾰족한 자리에서는 몇 개만 남으니, 자르는 폭이 자리마다 저절로 달라진다.
자르는 것과 모양을 바꾸는 것은 같은 일이 아니다. Google 의 생성 파라미터 문서는 top-k 로 후보를 추리고, top-p 로 더 걸러낸 뒤, 마지막에 temperature 로 뽑는다고 순서까지 적어 둔다. OpenAI 스펙은 top-p 와 temperature 중 하나만 건드리라고 권한다. 설정 칸에 값이 여러 개인 것은 조절할 것이 많아서가 아니라, 확률표에 손대는 자리가 여러 곳이기 때문이다.
temperature 를 낮추는 것이 안전한 게 아니다
답을 고정하려고 temperature 를 끝까지 내리면 1등 후보만 집어 오는 것과 같아지는데, 이 방식을 그리디 디코딩이라고 한다. 같은 논문이 그 대가를 쟀다. 되풀이로 세는 기준은 좁다 — 앞쪽 200 토큰 안에서 두 토큰 이상짜리 구절이 글 끝에 세 번 이상 되풀이되는 경우만 센다. 그 기준으로 사람이 쓴 원래 글을 세면 0.28%다. GPT-2 Large 로 글 5,000편을 만들어 보니, 그리디로 뽑은 글은 73.66%가 같은 구절을 되풀이하는 상태로 끝났다.
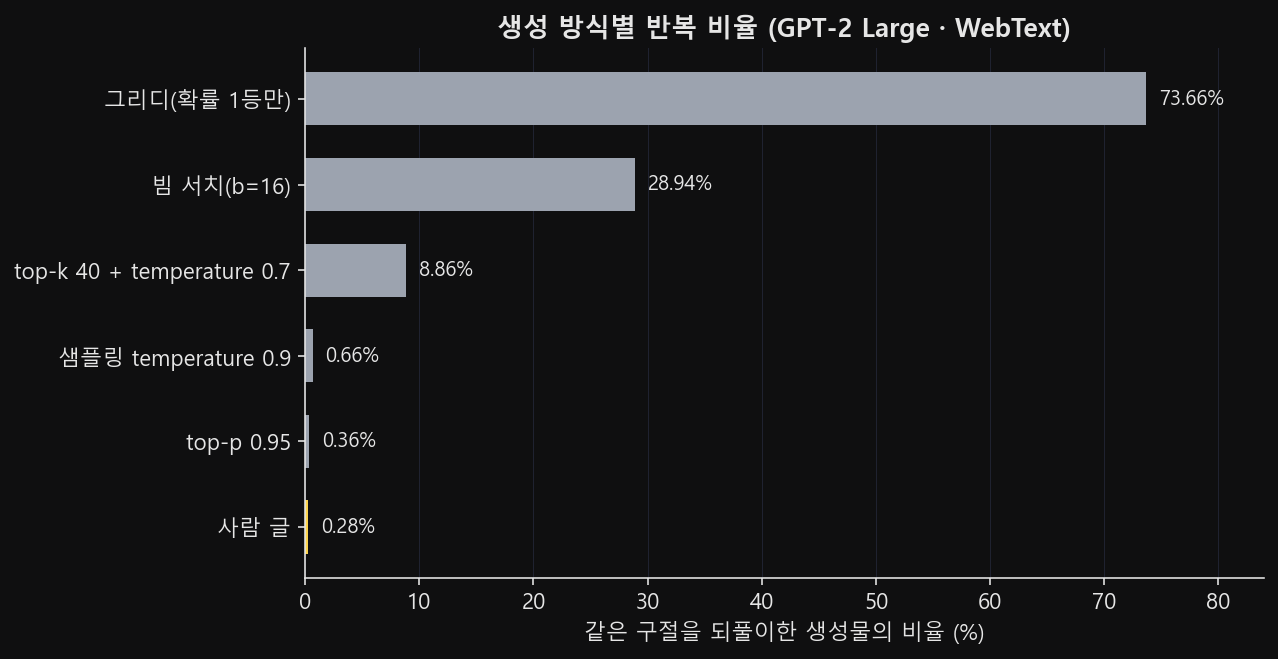
그림 3 에서 당시 흔히 쓰던 조합인 상위 40개만 남기고 temperature 0.7 로 뽑은 글은 8.86%였다. 아무것도 자르지 않고 temperature 만 0.9로 둔 쪽은 0.66%였다. 너무 세게 자르고 값까지 내리면 결국 그리디를 흉내 내게 된다고 논문은 진단한다. 논문은 되풀이가 스스로 자란다고도 적는다 — 어떤 구절이 되풀이될수록 다음에 또 나올 확률이 올라간다.
뽑기를 켜 둔 채 temperature 만 내려도 방향은 같다. 논문의 그림 9는 이 값을 0.9 아래로 내리면 되풀이가 심하게 는다고 적고, 그림에서 읽으면 0.8에서 약 3%던 반복률이 0.1에서는 약 70%가 된다. 앞의 73.66%는 뽑기를 끈 실험, 이쪽은 켠 채 값만 내린 실험이라 따로 봐야 하지만 방향은 하나다.
다만 이 수치들은 답이 하나로 정해지지 않은 글에서의 값이고, 번역처럼 정답이 좁은 일에서는 사정이 다르다. temperature 를 내려 답을 고정하면, 같은 말을 되풀이할 확률도 함께 올라간다. 2026년 운영 문서도 그 상태에서는 값을 올리라고 적는다.
If the model enters infinite generation, increasing the temperature to at least 0.1 may lead to improved results. 1.0 is the recommended starting value for temperature.
모델이 끝없이 생성하는 상태에 빠지면 temperature 를 적어도 0.1까지 올리는 것이 도움이 될 수 있다. temperature 의 권장 시작값은 1.0이다.
출처: Google, Content generation parameters, 2026-09-18 갱신0으로 내려도 같은 답이 보장되지 않는다
그렇다면 temperature 를 아예 0으로 두면 어떨까. 뽑기가 사라지니 같은 답이 나와야 맞다. 그런데 그 값을 내주는 회사들이 먼저 아니라고 적는다.
Google 문서는 이 값이 0이면 확률이 가장 높은 후보가 늘 선택된다고 적는다. 그러면서 "mostly deterministic, but a small amount of variation is still possible" 이라고 덧붙인다 — 대체로 고정되지만 약간의 변동은 여전히 가능하다는 뜻이다. OpenAI 의 공식 스펙은 같은 조건이면 같은 결과가 나오도록 최선을 다한다고 적은 바로 다음에 "Determinism is not guaranteed" 를 붙인다.
그 차이를 실제로 센 기록이 Thinking Machines Lab 의 2025년 9월 글에 있다. Qwen3-235B-A22B-Instruct-2507 이라는 모델에 temperature 0으로 같은 질문을 1,000번 던지고 매번 1,000 토큰씩 받았더니, 서로 다른 답이 80가지 나왔다. 가장 흔한 답조차 78번에 그쳤다. 1,000개의 답은 102번째 토큰까지 글자 하나까지 같았고, 103번째에서 처음 갈린 뒤로 갈림이 쌓였다.
흔히 드는 설명은 GPU 가 여러 계산을 한꺼번에 하니 끝나는 순서가 매번 다르다는 것인데, 글쓴이는 같은 계산을 1,000번 돌려도 결과가 비트 하나까지 같았다며 기각한다. 원인은 한 칸 옆에 있다. 소수를 더할 때는 순서가 바뀌면 끝자리가 달라질 수 있는데, 모델을 돌리는 계산은 배치, 그러니까 한 번에 같이 처리하는 요청 묶음의 크기에 따라 그 순서를 바꾼다. 배치 크기를 정하는 것은 내 요청이 아니라 그 순간 서버에 몰린 다른 사람들의 요청이다. 배치 크기가 달라도 같은 순서로 더하게 고친 계산을 넣자 1,000개가 전부 같은 답이 됐다.
이 1,000회 실험은 동료 심사를 거친 논문이 아니라 회사 블로그 글이고, 모델 한 종·질문 한 개로 잰 값이다. 다른 서버에서도 같다는 보장은 없다.
그림 4 이 설정 칸으로 닿는 범위이고, 두 번째 원인은 그 바깥에서 일어난다. 우리가 잰 네 질문도 temperature 0에서는 스무 번 다 같은 답이었지만, 답이 짧고 스무 번뿐이라 그 실험처럼 백 토큰을 넘겨 갈릴 자리가 없었다. temperature 0은 뽑기를 끄는 값이지, 서버 사정까지 끄는 값이 아니다.
그래서 설정 칸에서 무엇을 읽어야 하나
답이 달라지는 이유는 둘이다. 하나는 일부러 확률표에서 뽑기 때문이고, 다른 하나는 그 뽑기를 껐는데도 계산 순서가 달라지기 때문이다. 앞쪽은 설정 칸으로 줄일 수 있고, 뒤쪽은 거기서 손이 닿지 않는다. 계산 순서를 정하는 것이 내 요청 하나가 아니기 때문이다.
그래서 설정 칸보다 먼저 볼 것이 질문이다. 숫자 하나를 고르라는 질문과 한 문장을 지어 달라는 질문은 다음 낱말 후보의 수부터 다르고, 그 차이는 temperature 를 건드리기 전에 이미 정해져 있다. 이 실측에서도 답의 모양을 좁게 요구한 질문일수록 덜 갈렸다. 매번 같은 답을 받아야 하는 자리라면, 값을 만지기 전에 답의 모양부터 좁혀 두는 것이 순서다.
달라 보이는 답이 실제로 다른 답인지도 따로 봐야 한다. 「서울」과 「서울특별시」는 서로 다른 답으로 세었지만 가리키는 곳은 하나다. 답이 갈렸다고 느껴질 때, 갈린 것이 표기인지 내용인지는 세어 봐야 안다.
다음은 값을 내렸을 때 무엇이 줄고 무엇이 느는지다. 뽑기에서 오는 차이는 줄어든다. 대신 같은 말을 되풀이할 확률이 올라가고, 그래서 Google 문서는 끝없이 생성하는 상태라면 temperature 를 오히려 올리라고 적는다. 값을 내려 봤다면 답이 같아졌는지뿐 아니라 같은 구절이 맴돌기 시작했는지도 읽어 봐야 한다.
마지막은 이 값들이 어디까지의 값인지다. 반복률은 2019년에 나온 GPT-2 로 잰 것이고, temperature 0의 1,000회 실험은 모델 한 종의 기록이며, 스무 번씩 물어본 실측은 모델 한 종을 하루 잰 것이다. 여기 나온 어느 줄도 「요즘 모델은 이렇다」로 넓혀 읽을 값이 아니다.
설정의 범위도 회사마다 다르다. OpenAI 스펙은 0에서 2 사이에 기본값 1이라고 못 박아 두었고, Google 의 Gemini API 참조 스펙은 범위만 0에서 2로 적고 기본값은 모델마다 다르다고 한다. 2026년 9월에 조회해 보면 현행 Gemini 텍스트 모델은 전부 1이다. 같은 회사 문서는 Gemini 3.6 Flash 이후 모델에서 이 값을 넣어도 무시된다고 적어 두기도 했다.
아무도 재지 않은 것이 하나 있다. temperature 를 내리면 답이 더 정확해지는지를 확인한 자료는 여기에 없다 — 문헌들이 잰 것은 반복률과 다양성, 그리고 사람의 선호다. 값을 낮추면 답이 덜 흔들릴 뿐, 맞는 쪽으로 옮겨 간다는 근거는 없다.
temperature 를 0으로 내려 두면 뽑기에서 오던 차이는 실제로 사라진다. 남는 차이는 그 순간 같은 서버에 질문을 던진 다른 사람들이 정한다.
더 읽기
- Holtzman, Buys, Du, Forbes, Choi, "The Curious Case of Neural Text Degeneration", ICLR 2020 (arXiv:1904.09751v2) — https://arxiv.org/abs/1904.09751
- He, Horace and Thinking Machines Lab, "Defeating Nondeterminism in LLM Inference", 2025-09-10 — https://thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/
- Google, "Content generation parameters", 2026-09-18 갱신 — https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/capabilities/content-generation-parameters