음악 앱에서 셔플을 눌렀는데 같은 가수 노래가 연달아 나오면 덜 섞인 것처럼 보인다. 그런데 가수마다 3곡씩 든 30곡을 진짜 무작위로 섞어도, 열 번 중 아홉 번 가까이는 어딘가에서 같은 가수 곡이 이어 나온다. 곡과 곡 사이 자리마다 작은 확률이 29번 쌓이기 때문이다. 곡 순서를 임의로 섞어 트는 이 기능을 셔플 재생(shuffle play)이라고 한다.
셔플을 켠 30곡짜리 재생 목록에서 「다음 곡」 목록을 열어 보면, 넷째 줄과 다섯째 줄에 같은 가수 이름이 나란히 떠 있을 때가 있다. 셔플 재생이라면서 왜 같은 가수가 연달아 나올까? 음악 서비스 스포티파이(Spotify)도 2014년 회사 블로그 글에서 이 불만을 소개했다. 같은 가수 곡이 바로 이어 나온다며 사용자들이 「Why isn’t your shuffling random?」(셔플이 왜 무작위가 아니냐)고 물었다는 것이다. 같은 가수가 붙었다고 해서 덜 섞인 것은 아니다. 모든 순서가 똑같이 나올 수 있게 제대로 섞은 목록에서는 같은 가수가 이어 나오는 일이 오히려 흔하다.
셔플 재생 30곡, 곡 사이 29자리
이 글에서 「진짜 무작위로 섞는다」는 말은 나올 수 있는 모든 순서가 같은 확률로 나오게 섞는다는 뜻으로 쓴다. 스포티파이가 2025년 글에서 설명한 「표준」 셔플은 곡마다 무작위 값을 하나씩 붙이고 그 값 순서로 줄을 세운다. 이렇게 섞어도 모든 순서가 같은 확률로 나온다. 그리고 같은 가수 곡이 바로 이어 나온 자리 하나를 이 글에서는 「붙음」 한 번으로 센다.
대표로 삼을 목록은 가수 10명이 3곡씩 부른 30곡이다. 먼저 어떤 곡이 끝났을 때 바로 다음 곡이 같은 가수일 확률을 구한다. 남은 곡은 29곡이고, 그 가운데 방금 들은 가수의 곡은 2곡이다. 그러니 다음 곡이 같은 가수일 확률은 2/29, 약 6.9%다. 곡 사이 자리 14~15개에 한 번꼴인 작은 확률이다.
그런데 이런 「곡 사이 자리」는 하나가 아니다. 30곡을 한 바퀴 들으면 첫째와 둘째 곡 사이, 둘째와 셋째 곡 사이처럼 곡 사이 자리가 29개 생긴다. 어느 자리든 같은 가수가 붙을 확률은 똑같이 2/29다. 한 바퀴에 평균 몇 번 붙는지는 자리마다 붙을 확률을 그냥 더하면 된다. 자리가 29개이고 자리마다 2/29이니, 식 1처럼 평균 2번이 나온다.
자리 하나의 확률은 7%가 안 되지만, 거기에 자리 수 29를 곱하면 한 바퀴 평균 붙음은 두 번이 된다. 평균만으로는 감이 덜 오니, 한 번이라도 붙을 확률을 따로 계산했다. 30곡을 진짜 무작위로 섞으면 한 바퀴 안에 같은 가수가 한 번 이상 이어질 확률은 87.4%다. 한 번도 안 붙는 바퀴는 12.6%, 여덟 바퀴에 한 번꼴이다. 앞의 6.9%와 이 87.4%는 묻는 대상이 다르다. 6.9%는 곡 사이 자리 하나의 확률이고, 87.4%는 그 자리 29개를 모두 지나는 한 바퀴 전체의 확률이다.
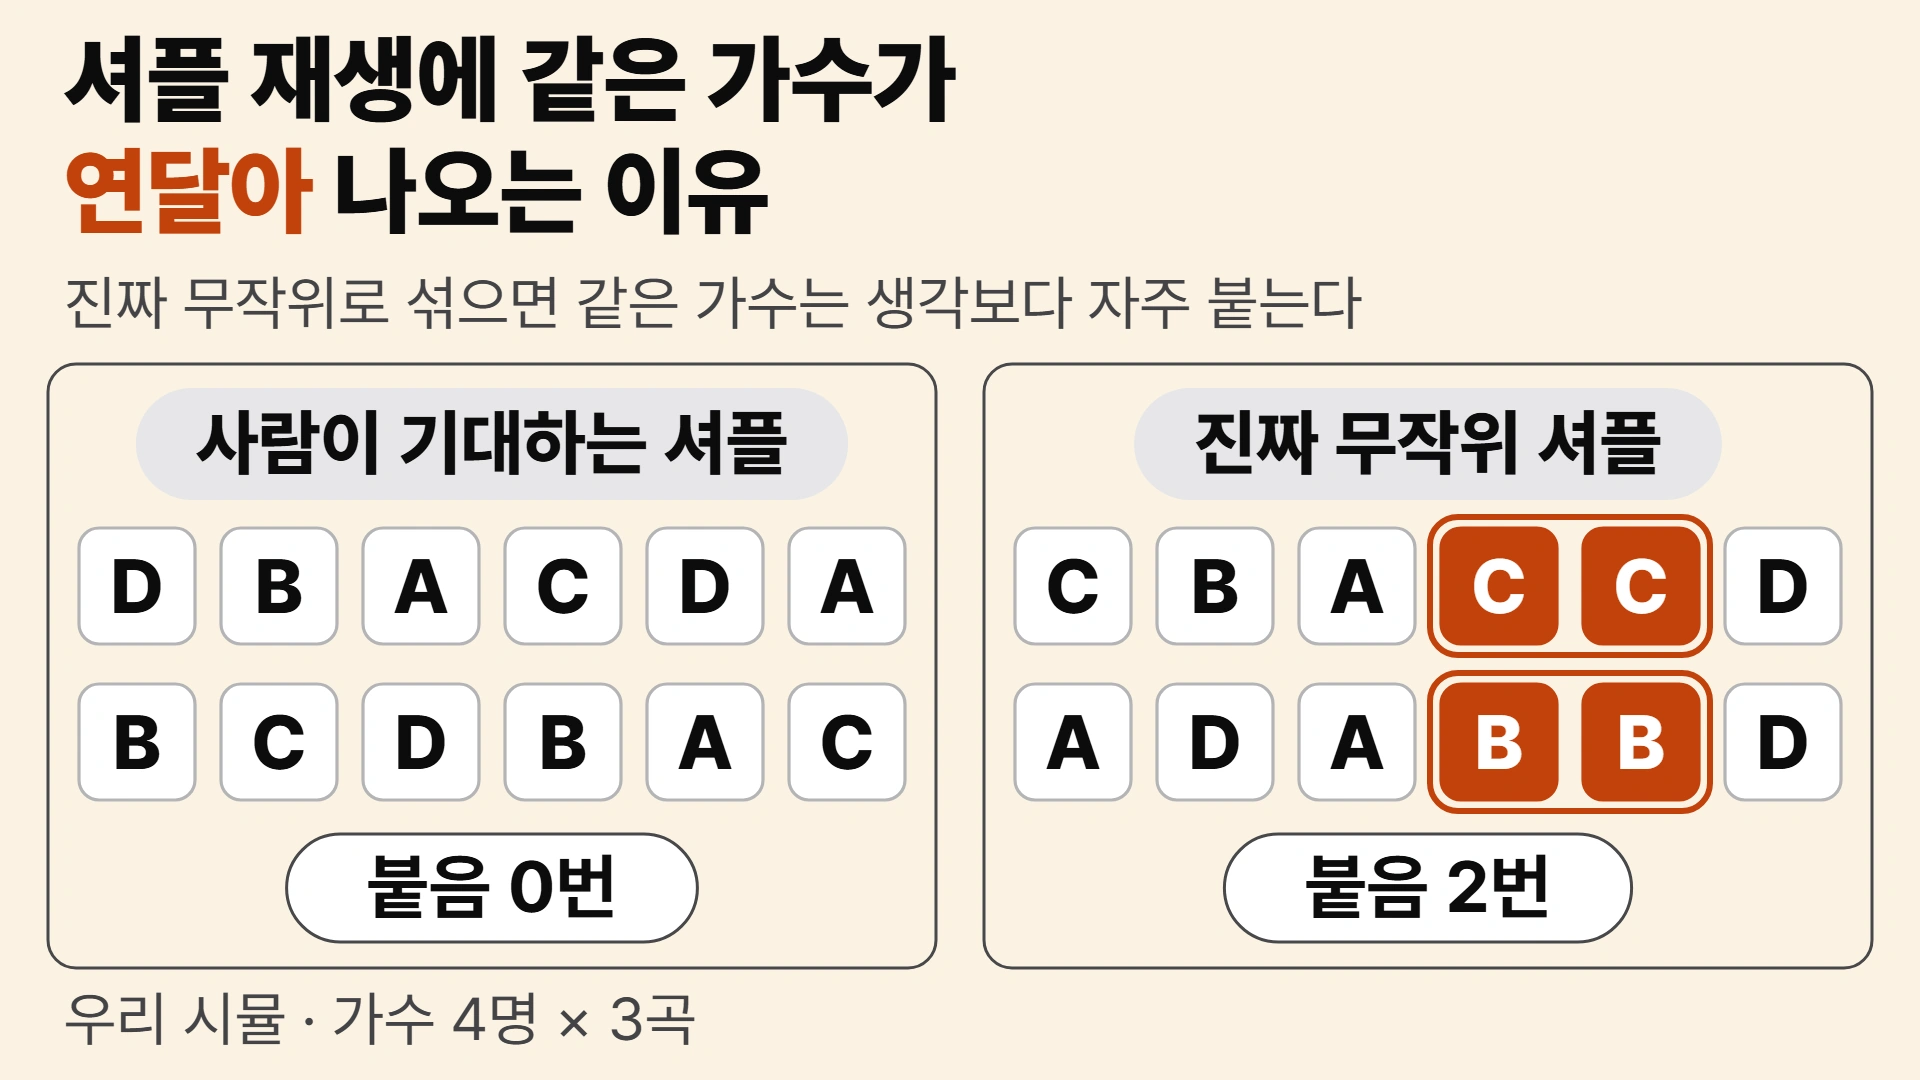
글 맨 위 그림은 가수 4명이 3곡씩 부른 12곡을 두 가지로 섞은 순서다. 목록을 한 번 섞어 나온 순서, 곧 한 바퀴를 이 글에서는 「판」이라고 부른다. 오른쪽 줄은 진짜 무작위로 섞은 판 가운데 붙음이 2번인 판을 골라 낸 것이다. 이 12곡 목록도 한 바퀴 평균 붙음이 2번이라, 평균과 같은 판이다. 왼쪽 줄은 사람이 기대하는 모습대로 같은 가수가 한 번도 이어지지 않은 판이다. 다만 이 판은 진짜 무작위로 섞은 것이 아니라, 뒤에서 볼 「고르게 퍼뜨리기」 방식으로 섞은 판 가운데 붙음이 0번인 첫 판이다.
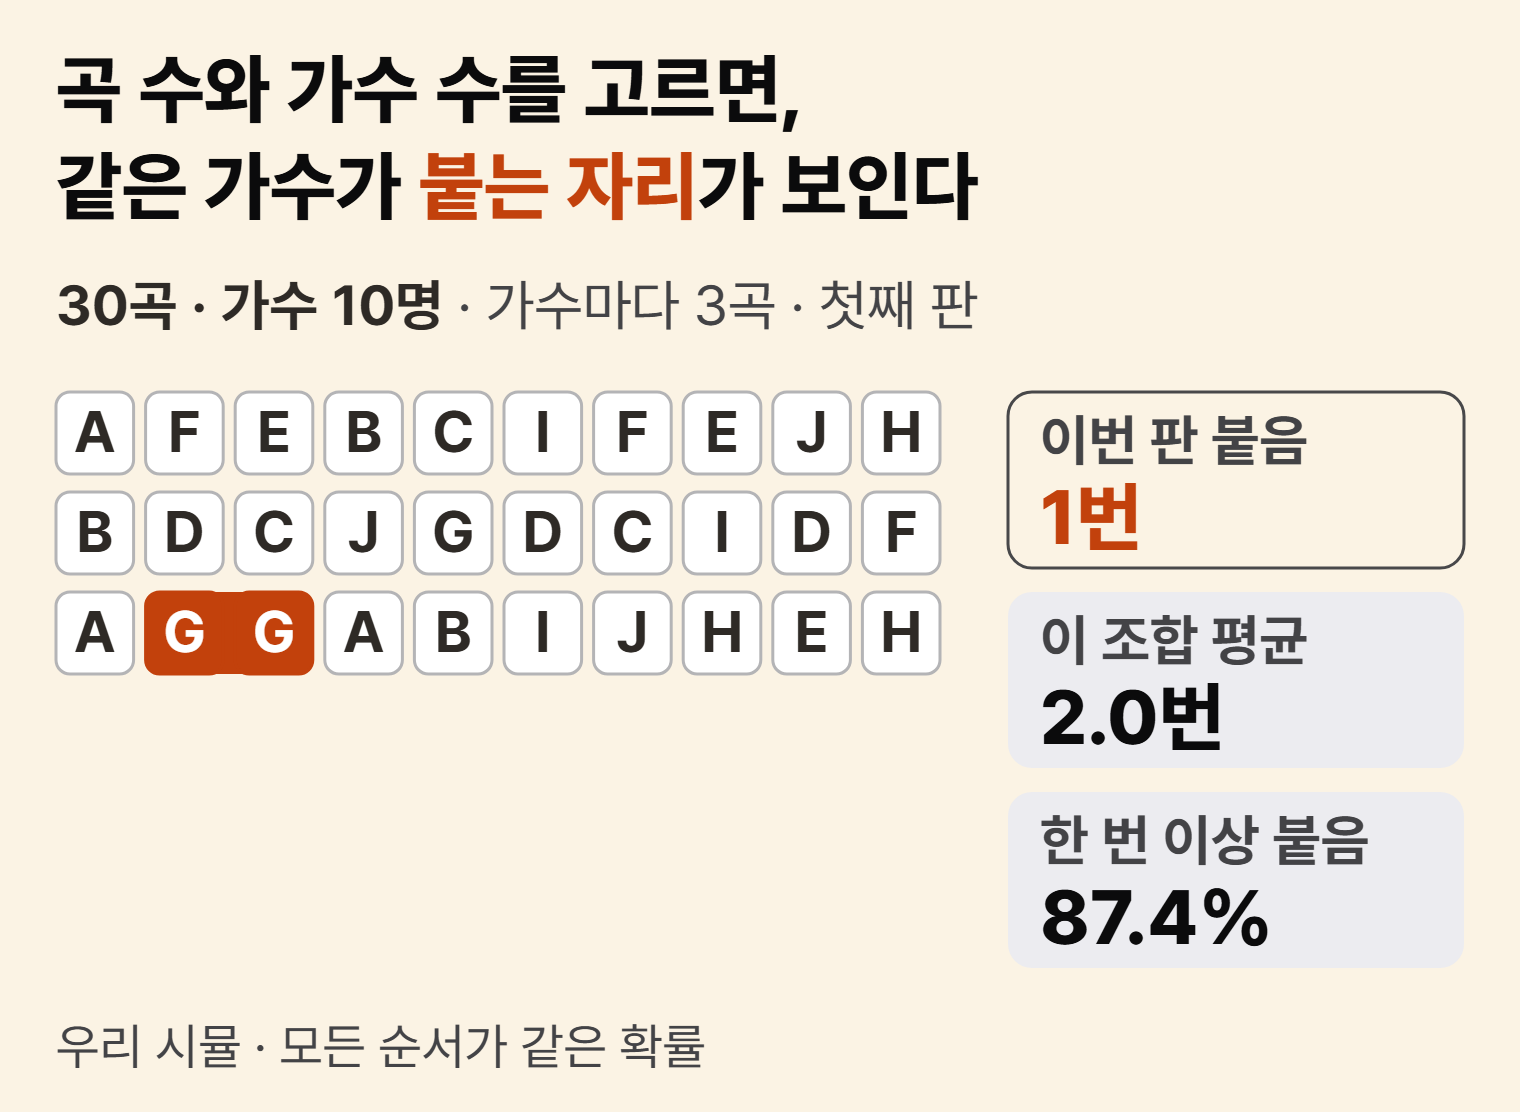
그림 1에서는 곡 수와 가수 수를 바꿔 가며 같은 가수가 붙는 자리를 직접 볼 수 있다. 처음 보이는 판은 30곡, 가수 10명, 첫째로 섞은 판이다. 이 판에서는 같은 가수가 한 번 이어졌다. 평균 2번은 판 하나의 값이 아니라 많은 판을 모은 값이라, 판마다 1번이 나오기도 하고 3번이 나오기도 한다. 30곡을 200,000번 섞어 붙음 횟수를 세어 보면 가장 흔한 것은 2번(28.1%)이고, 1번(27.0%)과 3번(18.7%)이 뒤를 잇는다.
정확한 셈이 맞는지는 직접 섞어서 세어 봐도 확인된다. 아래 코드는 30곡을 200,000번 섞고, 판마다 같은 가수가 이어진 자리를 센다. 끝에 찍히는 두 값을 앞의 87.4%와 2번에 견주어 보면 된다.
import random
rng = random.Random(20261022)
songs = [a for a in range(10) for _ in range(3)]   # 가수 10명 × 3곡
trials, any_adj, total = 200_000, 0, 0
for _ in range(trials):
    s = songs[:]
    rng.shuffle(s)
    k = sum(1 for x, y in zip(s, s[1:]) if x == y)
    total += k
    any_adj += k > 0
print(f"한 번 이상 붙은 판: {any_adj / trials:.4f}")
print(f"한 바퀴 평균 붙음: {total / trials:.4f}")
한 번 이상 붙은 판: 0.8739
한 바퀴 평균 붙음: 1.9999200,000번 섞어 센 값은 한 번 이상 붙은 판 87.4%, 한 바퀴 평균 1.9999번이다. 앞에서 정확하게 계산한 87.4%와 2번에 거의 그대로 맞는다. 곡 사이 한 자리의 확률은 작아도 그런 자리가 29개라, 진짜 무작위 셔플에서는 같은 가수가 한두 번 이어지는 바퀴가 가장 흔한 모습이다.
가수마다 곡 수로 짚는 짐작 표
내 재생 목록이 셔플에서 얼마나 붙을지는 가수마다 몇 곡씩 담았는지로 미리 짐작할 수 있다. 먼저 가수마다 몇 곡인지 세고, 그다음 가장 흔한 곡 수의 행을 아래 표에서 찾으면 된다. 아래 표는 30곡 기준이다.
| 가수마다 | 가수 수 | 한 바퀴 평균 붙음 | 한 번 이상 붙을 확률 |
|---|---|---|---|
| 1곡 | 30명 | 0번 | 0% |
| 2곡 | 15명 | 1번 | 63.8% |
| 3곡 | 10명 | 2번 | 87.4% |
| 5곡 | 6명 | 4번 | 98.6% |
| 6곡 | 5명 | 5번 | 99.6% |
| 10곡 | 3명 | 9번 | 99.9% 넘음 |
표는 가수마다 곡 수가 같은 목록에서 잰 값이다. 한 가수 곡이 유난히 많으면 표보다 많이 붙는다. 30곡 가운데 한 가수가 10곡을 차지하고 나머지 20곡을 모두 다른 가수가 한 곡씩 부른 목록이라면, 가장 흔한 곡 수는 1곡이지만 평균 붙음은 3번, 한 번 이상 붙을 확률은 98.8%다.
평균 칸에는 규칙이 하나 있다. 가수마다 곡이 n곡씩이면 한 바퀴 평균 붙음은 n − 1번이다. 목록이 N곡이면 어떤 곡 다음 곡이 같은 가수일 확률은 남은 N − 1곡 가운데 같은 가수 곡 n − 1곡이 차지하는 몫이고, 곡 사이 자리도 N − 1개다. 둘을 곱하면 N − 1이 지워져 n − 1만 남는다. 그래서 평균은 목록 길이와 상관이 없다. 가수당 3곡이면 6곡짜리 목록이든 90곡짜리 목록이든 평균은 2번이다.
확률 칸은 30곡에서 잰 값이라 다른 길이에는 그대로 옮기지 않는다. 다만 가수당 3곡인 경우는 따로 셌는데, 한 번 이상 붙을 확률이 6곡에서 90.0%, 90곡에서 86.8%로 거의 그대로였다. 표의 1곡 행처럼 가수마다 한 곡씩만 담으면 붙을 짝이 없으니 붙음도 0이다. 뒤집어 보면 가수마다 3곡씩인 목록에서 같은 가수가 한 번도 이어지지 않는 바퀴는, 우리가 센 6곡부터 90곡까지 여덟~열 바퀴에 한 번꼴이었다. 30곡 표에서 그런 바퀴는 가수마다 5곡이면 1.4%, 6곡이면 0.4%로 더 드물다.
30곡 중 10곡을 차지한 한 가수
이번에는 가수마다 곡 수가 다른 목록을 보자. 30곡 가운데 한 가수가 h곡을 차지하고, 나머지는 모두 다른 가수가 한 곡씩 부른 목록이다. 이 가수가 3곡이면 한 바퀴 평균 붙음은 0.2번이고, 한 번 이상 붙을 확률은 19.3%다. 5곡이면 평균 0.67번에 53.8%, 8곡이면 평균 1.87번에 91.6%로 오른다. 10곡이 되면 평균 3번, 한 번 이상 붙을 확률은 98.8%다.
곡 수가 고르지 않은 목록의 평균도 손으로 구할 수 있다. 가수마다 「곡 수 × (곡 수 − 1)」을 구해 모두 더하고, 전체 곡 수로 나누면 된다. 가수 10명이 3곡씩이면 가수마다 3 × 2 = 6이고, 열 명을 더하면 60이다. 이것을 30으로 나누면 앞에서 본 평균 2번이 나온다. 한 가수가 10곡이고 나머지가 한 곡씩이면 10 × 9 = 90이고, 한 곡짜리 가수는 1 × 0 = 0이라 보탤 것이 없다. 90을 30으로 나누면 평균 3번이다.
이 계산을 보면 한 가수의 곡 수가 붙음을 얼마나 키우는지 드러난다. 그 가수의 곡이 5곡에서 10곡으로 두 배가 되면, 「곡 수 × (곡 수 − 1)」은 20에서 90으로 네 배 넘게 커진다. 같은 30곡이라도 가수가 몇 명이냐보다 한 가수가 몇 곡을 차지했느냐가 붙음을 크게 바꾼다.
비슷한 구조를 생일에서 볼 수 있다. 한 반에 생일이 같은 두 사람이 있을 확률은, 내 생일과 같은 사람이 있을 확률보다 훨씬 크다. 앞의 것은 반 안의 아무 두 사람이든 맞으면 되고, 뒤의 것은 나라는 한 사람에 묶여 있기 때문이다. 앞의 확률을 묻는 이 문제를 생일 문제(birthday problem)라고 부른다.
Froelich 외(2009)는 아이팟(iPod) 셔플 논란을 이 구조로 계산했다. 3,000곡(앨범 250개 × 12곡)에서 작은 기기 아이팟 셔플(iPod Shuffle)에 넣을 120곡을 무작위로 골라 담을 때, 특정 앨범 하나에서 3곡 이상이 골라질 확률은 약 1%였다. 하지만 아무 앨범에서든 3곡 이상이 골라질 확률은 94.45%였다. 우리도 같은 조건을 다시 계산해 94.45%를 얻었다. 이 값은 순서에서 곡이 이어 나오는 붙음이 아니라, 120곡을 고를 때 한 앨범의 곡이 몰리는 일의 확률이다.
재생 목록의 붙음에서도 같은 구조가 보인다. 가수 10명이 3곡씩인 30곡에서, 미리 점찍은 가수 한 명의 곡이 어딘가에서 붙을 확률은 19.3%다. 그 가수의 세 곡이 놓인 자리만 따지면 되므로, 이 절 처음에 본 「한 가수가 3곡인 목록」과 같은 값이다. 열 명 가운데 아무 가수든 붙을 확률은 87.4%로 훨씬 크다. 같은 가수가 연달아 나오는 일은 특정 가수 한 명이 아니라 열 명 누구에게서든 생기면 되므로, 셈으로 보면 이만큼 흔하다.
동전·슛 수열 실험 속 사람의 무작위
셈으로는 흔한 일인데 왜 이상해 보일까. 재생 목록을 두고 사람의 느낌을 잰 연구는 찾지 못했다. 가장 가까운 근거는 동전 앞뒤 같은 두 기호의 수열과 농구 슛 수열로 한 실험들이다.
Falk와 Konold(1997)는 Falk(1975)의 자료 등을 다시 정리해, 사람이 어떤 수열을 가장 무작위답다고 보는지 살폈다. 기준은 수열이 얼마나 자주 바뀌느냐였다. 이웃한 두 기호가 서로 다른 자리를 「바뀐 자리」라고 하면, 진짜 무작위 수열은 열 자리 중 다섯 자리쯤에서 바뀐다. 그런데 사람들이 매긴 무작위다움 점수가 평균으로 가장 높았던 수열은 열 번 중 여섯 번 바뀌는 수열이었다. 여러 연구를 모은 표에서도 이 값은 대체로 비슷했다. 사람이 떠올리는 무작위는 실제보다 자주 바뀐다.
흑백 칸을 섞은 격자 그림에서도 같은 일이 있었다. 진짜 무작위만큼 바뀌는 격자가, 그보다 더 자주 바뀌는 격자보다 덜 무작위로 보였다. 논문은 그 까닭을 「the contiguous same-color zones that occur by chance make the grid appear too clustered to be random」이라고 적었다. 우연히 생긴 같은 색 덩어리 때문에 격자가 무작위라기엔 너무 뭉쳐 보인다는 말이다.
길로비치·발론·트버스키(Gilovich·Vallone·Tversky, 1985)는 코넬·스탠퍼드 대학의 농구 팬 100명에게 슛 성공과 실패를 적은 수열 여섯 개를 보여 주었다. 팬들은 수열마다 동전 던지기 같은 「우연」인지, 그보다 성공·실패가 길게 이어지는 「연속」인지, 짧게 갈마드는 「교대」인지 골랐다. 「우연」의 가장 좋은 예로 뽑힌 것은 열 번 중 일곱·여덟 번 바뀌는 수열이었다. 진짜 무작위에 맞는 열 번 중 다섯 번 바뀌는 수열은 32%만 「우연」으로 골랐고, 62%는 「연속」으로 분류했다.
동전은 앞일을 기억하지 않는데도, 방금 나온 쪽 다음엔 다른 쪽이 나올 차례라고 여기는 착각을 도박사의 오류(gambler’s fallacy)라고 한다. 스포티파이의 2014년 글도 앞의 사용자 불만을 이 오류로 설명했다. 다만 곡이 하나씩 빠지는 셔플은 동전과 사정이 조금 다르다.
30곡 가운데 가수 A의 곡은 3곡이라, 아무 자리 하나가 A일 몫은 10%다. 방금 A를 들었다면 남은 29곡 중 A는 2곡이라, 다음 곡이 A일 확률은 약 6.9%로 실제로 조금 준다. 그래서 「다음은 다른 가수겠지」라는 짐작은 방향만큼은 맞는다. 놓치는 것은 크기다. 6.9%는 0이 아니고, 이런 자리가 한 바퀴에 29개나 있다.
셔플을 의심하는 마음은 이렇게 두 갈래로 나뉜다. 같은 가수가 또 나왔으니 셔플이 고장 났다고 느끼는 것은 무작위 속 덩어리를 규칙으로 읽는 쪽이다. 방금 그 가수가 나왔으니 다음은 다른 가수일 차례라고 여기는 것은 도박사의 오류 쪽이다.
무작위에서 덩어리를 보는 일을 차트에서 다룬 글이 이 블로그의 동전 던지기 차트 편이다. 거기서는 동전 무작위가 그린 차트에서 추세·박스권 같은 무늬가 보였고, 여기서는 무작위 재생 순서에서 같은 가수 덩어리가 보인다. 동전·슛 수열 실험에서 사람은 무작위를 실제보다 자주 바뀌는 순서로 떠올렸고, 그 눈으로 보면 제대로 섞인 재생 목록도 덜 섞인 것처럼 보이기 쉽다.
2005년 손잡이에서 2025년 반복 줄이기까지
2005년 9월 7일 애플(Apple) 보도자료의 아이튠즈(iTunes) 5 기능 목록에는 스마트 셔플(Smart Shuffle)이 들어 있다. 보도자료는 이 기능을 「Smart Shuffle, which lets the user change the “randomness” of shuffled songs」라고 소개했다. 셔플한 곡의 「무작위성」을 사용자가 바꿀 수 있게 했다는 말이다. 스티븐 레비(Steven Levy)의 책 『The Perfect Thing』(2006)에 따르면, 이 기능은 막대를 오른쪽으로 당기면 같은 가수의 곡 사이를 일부러 띄우고, 왼쪽으로 당기면 오히려 같은 가수 곡을 몰아 준다.
레비는 아이팟 셔플에 넣을 곡을 무작위로 골라 담는 기능을 여러 번 돌려 보고, 돌릴 때마다 몇몇 가수가 유난히 많이 담긴다며 애플에 까닭을 물었다. 아이팟 마케팅 이사 그레그 조스위악(Greg Joswiak)은 「I’ve checked with the engineers again, and it’s essentially random.」이라고 답한다. 엔지니어들에게 다시 확인했고, 곡을 고르는 방식이 사실상 무작위라는 것이다. 레비는 손잡이를 내놓은 날의 발표에서 스티브 잡스(Steve Jobs)가 이렇게 말했다고 적었다.
We’re making it less random to make it feel more random.
더 무작위로 느껴지게 하려고, 덜 무작위로 만들고 있다.
Steve Jobs — Steven Levy, 『The Perfect Thing』(2006)이 옮긴 말스포티파이는 8년 남짓 뒤인 2014년 2월 28일, Lukáš Poláček이 쓴 블로그 글 「How to shuffle songs?」에서 셔플을 바꿨다고 밝혔다. 새 셔플은 가수마다 그 가수의 곡을 목록 전체에 되도록 고르게 퍼뜨리고, 모든 곡을 그 위치 순서로 모은다. 그래서 같은 가수 곡이 서로 떨어진다. 한 가수 곡이 4곡이면 대략 목록 길이의 25%마다 오게 하되, 간격을 20~30% 사이에서 조금씩 흔든다.
스포티파이의 글은 이 방식이 점을 고르게 흩어 찍어 중간 밝기를 내는 인쇄·화면 기법에서 착안했다고 설명한다. 같은 글은 Martin Fiedler가 2007년 블로그에 쓴 방식을 찾아 고쳐 썼다고도 밝힌다. 새 셔플은 당시 데스크톱 앱에 먼저 들어갔다. 이 글에서는 이 방식을 「고르게 퍼뜨리기」라고 부른다.
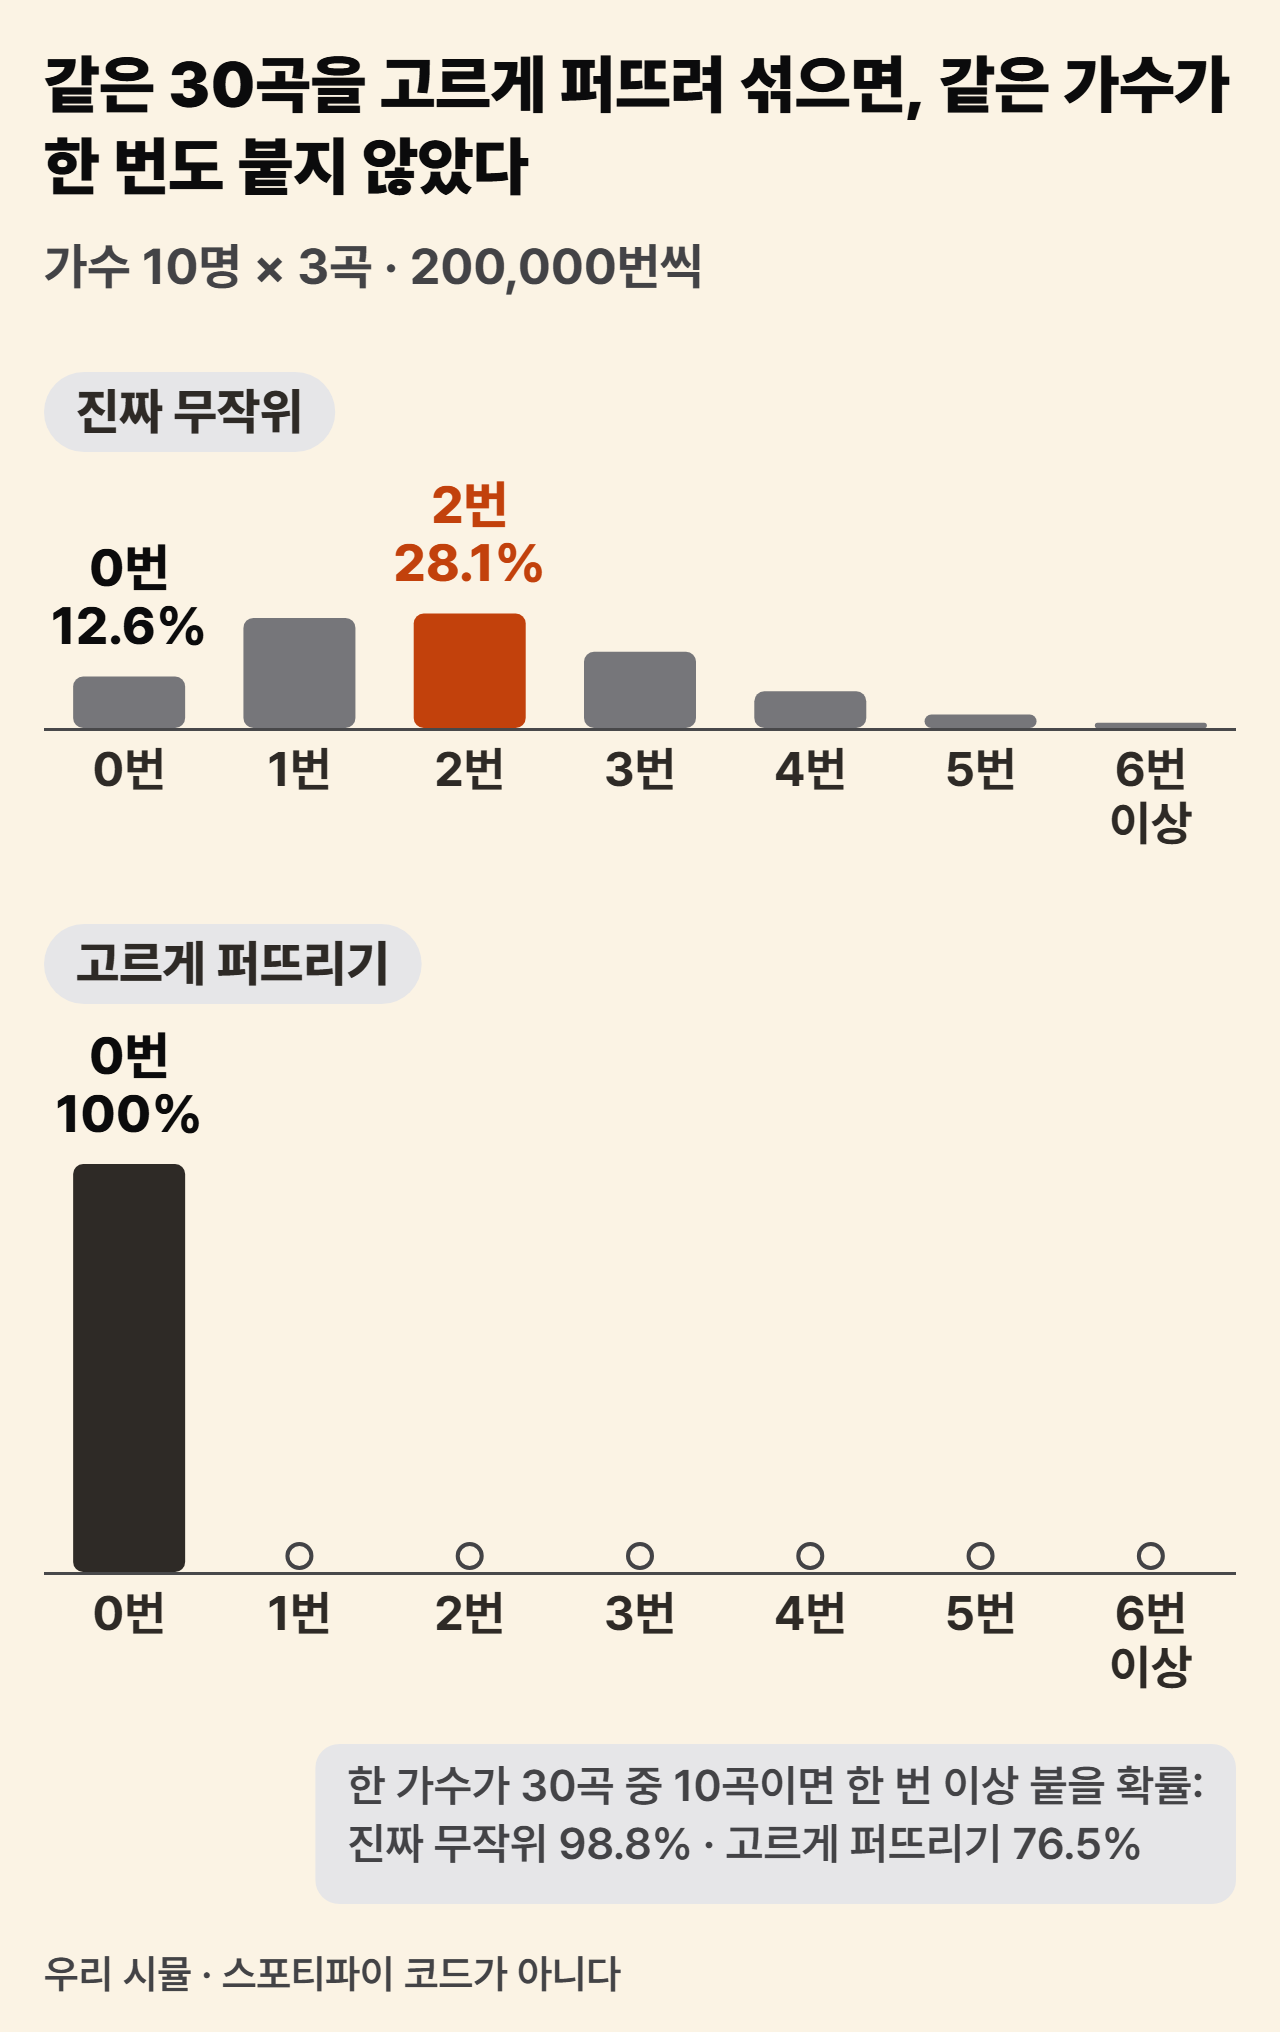
스포티파이 글이 설명한 방식을 우리가 해석해 200,000번 돌려 보았다. 가수마다 곡을 고르게 퍼뜨리되 시작 위치와 간격을 조금씩 무작위로 흔든 것이고, 스포티파이의 실제 코드는 아니다. 가수 10명이 3곡씩 부른 30곡에서는 200,000판 모두 같은 가수가 한 번도 붙지 않았다(그림 2). 같은 30곡을 진짜 무작위로 섞으면 87.4%의 판에서 한 번 이상 붙는다. 하지만 한 가수가 30곡 중 10곡을 차지하면, 고르게 퍼뜨려 섞어도 76.5%의 판에서 붙음이 남았다. 진짜 무작위로 섞었을 때의 98.8%보다는 적지만, 고르게 퍼뜨린다고 붙음이 늘 사라지는 것은 아니다.
같은 「섞기」라도 방향이 반대인 이야기가 이 블로그의 카지노 셔플 기계 편이다. 거기서는 기계가 덜 섞어 도박꾼이 다음 카드를 맞혔다. 여기서는 다 섞인 순서를 사람이 덜 섞였다고 느낀다.
스포티파이는 2025년 11월 13일 엔지니어링 블로그 글에서 셔플을 다시 설명했다. 그 글은 「For the last 5 years, Spotify’s Shuffle was exactly that – random.」이라고 적는다. 지난 5년 동안 스포티파이의 셔플은 말 그대로 무작위였다는 것이다. 2014년 방식을 언제, 왜 그만뒀는지는 그 글에 없다.
같은 날 스포티파이는 유료 요금제인 프리미엄(Premium) 사용자의 기본 셔플을 「반복 줄이기」로 바꿨다고 밝혔다. 무작위 순서를 여러 개 만든 뒤, 최근에 들은 곡이 앞쪽에 덜 오는 순서를 골라 트는 방식이다. 겨냥하는 것은 같은 가수가 아니라 최근에 들은 곡이다. 그 글이 「The task wasn’t to make Shuffle less random, but to make it feel more fair and more fresh.」라고 쓴 것은, 어떤 곡이나 가수가 자꾸 다시 나온다는 사용자 불만을 두고 한 말이다. 불만에는 가수도 들어 있었지만, 그 글이 내놓은 답은 최근에 들은 곡을 뒤로 미루는 쪽이었다.
세 번의 선택은 모두 「모든 순서가 같은 확률」이라는 섞기에서 얼마나 물러설지를 정한 일로 읽힌다. 애플은 물러설지 말지를 사용자에게 맡겼다. 2014년의 스포티파이는 같은 가수 곡을 떨어뜨리는 쪽으로 물러섰고, 2025년의 스포티파이는 최근 들은 곡만 뒤로 미룬다. 모든 순서가 같은 확률인 섞기에서는 붙은 순서도 똑같이 나올 수 있다. 같은 가수 곡이 여럿 든 목록에서 붙음을 없앤 셔플은, 모든 순서를 같은 확률로 고르지 않는다.
더 읽기
- Lukáš Poláček, 「How to shuffle songs?」, Spotify Labs 블로그(2014-02-28) — 웹 아카이브 보관본 https://web.archive.org/web/20140310223519/http://labs.spotify.com:80/2014/02/28/how-to-shuffle-songs/
- Ludvig Borgne, Chidem Sahiner, 「Shuffle: Making Random Feel More Human」, Spotify Engineering(2025-11-13) — https://engineering.atspotify.com/2025/11/shuffle-making-random-feel-more-human
- Amy G. Froelich, William M. Duckworth, Jessica Culhane, 「Does Your iPod Really Play Favorites?」, The American Statistician 63(3), 263–268(2009) — https://doi.org/10.1198/tast.2009.07073
- Ruma Falk, Clifford Konold, 「Making Sense of Randomness: Implicit Encoding as a Basis for Judgment」, Psychological Review 104(2), 301–318(1997) — https://srri.umass.edu/sites/srri/files/FalkKonold1997/index.pdf