영어 메일이나 보고서에서 delve(파고들다)라는 낱말을 보고 AI 가 썼나 싶었던 경험은 낯설지 않다. 영어 의학 논문 초록에서 이 낱말은 2020년과 2024년 초 사이에 15배 가까이 늘었다. 연구자들이 원인을 하나씩 따져 보니 학습 데이터에서는 증거를 찾지 못했다. 모델을 대화용으로 다듬는 단계가 원인 후보로 남았다. 같은 내용의 글 두 편 중 delve 같은 낱말을 넣어 쓴 쪽과 막아 쓴 쪽을 사람에게 직접 고르게 한 실험은 결론이 나지 않았다. 이렇게 모델이 어떤 낱말을 사람 글보다 유난히 자주 쓰는 일을 논문은 lexical overrepresentation 이라고 부른다.
영어 초록에서 delve 가 15배 가까이 늘었다
영어 의학 논문 초록에서 delve 라는 철자는 2020년에 백만 낱말당 0.58번 나왔다. 2024년(5월까지)에는 같은 잣대로 8.50번 나왔다. 몇 해 사이에 15배 가까이 늘어난 셈이다. 이 숫자는 의학 논문 데이터베이스 PubMed 에 실린 초록 2,670만 편을 센 연구의 표에서 왔다.
delve 는 「파고들다」라는 뜻의 영어 동사다. 챗봇에게 영어로 무언가를 물었는데 답이 「Let’s delve into …」로 시작하면, 이게 AI 말투인가 싶은 생각이 들 수 있다. 영어 메일이나 보고서에서 같은 표현을 만나도 비슷하다. 그 인상이 맞는지, 맞다면 왜인지는 느낌만으로는 알 수 없다. 논문 초록의 숫자는 적어도 한 곳에서 이 낱말이 실제로 크게 늘었음을 보여 준다.
이 글이 다루는 연구는 모두 영어 글을 센 것이고, 대부분은 과학 논문 초록이다. 한국어 챗봇의 말버릇은 이 연구들의 범위 밖이라 다루지 않는다. 한 낱말이 몇 해 만에 15배 가까이 늘었고, 연구자들은 그 낱말이 어디서 왔는지를 물었다. 이 글은 그 물음에 답하려 한 연구들을 차례로 따라간다. 따져 볼 원인 후보는 셋이다. 모델이 배운 학습 데이터, 모델의 구조와 알고리즘, 그리고 모델을 대화용으로 다듬는 단계다.
ChatGPT 는 왜 delve 를 쓸까 — 말버릇 낱말을 고르는 법
까닭을 묻기 전에 먼저 정할 것이 있다. 어떤 낱말이 AI 때문에 늘었는지를 어떻게 고르느냐다. 미국 플로리다 주립대의 Juzek 과 Ward 는 2025년 학회 논문에서 두 목록의 겹침으로 이 낱말들을 골랐다.
첫째 목록은 사람이 쓴 초록에서 왔다. 2020년과 2024년의 PubMed 초록을 견주면, 뚜렷이 늘어난 낱말이 약 7,300개 나온다. 두 저자는 이 목록을 따로 훑으면서 연도 숫자 같은 것과, 과학의 진전이나 세상일로 설명되는 급증어를 뺐다. 의견이 갈리면 넣는 쪽을 택했고, 설명되지 않는 급증어가 50줄 모이자 거기서 멈췄다. 여기서 한 줄은 활용형 하나를 뜻한다.
둘째 목록은 AI 가 쓴 초록에서 왔다. 2020년 초록 1만 편을 AI 에게 몇 문장으로 요약하게 한 뒤, 그 요약만 보고 200단어쯤 되는 초록을 새로 쓰게 했다. 이렇게 나온 AI 초록 9,953편에서 원래 사람 초록보다 뚜렷이 많이 쓰인 낱말을 모았다.
두 목록에 모두 든 것이 21줄이다. 21개 낱말이 아니라 21줄이라고 쓰는 데는 까닭이 있다. 논문은 활용형을 따로 세서, delve·delves·delved·delving 이 각각 한 줄을 차지한다. 거꾸로 첫째 목록의 50줄 가운데 29줄은 둘째 목록에 들지 못했다. meticulously·commendable 처럼 AI 말투로 자주 거론되는 낱말도 그 29줄에 있다. 그러니 21줄은 ChatGPT 말버릇 전체가 아니라, 이 절차로 고른 낱말이다.
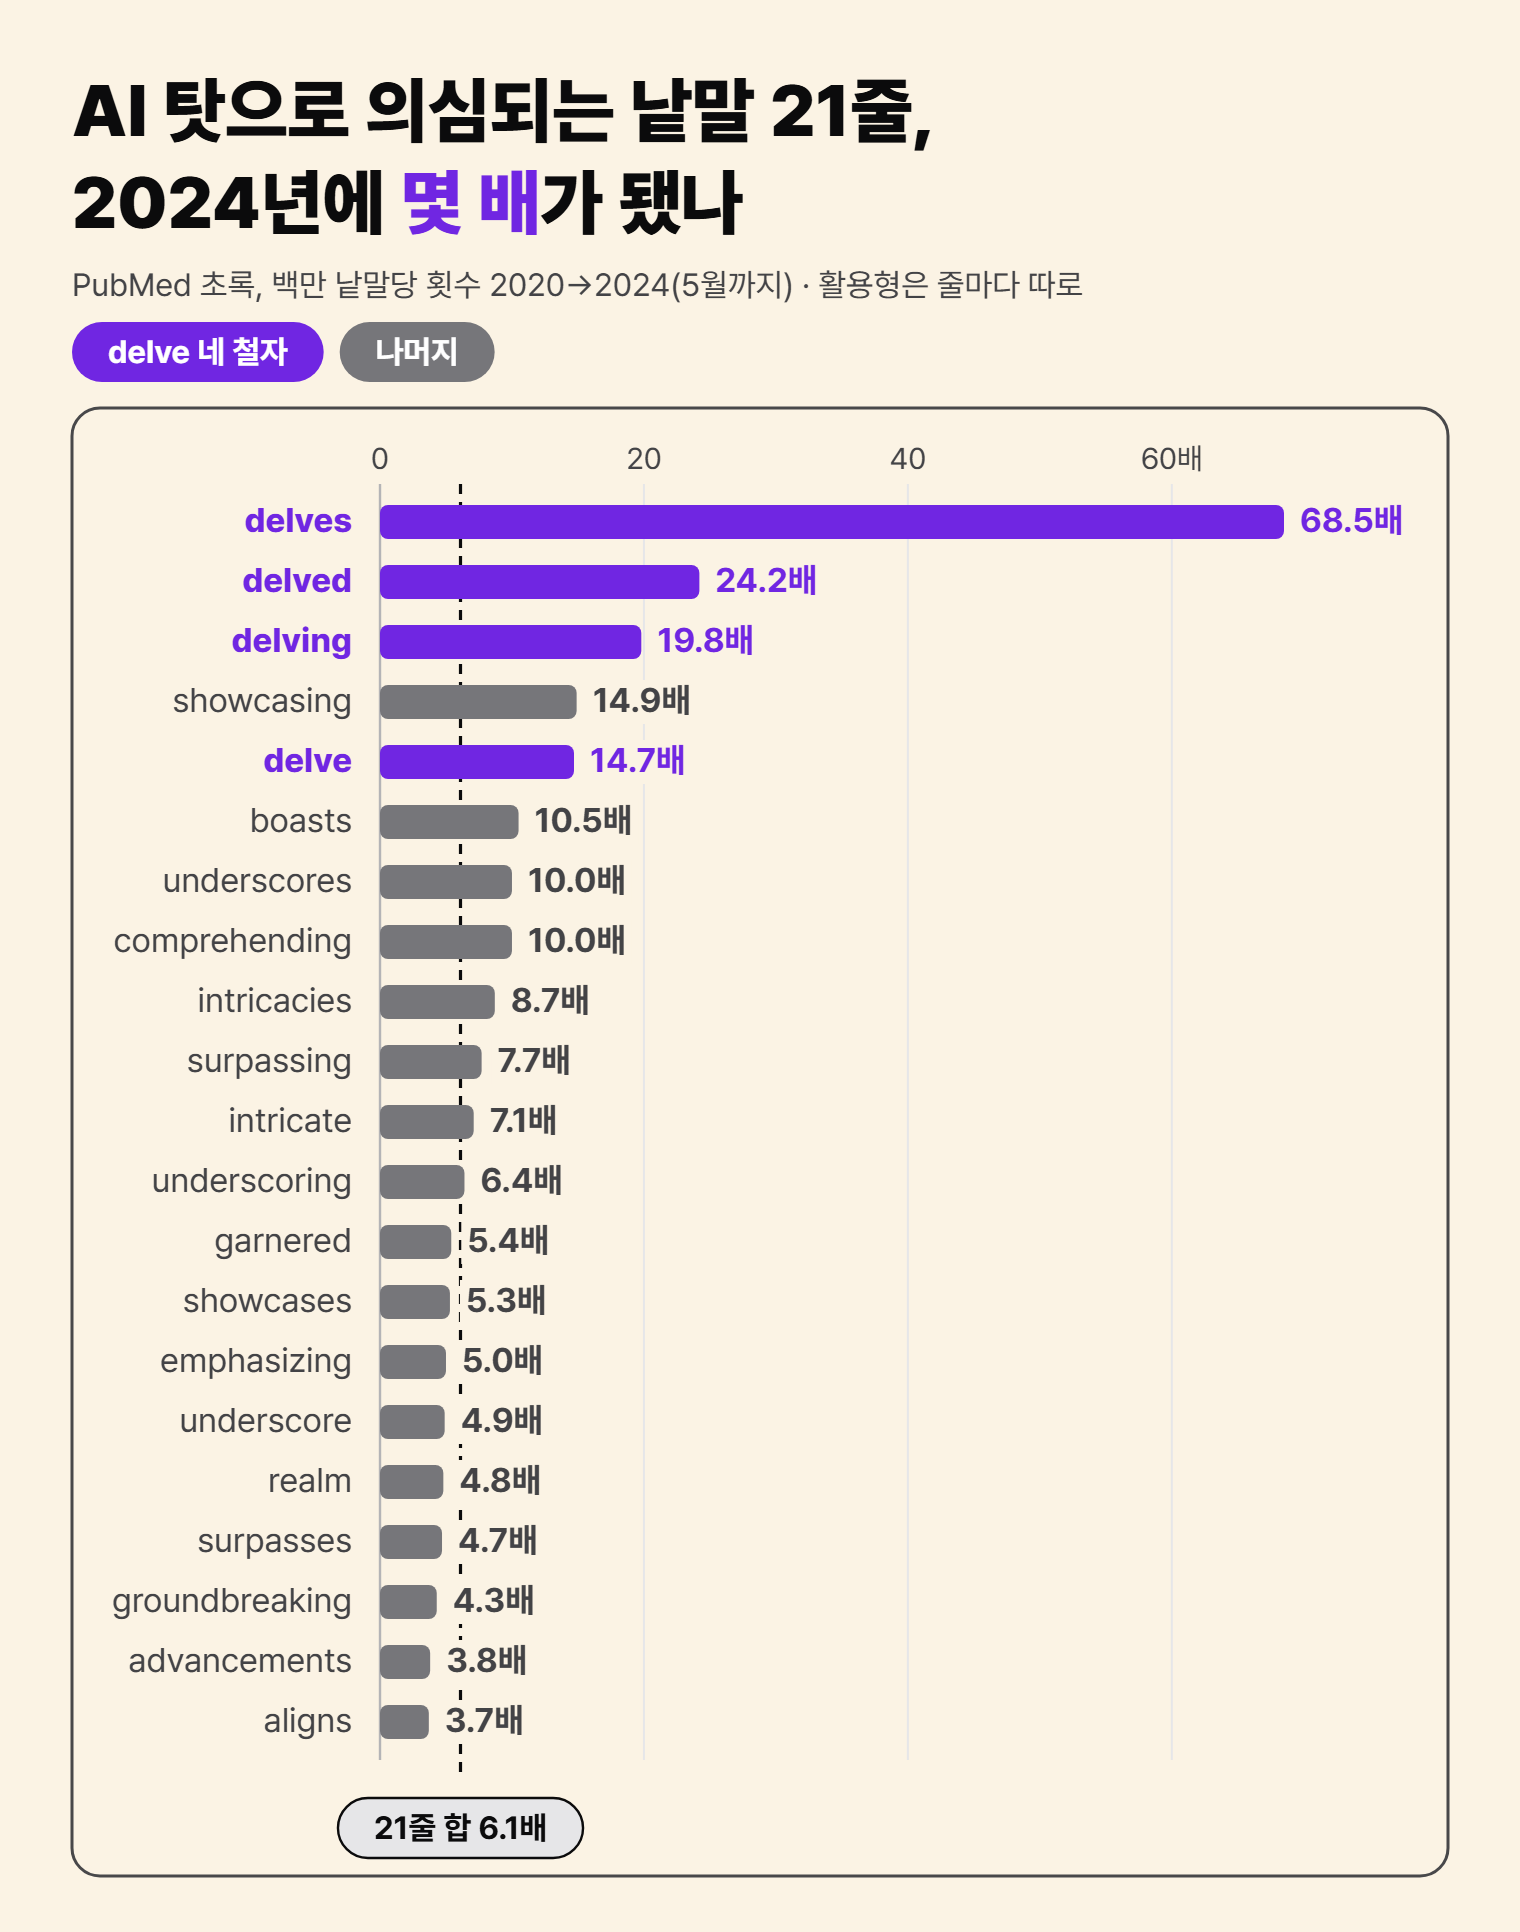
그림 1 에서 보듯 21줄은 모두 늘었지만 폭은 제각각이다. 가장 많이 는 delves 는 68.5배이고, 가장 적게 는 aligns 는 3.7배다. 21줄을 합쳐 세면 6.1배인데, delve 네 철자는 모두 그보다 훨씬 위에 있다. 논문은 이렇게 모델이 어떤 낱말을 사람 글보다 유난히 자주 쓰는 일을 lexical overrepresentation 이라고 부르고, 그 까닭을 묻는다.
연구의 결과를 먼저 적어 두면 이렇다. 학습 데이터에서는 증거를 찾지 못했고, 모델의 구조나 알고리즘에서도 증거를 찾지 못했다. 남은 것은 모델을 대화용으로 다듬는 단계다. 사람에게 두 글 중 하나를 직접 고르게 한 마지막 실험은 결론이 나지 않았다.
이 글은 그 다듬는 단계를 튜닝이라 부른다. 미세 조정(파인튜닝)과 인간 피드백 기반 강화학습(RLHF)을 합친 이름이다. 미세 조정은 많은 글로 다음 낱말 맞히기를 배운 모델에게 대화 예시를 보여 주며 더 가르치는 일이다. 인간 피드백 기반 강화학습은 이름대로 사람의 판단을 쓴다. 사람이 여러 답을 비교해 매긴 평가를 보고, 모델이 높은 평가를 받는 쪽으로 배우게 하는 일이다. 이렇게 사람 손을 거쳐 모델을 다듬는 단계는 맞장구치는 챗봇의 버릇을 다룬 글에서도 원인 후보로 나왔다.
We fail to find evidence that lexical overrepresentation is caused by model architecture, algorithm choices, or training data.
특정 낱말이 넘쳐 나는 일이 모델 구조나 알고리즘 선택, 학습 데이터 때문이라는 증거를 찾지 못했다.
Juzek & Ward, COLING 2025저자들이 고른 말은 「증거를 찾지 못했다」이지 「원인이 아님을 밝혔다」가 아니다. 논문 끝에서 저자들은, 이렇게 증거가 나오지 않았어도 모델 설계와 학습 데이터가 모델의 낱말 고르기에 영향을 준다고 의심한다고 덧붙였다. 증거를 찾지 못했다는 말과 원인이 아니라는 말은 다르다. 이 글이 따라갈 것도 원인을 찾아낸 이야기가 아니라, 원인 후보가 좁혀진 이야기다.
원인 후보 하나 — 학습 데이터에서는 증거가 나오지 않았다
가장 먼저 떠오르는 설명은 학습 데이터다. ChatGPT 가 배운 글에 원래 delve 가 많았다면, 모델은 그 빈도를 따라 쓸 뿐이다. 그런데 그 데이터는 공개되지 않았고, 저자들도 ChatGPT 같은 챗봇의 바탕이 되는 대규모 언어 모델(LLM)이 정확히 무엇으로 학습했는지 알지 못한다고 적었다.
그래서 저자들은 비슷한 글 묶음 넷과 견주었다. arXiv 논문 초록, 뉴스 중심의 영어 말뭉치, PubMed 초록, 위키백과다. arXiv 는 연구자가 심사 전 논문 원고를 올려 두는 공개 사이트다. 논문 표에서 다시 세어 보면, 21줄 가운데 17줄은 AI 초록에서 네 말뭉치 어느 것보다 자주 나왔다. 못 넘은 4줄은 boasts·realm·surpasses·surpassing 이다.
다른 설명도 돌았다. 나이지리아 비즈니스 영어에는 delve 가 흔한데, AI 학습 작업을 맡은 그곳 노동자들이 예시 답에 이 낱말을 써서 AI 가 닮았다는 것이다. 이 설명은 영국 일간지 가디언(Guardian)의 기술 뉴스레터 칼럼(2024년 4월 16일)에서 나왔다. 연구 결과는 아니다. 저자들은 나라별 영어 말뭉치에서 21줄이 어느 한 나라 영어에 몰려 있는지 보았고, 그런 증거를 찾지 못했다. 평가자의 국적을 조사한 것은 아니다.
학습 데이터 쪽에서는 이렇게 증거가 나오지 않았다. 다만 견준 것은 실제 학습 데이터가 아니라 그 자리를 대신한 말뭉치다. 그래서 학습 데이터는 원인 후보에서 지워지지 않는다.
원인 후보 둘과 셋 — 튜닝 전과 후를 한 쌍으로 견주었다
다음 후보는 모델의 구조와 알고리즘이다. 이것을 가르려면 다른 점이 거의 튜닝뿐인 모델 한 쌍이 필요한데, ChatGPT 는 그렇게 들여다볼 수 없다. 저자들은 대신 메타(Meta)의 공개 모델 Llama 2-7B 의 두 판을 골랐다. 튜닝 전의 base 판과 튜닝 뒤의 chat 판으로, 구조와 여러 알고리즘은 같게 두었고 가장 큰 차이가 튜닝이다.
두 판에 사람 초록 1만 편과 AI 초록 9,953편을 넣고, 다음 낱말 예측이 퍼진 정도(엔트로피)를 쟀다. 엔트로피는 모델이 다음 낱말 후보들에 확률을 고르게 나눠 줄수록 크고, 한 낱말에 몰아줄수록 작다. 튜닝 전에는 사람 초록 1.616, AI 초록 1.633 으로 거의 같았다. 튜닝 뒤에는 1.051 과 0.886 으로 벌어졌다(그림 2). 튜닝은 사람 초록의 값도 35.0% 낮췄지만, AI 초록의 값은 그보다 많은 45.7% 낮췄다.

튜닝 뒤 벌어진 그 차이가 뜻하는 바는 이렇다. 튜닝 전 모델은 사람 글에서도 AI 글에서도 다음 낱말 후보에 확률을 비슷하게 퍼뜨렸다. 튜닝 뒤 모델은 21줄의 낱말이 넘쳐 나는 AI 글에서 그 확률을 한 낱말 쪽에 더 몰아줬다. 튜닝이 모델의 말투를 AI 글 쪽으로 옮겨 놓았을 가능성에 부합하는 결과다. 저자들도 구조와 여러 알고리즘은 두 판이 같으니 주된 원인이 아닐 것이라고 보았다. 대신 달라진 미세 조정과 인간 피드백 기반 강화학습을 중요한 원인 후보로 꼽았다.
한계도 분명하다. 대상이 ChatGPT 가 아니라 Llama 다. 저자들도 이 차이가 21줄 때문인지, AI 글의 다른 특징 때문인지는 단정하지 못한다고 적었다. 이 비교로는 미세 조정과 인간 피드백 기반 강화학습 중 어느 쪽이 작용했는지도 가를 수 없다. 그래서 저자들의 판단은 「원인이다」가 아니라 「부합한다」에 머문다.
마지막 증거 — 사람에게 고르게 했다, 우리가 다시 세어 보니
이 절의 비율은 저자들이 공개한 저장소의 선택 기록 파일(1,822건, 문항 60개)을 이 글이 다시 센 값이다. 비율과 검정 값은 논문과 일치했고, 논문이 붙인 모형 이름만 실제 계산과 달랐다.
튜닝 속 사람 평가가 원인이라면, 평가자들은 delve 같은 낱말이 든 답을 더 좋게 매겼을 것이다. 실제 평가자 정보는 공개돼 있지 않아서, 저자들은 대신 인도에 사는 참가자 201명을 온라인으로 모집해 이 짐작을 시험했다. 제외 기준을 거쳐 공개 파일에 남은 사람은 126명이다.
참가자는 내용이 같은 초록 두 편 중 마음에 드는 쪽을 골랐다. 한 편은 21줄 가운데 무작위로 고른 4개를 넣으라고 시켜 쓴 판, 다른 편은 21줄의 낱말을 막아 쓴 판이다. 두 편 모두 낱말을 막아 쓴 방해 쌍도 섞여 있었는데, 여기서 한쪽을 고른 비율은 49.9%로 동전 던지기와 같았다. 이 값이 견줄 기준선이 된다.
계획했던 핵심 30문항 통합 비교에서는 저자들의 기대와 달리 낱말 없는 쪽이 조금 더 뽑혔다(53.4%). 그러나 그 차이는 우연으로 보기 어려운지를 가르는 기준을 넘지 못했다. 저자들은 초록을 만들다가 낱말을 넣은 판의 첫 문장에 delve 형태가 많이 든 것을 알아채고 문항을 둘로 나눴다. 계획에 없던 탐색 분석이다.
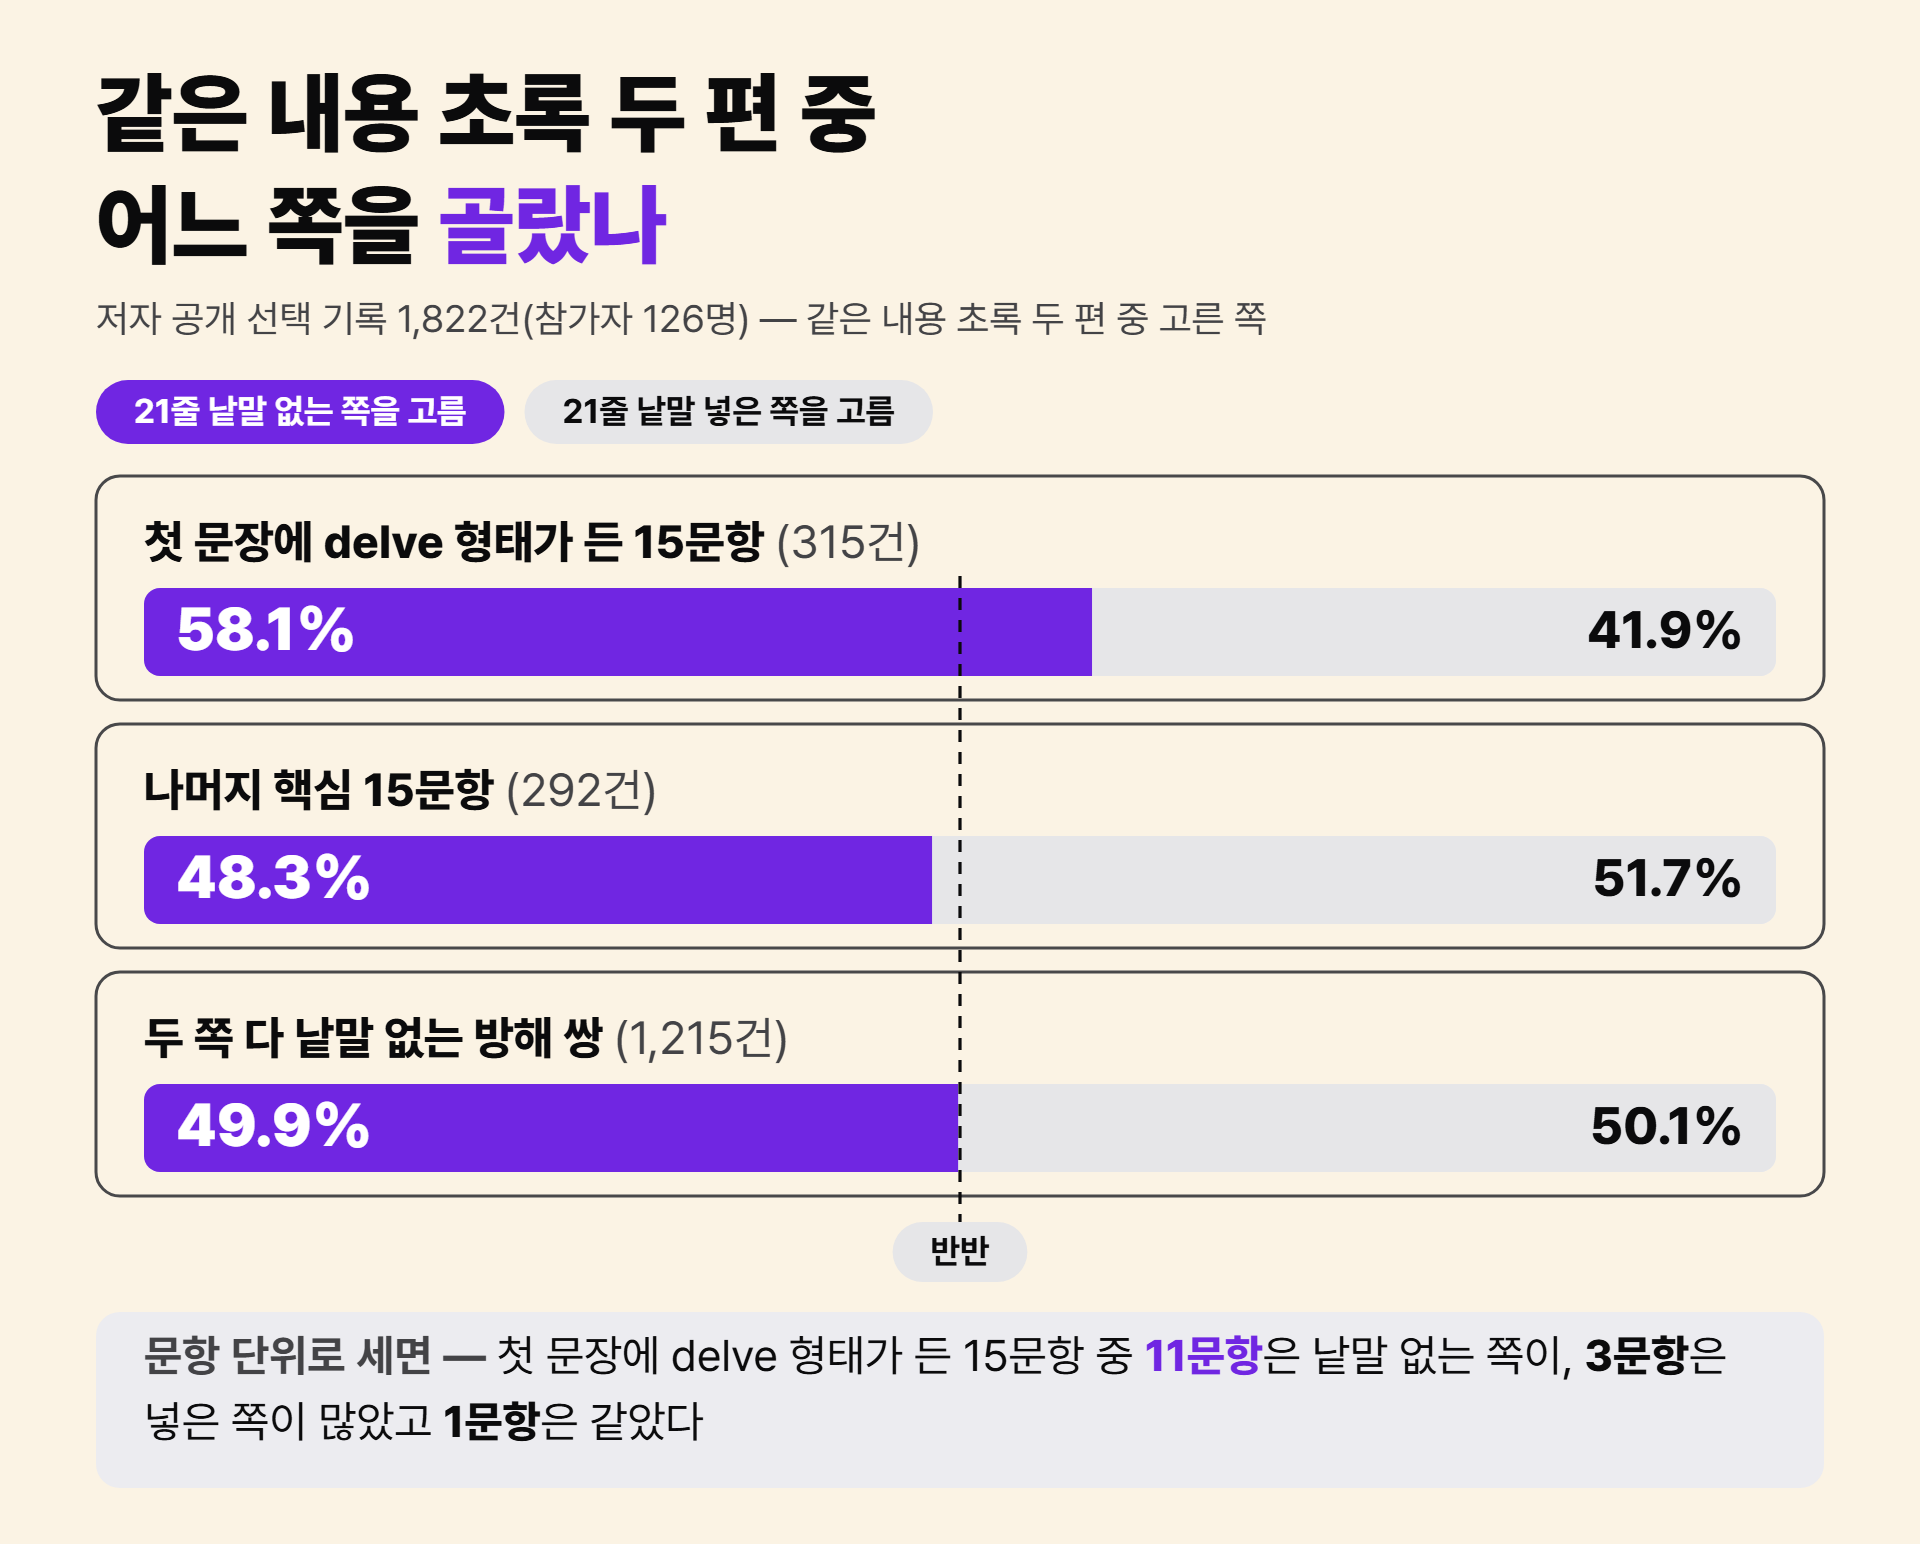
첫 문장에 delve 형태가 든 15문항에서는 58.1%(315건 중 183건)가 낱말 없는 쪽을 골랐다. 나머지 15문항은 48.3% 였다(그림 3). 방해 쌍보다 8.2%포인트 높다. 다만 낱말을 넣은 판에는 21줄의 낱말 여럿이 들어 있어, delve 하나의 효과인지는 가를 수 없다.
저자들이 문항을 묶어 따로 돌린 분석에서는 delve 문항의 차이가 그 기준을 넘었다. 이 글이 문항 단위로 다시 세면 15문항 중 11개는 낱말 없는 쪽이, 3개는 반대쪽이 많았고 1개는 같았다. 같은 자료를 두 방식으로 세어 결과가 갈리고, 이쪽은 그 기준에 겨우 못 미치는 경계선이다.
저자들은 이 실험을 스스로 「결론 불충분(inconclusive)」이라 불렀다. 참가자들이 delve 에 민감했을 수 있다는 설명은 저자들의 추측이고, 큰 표본으로 다시 확인하자고 했다. 그러니 「사람들은 delve 를 싫어한다」로 넓힐 수는 없다.
지목된 뒤 arXiv 초록에서 delve 가 줄었다
2024년 3월 말, AI 인플루언서 Jeremy Nguyen 이 ChatGPT 가 답에 delve 를 즐겨 쓴다고 짚었다. 앞의 가디언 칼럼이 이 일을 적었고, delve 를 한 번 썼다고 AI 가 썼다는 증거가 되지는 않는다는 말도 함께 남겼다. 이 낱말이 공개적으로 지목된 셈이다.
그 뒤의 흐름은 Geng 과 Trotta 가 살폈다. 두 사람은 2018년부터 2024년까지 arXiv 에 올라온 논문 초록 129만여 편에서 낱말 빈도를 달마다 셌다. 저자들에 따르면 delve 는 2024년 1~3월에 가장 많이 쓰였다. 그리고 2024년 3~4월이 지나면서 줄기 시작했다. 반면 significant 처럼 ChatGPT 가 즐겨 쓴다고 알려진 다른 낱말은 계속 늘었다.
왜 줄었는지에 대해서는 설명이 둘 있다. Geng 과 Trotta 는 이 낱말들이 LLM 때문에 나쁜 평판을 얻었을 수 있고, 그래서 많은 연구자가 초록을 서둘러 고쳤을 것이라고 보았다. 새 모델이 원인이었다면 감소가 더 늦게 왔으리라는 것이 그 근거다.
arXiv 의 AI 논문을 분기마다 정리하는 보고서에서 Leiter 외 연구진은 다른 설명을 냈다. 2024년 5월 GPT-4o 같은 새 모델이 다른 어휘를 쓰기 때문일 수도 있다는 것이다. 다만 「아마도(perhaps)」라는 단서를 달았고, 인과관계는 시험하지 않았다고 적었다.
두 설명 모두 직접 시험해 본 결과가 아니다. 줄어든 것은 arXiv 초록 텍스트이고, 그 글을 사람이 썼는지 AI 가 썼는지 섞였는지는 논문이 알 수 없다. 글 한 편을 두고 AI 가 썼는지를 가리는 일은 또 다른 문제다. 그 어려움은 AI 탐지기가 사람 글을 AI 글로 찍는 일에서 다뤘다.
한편 Kousha 와 Thelwall 은 학술 데이터베이스 여섯 곳에서 delve 네 철자를 묶어 찾아, 2022년에서 2024년 사이 1,500% 늘었다고 보고했다. 이 값은 데이터베이스를 통틀어 요약한 것이고, 본문 값은 데이터베이스마다 다르다. 예컨대 Dimensions 에서는 약 9배였다. 세는 단위도 delve 활용형이 든 논문의 비율이라, 앞의 백만 낱말당 횟수와 같은 양이 아니다.
이 증가가 앞에서 본 감소와 모순은 아니다. 감소는 2024년 1~3월의 정점 뒤에 시작됐는데, 2024년 한 해를 통째로 세면 그 정점이 들어 있어 2022년보다 훨씬 클 수 있다. 다만 이 연결은 이 글의 해석이고, 두 논문이 직접 맞대 본 것은 아니다. 지목된 뒤 이 낱말은 줄었지만, 왜 줄었는지를 두고는 두 설명이 아직 다 남아 있다.
delve 같은 낱말은 AI 가 섞인 정도를 재는 눈금이 된다
delve 처럼 넘치는 낱말들의 빈도는 AI 가 학술 글쓰기에 얼마나 섞였는지를 재는 눈금이 된다. Kobak 외 연구진은 2010년부터 2024년까지 PubMed 초록 1,500만 편 이상에서 갑자기 넘친 낱말 수백 개를 묶어 세었다. 그 결과 2024년 초록의 최소 13.5% 가 LLM 을 거쳤다고 추정했다. 이 값은 하한이다. 분야·나라·학술지마다 달라서, 일부 묶음에서는 40% 에 이르렀다(Science Advances, 2025). 저자들은 그 흔적이 코로나19 대유행 같은 큰 사건이 생의학 논문 글쓰기에 남긴 흔적보다 크다고 보았다.
다만 이 눈금은 초록 전체에서 낱말이 넘친 정도로 재는 것이어서, 초록 한 편이 AI 를 거쳤는지는 알려 주지 않는다. 눈금 자체도 움직인다. 앞 절에서 본 것처럼, 낱말이 지목되자 arXiv 초록에서 그 빈도가 줄었다. 사람들이 고쳐 쓰든 모델이 바뀌든, 한 낱말에 기댄 눈금은 지목된 뒤 흔들릴 수 있다.
빈도를 세는 일은 의심할 낱말을 고르는 데서 시작했다. PubMed 초록에서 백만 낱말당 0.58번이던 delve 는 2024년(5월까지) 8.50번까지 늘었다. 그 낱말이 지목된 2024년 3~4월을 지나며 arXiv 초록에서는 줄기 시작했다.
더 읽기
- Tom S. Juzek, Zina B. Ward, 「Why Does ChatGPT "Delve" So Much? Exploring the Sources of Lexical Overrepresentation in Large Language Models」, COLING 2025 — https://aclanthology.org/2025.coling-main.426/ · 저자 공개 저장소 https://github.com/tjuzek/delve
- Mingmeng Geng, Roberto Trotta, 「Human-LLM Coevolution: Evidence from Academic Writing」, arXiv:2502.09606 — https://arxiv.org/abs/2502.09606
- Dmitry Kobak 외, 「Delving into LLM-assisted writing in biomedical publications through excess vocabulary」, Science Advances 2025 — https://arxiv.org/abs/2406.07016