직접 쓴 리포트를 AI 글 탐지기에 넣었더니 「AI 98%」라는 판정이 돌아온다. 2023년 봄에 스탠퍼드 연구진이 탐지기 일곱 개에 영어가 모국어가 아닌 학생들의 에세이 91편을 넣어 보니, 일곱 개가 사람이 쓴 그 글을 AI 글로 찍은 비율이 평균 61%였다. 같은 탐지기가 미국 중학생 글에는 5%였다 — 글쓴이보다 글의 뻔함이 판정을 갈랐다. 이렇게 사람이 쓴 글을 AI 글로 잘못 찍는 것을 오탐(false positive)이라고 한다.
「내 리포트가 AI 98%」 — AI 탐지기 7종에 넣어 본 두 집단

직접 쓴 리포트인데 탐지기 화면에는 「AI 98%」가 떠 있다고 해 보자. 난감한 것은 그다음이다. 무엇을 보고 그렇게 판정했는지는 화면에 적혀 있지 않고, 아니라고 말할 근거도 거기서는 나오지 않는다. 숫자 옆에 이유가 붙어 있지 않으니, 반박하려면 글을 쓴 과정을 스스로 증명하는 수밖에 없다. 글을 낸 쪽도 받은 쪽도 그 숫자 하나만 들고 마주 앉게 된다.
이 장면이 실제로 어떻게 갈리는지를 2023년 봄에 시험한 연구가 있다. 스탠퍼드 연구진이 그때 널리 쓰이던 AI 글 탐지기 일곱 개를 모아, 2023년 3월 15일에 사람이 쓴 글 두 묶음을 그대로 집어넣었다. 한쪽은 영어가 모국어가 아닌 학생들이 쓴 TOEFL 에세이 91편, 다른 쪽은 미국 8학년(중학교 2학년) 학생들이 쓴 글 88편이다. 두 묶음 다 사람이 쓴 글이니, 탐지기가 AI 라고 답하면 그건 전부 틀린 답이다.
두 묶음이 어디서 왔는지도 적어 둘 만하다. TOEFL 에세이 91편은 중국의 한 교육 포럼에 올라와 있던 글을 모은 것이고, 8학년 글 88편은 학생 에세이를 채점용으로 모아 공개해 둔 자료에서 가져왔다. 표본이 넓지 않다는 것은 저자들도 논문에 한계로 적어 두었다. 그래도 둘 다 AI 가 손댄 적 없는 사람의 글이라는 점은 같다.
8학년 글 88편에서는 탐지기 일곱 개의 오판 비율이 평균 5%였다. 같은 탐지기들에 TOEFL 에세이 91편을 넣자 그 평균이 61%가 됐다. 하나씩 보면 가장 낮은 탐지기가 48%, 가장 높은 탐지기가 76%다. 가장 무던한 탐지기조차 에세이의 절반 가까이를 AI 글로 찍은 셈이다.
사람이 쓴 글을 AI 글로 잘못 찍는 것, 이른바 오탐(false positive)이다. 여기서 61%는 탐지기 일곱 개의 오탐률을 평균한 값이지, 에세이 91편 가운데 61%가 걸렸다는 뜻이 아니다. 에세이를 기준으로 세면 숫자가 달라진다. 91편 가운데 89편이 적어도 한 탐지기에 걸렸고, 18편은 일곱 곳 모두에서 AI 글이라는 판정을 받았다.
이 값을 사람 수로 옮겨 보면 크기가 잡힌다. 영어가 모국어가 아닌 학생 열 명이 정직하게 쓴 에세이를 탐지기 한 곳에 넣으면, 평균 여섯 편이 AI 글로 찍힌다는 뜻이다. 일곱 곳을 다 돌려 한 곳에서라도 걸리는 것까지 세면 열 중 아홉을 넘는다.

그림 1 는 그 판정을 탐지기별로 펼쳐 놓은 것이다. TOEFL 에세이 열은 위에서 아래까지 전부 짙고, 8학년 열은 대부분 옅다. 같은 연구의 첫 판에서 대조군으로 썼던 미국 대학 지원 에세이 70편 열은 더 옅어서 평균이 1.6%다. 같은 탐지기에 같은 날 넣었는데 판정은 5%와 61% 사이에서 이렇게 갈렸다.
이 그림의 값은 논문 본문이 아니라 저자들이 공개해 둔 원자료에서 다시 계산한 것이다. 탐지기가 돌려준 점수가 0.5를 넘으면 AI 글 판정으로 세었고, 그 규칙으로 논문이 발표한 수치 열두 개가 반올림 범위 안에서 재현됐다. 칸에 적힌 값과 본문에 적은 값이 같은 계산에서 나왔다는 뜻이다.
눈여겨볼 것은 탐지기 쪽을 하나도 건드리지 않았다는 점이다. 글쓴이가 정직했는지 아닌지도 두 묶음이 같다 — 전부 사람이 쓴 글이다. 그러니 판정을 가른 것은 글 자체의 어떤 성질이고, 그 성질은 글쓴이의 정직함과는 상관이 없다. 그게 무엇인지는 탐지기가 무엇을 재는지 보면 드러난다.
탐지기가 보는 것은 뻔함이다 — 혼란도(perplexity)
대부분의 AI 탐지기는 글을 읽고 글쓴이를 알아보지 않는다. 언어 모델을 하나 옆에 두고, 그 모델에게 이 글의 다음 낱말을 맞혀 보라고 시킨다. 모델이 척척 맞히면 뻔한 글이고, 자꾸 엉뚱한 낱말을 대면 뻔하지 않은 글이다. 이 맞히기 어려운 정도를 혼란도(perplexity)라고 부른다. 논문 저자들의 설명으로는 언어 모델이 문장의 다음 낱말을 맞히려 할 때 얼마나 놀라거나 헷갈려 하는지를 재는 값이고, 쉽게 맞힐수록 그 값이 낮다.
어떤 글이 뻔한지는 예로 보는 편이 빠르다. GPTZero 는 자사 글에서 「Hi there, I am an AI ___」 같은 문장을 든다. 빈자리에 모델이 붙일 법한 낱말은 assistant 이고, 거기에 potato 가 오면 혼란도가 훌쩍 뛴다는 것이다. 회사 설명으로는 그렇게 튀는 자리가 있을수록 사람이 썼을 가능성도 커진다.
AI 가 쓴 글은 이 값이 낮은 편이다. 저자들은 챗봇 같은 언어 모델을 「고급 자동완성」에 빗대는데, 지금 자리에 올 법한 가장 그럴듯한 낱말을 찾아 붙이는 식으로 문장을 만든다는 뜻이다. 그렇게 만든 글을 다시 언어 모델에게 맞혀 보라고 하면 잘 맞힌다. 그래서 대부분의 탐지기는 혼란도가 낮은 글을 AI 글 쪽으로 본다. 논문이 여기에 「대부분」이라는 한정을 붙여 둔 것도 눈여겨볼 만하다. 일곱 가운데 여럿은 상용 제품이라 안에서 무엇을 재는지 밖에서 확인할 수 없고, 나중에 학술지에 실린 판(게재본)은 그 불투명함도 함께 문제 삼는다.
GPTZero 는 자사 글에서 혼란도만 보는 것이 아니라, 문장 길이와 뻔함이 문서 안에서 얼마나 들쭉날쭉한지(burstiness)도 함께 본다고 설명한다. 2023년 3월에 올라온 그 글은 두 통계 지표가 자사 탐지 모델이 쓰는 일곱 가지 지표 가운데 하나라고도 적어 두었다.
여기서 오탐이 그대로 따라 나온다. 어휘와 문법의 폭이 좁은 사람의 글도 다음 낱말이 잘 맞혀진다. 논문은 비모국어 화자의 글이 예측하기 쉬워지는 까닭을 쓸 수 있는 낱말과 문형의 범위가 좁은 데서 찾는다. 그런 글을 넣으면 탐지기가 재는 값이 AI 가 쓴 글과 같은 쪽으로 간다.
그림 2 는 사람이 뻔한 어휘로 쓴 글이 오탐에 닿기까지의 한 길을 그린 것이다. 위 레인에서 출발한 글이 아래 탐지기 레인으로 내려가 「다음 낱말 맞히기 쉬움」 칸을 지나고, 거기서 곧장 AI 판정이 나온다. AI 가 쓴 글도 가운데 그 칸을 똑같이 지난다. 그러니 칸을 통과한 값만 들고서는 어느 쪽에서 들어온 글인지 되물을 수가 없다. 주의할 것은 이것이 탐지기의 논리이지 사실이 아니라는 점이다. 뻔한 글이라고 해서 AI 가 쓴 글인 것은 아니고, 논문이 반박하는 대목이 정확히 거기다.
그래서 탐지기가 재는 축은 「누가 썼나」가 아니라 「얼마나 뻔한가」다. 내 리포트가 뻔한 문장으로 채워져 있다면, 내가 직접 썼다는 사실은 그 값에 들어가지 않는다. 뒤집어 말하면, 문장이 고만고만한 사람일수록 같은 글에서 더 자주 걸린다.
어휘를 바꾸면 오탐이 양방향으로 움직인다
논리가 그럴듯하다고 해서 맞는 것은 아니다. 연구진은 그다음 단계에서 그 논리를 직접 시험했다. 같은 TOEFL 에세이 91편을 내용은 그대로 두고 AI 에게 낱말 선택만 원어민처럼 들리게 다듬게 한 뒤, 같은 탐지기 일곱 개에 다시 넣었다.
탐지기 일곱 개의 평균 오탐률이 61%에서 약 12%로 내려갔다. 일곱 곳이 모두 AI 라고 찍었던 에세이의 비율도 19.8%에서 1.1%로 떨어졌다. 글쓴이도 그대로고 내용도 그대로다. 낱말만 바꿨는데 판정이 통째로 뒤집혔다.
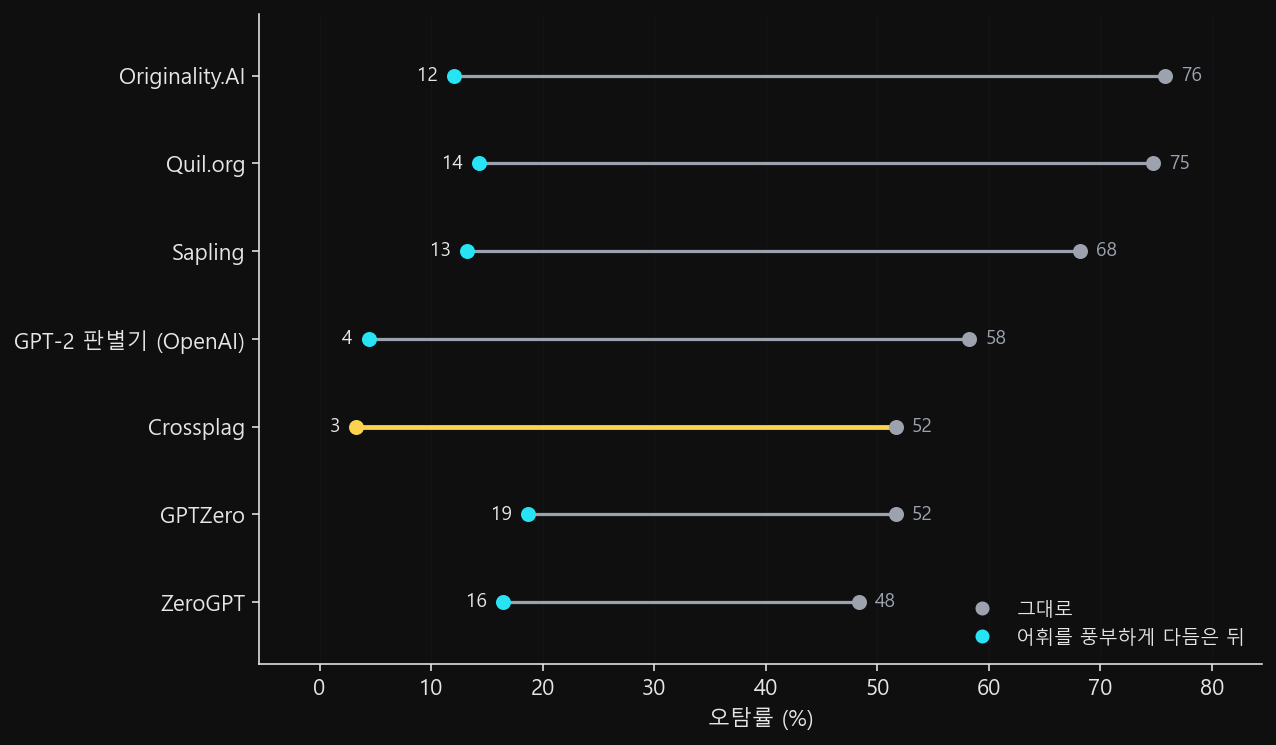
그림 3 는 그 이동을 탐지기별로 그린 것이다. 일곱 개 모두 값이 내려갔고, 내려간 폭은 제각각이다. 52%에서 3%로 내려간 Crossplag 가 있는가 하면, 같은 자리에서 출발해 19%까지만 내려온 GPTZero 도 있다.
반대로도 해 봤다. 8학년 글을 비모국어 화자가 쓴 것처럼 낱말만 단순하게 바꾸자, 오탐률 평균이 5%에서 57%로 올라갔다. 일곱 중 Originality.AI 는 그렇게 바꾼 글의 98.9%를 AI 글로 찍었다. 모국어 화자가 직접 쓴 글인데도 그렇다.
양쪽을 붙여 놓으면 판정을 움직인 축이 드러난다. 글쓴이가 누구인지가 아니라 글이 얼마나 뻔한지가 값을 끌어올리고 끌어내렸다. 여기서 요령 하나가 떠오르지만, 논문은 그것을 해법으로 적지 않는다. 무고를 벗으려고 AI 에게 글을 다듬게 하는 편이 유리해지는 상황 자체를 문제로 짚는다.
그런데 AI 가 쓴 글은 오히려 잘 안 걸린다
그러면 탐지기는 AI 가 쓴 글이라도 잘 잡을까. 같은 연구가 그것도 쟀다. 당시 ChatGPT 에게 쓰게 한 대학 지원 에세이 31편을 같은 일곱 개에 넣었더니 평균 탐지율이 70%였다. 가장 잘 잡은 한 곳은 31편을 모두 잡았고, 가장 못 잡은 곳은 절반도 못 잡았다.
그다음이 더 나아간다. 같은 글을 다시 주고 더 문학적인 표현으로 고치라고 시키자, 일곱 개의 평균 탐지율이 3%로 떨어졌다. 가장 잘 잡은 탐지기의 값도 13%였다. 사람이 쓴 TOEFL 에세이에서 일곱 개의 오탐률이 평균 61%였는데, AI 가 쓰고 한 번 고친 에세이에서 같은 일곱 개의 탐지율은 평균 3%다.
다른 연구팀이 독립적으로 한 시험도 같은 방향을 가리킨다. 2023년 3월부터 5월 사이에 교육 현장에서 쓰이는 도구 14종을 문서 종류별로 시험한 결과다. 연구자들이 직접 쓴 영어 글에서 오탐률은 평균 2.4%였는데, 같은 사람들이 모국어로 쓴 뒤 기계로 번역한 글에서는 11.1%로 뛰었다. 사람이 쓴 글이라는 점은 같고, 기계를 한 번 거쳤다는 점만 다르다.
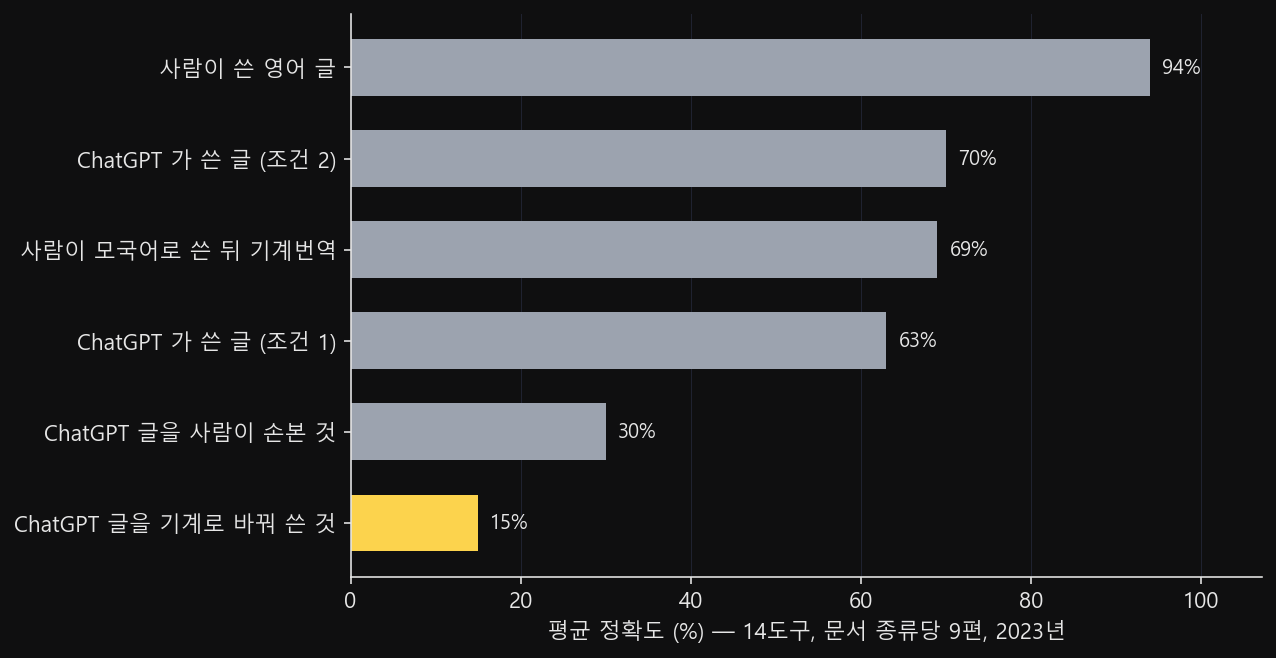
그림 4 가 문서 종류별 성적이다. 사람이 쓴 영어 글에서 94%로 가장 높고, 손질을 거친 AI 글로 갈수록 낮아진다. 생성한 글을 사람이 손보면 평균 정확도가 30%, 기계로 바꿔 쓰면 15%까지 내려갔다. 14종 가운데 가장 성적이 좋은 Turnitin 도 76%였고, 80%를 넘긴 도구는 없었다.
이 수치에는 한정을 붙여야 한다. 문서 종류마다 9편씩이라 표본이 아주 작고, 도구 하나의 오탐률은 한 건이 5.6%포인트씩 움직인다. 상용 도구 두 곳은 회사가 시험인 줄 알고 로그인을 내준 상태에서 받은 결과라, 저자들이 무료 도구와 같은 조건이 아닐 수 있다고 적어 두었다.
두 연구를 한 줄로 이으면 이렇게 된다. 탐지기는 전반적으로 AI 글을 놓치는 쪽으로 기울어 있다. 그런데도 어휘와 문장이 단순한 글, 비모국어 화자의 글, 기계번역을 거친 글은 반복해서 걸린다. 같은 자로 재는데, 한쪽은 빠져나가고 다른 쪽은 붙잡힌다.
왜 원리적으로 어려운가 — 상한과 오픈AI 의 철수
탐지기를 더 잘 만들면 되는 것 아니냐는 물음이 남는다. 오픈AI 는 자기 탐지기를 분류기라고 불렀는데, 그것을 공개하면서 함께 적은 두 문장이 이 물음에 닿아 있다. 하나는 뻔한 글에 관한 것이다. 공개 글은 1,000개의 소수를 차례로 적은 목록을 예로 들면서, 그런 글은 누가 쓰든 같아지니 사람이 썼는지 AI 가 썼는지 가려낼 방법이 없다고 적었다. 다른 하나는 탐지기 자신에 관한 것이다. 학습에 쓴 글과 많이 다른 글이 들어오면 신경망 분류기가 틀린 답을 강하게 확신하는 일이 있다고, 같은 글이 밝혀 두었다.
수학 쪽에서도 상한이 하나 나와 있다. 사람이 쓴 글과 AI 가 쓴 글이 서로 닮아 갈수록 어떤 탐지기의 성적도 동전 던지기 쪽으로 내려간다. 다른 연구팀이 이 상한을 수학의 정리(定理)로 증명해 두었다. 다만 그 저자들은 이것으로 탐지가 불가능해졌다고 말하지 않는다 — 보안 수단이 완벽할 필요는 없다고 같은 논문에 적어 두었다.
그리고 사건이 하나 있었다. 오픈AI 는 2023년 1월 31일에 AI 글 분류기를 공개했다. 자체로 만든 시험 집합에서 AI 글의 26%를 잡아냈고 사람 글의 9%를 AI 글로 찍는다고, 공개 글에 수치를 적어 두었다. 같은 해 7월 20일, 오픈AI 는 그 분류기를 내렸다.
As of July 20, 2023, the AI classifier is no longer available due to its low rate of accuracy.
OpenAI, “New AI classifier for indicating AI-written text” 종료 공지정확도가 낮다는 것이 공지에 적힌 사유의 전부다. 어느 쪽 정확도가 낮았는지는 숫자로 적혀 있지 않다. 앞의 논문들이 이 종료를 근거로 든 것도 아니다 — 종료는 두 실측 논문(스탠퍼드 연구진의 최신판과 14종 시험의 개정판)이 나온 2023년 7월 10일에서 열흘 뒤의 일이다.
세 갈래가 같은 자리를 가리킨다. 뻔한 글일수록 누가 썼는지는 글 안에 남지 않는다. 그리고 남지 않은 것을 숫자로 답해야 하는 기계는, 틀릴 때 조용히 틀리지 않고 높은 확신과 함께 틀린다.
이 판정이 말해주는 것과 말해주지 않는 것
이제 처음 화면으로 돌아가자. 「AI 98%」가 무엇을 센 숫자인지는 제품마다 다르고, 그 정의를 밝힌 1차 자료는 이번에 찾지 못했다. 확실한 것은 그 글이 해당 제품이 정해 둔 뻔함의 문턱을 넘었다는 사실 하나다. 98%가 「이 글이 AI 글일 확률」을 뜻한다고 읽을 근거는 없다.
게재본은 「99% 정확」 같은 홍보 문구도 함께 짚는다. 공개된 시험 자료도, 모델의 내부도, 학습에 쓴 글도 밖에서는 확인할 수 없는데 그 숫자만 사실처럼 받아들여진다는 것이다. 같은 글은 모국어 화자라고 안전한 것은 아니라고도 적는다. 사회·경제적 배경에 따라 쓰는 말이 다르니, 어떤 집단은 무고를 당할 위험이 더 높아질 수 있다는 쪽이다.
그래서 이런 숫자를 받았을 때 되물어볼 것이 생긴다. 이 제품은 사람이 쓴 글을 얼마나 자주 AI 로 찍는가, 그리고 그 값은 어떤 글 묶음에서 나왔는가. 스탠퍼드 연구진이 일곱 제품에 대해 잰 값이 바로 그 오탐률이었고, 넣는 묶음을 바꾸자 5%와 61% 사이에서 움직였다.
세 문헌의 권고도 한쪽으로 모인다. 평가나 징계의 근거로 쓸 물건이 아니라는 쪽이다. 스탠퍼드 연구진이 논의절에서 권고를 꺼내며 첫 번째로 든 것이 이 문장이다.
First, we strongly caution against the use of GPT detectors in evaluative or educational settings, particularly when assessing the work of non-native English speakers.
Liang, Yuksekgonul, Mao, Wu, Zou, “GPT detectors are biased against non-native English writers” (arXiv:2304.02819v3)평가나 교육 현장에서 AI 탐지기를 쓰는 데 강하게 반대한다는 뜻이고, 영어가 모국어가 아닌 사람의 글을 평가할 때 특히 그렇다는 단서가 붙어 있다. 같은 연구진은 게재본에서 대가 하나를 더 든다. 이런 도구를 쓰기 시작하면 결백을 증명하기 전까지 학생이 의심받는 분위기가 자리 잡는다는 것이다.
만든 쪽도 용도를 못 박아 두었다. 오픈AI 는 분류기를 공개하며 이것을 판단의 주된 도구로 쓰지 말고 다른 방법을 거드는 정도로만 쓰라고 적었다. 1,000자보다 짧은 글에서는 특히 못 믿을 값이 나온다는 말도 같은 글에 있다. 시험한 쪽과 만든 쪽의 권고가 같은 자리를 가리킨 셈이다.
게재본이 낮은 위험으로 인정한 쓰임이 하나 있다. 상투적인 표현과 되풀이되는 문형을 골라내는 데는 쓸 만하니, 평가 도구가 아니라 학생이 자기 글을 스스로 점검하는 도구로 쓰라는 것이다.
한국어로 쓴 글을 탐지기에 넣어 본 실측은 이번에 읽은 자료의 범위 밖이었다. 오픈AI 는 자사 분류기를 영어에만 쓰라고 권하면서 다른 언어에서는 성능이 확연히 떨어진다고 적었다. 시점도 좁다 — 위에 적은 실측은 전부 2023년 봄의 것이고, 그때 시험된 탐지기 대부분은 GPT-2 를 뼈대 모델로 쓰고 있었다.
그 화면 앞에서 할 수 있는 말은 하나로 줄어든다. 탐지기가 적어 준 「AI 98%」는 내가 쓴 글이 그 제품이 정해 둔 뻔함의 문턱을 넘었다는 것까지 알려 준다. 누가 썼는지는 그 숫자가 재지 않았다.
더 읽기
- Liang, Yuksekgonul, Mao, Wu, Zou, "GPT detectors are biased against non-native English writers", arXiv:2304.02819v3 (2023-07-10) — https://arxiv.org/abs/2304.02819
- Weber-Wulff, Anohina-Naumeca, Bjelobaba 외, "Testing of detection tools for AI-generated text", International Journal for Educational Integrity 19(1), 2023 — https://doi.org/10.1007/s40979-023-00146-z
- Sadasivan, Kumar, Balasubramanian, Wang, Feizi, "Can AI-Generated Text be Reliably Detected?", arXiv:2303.11156v4 (2025-01-17) — https://arxiv.org/abs/2303.11156