아플 때 증상을 적어 챗봇에게 무슨 병일지 물어볼 수 있다. Nature Medicine 에 실린 영국의 한 무작위 실험에서, GPT-4o 는 가상 환자 사례를 통째로 받으면 관련 병명을 94.7% 맞혔다. 그런데 같은 사례를 자기 증상처럼 받아 GPT-4o 와 대화한 참가자들의 답은 34.5% 만 맞았다. 챗봇 없이 평소 하던 대로 찾아본 사람들(47.0%)보다도 낮은 값이다. 공개된 대화 기록을 다시 세어 보면, 챗봇이 대화 중에 정답 병명을 말하고도 그 병명이 사람의 최종 답에서 빠진 경우가 절반이 넘었다. 연구진은 사람과 모델 사이에서 정보가 이렇게 새는 일을 소통 끊김(breakdown in communication)이라고 불렀다.
비슷한 증상을 적은 두 사람, 정반대로 돌아온 답
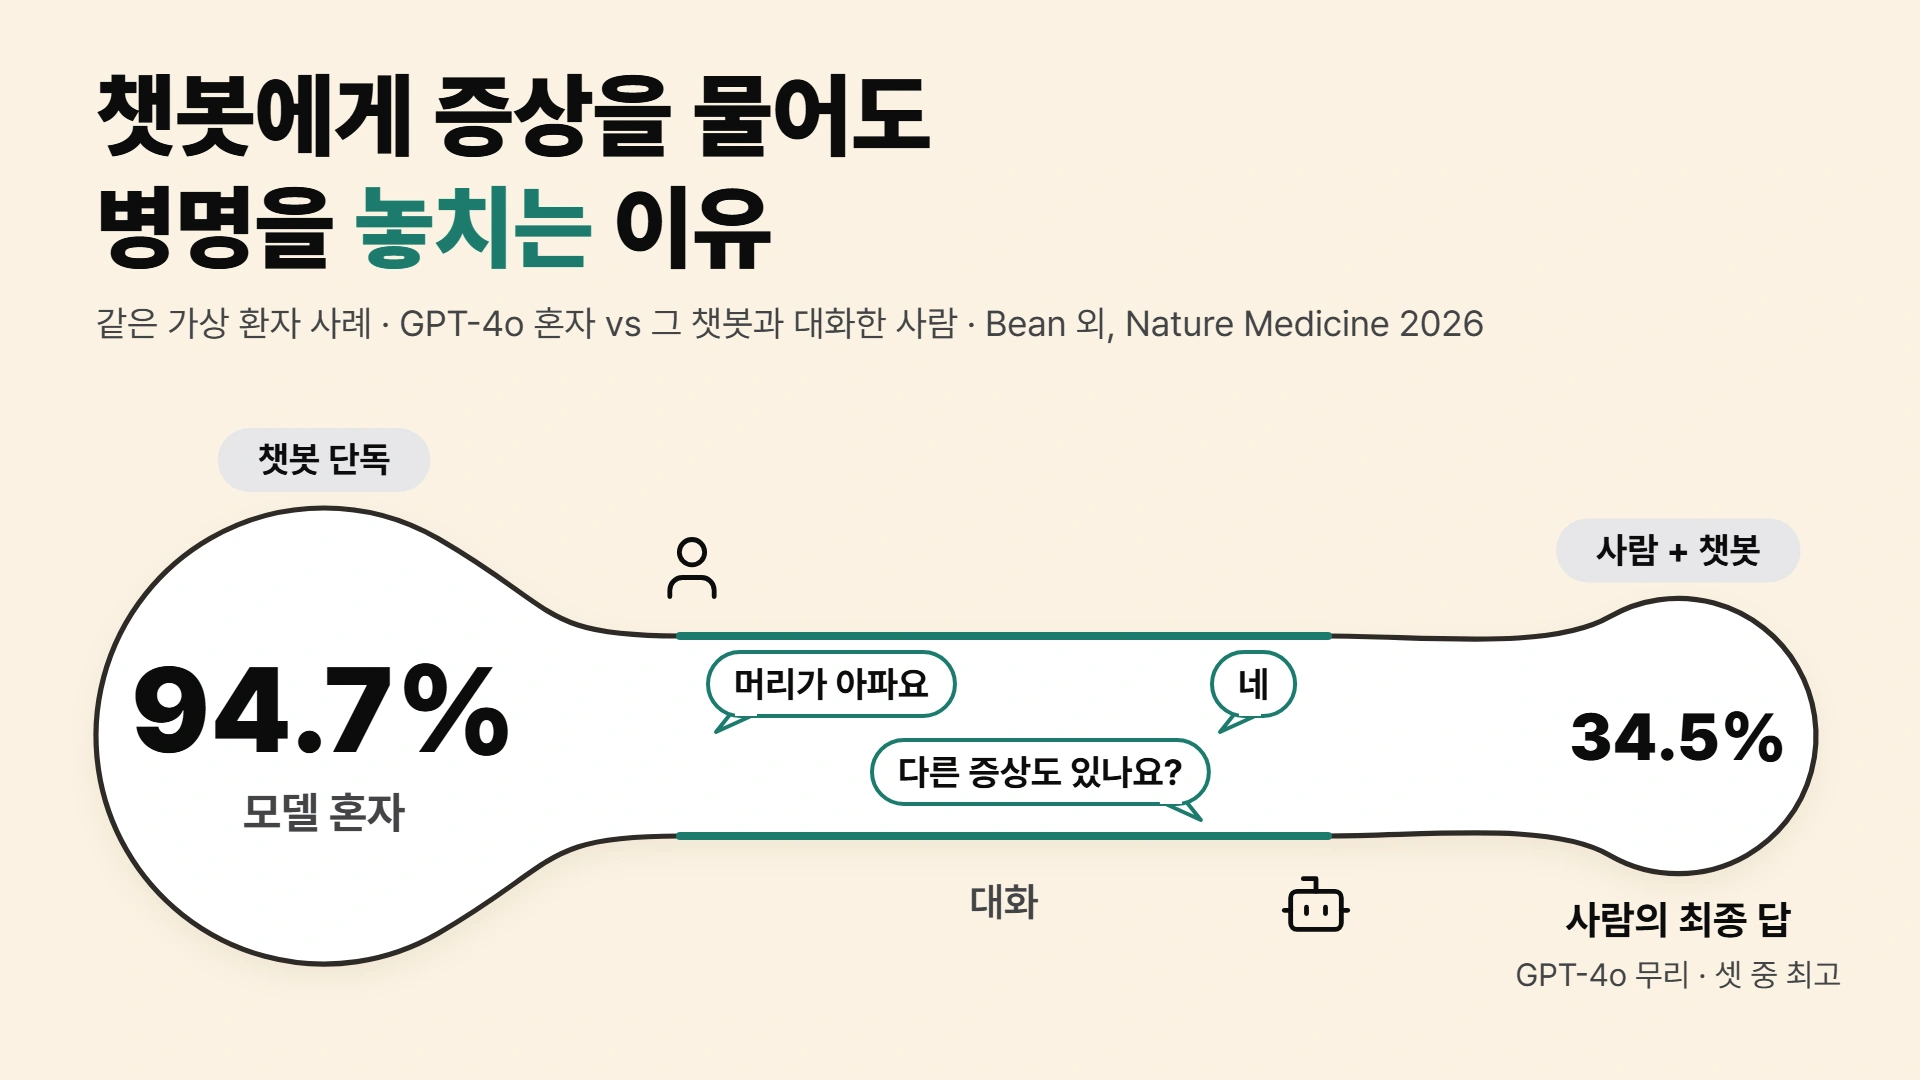
한 실험에서 두 참가자가 같은 가상 환자 사례를 받았다. 사례의 병은 지주막하출혈, 뇌를 싸는 막 아래에 피가 고이는 병이다. 두 사람 모두 GPT-4o 와 대화하며 사례에 적힌 증상을 자기 증상처럼 설명했다. 둘 다 끔찍한 두통과 뻣뻣한 목, 빛이 눈부시다는 이야기를 적었다.
그런데 돌아온 답은 정반대였다. 한 사람은 어두운 방에 누워 있으라는 말을 들었고, 다른 사람은 응급 진료를 받으라는 권고를 받았다. 논문은 이 장면을 「One user was told to lie down in a dark room, and the other user was given the correct recommendation to seek emergency care.」라고 적었다. 여기서 「맞는 권고」는 연구진이 이 사례에 미리 정해 둔 정답 칸을 가리킨다.
연구진은 두 메시지가 「아주 비슷했다(very similar)」고 썼다. 하지만 똑같지는 않았다. 대화를 실은 표의 설명은 두통이 「갑자기」 시작됐다고 적은 사람이 두 번째 참가자, 곧 응급 진료를 권고받은 쪽뿐이었다고 짚는다.
이 표는 학술지에 싣기 전에 먼저 공개한 판, 곧 프리프린트에 글자로도 실려 있다. 거기서 두 첫 메시지를 맞대 보면 다른 점이 더 있다. 두 번째 참가자는 「살면서 가장 심한 두통(the worst headache ever)」이 생겼다고 적었다. 메시지 끝에서는 「어떻게 해야 하나요?(What action should I take?)」라고 할 일을 직접 물었다. 첫 번째 참가자의 첫 메시지에는 둘 다 없다.
그래서 이 장면만으로는 어느 낱말이 답을 갈랐는지 가릴 수 없다. 분명한 것은 같은 챗봇이 비슷한 이야기를 듣고 정반대 답을 냈다는 사실이다. 이 장면은 일화 하나로 끝나지 않는다. 같은 실험 전체의 숫자에서도, 챗봇이 아는 것과 사람이 대화에서 얻어 가는 것 사이에 틈이 드러난다.
건강 상담 챗봇은 혼자 풀 때 더 잘 맞혔다 — 실험의 짜임
두 참가자의 장면은 영국 옥스퍼드 인터넷 연구소(Oxford Internet Institute)를 중심으로 한 Bean 외 연구진이 2026년 Nature Medicine 에 낸 실험에서 나왔다. 연구진은 이 실험을 사전 등록했다. 사전 등록은 무엇을 어떻게 잴지 실험 전에 공개해 두는 일이다. 결과를 본 뒤에 기준을 바꾸지 못하게 하려는 장치다.
재료는 가상 환자 사례 10개다. 일반의 다섯 명과 중환자 의사 두 명, 모두 일곱 명의 의사가 사례와 정답을 만들었다. 사례는 「당신은 …」으로 시작하는 2인칭 글이고, 증상과 생활과 병력 세 부분으로 되어 있다. 병은 지주막하출혈, 폐색전증, 신장 산통, 폐렴, 빈혈, 감기, 알레르기 비염 등 열 가지다. 연구진은 증상이 비교적 익숙한 흔한 질환 위주로 골랐다고 밝혔다.
참가자는 영국 성인 1,298명이다. 연구진은 이들을 네 무리로 무작위로 나눴다. 세 무리(모두 997명)는 각각 GPT-4o, Llama 3, Command R+ 중 한 챗봇과 대화하며 사례를 풀었다. 남은 한 무리 301명은 챗봇 없이 평소 집에서 하던 대로 찾아봤는데, 이 무리가 대조군이다. 사후 설문에서 대조군 대부분은 검색 엔진을 쓰거나 영국 국민보건서비스(NHS) 웹사이트 같은 믿을 만한 사이트로 곧장 갔다고 답했다. 무작위로 나눴으니 무리 사이에 차이가 나면, 사람이 달라서가 아니라 손에 쥔 도구가 달라서라고 읽을 수 있다.
세는 단위는 응답 1건이다. 한 사람이 사례 하나를 놓고 나눈 대화와 마지막에 적어 낸 답을 한 묶음으로 센다. 참가자 한 명이 사례를 하나나 둘 풀어서 1,298명에게서 2,400건이 모였고, 네 무리에 600건씩 돌아갔다.
참가자가 마지막에 푼 과제는 둘이다. 첫째는 관련 질환 이름 대기다. 떠오르는 병명을 자유롭게 적고, 의사들이 만든 정답 목록의 병명과 하나라도 맞으면 정답으로 친다. 둘째는 어디로 가야 하나다. 집에서 돌보기, 일반 진료 예약, 당일 진료, 응급실, 구급차의 다섯 칸 중 하나를 고르고, 의사들이 정해 둔 칸과 같으면 정답이다.
비교할 기준점이 하나 더 있다. 「모델 혼자」 조건이다. 연구진은 사람을 거치지 않고 같은 사례 전문을 모델에 그대로 주고 두 질문을 물었다. 사례 하나에 60번씩 물어 모델마다 600건을 모았다.
실험은 2024년 8~10월에 그때의 세 모델로 했다. 참가자는 영국 성인이고, 실제로 아픈 상태가 아니라 가상 사례를 자기 일처럼 연기했다. 한국 사용자는 측정되지 않았다. 의사에게 진료받는 무리도 없어서, 챗봇과 의사를 견주는 일은 이 실험의 범위 밖이다.
모델 혼자 조건은 사례 전문을 받았고 두 질문을 따로따로 받았으며, 답도 사람의 최종 답보다 훨씬 길었다. 「하나라도 맞으면 정답」인 채점에서는 긴 답이 유리할 수 있지만, 그 크기는 원문이 재지 않았다. 모델 혼자 실험은 사전 등록 뒤에 추가한 분석이다. 이 글에서 「우리 재집계」라고 적은 값은 저자들이 공개한 데이터(HELPMed, MIT 라이선스)를 우리가 다시 센 것이고, 모델을 새로 돌리지는 않았다.
결과부터 보자. GPT-4o 는 혼자 풀 때 관련 질환을 94.7% 맞혔다. 그런데 GPT-4o 와 대화한 참가자의 최종 답은 34.5% 만 맞았다. 챗봇 없이 찾아본 대조군은 47.0% 였다.
세 챗봇을 합쳐 보아도 모양은 같다. 모델 혼자는 94.9% 였고, 그 모델들을 쓴 사람은 우리 재집계로 33.5% 였다. 무리별로는 GPT-4o 34.5%, Llama 3 34.0%, Command R+ 32.0% 여서, 앞에서 든 34.5% 가 세 챗봇 가운데 가장 높은 값이다. 챗봇을 쓴 세 무리 모두 챗봇 없이 찾아본 대조군보다 덜 맞혔다. 모델이 혼자 낸 점수가 높다고 해서, 사람이 그 모델과 대화해 얻는 답도 그만큼 좋아지지는 않았다는 뜻이다.
첫 번째 틈 — 사람이 챗봇에게 덜 말했다
사람과 챗봇 사이에서 정보는 두 방향으로 오간다. 사람은 증상을 챗봇에게 말하고, 챗봇은 병의 후보와 권고를 사람에게 돌려준다. 먼저 사람에서 챗봇으로 가는 쪽을 본다.
공개된 대화 기록을 우리가 다시 세어 보니, 챗봇과 나눈 대화 1,800건에서 사람이 보낸 메시지 수의 중앙값은 2였다. 한 번만 묻고 끝낸 대화가 25.9%(466건)였다. 첫 메시지도 짧았다. 낱말 수 중앙값이 15이고, 가운데 절반이 7~30낱말 사이에 있었으며, 1~5낱말짜리가 16.3% 였다그림 1. 여기서 낱말은 참가자가 쓴 영어 문장을 띄어쓰기로 나눈 단위다. 첫 메시지가 「headache」 한 낱말뿐인 대화도 있었다.

저자들도 대화를 직접 읽었다. 모델과 사례의 조합마다 하나씩 무작위로 고른 30건이다. 그중 16건은 첫 메시지에 사례의 정보가 일부만 담겨 있었다. 이 16건 가운데 7건은 대화가 이어지면서 빠진 증상이 채워졌는데, 챗봇의 질문에 답하면서 또는 스스로 덧붙여서였다. 닫힌 질문을 주로 던진 사용자도 여럿이었다. 「스트레스 때문일 수도 있을까요?(Could this be related to stress?)」처럼 물으면 챗봇이 내놓을 수 있는 대답도 그만큼 좁아진다.
저자들은 대화 안에 정답 병명이 한 번이라도 나온 비율부터 이미 모델 혼자 풀 때보다 낮았다고 보고한다. 그리고 이것이 사례에 필요한 정보가 사람과 모델 사이에서 전해지지 않았음을 시사한다고 썼다. 챗봇은 받은 말로만 판단하는데, 사람은 사례에 적힌 것보다 적게 말하는 일이 잦았다. 정답이 대화에 나오지 않은 일부는 모델이 몰라서가 아니라 재료가 모자라서였을 수 있다.
두 번째 틈 — 챗봇이 말한 병명이 사람의 답까지 오지 않았다
이번에는 반대 방향, 챗봇에서 사람으로 가는 쪽이다. 우리 재집계로는 GPT-4o 무리 600건 가운데 챗봇의 말 어딘가에 정답 병명이 나온 대화가 383건(63.8%)이었다. 그런데 그중 201건(52.5%)에서는 그 병명이 사람의 최종 답에 없었다. 세 챗봇을 합치면 챗봇이 정답을 말한 1,198건 가운데 677건, 56.5% 다그림 2. 여기서 「말했다」는 챗봇이 그 병을 권했다는 뜻이 아니다. 여러 후보를 늘어놓다가 한 번 지나간 이름도 센다.
원문은 이 비율을 숫자로 내지 않았다. 다만 정답이 대화에 나왔는데도 사용자들이 그것을 최종 답에 「일관되게 넣지 않았다(did not consistently include them)」고 썼다. 그리고 이것을 모델과 사용자 사이의 「두 번째 소통 끊김(a second breakdown in communication)」이라고 불렀다.
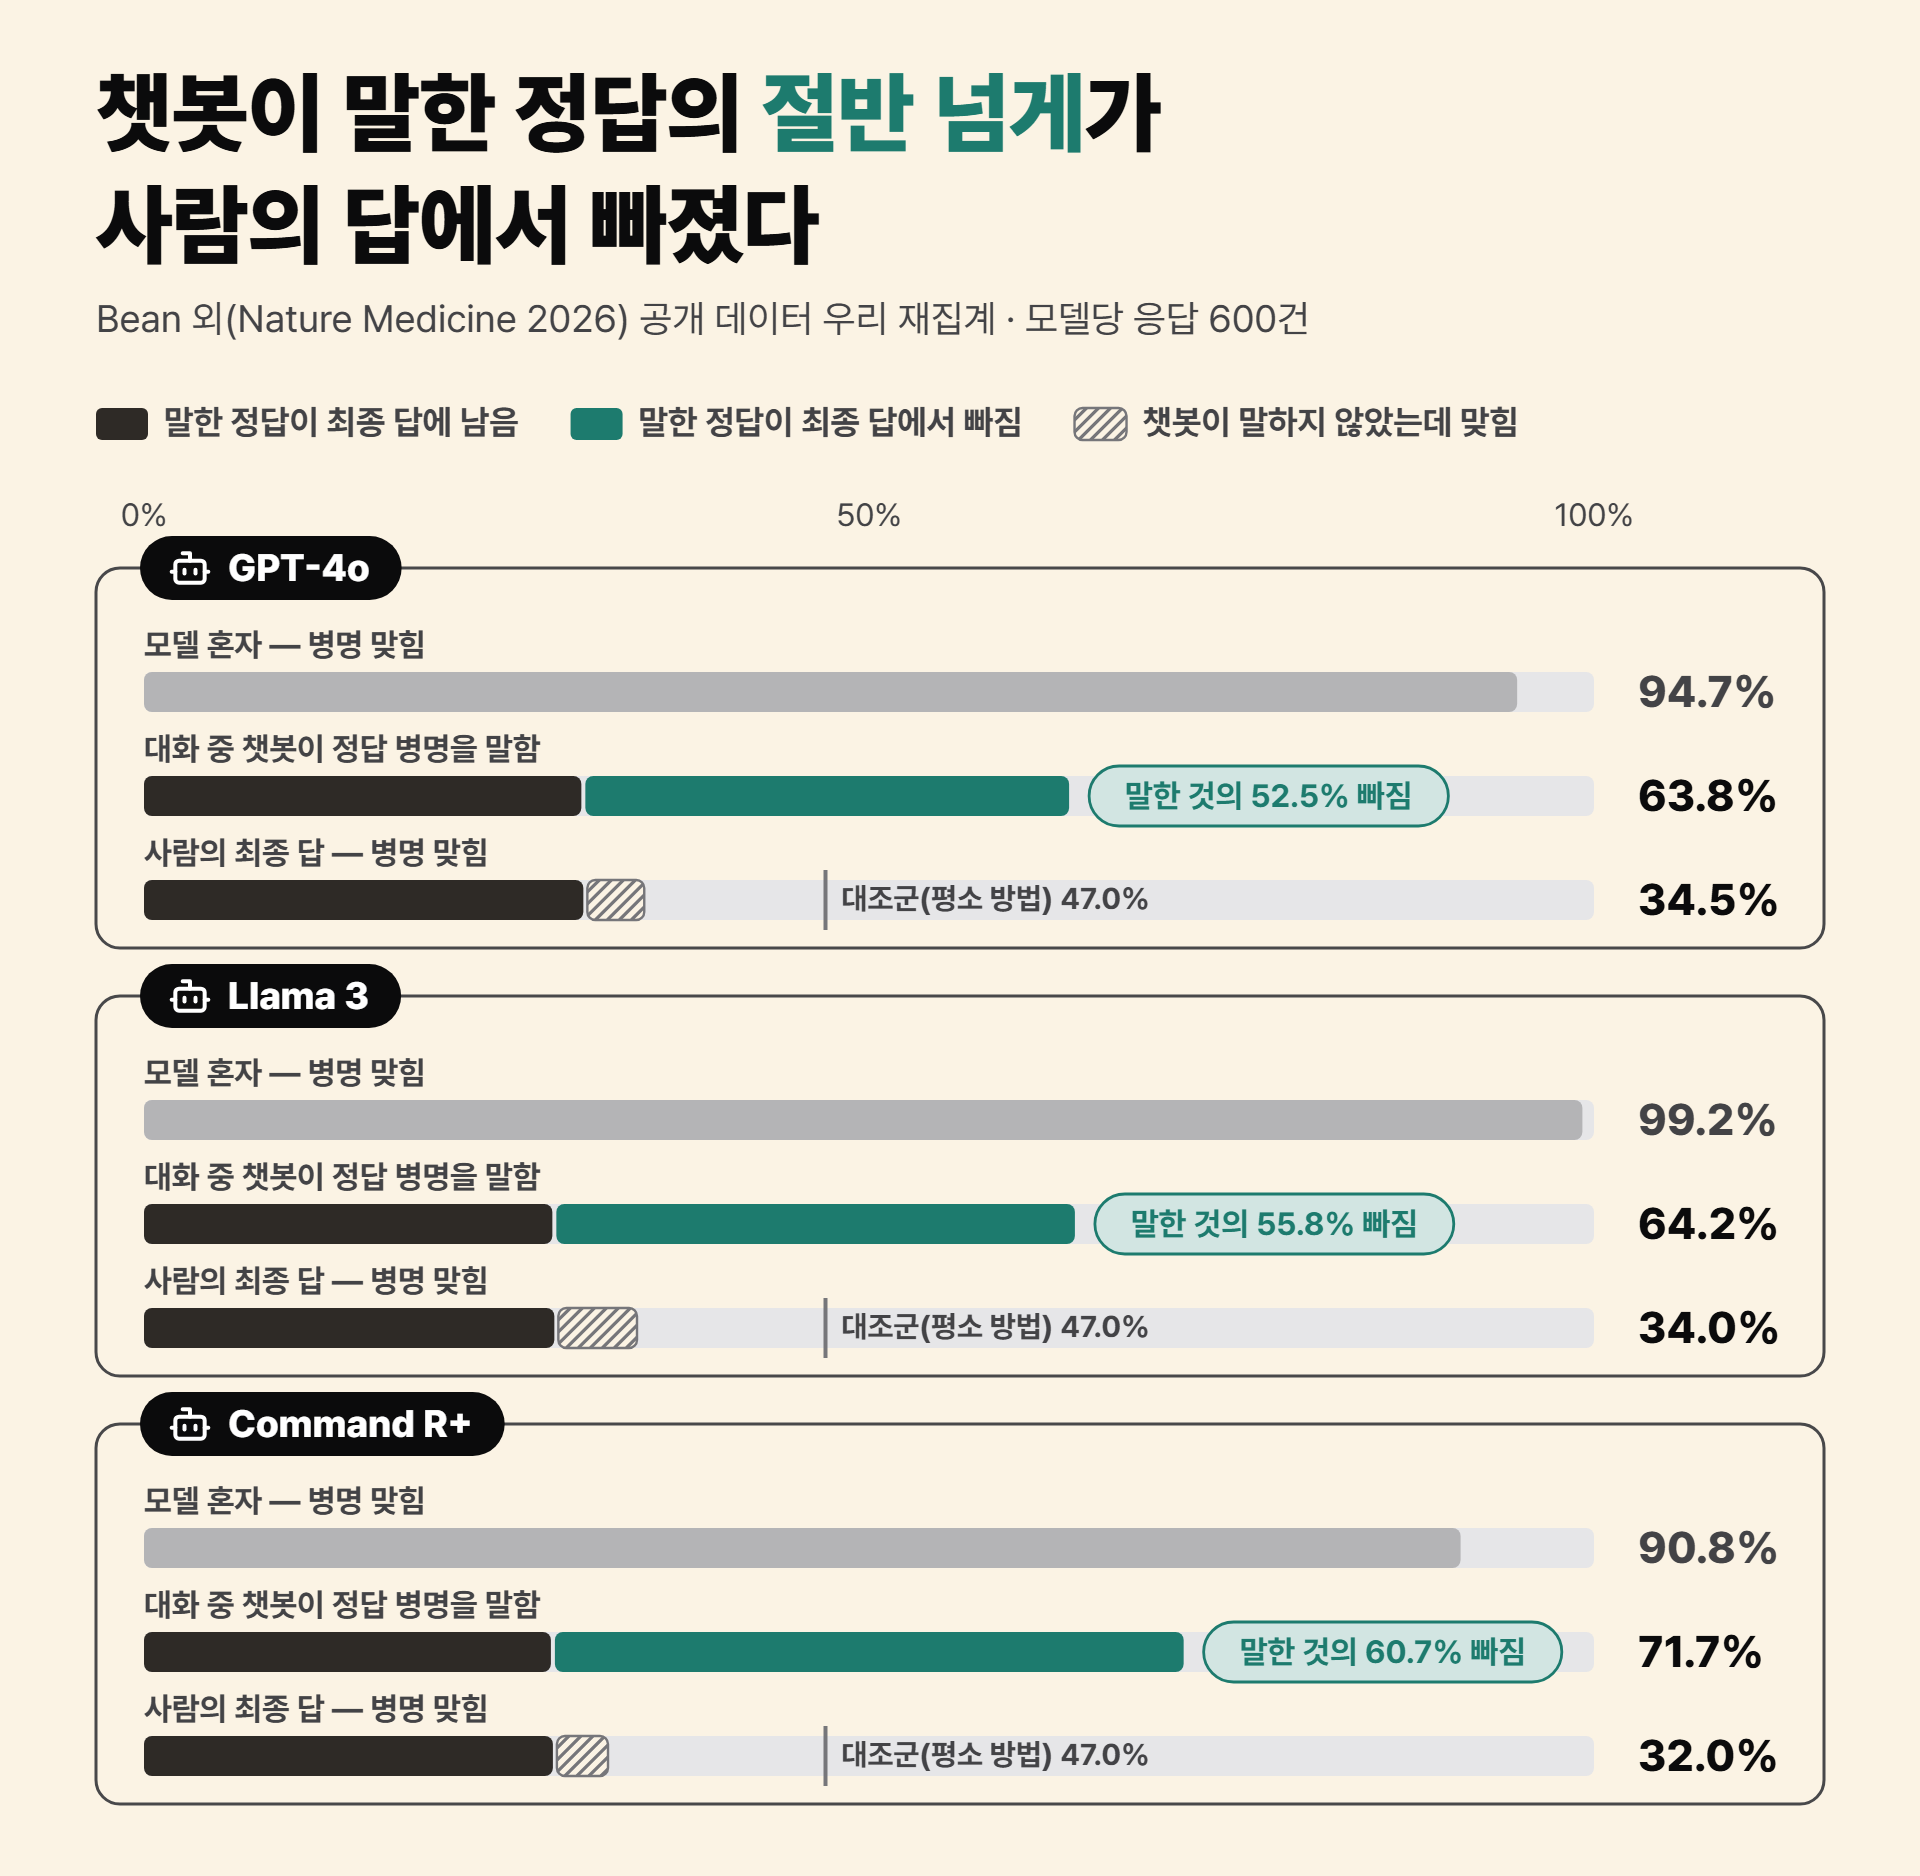
반대쪽 숫자도 있다. 챗봇이 정답을 한 번도 말하지 않은 602건 중 82건(13.6%)은 사람이 스스로 맞혔다. 그래서 그림의 세 막대는 윗단계가 아랫단계를 품는 깔때기가 아니다. 사람의 최종 정답에는 챗봇이 말한 것을 남긴 몫과 챗봇 없이 맞힌 몫이 섞여 있다.
저자들이 읽은 대화 하나가 이 틈을 보여 준다. 지주막하출혈 사례에서 Command R+ 는 뻣뻣한 목이 빛에 예민함이나 가라앉지 않는 두통과 함께 오면 수막염(meningitis)의 증상일 수 있다고 말했다. 수막염은 이 사례의 정답 목록에 든 병명이다. 하지만 참가자의 최종 답에는 「Severe headache, light sensitivity and stiff neck.」이라는 증상만 적혔고 병명은 없었다. 저자들이 이 대화에 남긴 메모는 「Model suggested meningitis but the user ignored it.」 한 줄이다.
반대 방향의 성공도 있었다. 챗봇이 엇나간 말을 하자 사용자가 되받아 대화를 바로잡은 경우를 연구진은 따로 기록했다. 그래도 저자들은 참가자가 모델이 내놓은 후보 가운데 좋은 것을 골라내지 못했을 수 있다고 본다. 정답이 대화 안에 있었다는 것과 사람이 그것을 가져갔다는 것은 별개의 일이다.
어디로 갈지 고르는 일은 챗봇을 쓰든 안 쓰든 비슷했다
두 번째 과제인 「어디로 가야 하나」에서도 모델 혼자와 사람 사이의 틈은 그대로였다. 모델 혼자 풀 때 정답 칸을 고른 비율은 GPT-4o 64.7%, Llama 3 48.8%, Command R+ 55.5% 였다. 그 모델을 쓴 사람은 43.7%, 44.2%, 41.7%, 대조군은 42.3% 였다. 챗봇 무리와 대조군의 차이는 우연으로도 날 수 있는 크기, 곧 통계적으로 유의하지 않은 크기였다.
대조군을 포함한 모든 무리가 정답 칸보다 덜 급한 쪽으로 보는 경향을 보였다. GPT-4o 와 Llama 3 무리는 오히려 대조군보다 조금 더 급하게 보는 경향이 있었지만, 이 차이도 유의하지 않았다. 그러니 「챗봇을 쓰면 더 위험하게 판단한다」는 결론은 이 실험에서 나오지 않는다. 챗봇이 어디로 갈지에 대한 판단을 낫게 했다는 근거도, 나쁘게 했다는 근거도 이 실험에는 없다. 모델 혼자 낸 점수만큼 사람의 판단이 따라오지 않는 틈은 두 번째 과제에도 있었다.
모델 혼자 본 시험이 말해 주지 않는 것
연구진은 한 걸음 더 나갔다. 같은 모델에게 의사 시험식 객관식 문제(MedQA)를 풀렸고, 모델이 환자 역을 맡아 챗봇과 대화하는 모의 실험도 돌렸다. 두 점수 모두 사람과 함께할 때 생긴 실패를 미리 보여 주지 못했다. 저자들이 이 비교를 한 까닭은, 이런 시험이 챗봇을 내놓기 전에 안전성과 믿을 만함을 확인하는 데 흔히 쓰이기 때문이다.
원문의 요약 문장은 「Standard benchmarks for medical knowledge and simulated patient interactions do not predict the failures we find with human participants.」이다. 모의 환자 대화는 평균적으로 실제 참가자보다 점수가 높게 나왔다. 모델이 환자 역을 맡은 대화가 잘 풀렸어도, 실제 사람과의 대화가 어떻게 끝날지는 그것으로 미리 알 수 없었다.
결과가 닿는 범위도 저자들이 적어 두었다. 이 실험은 2024년 8~10월의 세 모델로 한 것이고, 저자들은 이 작업이 줄 수 있는 것은 성능의 「하한(lower bound)」뿐이라고 썼다. 그때의 모델로 잰 성능이라, 모델이 나아지면 성능은 그 값보다 높아질 수 있다는 아래쪽 경계다. 실제로 저자들은 더 새 모델의 의학 시험 점수가 더 높을 가능성이 크다고 본다. 하지만 그 향상이 실제 사용자와 함께할 때도 이어질지는 「불분명하다(unclear)」고 덧붙였다. 최신 모델이면 해결된다는 말도, 최신 모델도 똑같다는 말도 이 실험에서는 나오지 않는다.
모델 혼자 받은 높은 점수는 사례 전문을 처음부터 손에 쥔 상태에서 나왔다. 실제 대화에서는 그 내용을 사람이 제 말로 나눠 건네야 했고, 대화의 25.9% 는 질문 한 번으로 끝났다. 답이 돌아오는 쪽에서도 정보는 줄었다. 챗봇이 대화 중에 정답을 말한 경우의 절반 넘게에서, 그 정답은 사람의 최종 답까지 건너가지 못했다.
더 읽기
- Andrew M. Bean, Rebecca Elizabeth Payne, Guy Parsons, Hannah Rose Kirk, Juan Ciro, Rafael Mosquera-Gómez, Sara Hincapié M, Aruna S. Ekanayaka, Lionel Tarassenko, Luc Rocher, Adam Mahdi, "Reliability of LLMs as medical assistants for the general public: a randomized preregistered study", Nature Medicine 32, 609–615 (2026), doi:10.1038/s41591-025-04074-y — https://doi.org/10.1038/s41591-025-04074-y
- 같은 연구의 프리프린트, "Clinical knowledge in LLMs does not translate to human interactions", arXiv:2504.18919v1 (2025) — https://arxiv.org/abs/2504.18919
- 저자 공개 데이터·분석 코드 HELPMed (MIT 라이선스) — https://github.com/am-bean/HELPMed