챗GPT 앱에 새 모델로 바뀌었다는 알림이 뜨면, 답이 더 정확해졌으리라 기대하게 된다. OpenAI 모델 22개 판에 같은 증상 사연 45개를 10번씩 물은 공개 기록이 있다. 그 가운데 같은 줄기에서 뒤에 나온 판 아홉 쌍을 보면, 여섯 쌍은 정답이 오히려 줄었다. 정답 수가 똑같았던 한 쌍에서도, 열 번 중 다섯 번 이상 더 맞히게 된 질문이 넷, 그만큼 덜 맞히게 된 질문이 넷 나왔다. 같은 이름의 AI가 판이 바뀌면서 답하는 모양이 달라지는 일을 드리프트(drift)라고 한다.
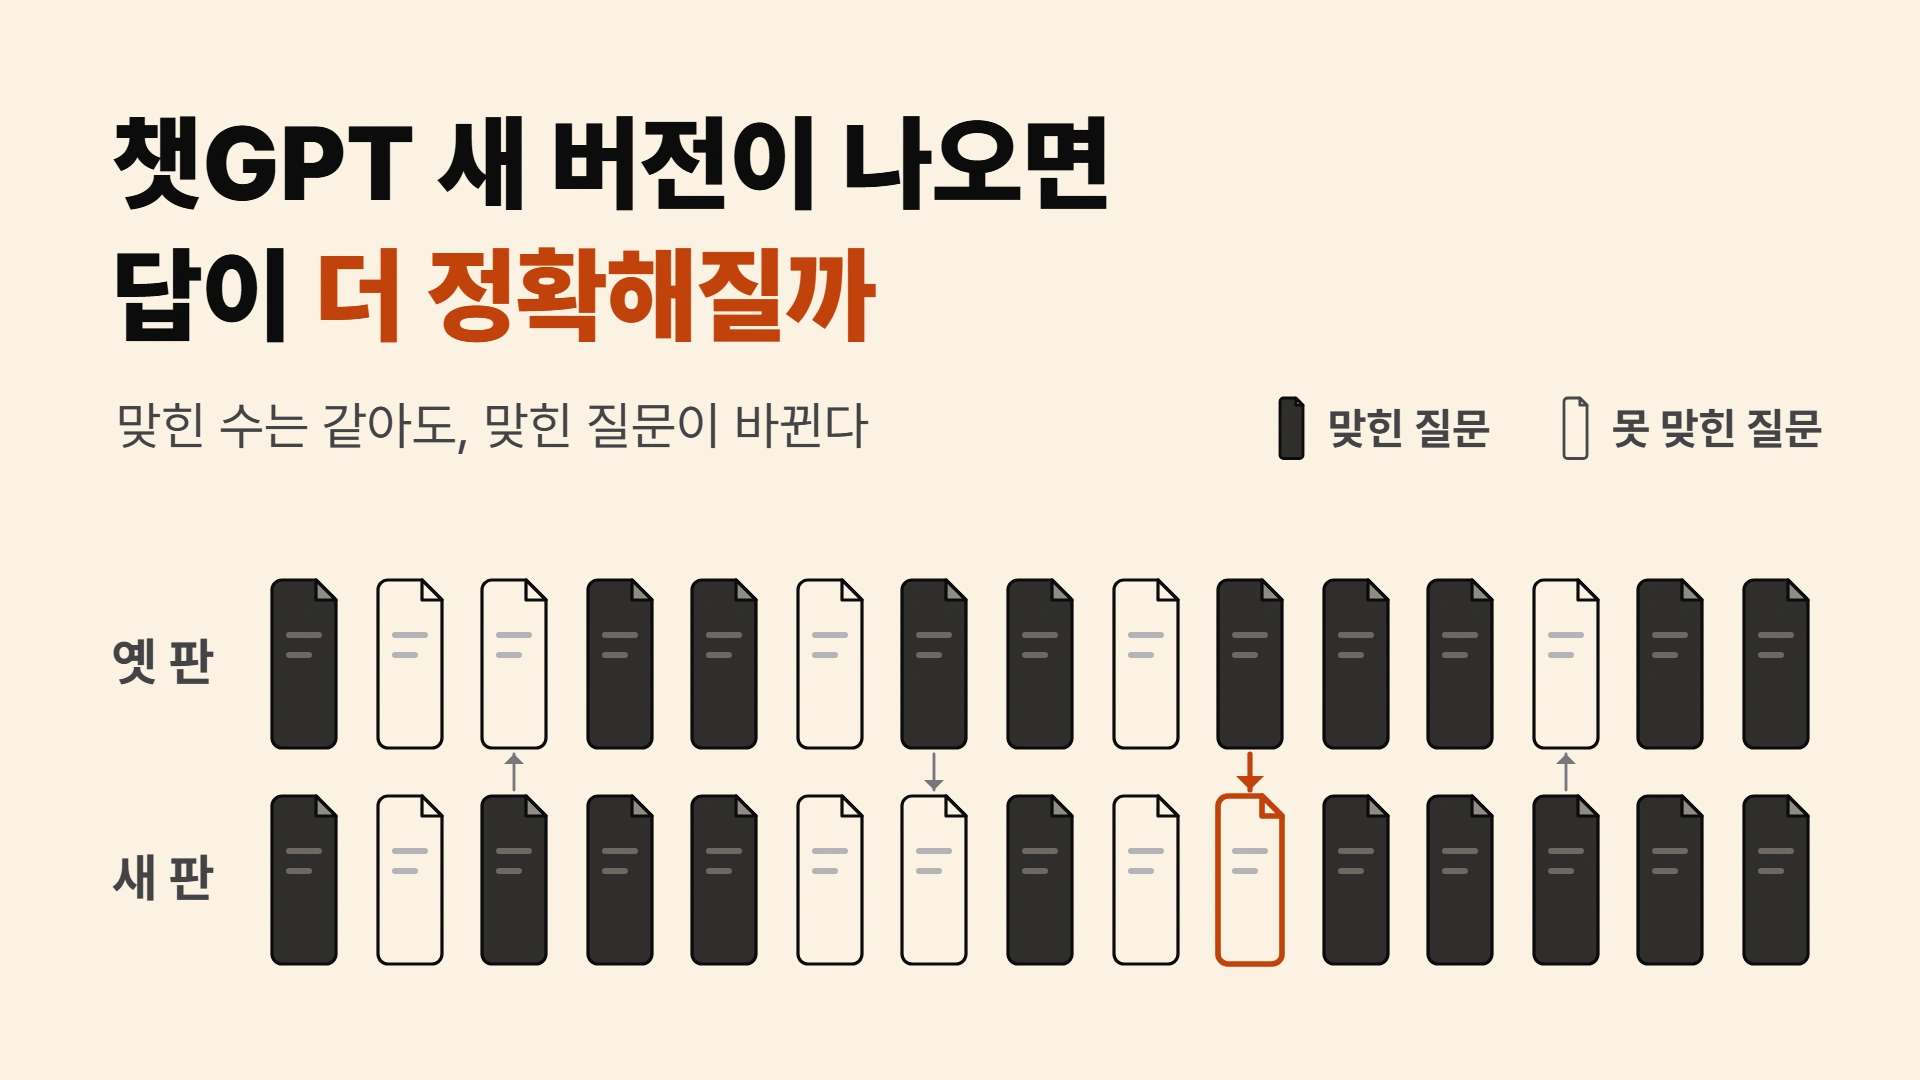
출근길에 챗GPT 앱 맨 위로 모델이 업데이트됐다는 알림이 뜬다. 오늘도 지난달까지 막힘없이 풀어 주던 엑셀 수식 질문을 넣을 참이다. 챗GPT 새 버전이 나오면 답이 더 정확해질까?
새 판이라고 같은 질문을 더 맞히지는 않았다. 판이 바뀌면서 달라진 것은 정답 개수보다 맞히는 질문과 답하는 버릇이었다. 공개 기록 하나는 OpenAI 모델 22개 판에 같은 증상 사연 45개를 10번씩 물었다. 같은 줄기에서 뒤에 나온 판끼리 아홉 쌍을 견주면, 여섯 쌍은 정답이 오히려 줄었다.
정답 수가 같은 쌍도 있었다. o3-mini에서 o4-mini로 넘어간 쌍은 450번 중 312번으로 정답 수가 똑같았다. 그런데도 열 번 중 다섯 번 이상 더 맞히게 된 질문이 넷, 그만큼 덜 맞히게 된 질문이 넷 나왔다. 2023년 GPT-4 성능 저하의 대표 숫자였던 소수 판별 정답 감소도, 문항별로 세면 답이 한쪽으로 쏠려 생겼다. 그래서 새 판이 나오면 「평균이 올랐나」보다 「내가 묻는 종류의 질문에서 어떻게 바뀌었나」를 따로 봐야 한다.
평균으로 보면, 뒤에 나온 판이 더 맞히지 않았다
베를린 공과대학의 Kopka 외 연구진은 실제 온라인에 올라온 증상 사연을 다듬어, 사연 45개를 OpenAI 모델 22개 판에 10번씩 물었다. 모델은 사연마다 응급(바로 응급실), 비응급 진료(병원에 가 볼 일), 자가 관리(집에서 지켜볼 일) 세 칸 가운데 하나를 골랐다. 정답은 의사 두 사람이 합의한 칸이다. 사연 45개 가운데 정답이 응급인 것이 2개, 비응급 진료가 30개, 자가 관리가 13개다. 새 판이 나오면 그 판만 새로 물었고, 묻는 일은 2025년 1월부터 2026년 1월까지 다섯 차례 있었다. 영어로, 세 칸 가운데 하나만 고르게 한 시험지(그림 각주의 「3칸 강제 선택」)라서 실제 대화에서의 정확도와는 다를 수 있다.
여기서 「판」은 모델 이름 하나하나를 가리킨다. 제목의 「새 버전」도 이 글에서는 뒤에 나온 판을 말한다. 같은 GPT-5 줄기에도 gpt-5, gpt-5.1, gpt-5.2처럼 뒤따라 나온 판이 있다. 연구진은 이 줄기의 판마다 답하기 전에 생각하는 단계를 켜고 한 번, 끄고 한 번 따로 물었다. 그래서 판 이름 뒤에 그 단계를 켠 쪽은 「(추론 설정)」, 끈 쪽은 「(추론 끈 설정)」을 붙여 가른다.
판마다 450번(사연 45 × 10번) 가운데 맞힌 횟수를 세면, 가장 많이 맞힌 판은 2025년 1월 9일에 물은 o1-mini로 331번(73.6%)이었다. 가장 적게 맞힌 판은 gpt-4.1-nano로 196번(43.6%)이었다. 마지막 회차인 2026년 1월 23일에 물은 gpt-5.2(추론 설정)는 234번(52.0%)을 맞혀, 1년 먼저 물은 o1-mini보다 97번 적었다. 그림 1는 22개 판을 출시 순서대로 놓은 것이다.
출시 순서로 바로 옆에 놓인 판끼리 견주면, 줄기가 다른 판이 이웃이 되기도 한다. 그래서 o3-mini 다음의 o4-mini, gpt-5 다음의 gpt-5.1처럼 같은 줄기·같은 설정에서 뒤에 나온 판끼리만 아홉 쌍을 골라 견줬다. 이 글은 이런 판을 후속판이라 쓴다. 후속판 아홉 쌍 가운데 정답이 줄어든 쌍이 여섯, 늘어난 쌍이 둘, 같은 쌍이 하나였다. 쌍마다 늘고 준 것을 센 결과다. 새 판일수록 나빠지는 흐름이 우연으로도 나올 만한 크기인지는 따져 보지 않았다.

Our results show that average accuracy remains relatively constant across models and does not improve with newer iterations.
우리 결과에서 평균 정확도는 모델이 달라져도 비교적 일정하게 머물렀고, 새 판이 나와도 나아지지 않았다.
Kopka 외, Communications Medicine (2026)저자들은 판을 출시 순서대로 놓고 보았을 때 나아지는 흐름을 보지 못했다고 적었다. 판이 바뀌어도 앱에서 부르는 이름은 그대로 챗GPT다. 이렇게 같은 이름 아래에서 판이 바뀌며 답하는 모양이 달라지는 일을 드리프트(drift)라고 한다. 업데이트 알림의 「새 판」이라는 이름은, 평균 정답 수로 견줘도 「더 맞히는 판」을 약속하지 않았다.
질문 하나하나로 보면, 맞히는 질문이 바뀌었다
평균이 같은 두 판이라도 같은 질문에 같은 답을 내지는 않는다. 질문 하나하나를 견주기 전에 알아 둘 것이 있다. 같은 판에 같은 질문을 10번 물어도 답이 갈린다는 점이다. 이 시험은 같은 질문에도 답이 조금씩 다르게 나오게 해 둔 기본 설정으로 물었다. 왜 그렇게 되는지는 같은 질문에 챗봇 답이 달라지는 이유에서 다뤘다.
그래서 셈은 질문마다 10번 가운데 맞힌 횟수로 한다. 옛 판과 새 판에서 그 횟수를 견줘, 늘었으면 더 맞힌 질문, 줄었으면 덜 맞힌 질문, 같으면 「그대로」다. 더 맞힌 질문 가운데 1~4번 더 맞히면 「오름」, 5번 이상 더 맞히면 「크게 오름」이다. 덜 맞힌 쪽도 같은 자로 「내림」과 「크게 내림」을 가른다. 예컨대 옛 판이 10번 다 맞히던 질문을 새 판이 2번만 맞히면 크게 내린 질문이다.
답이 흔들리기만 해도 오르내림은 생긴다. 그 크기를 재려면 한 질문에 대한 두 판의 답 스무 번을 한데 섞어, 열 번씩 두 묶음으로 다시 나눠 본다. 두 판이 사실 같은 판이었다면 나왔을 오르내림이 이렇게 만들어진다. 나누는 방법마다 값이 달라서, 그 평균을 「같은 판을 다시 물을 때의 흔들림 기대」라고 적는다. 이렇게 셈하면 흔들림만으로 크게 내리는 질문은 후속판 쌍마다 0.07~0.28개쯤이다. 흔들림만이라면 한 쌍에서 크게 내린 질문이 하나도 안 나오는 것이 보통이다.
대표로 볼 쌍은 o3-mini → o4-mini다. 두 판은 450번 가운데 똑같이 312번을 맞혔다. 질문 45개로 나눠 보면 새 판이 더 맞힌 질문이 8개, 덜 맞힌 질문이 11개, 그대로인 질문이 26개다. 같은 판을 다시 물을 때의 흔들림 기대는 더 맞힌 질문과 덜 맞힌 질문이 각각 8.2개쯤이다. 8개와 11개는 이 기대에서 멀지 않아서, 이만한 오르내림은 같은 판끼리도 나온다.
흔들림을 넘는 것은 크게 바뀐 질문이다. 더 맞힌 8개 가운데 넷이 크게 올랐고, 덜 맞힌 11개 가운데 넷이 크게 내렸다. 흔들림만이라면 각각 0.21개쯤 나오는 크기다. 바뀐 자리도 갈렸다. 크게 오른 넷은 모두 자가 관리 사연이었고, 크게 내린 넷은 모두 비응급 진료 사연이었다.
자가 관리 사연에서 맞힌 횟수는 130번 중 22번에서 61번으로 늘었고, 비응급 진료 사연에서는 300번 중 270번에서 231번으로 줄었다. 정답 수는 그대로인데, 맞히는 질문의 종류가 옮겨 간 셈이다. 다른 쌍에서 크게 내린 칸이 어느 묶음에 모이는지는 그림 2의 판 쌍 번호 칸에 1~15를 넣어 찾을 수 있다. 1~9번은 후속판 쌍이다. 10~15번은 견주어 보라고 넣은 쌍으로, 크기만 다른 판끼리이거나 답하기 전에 생각하는 단계를 얼마나 길게 두느냐만 다른 판끼리다(그림 알약의 「생각 시간만 다른 판」).
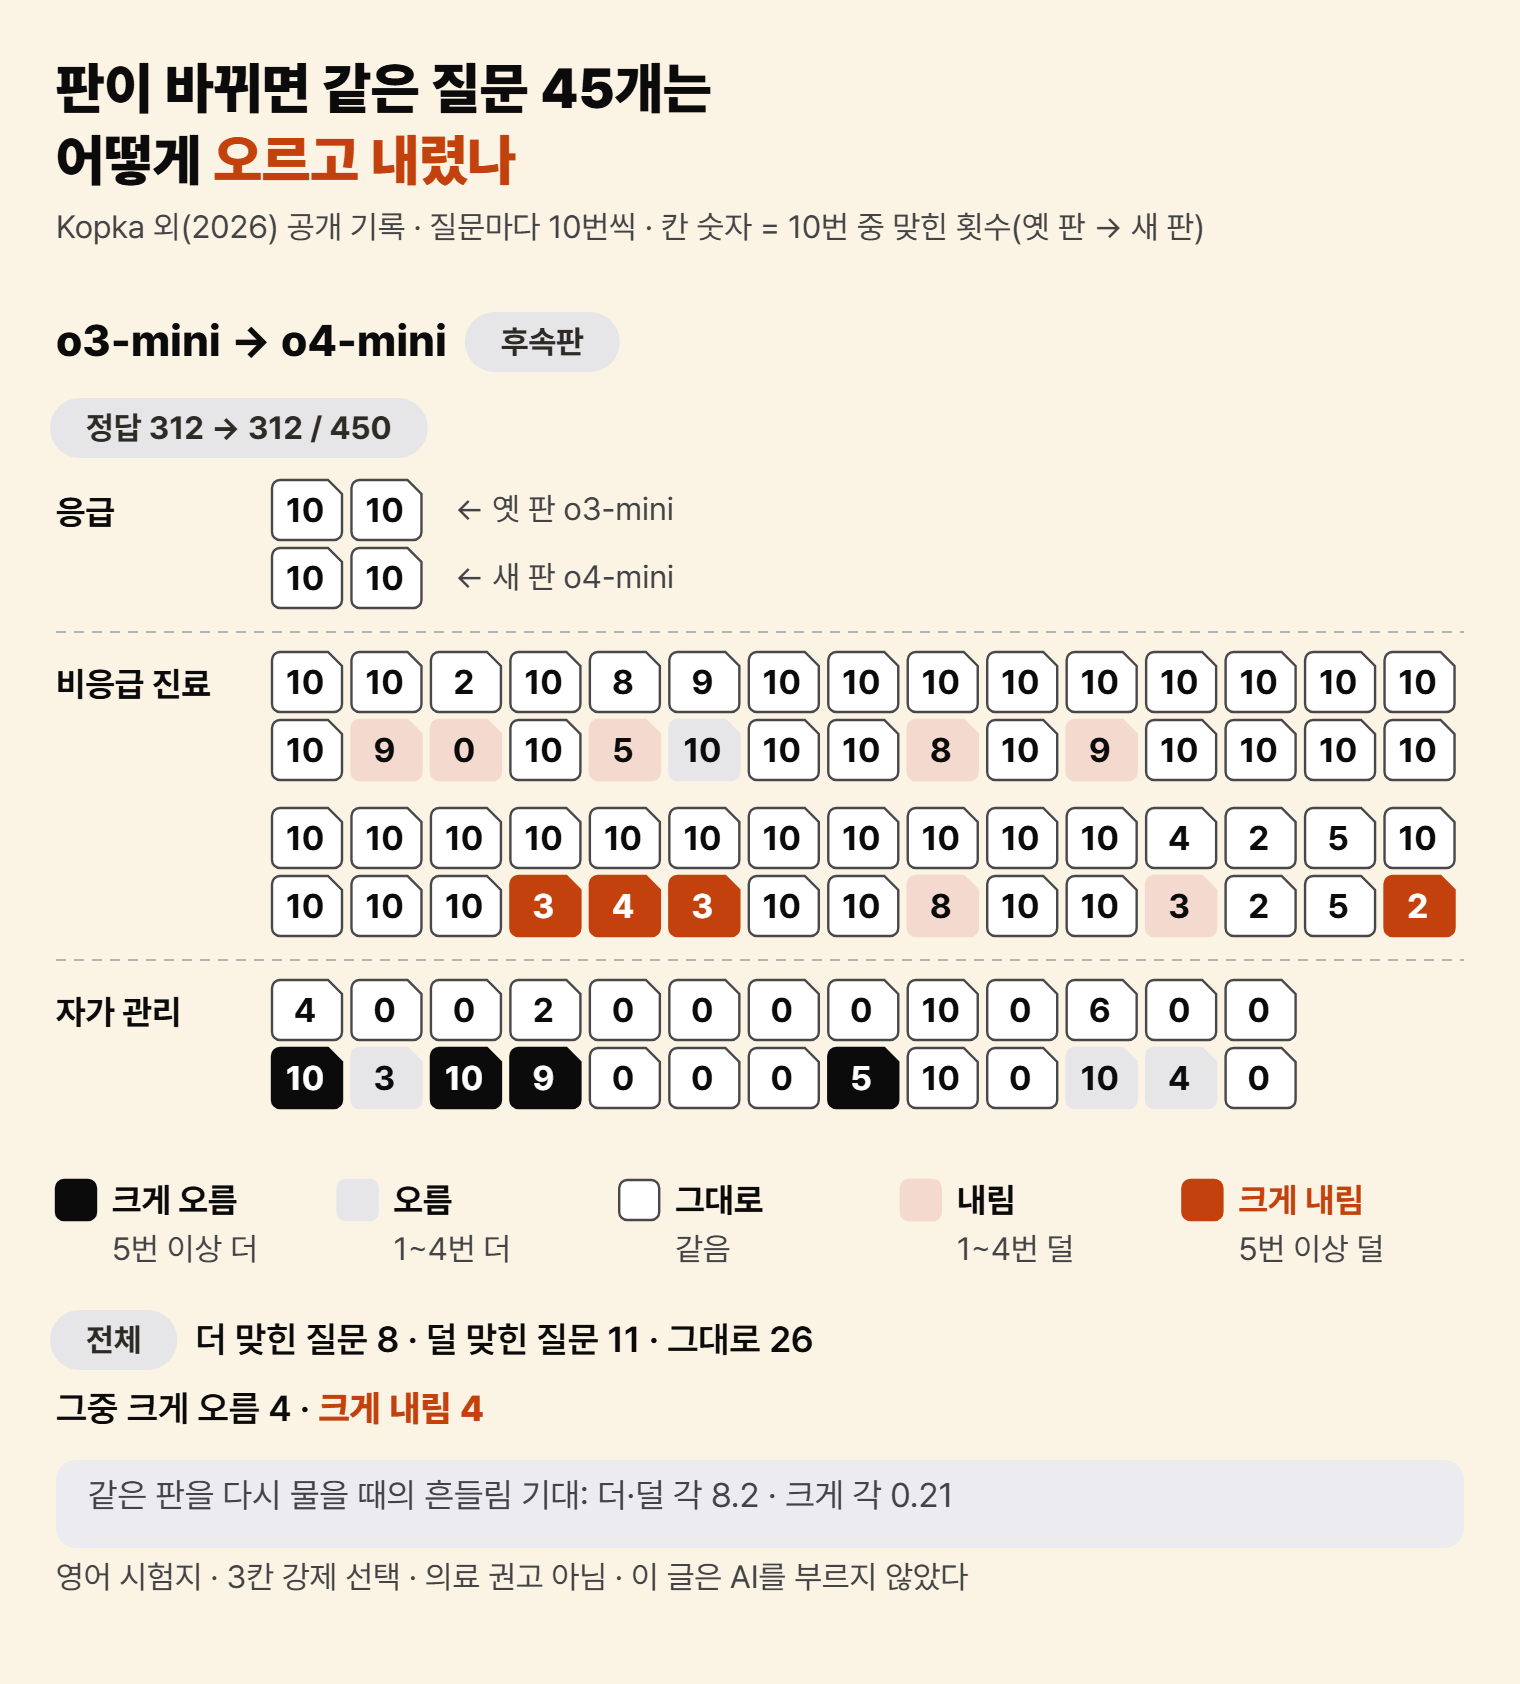
o3-mini와 o4-mini는 정답 수가 똑같은 두 판이다. 그래도 o3-mini가 10번 다 맞히던 비응급 진료 질문 넷을, o4-mini는 2~4번만 맞혔다. 내가 묻는 질문이 이 넷 가운데 있었다면, 정답 수가 같은 새 판이 나에게는 더 못한 판이었다.
새 판이 나왔을 때 내 질문으로 확인하는 순서
같은 셈을 내 질문으로 해 볼 수 있다. 앞 절처럼 옛 판과 새 판의 답을 질문마다 견주되, 흔들림부터 재 두는 것이 핵심이다. 판이 바뀌기 전에 시작해야 하는 일이라 순서가 중요하다.
- 자주 묻는 질문 몇 개를 정해 두고, 지금 판의 답을 적어 둔다. 답이 맞는지 내가 판정할 수 있는 질문으로 고른다. 정답이 있는 계산, 사실 확인, 내 일에 쓰는 자료 같은 것이다.
- 같은 질문을 같은 판에 몇 번 다시 물어, 답이 얼마나 흔들리는지 먼저 적는다.
- 새 판이 나오면 같은 질문을 2단계와 같은 횟수로 다시 묻는다. 2단계의 흔들림보다 크게 바뀐 질문만 「바뀌었다」로 센다. 그림 2의 주황색 크게 내림 칸이 이렇게 「바뀌었다」로 셀 질문의 본보기다.
앞 절의 「10번 중 5번 이상」은 10번씩 물었을 때의 문턱이다. 묻는 횟수가 다르면 그 문턱을 그대로 옮겨 쓸 수 없어서, 2단계에서 잰 흔들림을 기준으로 삼는다. 앱에서는 옛 판을 다시 고르기 어려우니, 이 순서로 재면 판이 바뀐 몫과 묻는 때가 달라진 몫이 함께 섞인다. Kopka 기록의 후속판 아홉 쌍 가운데 여섯 쌍도 두 판을 다른 날 물어서, 같은 섞임이 있다. 그래도 내가 묻는 질문에서 무엇이 크게 달라졌는지는 이 순서로 잡힌다.
2023년 챗GPT 성능 저하의 대표 숫자는 답이 한쪽으로 쏠려 생겼다
GPT-4가 전보다 못해졌다는 보도는 2023년 여름에 나왔다. 근거가 된 연구는 스탠퍼드와 UC 버클리의 Chen·Zaharia·Zou가 논문 공유 사이트 arXiv에 올린 논문이다. 이 논문은 이듬해 Harvard Data Science Review에 실렸다. 논문은 몇 차례 고쳐졌고, 아래 수치는 소수와, 소수가 아닌 합성수를 함께 넣은 개정판(v3)의 것이다.
논문이 견준 「3월판」과 「6월판」은 판이 만들어진 때를 이름에 붙인 것이다. 두 판 모두 2023년 7월에 나란히 물었다. 3월에 한 번 묻고 6월에 다시 물은 것이 아니고, 앱이 몰래 바뀌는지를 잰 연구도 아니다.
시험은 수 1,000개를 하나씩 주고 소수인지 묻는 것이었다. 소수 500개는 7월 2일에, 합성수 500개는 7월 24일에 물었다. GPT-4의 정답은 3월판 840개에서 6월판 511개로 줄었다(84.0% → 51.1%).
그런데 6월판은 1,000문항 가운데 987번을 「아니다(합성수)」라고 답했다. 맞던 것이 틀린 476문항은 전부 소수였고, 틀리던 것이 맞은 147문항은 전부 합성수였다. 그림 3 위쪽의 흐름 그림 두 개가 이 갈림을 소수와 합성수로 나눠 보여 준다.
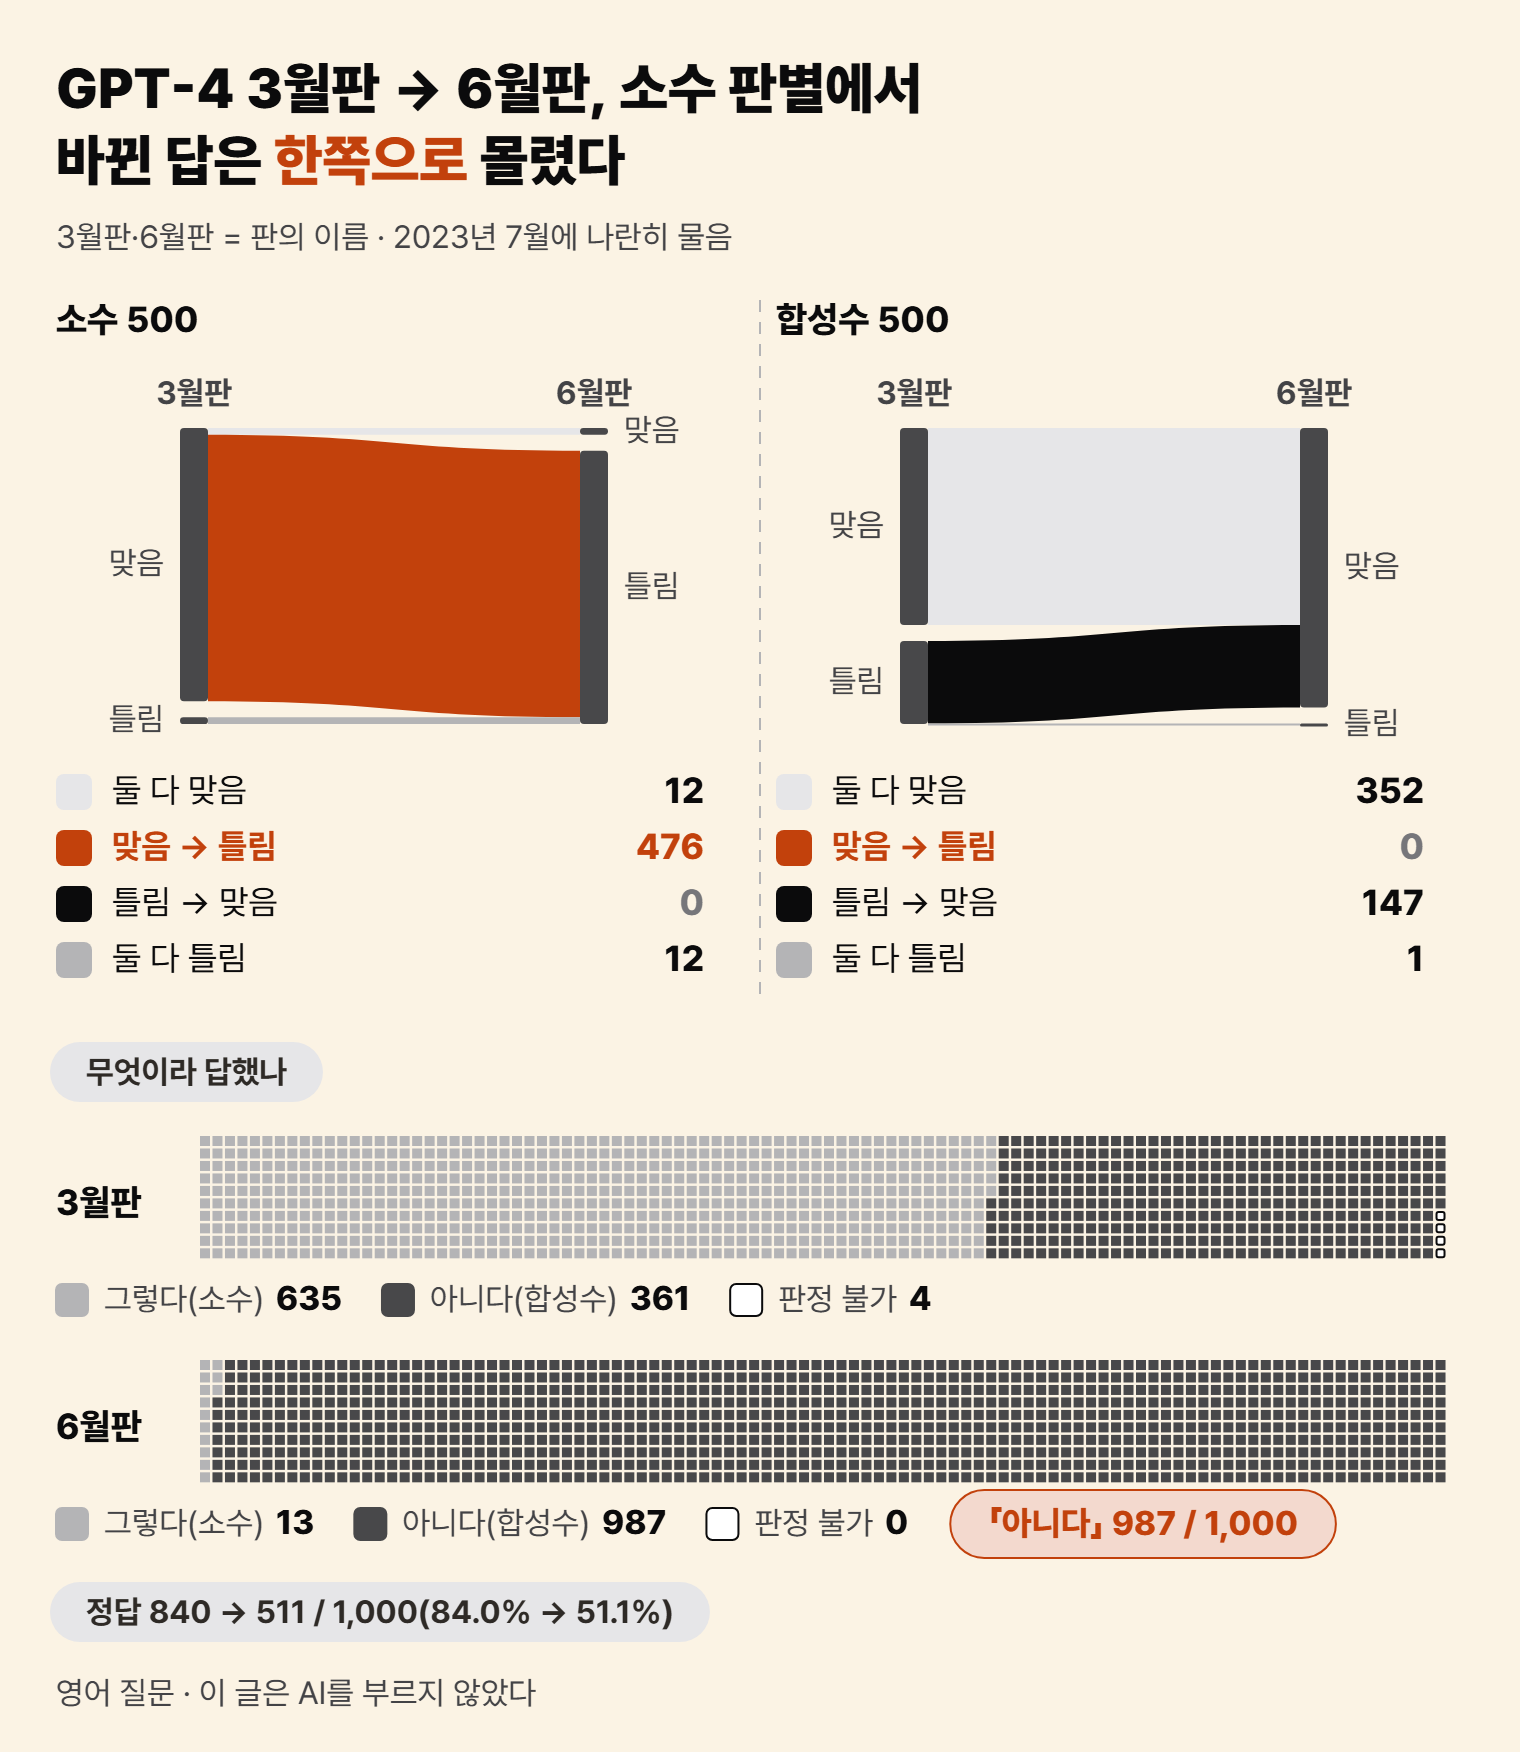
3월판이 소수를 잘 알았던 것도 아니다. 3월판은 합성수 500개 가운데 147개를 「소수」라고 답했고, 1,000문항 전체에서 「그렇다」를 635번 골랐다. 「그렇다」 쪽으로 기울던 답이 6월판에서 반대쪽 끝으로 쏠렸다. 같은 방식으로 견준 GPT-3.5의 두 판은 거꾸로 정답이 496개에서 762개로 늘었다(49.6% → 76.2%).
모든 시험에서 답이 이렇게 쏠린 것은 아니다. 같은 두 판에 미국 의사 면허 시험 문제 340문항을 보기가 빠짐없이 들어간 채로 물은 7월 25일 기록에서는, 답이 바뀐 문항이 20개였다. 맞던 것이 틀린 문항이 16개, 틀리던 것이 맞은 문항이 4개였다. 340문항 가운데 20개라, 소수 판별처럼 한쪽으로 크게 쏠린 모양은 아니었다.
첫 판이 나온 이튿날 이를 비판한 Narayanan·Kapoor는 「None of it suggests a degradation in capability.」라고 적었다. 논문 결과 가운데 능력이 떨어졌음을 가리키는 것은 하나도 없다는 평가다. 두 사람의 글은 동료 심사를 거치지 않은 뉴스레터이고, 비판한 대상도 소수만 넣은 첫 판이었다. 합성수를 더한 개정판으로 다시 세어 봐도, 「성능이 떨어졌다」로 보인 소수 판별의 숫자는 답이 「아니다」 한쪽으로 몰린 결과였다.
틀리는 방향으로 보면, 더 급한 쪽으로 틀리는 버릇도 오르내렸다
답이 한쪽으로 기우는 일은 Kopka 시험지에서도 보인다. 세 칸 시험지에서는 틀린 답에도 방향이 있다. 집에서 지켜볼 사연에 「병원에 가 볼 일」을 골랐다면, 실제보다 더 급한 칸을 고르며 틀린 것이다. 틀린 답 가운데 이렇게 더 급한 칸을 고른 것을 과대분류(overtriage)라고 부른다.
판마다 틀린 답 가운데 과대분류가 몇 번인지 센다. 분모가 그 판이 틀린 횟수라서, 틀린 횟수가 적은 판은 몇 번만 달라도 비율이 크게 움직인다. gpt-3.5-turbo는 틀린 247번이 전부 더 급한 쪽이었다(100%). 가장 낮은 판은 o4-mini다. 틀린 138번 가운데 90번(65.2%)이 더 급한 쪽이었다. 마지막 회차의 gpt-5.2(추론 설정)는 틀린 216번이 전부 더 급한 쪽이었다(100%).
틀린 답이 전부 더 급한 쪽인 판은 gpt-3.5-turbo, o3, gpt-4.1-mini, gpt-4.5-preview, gpt-5.2(추론 설정) 다섯이다. 출시 순서의 맨 앞과 맨 뒤뿐 아니라 가운데에도 끼어 있다. 저자들은 「In newer models, the tendency to overtriage first decreased and then increased again in gpt-5.」라고 적었다. 새 모델에서 과대분류 경향이 먼저 줄었다가 gpt-5에서 다시 늘었다는 서술이다. 다만 판 하나하나를 놓고 보면, 한 번 줄었다 다시 오른 매끈한 곡선은 아니다.
앞에서 본 o3-mini → o4-mini도 이 셈으로 다시 볼 수 있다. 두 판은 틀린 횟수도 138번으로 같았는데, 그중 더 급한 쪽으로 틀린 것은 116번에서 90번으로 줄었다. 이 줄어든 몫은 자가 관리 사연을 더 맞힌 데서 나왔다. 자가 관리는 가장 덜 급한 칸이라, 이 사연에서 틀린 답은 모두 더 급한 쪽이다.
판 22개를 통틀어 보면, 답하기 전에 생각하는 단계를 둔 판 10개가 나머지 12개보다 자가 관리 사연을 평균으로 더 자주 맞혔다. o로 시작하는 판들과 GPT-5 줄기의 「(추론 설정)」 판들이 그 10개다. 그 까닭은 저자들도 가설로만 적었다. o3-mini와 o4-mini는 둘 다 이 단계를 둔 판이라, 앞의 변화는 이 대비 밖에 있다. 이 시험지에서는 판이 바뀌면, 맞히는 질문과 함께 틀리는 방향도 움직였다.
다음 업데이트 알림 앞에서
며칠 뒤 앱에 또 알림이 오고, 이번에는 더 똑똑해졌다는 소개까지 붙어 있다. 그 말이 내가 묻는 질문에도 들어맞는지는 알림 문구에 나오지 않는다. 적어 둔 엑셀 수식 질문을 꺼내 전과 같은 횟수로 다시 물어 본다. 답이 크게 바뀌었다면, 그 변화에는 새 판의 몫 말고도 묻는 날이 달라진 몫이 섞여 있을 수 있다.
챗봇에게 증상을 물어도 병명을 놓치는 이유는 마지막 절에서, 최신 모델이면 나아지는지를 열린 물음으로 남겼다. 이 글이 다시 센 기록은 그 물음의 한 갈래에 답한다. 같은 사연을 22개 판에 물었을 때, 후속판 아홉 쌍 가운데 정답이 늘어난 쌍은 둘뿐이었다.
Kopka의 숫자는 영어로 쓴 사연에서 세 칸 가운데 하나를 고르게 한 시험지 위의 값이다. 그 시험지에서 「새 판」이라는 이름은 더 맞힌다는 보장이 되지 못했다. 정답 수가 똑같은 두 판 사이에서도, 크게 더 맞히게 된 질문과 크게 덜 맞히게 된 질문이 함께 나왔다.
증상 사연 45개는 판끼리 견주는 시험지로만 썼다. 어떤 증상에 어디로 가야 하는지 알려 주는 글이 아니다. Kopka 기록은 영어로 쓴 사연에 세 칸 중 하나만 고르게 한 시험지다. 두 연구 모두 앱 화면이 아니라, 판 이름을 골라 직접 부르는 개발자용 통로로 물었다.
물은 때는 Kopka 연구진이 2025년 1월~2026년 1월, Chen 연구진이 2023년 7월이다. 그 뒤에 나온 판이나 지금 앱의 정확도는 이 기록에 들어 있지 않다. 수치는 두 연구가 공개한 기록(Kopka 9,900행 · Chen 연구진의 응답 원문)을 우리가 다시 센 것이고, AI에게 새로 물은 것은 없다. 판 쌍도 우리가 골랐다.
더 읽기
- Marvin Kopka, Longqi He, Markus A. Feufel, 「Evaluating the accuracy of ChatGPT model versions for giving care-seeking advice」, Communications Medicine 6:171(2026) — https://doi.org/10.1038/s43856-026-01466-0
- Lingjiao Chen, Matei Zaharia, James Zou, 「How Is ChatGPT’s Behavior Changing over Time?」, Harvard Data Science Review 6(2)(2024) — https://doi.org/10.1162/99608f92.5317da47 · arXiv 개정판(v3) https://arxiv.org/abs/2307.09009 · 공개 응답 https://github.com/lchen001/LLMDrift
- Arvind Narayanan, Sayash Kapoor, 「Is GPT-4 getting worse over time?」(뉴스레터, 2023-07-19 — 동료 심사 없음) — https://www.normaltech.ai/p/is-gpt-4-getting-worse-over-time