코딩 에이전트에게 로그인 버그를 맡겼더니 엉뚱한 파일을 고치고, 테스트를 제대로 거치지 않고, 어제 정한 규칙을 어겼다고 해 보자. 어디부터 손볼지는 실수의 이름보다, 작업 기록과 그 턴의 입력에 무엇이 남았느냐로 갈린다. 증거가 가리키는 곳은 지시문이나 그 턴에 넘긴 재료일 때도 있고, 모델을 돌리는 루프·기억·권한일 때도 있다. 지시문과 재료의 바깥에서 모델을 돌리는 이 루프·도구·기억·권한을 설계하는 일을 하네스 엔지니어링(harness engineering)이라고 한다.
장보기 목록을 들고 마트에 가도 기억력이 좋아지지는 않는다. 다만 「무엇을 사야 했더라」를 떠올리는 문제가, 목록을 보고 알아보는 문제로 바뀐다. 이 비유는 AI 에이전트를 정리한 2026년의 한 리뷰 논문이 머리말에서 쓴 것이다. 저자들은 「생각을 돕는 도구는 사람의 능력을 바꾸지 않고, 일을 바꾼다」는 노먼(D. A. Norman)의 말을 첫머리에 싣고, 장보기 목록을 그 말의 예로 든다.
장보기 목록 이야기는 실험 결과가 아니라, 저자들이 논문 전체를 읽어 가는 틀이다. 저자들은 AI를 잘 쓰는 법도 그림 1의 목록이 한 일과 같은 방향으로 바뀌어 왔다고 본다. 논문의 말로는 「바탕 모델은 그대로일 수 있고, 바뀌는 것은 모델에게 건네는 일의 모습」이다.
이 글은 그 변화를 한 가지 상황에 대어 끝까지 따라간다. 이런 상황을 가정해 보자. 코딩 에이전트에게 「로그인 버튼을 누르면 가끔 401 오류가 난다, 고쳐 줘」를 맡겼다. 에이전트는 수정을 내놓고 「고쳤다」고 답한다. 그런데 살펴보니 세 군데가 어긋나 있다.
- (ㄱ) 문제와 관련 없는 파일을 고쳤다. 작업 기록을 보니 로그인 처리 코드는 열어 보지 않고 다른 파일만 읽었다.
- (ㄴ) 테스트를 제대로 거치지 않고 「고쳤다」고 했다.
- (ㄷ) 어제 세션에서 정한 규칙(「인증 모듈은 손대지 말 것」)을 어겼다.
버그의 원인과 정답 코드는 다루지 않는다. 이 글의 주인공은 버그가 아니라, 에이전트가 「고쳤다」고 말하기까지 일하는 방식이다. 이런 실수를 손보는 법을 두고 함께 쓰이는 말이 셋 있다. 2026년 10월 26일 구글 자동완성에는 세 말을 나란히 넣은 검색어와, 「컨텍스트 엔지니어링 하네스 엔지니어링 차이」처럼 차이를 묻는 검색어가 떴다. 이 글은 그 물음을 이렇게 세운다. 프롬프트 엔지니어링, 컨텍스트 엔지니어링, 하네스 엔지니어링은 뭐가 다를까?
셋은 고치는 자리가 다르다. 프롬프트는 지시문을, 컨텍스트는 매 턴 모델에게 넘기는 재료 전체를, 하네스는 그 바깥에서 모델을 돌리는 루프·도구·기억·권한을 고친다. 앞의 경계는 Anthropic의 엔지니어링 글이, 뒤의 경계는 이 리뷰 논문이 그었고, 셋을 한 줄로 이은 것은 이 글의 정리다. 아래에서는 이 세 자리를 차례로 돌며 사례의 세 실수를 고쳐 본다.
하네스 엔지니어링은 지시문과 재료의 바깥을 고친다
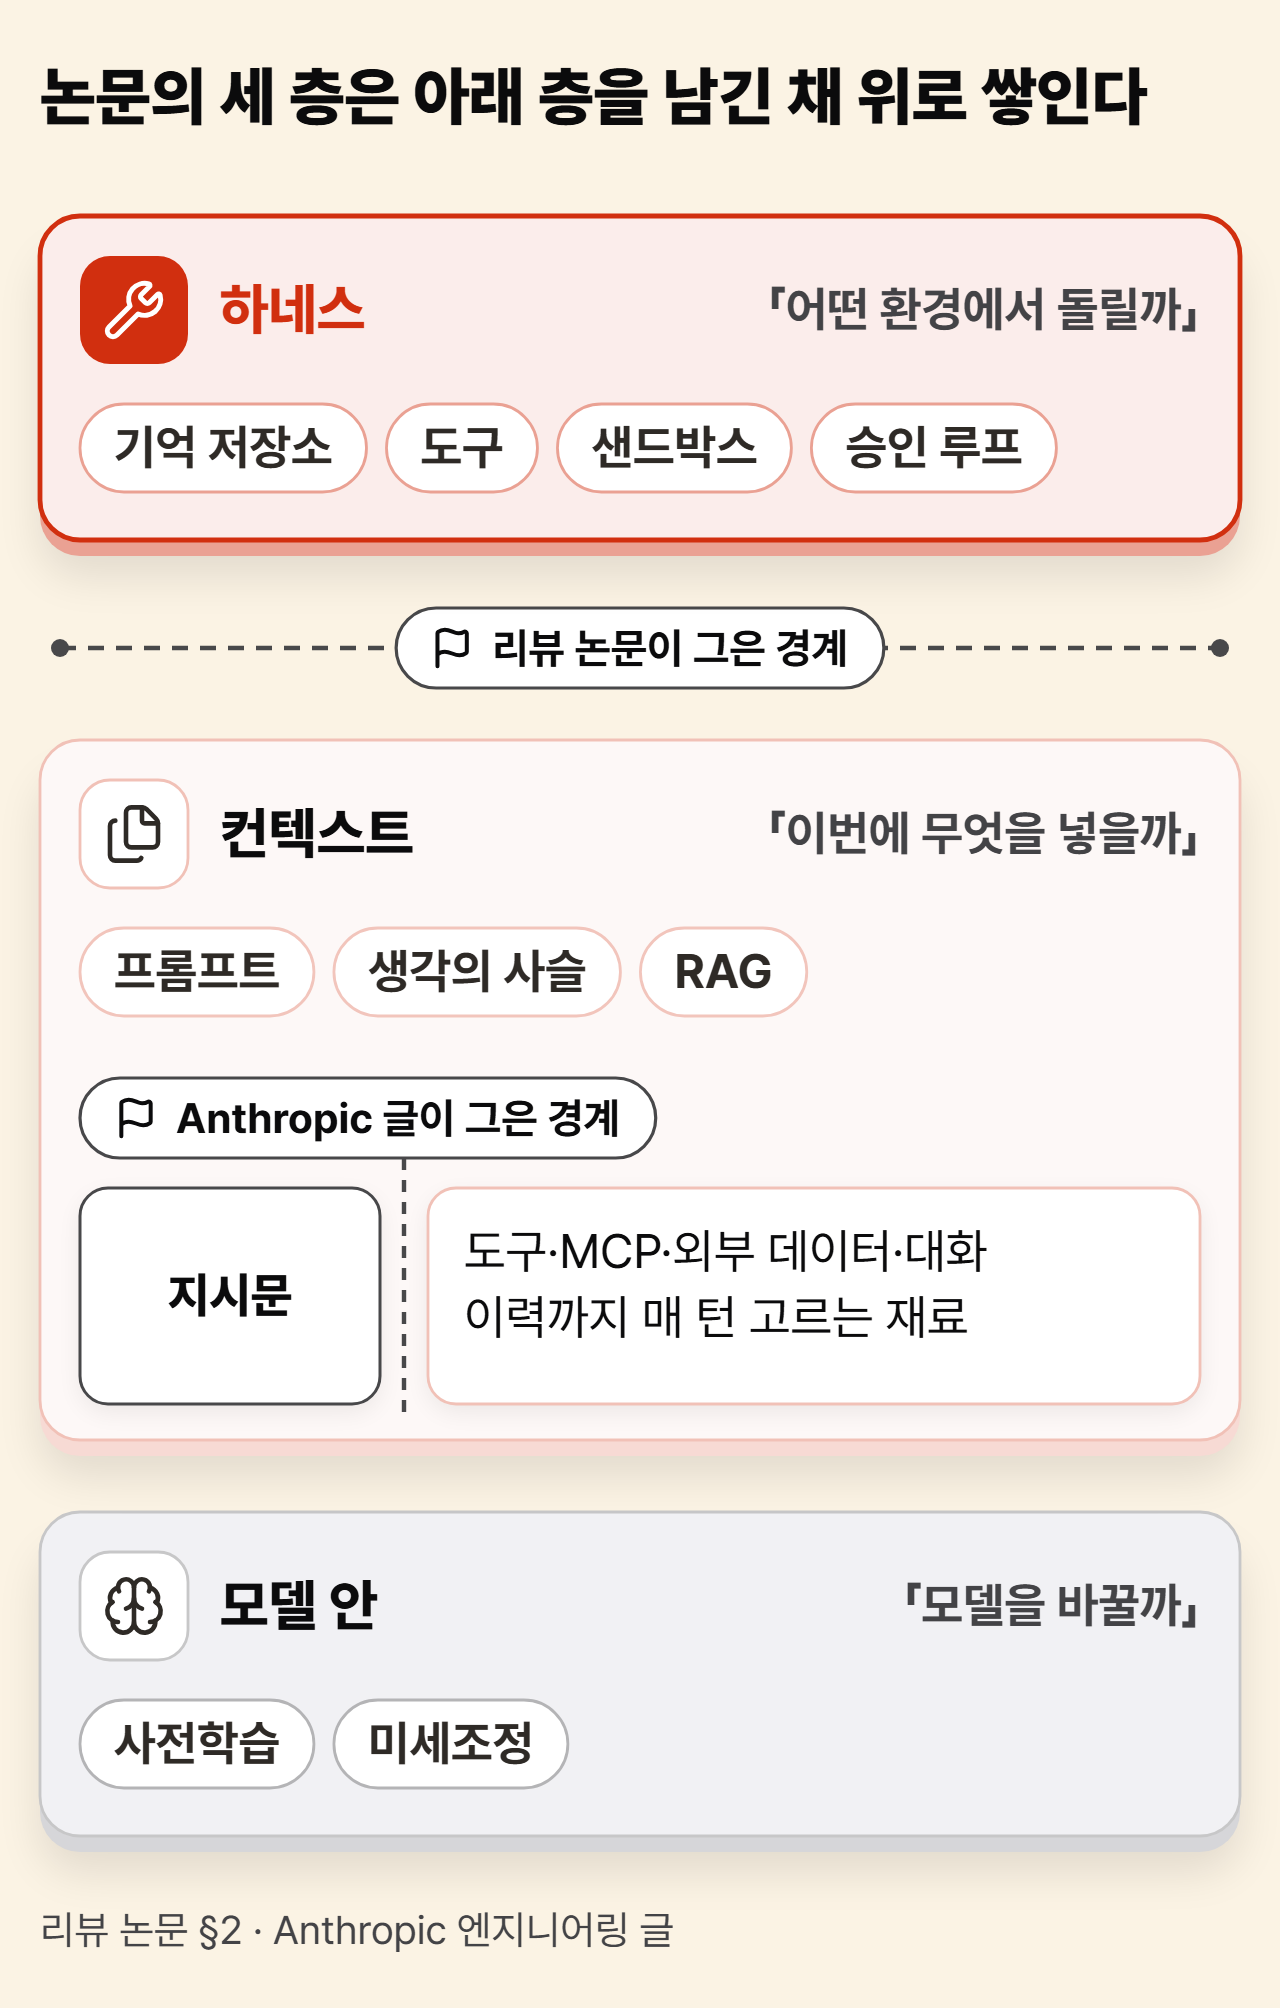
제목의 세 말과 논문이 나눈 세 층은 같은 셋이 아니다. 논문은 AI를 잘 쓰는 법이 옮겨 온 길을 모델 안, 컨텍스트, 하네스의 세 층으로 나눈다. 맨 아래 모델 안 층에서는 「나아진다는 것은 대체로 모델 자체를 고치거나 바꾸는 일」이었다.
프롬프트 엔지니어링은 그다음 컨텍스트 층에서 논문이 맨 먼저 드는 기법이다. 생각의 사슬과 RAG도 같은 층에 든다. 이 블로그의 「단계별로 생각해 봐」를 붙이면 더 잘 맞힐까에서는 그 한 줄이 정답률을 바꾸는지를 봤고, 여기서는 그 기법이 놓이는 층을 본다.
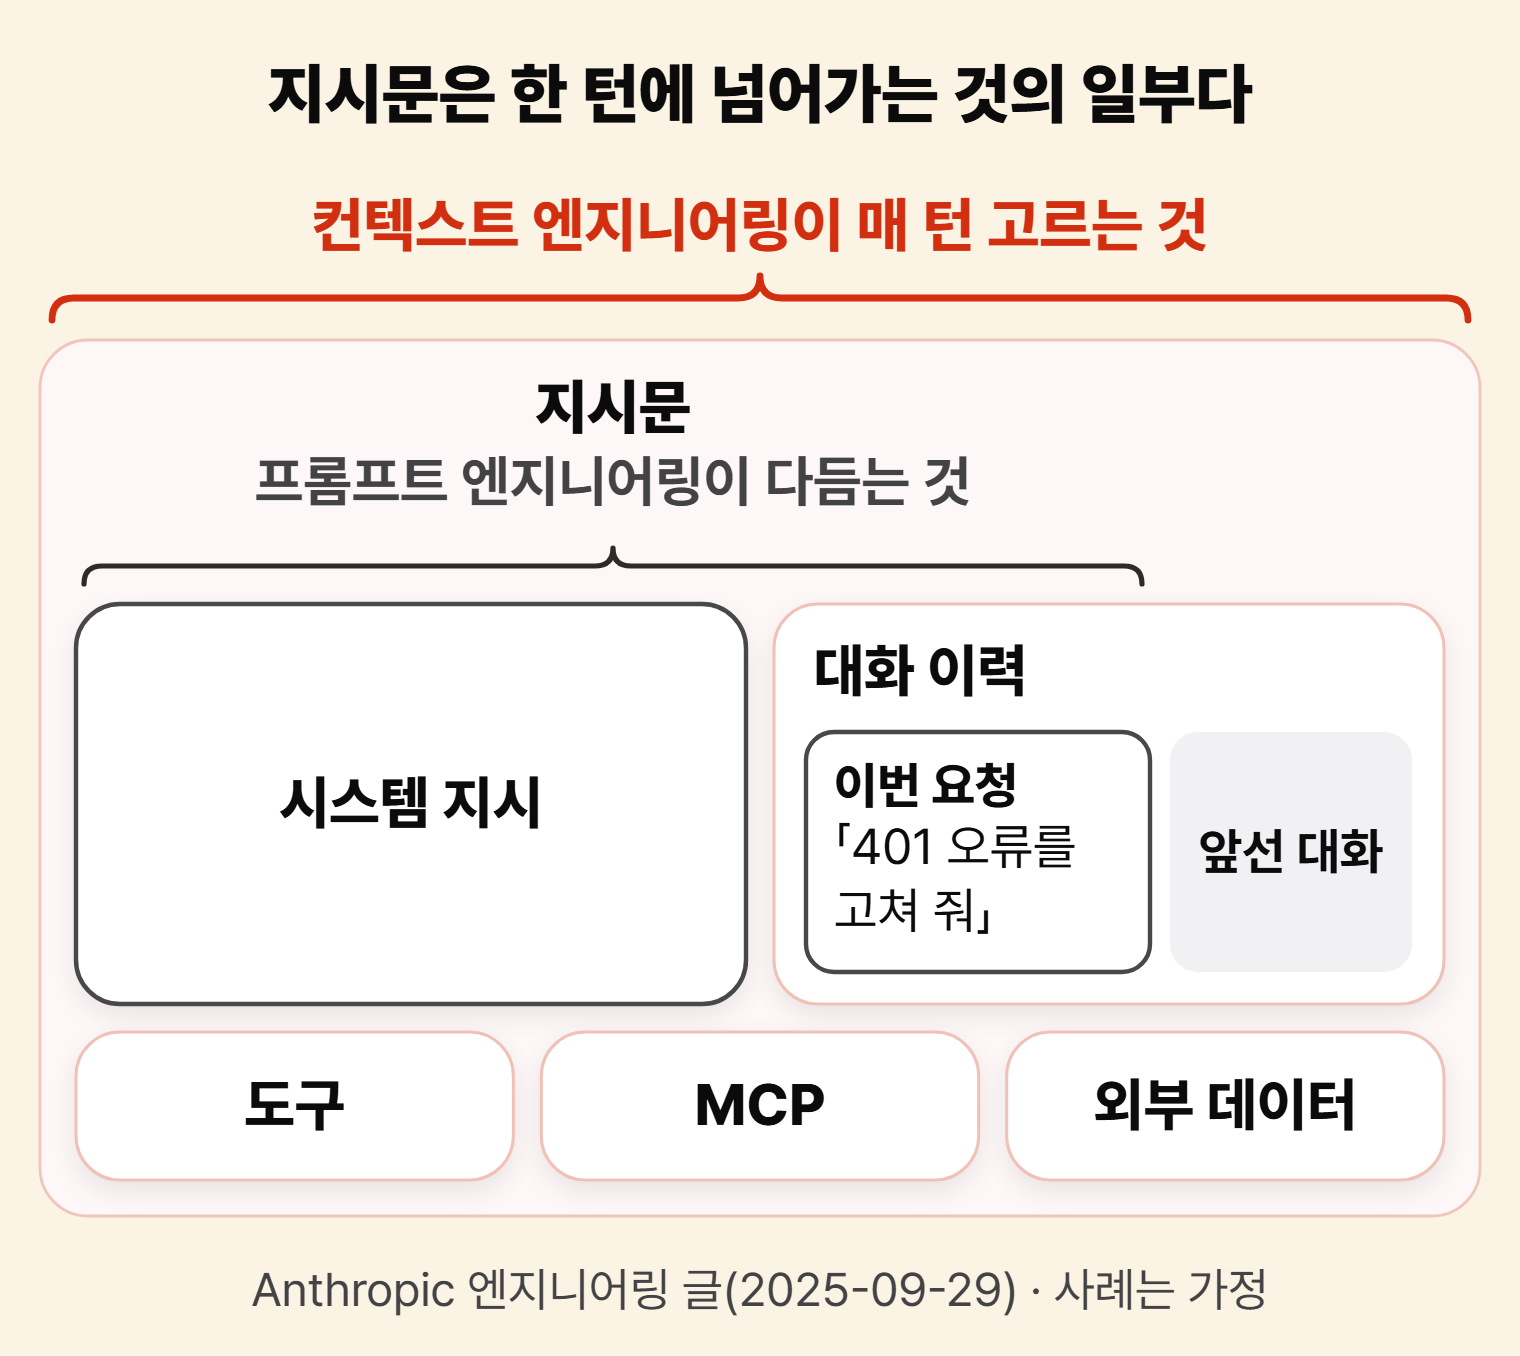
프롬프트와 컨텍스트 사이의 경계는 Anthropic의 엔지니어링 글이 긋는다. 그 글에서 프롬프트 엔지니어링은 LLM에 줄 지시문을 쓰고 정리하는 방법이고, 그 가운데서도 시스템 프롬프트를 특히 다룬다. 컨텍스트 엔지니어링(context engineering)은 추론 중에 모델에 들어갈 가장 알맞은 토큰 묶음을 골라 두고 관리하는 전략이다. 이 사례로 말하면 사용자가 건넨 「401 고쳐 줘」와 시스템 지시가 지시문이다. 그 턴에 함께 넘어가는 앞선 대화, 읽은 파일, 도구 결과까지가 컨텍스트다.
Anthropic 글은 또 프롬프트를 쓰는 일을 따로 떨어진 한 가지 일로, 컨텍스트 엔지니어링을 되풀이되는 일로 대비한다. 고르는 단계가 「모델에 무엇을 넘길지 정할 때마다」 다시 일어난다는 것이다. 그림 2은 한 턴에 모델이 받는 것 가운데 지시문이 어디에 놓이는지를 보여 준다.
컨텍스트 층에도 한계가 있다. 논문은 「컨텍스트 창은 유한하고, 크게 쓰면 비싸며, 관련이 덜한 재료로 채우면 시끄러워지기 쉽다」고 쓴다. 저자들은 지시를 더 줄 수는 있어도, 그렇다고 시스템이 세션을 넘어 상태를 유지하는 법을 알게 되지는 않는다고 지적한다. 시간이 지나도 행동 제약을 지키는 법도 마찬가지다. 사례의 (ㄷ), 곧 어제 정한 규칙을 오늘 세션까지 가져가 지키는 일도 여기에 걸린다. 저자들은 이 지점에서 엔지니어링의 관심이 옮겨 갔다고 보고, 그 변화를 질문 하나로 요약한다.
engineering attention increasingly shifted from “what should we tell the model?” to “what environment should the model operate in?”
엔지니어링의 관심은 점점 「모델에게 무엇을 말해야 할까?」에서 「모델이 어떤 환경에서 일해야 할까?」로 옮겨 갔다.
Zhou 외, 「Externalization in LLM Agents」 §2.3 (arXiv:2604.08224 v1, 2026)이 둘째 질문에 답하는 자리가 하네스(harness)다. 논문은 지금의 능력이 모델에만 있지 않고, 모델이 「무엇을 보고, 기억하고, 부르고, 해도 되는지」를 정하는 구조들에 나뉘어 있다고 쓴다. 이 글에서는 그 구조, 곧 모델을 둘러싸고 이 네 가지를 정하는 실행 환경을 하네스라고 부른다.
코딩 에이전트는 이미 이런 환경 안에서 돈다. 논문은 코딩 에이전트가 파일, 셸, 버전 관리, 테스트를 갖춘 개발용 하네스 안에 모델을 넣는다고 쓴다. 두 출처가 어느 층 사이에 경계를 그었는지는 그림 3에 그렸다. 표 1은 세 자리를 정의만으로 나란히 놓은 것이다.
| 자리 | 바뀐 질문 | 손대는 자리 | 경계를 그은 출처 |
|---|---|---|---|
| 프롬프트 | 모델에게 뭐라고 말할까 | 지시문(시스템 프롬프트와 사용자가 건넨 작업 지시) | Anthropic 글 |
| 컨텍스트 | 이번 턴에 무엇을 넣을까 | 매 턴 넘기는 재료 전체(지시·도구·MCP·외부 데이터·대화 이력) | Anthropic 글 |
| 하네스 | 모델이 어떤 환경에서 일할까 | 모델이 보고·기억하고·부르고·해도 되는 것을 정하는 루프·도구·기억·권한 | 리뷰 논문 |
이 글이 기대는 두 출처는 성격이 다르다. 리뷰 논문(Zhou 외, arXiv:2604.08224 v1, 2026년 4월)은 남의 연구를 모아 틀을 세운 글이다. 그래서 자체 실험이나 수치가 없다. Anthropic 글(2025년 9월 29일)은 회사 엔지니어링 블로그에 실린 정의와 권고다. 그 글에는 「하네스」라는 낱말이 나오지 않으므로, 하네스의 정의는 논문에서만 가져온다.
표 1의 세 줄을 한 표로 묶은 것은 이 글의 정리다(글쓴이 종합). 앞의 두 질문은 세 말에서 이 글이 뽑은 것이고, 셋째 질문은 논문 §2.3의 문장이다. 이렇게 놓고 보면 세 자리는 묻는 것부터 다르다.
프롬프트로는 지시문 한 장을 고친다
가장 먼저 떠오르는 손질은 지시문에 두 가지를 적는 것이다. 하나는 완료 기준(「끝내기 전에 테스트를 돌려라」)이고, 다른 하나는 하지 말 것(「인증 모듈은 건드리지 마라」)이다. Anthropic 글은 이런 지시를 쓸 때 「알맞은 높이(right altitude)」를 찾으라고 하고, 그 양쪽 끝에 흔한 실패 둘을 둔다.
한쪽 끝은 막연한 지시다. 글은 이런 지시가 원하는 결과에 대한 구체적인 신호를 주지 못하거나, 같이 아는 맥락이 있다고 잘못 가정한다고 쓴다. 다른 쪽 끝은 if-else처럼 못 박은 지시다. 복잡하고 깨지기 쉬운 논리를 프롬프트에 박아 넣으면, 지시가 깨지기 쉬워지고 손볼 곳이 시간이 갈수록 늘어난다.
알맞은 높이는 그 사이다. 행동을 이끌 만큼 구체적이면서, 모델이 기댈 판단 기준을 줄 만큼 유연한 지시다. 사례에 맞춰 세 높이의 지시문을 적어 보면 표 2와 같다.
| 높이 | 사례의 지시문(가정) | 무엇이 문제인가 | 근거 |
|---|---|---|---|
| 너무 막연함 | 「로그인 좀 고쳐 줘」 | 원하는 결과에 대한 신호가 없고, 같이 아는 맥락이 있다고 잘못 가정한다 | Anthropic, 알맞은 높이 |
| 알맞은 높이 | 「로그인할 때 가끔 401이 난다. 원인을 찾아 고치고, 끝내기 전에 테스트를 돌려라. 인증 모듈은 건드리지 마라.」 | 행동을 이끌 만큼 구체적이면서 판단의 여지를 남긴다 | 같은 글 |
| 너무 못 박음 | 「이 경우엔 이 줄을, 저 경우엔 저 줄을」처럼 파일과 조건마다 할 일을 줄줄이 정한 지시 | 깨지기 쉽고, 손볼 곳이 시간이 갈수록 늘어난다 | 같은 글 |
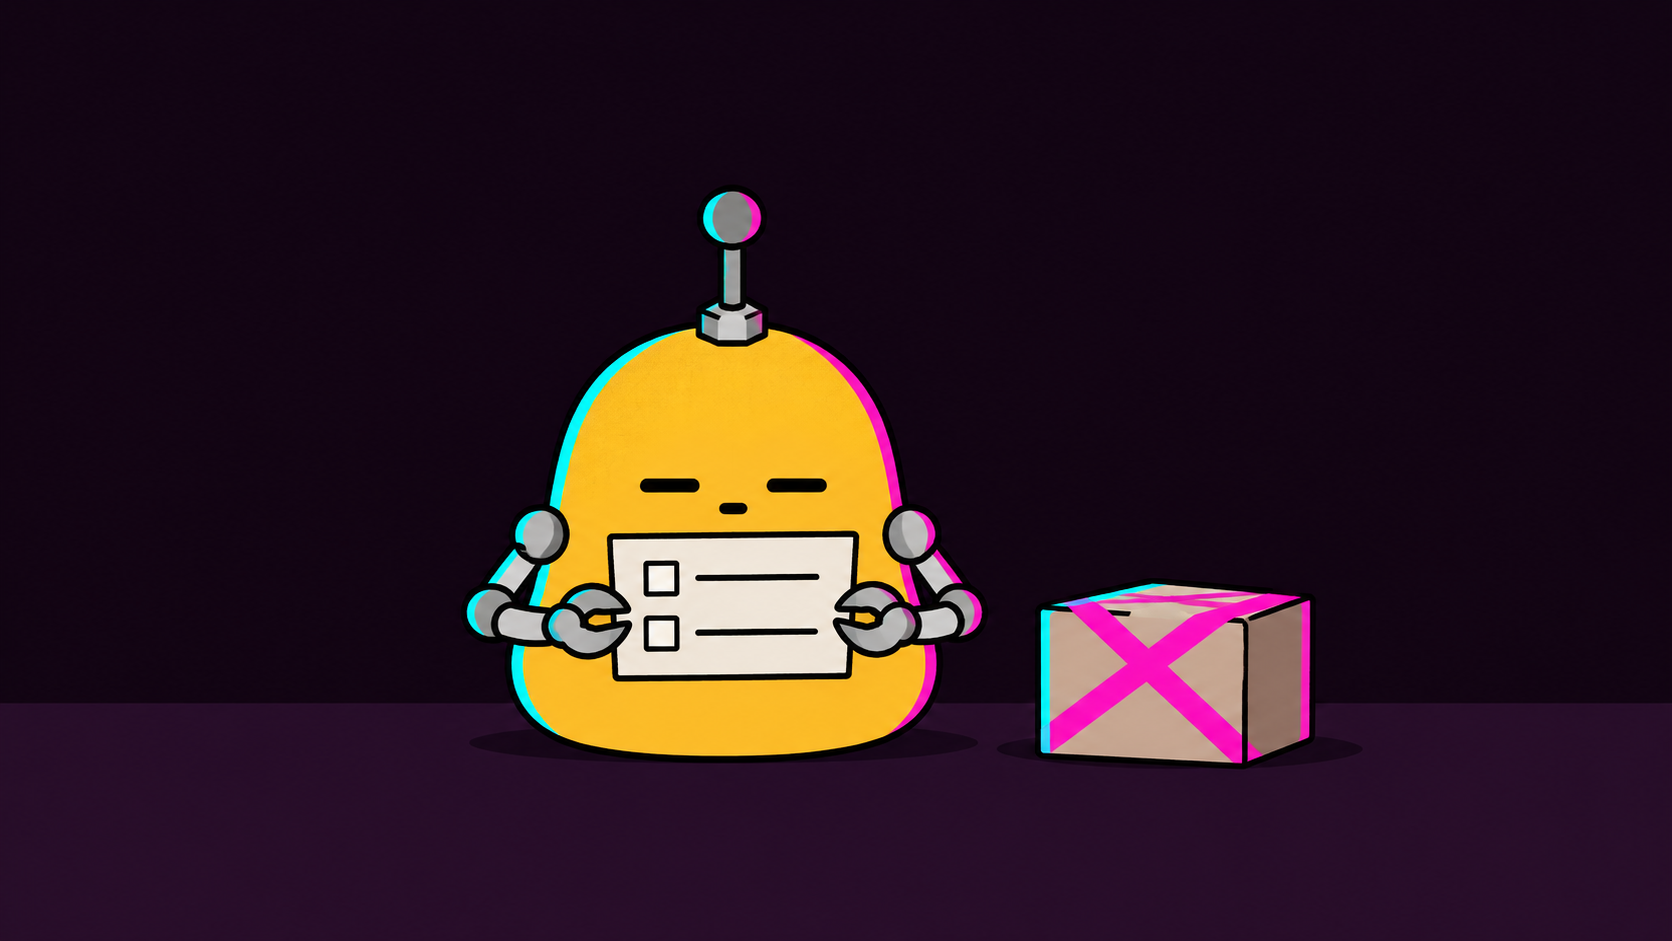
표 2의 세 지시문은 이 글이 지은 가정이다. 이 사례에서는 알맞은 높이의 지시문에 그림 4처럼 완료 기준과 손대지 말 것을 더했다. 이 지시문이 사례의 어디까지 손이 가는지 보려면 (ㄴ)과 (ㄷ)을 조금 더 나눠야 한다. (ㄴ)은 테스트를 아예 돌리지 않고 끝낸 경우(ㄴ-1)와, 돌렸는데 실패한 결과를 넘기고 끝낸 경우(ㄴ-2)로 나뉜다. 어느 쪽인지는 작업 기록이 가른다.
(ㄷ)은 세 물음으로 가른다. 규칙이 어딘가에 저장됐나, 이번 입력에 들어왔나, 들어왔는데도 어겼나. 규칙이 어디에도 저장되지 않았으면 (ㄷ-1), 저장됐는데 이번 입력에 실리지 않았으면 (ㄷ-2), 입력에 있었는데도 어겼으면 (ㄷ-3)이다. 셋째에서 기록으로 확인되는 것은 규칙이 입력에 있었다는 데까지이고, 모델이 규칙을 알았다는 데까지는 아니다.
(ㄴ-1)에서 지시문에 완료 기준이 아예 없었다면, 여기가 먼저 볼 자리다. (ㄷ)의 경우에도 오늘 지시문에 규칙을 적으면, 그 규칙은 이 대화의 입력에는 들어간다. 그러나 그 규칙을 다음 세션까지 가져가는 것은 지시문 밖의 일이다. 논문은 따로 꺼내 두지 않으면 「새 세션은 일부를 잊고 시작한다」고 쓴다. 지시를 더 준다고 시스템이 세션을 넘어 상태를 유지하는 법을 알게 되지는 않는다는 앞의 문장도 여기에 걸린다.
(ㄱ)도 지시문에 고칠 범위를 적어 줄 수는 있다. 하지만 그 턴에 에이전트가 무엇을 찾아 읽었는지는 재료 쪽 이야기다. 지시문이 손보는 것은 그 대화 안의 말이다.
컨텍스트로는 무엇을 언제 실을지 정한다
컨텍스트 쪽에서 먼저 정할 것은 무엇을 처음부터 싣고, 무엇을 그때그때 찾게 하느냐다. Anthropic 글이 드는 예에서 프로젝트 지시 파일(CLAUDE.md)은 처음부터 창에 그대로 실리고, 나머지 파일은 glob·grep 같은 도구로 필요할 때 찾아 읽는다. 글은 둘을 섞은 이 방식을 혼합(hybrid) 전략이라 부른다. 그 가운데 필요할 때 찾아 읽는 쪽이 「그때그때(just in time)」 전략으로, 파일 경로·저장해 둔 질의·웹 링크 같은 가벼운 표지만 들고 있다가 필요할 때 창에 불러온다. 늘 실리는 그 파일을 짧게 쓰는 방법은 이 블로그의 짧은 CLAUDE.md가 더 강한 에이전트를 만든다에서 다뤘다. 여기서는 그 파일이 「처음부터 싣는 것」 자리에 놓인다는 점만 본다.
사례 (ㄱ)에는 단서가 있었다. 기록에 로그인 처리 코드를 읽은 흔적이 없다. 그렇다면 먼저 볼 후보는 그 턴에 무엇을 찾아 읽어 창에 넣었느냐다. Anthropic 글은 안내가 없으면 에이전트가 도구를 잘못 쓰고, 막다른 길을 쫓고, 중요한 정보를 알아보지 못해 창을 낭비할 수 있다고 쓴다.
논문의 실패 분류에서는 맞게 추론했는데 잘못된 재료 위에서 한 실수를 입력 선택 오류라고 부른다. 다만 결과만 보고 원인을 정할 수는 없다. 이 이름은 기록에 그런 단서가 있을 때에야 맞는다.
그렇다고 관련 있어 보이는 파일을 전부 창에 넣는 것도 답이 아니다. Anthropic 글에 따르면, 창에 든 토큰이 많아질수록 모델이 거기서 정보를 정확히 떠올리는 능력이 떨어진다. 글은 재료가 많을수록 흐려지는 이 현상(context rot)을 다루면서, 모델에게 「주의 예산」이 있어 토큰이 하나 들어올 때마다 그 예산이 조금씩 줄어든다고 설명한다. (ㄷ-3)에서 권한·승인 자리와 나란히 입력 구성을 보는 것도 이 때문이다. 흐려지는 현상 자체는 연재 다음 편에서 깊이 다룬다. 이 블로그의 컨텍스트 창 100만 토큰 시대, RAG는 언제 이기고 언제 지는가는 긴 창과 검색을 비용과 정확도로 비교한 실측을 다뤘고, 여기서는 재료가 많을수록 흐려진다는 데서 멈춘다.
작업이 길어지면 창이 찬다. Anthropic 글이 드는 첫 손질은 압축이다. 한계에 가까워진 대화를 요약하고, 그 요약으로 새 창을 열어 이어 간다. 대화 깊이 묻힌 도구 결과를 지우는 것도 가장 가벼운 압축으로 든다. 다만 글은 압축이 지나치면 나중에야 중요해질 미묘한 맥락을 잃을 수 있다고 쓴다.
노트도 있다. Anthropic 글은 에이전트가 할 일 목록이나 NOTES.md 같은 파일에 수시로 적어 두고, 나중에 다시 창으로 읽어 들이는 방법을 든다. 저장해 둔 규칙이 이번 입력에 실리지 않은 (ㄷ-2)를 컨텍스트 쪽에서 손보는 자리가 여기다. 어제 노트에 적어 둔 규칙이 오늘 이번 턴에 읽히게 하는 것이다. 넓게 찾아보는 일은 깨끗한 창을 가진 하위 에이전트에게 맡길 수도 있다. 하위 에이전트가 많이 읽어도 본 창에는 줄인 결과만 돌아오므로, (ㄱ)처럼 어느 파일을 봐야 할지부터 찾아야 할 때 쓸 수 있는 손질이다.
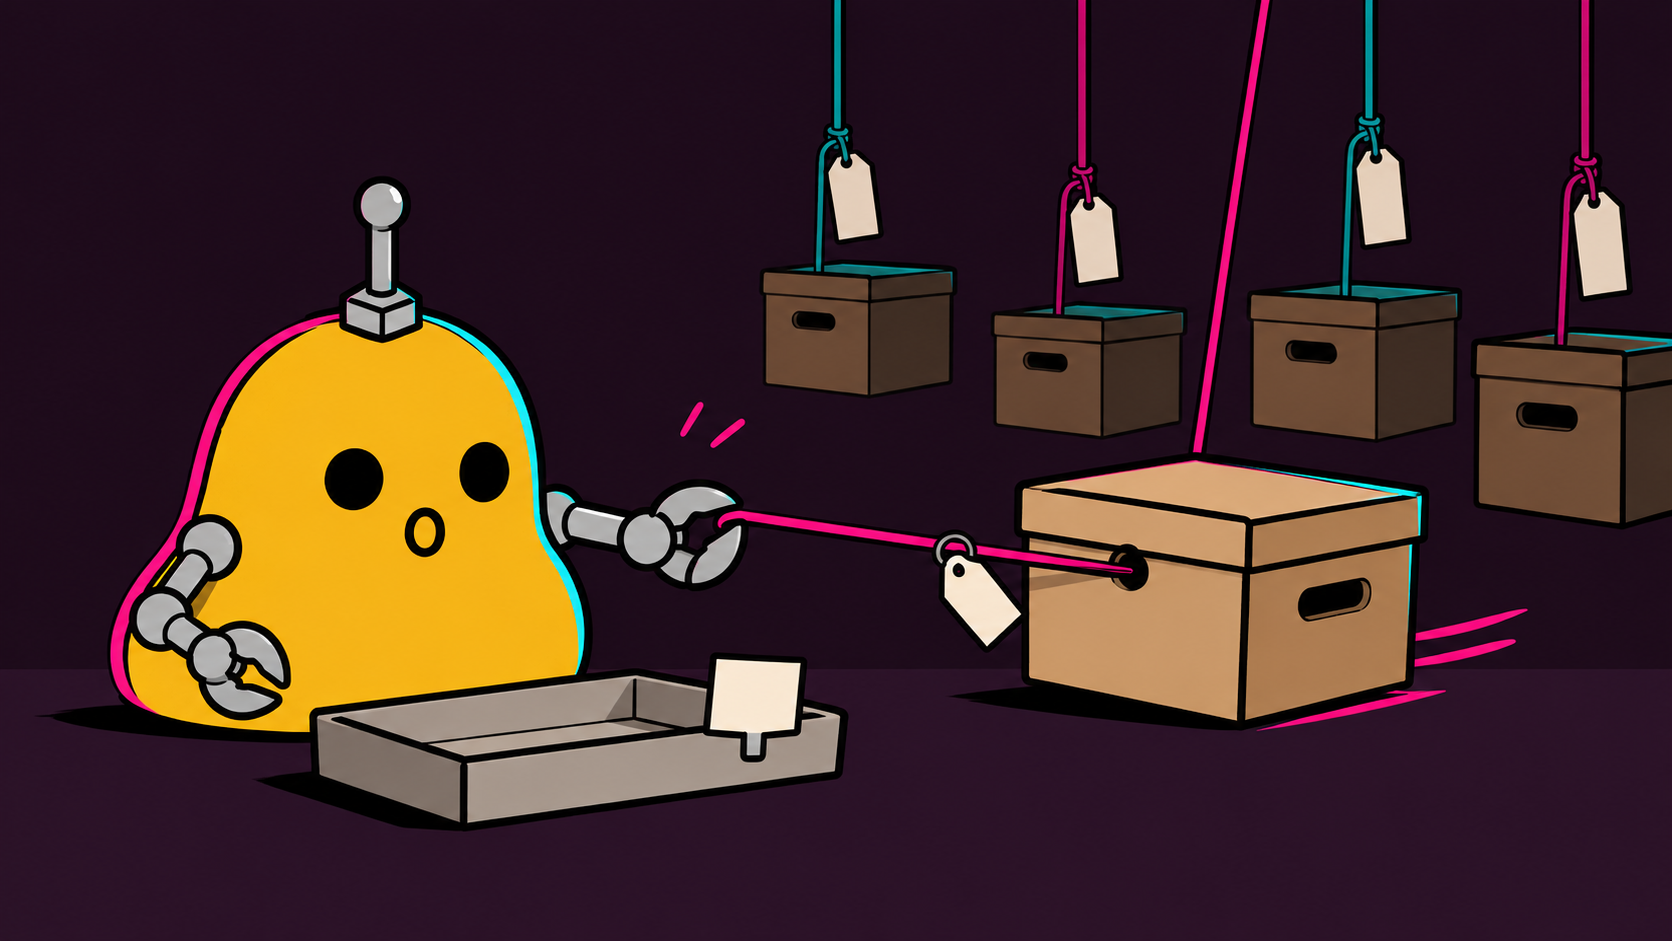
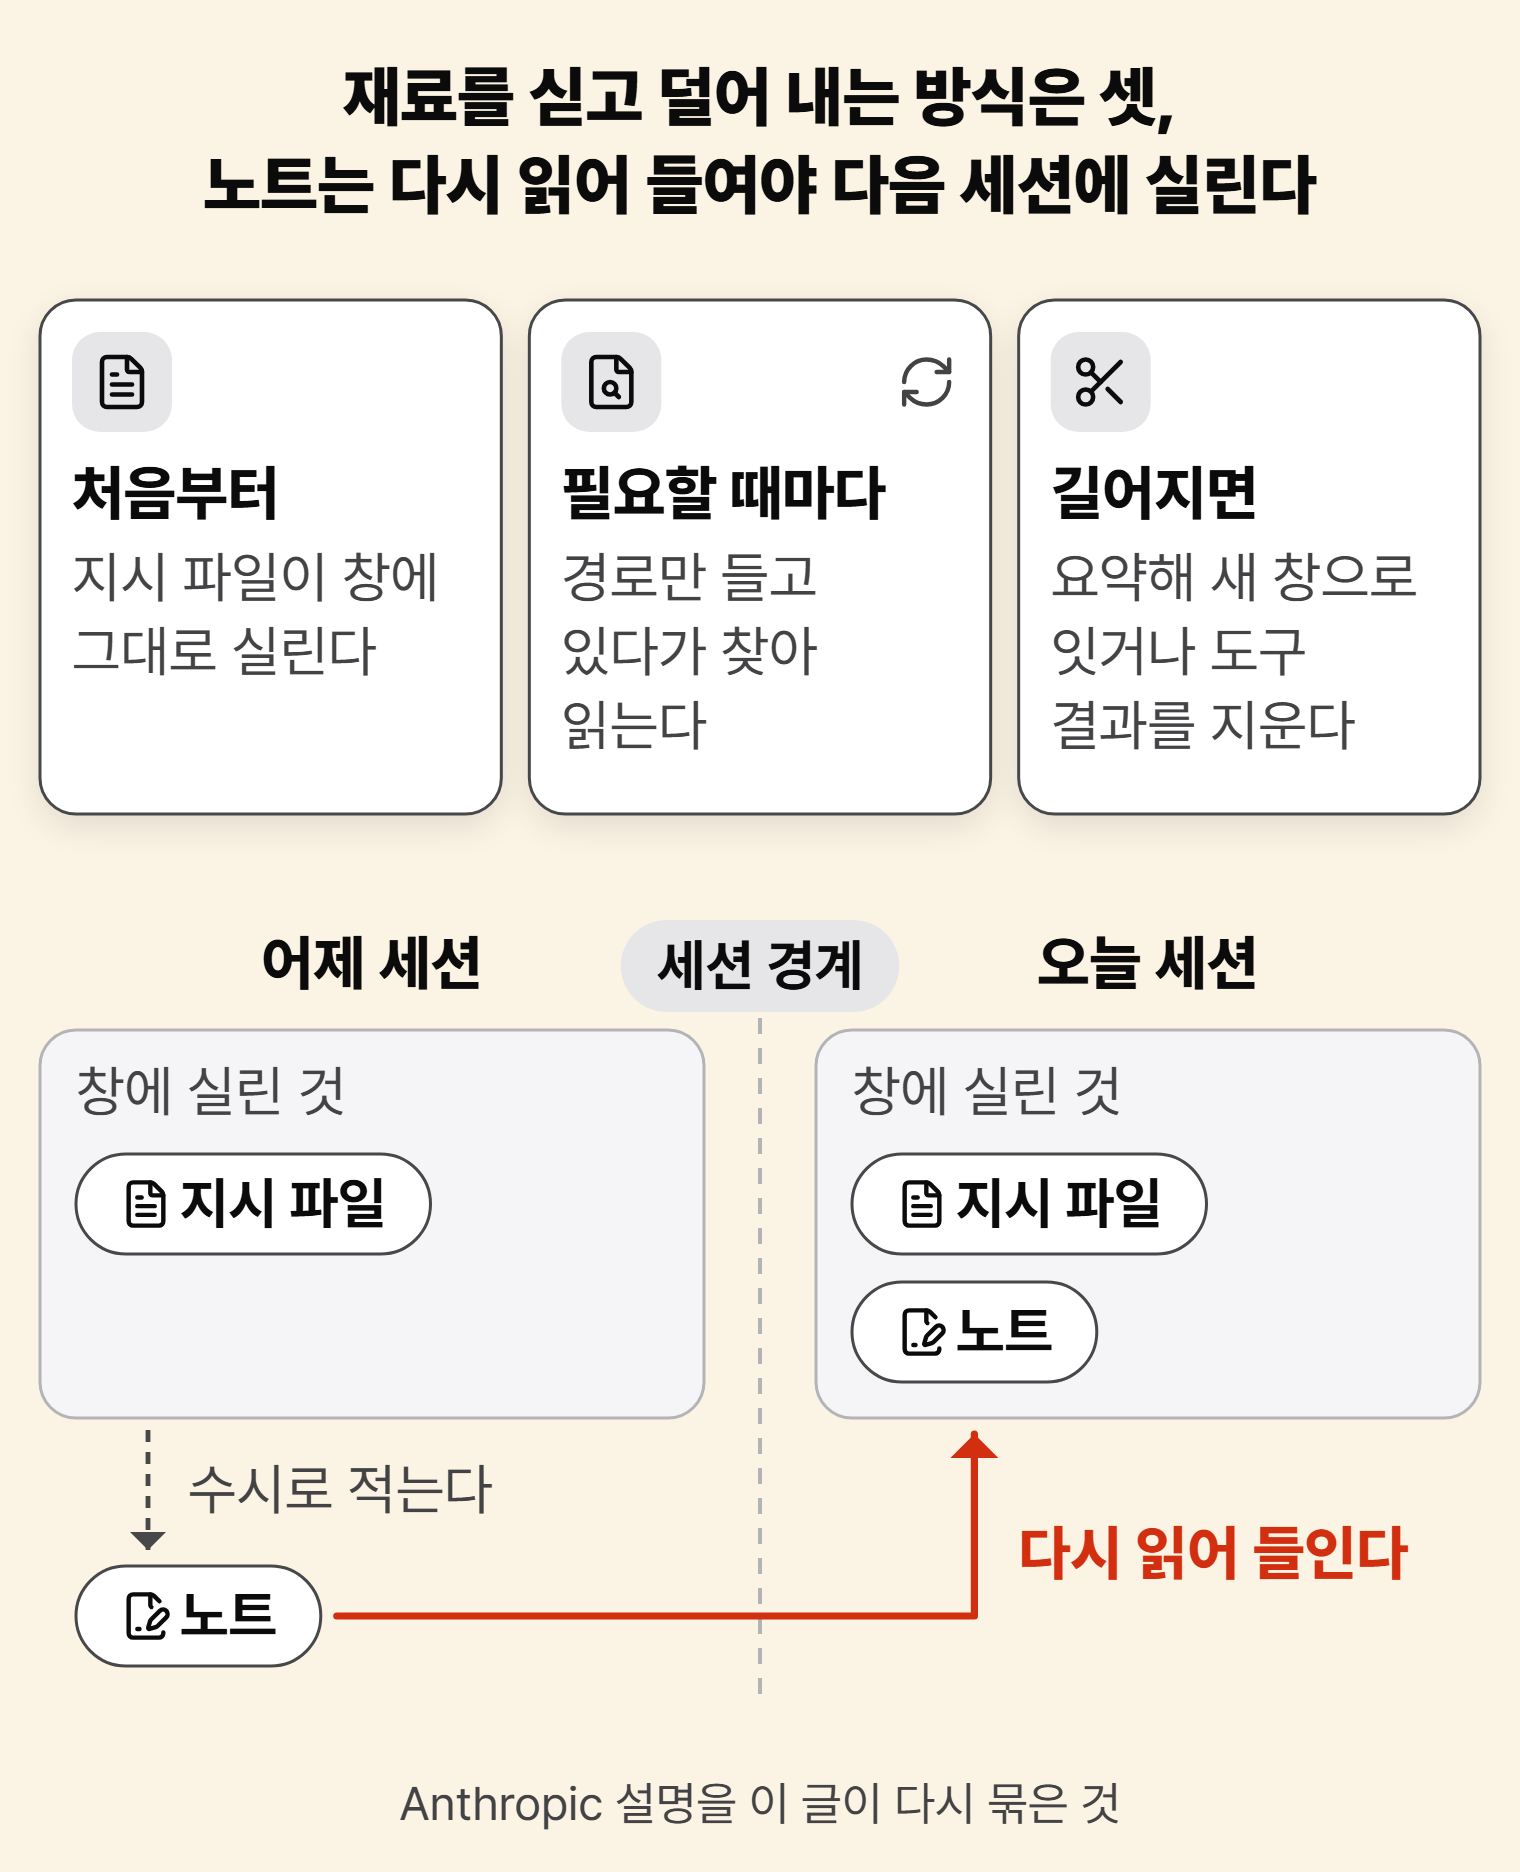
그림 5은 경로만 들고 있다가 파일 하나만 끌어오는 모습을, 그림 6는 재료를 싣고 덜어 내는 방식들과 세션을 건너는 노트를 보여 준다. 창 밖에 적어 둔 것은 세션 경계를 건너는 길이 될 수 있다. 다만 다음 세션에 다시 읽히려면 불러오는 장치가 있어야 한다. 처음부터 싣도록 둔 지시 파일은 세션마다 실리지만, 노트는 읽어 들이게 해 둬야 읽힌다. 같은 노트 파일이라도 「이번 턴에 무엇을 읽힐까」로 고르면 컨텍스트의 일이고, 그 파일을 세션을 넘겨 저장하고 다시 불러오는 장치를 운영하면 하네스의 일이다.
하네스로는 에이전트가 도는 루프를 바꾼다
하네스의 뼈대는 에이전트가 도는 루프다. 논문은 이 루프를 보고, 찾고, 계획하고, 행동하고, 결과를 보는 순환으로 그린다. 모델이 지금 상태를 받아 행동을 정하고, 도구로 실행하고, 결과를 보고 계획을 고친다. 이 글에서는 다섯 마디를 계획, 행동, 결과 보기의 셋으로 줄여 부른다.
그런데 코딩 에이전트는 이미 이런 루프를 돈다. 논문은 하네스가 맨 루프에 더하는 것을 끝맺음, 재귀, 자원 소비를 다스리는 제어라고 쓴다. 원문이 드는 예는 최대 단계 수, 재귀 깊이 제한, 단계마다의 비용 상한, 시간 제한이다.
(ㄴ-1)처럼 테스트를 돌리지 않고 끝낸 경우라면, 이 끝맺음 제어 자리에 끝내기 전에 테스트를 거쳤는지 확인하는 지점을 둘 수 있다. 이것은 논문이 든 예가 아니다. 논문의 끝맺음 제어를 이 사례에 옮겨 본 가정 설계다(글쓴이 종합).
(ㄴ-2)처럼 돌렸는데 실패를 넘긴 경우는 자리가 다르다. 먼저 실패한 결과가 다음 입력에 실렸는지 본다. 기록에 남았어도 대화를 요약하면서 빠졌다면 컨텍스트 쪽 일이다. 실렸는데도 넘겼다면, 결과를 보고 계획을 고치는 마디를 본다.
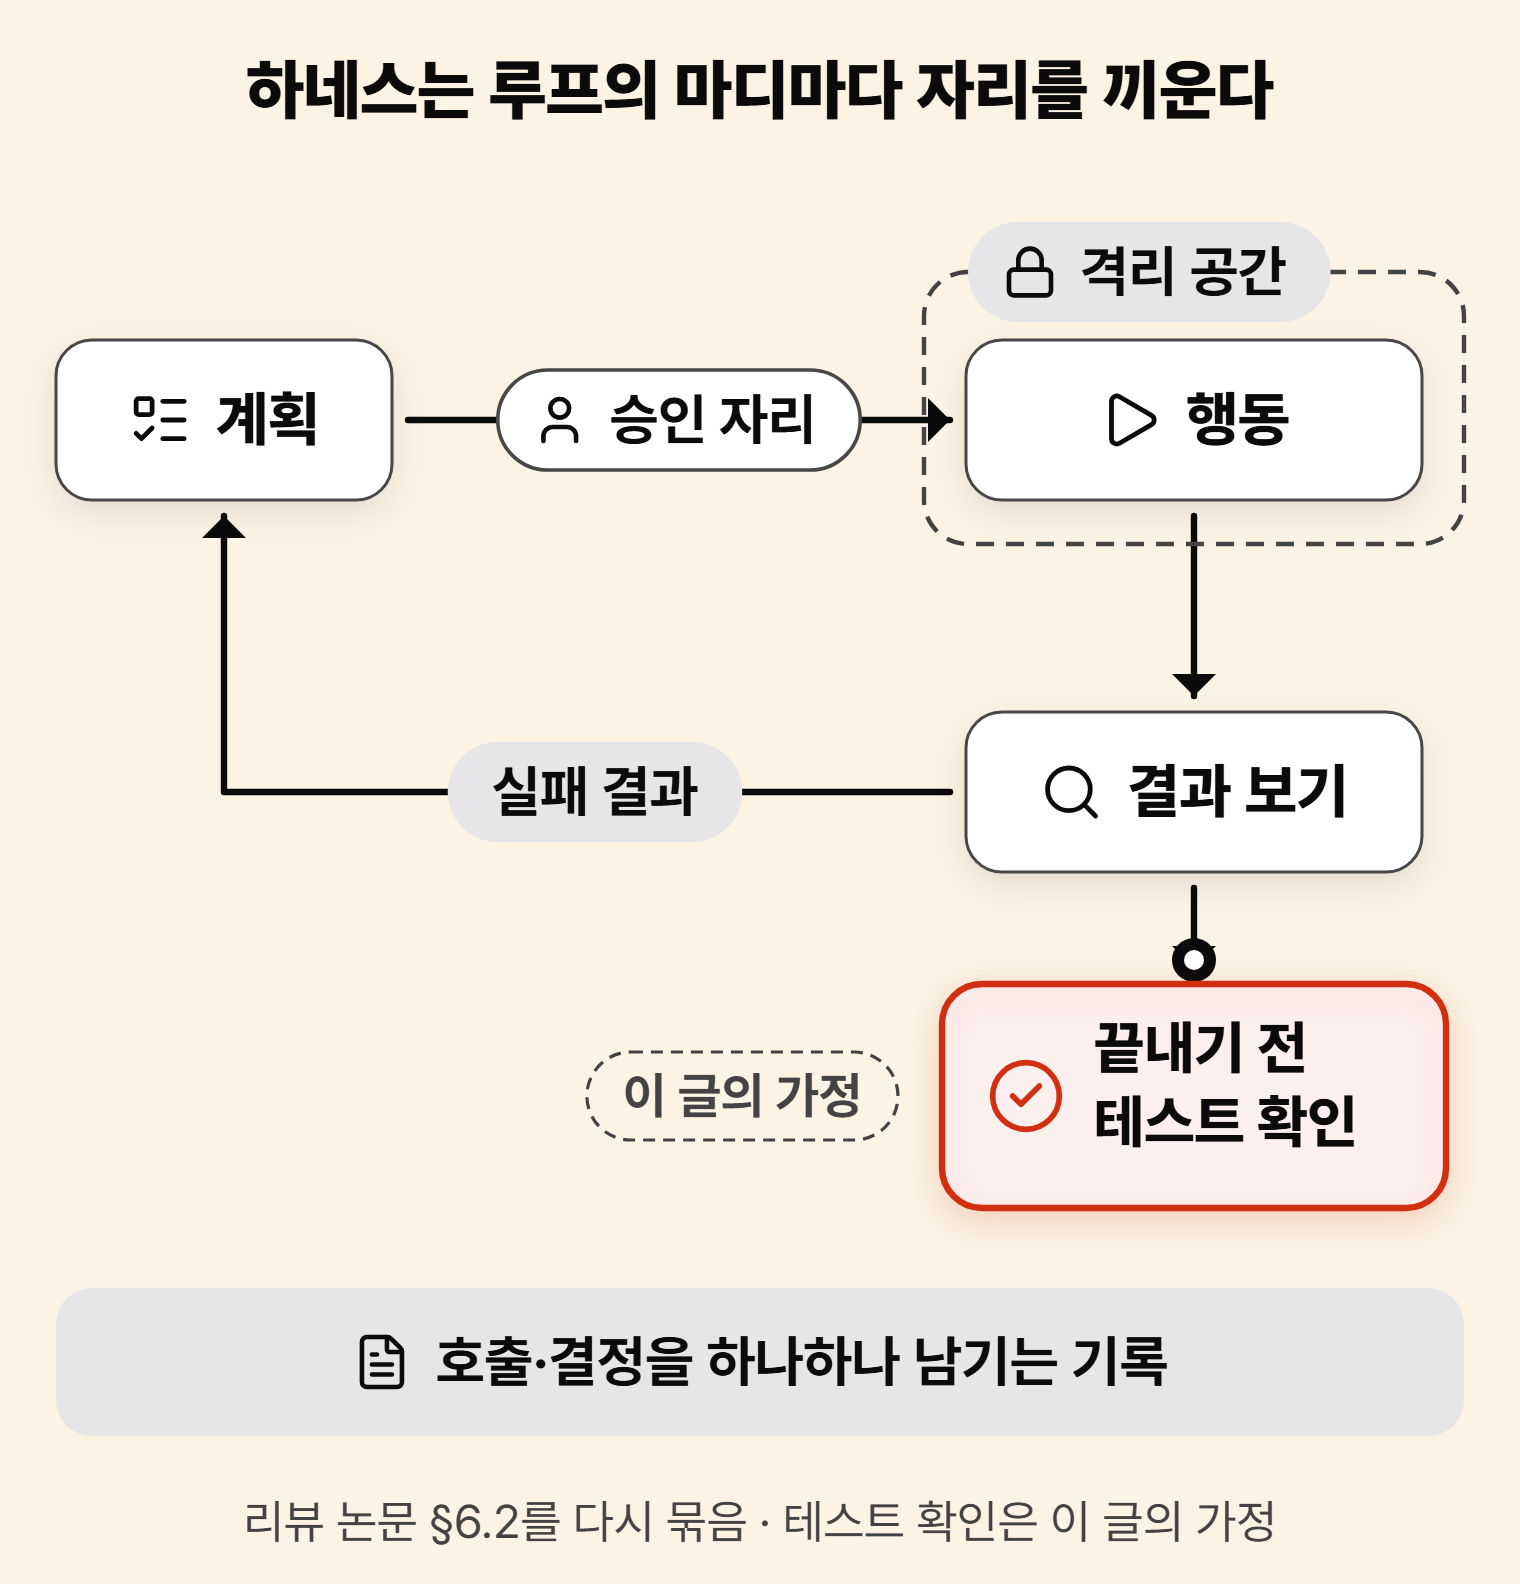
그림 7에서 보듯, 루프에는 끝맺음 말고도 하네스가 끼우는 자리가 더 있다. 하나는 권한이다. 논문은 실제로 쓰이는 시스템이 대부분 루프 안에 사람이 개입하는 지점을 둔다고 쓴다. 에이전트가 하려는 행동을 사람이 보고 승인하거나 거절하는 자리다.
설정도 권한을 다룬다. 논문에 따르면 프로젝트 설정은 어떤 도구를 쓸 수 있고, 어떤 파일 경로에 접근할 수 있으며, 어떤 명령에 승인이 필요한지를 정한다. 지시문에 넣어야 했을 제약을 하네스가 실행 중에 지키는 규칙으로 옮긴 것이다. 규칙이 입력에 있었는데도 인증 모듈을 고치려 한 (ㄷ-3)은 이 설정과 앞의 승인 자리에 걸린다. 격리 실행은 에이전트가 읽고 쓰고 바꿀 수 있는 범위를 줄이고, 실패를 진단하고 되돌릴 수 있게 한다. (ㄱ)에서 잘못 고친 파일을 되돌리는 자리가 여기다.
다음은 기억이다. 논문은 기억이 에이전트의 상태를 시간을 넘어 모델 밖에 꺼내 둔다고 본다. 규칙이 어디에도 저장되지 않은 (ㄷ-1)에서, 규칙을 저장하고 다음 세션에 불러오는 장치를 두는 자리가 여기다. 앞의 권한과는 하는 일이 다르다. 접근을 막으면 인증 모듈을 고치는 행동은 막을 수 있지만, 에이전트가 어제의 규칙을 알게 되지는 않는다.
마지막은 기록이다. 논문은 모델 호출, 도구 호출, 기억 읽기와 쓰기, 결정 분기를 하나하나 구조화해 남기는 방법을 든다. (ㄱ)의 단서, 곧 로그인 처리 코드를 읽지 않았다는 사실을 보여 준 것이 바로 이 기록이다. (ㄴ-1)과 (ㄴ-2)를 가르는 것도 기록이다.
덧붙여 논문은 되풀이하는 절차를 파일로 적어 두고 관련 작업일 때만 불러오는 일도 하네스 쪽에 둔다. 이런 파일, 곧 스킬(되풀이 절차를 적어 둔 파일)은 이 연재 뒤쪽에서 다룬다. 지금까지의 손질을 사례의 여섯 경우에 맞춰 늘어놓으면 표 3이 된다.
| 사례의 실수 | 프롬프트로 손대는 것 | 컨텍스트로 손대는 것 | 하네스로 손대는 것 |
|---|---|---|---|
| (ㄱ) 엉뚱한 파일을 고쳤다 | 고칠 범위를 지시문에 적는다 | 관련 파일을 찾아 읽게 하는 길잡이(처음 싣는 지시 파일·경로 표지), 넓은 탐색은 하위 에이전트에게 | 읽고 바꾼 파일이 남는 기록, 되돌릴 수 있는 격리 실행 |
| (ㄴ-1) 테스트를 돌리지 않고 끝냈다 | 완료 기준 「끝내기 전에 테스트」를 적는다 | 할 일 목록에 테스트 단계를 남겨 다시 읽히게 한다 | 끝내기 전에 테스트를 거쳤는지 보는 끝맺음 제어(가정 설계) |
| (ㄴ-2) 실패한 결과를 넘기고 끝냈다 | 「실패하면 고치고 다시 돌려라」를 적는다 | 실패한 결과가 요약에서 빠지지 않고 다음 입력에 실리게 한다 | 실패한 결과가 다음 계획으로 돌아오는 루프 |
| (ㄷ-1) 규칙이 어디에도 저장되지 않았다 | 오늘 지시문에 다시 적는다(다음 세션 입력에는 남지 않는다) | —(실을 규칙이 아직 없다) | 규칙을 세션 밖에 저장하고 다음 세션에 불러오는 기억 |
| (ㄷ-2) 저장된 규칙이 이번 입력에 실리지 않았다 | 오늘 지시문에 다시 적는다(이 대화에만 들어간다) | 처음 싣는 지시 파일이나 노트에 있는 규칙이 이번 턴에 읽히게 한다 | 저장된 규칙을 새 세션 입력에 불러오는 장치 |
| (ㄷ-3) 규칙이 입력에 있었는데도 어겼다 | 규칙을 다시 강조한다(지시를 더 준다고 제약을 지키는 법을 알게 되지는 않는다) | 입력이 길어 규칙이 흐려지지 않았는지 보고, 관련이 덜한 재료를 덜어 낸다 | 경로 접근 설정과 그 명령 앞 승인 자리 |
여섯 줄에 사례를 맞춘 것은 이 글의 정리다(글쓴이 종합). 같은 실수 줄에서도 세 자리가 손대는 것은 서로 다르고, 컨텍스트 열이 비는 칸은 실을 규칙이 아직 없는 (ㄷ-1) 하나뿐이다. 그렇다면 틀린 결과를 받았을 때 할 일은, 그 실수가 어느 경우인지부터 가리는 것이다.
실수가 나는 자리부터 본다
에이전트가 「고쳤다」고 했는데 틀렸을 때, 증상만 보고는 어디부터 볼지 정하기 어렵다. 기록과 입력에 남은 증거가 먼저 볼 자리를 가른다. 아래 표 4는 논문의 실패 분류(§7.2)와 지시만으로는 보장되지 않는 것(§2.2)을 증상과 증거 쪽에서 다시 묶은 것이다(글쓴이 종합). 어디부터 볼지 짐작하는 표라, 이 글에서는 짐작 표라 부른다.
| 증상 | 확인할 증거(기록·입력) | 먼저 볼 자리 | 근거 |
|---|---|---|---|
| 시킨 대로 했는데 결과가 틀렸다 | 지시문을 그대로 따른 흔적 | 지시문(프롬프트) | 지시는 충실히 따랐는데 지시 자체가 틀렸거나 일에 맞지 않는다(§7.2 절차 지침 오류) |
| (ㄱ) 엉뚱한 파일을 고쳤다 | 관련 파일(로그인 처리 코드)을 읽은 흔적이 없다 | 그 턴의 재료(컨텍스트) — 후보 | 맞게 추론했는데 잘못된 재료 위에서 했다(§7.2 입력 선택 오류). 기억 검색에서 온 실수일 수도 있다 |
| 할 일은 알아들었는데 도구 호출·출력 형식을 자꾸 깬다 | 출력이 약속한 형식과 어긋난 자리 | 내놓아야 하는 형식의 약속(주고받는 규칙을 미리 정해 둔 프로토콜이 정하는 칸) | 의도는 맞는데 출력이 약속한 형식을 어긴다(§7.2 프로토콜 쪽 실패) |
| (ㄴ-1) 테스트 없이 「고쳤다」 | 테스트를 돌린 기록이 없다 | 지시문에 완료 기준이 없었다면 지시문, 있었다면 하네스의 끝맺음 제어 | 알맞은 높이(Anthropic) · 끝맺음 제어(§6.2.1) — 끝내기 전 테스트 확인은 가정 설계 |
| (ㄴ-2) 테스트가 실패했는데 「고쳤다」 | 실패한 테스트 결과가 있고, 그 뒤 다른 시도가 없다 | 그 결과가 다음 입력에 실렸는지(컨텍스트), 실렸다면 하네스 — 결과가 다음 계획으로 돌아오는 자리 | 지나친 요약은 맥락을 잃는다(Anthropic) · 결과를 보고 계획을 고치는 루프(§6.2.1) |
| (ㄷ-1) 규칙이 어디에도 저장되지 않았다 | 지시 파일·노트·기억 어디에도 그 규칙이 없다 | 하네스 — 세션을 넘는 기억 | 지시를 더 준다고 세션을 넘어 상태를 유지하는 법을 알게 되지는 않는다 · 새 세션은 일부를 잊고 시작한다(§2.2) |
| (ㄷ-2) 저장된 규칙이 이번 입력에 실리지 않았다 | 저장된 곳에는 규칙이 있는데, 오늘 세션 입력에는 없다 | 그 턴의 재료(컨텍스트) — 이번 턴에 무엇을 읽혔나 | 노트(Anthropic) |
| (ㄷ-3) 규칙이 입력에 있었는데도 어겼다 | 그 턴 입력에 규칙이 있었다 | 입력 구성(컨텍스트 — 긴 입력에서 규칙이 흐려졌나)과 하네스의 경로 접근 설정·승인 자리 | 재료가 많을수록 흐려진다(Anthropic) · 설정(§6.2.5) · 승인 지점(§6.2.3) · 지시를 더 준다고 제약을 지키는 법을 알게 되지는 않는다(§2.2) |
사례의 여섯 경우는 표에서 이렇게 나뉜다. (ㄱ)은 재료로, (ㄴ-1)은 지시문이나 끝맺음 제어로, (ㄴ-2)는 결과 전달과 결과 되먹임으로 간다. (ㄷ)은 셋으로 갈려 (ㄷ-1)은 기억으로, (ㄷ-2)는 이번 턴의 재료로, (ㄷ-3)은 입력 구성과 권한으로 간다. 이름이 다른 (ㄱ)과 (ㄷ-2)는 같은 자리로 간다. 다만 「먼저 볼 자리」는 시작점이지 원인 판정이 아니고, 다음 절에서 보듯 칸은 서로 겹친다. 그래도 증상과 증거로 줄을 먼저 고르면, 지시문만 거듭 고쳐 쓰는 일은 줄일 수 있다.
논문 속 하네스는 기억·스킬·프로토콜을 담는다
논문 제목에는 기억·스킬·프로토콜·하네스, 네 낱말이 나란히 나온다. 그런데 저자들은 하네스를 앞의 셋과 같은 줄에 세우지 않는다. 논문은 하네스가 기억·스킬·프로토콜과 「나란한 네 번째 종류가 아니」며, 이 셋이 「돌아가고 서로 맞물리는 실행 환경」이라고 쓴다. 하네스가 맡는 일로는 작업 순서를 짜고 지휘하는 논리, 제약, 무엇을 했는지 남는 기록, 피드백 루프를 든다.
셋이 각각 무엇을 바꾸는지도 논문은 한 문장씩 정리한다. 기억은 바뀌는 지식을 모델 밖의 검색 저장소와 입력으로 꺼내 두어, 떠올리는 문제를 알아보는 문제로 바꾼다. 스킬은 되풀이하는 절차를 파일로 꺼내, 그때그때 지어내던 것을 짜인 부품의 조립으로 바꾼다. 프로토콜(protocol)은 주고받는 규칙을 미리 정한 형식이다. MCP 같은 약속된 주고받기 형식은, 모델이 도구나 다른 에이전트와 즉석에서 맞추던 조율을 지켜야 할 계약으로 바꾼다. 셋의 깊이는 다음 글들에서 하나씩 다룬다.
하네스 쪽에서 컨텍스트 창과 모델의 출력을 함께 보면 칸이 생긴다. 논문 §7.2는 모델의 경계를 세 칸으로 나눈다. 기억에서 오는 맥락 입력, 스킬에서 오는 지시 입력, 그리고 프로토콜이 정하는 내놓을 형식의 약속이다. 저자들은 이렇게 나눈 구조를 「구조화된 형태의 컨텍스트 엔지니어링(a structured form of context engineering)」으로 볼 수 있다고 쓴다. 이 논문은 컨텍스트 엔지니어링이라는 말을 거의 쓰지 않는데, 쓰는 자리가 바로 여기다. 저자들의 말로는, 하네스는 프롬프트를 한 덩어리 글로 두지 않고 따로 고칠 수 있는 칸으로 나눈다.
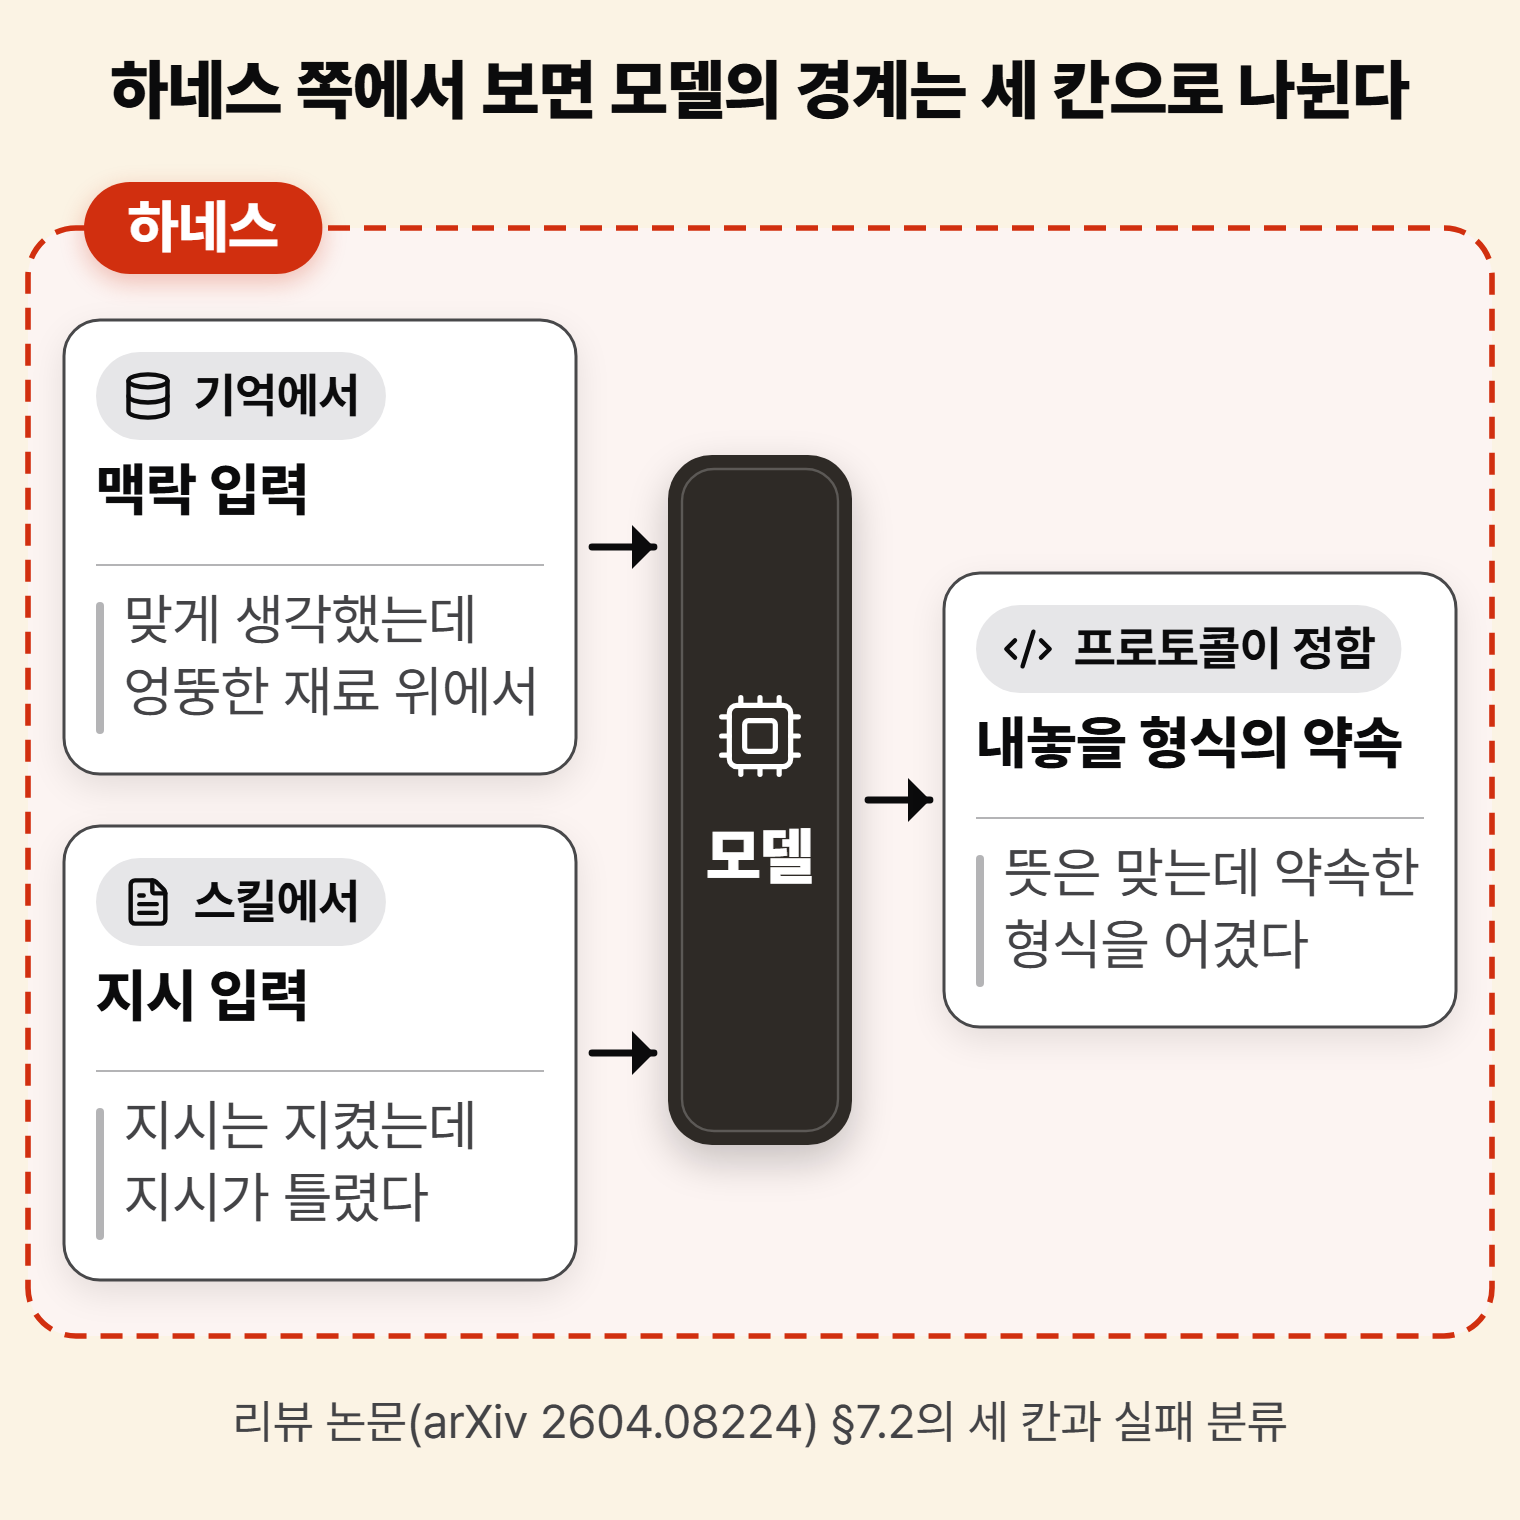
나누면 따로 고칠 수 있다. 칸마다 바뀌는 속도와 관리할 것, 실패하는 모습이 다르기 때문이다. 논문은 「각 층을 다른 층을 흔들지 않고 고칠 수 있다」고 쓰고, 기억 검색을 고쳐도 스킬을 다시 쓸 필요가 없다는 예를 든다. 앞 절 짐작 표의 지시문·재료·형식 세 줄은 그림 8의 세 칸에 붙은 실패 이름에서 왔다.
이 글의 분류로는, 늘 창에 실리는 프로젝트 지시 파일도 일하는 방식을 일러 주는 글이라 지시 입력 쪽에 든다. 다만 논문은 이 칸을, 모든 절차를 한 덩어리 시스템 프롬프트에 적어 두는 대신 관련 작업이 나타날 때만 필요한 지시를 불러와 채우는 칸으로 그린다. 칸이 깔끔하게 떨어지지 않는 자리는 논문 안에도 있다. 맥락 입력 칸의 실수, 곧 잘못된 재료 위의 추론을 논문은 기억 검색이 실패한 결과로 적는다. 증상은 컨텍스트에서 보여도 손볼 곳은 기억 규칙일 수 있다. 짐작 표의 「먼저 볼 자리」를 원인 판정이 아니라 시작점으로 읽어야 하는 이유가 여기 있다.
세 층은 갈아 끼우지 않고 쌓인다
세 층을 시간 순서로 늘어놓으면, 새 층이 앞 층을 밀어낸 것처럼 읽히기 쉽다. 두 출처는 모두 그렇게 보지 않는다. 논문은 세 층이 「서로를 밀어내지 않고 겹쳐 쌓인다(layered rather than mutually exclusive)」고 쓴다. 인프라가 가장 두꺼운 시스템에서도 가중치는 여전히 중요하다는 단서도 붙인다. 저자들은 층이 올라갈 때마다 시스템에서 고치고 키울 부분을 개발자가 두는 자리가 옮겨 간다고 본다. 그에 따라 개발자가 공을 가장 많이 들이는 곳도 달라진다.
Anthropic 글은 컨텍스트 엔지니어링을 프롬프트 엔지니어링의 「자연스러운 다음 단계(natural progression)」로 부른다. 논문의 표현으로 모델은 「여전히 핵심 추론 엔진이지만, 더는 지능이 있는 유일한 자리가 아니다」. 그림 3에서 위 층이 생겨도 아래 층을 그대로 남겨 그린 것도 이 때문이다.
겹침은 출처 사이에서도 보인다. Anthropic 글은 압축을 컨텍스트 전략으로 다룬다. 그런데 논문은 요약이나 단계적 불러오기 같은 창 관리를, 어느 한 부품이 혼자 풀 수 없는 하네스 차원의 조율 문제로 다룬다. 같은 압축이 한 출처에서는 컨텍스트 쪽에, 다른 출처에서는 하네스 쪽에 놓인다. 앞에서 본 같은 노트 파일의 두 관점과 같은 이야기다.
「이제 프롬프트 엔지니어링은 끝났다」는 결론은 두 출처 어디에도 없다. 겹쳐 쌓인다는 말은 반대로, 한 자리만 손보면 나머지가 해결된다는 말도 아니다. 세 자리는 함께 남아 있다.
하네스를 바꾸면 성능이 얼마나 달라지는지 이 논문은 수치로 답하지 않는다. 저자들은 지금의 벤치마크가 주로 고정된 프롬프트와 모델 설정에서 과제 완료를 재기 때문에, 하네스가 보탠 부분을 따로 가려내지 못한다고 본다(§8.6). 그래서 부품을 하나씩 빼 보는 실험, 하네스는 두고 모델만 바꿔 보는 실험을 앞으로의 평가 방법으로 제안한다.
하네스라는 말의 경계도 아직 단단하지 않다. 논문은 「하네스」라는 말이 최근 현업에서 쓰이기 시작했다고 적고, 그 쓰임새의 예로 OpenAI의 Codex 관련 글을 든다. 저자들 스스로도 이 개념이 아직 자리를 잡아 가는 중이라고 보고, 자기들의 설명을 「닫힌 정의라기보다 지금 시스템들에서 되풀이되는 패턴을 모은 것」으로 읽어 달라고 쓴다. 관점도 실용 쪽으로 좁혔다. 모델 밖으로 꺼내 두는 설계의 가치를, 그렇게 만든 시스템이 얼마나 믿을 만하고 조합하기 쉽고 관리하기 쉬운지로 본다는 것이다. 이 글이 쓴 하네스의 뜻도 그 정도의 무게로 읽으면 된다.
자주 묻는 질문
프롬프트 엔지니어링은 이제 필요 없나?
필요하다. Anthropic 글은 지금도 시스템 프롬프트를 알맞은 높이로 쓰라고 권하고, 예시를 넣는 퓨샷 프롬프팅은 「계속 강하게 권한다」고 쓴다. 다만 예외 상황을 줄줄이 늘어놓기보다, 기대하는 행동을 잘 보여 주는 서로 다른 대표 예시를 골라 넣으라고 한다.
컨텍스트 엔지니어링과 RAG는 같은 말인가?
같은 말이 아니다. 논문 §2.2에서 RAG는 질의할 때 바깥 문서를 창에 넣는 기법으로, 컨텍스트 층에 든 여러 기법 가운데 하나다. Anthropic 글은 많은 AI 앱이 추론 전에 임베딩으로 중요한 맥락을 찾아 두는 방식을 쓰고, 여기에 「그때그때」 찾는 전략을 더해 가는 흐름을 전한다. 컨텍스트 엔지니어링은 지시·도구·대화 이력까지 창 전체를 다룬다. RAG는 그 안의 한 방법이다.
CLAUDE.md는 프롬프트인가 컨텍스트인가?
세 자리에 걸친다(글쓴이 종합). 그 파일에 무엇을 적느냐는 지시문의 일이다. 그 파일을 처음부터 싣느냐, 필요할 때 찾게 하느냐는 컨텍스트의 일이다. 그 파일을 어떤 범위의 설정으로 두고, 늘 실을 것과 필요할 때 부를 절차로 나누는 구조는 하네스 쪽이다.
하네스 엔지니어링의 예를 들면?
논문이 드는 초기 예는 Auto-GPT와 BabyAGI다. 두 프로젝트는 LLM을 할 일 대기열, 이어지는 기억, 웹 접속이 있는 루프로 감쌌다. 논문은 이런 최소한의 하네스로도 프롬프트 하나로는 못 하던 행동을 이어 갈 수 있었다고 본다. 오늘의 코딩 에이전트는 파일·셸·버전 관리·테스트를 갖춘 개발용 하네스 안에서 도는 예다.
하네스는 직접 만들어야 하나, 쓰는 도구에 있는 것으로 되나?
코딩 에이전트를 쓰고 있다면 이미 개발용 하네스 안에서 일한다. 그 안에서 손볼 일은 둘로 나뉜다(글쓴이 종합). 하나는 파일과 설정으로 손보는 일이다. 처음 싣는 지시 파일, 노트, 어떤 경로와 어떤 명령에 승인이 필요한지 정하는 권한 설정이 여기에 든다. 논문은 권한 같은 설정이 사용자, 프로젝트, 조직 범위로 나뉜다고 적는다. 다른 하나는 루프를 만드는 일로, 끝맺음 제어와 결과 되먹임처럼 에이전트를 돌리는 쪽을 짜는 사람이 다룰 일이다.
하네스를 늘리지 않아도 되는 때는?
이 글은 세 가지를 물어본다(글쓴이 종합). 한 번 하고 말 일인가, 세션을 넘겨 기억해야 하나, 같은 절차를 되풀이하나. 논문은 한 번뿐이거나 아주 특이한 일은 모델 밖으로 꺼내 두고 묶고 관리하는 수고를 정당화하지 못할 수 있다고 쓴다. 반대로 여러 작업에서 되풀이해 필요한 능력이라면 꺼내 두는 쪽이 옮겨 쓰고 조합하기 좋다고 본다.
비용도 있다. 논문은 검색, 라우팅(일을 맞는 곳으로 보내는 일), 도구 호출이 모두 지연을 더한다고 적는다. 불러온 것마다 한정된 창을 두고 다투기도 한다. Anthropic 글도 실행 중에 찾아보는 것은 미리 찾아 둔 것을 가져오는 것보다 느리다고 쓴다. 같은 글은 「되는 것 가운데 가장 단순한 것을 하라(do the simplest thing that works)」를 권한다.
내 에이전트가 틀릴 때 어디부터 볼까
요지는 고치기 전에 기록으로 실수가 난 자리를 먼저 고르고, 고른 자리로만 가는 것이다. 아래 순서는 이 글의 정리다(글쓴이 종합). 논문은 §6.2의 여섯 차원을 하네스 구조를 설명하는 분석 틀로 내놓았고, 이런 점검 순서는 정하지 않았다. 1·2단계는 늘 거치고, 3~7단계는 고른 줄에 해당할 때만 간다.
- 기록부터 연다 — 이번 작업에서 읽은 파일, 바꾼 파일, 돌린 명령과 그 결과를 본다. 논문의 말대로, 흔적을 남기지 않는 에이전트는 디버깅할 수 없다.
- 후보 줄을 고른다 — 증상과 기록을 짐작 표의 「확인할 증거」 열에 맞춰 본다. 두 줄에 걸치면 둘 다 후보로 둔다.
- 지시문 줄이면 — 완료 기준과 하지 말 것이 적혀 있었는지, 너무 막연하거나 너무 못 박지는 않았는지 본다. 시킨 대로 했는데 틀렸다면 적힌 내용이 맞는지, 이 일에 맞는지도 본다.
- 재료 줄이면 — 그 턴에 실린 지시 파일과 찾아 읽은 파일 목록을 본다. 관련 파일이 빠졌는지, 요약하면서 규칙이나 실패 결과가 빠지지 않았는지, 입력이 길어 규칙이 흐려지지 않았는지 본다.
- 형식 줄이면 — 출력이 어긋난 자리를 약속한 형식(프로토콜이 정한 칸)과 나란히 놓고, 어느 칸을 어겼는지 본다.
- 기억 줄이면 — 규칙이 어딘가에 저장돼 있는지 본다. 저장돼 있는데 오늘 입력에 실리지 않았다면 재료 줄로 간다.
- 루프·권한 줄이면 — 끝내기 전 테스트 확인(이 글의 가정 설계), 실패 결과 되먹임, 승인 자리, 경로 접근 설정 가운데 그 줄이 가리키는 것만 본다.
다음 물음은 바깥의 칸마다 있다
모델을 그대로 두고 바깥을 바꿔서 에이전트가 더 믿을 만해진다면, 그 바깥의 칸은 하나하나 어떻게 생겼을까. 창에 재료를 많이 넣을수록 모델이 왜 헷갈리는지, 에이전트가 어제 한 일을 어떻게 기억하는지, 절차를 왜 파일로 꺼내 두는지가 다음 글들이 다룰 물음이다. 이 글의 사례에서 그 칸들은 이미 갈라져 있었다. 어긴 규칙 하나도 기록에 무엇이 남았느냐에 따라 기억, 그 턴의 재료, 입력 구성과 권한으로 나뉘었다.
같은 실수라도 그것이 지시문에서 나는지, 매 턴 넘긴 재료에서 나는지, 그 바깥의 루프와 기억과 권한에서 나는지에, 프롬프트·컨텍스트·하네스 가운데 어디부터 손볼지가 달려 있다.
연재 「AI의 바깥을 설계하는 법」 8편 중 1편 — 다음 편은 컨텍스트를 많이 넣을수록 왜 헷갈리는지를 다룬다.
더 읽기
- C. Zhou 외, 「Externalization in LLM Agents: A Unified Review of Memory, Skills, Protocols and Harness Engineering」, arXiv:2604.08224 v1 (2026) — https://arxiv.org/abs/2604.08224v1
- Anthropic, 「Effective context engineering for AI agents」, Anthropic Engineering (2025-09-29) — https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- 관련 글: 「단계별로 생각해 봐」를 붙이면 더 잘 맞힐까 — 컨텍스트 층의 대표 기법 하나가 정답률을 실제로 바꾸는지 따져 본 글.
- 관련 글: 컨텍스트 창 100만 토큰 시대, RAG는 언제 이기고 언제 지는가 — 「창은 유한하다」는 한계를 긴 창과 검색의 비용·정확도로 잰 글.
- 관련 글: 짧은 CLAUDE.md가 더 강한 에이전트를 만든다 — 처음부터 창에 실리는 프로젝트 지시 파일을 짧게 쓰는 방법을 다룬 글.