친구 역설(friendship paradox)은 친구 목록에서 각 사람이 자기 친구 수만큼 여러 번 등장해서 생기는 표본 편향이다. 그래서 사람들의 친구 수 평균보다 그 친구들의 친구 수 평균이 언제나 크거나 같다. Feld 의 8명 예시에서는 8명 중 5명이, 2011년 5월 페이스북 활성 사용자 7.21억 명 중에서는 92.7%가 자기 친구들의 평균보다 친구가 적었다.
친구 목록을 열어 세어 보면
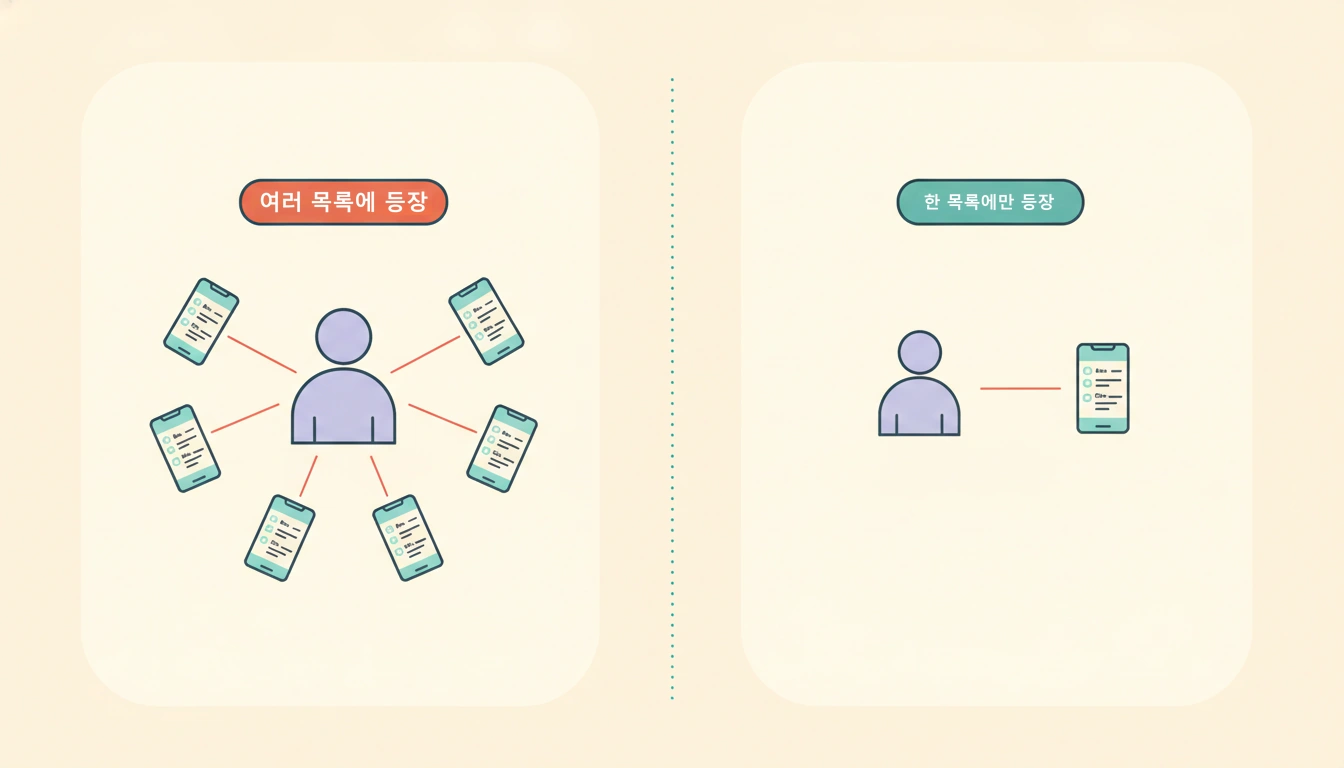
인스타그램이나 카톡 친구 목록을 열어 보자. 눈에 보이는 열 명의 친구 수를 하나씩 세어 적고, 그 열 개의 숫자를 내 친구 수와 나란히 놓는다. 대개는 나보다 친구가 많은 사람 쪽이 더 길게 늘어선다.
여기서 보통은 자기 쪽을 탓하게 된다. 내가 유독 인기가 없어서, 혹은 연락을 게을리해서 이렇게 나온 것 같기 때문이다. 그런데 이 어긋남은 성격이나 노력의 문제가 아니다. 목록에 누가 실리는지를 정하는 규칙 자체가 이미 한쪽으로 기울어 있다. 세는 방식이 만드는 결과라는 뜻이다.
이 현상에는 이름이 있다. 사회학자 Feld 가 1991년 논문에서 이 어긋남을 처음 정리했고, 친구 역설(friendship paradox)이라는 이름은 그 뒤에 붙었다. 이름이 붙은 것은 이것이 어느 한 사람에게만 일어나는 일이 아니어서다. 여덟 명짜리 친구 무리에서도, 사용자 7억 명짜리 소셜 네트워크에서도 같은 방향으로 기운다. 작은 쪽부터 세어 보자.
친구 목록은 이미 기울어진 표본이다 — Feld 의 8명
Feld 는 편향의 출처를 한 문장으로 짚는다. 친구가 40명인 사람은 40명의 친구 목록에 저마다 한 번씩 등장하고, 친구가 1명인 사람은 단 한 사람의 목록에만 등장한다는 것이다. 그러니 모든 친구 목록을 이어 붙여 만든 명단은 사람을 공평하게 한 번씩 담지 않는다. 친구가 많은 사람일수록 그만큼 여러 번 들어간다. 친구 수만큼 가중된 표본인 셈이다.
이 차이는 무엇을 한 번으로 셀지에서 갈린다. 사람을 한 번씩 세면 한 사람이 한 표를 갖는다. 친구 목록을 이어 붙여 세면 한 표를 갖는 것은 사람이 아니라 친구 관계의 끝점이다. 사람은 그대로인데 표의 주인이 바뀌는 것이다.
Feld 가 든 예시는 Marketville 이라는 고등학교의 여학생 8명이다. Betty·Sue·Alice·Jane·Pam·Dale·Carol·Tina 여덟 명 사이에 친구 관계 10쌍이 있다. 이 정도 크기면 종이에 그려 놓고 손으로도 셀 수 있다. 앞 문단의 이야기가 숫자로 어떻게 나타나는지 끝까지 따라갈 수 있다는 뜻이다.
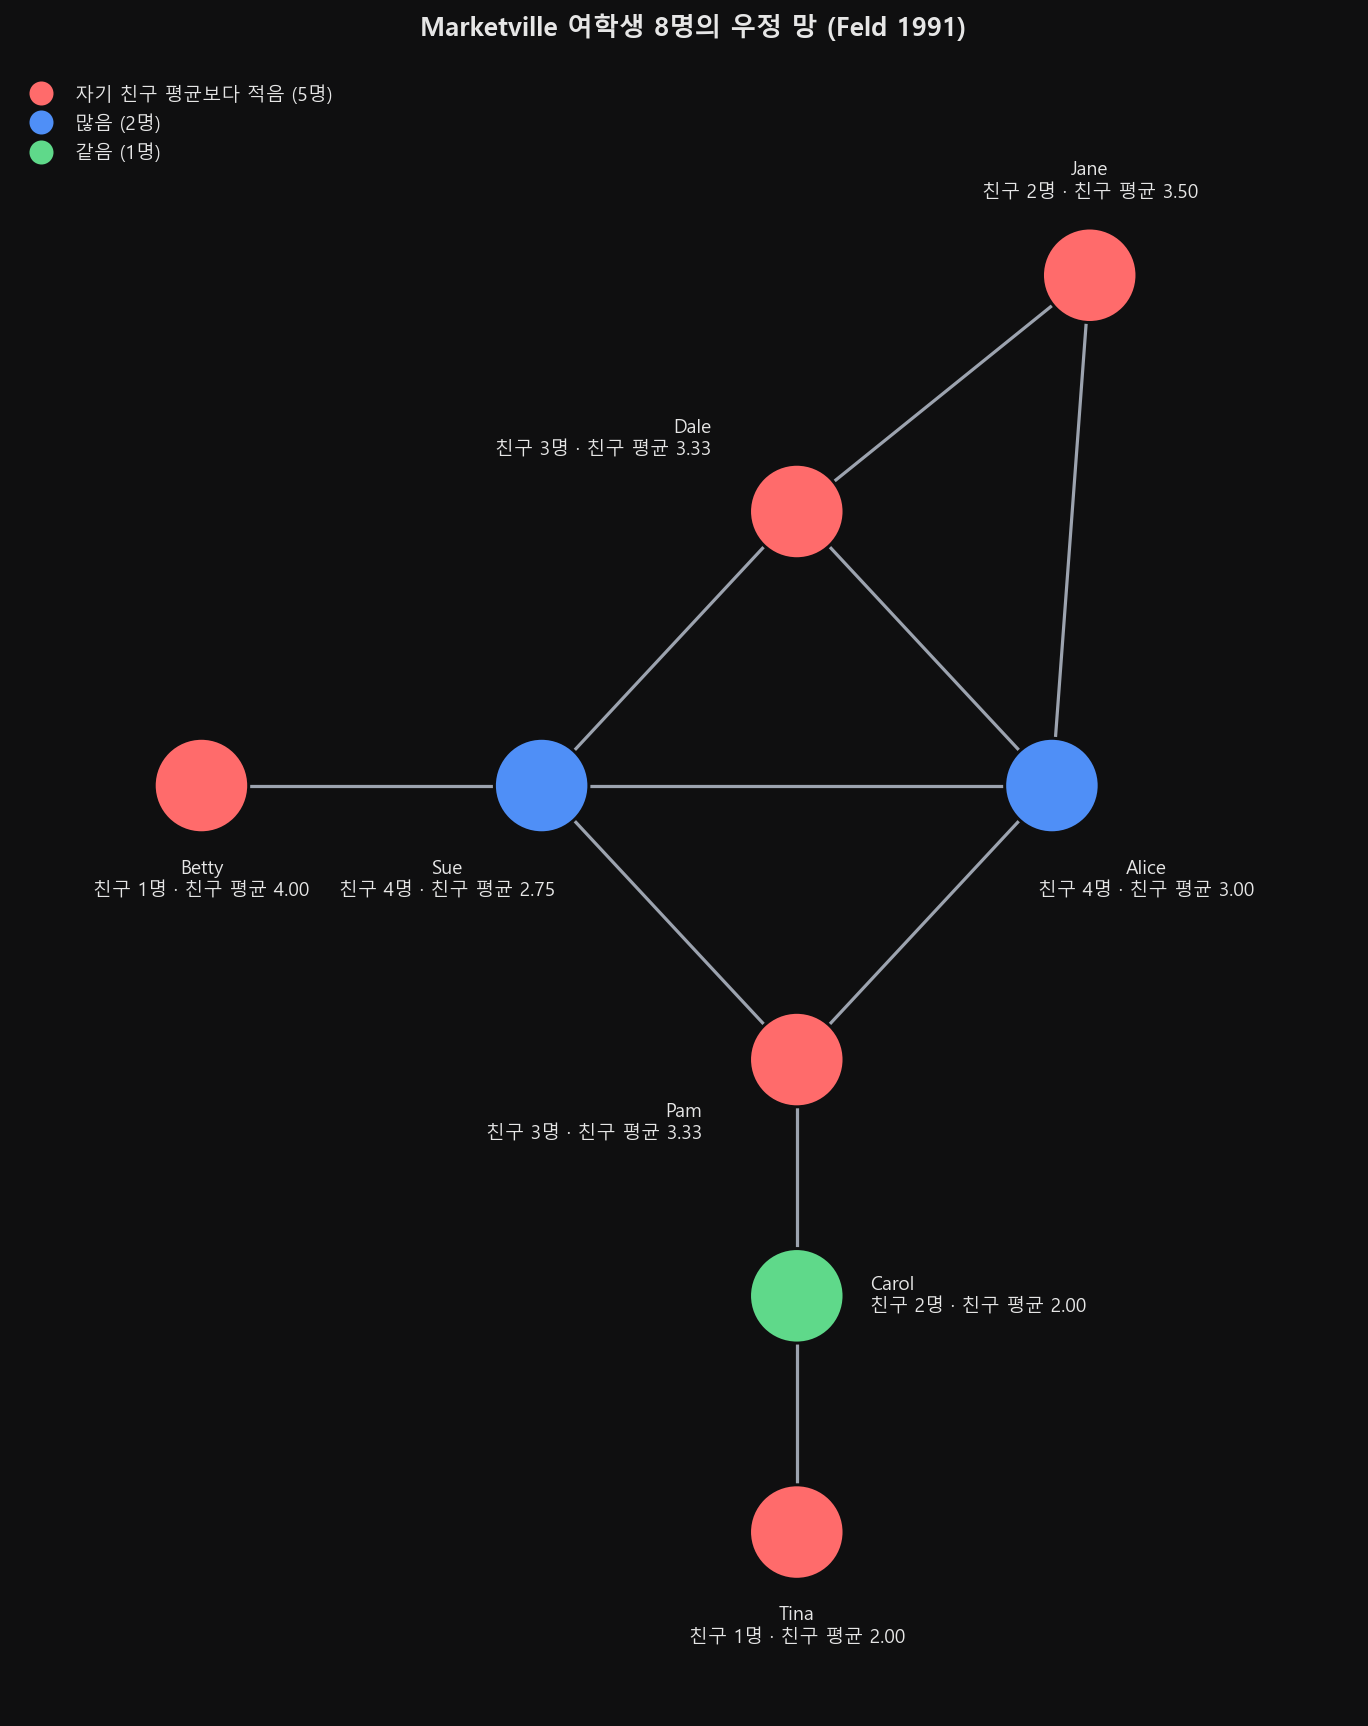
그림 1 의 관계망을 그대로 코드로 옮겨, 두 가지 평균을 각각 계산해 보자. 하나는 여덟 명의 친구 수 평균이고, 다른 하나는 열 쌍의 친구 관계를 양 끝에서 한 번씩 센 친구의 친구 수 평균이다.
# Feld 1991 그림 1 — Marketville 여학생 8명, 친구 관계 10쌍
edges = [
    ("Betty", "Sue"), ("Sue", "Dale"), ("Sue", "Alice"), ("Sue", "Pam"),
    ("Jane", "Dale"), ("Jane", "Alice"), ("Dale", "Alice"),
    ("Alice", "Pam"), ("Pam", "Carol"), ("Carol", "Tina"),
]

friends = {}
for a, b in edges:
    friends.setdefault(a, set()).add(b)
    friends.setdefault(b, set()).add(a)

names = ["Betty", "Sue", "Alice", "Jane", "Pam", "Dale", "Carol", "Tina"]
deg = {n: len(friends[n]) for n in names}

total_friends = sum(deg.values())                          # 친구 수 합
total_ff = sum(deg[f] for n in names for f in friends[n])  # 친구의 친구 수 합

mean_person = total_friends / len(names)
mean_ff = total_ff / total_friends
fewer = sum(1 for n in names
            if deg[n] < sum(deg[f] for f in friends[n]) / deg[n])

for n in names:
    ff_sum = sum(deg[f] for f in friends[n])
    print(f"{n:6s} 친구 {deg[n]}명  친구의 친구 수 합 {ff_sum:2d}  친구 평균 {ff_sum/deg[n]:.2f}")
print(f"친구 수 합 {total_friends}, 친구의 친구 수 합 {total_ff}")
print(f"개인 평균 {mean_person:.1f}  vs  친구의 친구 수 평균 {mean_ff:.1f}")
print(f"자기 친구 평균보다 친구가 적은 사람: {len(names)}명 중 {fewer}명")
Betty 친구 1명 친구의 친구 수 합 4 친구 평균 4.00
Sue 친구 4명 친구의 친구 수 합 11 친구 평균 2.75
Alice 친구 4명 친구의 친구 수 합 12 친구 평균 3.00
Jane 친구 2명 친구의 친구 수 합 7 친구 평균 3.50
Pam 친구 3명 친구의 친구 수 합 10 친구 평균 3.33
Dale 친구 3명 친구의 친구 수 합 10 친구 평균 3.33
Carol 친구 2명 친구의 친구 수 합 4 친구 평균 2.00
Tina 친구 1명 친구의 친구 수 합 2 친구 평균 2.00
친구 수 합 20, 친구의 친구 수 합 60
개인 평균 2.5 vs 친구의 친구 수 평균 3.0
자기 친구 평균보다 친구가 적은 사람: 8명 중 5명답이 여기서 다 나왔다. 여덟 명의 친구 수를 그냥 더해 여덟으로 나누면 2.5명이다. 같은 여덟 명을 친구 목록 쪽에서 세면 3.0명이 된다. 여덟 명 중 누구도 친구를 더 사귀지 않았는데 평균만 0.5명 올라간 것이다. Sue 와 Alice 처럼 친구가 4명인 사람이 네 번씩 계산에 들어가고, Betty 와 Tina 처럼 1명인 사람은 한 번만 들어가기 때문이다.
개인 기준으로 보면 여덟 명 중 다섯 명이 자기 친구들의 평균보다 친구가 적다. Sue 와 Alice 두 명은 더 많고, Carol 한 명은 같다. 큰 쪽을 그만큼 여러 번 세는 표본 이야기는 이 블로그의 검사 역설 편에서도 다뤘다. 이제 이 방향이 여덟 명짜리 예에서 우연히 나온 것이 아님을 확인할 차례다.
왜 항상 성립하는가 — 항등식 한 줄
8명 예시는 어쩌다 그렇게 나온 것이 아니다. 두 평균의 관계는 식 한 줄로 고정돼 있다. 그 식에 분산이 들어가는데, 분산은 각 사람의 친구 수가 평균에서 얼마나 떨어져 있는지를 제곱해 평균 낸 값이다. 친구 수가 들쭉날쭉할수록 커지고, 전원이 똑같으면 0이다. 말로 하면 이렇다. 친구의 친구 수 평균은 친구 수 평균에 분산을 평균으로 나눈 값을 더한 것과 같다.
여기서 $x_i$ 는 사람 $i$ 의 친구 수, $\bar{x}$ 는 그 평균, $s^2$ 는 분산이다. 왼쪽 분자가 제곱합인 이유는 친구가 $x_i$ 명인 사람이 $x_i$ 개의 목록에 등장해 매번 $x_i$ 라는 값을 보태기 때문이다.
8명으로 검산해 보자. 친구의 친구 수 합 60을 친구 수 합 20으로 나누면 3.0이다. 오른쪽은 평균 2.5에 분산 1.25를 2.5로 나눈 0.5를 더해 역시 3.0이다. 두 값이 맞는다.
식 1 은 항등식이므로 부등호는 덤으로 따라온다. 분산은 제곱들의 평균이라 음수가 될 수 없고, 그래서 오른쪽은 $\bar{x}$ 보다 작아질 수 없다. 등호는 분산이 정확히 0일 때, 즉 모두가 똑같은 수의 친구를 가질 때만 성립한다.
한 사람 $i$ 기준으로 "내 친구들의 평균"은 따로 정의된다. 내 친구 각자의 친구 수를 모두 더한 다음, 내 친구 수로 나눈 값이다.
$N(i)$ 는 $i$ 의 친구 집합이다. 식 1 은 사람들 전체의 두 평균을 비교하고, 식 2 은 한 사람의 몫만 잰다. 같은 질문이 아니다. 그래서 "몇 %가 자기 친구 평균에 못 미치는가"는 항등식이 답해 주지 않는다.
비율은 배치가 정한다 — 같은 친구 수 분포로도 0%에서 75%까지
식 1 이 보장하는 것은 평균끼리의 대소뿐이다. "모든 사람이 자기 친구 평균보다 친구가 적다"는 명제가 아니다. 개인 몇 %가 미달인지는 정리가 아니라 관계망의 배치가 정한다. Feld 자신도 다수가 오히려 더 많아지는 예외적 배치를 논문 그림 5에 실었다.
친구 3명인 사람 4명과 친구 1명인 사람 12명, 모두 16명을 놓고 배치만 바꿔 보면 그 폭이 선명하다. 어떻게 이어도 개인 평균은 1.5명, 친구의 친구 수 평균은 2.0명으로 고정된다. 그런데 개인 기준 비율은 크게 흔들린다. 친구 많은 네 명을 자기들끼리 묶으면 16명 중 0명이 미달이고, 그 네 명이 각자 친구 적은 사람들을 거두면 16명 중 12명, 즉 75%가 미달이다. 관계를 무작위로 이어 붙인 경우에는 평균 43% 근처였다.
관계를 무작위로 이어 붙이면, 비율을 밀어 올리는 것은 평균이 아니라 분산이다. 2,000명짜리 관계망을 차수 분포만 바꿔 가며 시드 30개씩 돌려 보면 그대로 드러난다. 전원이 친구 5명이면 미달 비율이 0.5%로 사실상 없고, 친구 수가 평균 5명 근처에서 조금씩 흩어지면 65%, 한쪽 꼬리가 두꺼운 로그정규 분포에서는 85%까지 오른다.
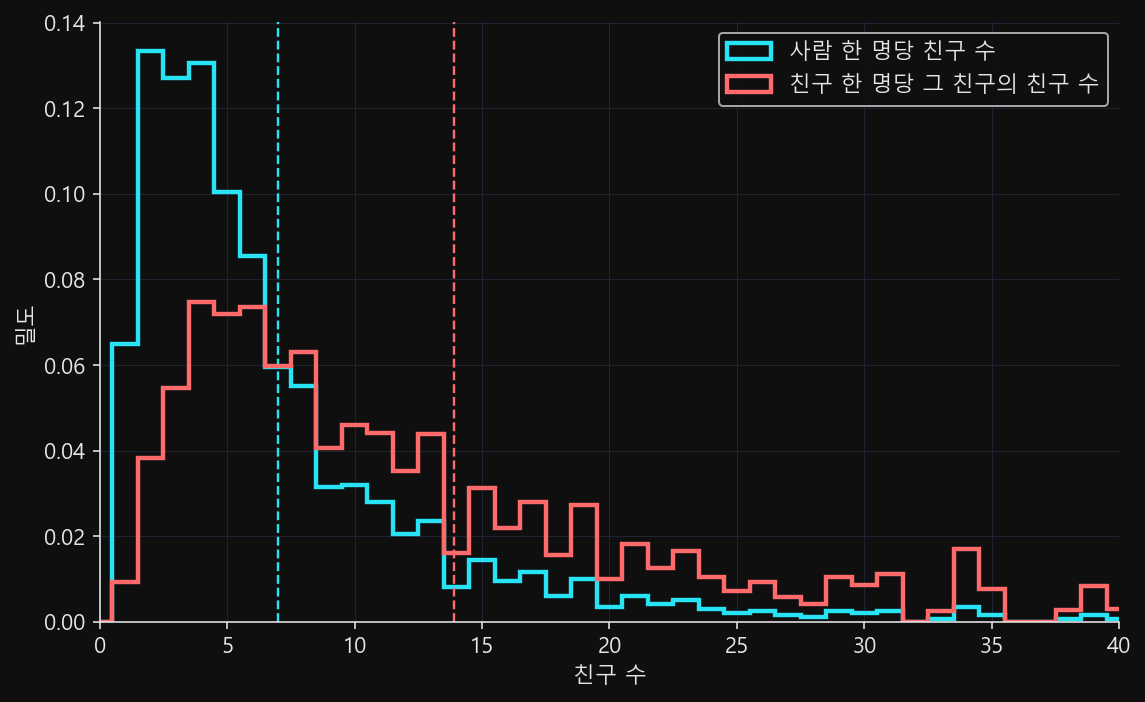
그림 2 에서 오른쪽으로 밀린 만큼이 식 1 의 분산 항이다. 실제 사회 관계망의 친구 수 분포는 대개 오른쪽 꼬리가 길어서, 이 밀림은 예외가 아니라 기본값에 가깝다.
Feld 가 분석한 Marketville 전체 자료도 그 방향이다. 상호 친구가 있는 여학생 146명 중 80명이 자기 친구 평균보다 친구가 적었고, 41명이 많았으며, 25명이 같았다. 학생 기준 평균 친구 수는 2.7명인데 친구 목록 기준으로는 3.4명이었다. Feld 는 3.4명을 기준선으로 삼으면 146명 중 74%가 그 아래에 놓인다고 적었다.
규모를 훨씬 키워도 방향은 같다. Ugander 연구팀이 분석한 2011년 5월 페이스북 스냅샷에는 활성 사용자 7.21억 명과 상호 친구 관계 687억 쌍이 들어 있다. 이 활성 사용자 중 92.7%가 자기 친구들의 평균 친구 수보다 친구가 적었다. 연구팀은 친구들 사이에서 내가 몇 번째인지를 묻는 데는 중앙값이 더 맞는 비교라며 중앙값으로도 쟀다. 그 기준으로도 83.6%가 자기 친구들의 중앙값에 못 미쳤다.
결함이 아니라 도구다 — 무작위 친구를 뽑으면 유행이 먼저 보인다
여기까지는 편향이 사람을 억울하게 만드는 이야기였다. 그런데 방향을 뒤집으면 쓸모가 생긴다. 무작위로 뽑은 사람에게 친구 한 명을 지목해 달라고 하면, 그 친구는 평균보다 연결이 많은 쪽으로 치우친다. 아무도 관계망 전체를 조사하지 않았는데도 그렇다. 편향이 대신 골라 주기 때문이다.
연결이 많은 사람은 유행에 먼저 닿는다. 감염병이든 소문이든 통로가 많은 쪽으로 먼저 흐르기 때문이다. 그러니 유행을 일찍 알아채고 싶다면 연결이 많은 사람들을 골라 지켜보면 된다. 문제는 누가 연결이 많은지 알려면 원래 관계망 전체를 조사해야 한다는 점이다. 친구 역설은 그 조사 없이 같은 사람들을 뽑는 지름길을 준다.
Christakis 와 Fowler 는 2009년 가을 하버드에서 이 발상을 시험했다. 무작위로 고른 학생 319명과 그들이 지목한 친구 425명, 두 집단의 독감 발생을 나란히 추적했다. 친구 집단의 유행 곡선이 먼저 올라갔다. 무작위 집단보다 13.9일 앞섰다(95% 신뢰구간 9.9~16.6일).
같은 구조를 모형에서도 돌려 볼 수 있다. 5,000명 규모의 관계망에 무작위 표본 300명과 그들이 지목한 친구 300명을 두고 감염 과정을 굴렸다. 두 표본의 평균 친구 수는 6.80명과 12.97명으로 갈렸다. 무작위 표본 쪽 평균과 분산을 식 1 에 넣으면 12.8명이 나오는데, 친구 표본에서 실제로 잰 12.97명이 그 값과 거의 같다.
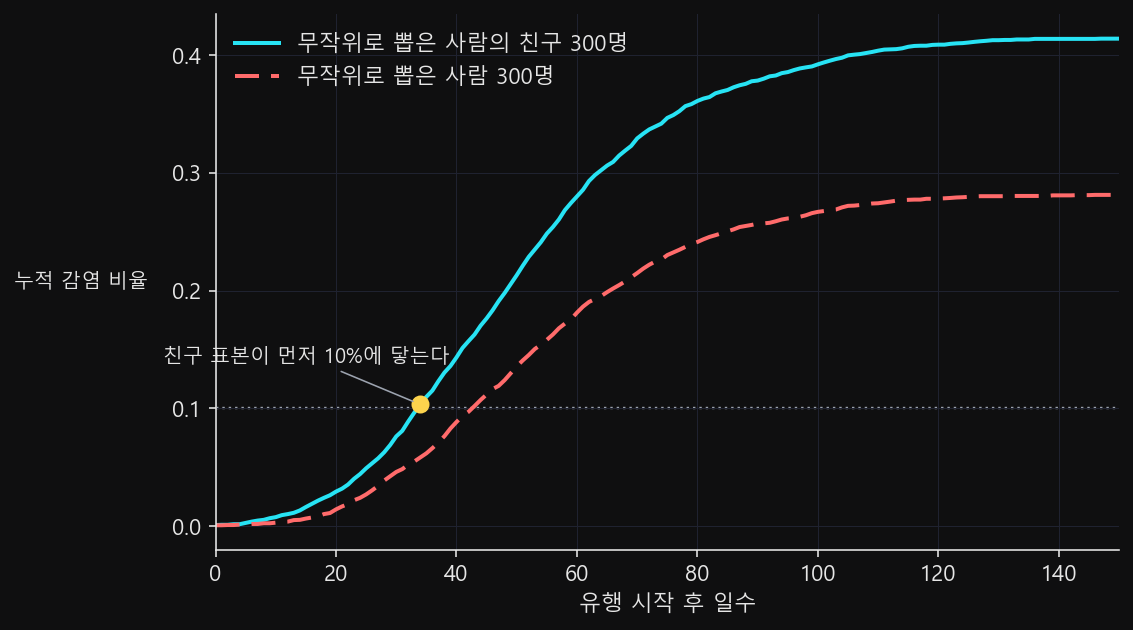
그림 3 에서 친구 표본은 시드별로 재면 감염 10% 지점에 평균 6.7일 먼저 닿았다. 시드 20개 중 유행이 실제로 번진 것은 15개였다. 그 15개 전건에서 친구 표본이 뒤처지지 않았다. 다만 이 6.7일은 모형이 낸 숫자이지 하버드의 13.9일을 재현한 값이 아니다. 관계망도 전파율도 다르므로 두 숫자는 따로 읽어야 한다. 모형이 말해 주는 것은 며칠 앞선다는 방향까지다.
같은 편향은 사람 대신 자리를 셀 때도 나타난다. 학교가 발표하는 평균 수업 규모보다 학생이 실제로 앉아 있는 강의실의 평균 인원이 더 많다. 큰 강의실이 그만큼 많은 학생의 경험에 들어가기 때문이다. Feld 와 Grofman 이 1977년에 이 수업 규모 역설을 다뤘다. Feld 가 든 또 다른 예는 도시다. 대부분의 도시는 작지만, 대부분의 사람은 큰 도시에 산다.
친구 목록이 기울어져 있다는 사실을 알고 나면 그 기울기를 쓸 수 있다. 관계망 전체를 조사하려면 누가 누구와 이어져 있는지를 전부 캐물어야 하지만, 무작위로 한 사람을 뽑아 친구를 한 명 지목받는 데는 질문 두 개면 된다. 그 한 번의 선택으로 유행을 며칠 앞서 보는 감시 표본이 만들어진다. 표본을 고르는 사람은 그 관계망에 대해 아무것도 몰라도 된다. 대신 편향이 일을 한다. 나를 초라하게 만들던 그 편향과 정확히 같은 편향이다.
더 읽기
- S. L. Feld, "Why Your Friends Have More Friends Than You Do", American Journal of Sociology 96(6), 1991, 1464–1477. https://www.jstor.org/stable/2781907
- J. Ugander, B. Karrer, L. Backstrom, C. Marlow, "The Anatomy of the Facebook Social Graph", arXiv:1111.4503 (2011). https://arxiv.org/abs/1111.4503
- N. A. Christakis, J. H. Fowler, "Social Network Sensors for Early Detection of Contagious Outbreaks", PLoS ONE 5(9): e12948 (2010). https://doi.org/10.1371/journal.pone.0012948