챗봇에게 두 자리끼리의 곱셈을 시키면 거의 다 맞힌다. 그런데 다섯 자리씩으로 늘리면 정답률이 뚝 떨어지고, 그 오답을 들여다보면 자릿수도 맞고 앞머리도 맞고 끝 두 자리도 맞는데 딱 가운데만 틀려 있다. 답의 크기와 양 끝을 어디선가 본 모양대로 맞춰 놓은 쪽에 가깝다. 그래서 풀이 과정을 한 줄씩 쓰게 하면 같은 모델이 훨씬 큰 자릿수의 곱셈까지 맞힌다.
오답 한 줄을 뜯어본다
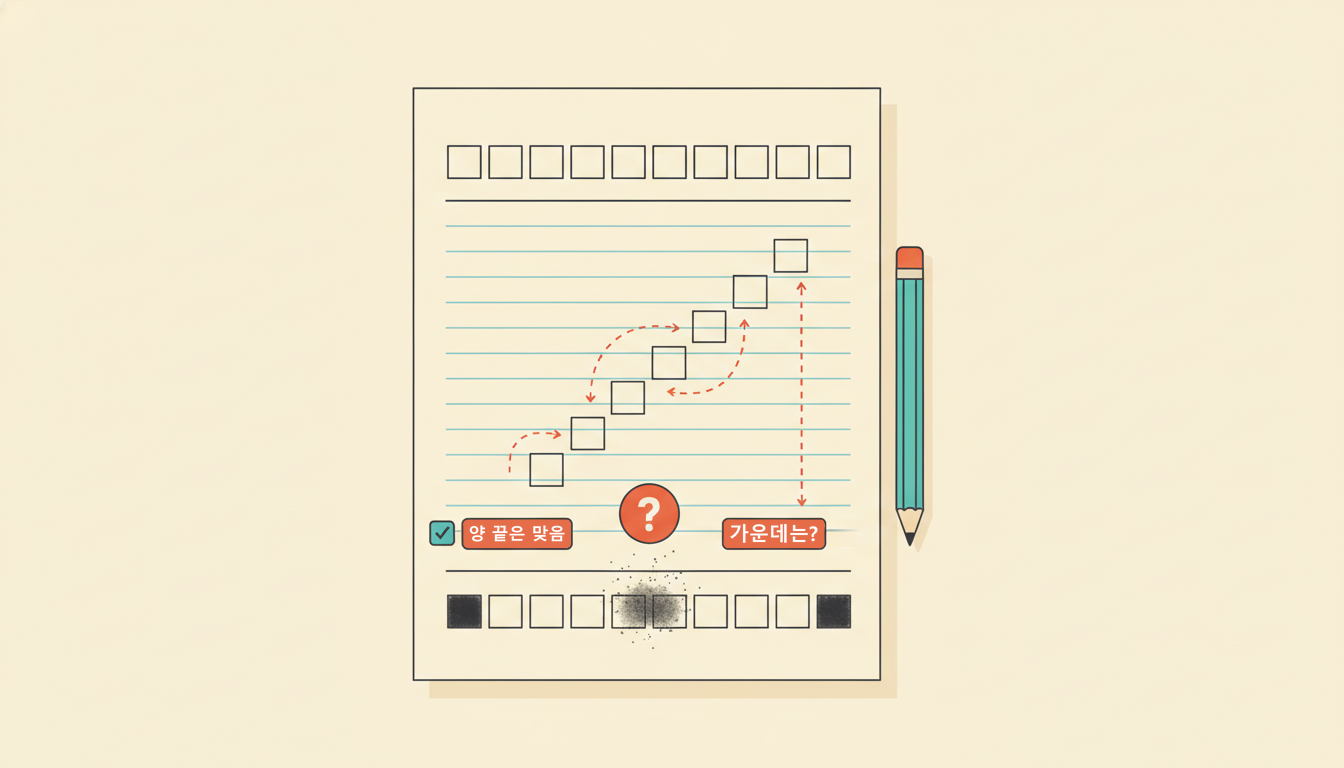
챗봇에게 69824 × 90943을 물어봤더니 6350015432라는 답이 돌아왔다. 정답은 6350004032다. 두 답을 한 자리씩 맞대 보면 열 자리라는 자릿수가 같고, 앞의 다섯 자리 63500이 같고, 끝의 두 자리 32도 같다. 어긋난 자리는 여섯째·일곱째·여덟째 셋뿐이다. 정답이 0·4·0을 둔 자리에 1·5·4가 들어가 있다.
틀린 답을 하나 받는 것 자체는 놀랍지 않다. 눈에 걸리는 것은 틀린 위치다. 답의 자릿수와 앞머리와 끝자리는 그대로 두고 가운데만 헝클어져 있으니, 끝까지 계산해 놓고 한 군데서 미끄러진 모양이 아니다. 계산기라면 이렇게 틀릴 수가 없다. 답의 크기와 시작과 끝은 이미 알고 있는데 그 사이를 채우지 못한 쪽에 가깝다.
챗봇에 숫자를 그대로 던져 본 사람이라면 이런 답을 한 번쯤 받아 봤을 것이다. 문장으로 된 답은 어색하면 티가 나는데, 숫자로 된 답은 자릿수만 그럴듯해도 맞아 보인다. 열 자리짜리 답을 받아 들고 한 자리씩 검산하기도 번거로우니, 이런 오답은 손에 쥔 채로 그냥 지나가기 쉽다. 이 글은 그 그럴듯함이 어디서 오는지를 따라간다.
답 하나로는 우연일 수 있다. 그래서 같은 모델에 곱셈 문제를 1,440번 물어봤다. 2026년 9월 22일에 gemini-3.1-flash-lite라는 모델을 놓고, 첫 수와 둘째 수를 각각 한 자리부터 여섯 자리까지 짝지었다. 그렇게 나온 서른여섯 가지 조합마다 스무 문제씩 냈다. 곱할 두 수는 미리 정해 둔 규칙으로 뽑았고, 한 번 돌린 결과를 그대로 다 썼다. 숫자만 답하라고 한 720문제 중 틀린 답이 146개였고, 위의 6350015432도 그 가운데 하나다.
채점은 정확히 일치할 때만 정답으로 셌다. 한 자리라도 다르면 오답이고, 어림이나 반올림은 인정하지 않았다. 응답에 숫자가 여럿 섞여 있으면 마지막 숫자를 답으로 보고 정답과 견줬다. 서른여섯 조합에 조건이 둘이라 응답이 1,440건이 됐고, 이 글의 실측값은 전부 그 안에서 뽑은 것이다.
곱셈은 칸이 잔뜩 있는 계산표다
이 오답의 정체는 초등학교 세로셈을 다시 꺼내 보면 드러난다. 23 × 47을 손으로 풀 때 우리가 실제로 하는 한 자리 곱셈은 네 번이다. 7과 3, 7과 2, 4와 3, 4와 2를 각각 곱하고 그 결과를 자리에 맞춰 쌓아 더한다. 다섯 자리끼리의 곱셈이라면 같은 한 자리 곱셈을 스물다섯 번 해야 한다. 채워야 할 칸의 수는 두 수의 자릿수를 곱한 값이다.
칸이 불어나는 속도가 이 이야기의 절반이다. 두 자리끼리는 4칸, 세 자리끼리는 9칸, 네 자리끼리는 16칸, 다섯 자리끼리는 25칸이다. 두 수의 자릿수를 나란히 하나씩 늘릴 때마다 가로로 한 줄 세로로 한 줄이 함께 붙으니, 칸만 세어도 다섯 자리 곱셈은 두 자리 곱셈의 여섯 배가 넘는다. 그리고 칸을 다 채운 뒤에도 그 값들을 자리에 맞춰 쌓아 더하는 일이 남아 있다.
물어본 서른여섯 가지 조합의 정답률을 격자로 늘어놓으면 그림 1 처럼 된다. 두 수의 자릿수를 더한 값이 7인 조합에서는 120문제가 전부 정답이었다. 8에서 88%로 내려오고, 9에서 69%, 10에서 18%가 되더니, 11과 12에서는 한 문제도 맞히지 못했다. 내려가는 모양도 완만하지 않아서, 7까지 100%에 붙어 있던 정답률이 네 계단 만에 0이 된다. 다섯 자리끼리와 여섯 자리끼리는 스무 문제 중 0개다.
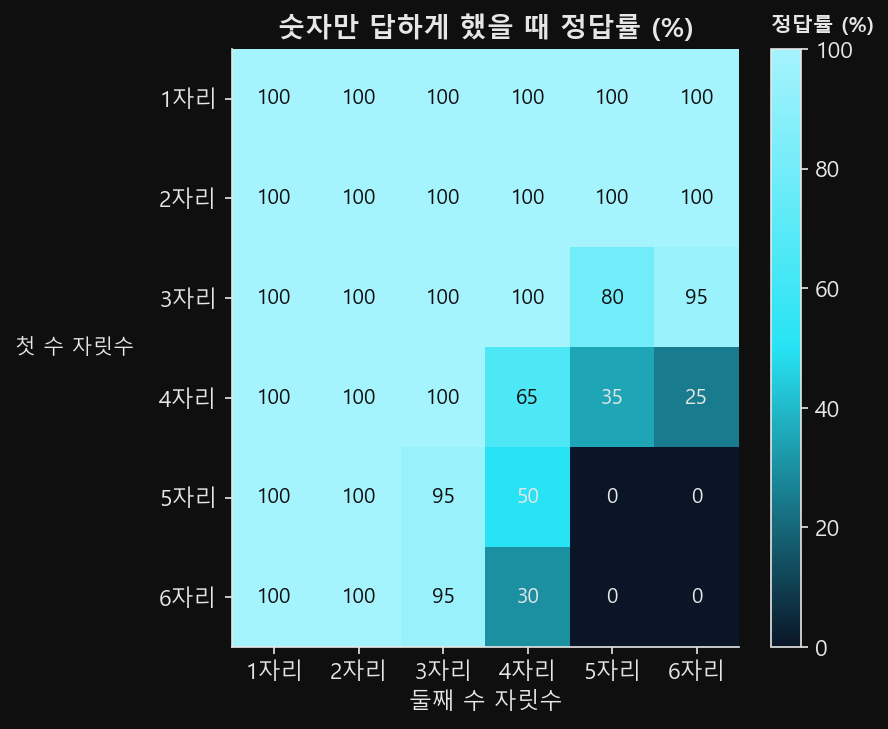
조합 하나에 스무 문제씩이라 몇 퍼센트 차이는 읽지 않는 편이 낫다. 여기서 읽을 것은 100에서 0으로 내려가는 모양이다. 이 값들은 모델 한 종(gemini-3.1-flash-lite, 내부 추론 기능을 끈 상태)을 2026년 9월 22일 하루 잰 것이다. 모델이나 날이 바뀌면 같은 수가 나오는지는 다시 재 봐야 안다.
격자의 가장자리는 사정이 다르다. 여섯 자리 × 한 자리는 스무 문제가 전부 정답이고, 여섯 자리 × 두 자리도 그렇다. 여섯 자리라는 긴 수 자체가 문제였다면 이쪽도 같이 무너져야 하는데 그렇지 않다. 무너지는 것은 양쪽이 다 길어질 때, 그러니까 채워야 할 칸이 한꺼번에 불어날 때다. 어려움을 가르는 것은 자릿수의 크기가 아니라 자릿수를 곱한 칸의 개수다.
같은 모양을 먼저 기록해 둔 연구가 있다. Dziri 연구팀은 2023년 1월부터 5월 사이에 GPT-4를 비롯한 여러 모델에 같은 종류의 곱셈을 시키고 자릿수별 정답률을 격자로 냈다. GPT-4는 두 자리끼리 99%, 세 자리끼리 59%, 네 자리끼리 4%, 다섯 자리끼리 0%였다. 그런데 한쪽이 한 자리이면 다른 쪽이 다섯 자리여도 91%다. 2023년의 모델과 2026년의 모델이, 만든 회사도 계열도 다른데 같은 모양으로 주저앉는다. 다만 그 자리가 한 계단 다르다 — 네 자리끼리에서 GPT-4는 4%였고 우리 실측은 65%였다.
논문은 세 자리끼리의 곱셈을 사람과 견주는 데서 이야기를 연다. 기본 계산 규칙만 익히면 사람은 그 곱셈을 풀 수 있는데, 당시 ChatGPT는 55%, GPT-4는 59%에 그쳤다는 것이다. 자릿수로 치면 고작 세 자리, 칸으로 세면 아홉 개다. 긴 수 하나를 다루는 일은 이 모델들에게 어렵지 않고, 어려워지는 것은 긴 수 두 개가 만나 칸이 한꺼번에 불어날 때다. 칸을 다 채우지 못한 답이 어떻게 생겼는지는 틀린 답 쪽에 남아 있다.
틀린 답도 모양은 맞는다
틀린 답 146개를 정답과 자리별로 맞대 보면, 자릿수가 같은 것이 145개다. 앞 두 자리가 맞는 것이 144개, 끝 한 자리가 140개, 끝 두 자리까지가 133개였다. 거의 모든 오답이 답의 크기와 양 끝은 맞혀 놓고 그 사이에서 틀렸다는 뜻이다.
논문 쪽에도 같은 해부가 있다. GPT-4에 다섯 자리끼리의 곱셈을 시켰을 때 답 전체를 맞힌 비율은 0%다. 그런데 맨 앞자리도, 답의 자릿수도, 맨 끝자리도 100%다. 앞 두 자리는 98%, 끝에 붙은 0의 개수는 97%인데, 끝 두 자리에서 63%로 내려앉는다.
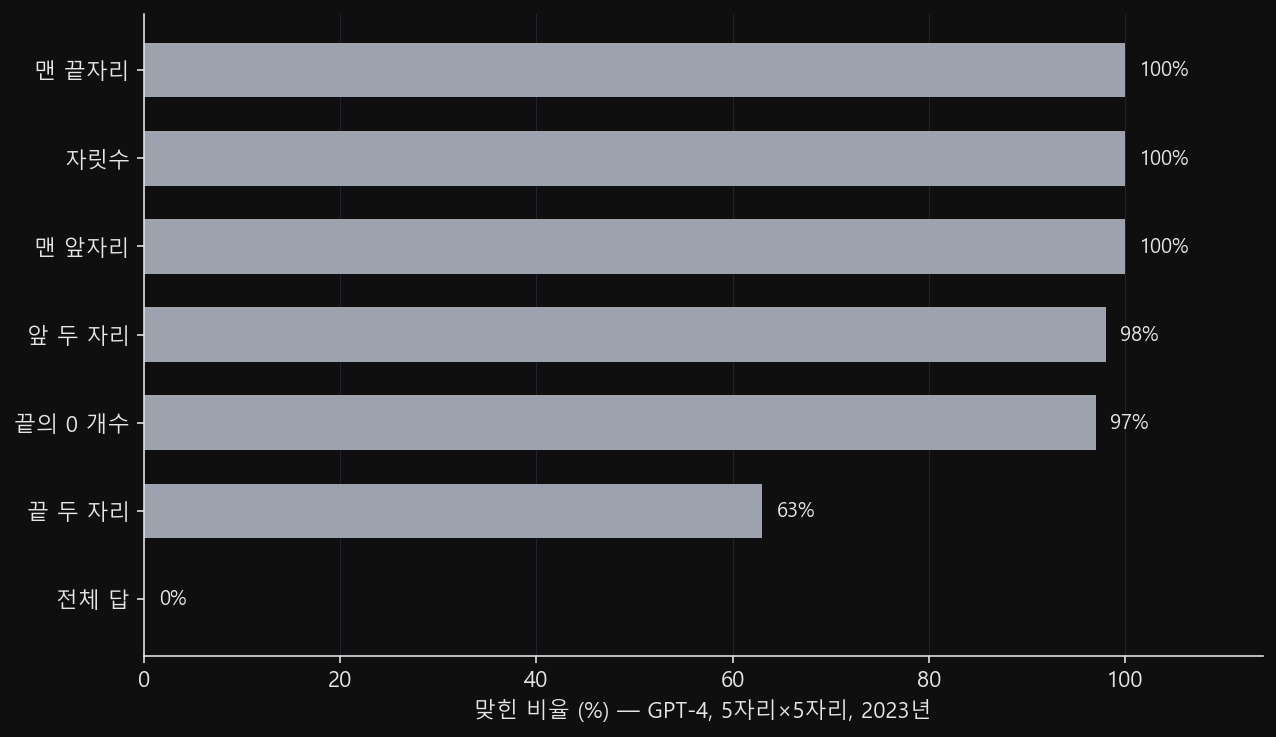
그림 2 에서 눈여겨볼 곳은 마지막 막대가 짧아지는 자리다. 끝 한 자리는 두 수의 끝자리끼리 한 번 곱하면 바로 나온다. 끝 두 자리부터는 아래 자리에서 올라온 올림이 섞이니 그제야 진짜 계산이 필요해진다. 정답률이 꺾이는 곳은 계산이 필요해지는 자리다.
그렇다면 맞은 답은 계산해서 나온 것일까? 그 물음에 가장 가까운 답은 같은 논문의 다른 실험, 풀이 과정을 함께 쓰도록 모델을 따로 훈련시킨 쪽에 있다. 거기서 네 자리 × 두 자리 곱셈의 최종 답이 맞은 경우만 골라 보니, 그중 82.3%는 계산 어딘가에 이미 오류를 안고 있었다. 논문은 사전 훈련 데이터에 그 문제와 답의 짝이 자주 등장했을 가능성을 든다. 크기와 양 끝을 맞히는 일은 계산의 결과라기보다 어디선가 본 답의 생김새를 되살린 것에 가깝다.
왜 하필 가운데가 틀리나 — 쓰는 순서의 문제
칸의 개수가 이야기의 절반이었다면, 나머지 절반은 답을 적는 순서다. 사람은 손으로 세로셈을 할 때 맨 오른쪽 끝자리부터 적는다. 그 순서가 편한 데에는 습관 말고 다른 이유가 있다.
- 두 수를 자리에 맞춰 위아래로 적는다.
- 맨 오른쪽 자리부터 한 자리씩 곱한다. 열이 넘으면 넘친 만큼을 왼쪽 자리로 올린다.
- 자리를 하나씩 왼쪽으로 옮기며 같은 일을 되풀이하고, 나온 줄들을 자리에 맞춰 쌓는다.
- 쌓인 줄을 다시 맨 오른쪽부터 더해 답을 적는다.
Lee 연구팀이 덧셈을 놓고 이 순서를 증명해 두었다. 오른쪽 끝자리부터 쓰는 방법은 자리마다 그 자리의 두 숫자와 직전 올림만 있으면 된다. 왼쪽 맨 앞자리부터 쓰려면 첫 글자를 적기 전에 두 수의 모든 자리를 알고 있어야 한다 — 문제를 다 풀어 둬야 한다는 뜻이다.
챗봇은 글을 앞에서부터 한 조각씩 이어 붙이는 방식이라 답도 왼쪽부터 쓴다. 그런데 앞에서 본 대로 그 맨 앞자리는 거의 틀리지 않는다. 전부 계산하고 적어서는 아니다 — 답의 앞자리가 두 입력의 앞자리와 강하게 맞물려 있어 끝까지 풀지 않아도 짐작된다는 것을 Dziri 연구팀이 확인했다.
같은 연구팀은 틀린 값이 어디서 생겼는지도 갈라 세어 두었다. 한 칸의 계산 자체를 틀린 경우와, 계산은 맞았는데 가져다 쓴 앞 칸의 값이 이미 틀려 있던 경우다. 대개는 후자가 더 많았고, 계산이 깊이 들어갈수록 맞은 칸의 비율은 0으로 떨어졌다. 한 걸음씩은 맞히는데 그 걸음을 이어 가지 못한다는 설명이다. 그림 3 의 네 단계 중 세 번째가 그 이어 가는 자리다.
McLeish 연구팀은 한 걸음 더 들어가 자리 자체를 지목한다 — 긴 숫자 안에서 각 자리가 몇 번째인지를 모델이 정확히 붙들지 못한다는 것이다. 사람은 자리를 세로로 맞춰 놓고 시작하는데 모델에게는 그렇게 맞춰 둘 자리가 없다. 앞에서 한 자리가 어긋나면 그 값을 받아 쓰는 뒤쪽이 통째로 따라 어긋나고, 그렇게 답의 가운데가 무너진다.
풀이를 쓰게 하면, 그리고 그 대가
무너지는 자리는 옮길 수도 있다. 1,440번의 실측에 조건이 하나 더 있었다. 절반은 「답 숫자만 쓰라」고 했고, 나머지 절반은 「풀이 과정을 단계별로 쓰고 마지막 줄에 답을 쓰라」고 했다. 모델도 설정도 문제도 같고 다른 것은 프롬프트의 이 한 줄뿐이다. 결과는 그림 4 처럼 갈렸다.
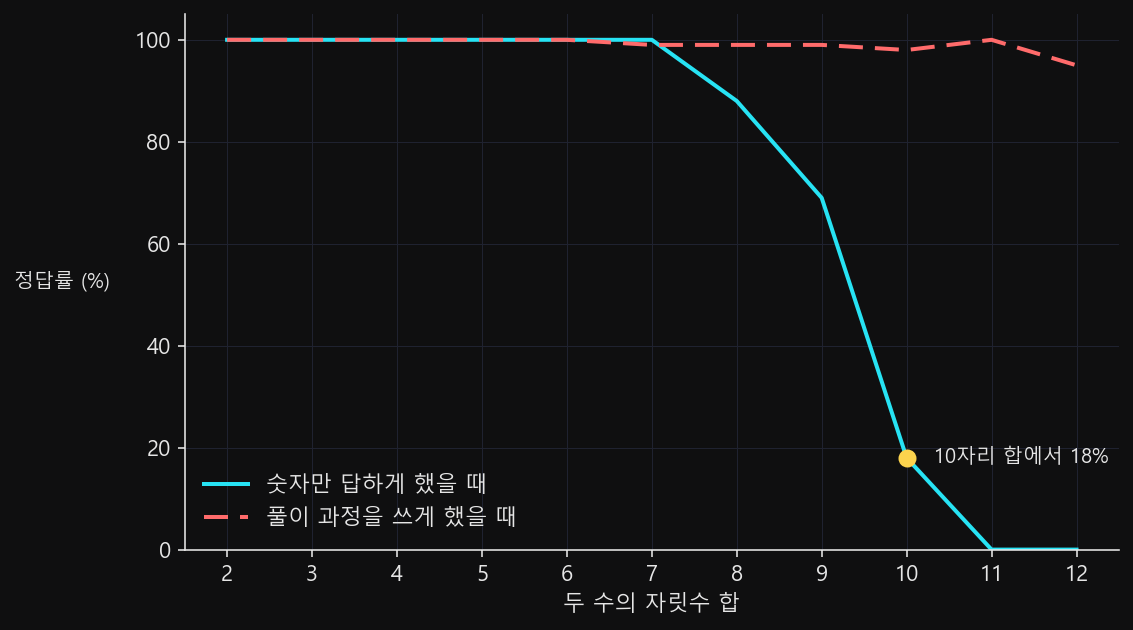
숫자만 답하게 한 쪽은 자릿수 합 10에서 18%로 떨어지고, 11과 12에서는 0%다. 풀이를 쓰게 한 쪽은 같은 세 지점에서 98%, 100%, 95%다. 여섯 자리끼리의 곱셈도 스무 문제 중 열아홉을 맞혔는데, 같은 모델이 답만 내놓게 했을 때는 한 문제도 못 맞히던 자리다.
모델이 쓴 풀이를 열어 보면 초등학교 세로셈과 같은 분해다. 992206 × 271524 문제에서는 둘째 수를 200000 + 70000 + 1000 + 500 + 20 + 4로 쪼갠 다음, 여섯 개의 부분곱을 하나씩 구해 차례로 더한다. 중간 결과가 전부 글로 적혀 있으니, 다음 줄에 필요한 값은 앞줄에 그대로 있다.
논문에도 풀이 과정을 시킨 실험이 있지만 조건이 다르다. 2023년의 GPT-4에 풀이 예시 몇 개를 보여 주고 같은 곱셈을 시켰다. 세 자리끼리는 59%에서 92%로 올랐지만, 네 자리끼리는 2%, 다섯 자리끼리는 0%였다. 모델부터 2023년 것이다. 이쪽은 사람이 예시를 먼저 보여 준 경우이고, 이 글의 실측은 모델이 스스로 풀이를 썼다. 두 결과를 이어 붙여 「3년 만에 이만큼 늘었다」고 읽을 수는 없고, 나란히 둘 수 있는 것은 풀이를 적게 하면 무너지는 자리가 뒤로 밀린다는 방향뿐이다.
공짜는 아니다. Lee 연구팀은 세 자리 덧셈 한 문제에 오가는 글의 길이를 표로 실었는데, 답만 적게 하면 13이고 상세한 풀이를 적게 하면 281이다(모델이 글을 세는 단위로 잰 값이다). 나눠 보면 스물한 배 남짓이다. 덧셈을 잰 값이라 곱셈의 배수로 옮길 수는 없다. 풀이를 쓰게 할지는 정확도와 답의 길이를 맞바꾸는 선택이 된다.
어디까지 되고, 어디부터는 아직인가
답의 자릿수와 앞머리와 끝자리는 맞는데 가운데가 어긋나 있다면, 그 답은 끝까지 계산해서 나온 것이 아니다. 크기가 맞으니 언뜻 그럴듯해 보이고, 그래서 눈으로 훑어서는 걸러지지 않는다. 두 수의 자릿수가 함께 커질수록 그런 답을 받을 확률이 올라간다는 것까지가 지금 확인된 범위다.
확인하는 방법 자체는 간단하다. 답의 자릿수를 세어 보고, 앞 두어 자리와 끝 두어 자리만 어림해 보면 된다. 그 세 곳이 다 맞는데 답이 틀렸다면, 끝까지 계산을 밟고 나온 답으로 보기 어렵다. 이 실측에서도 틀린 답 146개 중 자릿수까지 어긋난 것은 하나뿐이었고, 그 하나는 0을 길게 이어 쓰다 정해 둔 출력 길이에 걸려 끊긴 응답이었다.
지금은 많은 챗봇이 계산을 코드로 넘겨 맞힌다. 여기 나온 세 연구가 잰 것은 그 경로를 뺀 상태다. 도구를 붙여 주지도 않고 코드를 돌려 주지도 않은 채 모델이 스스로 답을 써 내려가게 한 것이고, 이 글의 실측도 그렇게 쟀다. 코드로 넘겨 맞히는 것은 모델이 계산을 배웠다는 뜻이 아니라 계산을 스스로 하지 않기로 했다는 뜻이다. 그래서 「요즘은 잘하던데」와 「모델이 곱셈을 익혔다」는 서로 다른 이야기다.
고칠 수 있느냐는 물음에는 절반쯤 답이 나와 있다. McLeish 연구팀은 각 자리의 위치를 따로 적어 주는 장치를 넣은 전용 소형 모델을 바닥부터 학습시켰다. 스무 자리까지의 덧셈만 가르쳤다. 그런데 스물한 자리에서 백 자리 구간의 덧셈을 평균 92.9% 맞혔고, 입력을 층마다 다시 넣어 주는 장치와 같은 층을 되돌려 쓰는 변형을 함께 얹자 99.1%가 됐다. 다만 백 자리를 넘기면 31.3%로 떨어지고, 이것은 범용 챗봇이 아니라 이 일만 하도록 만든 작은 모델의 값이다.
곱셈은 아직 그만큼 오지 않았다. 같은 연구에서 곱셈은 학습에서 본 범위 안, 열다섯 자리까지가 거의 완벽해졌을 뿐이고 그 밖으로 나가는 것은 아직이다. 훈련을 퍼붓는 쪽도 이미 시도됐다. Dziri 연구팀은 곱셈 문제와 답 180만 쌍을 GPT-3에 추가로 학습시켰다. 훈련에서 본 범위 안은 97~100%였는데, 범위를 한 계단 벗어난 자리는 2%였다. 외운 자리만 맞는다.
챗봇의 계산 오답에 자주 따라붙는 다른 설명이 하나 있다. 글자를 못 센다는 이야기는 토크나이저 편에서 다뤘는데, 곱셈이 틀리는 이유는 거기에 있지 않다. 자리 위치를 넣은 그 실험은 글자를 하나하나 그대로 읽는 방식을 쓰고도 같은 문제를 만났다. 숫자를 어떻게 쪼개 읽느냐를 바꿔도 자리를 세는 일은 그대로 남았다는 뜻이다.
지금 쓰는 챗봇이 곱셈을 얼마나 맞히는지는 도구와 추론 기능을 켠 채로 다시 재야 나온다. 남는 것은 「지금 만들어진 방식으로는」이라는 단서다. 답을 왼쪽부터 한 번에 뱉는 구조가 큰 수 곱셈에서 무너지고, 그 순서를 바꾸면 무너지던 자리가 뒤로 물러난다. 그래서 그런 답을 앞에 두고 고칠 수 있는 것은 시키는 말 쪽이다. 풀이 과정을 쓰게 하는 것은 그 모델 앞에 자리를 세어 둘 종이 한 장을 밀어 주는 일이다.
더 읽기
- Dziri, Lu, Sclar 외, "Faith and Fate: Limits of Transformers on Compositionality", NeurIPS 2023 (arXiv:2305.18654v3) — https://arxiv.org/abs/2305.18654
- Lee, Sreenivasan, Lee, Lee, Papailiopoulos, "Teaching Arithmetic to Small Transformers", arXiv:2307.03381v1 — https://arxiv.org/abs/2307.03381
- McLeish, Bansal, Stein 외, "Transformers Can Do Arithmetic with the Right Embeddings", NeurIPS 2024 (arXiv:2405.17399v2) — https://arxiv.org/abs/2405.17399