논문이나 기사를 AI 에게 붙여 넣고 요약을 받는다고 해 보자. 원문이 「~로 나타났다」고 조심스럽게 쓴 결론이, 요약에서는 「~이다」처럼 더 넓은 문장으로 바뀌곤 한다. 연구자들이 AI 10종이 쓴 요약 4,900건을 직접 읽어 보니, 이렇게 넓은 결론은 원문보다 요약에 더 자주 들어 있었다. 정확하게 써 달라고 당부한 요청에서도, 모델을 합쳐 보면 이런 요약은 줄지 않았다. 요약에서 결론의 범위가 원문보다 넓어지는 이 현상을 과잉일반화(overgeneralization)라고 한다.
「관련이 있었다」가 「낮춘다」가 된 요약 한 쌍
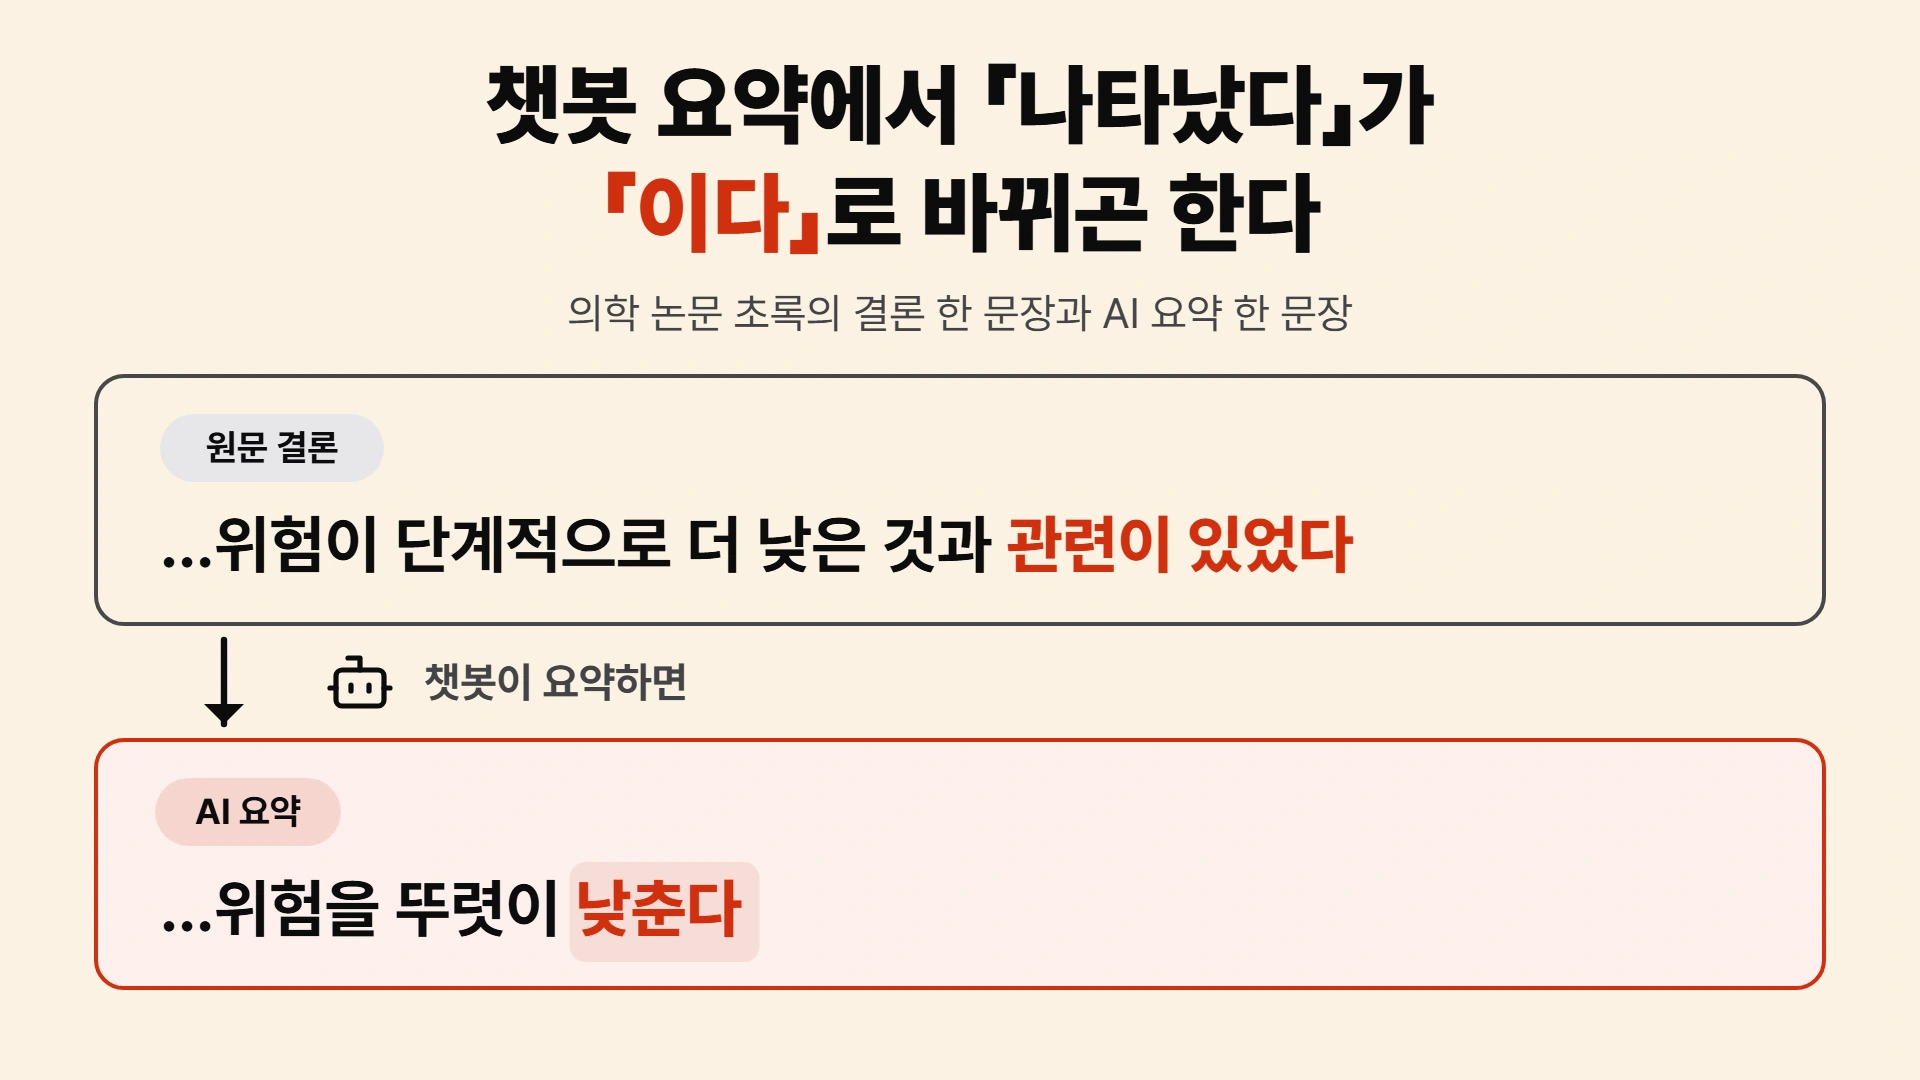
어느 의학 논문 초록은 「임신성 당뇨병을 앓은 적이 있는 여성에서, 좋은 생활 요인이 하나 늘 때마다 제2형 당뇨병 위험이 단계적으로 더 낮은 것과 관련이 있었다」(…was associated with an incrementally lower risk of type 2 diabetes)로 결론을 맺었다. 이 초록을 ChatGPT-4o 에게 요약시키자, 같은 자리에 「임신성 당뇨병을 앓은 적이 있는 여성에게는 건강한 생활 습관 하나하나가 … 제2형 당뇨병 위험을 뚜렷이 낮춘다」(…significantly lowers the risk of type 2 diabetes, …)가 적혀 돌아왔다. 요약을 부탁한 말은 「초록에 나온 주요 결과를 요약해 달라」는 평범한 요청이었다.
두 문장을 나란히 놓으면 낱말은 거의 그대로이고, 누구의 이야기인지도 같다. 바뀐 곳은 두 군데다. 원문은 과거형으로 「관련이 있었다」고 썼는데, 요약은 현재형으로 「낮춘다」고 쓴다. 원문의 「단계적으로 더 낮은 위험」은 요약에서 「뚜렷이 낮춘다」가 됐다. 「관련이 있었다」는 이 연구의 참가자들에게서 두 가지가 함께 나타났다는 관찰이다. 「낮춘다」는 지금 누구에게나 그렇다는 말처럼 읽히고, 이 쌍에서는 원인이라는 어감까지 붙었다(이 어감은 뒤에 나올 연구가 센 기준에는 들지 않는다).
이 쌍은 바뀐 모양이 잘 보여서, 연구자들이 공개한 데이터에서 골라 온 예다. 비율 이야기는 다음 절에서 요약 4,900건을 판정한 연구로 넘긴다. 재료가 의학 논문이지만, 이 글은 생활 습관이나 당뇨병에 관해 아무것도 판단하지 않는다. 보는 것은 문장의 모양뿐이다.
밝혀 둘 것이 하나 있다. 이 자료에서는 요약을 부탁한 말도, 원문 초록도, AI 가 쓴 요약도 전부 영어다. 이 글이 「나타났다」가 「이다」로 바뀐다고 적는 것은, 영어의 과거형이 현재형으로 바뀐 일을 한국어로 옮겨 쓴 것이다.
AI 가 원문에 없는 사실을 지어내는 일도 여기서 세는 대상이 아니다. 그런 일은 AI 가 모르는 것을 지어내는 이유에서 다뤘다. 여기서 보는 것은 원문에 있던 결론의 범위가 넓어지는 일이다. 사실은 그대로이고 시제와 동사만 바뀌었는데도, 문장이 말하는 범위가 달라졌다.
결론의 넓이는 세 가지로 잴 수 있다 — 과잉일반화
결론이 넓다는 것은 그 문장이 닿는 범위가 크다는 뜻이다. 넓이는 세 방향으로 잴 수 있다. 첫째는 누구에게 닿느냐로, 「이 연구의 참가자들에게서」가 「사람들은」이 되면 넓어진다. 둘째는 언제까지 닿느냐로, 「그때 그렇게 나타났다」가 「원래 그렇다」가 되면 한 번의 관찰이 지금도 늘 맞는 사실처럼 읽힌다. 셋째는 무엇을 말하느냐다. 「그렇게 나타났다」는 관찰이 「그렇게 해야 한다」는 권고가 되면 넓어진다.
첫째 방향에는 이름이 있다. 「아이들은 단것을 좋아한다」라는 문장을 보자. 몇 명의 아이인지, 몇 퍼센트인지 말하지 않고 아이들 전체를 한꺼번에 말한다. 이렇게 「~는 …하다」 꼴로 부류 전체를 말하는 문장을 총칭문(generic)이라고 한다. 「이 실험에서 시험한 아이들은」처럼 대상을 밝혀 말하면 총칭문이 아니다.
2025년 학술지 Royal Society Open Science 에 실린 Uwe Peters 와 Benjamin Chin-Yee 의 연구는 이 세 방향을 기준으로 AI 요약을 판정했다. 재료는 의학지와 종합 과학지의 초록 200편, 그리고 임상 논문 전문 100편이다. AI 모델 10종이 쓴 요약 4,900건을 연구자들이 직접 읽고, 결론이 넓은지 좁은지를 하나하나 표시했다. 세 방향 가운데 하나라도 넓으면 「넓은 결론」으로 셌다. 「…일 수 있다」처럼 한정하는 말이 남아 있어도, 결과를 현재형으로 말하면 넓은 것으로 셌다. 과거형으로만 쓴 문장은 총칭문으로 치지 않아서, 이 기준의 총칭문은 늘 현재형 문장이기도 하다.
원문 초록도 일부는 이미 넓은 결론을 담고 있었다. 의학 초록은 100편 중 20편, 과학 초록은 100편 중 88편이 그랬다. 원문이 이미 넓게 쓴 결론을 요약이 그대로 옮겼다면, 요약이 넓힌 것이 아니다. 제목의 과잉일반화는 요약이 원문보다 넓게 말한 경우만 가리킨다. 그래서 연구는 원문 초록과 요약을 같은 잣대로 세어 견준다.
답부터 말하면, 모든 모델을 합쳤을 때 요약은 원문 초록보다 넓은 결론을 더 자주 담았다. 연구는 이 차이를 승산비(오즈비)로 냈다. 승산은 「그럴 확률 ÷ 아닐 확률」이고, 승산비는 요약의 승산을 원문 초록의 승산으로 나눈 값이다. 그 값이 2.00 이다. 확률이 두 배라는 뜻은 아니고, 확률로 옮기면 차이는 이보다 작다.
모델마다 차이는 컸다. 연구는 각 모델의 요약이 원문 초록과 우연으로 보기 어려울 만큼 다른지를 통계로 따졌다. 그 기준을 넘어 넓은 결론을 더 자주 담은 모델은 옛 모델 GPT-4 Turbo·LLaMA 2 와 최신 모델 ChatGPT-4o·ChatGPT-4.5·LLaMA 3.3·DeepSeek 이었다. 차이가 가장 큰 것은 ChatGPT-4o 와 LLaMA 3.3 이었다. Claude 2·3.5·3.7 과 GPT-3.5 는 그 기준을 넘지 못했다. 한 모델에서 본 모양을 다른 모델에 그대로 옮겨 말할 수는 없다.
넓어진 117건 대부분에는 총칭문이 들어 있었다
저자들이 공개한 판정 데이터로 넓어진 요약의 모양을 다시 세었다. 옛 모델 네 개(GPT-3.5·GPT-4 Turbo·LLaMA 2·Claude 2)가 초록 200편을 단순 요청으로 요약한 800건 가운데, 원문은 좁았는데 요약이 넓어진 것은 117건이었다. 그중 106건(90.6%)은 총칭문을 담았다. 「~해야 한다」로 넘어간 것은 5건(4.3%)뿐이었다. 이 비율은 넓어진 건들 안에서의 모양이지, 요약 가운데 몇 %가 넓은지가 아니다.
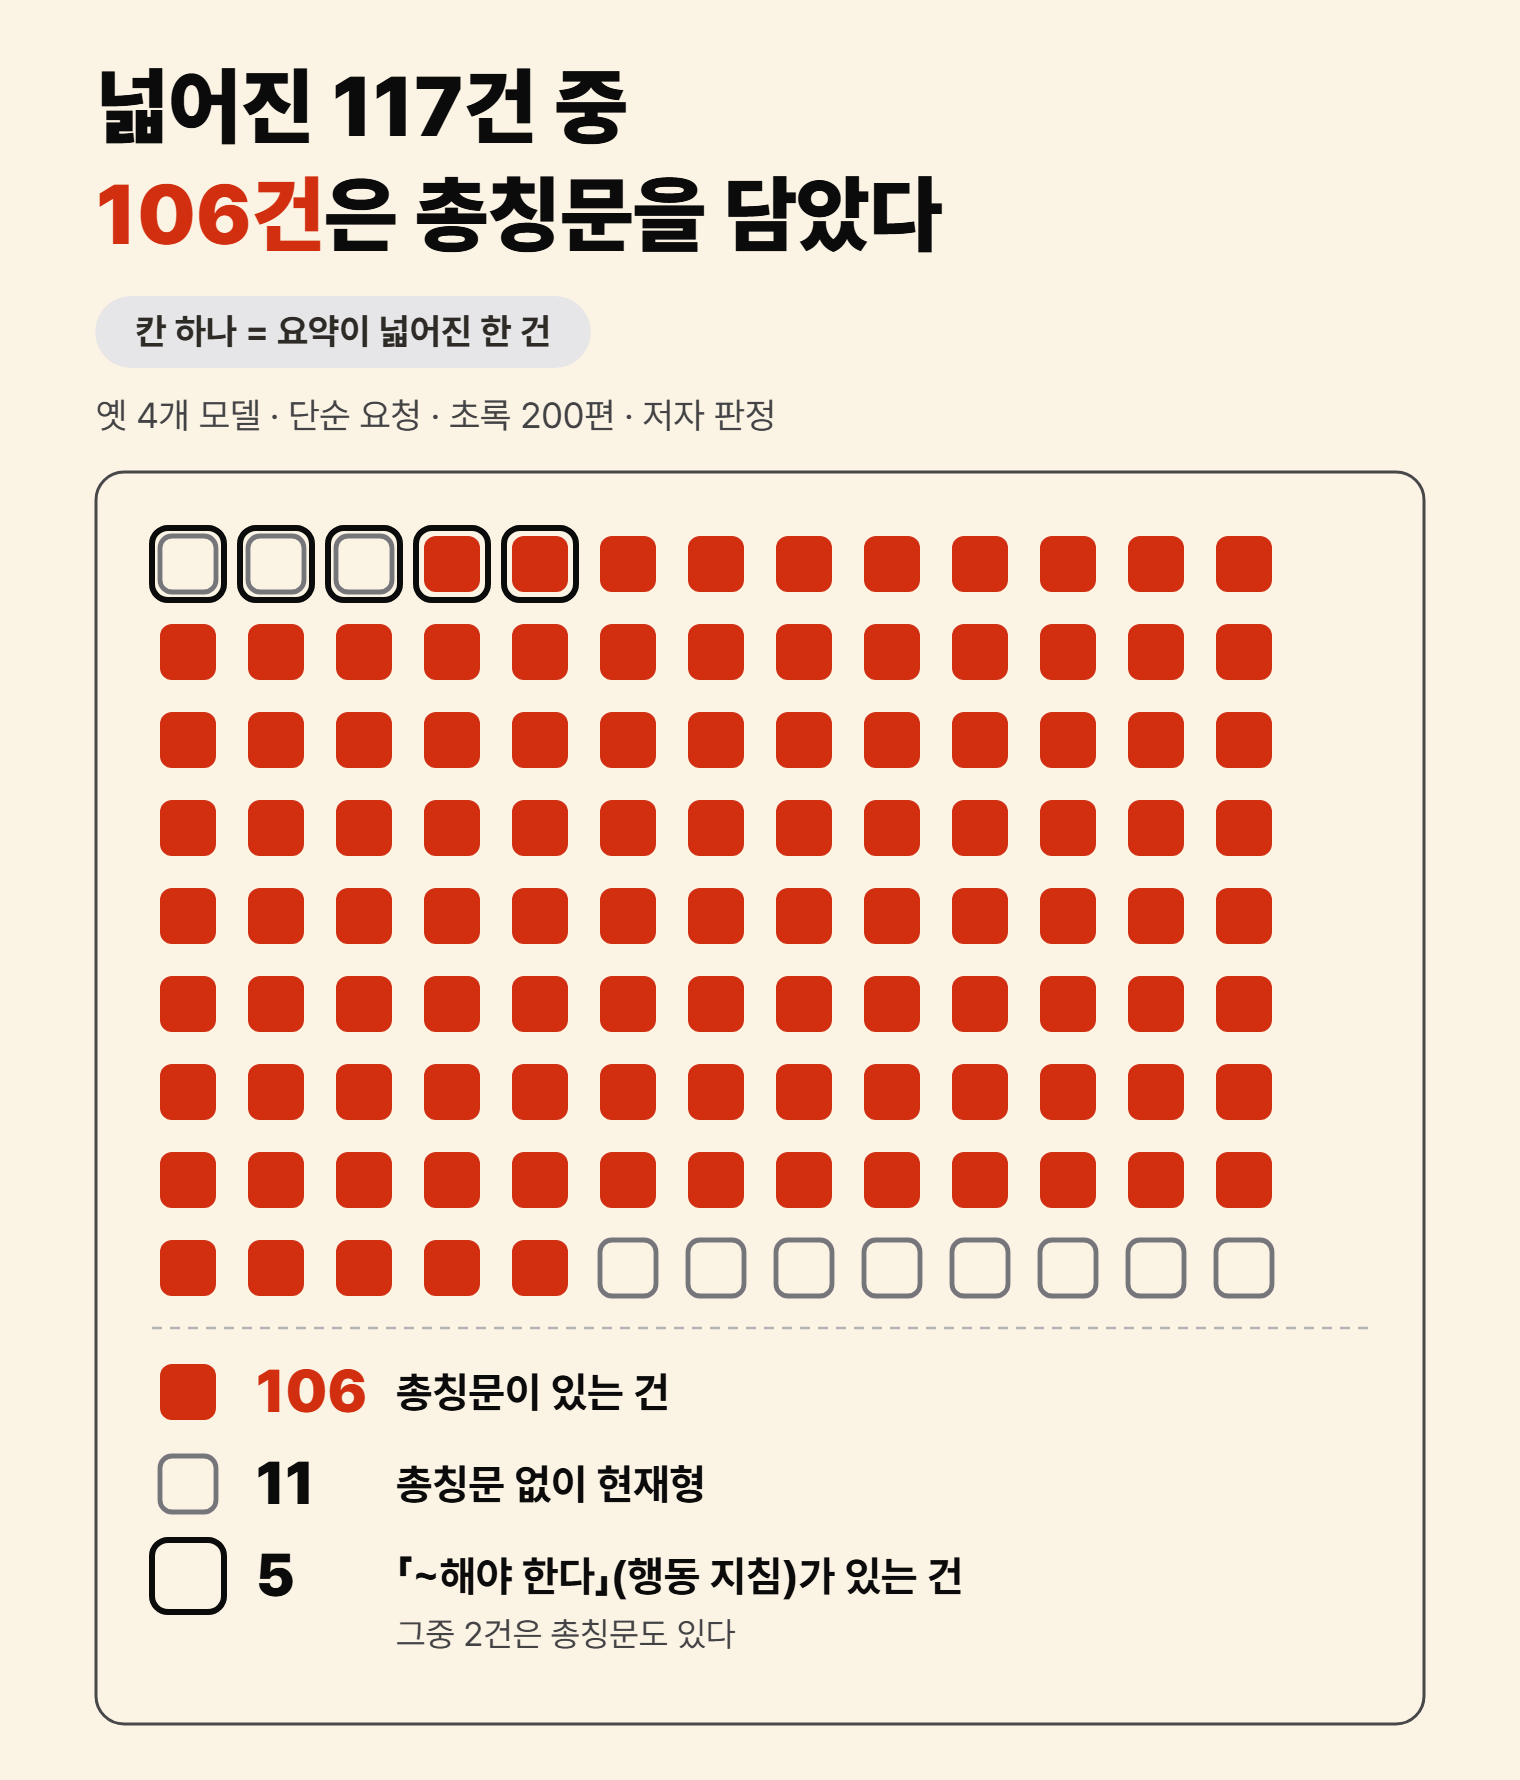
그림 1 의 빨간 칸에는 원문에 없던 총칭문이 들어 있다. 누구에게서 나온 결과인지 밝히지 않고 부류 전체를 말하는 문장이다. 저자들도 요약에서 가장 흔한 넓힘으로 이 바뀜을 꼽았다.
117건은 하나도 빠짐없이 결과를 현재형(또는 미래형)으로 말하는 문장도 담았다. 그런데 이 100% 는 대부분 판정 기준이 정해 둔 값이다. 이 기준의 총칭문은 늘 현재형이라, 106건은 저절로 현재형으로도 세어진다. 총칭문 없이 현재형 하나로 센 8건도 같아서, 114건의 현재형은 기준이 정한 값이다. 기준이 미리 정하지 않은 것은 총칭문 없이 「해야 한다」가 있는 3건뿐인데, 이 3건도 모두 현재형이라 「해야 한다」만 있는 건은 없었다. 그래서 시제 대조는 이 117건을 놓치지 않았다.
「정확하게」를 당부한 요청에서 넓은 결론이 늘었다 — 그런데 같이 바뀐 것이 있다
연구는 요약을 부탁하는 문장도 바꿔 보았다. 단순 요청은 「초록의 주요 결과를 요약해 달라」였다. 정확성 요청은 「포괄적이고 정보 밀도 높은 요약을 만들어라」로 시작해 「원문에 충실하고 부정확한 내용을 넣지 마라」로 끝나는 긴 요청이었다. 둘 다 영어이고, 이 글이 「정확하게」라고 줄여 부르는 것은 뒤의 요청이다.
같은 의학 초록 100편을 여섯 모델(GPT-3.5·GPT-4 Turbo·ChatGPT-4o·DeepSeek·LLaMA 3.3·Claude 3.5)이 요약한 자료를 다시 세었다. 넓은 결론을 담은 요약은 단순 요청에서 52.5%, 정확성 요청에서 64.3% 였다(원문 초록 20%). 저자들이 낸 승산비 1.90 도 확률이 두 배라는 뜻은 아니다. 같은 원문·같은 모델끼리 짝지은 600쌍에서는 단순 요청에서 넓지 않았다가 정확성 요청에서 넓어진 쌍이 130개, 반대가 59개였다.
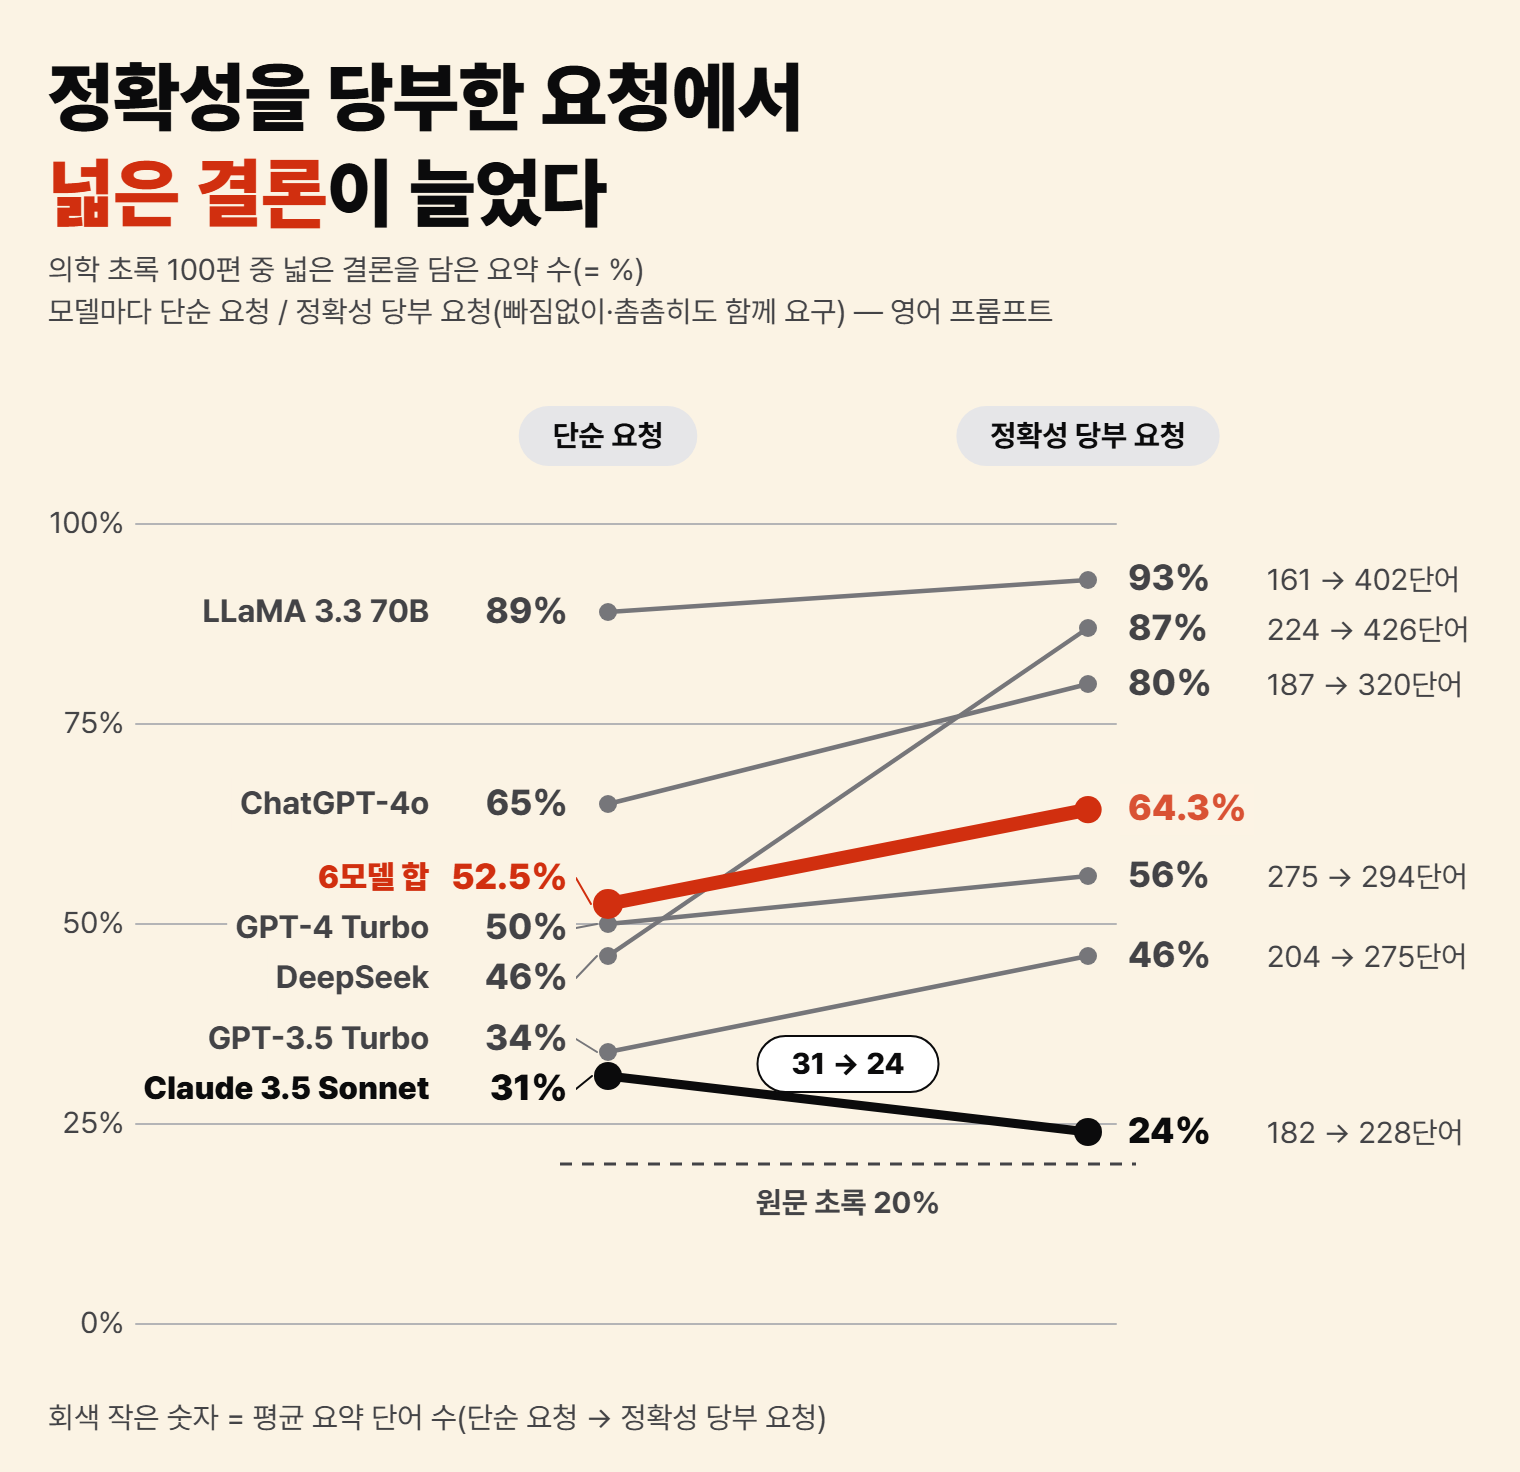
모델마다 기울기는 달랐다(그림 2). 이 글이 짝지은 쌍을 넓어진 쪽 대 좁아진 쪽으로 다시 세어 보면, 우연으로 보기 어려운 차이가 난 것은 DeepSeek(44 대 3)과 ChatGPT-4o(26 대 11)다. Claude 3.5 는 9 대 16 으로 좁아진 쪽이 더 많아 반대로 움직였지만, 우연으로도 나올 만한 차이였다.
정확성 요청이 바꾼 것은 「정확하게」 하나가 아니다. 빠짐없이, 촘촘히 담으라는 요구가 함께 들어 있었고 요약이 길어졌다. 여섯 모델 가운데 최신 넷의 자료에 요약 길이를 함께 넣어 거칠게 다시 따져 보면, 요청에 따른 차이는 우연으로도 나올 만한 크기로 줄었다. 다만 요청과 길이가 거의 함께 움직여서 어느 쪽 몫인지 가를 수 없다. 그래서 「정확하게」라는 말이 넓은 결론을 불렀다고는 말할 수 없다. 한 문구를 원인으로 지목하려면, 그 문구만 바꾼 비교가 있어야 한다.
전문을 읽힌 AI 요약도, 전문가 요약도 넓은 결론을 담았다
초록이 아니라 임상 논문 전문 100편을 요약시키면 어떨까. 넓은 결론을 담은 글의 비율은 원 논문 48%, 전문가가 쓴 요약 55%, GPT-4 Turbo 71%, ChatGPT-4o 95%, DeepSeek 97% 였다. 전문가 요약(NEJM Journal Watch)은 전문가가 전문가 독자를 위해 쓴 글이다. 사람 전문가의 요약도 넓은 결론을 담았고, 원 논문과의 차이는 우연으로도 나올 만했다. 「사람은 안 그런다」는 이야기가 아니다.
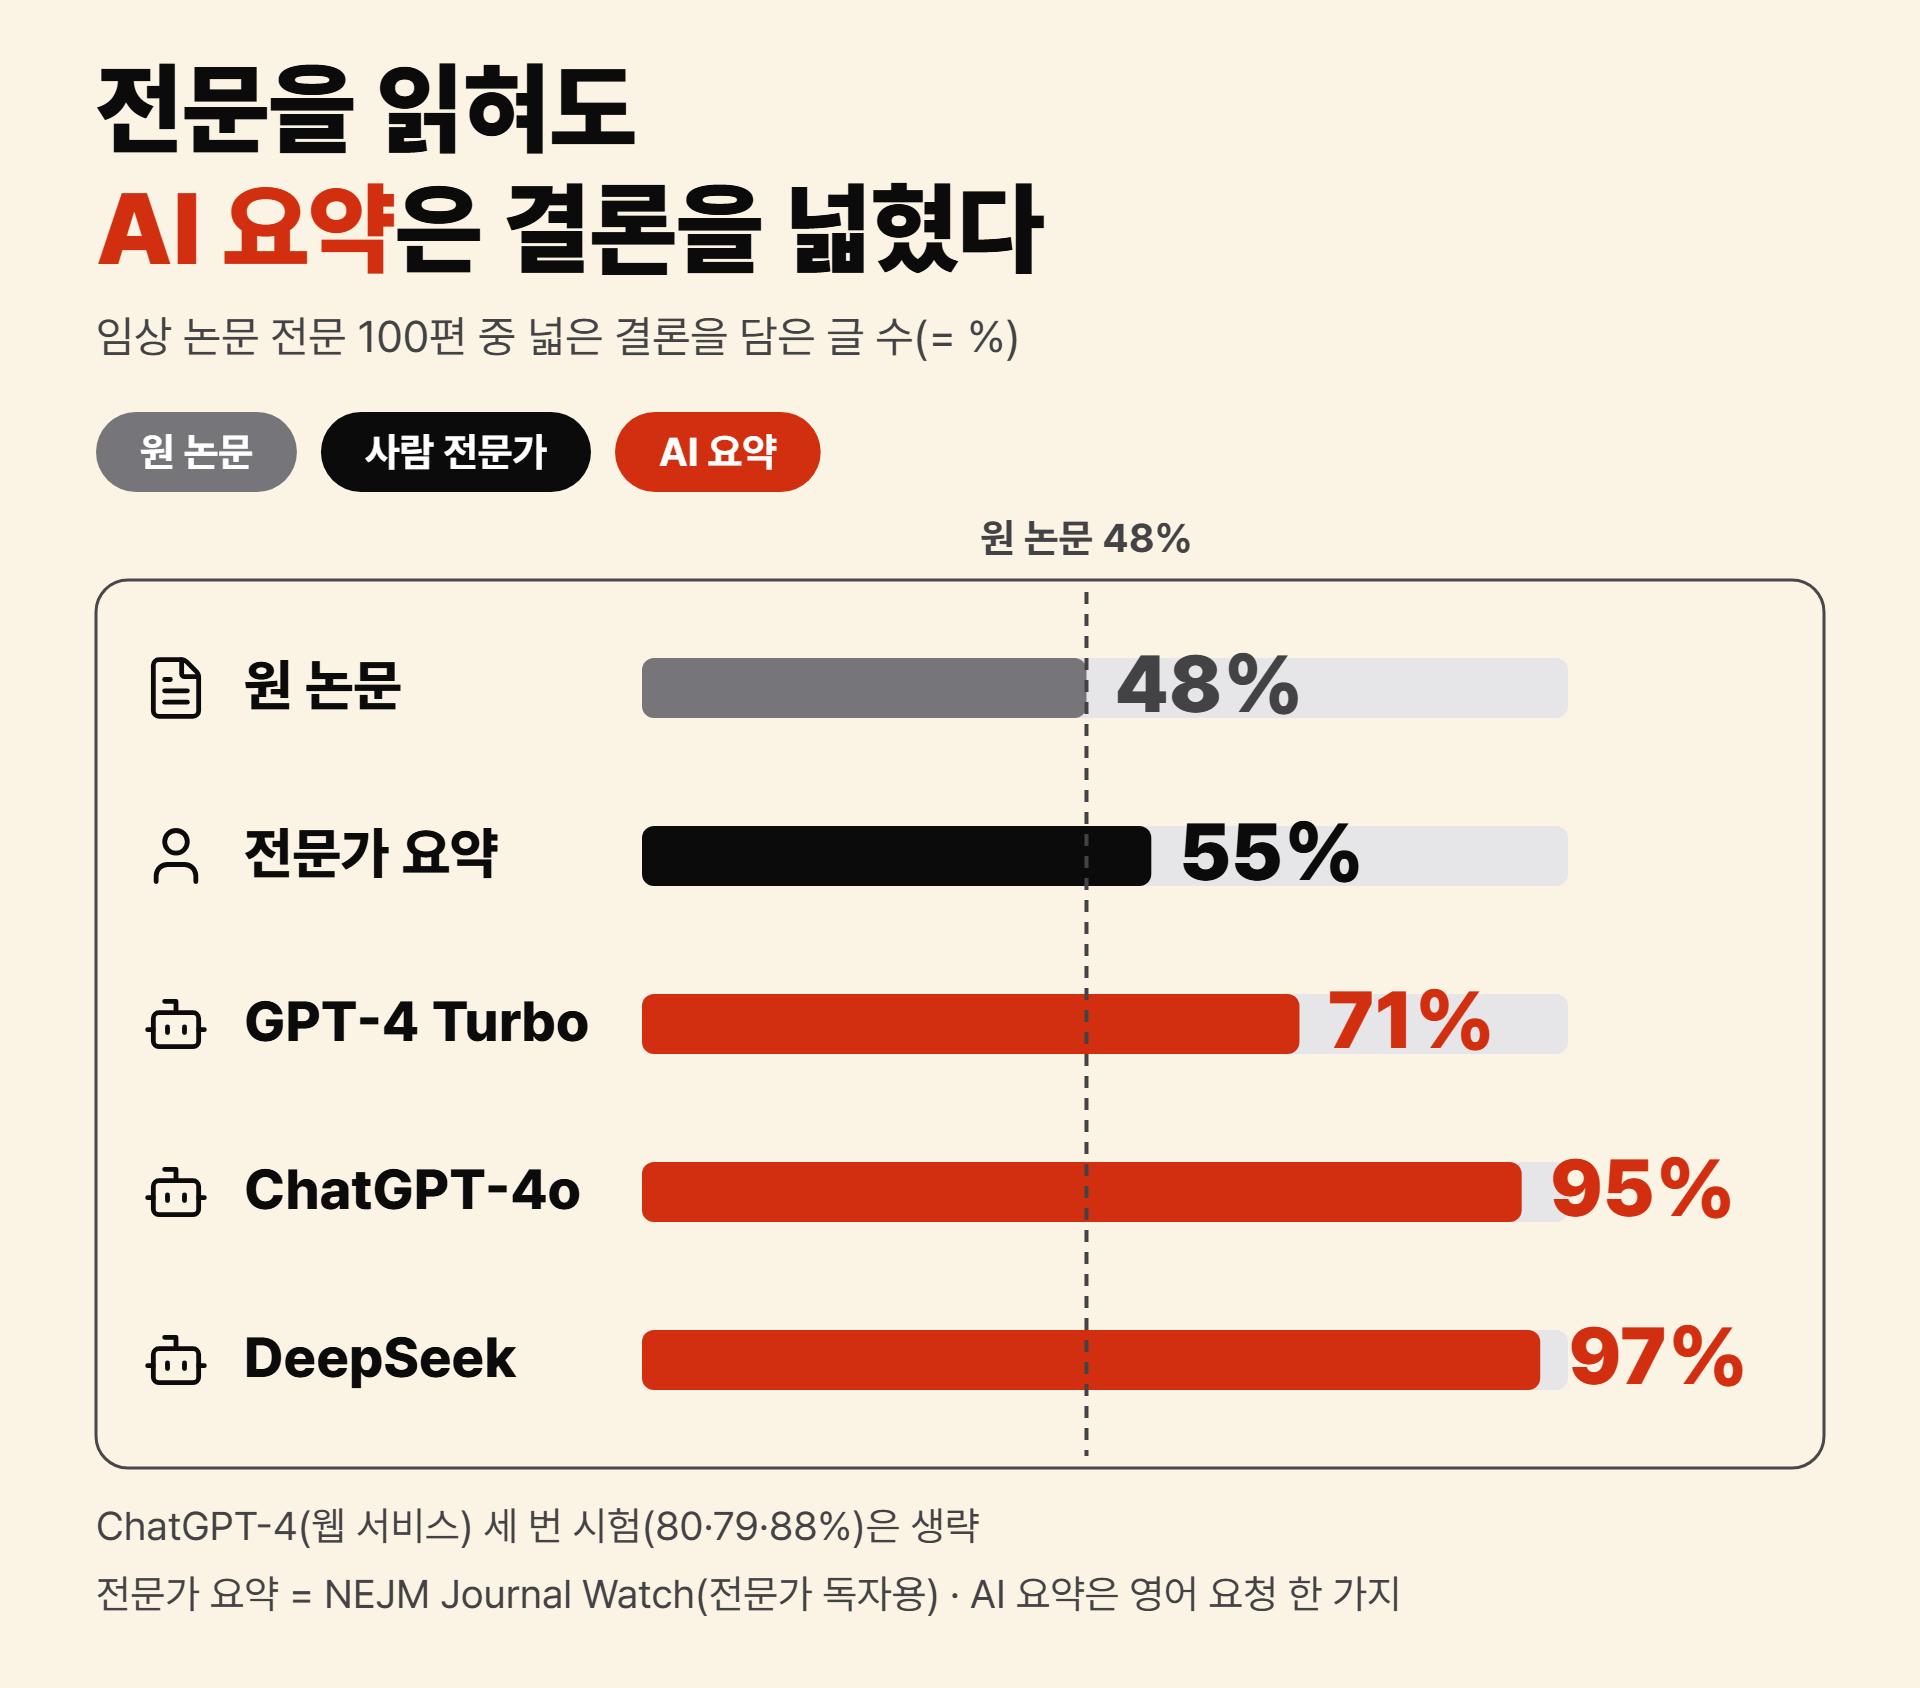
그림 3 에서 사람 막대는 원 논문 점선 바로 옆에서 끝난다. 저자들은 사람 요약을 견줄 기준으로만 썼고, 그 넓은 결론이 정당했는지는 따지지 않았다. 저자들도 이 점을 분명히 적었다.
In this study, we did not assess whether the generalizations in human-authored texts were warranted.
이 연구는 사람이 쓴 글의 일반화가 정당했는지는 평가하지 않았다.
Peters & Chin-Yee 2025, Royal Society Open Science넓히는 일은 AI 에게만 있는 것이 아니다. 다만 같은 논문 100편에서 세 AI 요약은 모두 사람 전문가의 요약보다 넓은 결론이 잦았다. 그래서 견줄 것은 사람 대 AI 가 아니라 원문 대 요약이다.
문장을 고쳐 쓰게 한 다른 연구에서도 확신은 위로 쏠렸다
다른 연구도 비슷한 쏠림을 보았다. Belem 외 연구진은 AI 에게 과학 문장 하나를 한 문장으로 바꿔 쓰거나 뉴스 문장으로 고치게 했다. 그리고 「~일 수 있다」와 「~이다」 사이의 확신 정도가 그대로 남는지를 쟀다. 확신 정도가 달라진 비율은 37.5~75% 였다. 과학 문장에서는 다섯 모델 중 셋이 확신을 올린 경우가 내린 경우보다 1.5~2.0배 많았고, 나머지 둘은 거의 반반이었다.
「확신 정도를 유지하라」 같은 지시를 붙이자 올림과 내림은 거의 균형을 맞췄지만, 약 40% 는 여전히 확신 정도가 바뀌었다. 저자들은 지시가 오류를 막지 않고 방향만 다시 맞췄다고 보았다. 여기까지는 문장 하나를 다룬 과제의 값이다. 글 한 편을 통째로 다루게 한 과제에서는 훨씬 낮아서, 학술 초록 15.0~24.8%(전체 바꿔쓰기와 한 문장 요약), 의료 판독문 2.0~5.0%(소견 전체 바꿔쓰기와 쉬운 말로 고치기)였다. 저자도 이 결과를 「초기 증거」라고 적었다. 두 연구는 같은 양을 재지 않았지만, 서로 다른 잣대에서 같은 방향의 쏠림이 두 번 보였다.
이 글의 숫자는 이렇게 세었다
재집계는 저자들이 공개 저장소 OSF 에 올린 데이터를 다시 센 것이다. 그 데이터에는 연구자들이 요약마다 손으로 표시한 판정이 들어 있고, 이 글은 그 판정을 그대로 셌다. 다시 판정하거나 AI 에게 새로 요약을 시키지 않았다. 요약 길이를 함께 넣은 점검은 이 글이 따로 해 본 거친 점검이다. 저자 논문의 승산비는 아래 구간들과 표본이 같지 않아서, 원자료 비율과 짝지은 개수까지만 적었다.
숫자마다 구간이 다르다. 117건은 옛 네 모델·단순 요청·초록 200편이다. 52.5% → 64.3% 와 짝지은 130 대 59 는 여섯 모델·의학 초록 100편(짝 600개)이고, 전문 막대는 임상 논문 전문 100편이다. 연구는 「한 단계씩 풀어 보라」를 더한 요청도 시험했지만, 모델마다 방향이 갈렸다(LLaMA 3.3 은 89% 에서 76% 로 줄었다). 그래서 단순과 정확성 두 요청만 견줬다. 실험의 요청과 원문은 모두 영어다.
원문과 요약을 맞댈 자리는 시제·한정어·「해야 한다」 셋이다
원문이 결과를 말한 문장과, 요약에서 같은 결과를 말하는 문장을 나란히 놓는다. 먼저 시제를 본다. 원문이 「나타났다」고 쓴 것을 요약이 「이다」로 쓰고 있다면, 이 연구의 기준으로는 넓어진 것이다. 다음은 한정어로, 누구에게서, 언제부터 언제까지, 어떤 조건에서 나온 결과인지가 요약에도 남아 있는지 본다. 넓어진 요약 대부분에 들어 있던 총칭문은 이 단계에서 걸린다. 마지막으로 원문에 없던 「~해야 한다」가 새로 생겼는지 본다.
처음의 당뇨병 초록은 첫 단계에서 바로 걸린다. 원문의 「관련이 있었다」는 과거형이고, 요약의 「낮춘다」는 현재형이다. 「임신성 당뇨병을 앓은 적이 있는 여성」이라는 한정어는 요약에도 남아 있다. 앞에서 옮긴 요약 문장에 「~해야 한다」는 없지만, 저자가 넓어졌다고 표시한 구절에는 「여러 건강한 습관을 들이는 것이 이 고위험 집단의 당뇨병 예방에 매우 중요하다」는 다음 문장도 들어 있다. 「해야 한다」라고 쓰지는 않았어도 권고에 가까운 말이라, 셋째 단계에서 한 번 더 멈춰 볼 자리다.
공개 데이터에서 하나 더 고른 예는 둘째 단계까지 걸린다. 고관절·무릎 인공관절 수술 환자를 다룬 초록은 「아스피린을 쓴 쪽이 에녹사파린을 쓴 쪽보다 90일 안에 증상이 있는 혈전이 더 많이 생겼다」고 썼다. LLaMA 3.3 의 요약은 「전체적으로 이 연구는 에녹사파린이 아스피린보다 수술 뒤 증상 있는 혈전 예방에 더 효과적임을 시사하며, …」라고 썼다. 저자가 넓어졌다고 표시한 것은 「에녹사파린이」부터다. 「시사한다」가 붙었어도 결과를 현재형으로 말했으니, 앞의 기준대로 넓은 것으로 센다. 표시된 구절에서는 「90일 안에」라는 한정어도 빠졌다.
이 대조로 가려지는 것은 요약이 원문보다 넓게 말했는지다. 연구자들이 요약 4,900건에 손으로 붙인 판정을, 독자가 요약 한 편에 직접 해 보는 셈이다. 요약이 옳은지, 원문의 결론이 정당한지는 이 대조로 판정하지 않는다. 의료나 법처럼 결정이 걸린 일도 이 대조가 대신하지 않는다. 요청에 「확신 정도를 유지하라」를 붙이는 방법은 Belem 외의 연구에서 쏠림의 방향만 맞췄고, 바뀐 문장을 다 막지는 못했다. 그러니 요약을 받은 뒤 원문과 맞대 보는 확인은, 요청 문구를 고친 뒤에도 남는 일이다.
두 연구가 판정한 것은 글에 적힌 문장의 모양이었다. Belem 외 연구진은 더 확신 있는 출력이 사용자의 믿음을 더 크게 바꾼다는 기존 연구를 인용했지만, 이 요약을 읽은 사람의 믿음은 두 연구 모두 직접 살피지 않았다. 「관련이 있었다」 대신 「낮춘다」를 읽은 사람은, 원문을 읽은 사람보다 그 결론을 더 굳게 믿게 될까?
더 읽기
- Uwe Peters, Benjamin Chin-Yee, 「Generalization bias in large language model summarization of scientific research」, Royal Society Open Science 12(4):241776 (2025). https://doi.org/10.1098/rsos.241776 (PMC12042776)
- Catarina G Belem 외, 「From ‘May’ to ‘Is’: Certainty Distortion in Language Model Rewriting」, arXiv:2606.07951v2 (2026). https://arxiv.org/abs/2606.07951
- Peters & Chin-Yee 공개 데이터(OSF): https://osf.io/q936d/