자동 자막에 아무도 하지 않은 「시청해 주셔서 감사합니다」가 끼어 있을 때가 있다. 사람 목소리가 한 마디도 없는 무음·잡음 파일 217개를 받아쓰기 AI(Whisper)에 한국어로 넣어 보니, 199개(91.7%)에 「감사합니다」가 적혀 나왔다. 받아쓰기 AI 는 소리를 단서로 다음 글자를 하나씩 고르는 기계라서, 단서가 없으면 그럴듯한 글을 스스로 지어 붙인다. 이것을 환각(hallucination)이라고 한다.
사람 목소리가 없는 파일에도 자막에는 인사말이 적힌다
말이 끊긴 자리의 자막에 「시청해 주셔서 감사합니다」가 떠 있는데, 그 인사를 한 사람은 아무도 없다. 한 개발자가 올린 오류 보고에도 비슷한 일이 적혀 있다. 말이 없거나 아주 짧은 음성을 받아쓰게 했더니 입력창에 한국어 「시청해주셔서 감사합니다!」가 들어갔는데, 정작 앱을 쓰던 사람은 한국어로 아무 말도 하지 않았다는 내용이다. 보고에 따르면 이 문구를 적은 것은 오픈AI 의 음성 인식 모델 Whisper(위스퍼)다.
이런 장면을 재현하는 데는 말이 없는 소리 파일만 있으면 됐다. 먼저 소리가 전혀 없는 파일, 즉 처음부터 끝까지 소리 크기가 0인 무음 파일을 1·2·3·5·10·20·30초 길이로 일곱 개 만들었다. 이것을 Whisper 에 언어를 한국어로 정해 받아쓰게 하자, 일곱 개 모두 똑같이 「감사합니다.」가 나왔다. 1초짜리 파일에도, 30초짜리 파일에도 같은 인사가 적혔다.
이 글의 실측은 따로 적지 않는 한 모두 아래 조건에서 쟀다(2026년 9월). 모델은 Whisper large-v3 이고, 이 모델을 빠르게 돌리도록 변환한 도구 faster-whisper 1.2.1 로 돌렸다. 언어는 한국어로 지정했고, 매 자리에서 가장 그럴듯한 글자 하나만 고르는 방식(그리디)을 썼다 — 뒤에 나올 영어 선행 연구와 같은 설정이다. 앱이나 서비스를 거치지 않고, 같은 컴퓨터·같은 판에서 모델을 직접 돌린 결과다. 같은 파일을 두 번 돌려 비교한 6,000건 넘는 결과는 문장 하나 다르지 않았다.
넣은 소리는 세 묶음이다. 첫째는 합성 무음·잡음 217개, 둘째는 환경음 모음 ESC-50 에서 사람 소리 10종을 뺀 40종 × 40개(각 5초)다. 셋째는 직접 만든 한국어 나레이션 79개(음성 합성) 뒤에 무음이나 잡음을 붙인 파일이다.
무음 일곱 개로 끝내지 않고 잡음 210개를 더했다. 「쏴」 하고 고르게 깔리는 백색 잡음과 분홍색 잡음 두 가지를, 음량 다섯 단계와 길이 일곱 단계의 조합마다 세 개씩 만들었다. 여기에도 사람 목소리는 한 마디도 없다. 이렇게 모은 무음·잡음 217개 가운데 212개(97.7%)에서 글자가 나왔고, 199개(91.7%)에는 「감사합니다」가 들어 있었다. 199개를 나누면 「감사합니다.」가 102개, 「시청해주셔서 감사합니다.」가 97개다. 모델의 출력은 띄어쓰기까지 그대로 옮겨서, 「시청해주셔서」도 붙여 적었다.
1초 무음부터 30초 잡음까지, 결과는 한쪽으로 쏠렸다. 말소리가 없으면 자막도 비어 있어야 할 것 같지만, 이 설정의 받아쓰기 AI 는 말소리가 없는 자리를 거의 빈칸으로 두지 않았다. 그 자리를 인사말로, 그것도 대부분 「감사합니다」로 채워 넣었다.
받아쓰기 AI 는 소리를 듣고 글자를 고르는 기계다
받아쓰기 AI, 곧 음성 인식(STT) 모델이 하는 일은 한 문장으로 말할 수 있다. 소리를 듣고, 거기 맞춰 적을 글자를 하나씩 고른다. 이미 적어 둔 글과 들리는 소리를 함께 보고, 다음 자리에 올 가장 그럴듯한 글자를 골라 이어 붙이는 식이다. 그래서 소리가 또렷하든 흐릿하든, 모델은 자리마다 후보 가운데 하나를 고른다. 그러면 말이 없는 구간은 어떻게 될까?
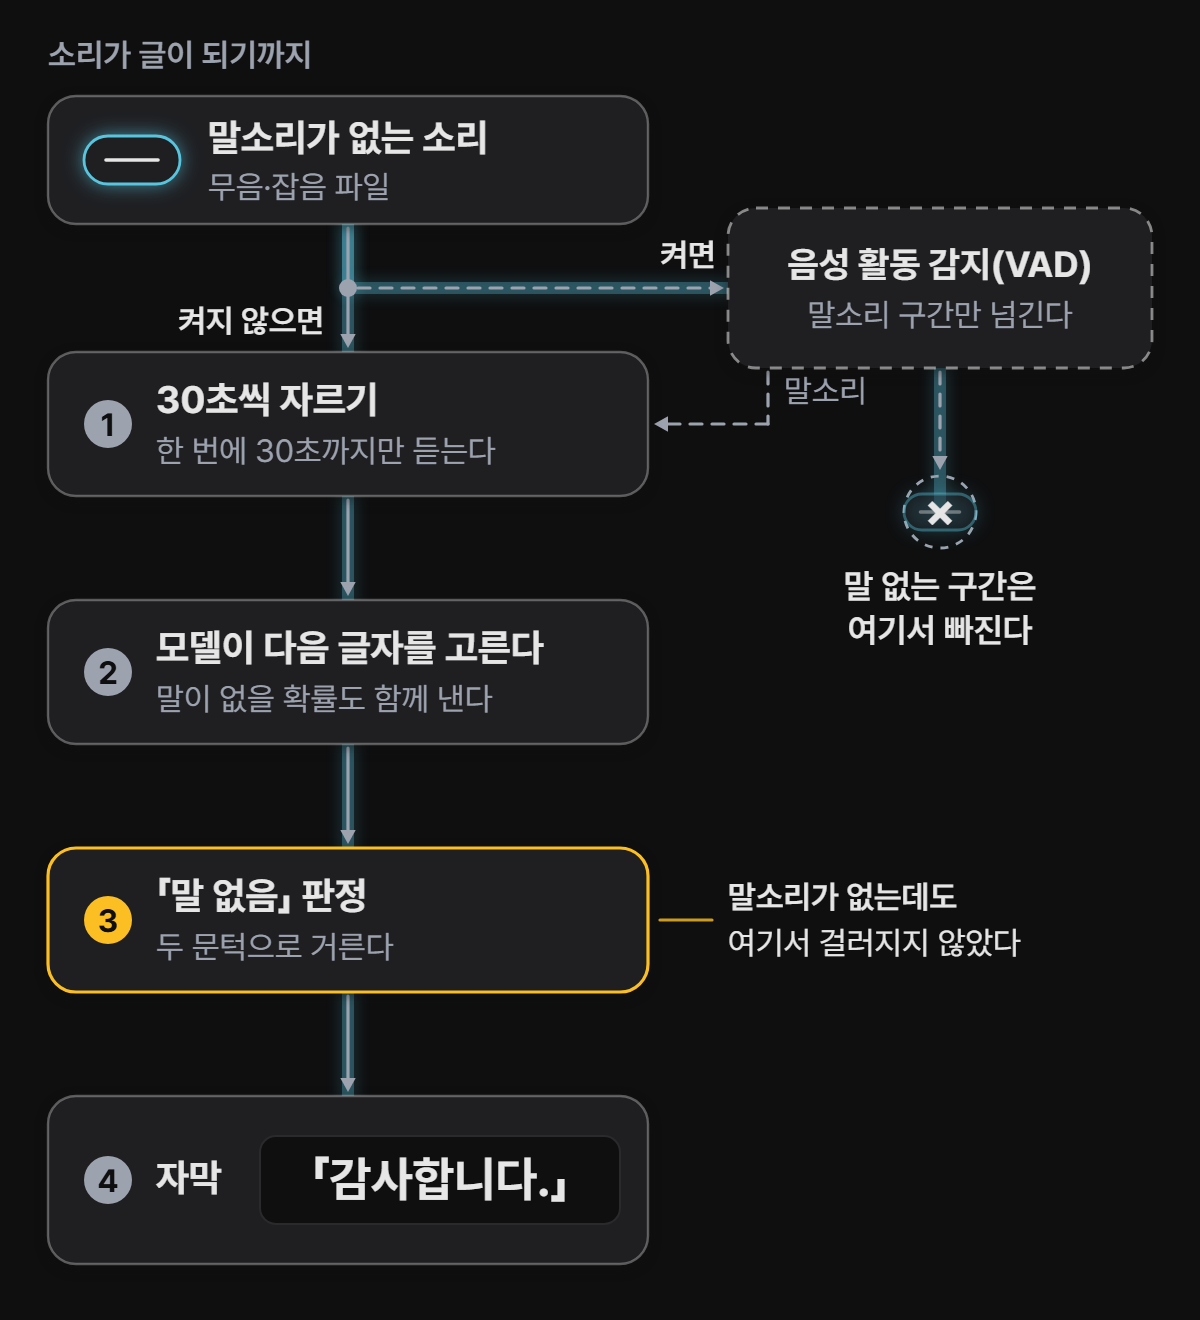
그림 1 는 소리가 자막이 되기까지를 차례로 그린 것이다. 오른쪽 옆길은 켰을 때만 지나는 길이라 마지막 절에서 따로 본다. Whisper 원논문을 보면 저자들은 말소리가 없는 구간도 학습 자료에 넣었고, 그런 구간에서는 모델이 「여기는 말이 없다」는 표시를 내도록 따로 가르쳤다. 그런데 이 글에서 쓴 도구 faster-whisper 1.2.1 의 코드에서는 그 표시가 글자 후보에 끼지 못하게 막혀 있다. 도구는 대신 모델이 매긴 「말이 없을 확률」을 숫자로 읽어 둔다. 그림의 ②번 칸이 그 자리다 — 모델은 글자를 고르면서 말이 없을 확률도 함께 낸다.
그 구간을 버릴지는 ③번 칸의 판정 규칙이 정한다. 규칙은 두 값을 함께 본다. 하나는 방금 본 「말이 없을 확률」이고, 다른 하나는 모델이 적어 낸 글에 스스로 매긴 확신이다. 말이 없을 확률이 높고, 적은 글에 대한 확신도 낮을 때에만 그 구간을 버린다. 원논문 저자들은 「말 없음」 확률 하나로는 말 없는 구간을 가려내기에 부족해서 두 값을 묶었다고 적었다.
합성 무음·잡음에서 글자가 나온 212개 구간을 이 규칙에 비춰 보면, 왜 걸러지지 않았는지가 보인다. 195개(92.0%)에서 모델은 「말이 없을 확률」을 문턱보다 높게 매겼다. 모델 스스로 그 자리에 말이 없을 것 같다고 본 셈이다. 그런데 거기 적은 글에 대한 확신도 문턱보다 높아서, 규칙은 그 구간을 버리지 않았다. 말이 없을 것 같다고 보면서도, 적어 낸 글에는 자신이 있었다는 뜻이다.
언어를 영어로 바꾸면 같은 217개에서 「Thank you.」가 나온다. 216개(99.5%)에서 글자가 나왔고, 그 가운데 202개가 「Thank you.」였다. 설정한 언어에 따라 인사말의 언어만 바뀌었고, 말 없는 자리에 인사를 적는 것은 그대로였다.
이렇게 들리지 않은 말을 지어 적는 것을 음성 인식의 환각(hallucination)이라고 한다. 챗봇이 없는 사실을 지어내는 것도 같은 이름으로 부른다. 그쪽은 글 모델의 환각을 다룬 앞 글에서 다뤘다. Whisper 원논문 저자들도 긴 녹음을 받아쓸 때 남는 실패 양상 가운데 하나로, 실제 소리와 전혀 상관없는 글을 통째로 적는 경우를 꼽았다. 말 없는 자리의 인사말이 자막까지 남는 것은, 적은 글에 대한 확신이 「말이 없을 것 같다」는 판단을 누르는 자리가 있기 때문이다.
빗소리는 인사말로, 개 짖는 소리는 흉내말로 — 환경음 1,600개
무음과 잡음은 만들어 낸 소리다. 실제 녹음에 섞이는 소리로 넓혀 보려고 환경음 모음 ESC-50 에서 사람 소리 10종을 뺀 40종을 종마다 40개씩, 모두 1,600개 넣었다. 빗소리·개 짖는 소리·사이렌·세탁기 소리 같은 5초짜리 소리들이다. 그 가운데 1,173개(73.3%)에서 글자가 나왔다. 가장 많이 적힌 글은 「시청해주셔서 감사합니다.」(297개), 「다음 영상에서 만나요.」(278개), 「감사합니다.」(157개) 순이었다.
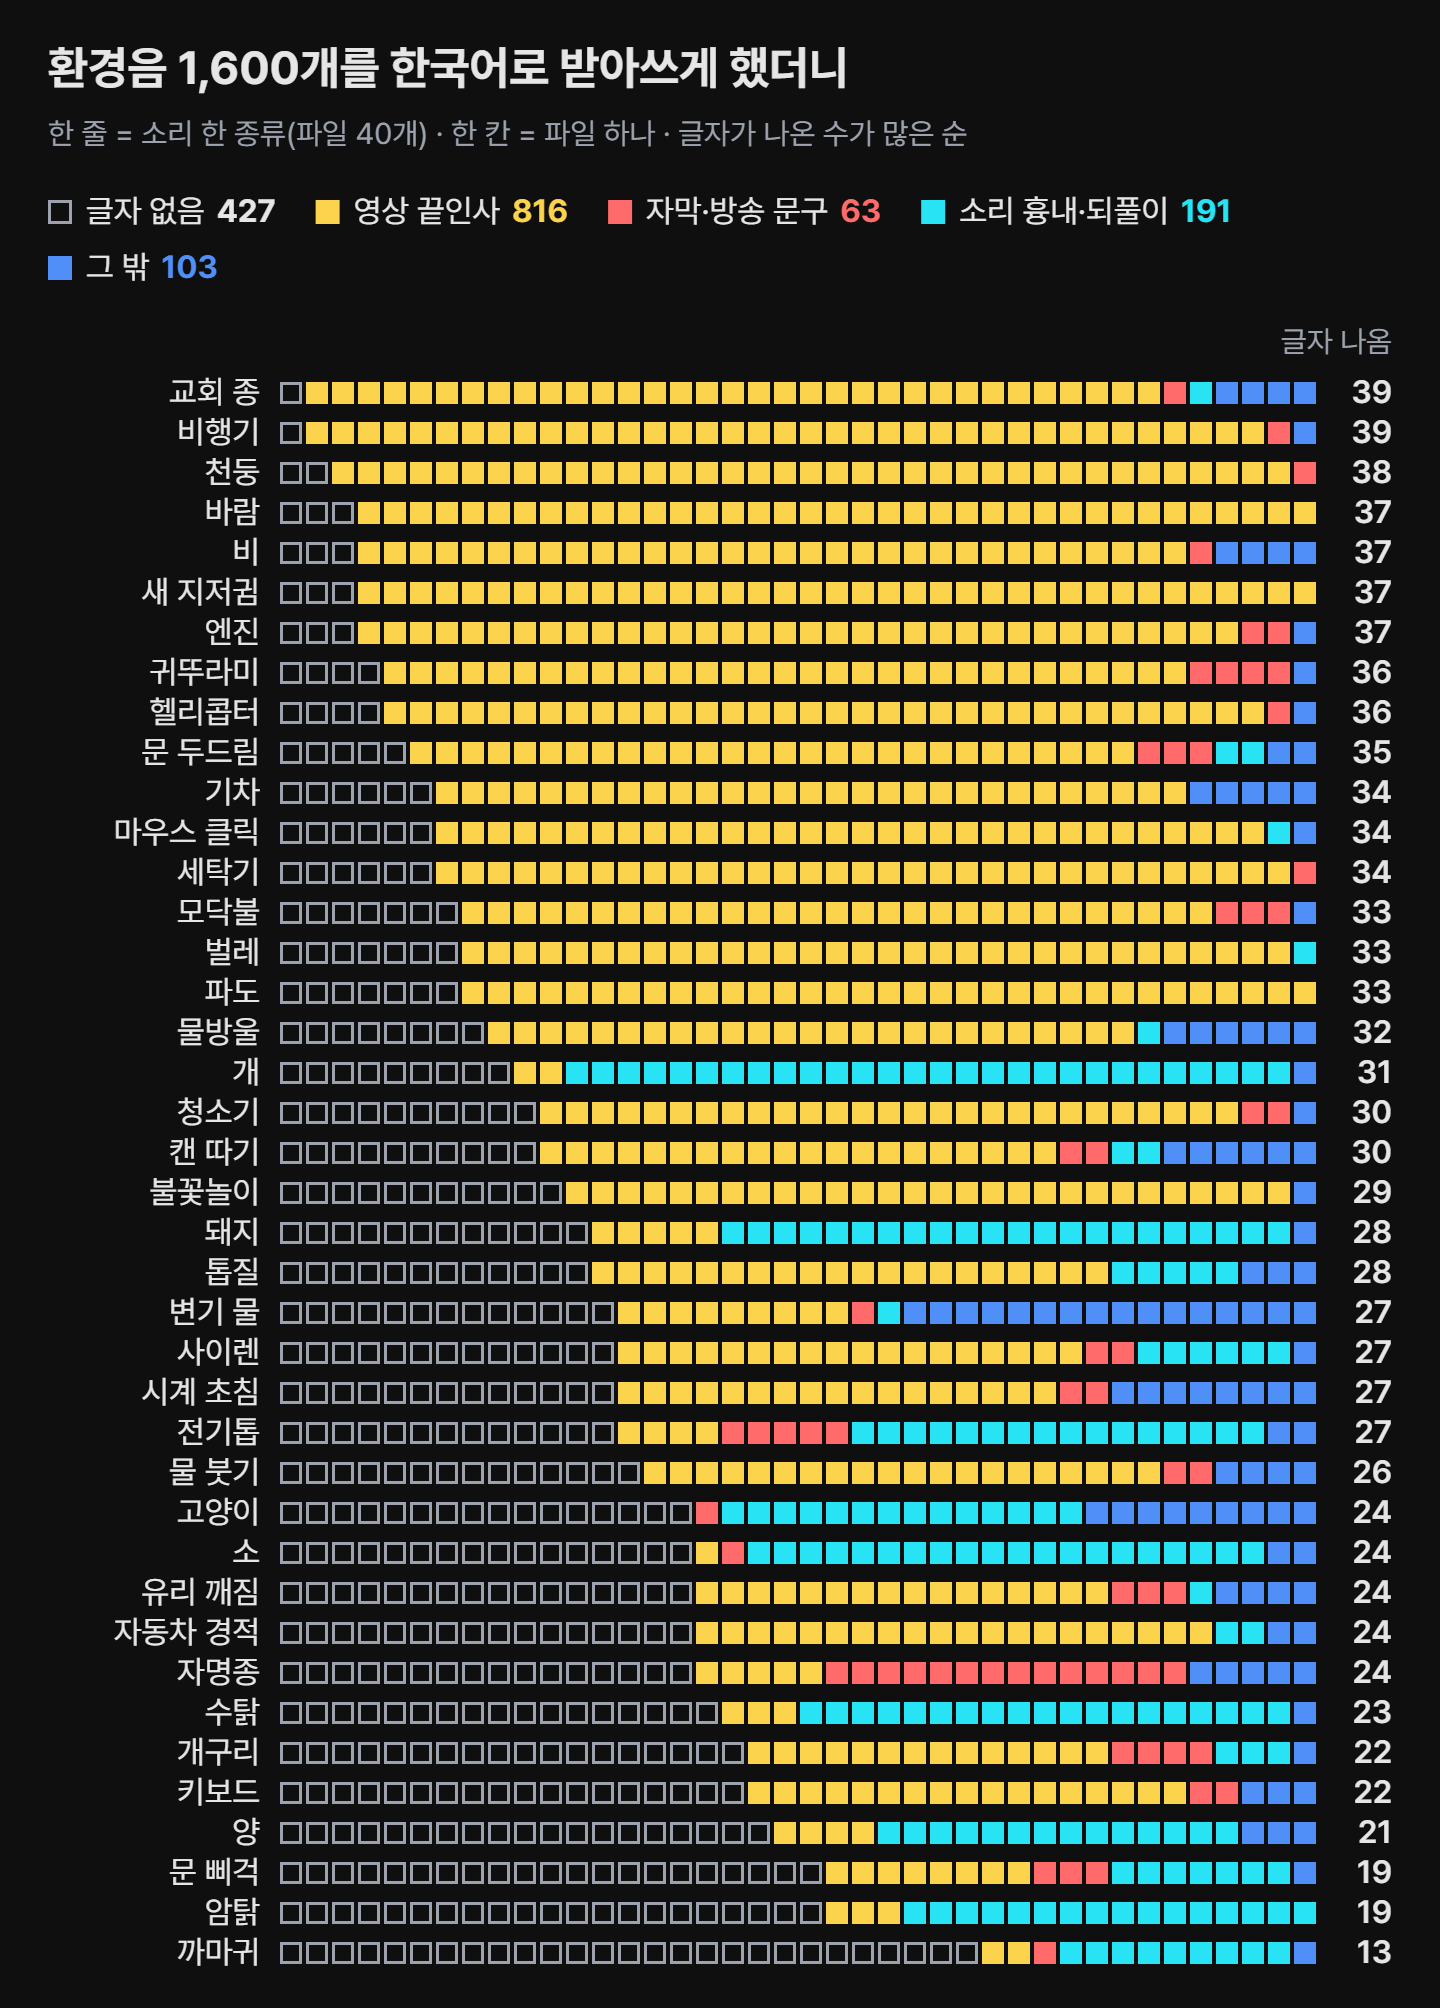
그림 2 는 1,600개가 저마다 무엇이 됐는지를 한 칸씩 칠한 것이다. 글자가 나온 1,173개 가운데 816개가 영상 끝인사 갈래였다. 비·비행기·바람·파도처럼 뒤에 깔리는 소리는 거의 다 이쪽이고, 빗소리는 40개 가운데 28개가 「시청해주셔서 감사합니다.」였다.
갈래가 뚜렷하게 바뀐 것은 개·돼지·소·닭처럼 우는 동물 소리와 몇몇 기계 소리다. 개 짖는 소리는 글자가 나온 31개 중 28개가 「왁! 왁! 왁! 왁!」처럼 소리를 흉내 내거나 한 글자를 되풀이한 글이었다. 같은 파일을 영어로 설정하면 「Woof!」 같은 글이 나왔다. 자명종은 글자가 나온 24개 가운데 12개가 「자막 제공 및 자막 제공 및 광고를 포함하고 있습니다.」라는 자막 고지였다.
영어로 설정하고 말소리 없는 소리 파일 30만여 개를 넣은 2025년 선행 실험에서도, 가장 흔하게 적힌 말은 thank you 였다. 말 없는 자리에 적히는 글은 이렇게 몇 갈래의 익숙한 글로 몰린다. 이번 실측에서는 어느 갈래로 가는지가 소리의 종류에 따라 달랐다. 무음이 아니어도 말만 없으면, 빗소리나 바람 소리가 깔린 구간에도 끝인사가 적힐 수 있다는 뜻이다.
인사말을 어디서 배웠는지는 절반만 확인된다
인사말과 자막 고지가 어디서 왔는지는 확인된 사실과 추론을 나눠서 봐야 한다. 확인된 쪽부터 본다. Whisper 원논문에 따르면 이 모델 계열은 인터넷에서 전사(받아 적은 글)와 짝지어진 오디오 68만 시간으로 학습했다. 다만 이 논문이 다루는 판은 large-v2 까지라, 이 글에서 잰 large-v3 의 학습 자료는 논문에 적혀 있지 않다.
같은 논문에는 학습 전사의 모양이 출력으로 새어 나온 선례가 있다. 개발 초기에 모델이 말하는 사람의 이름을 그럴듯하게, 그러나 거의 늘 틀리게 적는 버릇을 보였다. 저자들은 학습 전사 상당수에 화자 이름이 적혀 있었기 때문이라고 설명했다. 그래서 화자 표기가 없는 전사로 짧게 더 학습시켜 이 버릇을 없앴다.
추론인 쪽은 2025년 영어 실험의 해석이다. 저자들은 가장 흔한 환각 문구 30개 목록에 thanks for watching 이나 자막 제작 커뮤니티 표기 같은 모양이 있는 것을 보고, 영상 전사로 학습한 것이 강한 요인이라고 적었다. 이 판단의 근거는 출력 목록이고, 학습 자료를 직접 들여다본 것은 아니다. 「Whisper 는 유튜브 영상으로 학습했다」는 문장은 이 글이 읽은 어느 원문에도 없다.
이번 한국어 실측에도 같은 모양이 나왔다. 「자막은 설정에서 선택하실 수 있습니다.」 같은 자막 안내, 한글 자막 제작자 표기, 방송 기상 캐스터의 직함과 이름 한 줄, 방송 뉴스의 끝맺음 인사(이름 포함)가 적혔다. 모양은 영상과 방송의 끝자락을 닮았지만, 학습 자료 안에 이 한국어 문구가 있었는지는 어떤 출처도 확인하지 않았다. 그래서 인사말이 어디서 왔는지는 절반만 확인된 이야기다. 학습 방식과 화자 이름 선례는 원문에 적힌 사실이고, 영상 자막의 흔적이라는 설명은 출력 모양에서 거꾸로 짚은 추론이다.
말 뒤의 짧은 침묵은 대체로 조용하다
지금까지는 말이 아예 없는 파일을 넣었다. 말하다가 잠시 조용해지는 녹음에도 인사말이 붙을까? 직접 만든 한국어 나레이션 79개 뒤에 무음 10초를 붙여 받아쓰게 했더니, 덧붙인 꼬리 쪽에 글자가 붙은 파일은 79개 중 3개였다. 무음 대신 잡음 10초를 붙여도 3개였다. 말 뒤에 10초쯤 조용한 것만으로는 대개 아무것도 적히지 않았다.
그 3개에는 공통점이 있었다. Whisper 는 소리를 30초씩 잘라, 한 번에 한 조각(창)씩 듣는다. 원논문도 이 모델이 30초 조각으로 학습됐고 그보다 긴 소리를 한 번에 받지 못한다고 적었다. 꼬리에 글자가 붙은 3개는 모두 파일 안에 이미 12~17초쯤의 무음이 들어 있던 파일이라, 10초를 더 붙이자 두 번째 30초 창에 말이 한 마디도 들지 않게 됐다.
이렇게 말 없는 창이 생긴 3개는 셋 다 글자가 붙었고, 그런 창이 생기지 않은 76개에서는 하나도 붙지 않았다. 76개 가운데 73개는 파일 길이에 10초를 더해도 30초를 넘지 않았다. 파일 전체가 말이 든 첫 30초 창 하나에 들어간 것이다. 남은 세 파일은 말 자체가 30초를 넘어서까지 이어지는 긴 파일이라, 두 번째 창에도 말이 들어 있었다.
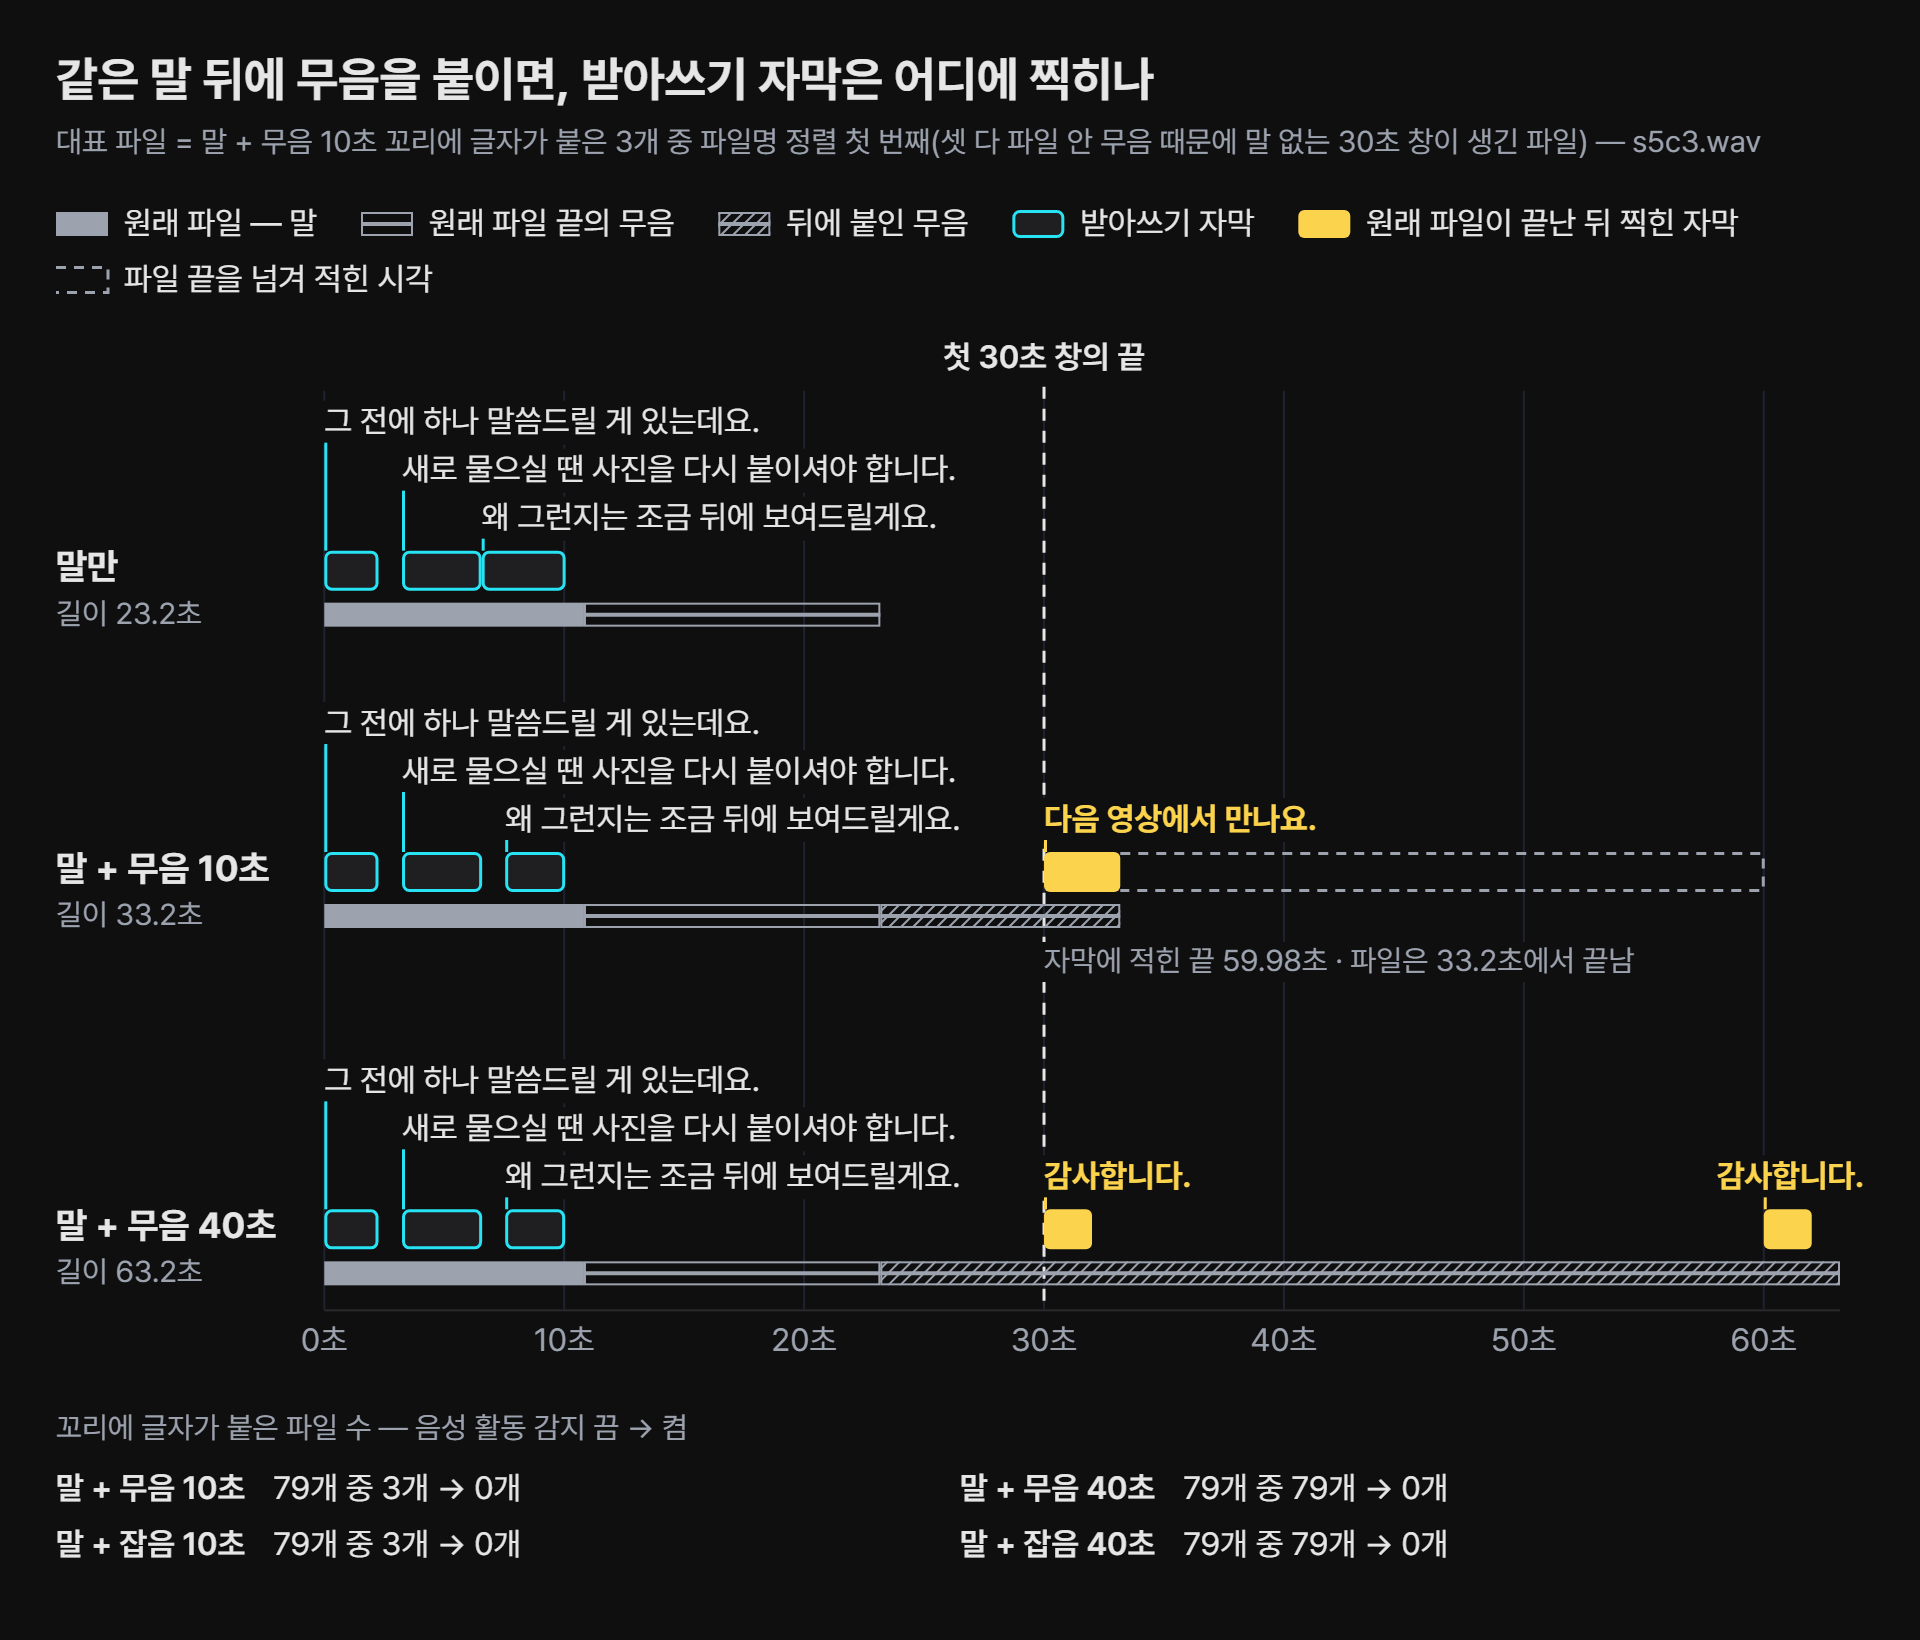
그림 3 은 꼬리에 글자가 붙은 3개 가운데 파일 이름 순으로 첫 번째 파일이다. 말은 10.8초쯤에서 끝나고, 파일 끝(23.2초)까지 12초 남짓 무음이 이어진다. 무음 10초를 붙이면 두 번째 창이 시작하는 30초 지점에 「다음 영상에서 만나요.」가 찍히고, 40초를 붙이면 30초와 60초 두 지점에 「감사합니다.」가 찍힌다.
40초를 붙이면 79개 모두에 말 없는 창이 생긴다. 그러자 무음 40초에서도 잡음 40초에서도 79개 전부 꼬리에 글자가 붙었다. 잡음 쪽에서는 79개 가운데 49개가 글자 그대로 「시청해주셔서 감사합니다.」였다. 인사만 붙은 것도 아니다. 「…사진으로 찍어 두셔도 좋습니다.」라는 말 뒤에 「이 화면은 제가 찍은 사진으로 찍을 수 있는 화면이 있습니다.」라는, 하지 않은 문장을 지어 붙여 스무 번 넘게 적은 파일도 있었다. 말 뒤에 잠깐 쉬는 것은 대개 괜찮았지만, 꼬리를 붙인 이 실험에서 30초 창 하나에 말이 한 마디도 들지 않은 파일에는 빠짐없이 무언가가 적혔다.
끄는 법과 그 한계 — 음성 활동 감지
도구의 기본 설정대로 받아쓰게 하자, 말 없는 자리의 글자는 이번 실행에서 오히려 늘었다. 이 글의 실측은 매 자리에서 가장 그럴듯한 글자 하나만 고르는 그리디로 쟀다. faster-whisper 의 기본 설정은 이와 달리 여러 후보를 함께 따져 고른다. 무음·잡음과 환경음에서 종류별로 고르게 뽑은 157개를 이 설정으로 다시 돌리자, 글자가 나온 비율은 86.6%였다. 같은 157개를 그리디로 돌렸을 때는 79.0%였다. 기본 설정에는 무작위가 끼어 있어 이 86.6%는 이번 실행의 값이다.
말 없는 자리의 글자를 막는 방법은, 말 없는 구간을 애초에 모델에 넣지 않는 것이다. 음성 활동 감지(VAD)가 그 일을 한다. 소리에서 말소리가 있는 구간만 골라 모델에 넘기고, 나머지는 받아쓰기 전에 빼 버리는 장치다. 그림 1 오른쪽의 옆길이 바로 이것이다.
같은 파일들에 faster-whisper 에 들어 있는 음성 활동 감지(Silero VAD)를 기본 설정으로 켜고 다시 받아쓰게 했다. 합성 무음·잡음 217개에서 글자가 나온 파일은 212개(97.7%)에서 2개(0.9%)로 줄었다. 환경음은 1,173개(73.3%)에서 136개(8.5%)로 줄었다. 말 뒤에 무음 10초를 붙였을 때 꼬리에 글자가 붙은 파일은 79개 중 3개에서 0개가 됐다. 무음 40초를 붙였을 때는 79개 전부에서 0개가 됐다.
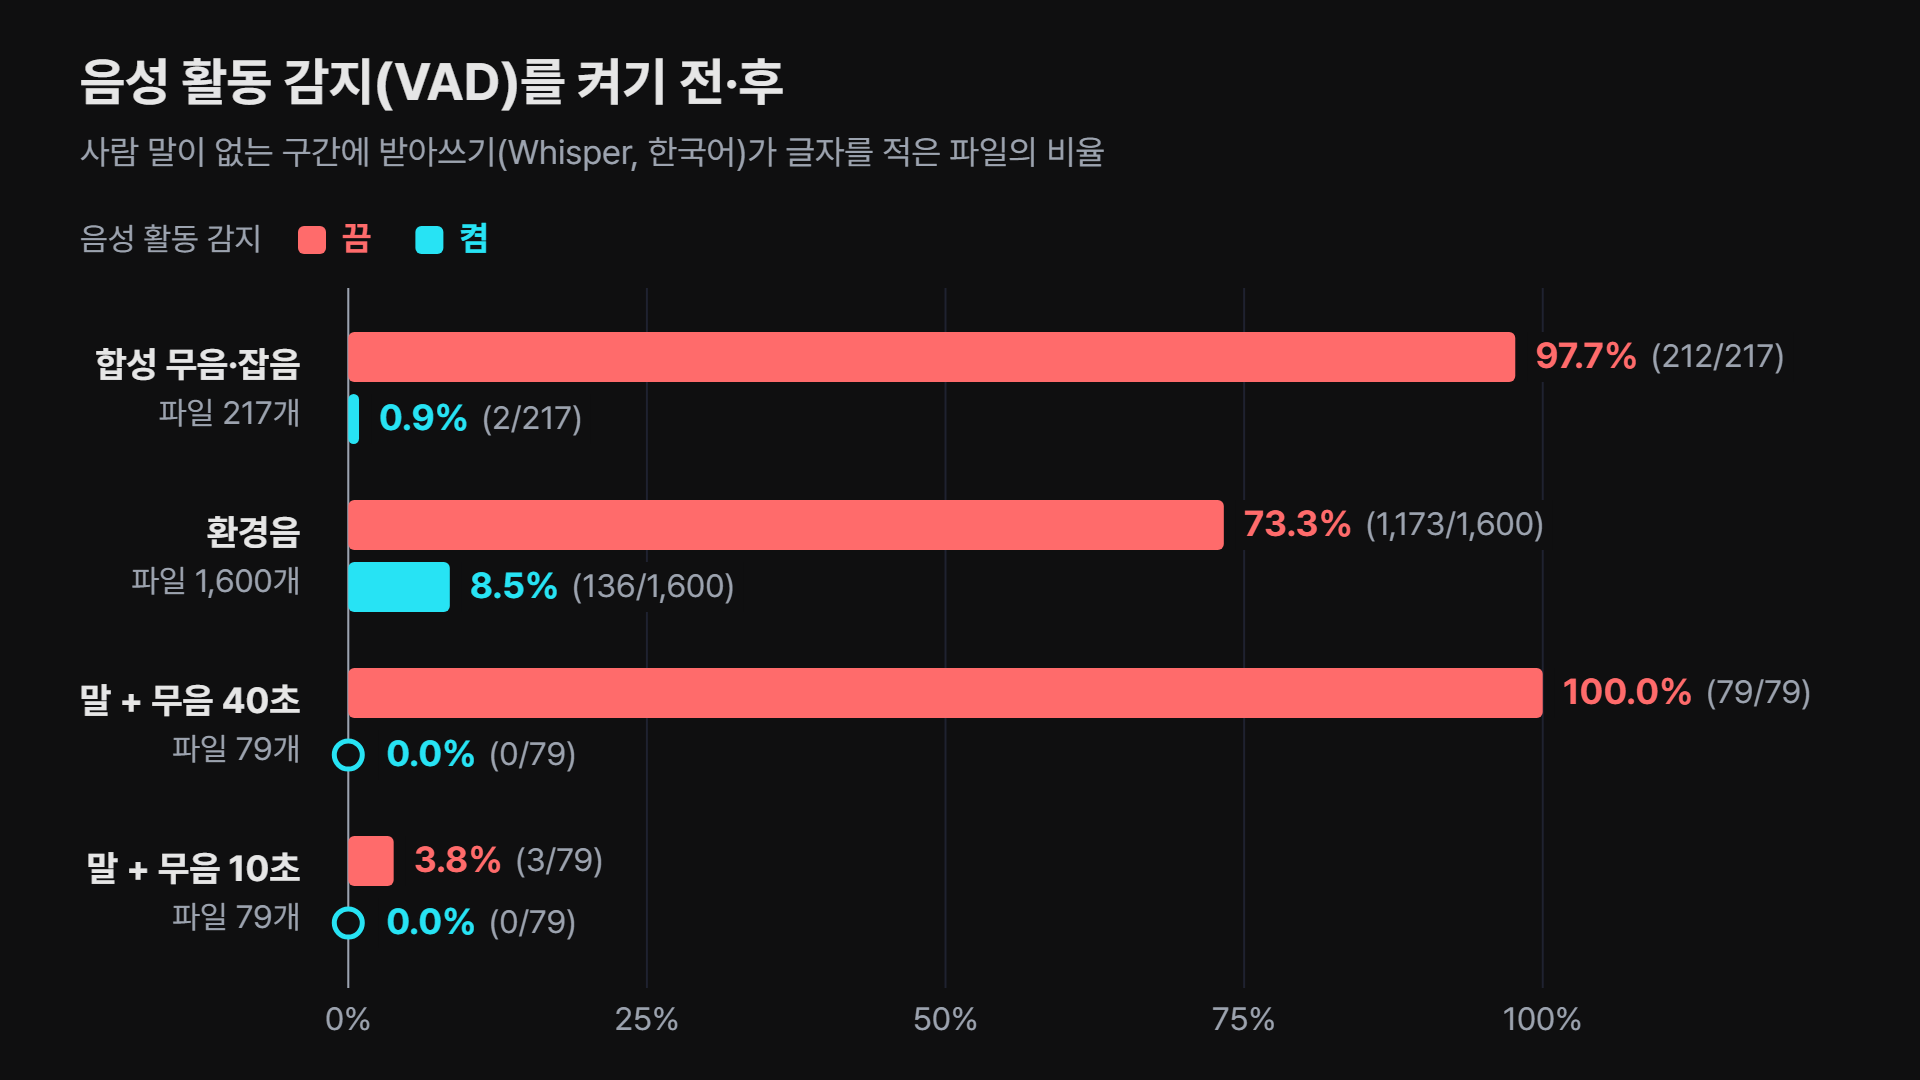
그림 4 에서 켜기 전과 켠 뒤 막대의 길이 차이가 그 결과다. 영어 선행 실험도 같은 쪽을 가리킨다. 그 실험에서 쓴 단어 오류율은 받아 적은 단어가 정답과 얼마나 다른지 재는 값이다. 없는 말을 많이 끼워 넣으면 100%를 넘을 수도 있다. 말소리 앞이나 뒤, 또는 양쪽에 말 아닌 소리를 겹치지 않게 붙인 영어 녹음에서, 아무 처리도 하지 않았을 때 단어 오류율은 104.8%였다. 한 가지만 쓴 대책 가운데 이 값을 가장 크게 낮춘 것은 Silero VAD 로 말소리 구간을 먼저 골라낸 방법이었고, 8.0%까지 내려갔다.
다만 0은 아니다. 켜 둔 채로도 합성 무음·잡음과 환경음을 합친 1,817개 가운데 138개에서 글자가 나왔고, 그중 65개가 「감사합니다.」였다. 방송 뉴스의 끝맺음 인사(이름 포함)도 4개 남았다. 영어 선행 연구의 저자들도 자신들이 비교한 방법 가운데 어느 것도 이런 오류를 완전히 막는 해법으로 볼 수는 없다고 적었다.
However, none of these approaches can be considered a complete solution that fully protects against errors of this kind.
Barański 외, “Investigation of Whisper ASR Hallucinations Induced by Non-Speech Audio” §V-B (ICASSP 2025, arXiv:2501.11378)자주 나오는 환각 문구를 목록으로 만들어 지우는 방법에는 반전이 있다. 영어 선행 연구가 만든 삭제 목록에 thanks for watching 은 들어갔지만, 가장 흔했던 thank you 는 들어가지 못했다. 영어에서 워낙 자주 쓰는 말이라, 늘 환각으로 보고 지우면 잘못 지우는 경우가 많아질 수 있다는 것이 저자들의 설명이다. 한국어의 「감사합니다」도 같은 처지일 가능성이 크다. 한국어 목록을 만들어 잰 것은 아니지만, 진짜로 한 인사까지 함께 지워질 수 있는 말이기 때문이다.
faster-whisper 에서는 받아쓰기를 부를 때 vad_filter 옵션을 켜면 된다. 이번 실측에서 켠 설정이 이것이다. 오픈AI 의 openai-whisper 에는 정한 길이보다 긴 무음을 건너뛰는 매개변수가 있다(논문 표기 hallucination silence threshold). 영어 선행 실험에서 이 설정의 효과는 저자 표현으로 「slight improvement」, 약간 나아지는 정도였다. 어느 쪽이든 켠 뒤에는 말이 없는 녹음을 한 번 넣어 보고 자막이 비는지 확인하는 편이 확실하다.
자막 끝의 「감사합니다」는 아무도 하지 않은 말일 수 있다. 이번 실측에서 그 인사는 말소리가 없는 구간에서 나왔고, 음성 활동 감지를 켠 뒤에도 0이 되지는 않았다. 하지만 받아쓰기 전에 말소리 구간만 골라 넘기는 설정 하나로, 말 없는 자리에 적히던 인사말은 대부분 막을 수 있다.
더 읽기
- Barański, Jasiński, Bartolewska, Kacprzak, Witkowski, Kowalczyk, "Investigation of Whisper ASR Hallucinations Induced by Non-Speech Audio", ICASSP 2025 (arXiv:2501.11378) — https://arxiv.org/abs/2501.11378
- Radford, Kim, Xu, Brockman, McLeavey, Sutskever, "Robust Speech Recognition via Large-Scale Weak Supervision", arXiv:2212.04356 (2022) — https://arxiv.org/abs/2212.04356
- Piczak, "ESC-50: Dataset for Environmental Sound Classification" (데이터셋, CC BY-NC 3.0, DOI 10.7910/DVN/YDEPUT — 이 글의 환경음 실측에 썼다. 데이터셋 논문: "ESC: Dataset for Environmental Sound Classification", Proceedings of the 23rd Annual ACM Conference on Multimedia, 2015) — https://github.com/karolpiczak/ESC-50