AI 검색에 건강 질문을 하면 답 밑에 병원·정부 기관 사이트 링크가 달려 나온다. 의료 질문 800개로 잰 연구에서 웹 검색을 붙인 GPT-4o 의 링크는 99.3% 가 열렸지만, 답의 절반 가까이(45%)는 달린 출처로 다 뒷받침되지는 않았다. 저자들이 공개한 판정을 다시 세어 보니, 뒷받침 안 된 주장의 대부분은 링크가 딴소리를 한 답이 아니라 출처를 아예 안 단 답에서 나왔다. 답의 말이 달린 출처에 실제로 적혀 있는지를 따지는 이 일을 출처 검증(citation verification)이라고 한다.
AI 검색 답의 링크는 열린다, 그 말도 거기 있을까
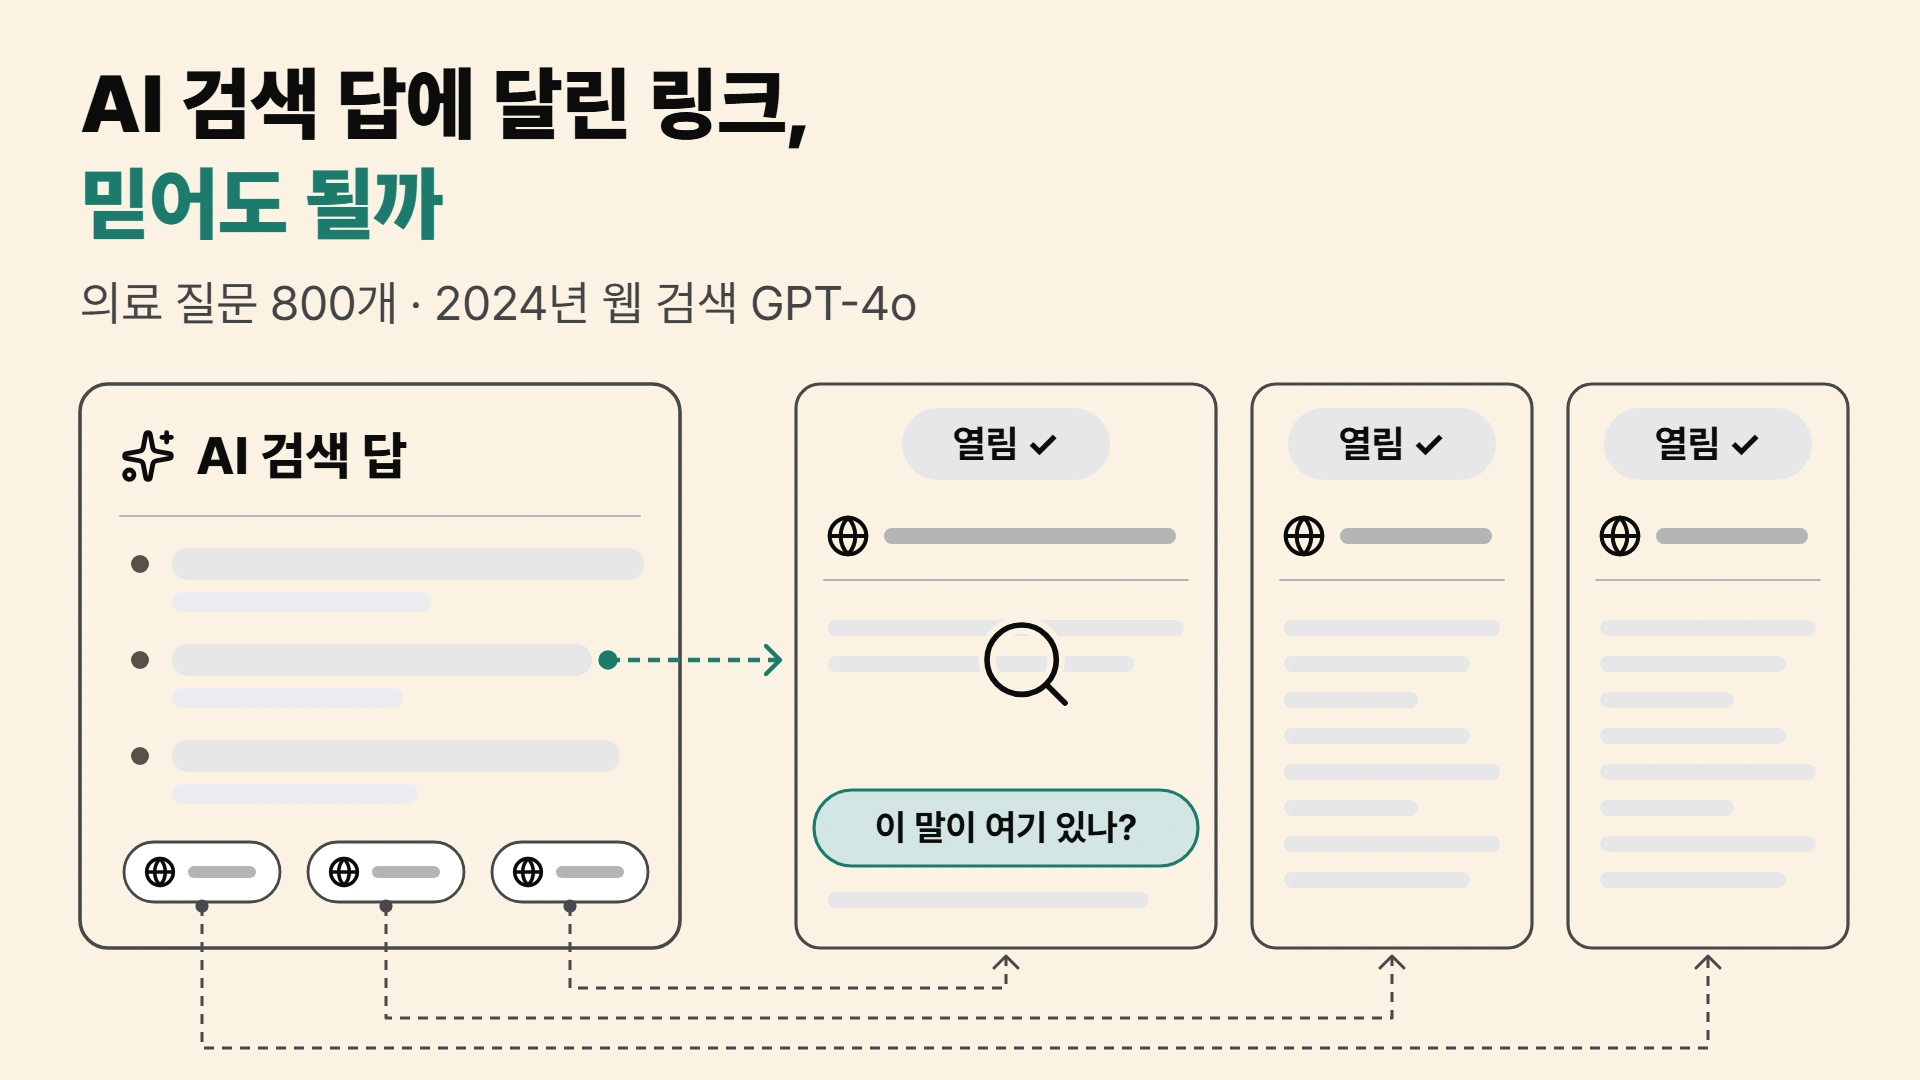
웹 검색을 붙인 GPT-4o 가 의료 질문에 단 링크는 99.3% 가 열렸지만, 답의 내용이 하나도 빠짐없이 출처로 뒷받침된 답은 55.3% 였다. AI 검색에 약 부작용이나 증상을 물었다가, 답 밑에 달린 병원 사이트 링크를 눌러 보는 장면을 떠올려 보자. 링크가 열리면 그 말에 출처가 있다고 믿기 쉽다. 하지만 링크가 열렸다는 것과 그 말이 거기 적혀 있다는 것은 서로 다른 질문이다. 뒤쪽은 열린 페이지를 끝까지 읽어 봐야 알 수 있다.
두 숫자는 Stanford 대학 연구진이 2025년 Nature Communications 에 낸 SourceCheckup 연구에서 나왔다. 연구진은 의료 질문 800개를 준비했다. 절반은 Mayo Clinic 의 건강 문서를 바탕으로 만든 질문이고, 절반은 Reddit 의 의료 상담 게시판(r/AskDocs)에 실제 사용자가 올린 질문이다. 연구진은 답에 달린 링크의 페이지를 내려받아 답과 대조했다. 평가한 모델은 2024년 상반기 판(GPT-4o 는 2024-05-13 판)이라, 지금 쓰는 ChatGPT 검색과 같은 모델이 아니다. 숫자도 의료 질문에서 잰 것이다.
검색 엔진에서 찾은 글을 바탕으로 답을 쓰게 하는 방식을 검색 증강 생성(retrieval-augmented generation, RAG)이라고 한다. 이 글에서는 그냥 「웹 검색을 붙인 모델」이라고 부른다. 연구에서 이런 모델은 GPT-4o 와 Gemini Ultra 1.0 둘이었고, 이 글은 주로 GPT-4o 를 따라간다. 웹 검색이 없는 모델은 링크가 40~70% 만 열렸다. 다만 같은 모델에 검색을 켰다 껐다 한 실험은 아니어서, 검색을 붙여서 링크가 좋아졌다고까지 말할 수는 없다. 이 글이 파고드는 것은 그다음 질문, 곧 열린 링크가 그 말을 하고 있느냐다.
링크로 세기, 주장으로 세기, 답으로 세기
열린 링크가 그 말을 하는지 재려면 먼저 「그 말」을 잘게 나눠야 한다. 연구진은 답을 확인 가능한 사실 하나씩으로 쪼갰고, 이 조각을 이 글에서는 주장이라고 부른다. 한 문장에 남성의 비율과 여성의 비율이 함께 적혀 있으면, 그 문장은 주장 둘로 나뉘는 식이다. 연구진은 답을 두세 문장으로 하라고 시켰지만, 웹 검색 GPT-4o 의 답은 평균 7개 가까운 주장으로 쪼개졌다.
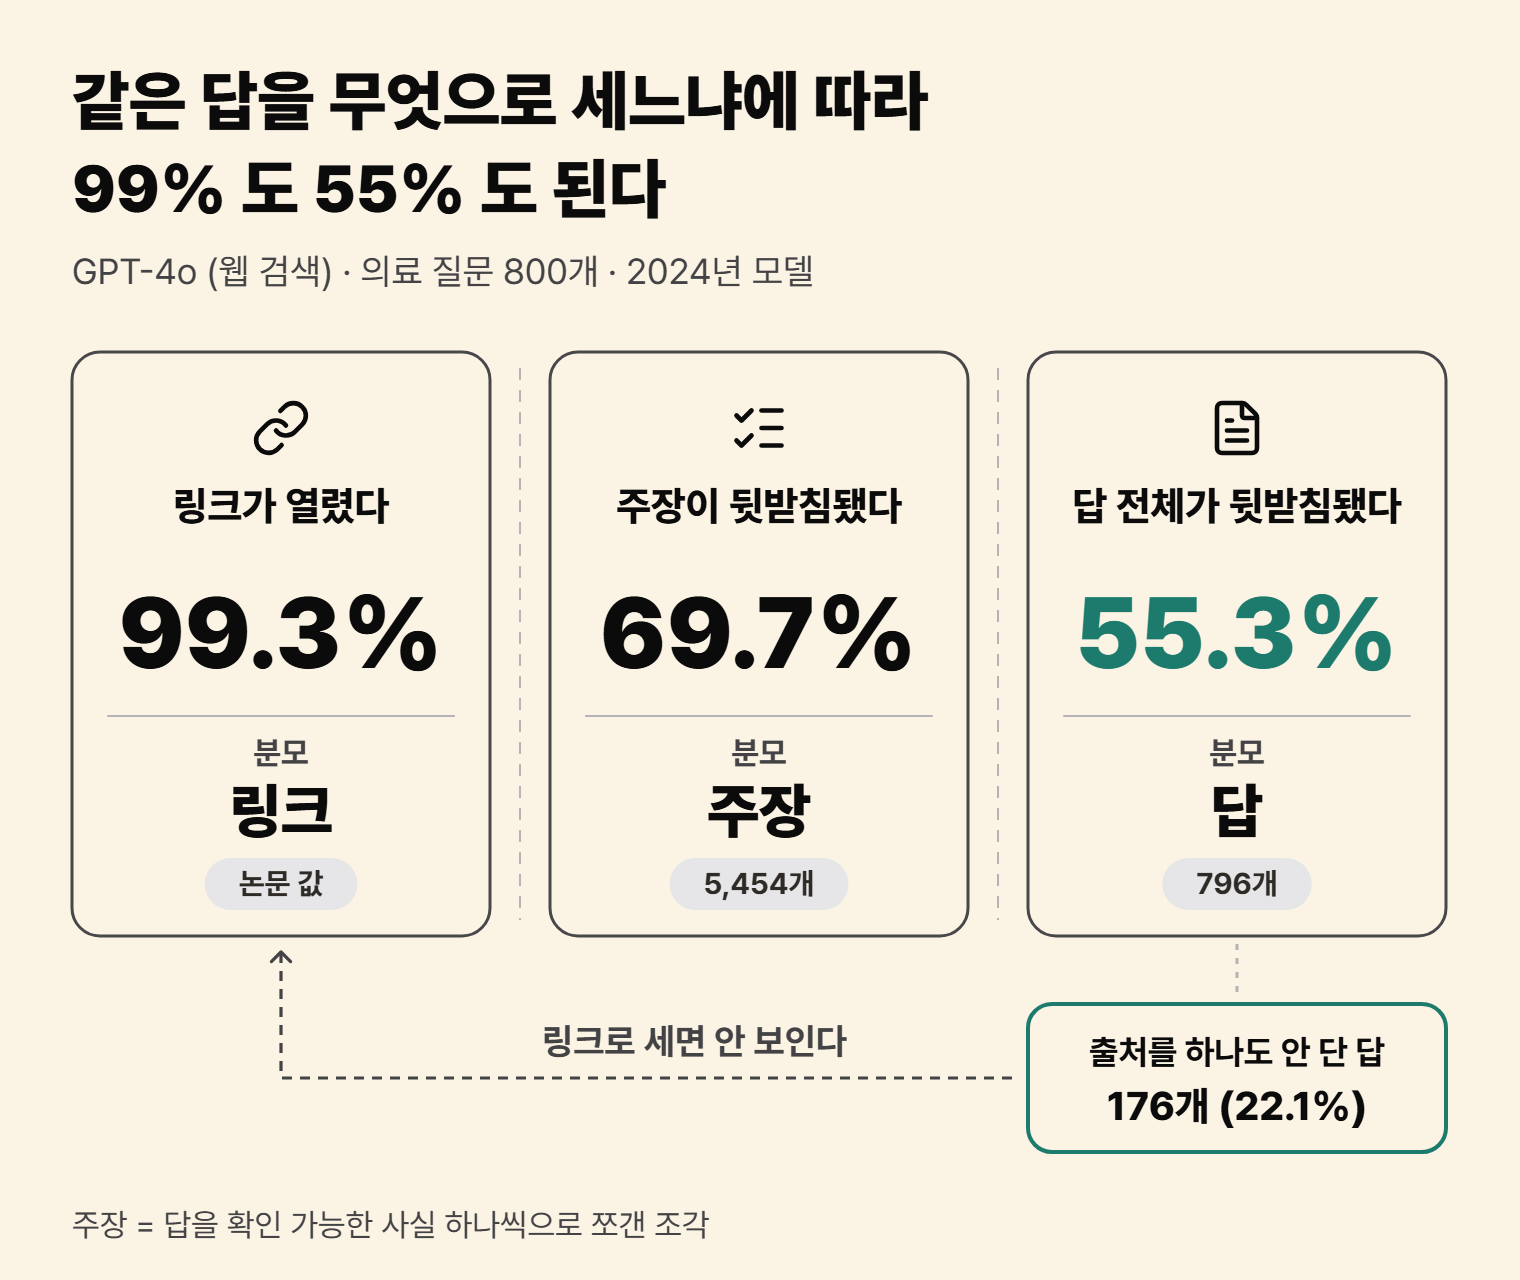
이렇게 나누면 같은 답 묶음을 세 가지 방식으로 셀 수 있다. 첫째는 링크를 하나씩 보는 방식이다. 링크마다 페이지가 열리는지만 묻고, 그 결과가 99.3% 다. 링크가 실제로 있는 페이지를 가리키는지, 없는 주소를 지어낸 것인지를 가리는 질문이다.
둘째는 주장을 하나씩 보는 방식이다. 답에 달린 링크 가운데 아무것이라도 그 주장을 말하고 있으면 뒷받침된 것으로 친다. 주장 바로 옆에 붙은 링크가 아니어도 된다. 이렇게 세면 주장 5,454개 가운데 69.7% 가 뒷받침됐다.
셋째는 답을 하나씩 보는 방식이다. 답 안의 주장이 하나도 빠짐없이 뒷받침돼야 그 답을 통과로 친다. 주장이 일곱 개인 답이라면 일곱 개가 모두 뒷받침돼야 한다. 답 796개 가운데 55.3% 가 통과했다(그림 1). 같은 답 묶음인데 분모가 링크인지, 주장인지, 답인지에 따라 숫자가 이만큼 벌어진다.
주장이 출처에 실제로 적혀 있는지 따지는 일을 출처 검증이라고 한다. 이 연구에서 출처 검증은 사람이 아니라 연구진이 만든 판정기가 맡았다. 판정기는 GPT-4o 로, 주장과 출처 페이지를 한 쌍씩 받아 판단한다. 연구진은 주장-출처 400쌍을 의사 세 명에게도 보였는데, 판정기는 의사들의 합의와 88.7% 일치했다. 의사끼리의 평균 일치율은 86.1% 였고, 저자들은 이를 근거로 판정기가 전문가만큼 판단한다고 보았다.
셋 가운데 틀린 숫자는 없다. 저마다 다른 질문에 답했을 뿐이다. 문제는 한 숫자만 보고 나머지 두 질문까지 답이 났다고 여길 때 생긴다. 99.3% 는 링크가 살아 있다는 뜻이지, 그 링크가 답의 말을 받쳐 준다는 뜻이 아니다.
뒷받침 안 된 주장은 대부분 출처 없는 답에 있었다
연구진은 질문, 답, 쪼갠 주장, 주장-출처 쌍마다의 판정을 모두 내려받을 수 있게 공개해 두었다. 공개분에는 질문 1,200개가 들어 있는데, 그중 논문과 같은 범위의 800개만 골랐다. 이 글은 저자들의 판정을 그대로 두고, 세는 방법만 바꿔 다시 셌다. 다시 센 값은 논문 표의 주장 단위 69.7%, 답 단위 55.3% 와 똑같이 나왔다. 아래의 분해는 논문에 없고, 이 글이 계산한 것이다.
링크 쪽에는 문제가 거의 없었다. 링크 100개 가운데 열리지 않은 것은 한 개도 채 안 됐다. 문제는 뒷받침 안 된 주장이었는데, 이런 주장은 전체 주장의 30.3% 였다. 그 가운데 22.2%p 가 출처를 하나도 안 단 답 176개에서 나왔다. 뒷받침 안 된 주장 넷 가운데 셋쯤이 링크가 아예 없는 답에 들어 있었다는 뜻이다. 출처를 달고도 뒷받침되지 않은 주장은 나머지 8.1%p 뿐이다.
출처를 하나 이상 단 답 620개만 따로 보면 주장은 89.6% 가 뒷받침됐다. 출처가 달린 답만 놓고 보면 주장 열 개 중 아홉은 달린 링크 어딘가에 적혀 있었다는 뜻이다. 그런데 답 전체가 통과한 비율은 71.0% 로 내려간다. 주장이 많은 답일수록 그중 하나는 빠지기 쉬웠기 때문인데, 이것은 뒤에서 따로 살펴본다.
세는 단위에 따라 「대부분」의 뜻도 달라진다. 주장으로 세면 뒷받침 안 된 것의 약 4분의 3 이 출처 없는 답에서 나왔다. 답으로 세면 주장이 다 뒷받침되지는 않은 답 356개 가운데 출처 없는 답이 176개, 출처를 달고도 주장이 하나 이상 빠진 답이 180개로 거의 반반이다. 출처 없는 답은 주장이 통째로 빠지고, 출처를 단 답은 대개 몇 개만 빠지기 때문이다. 어느 단위로 세든, 링크가 딴소리를 하는 문제보다 먼저 링크가 아예 없는 답이 있었다. 그리고 링크 열림률은 그런 답을 볼 수 없다.
출처를 하나도 안 단 답 176개
답 796개 가운데 176개(22.1%)는 출처 목록이 비어 있었다. 이 답들의 주장 1,213개는 전체 주장의 22.2% 이고, 받쳐 줄 출처가 없으니 그중 뒷받침된 것은 하나도 없다. 출처 없는 답은 Reddit 질문에서 117개로, Mayo Clinic 질문의 59개보다 두 배 가까이 많았다. 연구진은 이 모델에 출처를 URL 로 달라고 지시했고, 저자들도 이 점을 짚었다.
we find that GPT-4o (RAG) fails to produce sources in over 20% of responses, even when explicitly prompted to do so (Supplementary Fig. 2), partially contributing to its low response-level support.
출처를 달라고 분명히 지시해도 웹 검색 GPT-4o 는 답의 20% 넘게에서 출처를 내지 못했고, 이것이 답 단위 비율을 낮춘 한 이유다.
Wu 외, 「An automated framework for assessing how well LLMs cite relevant medical references」, Nature Communications (2025), 결과 절저자들이 쓴 「20% 넘게」는 이 글이 다시 센 22.1% 와 같은 대상을 잰 값이다. 링크 열림률은 링크를 하나씩 세므로, 링크가 0개인 답은 계산에 아예 들어가지 않는다. 뒷받침 안 된 주장을 가장 많이 낸 답들이 링크 검사에서는 흠 없이 지나간다는 뜻이다.
출처를 단 답 — 주장은 열에 아홉 뒷받침되는데 답 전체는 덜 통과한다
출처를 단 답 620개 안에서는 답이 길수록 덜 통과했다. 주장이 1~3개인 답은 91.3%, 11개 이상인 답은 51.6% 가 통과했다. 그런데 주장 하나하나가 뒷받침된 비율은 길이와 상관없이 87~95% 로 거의 평평했다. 그래서 이 글은 긴 답이 덜 통과한 원인을 주장의 뒷받침보다 개수로 본다.
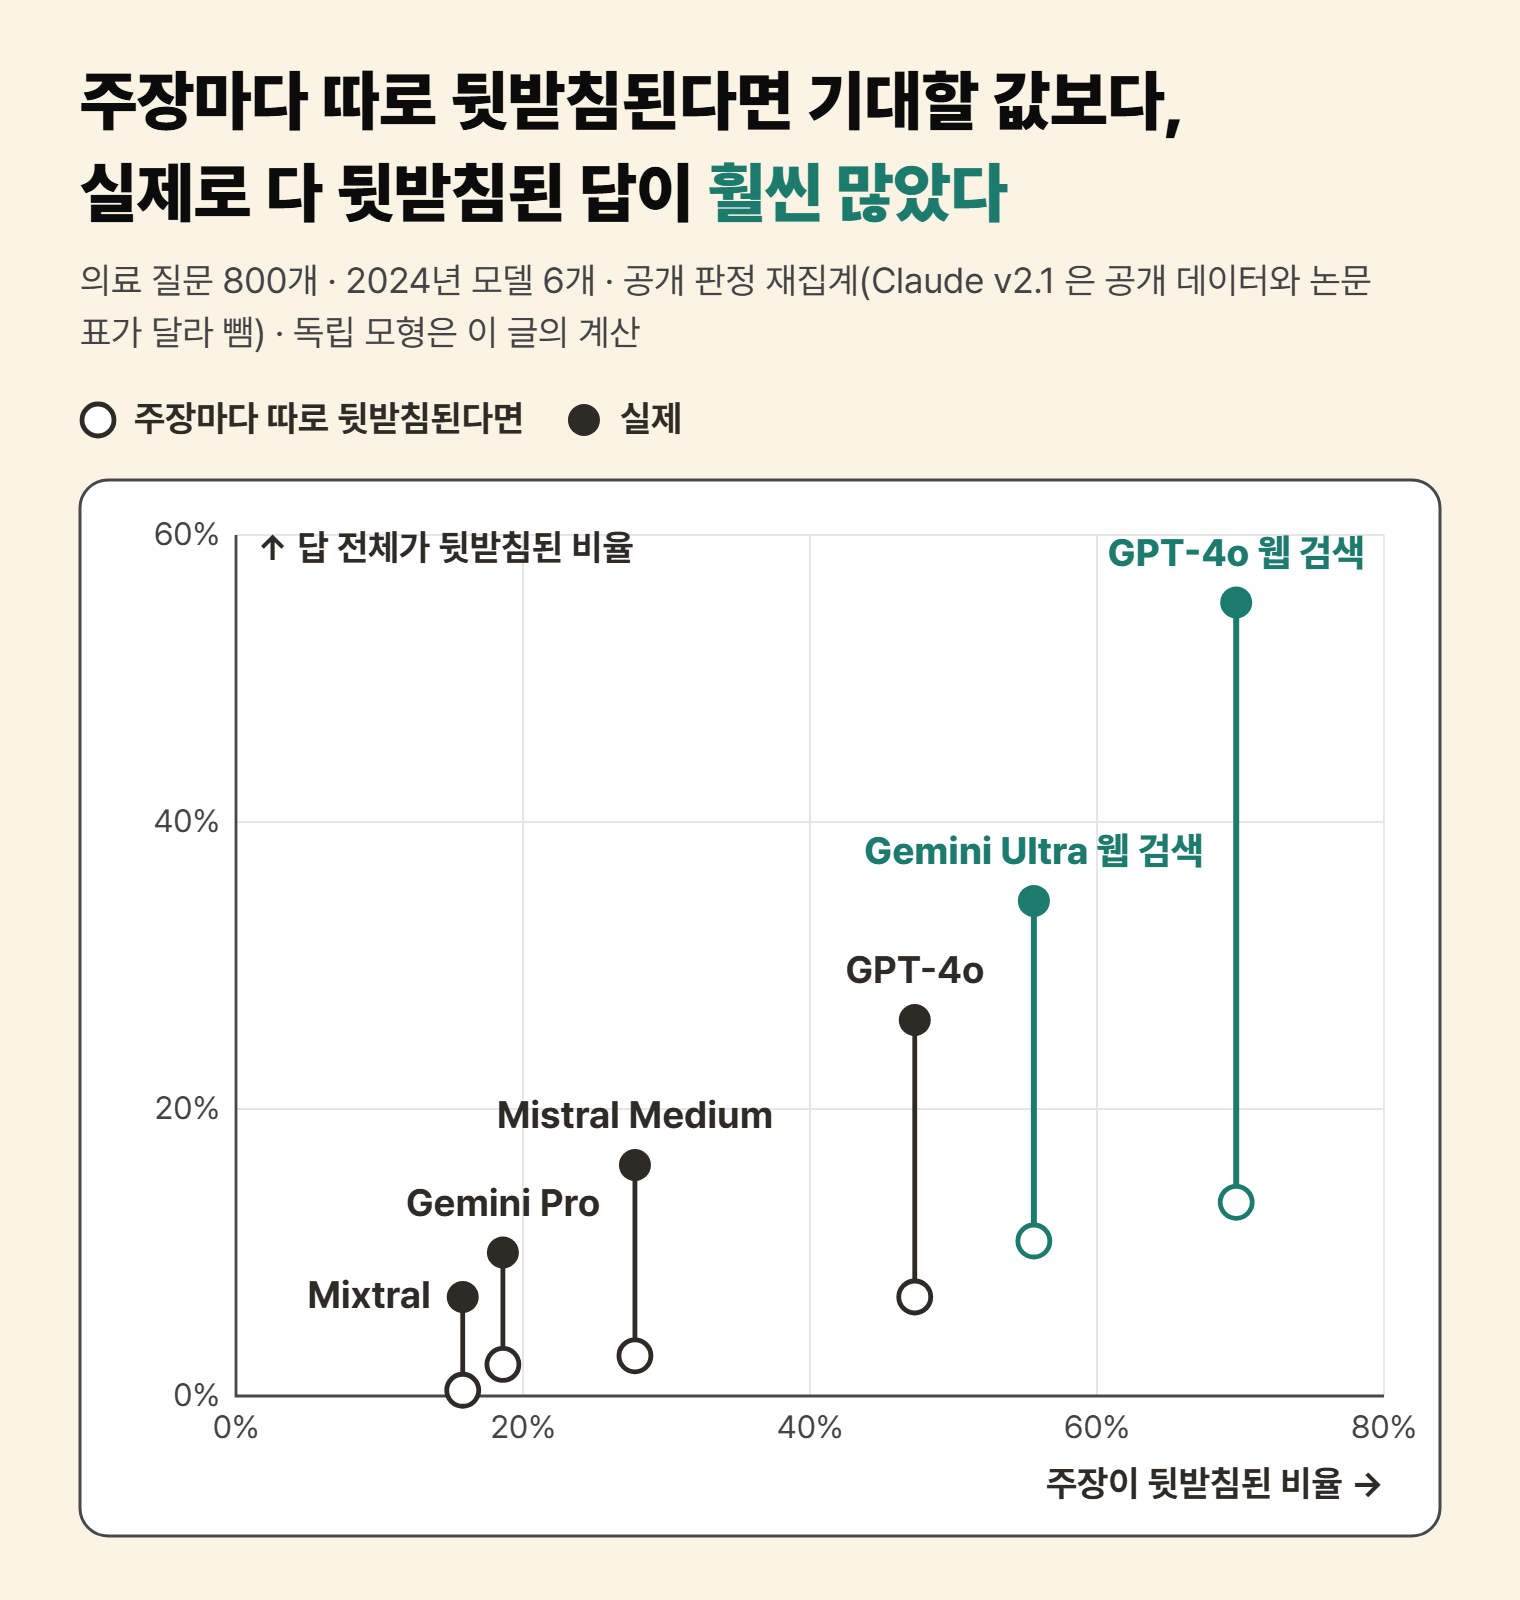
곱셈으로 보면 주장 수의 영향이 보인다. 주장마다 서로 상관없이 뒷받침되거나 빠진다고 쳐 보자. 주장 하나가 뒷받침될 확률이 0.9 이고 주장이 일곱 개면, 일곱 개가 다 뒷받침될 확률은 0.9 를 일곱 번 곱한 약 0.48 이다.
다만 실제 답은 이 곱셈보다 자주 통과했다. 출처를 단 답에서 주장이 뒷받침된 비율 89.6% 에 답마다 실제 주장 개수를 넣어 곱하면, 답 전체 통과는 약 50.1% 여야 한다. 실제로는 71.0% 였다. 주장이 많으면 통과가 어려워지긴 해도, 곱셈이 예상한 만큼은 아니었다. 뒷받침 안 된 주장이 몇몇 답에 몰려 있었다는 뜻이다. 출처 없는 답까지 넣은 전체 796개로 세면 실제(55.3%)가 계산(13.5%)보다 높았고, 그림의 모델 6개도 모두 그랬다(그림 2).
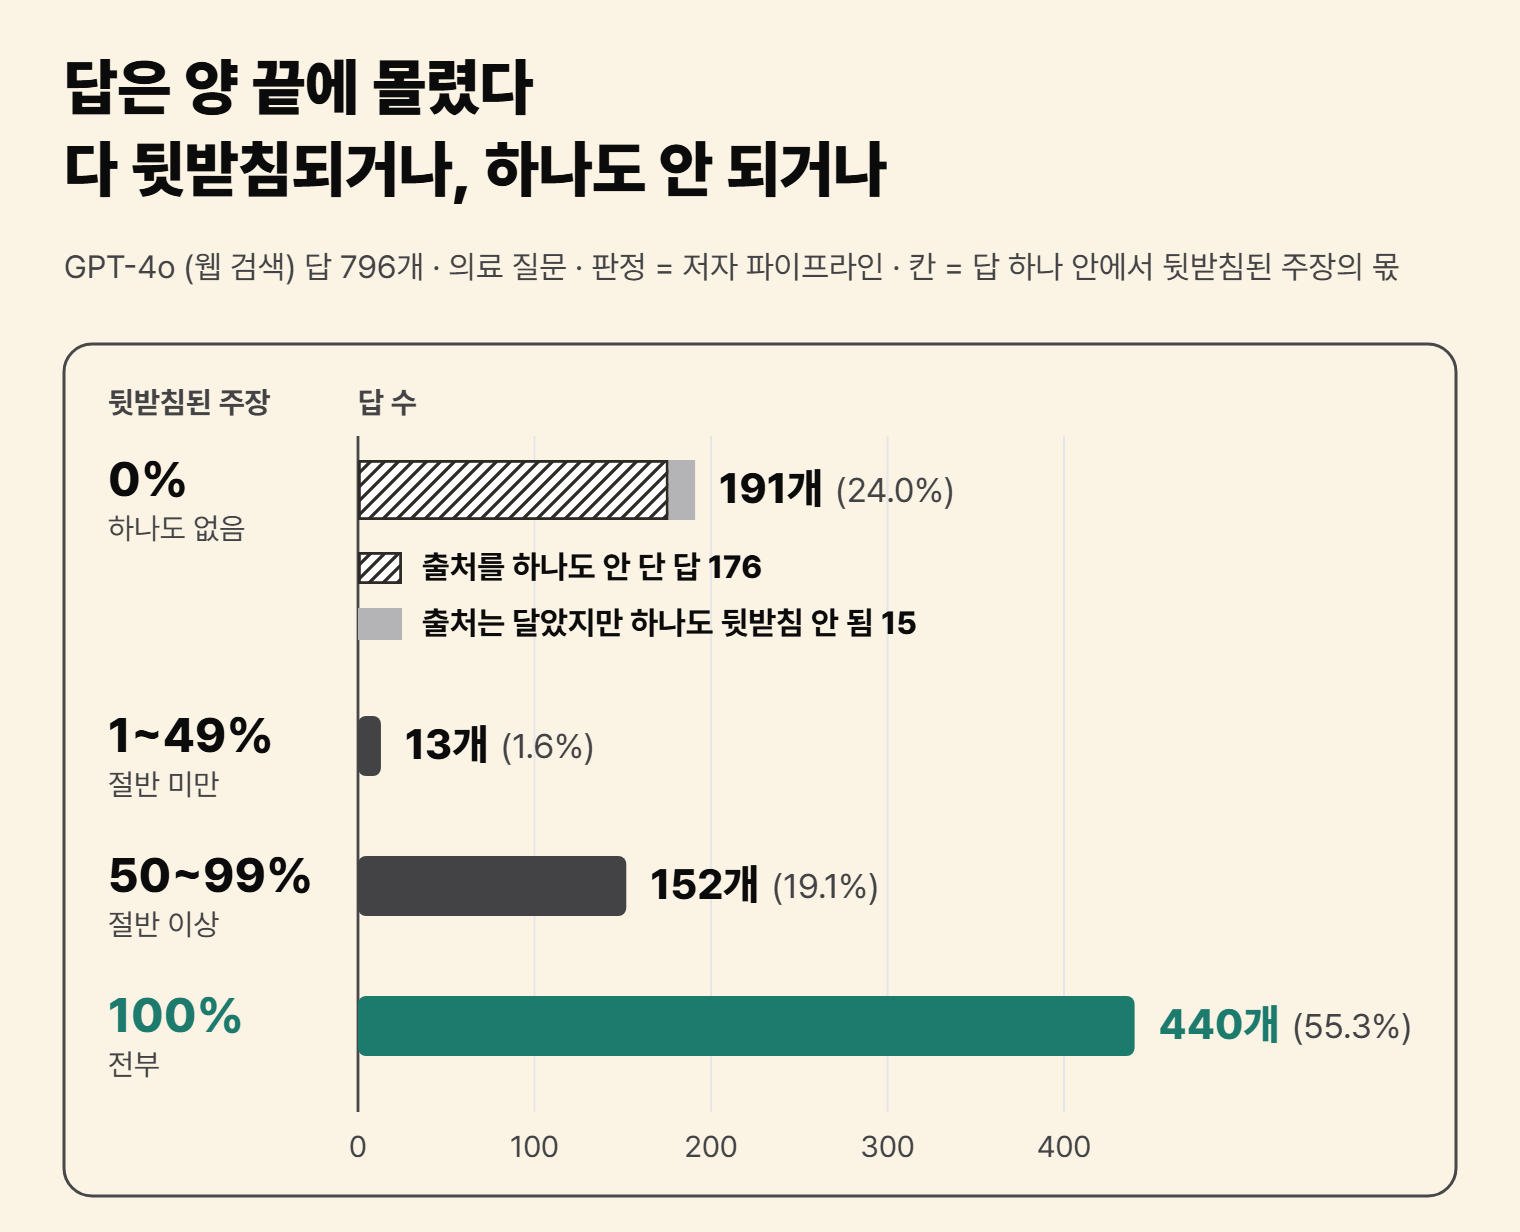
답마다 뒷받침된 주장의 몫으로 나눠 보면 몰림이 눈에 보인다(그림 3). 답 796개 가운데 440개는 주장이 전부 뒷받침됐고, 191개는 하나도 뒷받침되지 않았다. 그 191개 가운데 176개가 출처를 안 단 답이다. 양 끝 사이에 든 답은 165개뿐이다.
출처를 달고도 빠진 주장은 이런 모양이다. 골프 엘보(팔꿈치 안쪽 힘줄 통증)의 수술 없는 치료를 물은 질문이 있었다. 답은 체외충격파 치료가 초음파 유도 기법이라는 주장을 내놓고 Mayo Clinic 의 치료 페이지를 달았다. 판정기(GPT-4o)는 그 페이지가 「does not mention Extracorporeal Shock Wave Therapy」, 곧 체외충격파 치료를 언급하지 않는다는 이유를 남겼다.
질문 종류에 따라서도 갈렸다. 출처 없는 답까지 넣은 원문 값으로, 답 전체 통과는 Mayo Clinic 질문에서 80% 가까이, Reddit 질문에서 31.0% 였다. 저자들은 Reddit 질문이 「more open-ended」, 곧 답이 열려 있어 여러 분야의 출처가 필요하다고 설명했다. 출처를 단 답에서도 빈 곳은 고르게 흩어지지 않고 몇몇 답, 특히 주장이 많은 답에 몰린다.
2023년 AI 검색과 2025년 딥 리서치에서도 같은 틈이 보였다
2023년 Stanford 의 Liu 외 연구진은 Bing Chat·NeevaAI·perplexity.ai·YouChat 네 엔진의 답을 사람 평가자에게 보였다. 문장이 그 문장에 붙은 인용만으로 완전히 뒷받침된 비율은 평균 51.5% 였고, YouChat 의 11.1% 가 평균을 끌어내렸다. YouChat 답의 55.7% 는 인용이 아예 없었다(이 글이 공개 데이터로 센 값). SourceCheckup 은 답의 출처 아무거나를 보므로, 이 51.5% 를 앞의 69.7% 와 견주지는 않는다. 유용해 보이는 엔진일수록 인용이 제 문장을 뒷받침한 비율은 낮았다. 저자들은 출처를 베끼면 인용은 정확해지지만 덜 유용해 보인다는 가설을 냈다.
딥 리서치는 AI 가 여러 번 검색해 긴 보고서를 써 주는 기능이다. 2025년 DeepTRACE 는 초록에서 딥 리서치 설정의 인용 정확도가 시스템에 따라 40~80% 라고 적었다. 동료 심사 기재가 없는 프리프린트다. 판정은 GPT-5 가 했고 사람 판정과 맞는 정도가 중간쯤이라, 더 약한 근거다. 연구 시기도 판정하는 쪽도 달랐지만, 출처가 달렸다는 것과 그 말을 했다는 것 사이의 틈은 매번 나타났다.
같은 답 묶음, 세 가지 숫자
AI 가 모를 때 그럴듯한 말을 지어내는 까닭은 앞선 글에서 다뤘다. 그 글은 「모르겠다」에 점수를 주지 않는 채점표가 찍기를 부추긴다는 이야기였다. 이 글이 본 것은 그런 답에 링크가 달려 있을 때 그 링크가 무엇을 보증하느냐다.
링크가 열린다는 숫자에도 쓸모는 있다. 웹 검색이 없는 모델의 40~70% 와 웹 검색 GPT-4o 의 99.3% 를 나란히 놓으면, 열리지 않는 링크가 어느 쪽에 많은지는 드러난다. 없는 주소를 지어낸 링크를 가려내는 데는 이 숫자로 충분하다. 그러나 이 숫자는 링크가 살아 있다는 것까지만 말해 준다. 출처를 하나도 안 단 답이 다섯 개 중 하나 남짓이라는 것은 그 숫자에 담기지 않는다. 주장이 많은 답일수록 하나쯤 빠지기 쉽다는 것도, 뒷받침 안 된 주장이 몇몇 답에 몰려 있다는 것도 마찬가지다.
이 숫자들의 범위도 분명히 해 둔다. 모두 의료 질문에서, 2024년 상반기 모델로, 의사와 89% 가까이 일치한 판정기의 판단 위에서 센 값이다. 판정기가 의사들과 열 번에 한 번꼴로 어긋났으니, 쌍 하나하나의 판정에는 그만한 잡음이 섞여 있다. 주장도 연구진의 도구가 쪼갠 단위라, 쪼개는 방식에 따라 비율이 달라질 수 있다. 지금 쓰는 AI 검색 제품의 수치가 아니고, 다른 분야의 질문에 그대로 옮길 수도 없다. 같은 질문을 지금 물으면 다른 답과 다른 링크가 돌아올 수 있다.
그래도 같은 틈은 2023년의 Bing Chat 과 perplexity.ai 에서도, 2025년의 딥 리서치에서도 나타났다. 엔진이 바뀌고 판정하는 쪽이 사람에서 AI 로 바뀌어도, 링크가 달렸다는 숫자가 그 링크가 그 말을 했다는 숫자를 대신하지는 못했다. 같은 답 묶음이라도 링크를 분모로 놓으면 99%, 답을 분모로 놓으면 55% 다.
더 읽기
- Kevin Wu 외, 「An automated framework for assessing how well LLMs cite relevant medical references」, Nature Communications 16:3615 (2025) — https://www.nature.com/articles/s41467-025-58551-6 · 공개 데이터와 코드 https://github.com/kevinwu23/SourceCheckup
- Nelson F. Liu, Tianyi Zhang, Percy Liang, 「Evaluating Verifiability in Generative Search Engines」, Findings of EMNLP 2023 — https://arxiv.org/abs/2304.09848
- Pranav Narayanan Venkit 외, 「DeepTRACE: Auditing Deep Research AI Systems for Tracking Reliability Across Citations and Evidence」, arXiv:2509.04499 (2025, 프리프린트) — https://arxiv.org/abs/2509.04499