챗GPT에 농담을 부탁하고 같은 부탁을 몇 번 되풀이해 보면, 말만 조금 다른 비슷한 농담이 돌아오곤 한다. 2023년 1월 챗GPT에서 영어로 받은 농담 1,008개를 세어 보니 900개 넘게가 같은 25가지 농담의 되풀이였다. 농담마다 뽑힐 확률이 몇 개 쪽으로 크게 기울어 있기 때문이다. 이렇게 확률이 몇 개 답에 몰려 다른 답이 드물어지는 일을 모드 붕괴(mode collapse)라고 한다.
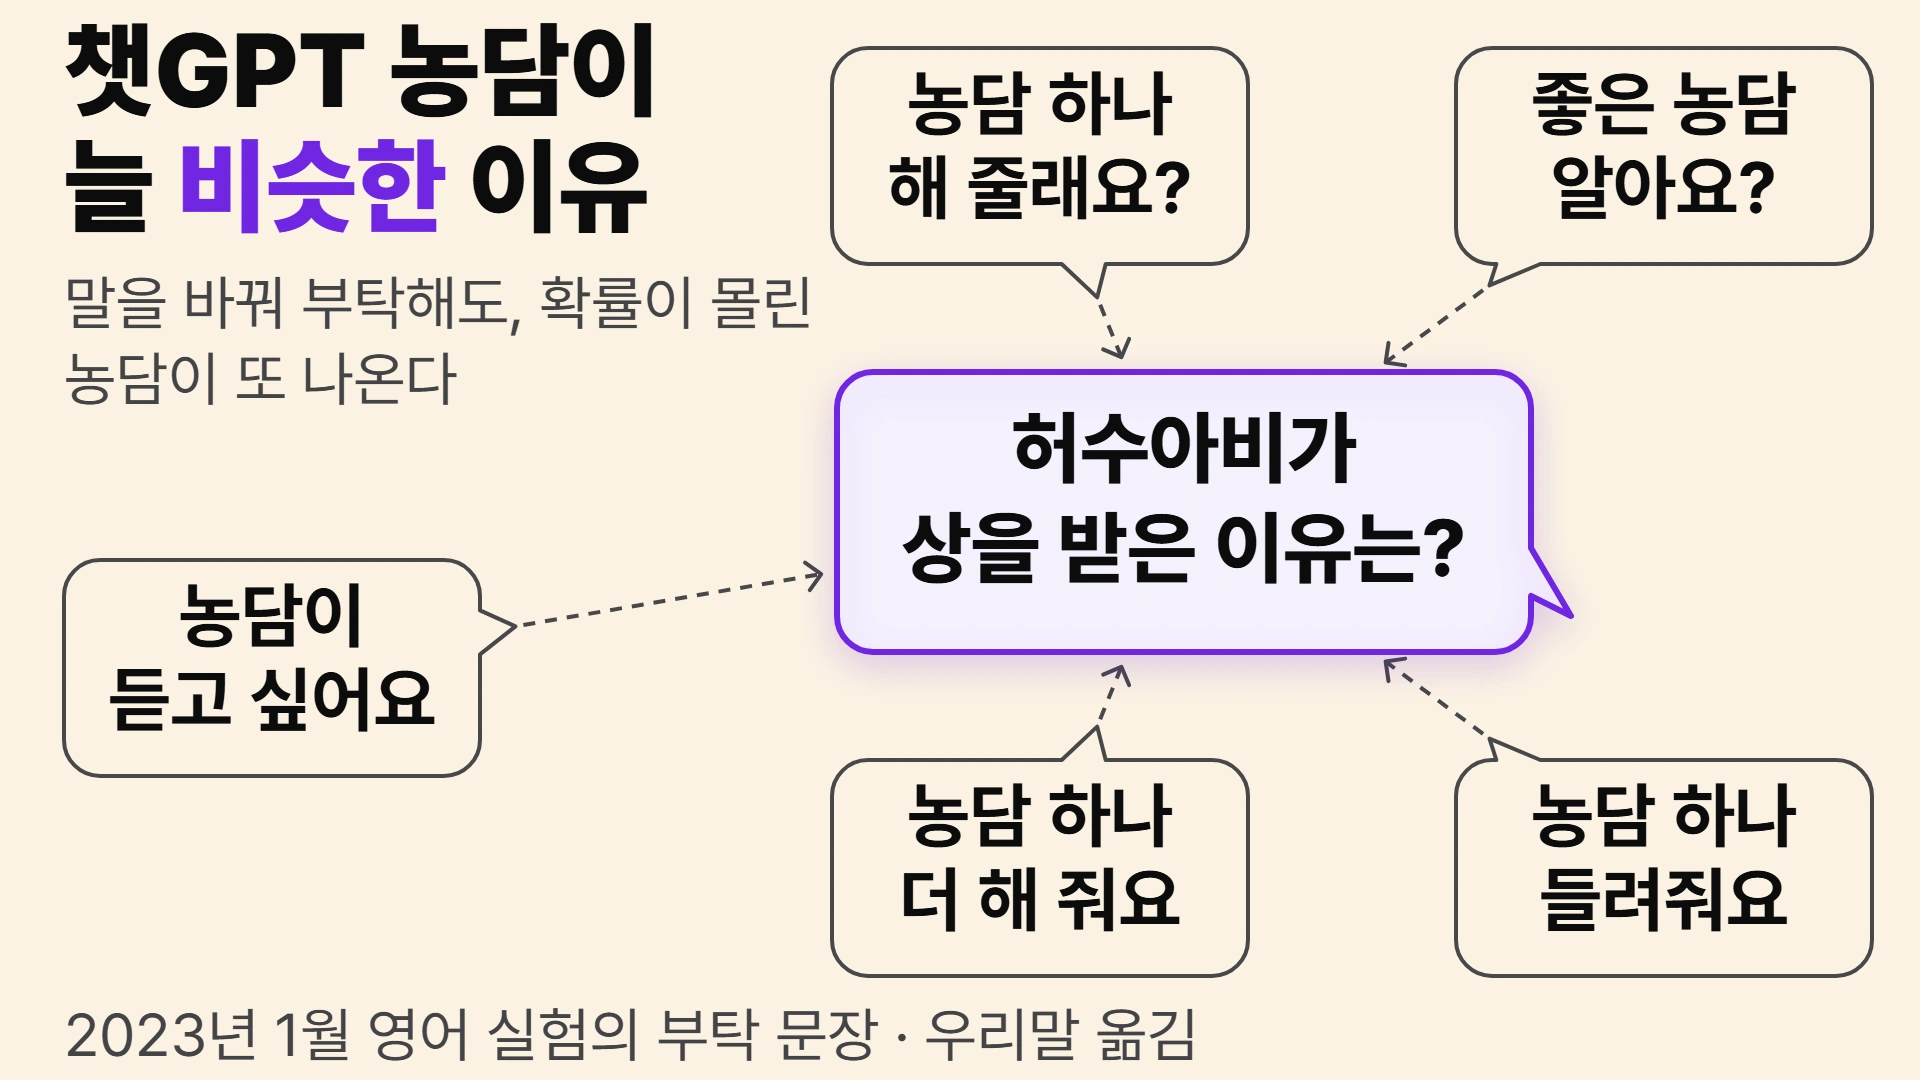
챗GPT(ChatGPT) 대화창에 「농담 하나 해 줘」라고 쳐 보고, 새 대화를 열어 같은 말을 한 번 더 쳐 보면 어디서 들어 본 말장난이 다시 나올 때가 있다. 부탁할 때마다 새 농담을 지어 줄 것 같은데, 들었던 농담이 또 돌아오니 이상하다. 챗GPT한테 농담해 달라고 하면 왜 매번 같은 농담이 나올까? 비슷한 농담이 돌아오는 것은 우연이 아니다. 농담을 고르는 확률이 몇 개 농담에 몰려 있어서, 몇 번을 다시 뽑아도 그 몇 개가 또 뽑힌다. 그 몰림을 실제로 세어 본 기록이 있다.
챗GPT 농담 1,008개는 몇 가지였나
독일항공우주센터(DLR)와 다름슈타트 공과대학교(TU Darmstadt)의 연구자 Jentzsch·Kersting은 2023년 1월 22~31일에 챗GPT에 영어로 농담을 부탁했다. 당시 챗GPT는 GPT-3.5 계열 모델로 돌아가는 웹 서비스였다. 「Can you tell me a joke?」처럼 말만 다른 부탁 문장 10가지를 돌려 가며 약 1,000번 부탁했고, 부탁할 때마다 새 대화를 열어 앞의 대화가 끼어들지 않게 했다. 답에는 거의 언제나 농담이 하나씩 들어 있었다. 「Do you know any good jokes?」라고 물었을 때만 농담이 여러 개 나와서, 받은 농담은 모두 1,008개가 됐다.
저자들은 이 1,008개를 사람 손으로 정리했다. 글자까지 똑같은 것을 하나로 치니 348개가 남았고, 「How about this one」 같은 인사말과 줄바꿈 차이까지 지우니 128개가 남았다. 마지막으로 같은 말장난끼리 다시 묶어 가장 자주 나온 25가지 목록을 만들었다. 예를 들어 「Why did the bicycle fall over? Because it was two-tired.」와 「Why didn’t the bicycle stand up by itself? Because it was two tired.」는 한 묶음이다. 둘 다 「two-tired」(바퀴가 둘)와 「too tired」(너무 지쳤다)의 소리가 같다는 데 기댄 농담이다.
이렇게 묶은 25가지가 1,008개 가운데 900개 넘게, 약 90%를 차지했다. 1위는 허수아비 농담으로 140번 나왔는데, 1,008개 가운데 13.9%이니 일곱 번에 한 번꼴이다. 상위 4가지만 더해도 502개로 절반 가까이(49.8%)다. 그림 1에서 맨 위 네 줄은 길게 뻗고, 그 아래 스물한 가지는 아래로 갈수록 짧아진다.

상위 다섯 가지는 아래와 같다. 원문은 논문 부록 B 그대로이고, 우리말 요지는 이 글이 붙인 것이다. 1위 허수아비 농담은 「outstanding in his field」가 「자기 분야에서 뛰어나다」와 「밭 한가운데 우뚝 서 있다」 두 뜻으로 읽히는 데 기댄 말장난이다.
| 순위 | 원문(영어) | 우리말 요지 | 횟수 |
|---|---|---|---|
| 1 | Why did the scarecrow win an award? Because he was outstanding in his field. | 허수아비가 상을 받은 이유는? 자기 분야(밭)에서 뛰어나서 | 140 |
| 2 | Why did the tomato turn red? Because it saw the salad dressing. | 토마토가 빨개진 이유는? 샐러드가 옷 입는(드레싱) 걸 봐서 | 122 |
| 3 | Why was the math book sad? Because it had too many problems. | 수학책이 슬픈 이유는? 문제가 너무 많아서 | 121 |
| 4 | Why don’t scientists trust atoms? Because they make up everything. | 과학자가 원자를 못 믿는 이유는? 모든 것을 이루어서(지어내서) | 119 |
| 5 | Why did the cookie go to the doctor? Because it was feeling crumbly. | 쿠키가 병원에 간 이유는? 몸이 부스러질 것 같아서 | 79 |
저자들은 정리한 농담 자료도 공개했다. 이 정리본을 이 글에서 다시 세어 보니, 허수아비 농담은 글자 하나 다르지 않은 같은 문장으로 140번 들어 있었다. 묶기 전에 글자 그대로만 따져도, 정리본의 농담 1,011개는 서로 다른 문장 118가지뿐이었다.
25가지는 모두 인터넷에 이미 있던 농담이었다. 저자들은 「All of the top 25 samples are existing jokes.」라고 적었고, 보통 인터넷 검색으로도 똑같은 문장을 바로 찾을 수 있다고 덧붙였다. 농담의 꼴도 거의 하나였다. 질문 한 줄에 말장난 답 한 줄이 붙는 꼴이다.
Despite one sample, all 1008 generated jokes were in the same question-answer format.
하나를 빼면, 받은 농담 1,008개가 모두 같은 질문-답 꼴이었다.
Jentzsch·Kersting, 「ChatGPT is fun, but it is not funny! Humor is still challenging Large Language Models」, WASSA 2023천 번 가까운 부탁에 돌아온 것은 대부분 인터넷에서 흔히 찾을 수 있는 몇 가지 말장난이었다. 글자까지 같은 문장을 하나로 치자 1,008개가 348개로 줄었을 만큼, 같은 문장이 그대로 되풀이된 경우도 많았다. 2023년 1월의 챗GPT는 같은 부탁에 사실상 몇 가지 농담만 돌려 냈다.
챗GPT는 정해진 농담 목록을 읽는가
25가지만 되풀이됐다면, 챗GPT가 농담 25개를 적은 목록을 들고 있다가 하나씩 읽는다고 생각하기 쉽다. 저자들은 이 짐작을 받아들이지 않았다. 목록에서 무작위로 고른다면 「we would expect the occurrence of samples to be more equally distributed」, 곧 농담마다 나온 횟수가 더 고르게 나뉘었을 것이라는 이유다. 이 25개를 고르게 돌려 읽었다면 농담마다 40번 안팎씩 나왔을 것이다(1,008 ÷ 25, 이 글의 셈). 실제 횟수는 140번부터 5번까지 크게 기울어 있었다. 또 저자들은 부탁에 주제를 정해 주면 있던 농담을 그 주제에 맞게 고친 농담이 나왔다고 적었다.
챗GPT 같은 언어 모델은 답을 한 낱말씩 만든다. 다음에 올 낱말 후보마다 확률을 매겨 두고, 그 확률에 따라 하나를 뽑는 일을 되풀이한다. 이 뽑기가 같은 질문의 답을 갈라 놓는 모습은 이 블로그의 같은 질문에 챗봇 답이 달라지는 이유에서 다뤘다. 거기서는 한 확률표 안에서 뽑기가 퍼져 같은 질문에 답이 달라졌고, 여기서는 그 표 자체가 몇 칸에 몰려 다시 뽑아도 같은 답이 나온다.
농담 한 편이 나올 확률은 낱말마다 고른 확률을 차례로 곱한 값이다. 그 값이 몇 개 농담에 몰려 있으면, 천 번을 뽑아도 같은 몇 개가 거듭 나온다. 한쪽 면이 유난히 무거운 주사위를 던지면 그 면이 자꾸 나오는 것과 같은 이치다. 다만 저자들이 센 것은 나온 횟수이고, 모델 안의 확률을 들여다본 것은 아니다. 천 번 가까운 부탁에서 횟수가 이만큼 몰렸으니 뽑는 확률도 몰려 있었다고 보는 것이 자연스럽다는 정도의 추론이다.
확률이 이렇게 몇 개 답에 몰려 나머지 답이 좀처럼 나오지 않는 일을 모드 붕괴(mode collapse)라고 부른다. 그러니 이 기록을 챗GPT가 농담을 25개만 안다는 뜻으로 읽을 일은 아니다. 이 기록이 보여 주는 것은 농담을 고르는 확률이 몇 개 쪽으로 쏠려 있다는 점이다. 그래서 같은 부탁을 되풀이하면, 확률이 큰 그 몇 개가 다시 돌아온다.
다른 농담을 받으려면 무엇을 바꿔 부탁하나
앞의 실험은 부탁 문장 열 가지를 돌려 썼는데도 농담이 25가지에 몰렸다. 열 가지는 표현만 다를 뿐 「농담 하나 해 달라」는 같은 내용이었다. 같은 뜻의 부탁을 되풀이하면 같은 확률표에서 다시 뽑는 셈이다. 문헌에서 다른 내용의 농담이 나온 것은 부탁의 내용을 바꾼 두 가지 방법이다.
— 주제를 정해 부탁한다. 예컨대 「고양이로 농담 하나 해 줘」처럼 쓴다. Jentzsch·Kersting도 「Can you tell me a joke about cats?」처럼 주제를 정한 부탁으로, 있던 농담의 틀에 새 내용을 넣은 농담을 받았다. 주제를 정한 같은 부탁을 되풀이하면 내용이 다른 답이 나왔다고도 적었다. 다만 1,008개와 따로 손으로 몇 번 해 본 예다. 저자들은 그 고양이 농담이 웃음 요소가 빠져 농담으로 통하기 어렵다고 평했다.
— 한 번에 여러 개를 부탁하고, 각각 나올 확률도 함께 적어 달라고 한다. 예컨대 「고양이 농담 다섯 개를, 각각 나올 확률과 함께 적어 줘」처럼 쓴다. 답 옆에 적히는 확률은 모델이 스스로 어림해 적는 값이고, 실제로 그 농담이 나올 확률을 잰 값은 아니다.
Zhang 연구팀(ICML 2026)은 GPT-4.1·Gemini-2.5·Claude 같은 요즘 모델들로 둘째 방법을 쟀다. 농담끼리 뜻이 얼마나 덜 닮았는지를 0~100으로 잰 다양성 값으로 보면 이렇다. 하나씩 받을 때 30.0, 다섯 개를 목록으로 한꺼번에 받을 때 58.8, 확률까지 함께 적게 할 때 62.5였다(모델 평균). 늘어난 몫의 대부분은 「한꺼번에 여러 개」에서 왔다. 이 값은 서로 다른 농담의 개수가 아니다. 이 측정의 부탁에는 처음부터 주제가 정해져 있었으니, 두 방법은 함께 쓸 수 있다.
첫째 방법은 2023년 실험 저자들이 따로 해 본 예에, 둘째 방법은 요즘 모델을 잰 수치에 기댄다. 시점은 달라도 가리키는 쪽은 같다. 같은 부탁은 같은 확률표에서 다시 뽑을 뿐이고, 그 표를 바꾸는 것은 부탁의 내용이다.
사람 평가로 다듬은 모델은 답이 덜 다른가
확률이 왜 몰렸는지는 Jentzsch·Kersting도 짐작만 했다. 저자들은 「Presumably」(아마도)로 시작하는 문장에서, 가장 자주 나온 농담은 학습 중에, 예컨대 사람이 매긴 점수로 답을 다듬는 단계에서 외운 것이리라고 적었다. 이 단계를 인간 피드백 강화학습(RLHF)이라고 한다. 저자들은 모델에도 학습 자료에도 접근하지 못했으니, 확인할 길은 없었다.
측정으로 다가간 연구가 있다. Kirk 연구팀(ICLR 2024)은 RLHF를 거친 모델과, 예시 답을 따라 하게만 가르친 모델을 견줬다. 같은 입력 하나에 16번씩 답하게 했더니 RLHF를 거친 모델의 답끼리 훨씬 덜 달랐다. 답을 뽑는 무작위 정도를 일부러 낮춘 설정도 아니었다. 다만 과제는 농담이 아니라 글 요약과 지시 따르기였고, 모델은 LLaMA였다.
비교 대상은 다듬기 전의 원래 모델이 아니었다. 서로 다른 입력끼리 견주면 차이는 일부 지표에서만 나타났다. 그래도 같은 부탁을 되풀이했을 때 다듬은 모델의 답이 서로 더 닮는다는 점은 뚜렷했다.
왜 익숙한 농담 쪽으로 더 몰리나
Zhang 연구팀은 다듬은 모델의 답이 몰리는 까닭을 사람 평가자의 버릇에서 찾는다. 사람만 평가한 선호 자료(HelpSteer)에서 두 답을 짝지어 보면, 우연이라면 원래 모델이 더 높은 확률을 준 쪽이 더 좋다고 뽑히는 경우는 절반쯤일 것이다. 실제로는 그런 경우가 51.6~60.8%로 절반보다 잦았다. 원래 모델이 흔하게 낼 만한 글, 곧 익숙한 글을 더 좋다고 고르는 버릇이 자료에 들어 있다는 것이다.
그런 자료로 모델을 다듬으면, 비슷하게 좋은 답이 많은 부탁에서 그 버릇이 동점을 깨는 쪽으로 작동한다(「acts as a tiebreaker」). 농담이나 시처럼 정답이 여럿인 부탁에서는 원래 모델이 가장 흔하게 내던 답 쪽으로 확률이 더 몰린다는 것이다. 식과 자료 분석으로 받친 저자들의 주장이고, 챗GPT 내부를 들여다본 결과는 아니다.
이 주장이 그리는 모양을, 2023년 챗GPT 농담 25가지의 횟수에서 출발하는 그림 2의 장난감 계산으로 옮겼다. 「익숙한 답 쪽으로 더 다듬는 세기」를 「그대로」에서 「아주 세게」로 올리면 확률이 앞쪽 몇 가지로 몰린다. 몰린 정도는 「사실상 몇 가지 중에서 고르는 셈인가」로 잰다. 모든 칸을 고르게 썼다면 몇 칸에 해당하는지를 센, 이 글의 요약 지표다. 출발점의 횟수부터 고르지 않아서 「그대로」도 25가지가 아니다. 이 수가 14.7, 9.8, 7.2, 5.2, 4.2가지로 준다.
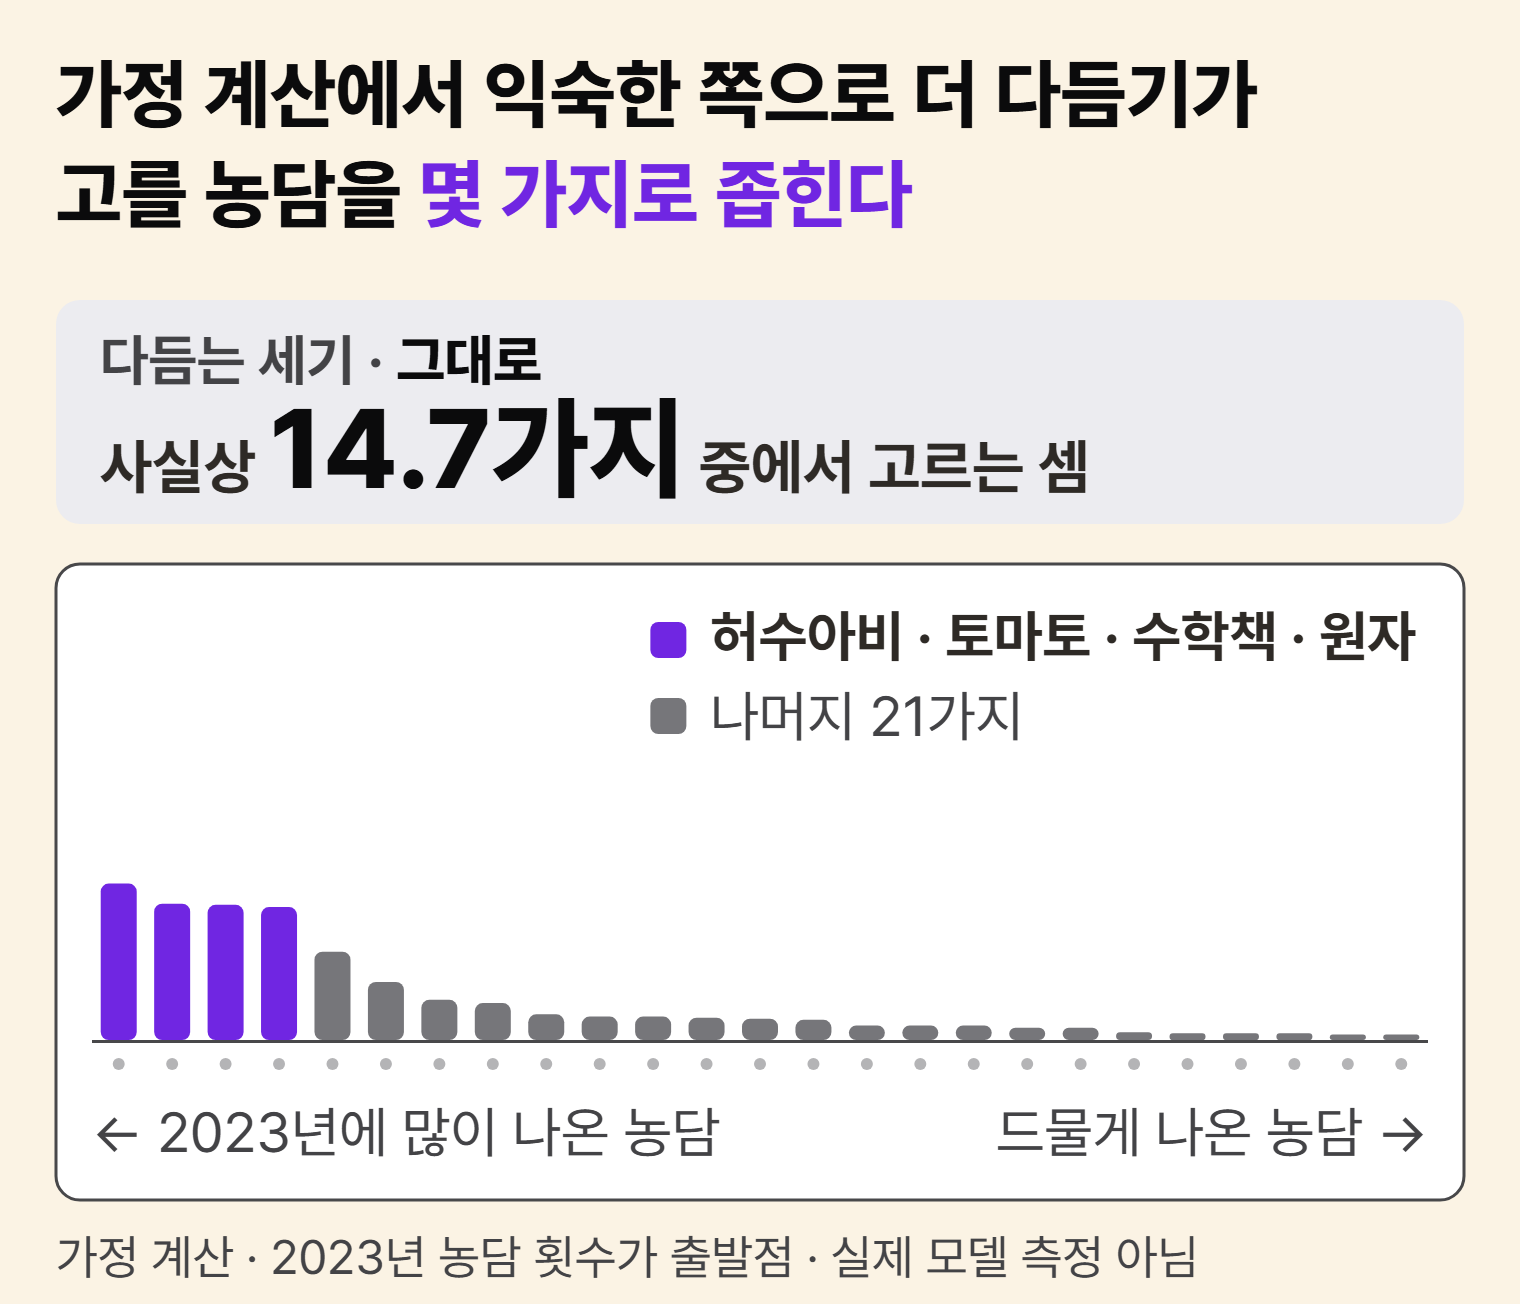
이 그림은 가정 계산이다. 그 농담들이 이 식으로 생겼다는 증거는 아니다. 이 장난감에서는 버릇이 셀수록 같은 몇 가지가 더 자주 돌아온다.
무작위 정도를 올리면 몰림이 풀리나
답을 뽑을 때 무작위 정도를 높이면 몰림이 풀릴까? Jiang 연구팀(NeurIPS 2025)은 농담이 아니라 열린 질문 100개로 이것을 봤다. 모델 25개가 질문마다 답을 50개씩 냈다. 연구팀은 문장의 뜻을 숫자로 바꿔, 답끼리 뜻이 닮은 정도를 0~1 사이 값(1에 가까울수록 닮음)으로 쟀다. 무작위 정도를 넉넉히 준 설정에서도 79%의 경우에 닮은 정도가 평균 0.8을 넘었다. 무작위 정도를 더 높이면서 확률이 낮은 후보를 일부 잘라 낸 설정에서는 아주 심한 반복이 줄었지만, 답 쌍의 61.2%가 여전히 0.8을 넘었다.
앞의 장난감에 무작위 정도를 더해 계산하면 이 측정과 반대 방향이 나온다. 장난감에서는 다듬는 세기와 무작위 정도가 정확히 맞비겨, 둘을 같은 만큼 올리면 확률이 출발점인 「그대로」 상태(사실상 14.7가지)로 돌아간다. 실제 모델에서 왜 덜 듣는지는 이 글이 계산으로 보이지 못한다. Jiang 연구팀의 측정에서는 후보를 잘라 낸 설정도 아주 심한 반복만 덜어 냈다.
몰림은 다듬는 단계 탓으로 밝혀졌나
「사람 평가로 다듬는 단계가 몰림을 만든다」는 생각은 확정된 사실이 아니다. Kirk·Zhang 연구팀의 논문은 이 가설의 출처로 janus가 2022년에 쓴 블로그 글을 인용한다. 「Mysteries of mode collapse」라는 글인데, 처음 제목은 「Mysteries of mode collapse due to RLHF」였다. 그런데 글쓴이는 RLHF 탓이라는 말을 스스로 거둬들였다. 글머리에 「I have received evidence from multiple credible sources that text-davinci-002 was not trained with RLHF.」라고 적어, 글이 다룬 모델이 RLHF로 학습되지 않았다고 밝힌 것이다.
다른 반론도 있다. Conmy·beren은 2023년 블로그 글에서, RLHF로 학습한 모델(text-davinci-003)에서는 그 결과가 재현되지 않았다고 적었다. 원래 모델보다 답이 더 흩어진 경우도 있었다고 덧붙였다. 다만 글쓴이들은 확신의 정도를 「confident but not certain」(확신하지만 확실하지는 않다)이라고 달았다.
몰림과 재미는 따로 재야 한다. Gorenz·Schwarz(PLOS ONE 2024)는 농담 예시와 조건을 넣은 구체적인 부탁으로 GPT-3.5 계열 챗GPT의 농담을 받아, 사람이 쓴 농담과 출처를 가리고 견주게 했다. 재미 평가는 같거나 더 높았다. 다만 이 저자들은 예시나 조건이 없는 막연한 부탁에는 질이 낮은 농담이 돌아올 수 있다고 경고했다. 그 예로 Jentzsch·Kersting 실험을 들어, 그런 막연한 부탁에 질 낮은 농담이 겹쳐 돌아왔다고 적었다. 이 연구가 잰 것은 재미였고, 같은 농담이 얼마나 되풀이되는지는 재지 않았다.
Shypula 연구팀(COLM 2025)은 품질 기준을 넘는 답끼리만 다양성을 쟀다. 그러자 더 나은 답을 고르게 다듬은 모델이, 예시를 따라 하게 가르친 모델이나 원래 모델보다 오히려 뜻이 더 다양한 답을 냈다. Kirk 연구팀 스스로도 자기들이 본 다양성 감소가 RLHF로 다듬는 일에 본래 따르는 맞바꿈인지, 지금 방법이 모자라서인지는 「unclear」(분명하지 않다)라고 적었다. 몰림은 여러 측정에 나타나지만, 어느 단계가 얼마나 만드는지를 두고는 연구들이 엇갈린다.
농담 말고 어떤 부탁에서 같은 답이 돌아오나
시 쓰기 과제 하나를, 같은 공개 모델 가족(Tulu-3)이 학습 단계마다 남긴 모델에 똑같이 시킨 측정이 있다. 다양성 값은 앞의 농담 측정과 같은 지표로, 시끼리 뜻이 얼마나 덜 닮았는지를 잰다. Zhang 연구팀이 그냥 부탁했을 때 그 값은 다듬기 전 모델에서 45.4%였다. 예시를 따라 하게 가르친 단계에서 20.8%가 됐고, 그다음 더 나은 답을 고르게 다듬은 단계에서 10.8%로 줄었다. 첫 단계에서 이미 절반 아래로 줄고, 다음 단계에서 또 절반쯤 줄어든 셈이다. 농담이 아니라 시 과제에서 잰 값이다.
글쓰기에서도 비슷한 측정이 있다. Padmakumar·He(ICLR 2024)는 사람들에게 논술문을 혼자, 또는 언어 모델과 함께 쓰게 했다. 사람 피드백으로 다듬은 InstructGPT와 함께 쓴 글이 가장 덜 다양했다. 혼자 쓴 글이나 다듬기 전 GPT-3와 함께 쓴 글과 견준 결과다. 저자들은 그 차이가 주로 InstructGPT가 함께 쓴 글에 직접 보탠 부분이 덜 다양했던 데서 왔다고 적었다.
무작위 정도를 다룬 절의 열린 질문 측정에서도 한 모델이 낸 답끼리는 서로 닮아 있었다. 시와 논술문, 열린 질문처럼 정답이 여럿인 부탁에서는 농담이 아니어도 같은 몰림이 측정됐다. 그림 생성에도 비슷한 장면이 있다.
이 블로그의 AI 단체 사진 속 같은 얼굴, 어떻게 고칠까가 다룬 일이다. 거기서는 이미지 생성 AI가 한 장의 단체 사진 안에서 얼굴을 서로 닮게 그렸고, 여기서는 글을 만드는 모델이 여러 번 받은 농담을 서로 닮게 냈다. 겉은 달라도 묻는 것은 같다. 「여러 개를 받았을 때 서로 얼마나 닮았나」라는 물음 하나로 농담과 시, 논술문과 열린 질문, 단체 사진의 얼굴이 함께 읽힌다. 같은 부탁에 얼마나 다른 농담이 돌아올지가 모델이 답마다 매겨 둔 확률이 몇 개에 몰려 있느냐에 달려 있다.
더 읽기
- Sophie Jentzsch, Kristian Kersting, 「ChatGPT is fun, but it is not funny! Humor is still challenging Large Language Models」, WASSA 2023(ACL Anthology) — https://aclanthology.org/2023.wassa-1.29/ · 공개 데이터 https://github.com/DLR-SC/JokeGPT-WASSA23
- Robert Kirk 외, 「Understanding the Effects of RLHF on LLM Generalisation and Diversity」, ICLR 2024 — https://arxiv.org/abs/2310.06452
- Jiayi Zhang 외, 「Verbalized Sampling: How to Mitigate Mode Collapse and Unlock LLM Diversity」, ICML 2026 — https://arxiv.org/abs/2510.01171